AlphaEvolve:让模型去优化「有客观评分函数」的问题
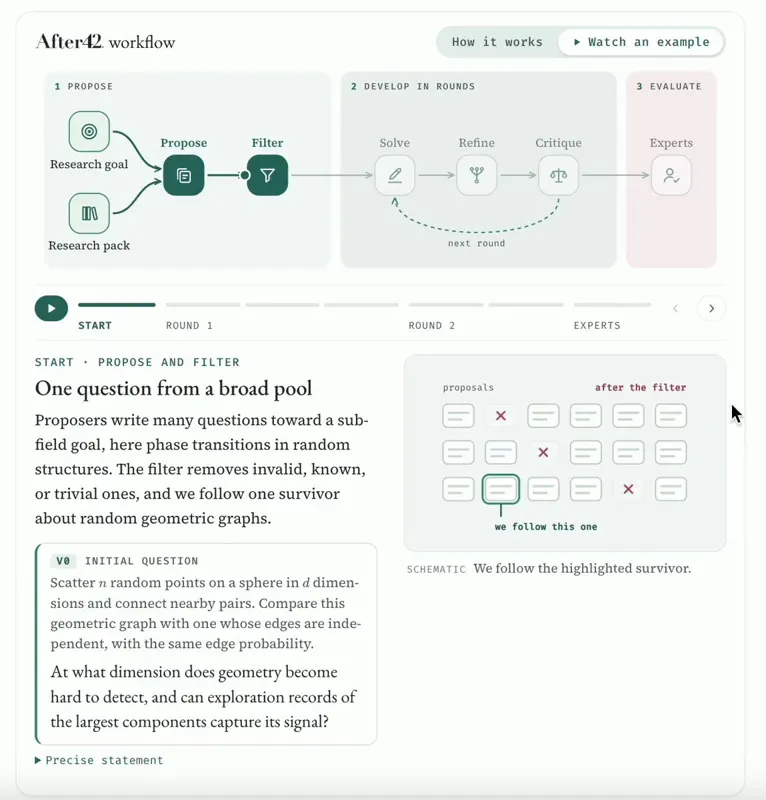
Google DeepMind 的编码代理式进化搜索:Gemini Flash 出量、Gemini Pro 出质地提出候选,自动评估器打分,高分候选留进种群当下一轮上下文,本质是 LLM 当变异算子的进化搜索;它只做有自动评估器的优化问题,因此归到 math 与 agents 两域。进化出的调度启发式已在 Google 数据中心(Borg)生产运行超过一年,持续回收 Google 全球算力的 0.7%(口径是 Google 全球算力,不是全人类算力),卡片读数取自它:全部结果里唯一经长期生产验证的一条。另有 matmul kernel 特定规模提速 23%;数学侧在 50 多个开放问题上约 20% 给出改进,含 4x4 复矩阵乘法用 48 次标量乘改进 Strassen 1969 年的 49 次记录。可验证性与证明器不同:Lean 通过是数学意义上的对,「提速 23%」是特定硬件下的经验读数。可用性接近零:无公开权重、Early Access 只有登记表,前提是你写得出便宜、快速、可信的评估器。置信度 B(有争议):Borg 那条经一年生产验证,未复现任何一条。
0.7%Google 全球算力回收(生产验证)有争议 · 2025-05
AlphaEvolve:让模型去优化「有客观评分函数」的问题Gamma:把「一份长材料」直接变成「一份能讲的演示」的编排型工具
Gamma 做的不是「写提示词出一页幻灯片」,而是把一份既有材料重新组织成一份可讲的演示:吃进长文档、PDF、粘贴的文本或一个网址,输出带大纲、分页、配图与版式的整套 deck,并且以「卡片式」结构让每一页都能单独重排、重写、换图。它代表文档与演示领域真正有用的那一类 AI——价值在编排与信息取舍,不在生成质量。它的天花板也同样清楚:输出是它自己的排版系统,导出到 pptx 之后样式还原度会掉一层,而这恰好是多数组织的硬性要求。
网页 / pptx / pdf输出形态厂商宣称 · 2025-01
Gamma:把「一份长材料」直接变成「一份能讲的演示」的编排型工具WorkBuddy:腾讯的全场景 AI 办公工作台
腾讯出品的办公 agent:说出要求后自主规划、调用工具、生成文件,过程和结果都留给你审核;打通腾讯办公 IM/文档/邮箱/会议/知识库。
15 分钟深度调研交付(厂商宣称)厂商宣称 · 2026-10
WorkBuddy:腾讯的全场景 AI 办公工作台Muse:Meta 的长时任务个人 agent
Meta 2026-09-08 在美区发布的个人 AI agent:iOS/Android/Web,跑在云端 VM 上,用 chat 下目标、能看着它操作浏览器,Sentinel 权限把读写分开。
美区 · iOS / Android / Web首发平台(Meta 官方)厂商宣称 · 2026-09
Muse:Meta 的长时任务个人 agent豆包工作:从 PPT 到操作电脑,字节的生产力 agent
字节 2026-08 推出的生产力 agent:做 PPT/文档/表格、深入调研、定时任务,还能读写本地文件、跨页面填表,并用手机远程派发任务。
Office 三件套 + 电脑操作能直接交付什么(厂商宣称)厂商宣称 · 2026-08
豆包工作:从 PPT 到操作电脑,字节的生产力 agentHermes Agent:把「自我改进」做成闭环学习回路的开源 agent
Nous Research 的自我改进型 agent(24.8 万+ star)。闭环学习回路五个机制:周期性记忆 nudge、任务后自主创建技能、技能在使用中自我改进、FTS5 会话检索 + LLM 摘要、Honcho 用户建模。一个 TUI,七个终端后端(local/Docker/SSH/Singularity/Modal/Daytona/Vercel Sandbox),六个聊天平台由单个 gateway 提供。模型不锁定。同时是轨迹数据生产装置。「自我改进」是可证伪主张,受控实验尚未做过,记为待复现。
248kGitHub Star 数
Hermes Agent:把「自我改进」做成闭环学习回路的开源 agentDeerFlow 2.0:字节的 super agent harness
字节跳动开源的 super agent harness(8.2 万+ star)。2.0 是彻底重写,与 1.x 不共享代码:子 agent、可扩展 skill、沙箱与文件系统、长期记忆、会话目标,外加把上下文压缩做成手动的 Manual Context Compaction。定位从「深度研究框架」抬到「承载任意任务的运行时」。基准复现尚未做过,记为待复现。
83kGitHub Star 数
DeerFlow 2.0:字节的 super agent harnessPaperclip:用 AI agent 团队经营一家公司
开源的 AI agent 团队编排系统:Node.js 服务端 + React 界面,自带 agent、定目标,在同一个仪表盘上追踪工作与成本。看着像任务管理器,底下是组织架构、预算、治理、目标对齐与 agent 协同——管的是业务目标,不是 pull request。MIT 协议,自托管。
81kGitHub Star 数
Paperclip:用 AI agent 团队经营一家公司Orca:把并行 agent 落在 git worktree 上的 ADE
Orca 自称 ADE(Agentic Development Environment),「给 100x builder 的 AI 编排器」(7.5 万+ star,MIT/TypeScript,YC 支持)。核心机制:一个提示词扇出到 Codex、Claude Code、OpenCode、Pi 等多个 agent,每个隔离在自己的 git worktree 里,再比较结果、合并赢家。另有 WebGL 终端、Design Mode(点选页面元素把 HTML/CSS/截图送进 prompt)、GitHub 与 Linear 原生集成、diff 批注回传、SSH worktree、移动端通知。未做基准复现,记为待复现。
76kGitHub Star 数
Orca:把并行 agent 落在 git worktree 上的 ADEPPT Master:把文档生成原生 PowerPoint(不是套模板)
把 PDF/DOCX/网页或一句主题交给任意 agent 工具,在本机生成原生可编辑的 PPTX:真幻灯片母版、原生形状、数据图表与可编辑公式,还能填充已有 pptx 的设计。
58kGitHub Star 数
PPT Master:把文档生成原生 PowerPoint(不是套模板)Multica:会上看板的 AI 编码 agent
开源自托管的 agent 工作区:像给同事派活一样把 issue 指派给 AI 编码 agent,它自己接单、在你自己的 runtime 上执行、全程留评论,最后交回 review。支持 26 个 agent CLI,意图/运行/决策/diff 全挂在同一个 issue 上,代码不出你的机器。
51kGitHub Star 数
Multica:会上看板的 AI 编码 agentLangGraph:把 agent 当成必须可持久、可中断、可恢复的长运行进程
LangChain 出品的底层状态图编排框架,MIT,Python 与 JS/TS 双实现,README 点名的生产用户有 Klarna、Replit、Elastic。它的血统写在致谢里:灵感来自 Google Pregel 与 Apache Beam,接口借鉴 NetworkX——把 BSP 图计算模型搬到 agent 上,得到「节点 = 一次模型调用或工具执行,边 = 控制流,状态 = 显式对象」。真正的价值不在「循环调模型 + 工具」那一层,而在四项运行时能力:持久化执行(崩了能从中断处精确续跑)、人在环中 interrupt(审批可以挂几小时到几天)、短期与长期两套记忆、以及 LangSmith 执行路径追踪。它的实际主张是「agent 的可靠性问题在运行时,不在模型」。可脱离 LangChain 单独使用;任何编译出的 CompiledStateGraph 都能作为子智能体交给上层 Deep Agents。42.1k★。未跑过;持久化恢复的一致性尚未验证,记为待复现。
42kGitHub Star 数
LangGraph:把 agent 当成必须可持久、可中断、可恢复的长运行进程DeepTutor
DeepTutor 是香港大学数据智能实验室(HKUDS)开源的「终身个性化辅导」平台(Apache-2.0,Python 3.11+ / Next.js 16,arXiv 2604.26962,40.6k stars):把聊天、多引擎 RAG 知识库、活书(living book)、写作与练习整合进一个学习工作区。核心能力:①Subagents & Partners——在聊天中直接调用本机的 Claude Code、Codex、Grok CLI、Kimi、opencode、Hermes、DeepSeek 等真实 agent harness 并把其工作流式导入对话,还能挂常驻 IM 伴侣;②多引擎知识库——LlamaIndex、PageIndex、GraphRAG、LightRAG(含远程 Server)、自托管 WeKnora、腾讯 IMA、MarginNote 4、Kiwix ZIM 离线档案、Obsidian 库皆可接入,文档解析可插拔(MinerU/Docling/Tika/markitdown/PyMuPDF4LLM/LiteParse),知识库可跟踪 GitHub 仓库与文档站(哈希差分 24h 自动同步);③Book 把资料编译成可编辑的「类型化块」活书(文本/测验/抽认卡/时间线/概念图/交互 HTML),导出 Markdown,长任务可暂停续跑;④个性化学习(Mastery Path、沉浸阅读、带可验证引用的朗读/测验/翻译)、Co-Writer 分屏 Markdown 写作(KaTeX+图示实时预览);⑤办公技能代码沙箱——运行模型生成代码处理 docx/pdf/pptx/xlsx;⑥Agent 原生 CLI——SKILL.md 开放格式可被 Claude Code/Codex 自动拾取,deeptutor run 可包进 LangChain/AutoGen 循环。项目由 Bingxi Zhao 主导,完全开源迭代、无任何付费在线产品。
41kGitHub Star 数
DeepTutor