
训练智能体的后训练课程:从 SFT、蒸馏到 GRPO 与异步环境
Hugging Face 用五步课程串起智能体后训练:SFT 学轨迹,蒸馏传概率,GRPO 优化结果,环境承接多回合行动,异步 harness 让训练接近真实部署。
训练智能体的后训练课程:从 SFT、蒸馏到 GRPO 与异步环境
来源:A curriculum for post-training agents,Hugging Face,2026 年 10 月 20 日。
预训练语言模型可以继续一段文本,但智能体要做的事情不同:读取任务、选择工具、观察结果、修正计划,然后继续行动,直到任务结束。此时,一次回答不再是行为的完整单位。一个 episode 可能包含几十条消息、多次工具调用,以及由外部程序返回的观测。训练智能体,也就是训练这整段交互历史,而不只是训练一个漂亮的最终答案。
这套课程把智能体后训练分为五个阶段。原文用编码智能体作为贯穿案例,因为代码动作可以执行、测试和验证;但同样的递进关系也适用于数据分析、浏览器操作、运维工作,以及基于仿真的机器人任务。五个阶段从最强、最昂贵的监督,逐步走向更弱、但更可扩展的结果信号:
- 监督微调(SFT):从更强模型产生的完整轨迹中学习。
- 蒸馏:通过教师生成的数据,或教师对学生自身 token 给出的概率,传递教师行为。
- GRPO:对同一 prompt 采样多个回答,根据组内相对得分学习。
- 强化学习环境:把得分变成有状态、多回合任务中的真实行动反馈。
- Harness 与异步基础设施:把真实智能体循环放进远端沙箱,并让生成和训练不必互相等待。
最关键的结论是:训练接口应尽量接近部署接口。如果线上智能体使用特定的工具 schema、上下文策略和停止条件,训练 rollout 就不应在无人察觉时替换成一份理想化的模仿数据。否则,优化器学到的只是一个用户永远不会运行的模拟器策略。
五步课程总览
| 阶段 | 信号来源 | TRL 训练器 | 需要准备什么 | 主要限制 |
|---|---|---|---|---|
| SFT | 正确的智能体轨迹 | SFTTrainer |
Prompt、完整轨迹和 assistant token 的 loss mask | 模型没有机会练习如何从自己的错误中恢复。 |
| 蒸馏 | 教师输出或教师概率 | DistillationTrainer |
Prompt 与教师模型 | 学生受教师能力上限约束,教师推理成本高。 |
| GRPO 强化学习 | 采样回答获得的分数 | GRPOTrainer |
Prompt 与一个或多个奖励函数 | 奖励稀疏,且必须难以被模型钻空子。 |
| 强化学习环境 | 多次行动后观察到的结果 | GRPOTrainer 配合 OpenEnv |
任务、工具、状态转移和最终检查器 | Rollout 生成成为最慢且运维最复杂的部分。 |
| 规模化 Harness | 通过接近生产的循环完成完整 episode | AsyncGRPOTrainer |
任务、环境、harness 与独立推理算力 | 要处理权重陈旧、沙箱隔离、失败恢复与吞吐。 |
这五项是一条课程路径,不是所有项目都必须依次支付全部成本。没有可用策略的团队可能需要先做 SFT;有强教师而数据预算有限时,蒸馏可能最合适;存在可靠 verifier 时,GRPO 能优化 demonstrations 中很少出现的能力;当任务结果取决于连续行动而不是单次回答时,才需要把训练推进到有状态环境。
0. 开始之前:把智能体与运行时拆开
在比较训练器之前,先把四个概念说清。这里的模型是学到的策略;智能体循环决定何时调用模型、如何解析输出,以及何时把下一次观测送回模型;harness 是包围这个循环的可执行脚手架,包含系统提示、工具、上下文管理、解析器、重试规则和停止逻辑;环境持有任务状态,并决定动作执行后会发生什么。
这些边界没有唯一标准,但在同一个实验内必须保持一致。可以用下面五个问题做检查:
- 哪些角色产生训练 loss:只有 assistant、整个对话,还是带标签的子集?
- 每一回合中,策略能看见哪些 observation?
- 工具是否会失败、超时、返回畸形结果,或要求模型自行恢复?
- episode 何时视为结束,最终 reward 由谁产生?
- SFT、RL 与评测之间,哪些组件保持冻结?
只要其中一项在训练和评测之间发生改变,就会出现很难察觉的分布偏移。一个模型可能在清理过的训练轨迹上表现很好,却在真实工具连续成功五次后突然报错时完全不会恢复。
1. 监督微调:从完整轨迹学习
SFT 把一段记录下来的智能体运行过程当作目标序列。轨迹中包含任务、消息、工具调用、工具结果,以及模型之后的决策。训练要让模型提高强模型或人类示范者所采取动作的概率。
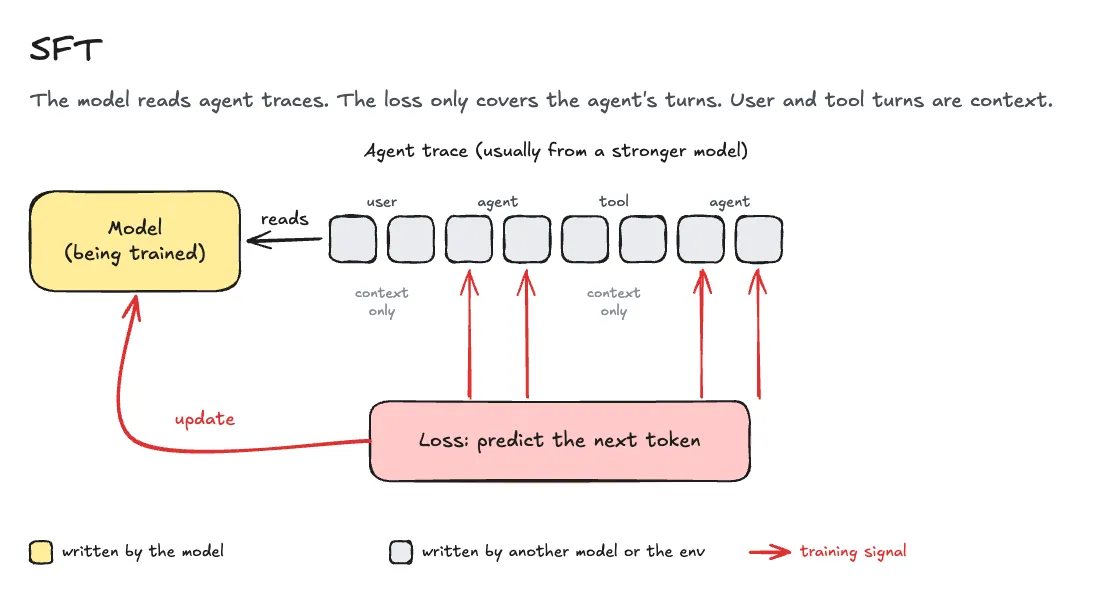
对于轨迹 $i$ 中的 assistant token $y_{i,t}$,常用目标是下面的 token 级交叉熵。智能体训练中的 mask $m_{i,t}$ 很重要:prompt、工具 schema 和环境 observation 通常不应被当作模型必须预测的动作。
$$L_{\mathrm{SFT}}=-\frac{\sum_{i,t}m_{i,t}\log\pi_\theta(y_{i,t}\mid x_i,y_{i,<t})}{\sum_{i,t}m_{i,t}}$$
这种方法的优势是稳定。每个目标 token 都已知,监督稠密,同一配方可以扩展到大型离线数据集。它也是最便宜的格式教学方式:何时调用工具、如何写参数、如何解释 observation、何时停止。对于尚不能稳定输出一次合法工具调用的小模型,SFT 往往就是必须经过的第一阶段。
限制同样明显:学生只能看到成功示范,不能生成自己的错误,也就得不到“从错误中恢复”的训练信号。真实部署时,策略一定会犯错;训练时却从未被要求在一个错误之后继续。这就是 exposure bias 在智能体场景中的表现。
因此,好的 SFT 数据远不止最终代码。要保留完整工具序列、observation 边界、重试行为和终止方式,同时删除线上策略看不到的隐藏推理。如果轨迹被清洗得过于理想,模型学到的就是另一项任务。
2. 蒸馏:传递比硬标签更多的信息
蒸馏仍然使用教师,但可以提供更丰富的信号。序列级蒸馏让教师生成轨迹,再由学生模仿;token 级蒸馏则让教师对学生自己产生的下一个 token 给出概率。后者是 on-policy 的:学生创建上下文,教师告诉它下一步动作应如何分布。
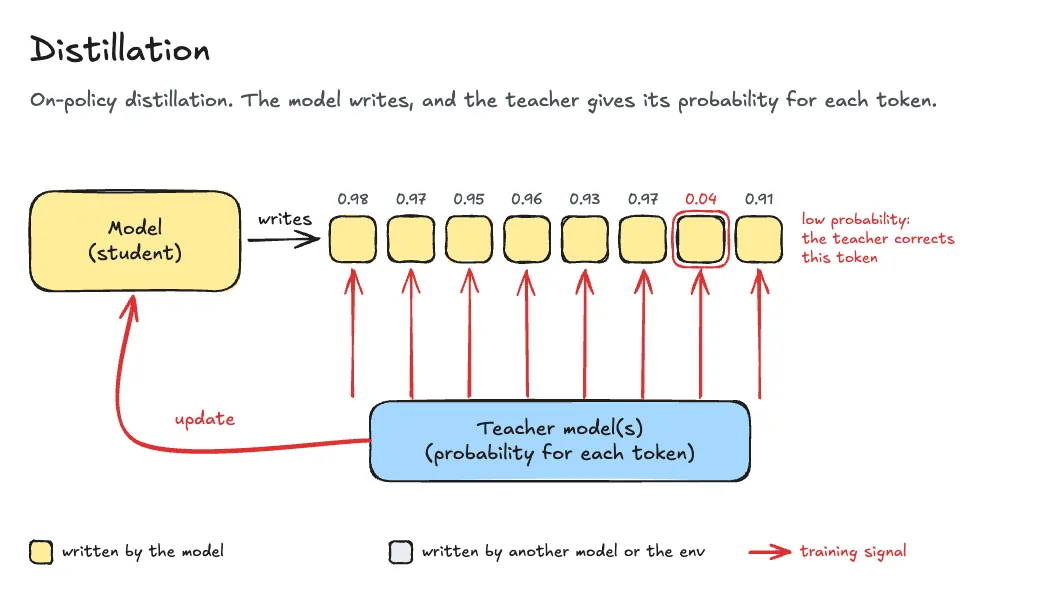
设教师分布为 $q_t$,学生在词表 $V$ 上的分布为 $p_\theta$,一种概念性的蒸馏损失是:
$$L_{\mathrm{KD}}=-\sum_t\sum_{v=1}^{V}q_t(v)\log p_\theta(v\mid c_t),\qquad q_t=\operatorname{softmax}\left(\frac{z_t^{T}}{\tau}\right)$$
其中 $c_t$ 是学生产生的上下文,$z_t^{T}$ 是教师 logits,$\tau$ 是温度。教师不只告诉学生“调用 run_tests”,还可以表达多个动作各自有多合理。这种稠密监督通常比 RL 需要更少样本,因为 RL 可能只给整条轨迹一个分数。
蒸馏有两项成本。第一,学生的能力上限受教师提供的证据约束,除非学生通过自身归纳偏置或额外 on-policy 探索获得新能力。第二,on-policy 蒸馏必须在学生 rollout 或训练期间运行教师。对于长 episode,教师推理很容易成为主要预算。
所以真正要选择的不是“蒸馏还是 RL”,而是监督密度。有优秀轨迹时先利用 demonstrations;教师能评价学生自己的局部选择,并且 token 级指导值得额外算力时使用概率蒸馏;行为难以模仿、但最终结果可以检查时,再使用基于 reward 的 RL。
3. 强化学习:用 GRPO 从结果学习
RL 不再要求教师。模型针对同一 prompt 采样回答,reward function 打分,训练再提高高分行为出现的概率。奖励可以来自精确检查器、测试套件、受约束的模型评分器,或经过仔细验证的组合信号。
Hugging Face 在这门课中使用 Group Relative Policy Optimization,即 GRPO。对每个 prompt,GRPO 采样一组 $K$ 个回答,并在组内比较 reward。它不需要额外的 value model 来估计 baseline,组内均值就是参照点。
$$A_i=\frac{r_i-\operatorname{mean}(r_1,\ldots,r_K)}{\operatorname{std}(r_1,\ldots,r_K)+\epsilon}$$
设策略概率比为 $\rho_t(\theta)$,裁剪阈值为 $\epsilon$,一种标准 GRPO 风格的目标可以写成:
$$\rho_t(\theta)=\frac{\pi_\theta(y_t\mid s_t)}{\pi_{\theta_{\mathrm{old}}}(y_t\mid s_t)}$$
$$L_{\mathrm{GRPO}}=-\mathbb{E}\left[\min\left(\rho_t(\theta)A_i,\operatorname{clip}\left(\rho_t(\theta),1-\epsilon,1+\epsilon\right)A_i\right)\right]+\beta D_{\mathrm{KL}}\left(\pi_\theta\Vert\pi_{\mathrm{ref}}\right)$$
具体实现可能采用不同的 advantage normalization、token 级或序列级概率比、工具 observation mask,或 DAPO、Dr. GRPO、GSPO、CISPO 等变体。共同思想仍是相对比较:同一 prompt 的多次尝试,足以告诉模型哪些行为应获得更高概率。
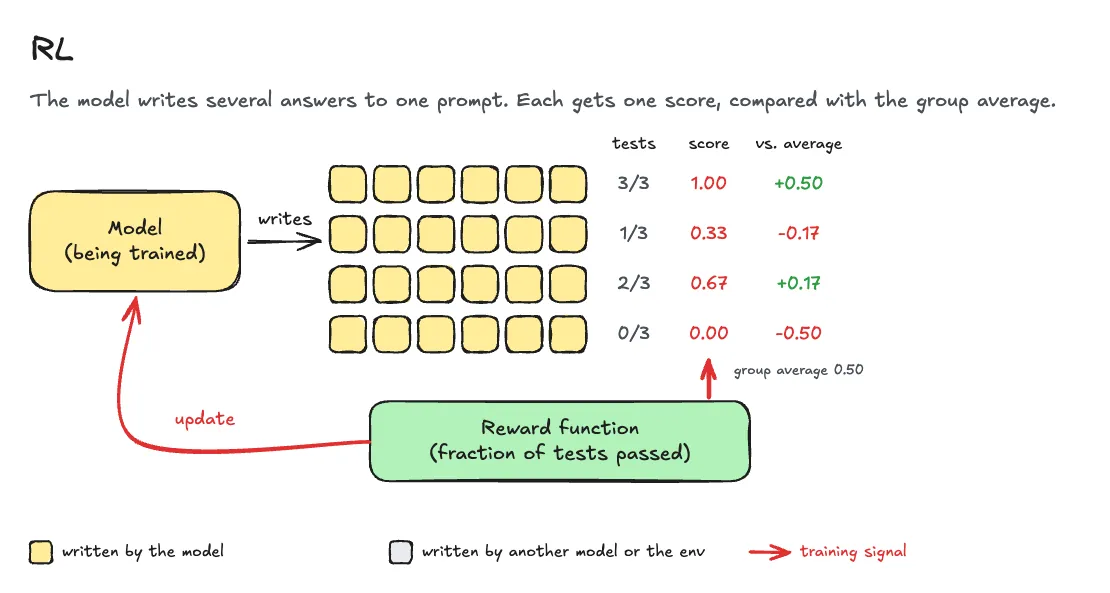
这种信号比 token 级蒸馏弱得多。一整个回答或 episode 最终可能只压缩成一个标量,因此模型需要大量尝试。稀疏奖励还会带来方差和探索问题:如果所有样本得分相同,中心化后的 advantage 为零,这个 prompt 就不再产生梯度;如果奖励容易作弊,优化器一定会找到作弊路径。
因此,实际 reward stack 不能只放一个主指标。它通常包含正确性检查、格式闸门、破坏性动作防护、延迟或步数惩罚,以及 reward hacking 检测。每一项都会改变策略,增加一个 reward 不是增加无害指标,而是重新定义目标。
4. 强化学习环境:让智能体连续行动
普通 reward function 通常只给一次回答打分。环境则允许智能体反复行动、观察状态变化并修复自己的工作。它把“让模型写一个 patch”变成“让模型查看仓库、编辑文件、运行测试、读取失败信息,然后再次尝试”。
这个接口继承自 Gym 的 reset-step 循环:重置任务、应用动作、接收新 observation 与 reward,最后把 episode 标记为结束。
observation, info = env.reset(seed=task_seed)
done = False
while not done:
    action = policy(observation)
    observation, reward, terminated, truncated, info = env.step(action)
    done = terminated or truncated
在智能体环境中,返回的 observation 可能是 shell 结果、文件 diff、浏览器截图、仿真器状态或测试报告。环境持有状态转移,可以执行工具、约束权限,并判断最终产物是否通过。
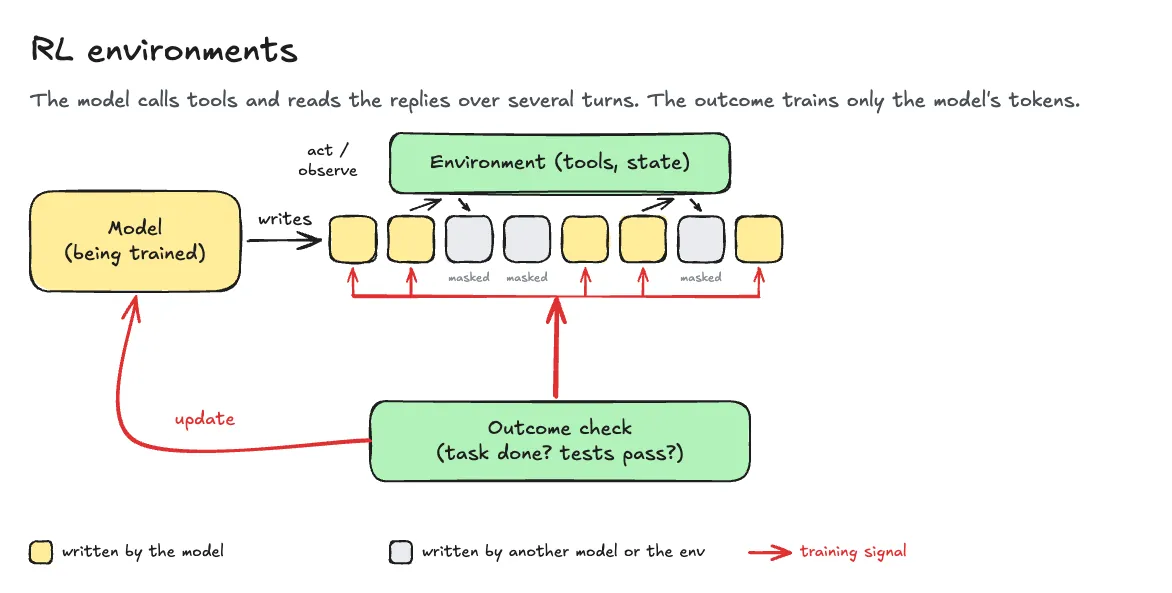
一段轨迹可以表示为:
$$\tau=(s_0,a_0,o_1,s_1,a_1,o_2,\ldots,s_T,a_T,o_{T+1})$$
如果使用学习到的 reward function,目标可能是折扣回报:
$$R(\tau)=\sum_{t=0}^{T}\gamma^t r_t$$
许多智能体任务更愿意使用终局 verifier:$R(\tau)=V(\tau)$。这里的 $V$ 会运行测试、检查数据库、验证文件或评估仿真目标。最终检查通常比逐步模型判断更可信,但它不会给整条轨迹提供细粒度梯度,信用分配仍然困难:最终通过时,三十个动作中究竟哪个值得奖励?
原文强调,这个循环本身很旧,真正变新的是使它可行的条件。2016 年已经有 reset-step 接口,但当时缺少强预训练策略、大规模且可达的任务、可靠的程序化奖励检查,以及低成本沙箱编排。今天的语言模型能在工具中行动,云平台能为每个 rollout 启动隔离机器,大量数字任务又天然提供可执行的成败条件。这些条件同时成熟,环境才从“概念上合理”变成“工程上可用”。
| 环境组件 | 职责 | 软件智能体示例 | 机器人示例 |
|---|---|---|---|
| 状态 | 保留先前动作造成的变化 | 仓库、shell 与浏览器 session | 机器人位姿、物体状态与仿真时钟 |
| 动作 API | 定义合法操作与参数 | 编辑文件、运行命令、点击元素 | 关节指令、抓取请求、导航目标 |
| 观测 | 返回动作结果 | 测试输出、diff 或页面快照 | 相机帧、本体感觉或接触反馈 |
| 终止 | 判断成功或失败何时确定 | 测试通过、超时或预算耗尽 | 到达目标、碰撞或 episode 上限 |
| 验证器 | 把最终状态转成 reward | 运行隐藏测试 | 测量目标距离与安全约束 |
长 episode 会让 rollout 生成成为瓶颈。训练器更新一次权重可能只要几秒,却要等待一个困难任务完成几分钟。更糟的是,一次基础设施失败可能让已经完成一半的轨迹全部作废。稳健环境需要 timeout、retry、资源上限、尽可能确定的随机种子,并清楚区分“任务失败”和“harness 失败”。
5. Harness 与规模:在最终部署的循环里训练
最后一步把完整的、接近生产的 harness 放进远端沙箱。模型拿到的不再是训练器临时拼出的简化 transcript,而是与真实智能体相同的 prompt 组装、工具解析、上下文管理、重试策略和完成检查器。每个 rollout 都在隔离机器里完成一次完整 episode。
这样做能改善迁移,却也提高吞吐难度。生成和训练使用不同的硬件画像与延迟模式。如果二者同步运行在同一组 GPU 上,训练器会在智能体等待工具时空转,推理引擎又会在权重更新时闲置。异步 RL 把两个池拆开,在它们之间传递 rollout 与权重。
flowchart LR
  D[Task dataset] --> R[Rollout workers]
  R --> H[Production-like harness]
  H --> E[Remote sandbox and tools]
  E --> H
  H --> B[Completed episodes buffer]
  B --> T[Policy trainer GPUs]
  T -->|Updated weights| V[vLLM inference GPUs]
  V --> R
异步循环引入一个新的状态变量:策略年龄。如果一个 rollout 由策略版本 $k_r$ 采样,而训练器已经推进到 $k_p$,样本抵达更新时就已经陈旧。
$$\Delta_{\mathrm{policy}}=k_p-k_r,\qquad \Delta_{\mathrm{policy}}\leq S_{\max}$$
TRL 的实验性 AsyncGRPOTrainer 暴露了控制这个系统的参数。独立 vLLM server 在其他 GPU 上生成轨迹,训练器同时更新策略。max_staleness、weight_sync_steps 与 max_inflight_tasks 在样本新鲜度和硬件利用率之间权衡。权重同步越新,on-policy 程度越高;同步过频或 in-flight 任务过少,又会让硬件闲置。
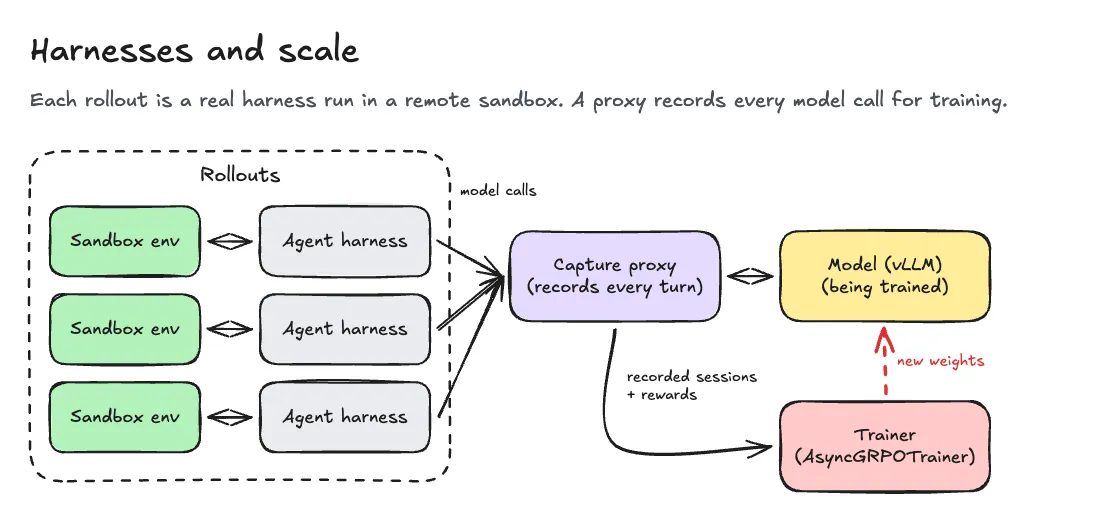
最小训练器配置可以很短:
from trl.experimental.async_grpo import AsyncGRPOTrainer
from trl.rewards import accuracy_reward
from datasets import load_dataset

dataset = load_dataset("trl-lib/DeepMath-103K", split="train")
trainer = AsyncGRPOTrainer(
    model="Qwen/Qwen3-4B",
    reward_funcs=accuracy_reward,
    train_dataset=dataset,
)
trainer.train()
推理 server 需要独立 GPU。文档示例用 vLLM server development mode、特定 log-probability 模式和 NCCL 权重传输启动它:
CUDA_VISIBLE_DEVICES=0 VLLM_SERVER_DEV_MODE=1 vllm serve Qwen/Qwen3-4B \
  --max-model-len 4096 \
  --logprobs-mode processed_logprobs \
  --api-server-count 8 \
  --weight-transfer-config '{"backend":"nccl"}'
这段示例展示的是接口,不是完整的生产配方。真实训练还需要沙箱生命周期管理、任务队列、失败分类、reward 审计、checkpoint 与策略陈旧度监控。最昂贵的部分往往不是 optimizer,而是让数千个异构 episode 持续流动,同时不污染状态,也不在无人察觉时给错产物打分。
如何选择下一阶段
| 当前症状 | 更合适的下一阶段 | 原因 |
|---|---|---|
| 模型无法产生要求的工具格式 | SFT | 先用大量干净示范,并对非 assistant token 做 mask。 |
| 格式正确,但教师能解释更好的 token 选择 | 蒸馏 | 在学生自己产生的上下文上增加稠密监督。 |
| 最终答案容易验证,但 demonstrations 很少 | GRPO | 用 reward 驱动的探索替代模仿。 |
| 单次回答无法完成任务 | RL 环境 | 暴露状态、工具与多回合成功条件。 |
| 玩具轨迹上能训练,部署后却失效 | 生产 Harness | 通过真实解析器、prompt、工具与停止规则训练。 |
| 智能体等待工具时 GPU 利用率骤降 | 异步 Harness 基础设施 | 解耦 rollout 生成与策略更新,并限制陈旧度。 |
对具身智能的启示
同一套课程也适用于机器人基础模型,即使 observation 与 action space 完全不同。SFT 可以从 demonstrations 教会策略产生合法动作块或工具调用;蒸馏可以把大型多模态教师压缩为更小的端侧策略;存在仿真器、judge 或任务检查器时,GRPO 可以优化结果;环境能在感知、规划与操作之间保留机器人状态;harness 则能复现机器人实际使用的上下文窗口、安全过滤器和工具 API。
困难也会更清楚。机器人 rollout 比 shell 命令更慢、更昂贵;仿真器只是近似;物理上无效的动作可能损坏硬件或制造不安全状态。因此,环境必须把硬安全约束与 reward 分开编码。异步训练能让仿真器和策略推理并行,但当环境不稳定或控制器依赖新鲜观测时,陈旧权重尤其危险。
组织原则没有改变:让监督尽可能贴近真正部署的行为。Demonstrations 展示期望路径,蒸馏评价局部决策,reward optimization 发现新的解法,环境检验行动的后果,harness 则让训练循环看起来像真实循环。
参考资料
- A curriculum for post-training agents:原文与课程总览。
- How frontier models train on outcomes in 2026:可验证奖励与现代 RL 配方。
- Why RL environments work now:Gym 时代与现代可执行任务之间缺失的条件。
- Keep the Tokens Flowing:开源异步 RL 系统与基础设施。
- TRL SFT Trainer、Distillation Trainer、GRPO Trainer 与 Async GRPO Trainer。
- OpenEnv 文档:有状态智能体环境与 harness。
来源:A curriculum for post-training agents,Ben Burtenshaw、Sergio Paniego、Merve,Hugging Face,2026 年 10 月 20 日。RobotWorld 中文版补充了实现细节、公式与具身智能场景分析。
原文来源:Hugging Face Bloghttps://huggingface.co/blog/huggingface/train-agents