Skip to content
SteadyTray:冻结步态、只训残差,让人形边走边端稳托盘

SteadyTray:冻结步态、只训残差,让人形边走边端稳托盘

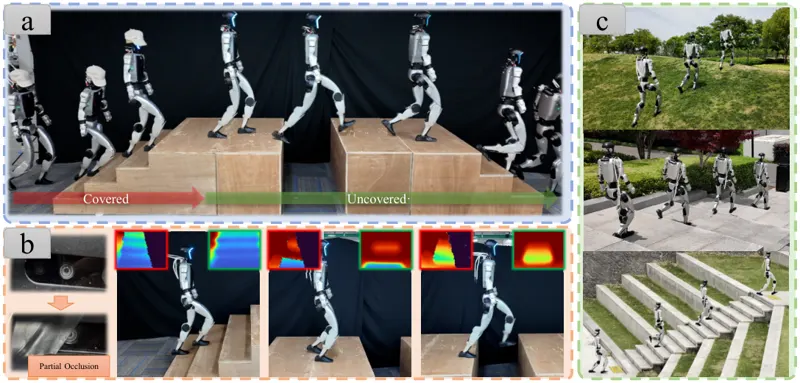
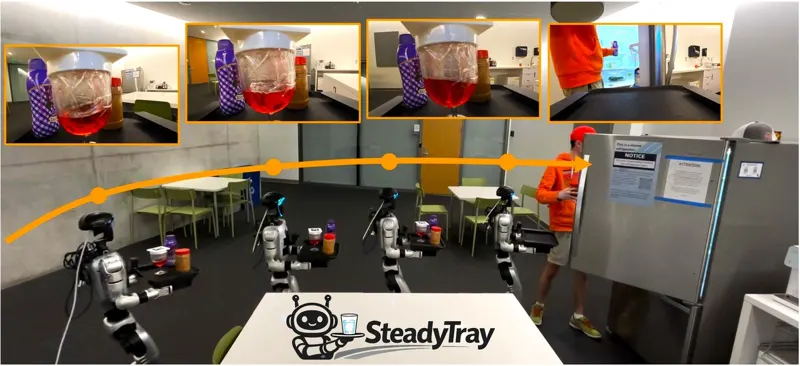
人形边走边端托盘的难点不在走,而在托盘与物体之间没有任何刚性连接:脚底落地冲击沿运动链传到末端执行器,物体只靠摩擦与重力被动约束,转弯、加减速或被推时随时滑移、倾斜、翻倒。SteadyTray 提出 ReST-RL,把两件事在参数层面拆开:预训练步态基策略训练完即完全冻结,任何后续梯度都不许回流;残差模块由特权编码器(机器人线速度、托盘位姿与投影重力、物体位姿/线速度/角速度,输出 64 维特征)加零初始化适配器组成,既可在动作空间叠加残差修正,也可用 FiLM 逐层调制冻结基策略的激活。零初始化保证训练第 0 步与原策略逐位一致,不会先毁掉步态再重建。部署侧用 DAgger 只蒸馏编码器、适配器整体冻结,学生仅需本体感知加头部 RealSense D435 与 AprilTag 的物体位姿估计,把模仿难度从动作空间压到 64 维潜空间。Isaac Lab 仿真(8192 并行环境,2×RTX A6000)中:变速指令跟踪成功率 96.9%(冻结基策略 47.4%、端到端 89.1%),推机器人 84.6%(基策略仅 9.1%),推物体 74.6%;三种残差接法成绩接近,说明收益来自结构化残差解耦本身而非某种适配器形态。奖励曲线显示端到端总奖励不低,但物体直立奖励长期停在约 0.9,残差变体爬到约 1.8。观测延迟消融中,延迟训练在 0.00 到 0.06 秒全部档位领先,含零延迟档(90.2 对 78.4)。Unitree G1(29 自由度)零样本端起咖啡杯、装水红酒杯、手术器械与密封食品盒,抗踢抗推恢复由上下肢协调完成。局限:编码器只处理单个物体、不建模细粒度几何与物理属性;头部相机视场窄且固定,难以换持握姿态避障;纯 sim-to-real RL 依赖大量奖励塑形与仿真调校;评测未覆盖高重心、易滑动或软体载荷。

人形机器人残差强化学习移动操作Anlun Huang, Zhenyu Wu, Soofiyan Atar·2026年3月11日
ReST-RL:用统一自训练与价值引导搜索强化大模型推理

ReST-RL:用统一自训练与价值引导搜索强化大模型推理

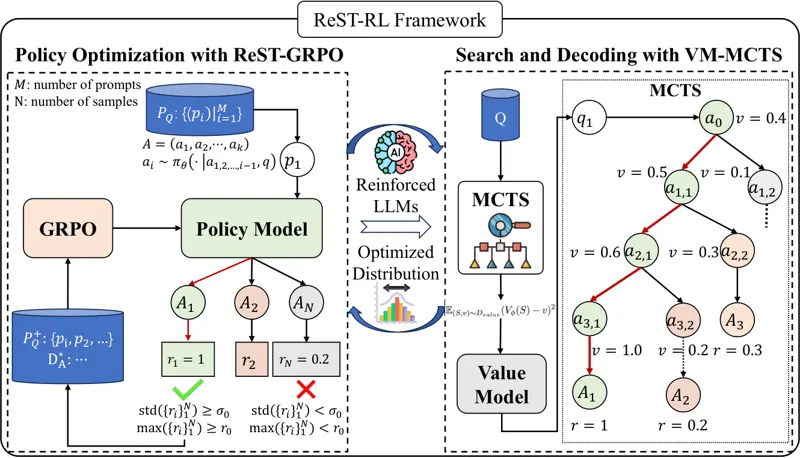
GRPO 是当前提升大模型推理能力的代表性强化学习方法,但它只在整条轨迹末端拿到一个稀疏奖励:一旦同组采样得到的奖励彼此接近,组内相对优势就退化成噪声,策略几乎学不到东西。ReST-RL 把策略优化与价值引导搜索重新接回同一条自训练流水线。第一阶段 ReST-GRPO 先按奖励标准差过滤掉信息量低的提示词,再从每个提示词的最高奖励轨迹中按离散指数分布抽取若干前缀,把它们当作在线 GRPO 的新起点——前缀只作为上下文,后缀一律重新采样并优化,而不是拿来模仿。第二阶段 VM-MCTS 在这个已静态化的策略下用 MCTS 自采价值目标,训练一个预测期望终端奖励的价值模型,推理时同一个模型既用于 UCT 搜索分配,也用于最终 Best-of-N 排序,搜索与验证共享同一套状态价值尺度。在 APPS、BigCodeBench、HumanEval 等代码基准上,Qwen3-8B 的平均分从 0.503 提升到 0.689;在匹配策略与价值模型的对照实验里,ReST-GRPO + VM-MCTS 在 APPS-500 上得到 0.642,而 GRPO + VM-MCTS 只有 0.538,说明第一阶段带来的轨迹分布改善确实穿过了价值学习环节存活下来。端到端算力核算上,ReST-GRPO 用 1752 GPU 小时对 GRPO 的 2080 小时,在 71 小时而非 207 小时达到 9% 的提升。仅用代码轨迹训练出的价值模型,在不做目标域微调的情况下迁移到 MATH、Omni-MATH 与 GPQA-Diamond 同样带来增益。

强化学习GRPOMonte Carlo Tree SearchSining Zhoubian, Dan Zhang, Jie Tang·2025年8月27日
RelateAnything:任意区域输入下的实时开放词汇关系预测

RelateAnything:任意区域输入下的实时开放词汇关系预测

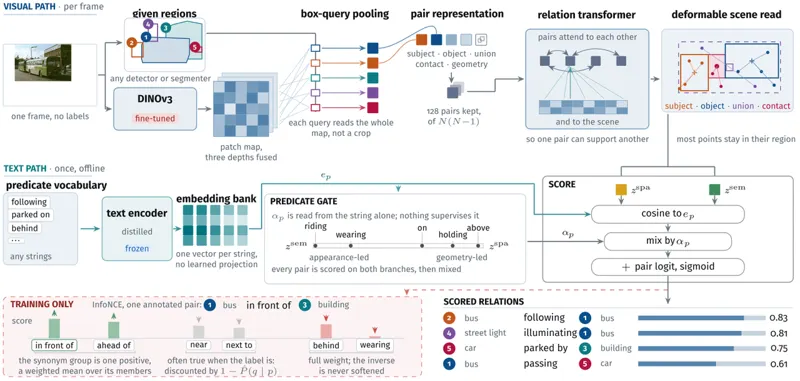
开放词汇检测允许在推理时接受任意类别列表,可提示分割能在没有类别名的情况下返回区域:分类体系已经离开模型、成为输入,而关系预测尚未如此。场景图模型仍在一个标注风格的 50 或 56 个谓词上训练与评测,关系头以物体标签为条件,因而与单一检测器绑定。本文指出三个障碍:不存在既自由文本又经过验证的关系语料;以标签为条件的架构无法接受训练时没见过的词汇;标准指标奖励与训练语料的一致性,使更大的词汇量反而表现为退步。RelateAnything 是一个 5300 万参数模型,输入图像与任意来源的区域,输出在推理时以字符串形式给出的谓词词汇上的打分关系;物体标签从不作为输入,词汇是文本嵌入库而非学习出的分类器,推理速度为每帧 20 毫秒。为支撑 19103 个谓词的训练,论文提出正-未标注监督与能够区分反义词的文本编码器(对比式编码器把反义词嵌入到余弦 0.95),并构建 RA-4M:47.4 万张图像、430 万条关系、10102 个自由文本谓词,对着编号框标记生成并经几何门验证;评测上构建 OV-SGG-Bench 六轴跨数据集协议。在三个跨数据集基准与一个零样本基准上,平均召回达到同规模最强开放词汇方法的 2.3 至 3.5 倍,并以不足其 2% 的参数量超过 3B 视觉语言场景图模型;域内评测会把迁移收益高估约 5 倍。模型、语料与基准均已公开。

Scene Graph Generation开放词汇Relation PredictionNeau, Maëlic·2026年9月11日