PAPER DEEP DIVE
CAP:以去噪世界模型实现连续自适应人形行走
CAP 用去噪世界模型把受污染深度重建为干净深度,与 50Hz 本体感受 VAE 双通路融合,让 G1 单策略在感知退化中稳定行走,脏深度成功率 97.9%。
一句话总结
CAP 把「感知失效就切换到盲走」的二选一范式,换成单策略连续自适应:世界模型编码器被训练成去噪器(输入脏深度、重建旋转稳定的干净深度),与 50Hz 本体感受 VAE 双通路共活融合;仿真脏深度下成功率 97.9%(Hiking 47.6%、二元切换 20.1%),Unitree G1 零微调直接部署,部分遮挡下 19/20 成功。
研究背景与动机
人形机器人走楼梯、跨沟、越障,靠脚下的反射是不够的,必须提前看到前方地形。前视深度相机提供的正是这种预判能力,但它在真实部署中并不可靠:运动模糊、自遮挡、传感器间歇性掉线都会污染深度流。关键在于,这些污染很少是「全有或全无」的,而是分级且瞬时的——某一刻深度只是部分退化,下一刻又可用了。所以一个面向真实世界的行走策略必须在整条感知质量谱上都能工作:从干净深度,到部分污染,再到完全丢失。
已有工作从这条谱的两端切入,近期尝试把它们桥接起来。盲走策略只从本体感受推断地形与身体状态,天然对外感知污染免疫,代价是无法预判前方障碍。感知策略引入外部感知,其中 PIE 用高度图重建、WMP 用世界模型自编码来丰富视觉潜变量,但它们都假定深度观测是干净且分布内的,假定一旦失效就跟着退化。切换式统一系统(VB-Com、MBC、RENet)同时训练感知子策略与盲走子策略,按感知可靠度在两者之间路由。
论文的批评点落在这些范式的共同假设上:不可靠的感知应当被盲走分支绕开。这个假设在传感器完全失效时是安全的,但它把「部分污染的深度」当成「完全污染的深度」处理,于是绕开了本来还能恢复的信息。更具体地说,感知策略会把退化输入当干净输入用,跟着一起退化;切换式系统则在门控翻转的瞬间丢弃可用深度,还可能引入突变的控制量。作者指出,没有任何一类现有方法通过去噪来恢复被污染的深度。
这正是 CAP 要占的位置:部分污染通常在深度历史里留下可恢复的几何线索,而这些线索既没有被去噪,也没有被利用。论文把感知鲁棒行走重新表述为连续适应问题,而不是二值模式切换问题。
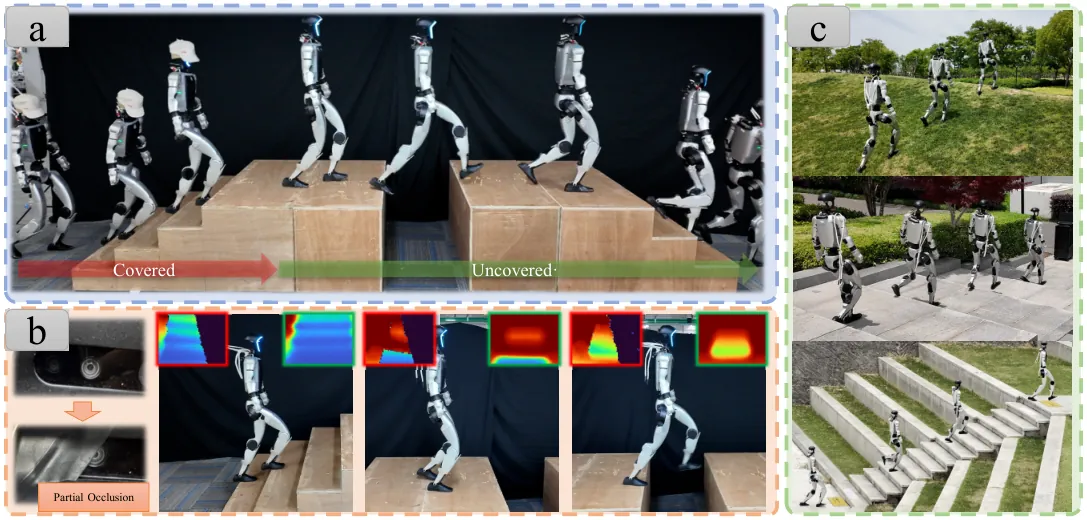
图 1(论文 Figure 1):CAP 让单一人形策略在感知变化与被污染条件下连续自适应地穿越复杂地形。(a) 混合地形上的遮挡—解遮挡片段;(b) 各地形下的部分遮挡样例,左侧红框为原始深度输入,右侧绿框为世界模型重建结果;(c) 草地与楼梯上的室外部署画面。
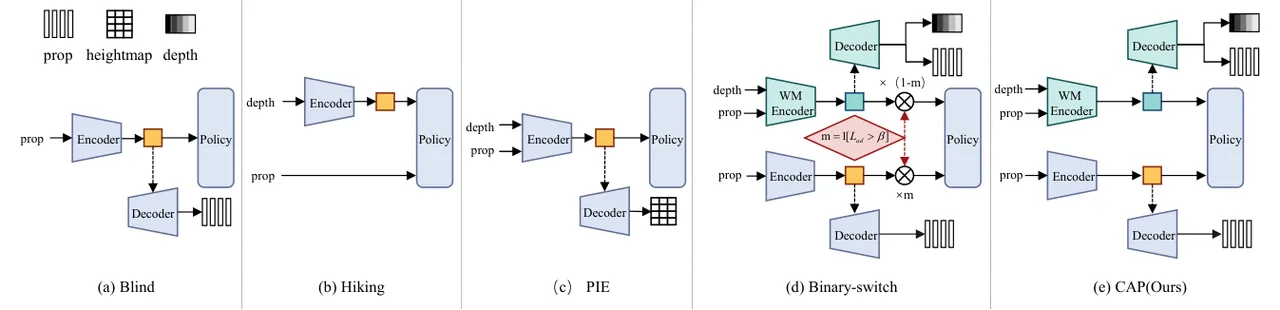
图 2(论文 Figure 2):四种范式的数据流对比。盲走策略不接深度,感知策略直接消费深度,二元切换系统在感知分支与盲走分支之间加门控;CAP 则让去噪世界模型通路与本体感受通路保持共活并连续融合。训练期才存在的 critic 与特权信号在图中省略。
方法详解
CAP 在架构上是一个非对称 actor–critic,外挂两个共同训练的编码器:感知世界模型(WM)编码器与本体感受变分(VAE)编码器。非对称设计让训练可以压缩成单阶段——actor 只接收部署机器人上真实可得的信号,critic 额外拿到仿真特权信号。优化过程有三条并发线:PPO 更新 actor 与 critic;VAE 在每个 PPO 步内按「重建 + KL」目标共训;WM 由独立优化器与 PPO 并行更新。
1. 策略与价值网络:共享门控的专家混合
策略侧的原始观测是一个本体感受向量 $o_t$ 和一张自中心深度图 $d_t$。本体感受向量按
$$o_{t}=[\,\omega_{t},\,g_{t},\,c_{t},\,\theta_{t},\,\dot{\theta}_{t},\,a_{t-1}\,]^{\top}\in\mathbb{R}^{45}$$
组织,其中 $\omega_t$ 是机体角速度,$g_t$ 是投影重力,$c_t$ 是速度指令,$\theta_t$ 与 $\dot{\theta}_t$ 是关节位置与速度,$a_{t-1}$ 是上一时刻动作。深度图 $d_t$ 由前向深度相机以 10Hz 采集,训练期可能被污染。
两个编码器把这些信号压成潜变量:WM 编码器以 10Hz 把 $o_t$ 与 $d_t$ 融合成 $z^{\text{wm}}_t$,VAE 编码器以 50Hz 把长度为 $H$ 的本体感受历史 $o^H_t=[o_{t-H+1},\dots,o_t]$ 压成 $z^{\text{vae}}_t$。actor 的输入是本体感受与两个潜变量的拼接
$$z^{a}_{t}=[\,o_{t},\,z^{\text{wm}}_{t},\,z^{\text{vae}}_{t}\,]^{\top}$$
随后送入共享门控专家混合(MoE)的 actor 分支:门控网络读取 $z^a_t$,把 $K$ 个专家的输出加权合成动作 $a_t$。按附录 A.1,actor 输入维度是 $45+32+16=93$,门控是 128 维隐层接 softmax 输出 $K=4$ 个专家权重,每个专家是 [256, 128, 64] 的 MLP,激活函数 ELU。这里的关键是门控读的是视觉与本体感受的联合表示,所以两条通路在所有感知条件下都保持共活,而不是二选一。
critic 镜像 actor 的输入,并额外访问部署时拿不到的特权信号:
$$z^{c}_{t}=[\,z^{a}_{t},\,v_{t},\,e_{t},\,m_{t}\,]^{\top}$$
其中 $v_t$ 是基座线速度,$e_t$ 是域随机化施加的外扰力,$m_t$ 是从地形真值采样的局部高度图。高度图给 critic 提供了一条与 actor 侧污染深度通路相互独立的干净外部感知信号,专门用于价值估计。critic 复用 actor 的门控权重但加 stop-gradient,避免价值损失扰动路由,最后输出 $\hat{V}_t$。附录 B.4 的消融显示,去掉这个高度图增广 critic 后,Noisy 档平均成功率从 97.9% 掉到 94.8%,平均回报从 40.6 掉到 38.7。
2. 感知世界模型编码器:输入与目标解耦的去噪
这是全文最核心的一处设计。作者明确指出,标准 Dreamer 式自编码里解码器重建的是编码器自己的输入;CAP 把输入与目标解耦——编码器吃观测到的深度 $d_t$,解码器却被要求重建另一个独立的、旋转稳定的干净深度 $d^{\mathrm{tgt}}_t$。这个目标视图在渲染时把相机 roll 与 pitch 固定到标称值(yaw 仍跟随机体朝向),于是这个目标同时逼迫编码器学两件事:其一是从污染深度到干净深度的去噪映射,其二是从随身体倾斜的传感器坐标系到地平线对齐参考系的变换。这两个变换都不是标准自编码目标能诱导出来的。
编码器实例化为 DreamerV3 的循环状态空间模型(RSSM),状态 $s_t=(h_t,z_t)$ 由确定性循环分量 $h_t$ 与随机潜变量 $z_t$ 组成:
$$\begin{aligned} h_{t}&=f_{\phi}(h_{t-k},\,z_{t-k},\,a_{t-k:t-1}),\\ z_{t}&\sim q_{\phi}(\cdot\mid h_{t},o_{t},d_{t}),\\ \hat{z}_{t}&\sim p_{\phi}(\cdot\mid h_{t}),\\ (\hat{o}_{t},\hat{d}_{t}^{\mathrm{tgt}})&\sim p_{\phi}(\cdot\mid h_{t},z_{t}) \end{aligned}$$
四行分别是递推、后验、先验和解码器;$k$ 是相邻两次 WM 更新之间隔的策略步数(部署时 WM 10Hz、策略 50Hz,所以 $k=5$),$a_{t-k:t-1}$ 是这期间执行的动作序列。训练目标是
$$\mathcal{L}_{\mathrm{WM}}=\mathbb{E}_{q_{\phi}}\Big[-\log p_{\phi}\big(d_{t}^{\mathrm{tgt}}\mid h_{t},z_{t}\big)-\log p_{\phi}\big(o_{t}\mid h_{t},z_{t}\big)+\beta_{\text{wm}}\,\mathrm{KL}\big(q_{\phi}(\cdot\mid h_{t},o_{t},d_{t})\,\|\,p_{\phi}(\cdot\mid h_{t})\big)\Big]$$
三项依次是去噪重建、本体感受重建和 KL 正则。正是 $d_t\neq d^{\mathrm{tgt}}_t$ 这个输入—目标失配,把 $\mathcal{L}_{\mathrm{WM}}$ 与既有 Dreamer 类公式区分开。重建项与 KL 项的相对权重由 harmony 式自适应缩放平衡,不是手调常数。先验 $p_\phi(\cdot\mid h_t)$ 让 WM 在观测变得不可靠时能向前预测,这种时间上的延续性有助于跨过短暂污染,但在持续感知丢失时会「过冲」——作者把这一失效区称为 WM overshoot regime,它同时是双通路设计和特征 dropout 的动机。
结构上,RSSM 的确定性维度是 512,随机潜变量是 $32\times32$ 的 categorical 分布。面向策略的投影是一个小 MLP,随 actor 一起在 PPO 下学习:$z^{\text{wm}}_t=\mathrm{MLP}_\psi(h_t)$,把 512 维 $h_t$ 经 [64, 64] 压到 32 维。随机分量 $z_t$ 只留在 WM 内部,不直接进策略。
3. 本体感受 VAE 编码器:控制频率上的身体状态
VAE 编码器以 50Hz 控制频率运行,完全不接深度输入,从本体感受历史 $o^H_t$ 映射出身体状态潜变量 $z^{\text{vae}}_t$ 并预测下一步本体感受 $\hat{o}_{t+1}$。它与 WM 在模态和时间尺度上互补:VAE 在控制频率上跟踪短时程身体动力学,WM 在 10Hz 上整合深度与本体感受以捕捉更长时程的地形结构。目标函数是标准 $\beta$-VAE 形式
$$\mathcal{L}_{\mathrm{VAE}}=\mathrm{MSE}\big(\hat{o}_{t+1},\,o_{t+1}\big)+\beta_{\text{vae}}\,\mathrm{KL}\big(q_{\theta}(z^{\text{vae}}_{t}\mid o^{H}_{t})\,\|\,p(z^{\text{vae}}_{t})\big)$$
按附录 A.1,VAE 的编码器是 [128, 32]、解码器是 [32, 128],潜变量 16 维,历史长度 $H=5$(即 50Hz 下 100ms 窗口),$\beta_{\text{vae}}=0.005$,每个 PPO 迭代共训一次。
需要强调的是,两条通路都不是充分的。WM 在过冲区会漂;VAE 没有外部感知输入,无法预判平台边缘、沟宽、栏高这类必须靠外部感知才能过的地形。所以设计是共活而非主备——附录 B.3 给出了直接证据:在阈值调好的二元切换基线上,本体感受分支的平均占空比在每个测试档位都低于 1%,也就是说门控几乎从不真的切过去,硬切换机制形同虚设,而 CAP 仍然全面胜出。
4. 耦合训练:输入侧噪声课程与潜变量侧特征 dropout
真实深度带着仿真器没有建模的伪影。作者用五条可组合的污染通道注入训练期的 $d_t$,按从像素级到帧级排列:高斯传感器噪声(读噪声)、椒盐噪声(零星无效像素)、块状遮挡(镜头污染)、边缘遮挡(深度不连续处的视差与自遮挡)、整帧失效(传感器故障)。每个环境有一个严重度 $n_e$ 同时缩放这五条通道,三档 profile Nominal / Degraded / Severe 分别对应干净、部分感知丢失、完全感知丢失。
profile 内部还有一个自适应更新:跟踪每个环境的滚动成功率 $\bar{s}_e$,按
$$n_{e}\leftarrow\begin{cases}n_{e}+1 & \bar{s}_{e}\geq\tau_{\uparrow}\\ n_{e}-1 & \bar{s}_{e}\leq\tau_{\downarrow}\\ n_{e} & \text{otherwise}\end{cases}$$
调整难度并裁剪到 $[0,N_{\max}]$($N_{\max}=10$)。这样每个环境的难度会自动跟上策略能力的增长,不需要人工排课程表。在必须依赖外部感知的地形(Platform、Gap、Hurdle)上,Severe 档被排除,以保证深度信号仍然可用;整帧失效的时间占比也被限制在 0.05。
第二个机制作用在潜变量侧。训练期 WM 产出的 $z^{\text{wm}}_t$ 是可靠的,没有正则化时策略会过度依赖它,本体感受通路得不到锻炼。作者用逐环境的 WM 特征 dropout 解决这个问题,其丢弃概率
$$p_{e}=\big(n_{e}/N_{\max}\big)\,p_{\max}$$
与噪声课程共享同一个严重度 $n_e$,所以每个环境是在输入侧与潜变量侧污染相匹配的条件下训练的。触发时,进入策略网络的 $z^{\text{wm}}_t$ 被三种污染之一均匀替换:Absent(置零,撤掉 WM 支撑)、Corrupted(按逐特征尺度加高斯噪声)、Misaligned(跨环境 shuffle,换成另一个环境的 $z^{\text{wm}}_t$)。
两个机制覆盖感知失效的互补轴向:深度噪声是输入侧污染,训练分布内的 WM 去噪能力;特征 dropout 是潜变量侧污染,让策略见到类似 OOD 的 WM 预测错误。这个分工在附录 B.4/B.5 得到验证——去掉特征 dropout 在 Clean/Noisy 两个锚点几乎看不出差别(Noisy 平均成功率 97.5% vs CAP 的 97.9%,平均回报甚至略高到 40.9),它真正针对的是分布外场景。
flowchart TB
    subgraph INPUT[Sensor input]
        DN[Depth noise curriculum
5 channels, severity n_e]
        D[Corrupted depth d_t
10 Hz]
        O[Proprioception o_t
50 Hz]
    end
    DN -- injects --> D
    subgraph WM[Perceptive world model - RSSM at 10 Hz]
        ENC[Encoder q_phi
h_t, z_t
recurrent on a_t-k:t-1]
        DEC[Decoder p_phi]
        TGT[Rotation-stabilized
clean depth d_t_tgt]
        PROJ[MLP_psi projects h_t
to z_wm 32d]
    end
    D --> ENC
    O --> ENC
    ENC --> DEC
    DEC -- reconstructs --> TGT
    ENC --> PROJ
    subgraph VAE[Proprioceptive VAE at 50 Hz]
        HIST[History o_t_H, H=5]
        VE[Encoder q_theta to z_vae 16d]
    end
    O --> HIST
    HIST --> VE
    subgraph POL[Shared-gate MoE policy at 50 Hz]
        DROP[WM feature dropout
p_e = n_e/N_max * p_max
Absent / Corrupted / Misaligned]
        GATE[Gate 128 to softmax over K=4]
        EXP[4 experts 256-128-64 ELU]
        ACT[Action a_t, 12 joints]
    end
    PROJ --> DROP
    DROP --> GATE
    VE --> GATE
    O --> GATE
    GATE --> EXP
    EXP --> ACT
    subgraph CRIT[Privileged critic - training only]
        HM[Heightmap m_t + base vel v_t + push e_t]
        VAL[V_hat_t with stop-gradient gate]
    end
    GATE --> VAL
    HM --> VAL
训练与评测设置
所有仿真实验在 Isaac Gym 中用 Unitree G1 完成,16384 个并行环境,地形统一为 Stair、Platform、Gap、Hurdle 四类。PPO 训练 20000 次迭代,rollout 长度 24,每次更新 5 个 epoch、4 个 minibatch,Adam 学习率 1e-3 并按 KL 自适应(目标 KL 0.01),裁剪系数 0.2,折扣 $\gamma=0.99$,GAE 的 $\lambda=0.95$。WM 用独立优化器,学习率 1e-4,batch 16、序列长 48,每个 PPO 迭代做 10 步梯度更新。奖励设计里速度跟踪与偏航跟踪各 2.0 权重,横向速度 -2.0,基座高度项 $-12.0\,(h-0.72)^2$。机器人域随机化覆盖负载 ±5kg、摩擦系数 [0, 1.25]、±0.75 m/s 推搡、±50N 外力、0–15ms 延迟;相机域随机化覆盖位置 ±0.02m、roll/pitch/yaw ±[1°, 2°, 1°]、焦距 $f_x$ 在 [0.9, 1.15] 倍、$f_y$ 在 [0.85, 1.1] 倍、主点偏移 ±0.05 倍图像中心。
评测用的是固定污染档位而非训练时的自适应课程:Clean 档取 Nominal profile 且 $n_e\sim\mathrm{U}[0,3]$,Noisy 档取 Degraded profile 且 $n_e\sim\mathrm{U}[7,9]$,Full failure 档取 Severe profile 且 $n_e=9$、只在楼梯上测。每个方法在 4096 个环境(四类地形均分)、3 个随机种子上评测并报告种子均值。评测时关闭自动重置,所以每个环境只贡献一条轨迹,首次终止即锁定结果;每个环境的噪声实现由种子固定并在方法间共享,这样差异只反映架构与训练配方,不反映评测分布。所有策略都执行恒定 0.8 m/s 前进指令,时域 20s;目标区放在 10m 地块末端前 0.5m。失败条件包括超时、横向偏离超过 0.75m、姿态崩溃(基座高于局部地形不足 0.3m,或 roll/pitch 超过 1.0 rad)、越出评测包络。地形难度 $d\sim\mathrm{U}[0.8,1.0)$,即固定在高难档:楼梯踏步高 0.05→0.23m,平台台阶高 0.10→0.45m,沟宽 0.10→0.85m,栏高至 0.45m。
实验结果
1. 锚点对比:干净档不掉分,脏档不崩
表 1 只评两个锚点档,读法是两道题:鲁棒训练有没有牺牲干净深度下的行走能力?深度退化时方法还可不可用?CAP 两道都过,在两个锚点上都拿到最好的平均成功率与平均回报。
| 方法 | Clean 楼梯 | Clean 平台 | Clean 沟 | Clean 栏 | Clean 平均成功率 | Clean 平均回报 | Noisy 平均成功率 | Noisy 平均回报 |
|---|---|---|---|---|---|---|---|---|
| Hiking(无重建的感知基线) | 92.3 | 93.7 | 96.3 | 83.0 | 91.3 | 38.3 | 47.6 | 22.7 |
| PIE(高度图重建基线) | 98.7 | 95.8 | 99.8 | 97.4 | 97.9 | 38.8 | 88.4 | 35.2 |
| Binary-switch(硬切换) | 94.4 | 96.1 | 91.0 | 92.7 | 93.6 | 38.5 | 20.1 | 14.5 |
| CAP 去掉噪声课程 | 98.9 | 99.6 | 100.0 | 99.8 | 99.6 | 41.7 | 89.2 | 37.3 |
| CAP 去掉 VAE 编码器 | 95.7 | 99.6 | 99.9 | 93.4 | 97.1 | 40.4 | 94.3 | 39.3 |
| CAP 去掉 MoE | 87.3 | 98.0 | 100.0 | 99.0 | 96.1 | 39.7 | 91.2 | 38.5 |
| CAP(完整) | 99.3 | 99.9 | 100.0 | 99.4 | 99.6 | 41.7 | 97.9 | 40.6 |
几个数字值得单看。Hiking 在 Noisy 档的沟地形只剩 1.7%,整体平均成功率 47.6%,尽管它训练时用了同一套深度噪声课程——说明只有课程、没有去噪重建目标,鲁棒性建不起来。PIE 是最强的非世界模型感知基线,Noisy 档仍有 88.4%,但比 CAP 低 9.5 个百分点。Binary-switch 在 Noisy 档只剩 20.1%,而且平台、沟、栏三类地形全部归零,只有楼梯保留 80.6%——因为楼梯是唯一光靠本体感受也能推进的地形。
消融把三个组件的分工分开了。去掉 MoE 在两个锚点都掉分,Clean 档楼梯从 99.3% 掉到 87.3%,是最大的单项损失。去掉噪声课程在 Clean 档完全无损(同样 99.6%),但 Noisy 档从 97.9% 掉到 89.2%,说明脏深度鲁棒性确实来自这条课程。去掉 VAE 编码器在两个锚点都掉,尤其楼梯与栏,Noisy 档 94.3%——这反驳了「VAE 只是视觉失效时的备用通道」的解读,它实际是与低频 WM 互补的高频共活流。
2. 感知质量扫描:把渐变退化变成渐变降级
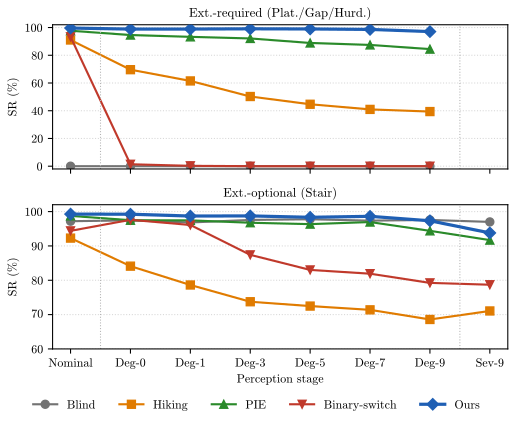
图 3(论文 Figure 3):八档感知质量扫描下的渐进退化。上图为必须依赖外部感知的地形(平台/沟/栏)平均成功率,下图为外部感知可选的楼梯成功率。CAP 在 Degraded 全段平滑下降,Binary-switch 在门控选中盲走分支时出现断崖。
扫描覆盖从标称深度到严重失效的八档,严重端只在楼梯上测。在必须依赖外部感知的地形上,盲走基线始终贴着本体感受地板;CAP 在整个 Degraded 段平滑退化,Hiking 因为没有重建目标而持续掉分,PIE 靠重建正则掉得温和些,Binary-switch 则在门控翻向盲走分支时出现断崖式跌落。在外部感知可选的楼梯上,理想行为是随外部信号变得无信息而逐渐逼近盲走参考线:CAP 在 Degraded 全段和 Severe 尾段都贴近这条参考线,而 Binary-switch 即使在 Severe 失效下仍低于盲走参考——这说明当盲走本身可行时,硬分支选择依然是脆的。作者把这条曲线形状当作「渐进降级」的核心行为证据:跨感知谱的平滑性并不是感知策略的通用属性,而是 CAP 连续融合换来的。
为了排除「Binary-switch 只是没调好」的解释,附录 B.3 又训了一个匹配版本:同样的策略与世界模型骨干、匹配的训练容量、同样的深度噪声课程,奖励/地形/训练预算全部固定。切换阈值在验证集上从网格 $\{0.25,0.5,0.75,1,1.25,1.5,2,4,8,16\}\beta_0$ 中用三个验证种子在 Nominal、Deg-3、Deg-9 三档选出,选定后固定,再在独立种子上测试。
| 方法(成功率 %) | Nominal | 低污染 [0,3] | 高污染 [7,9] | 完全遮挡(仅楼梯) |
|---|---|---|---|---|
| Binary-switch(匹配容量与课程) | 97.96 | 91.90 | 86.27 | 84.96 |
| CAP | 99.40 | 98.68 | 97.59 | 93.78 |
验证集选出的是网格里最大的阈值 $16\beta_0$;固定之后,本体感受分支的平均占空比在每个测试档位都低于 1%。CAP 在四种条件下全部更高。作者由此给出的解释是:污染感知训练降低了对硬交接的需求,感知分支学会了在退化深度下工作,所以部分污染并不必然让它的特征不可用;反过来,切走就等于丢掉有用的地形信息。
3. 真机实验:G1 零微调部署
策略直接从仿真搬到 Unitree G1,没有任何真实世界微调,只控制下半身 12 个关节(每侧髋 pitch/roll/yaw、膝、踝 pitch、踝 roll),腰与手臂关节保持固定位置目标。底层走 Unitree 的 DDS 命令/状态通道:500Hz 控制环发布最新 PD 关节目标,学习策略以 50Hz 更新下半身目标。深度通路刻意保持预处理简单——D435i 以 480×270 读取,经裁剪到训练深度范围、缩放/裁到网络输入尺寸、归一化,得到 48×64 的深度张量;不加重建、不做补洞、不做时域去噪,干净/遮挡/闪光污染三种片段用的是同一套轻量几何预处理,剩余的真实传感器伪影交给训练好的 WM–策略系统处理。
实时性靠把低频 WM 更新与高频策略图分开:WM 环 10Hz,吃本体感受、最新深度帧和近期动作来更新循环潜变量,每步后把确定性潜变量拷进线程安全的共享缓冲;50Hz 策略环并行读取最新可用的 WM 潜变量与当前本体感受历史。两个模型都导出成 ONNX 图由 ONNX Runtime 执行,预分配输入缓冲加短的非嵌套锁,把策略侧更新延迟压到约 2ms。
| 感知条件(每格 $n=5$ 次试验) | 楼梯 | 平台 | 沟 | 混合 | 合计 |
|---|---|---|---|---|---|
| Clean | 5/5 | 5/5 | 5/5 | 5/5 | 20/20 |
| 部分遮挡 | 5/5 | 4/5 | 5/5 | 5/5 | 19/20 |
| 完全遮挡 | 5/5 | 0/5 | 0/5 | 0/5 | 5/20 |
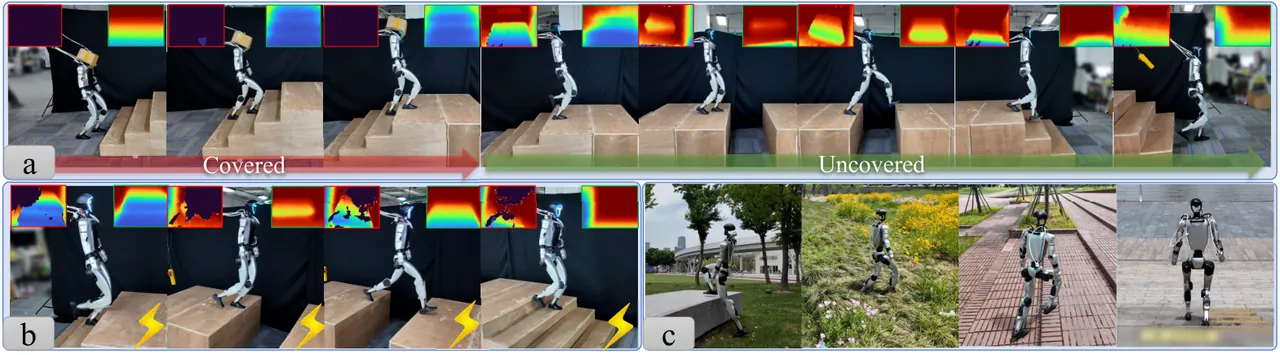
图 4(论文 Figure 4):CAP 在 G1 上的真实部署。(a) 混合地形遮挡—解遮挡;(b) 闪光导致的深度污染;(c) 平台、草地、楼梯的室外场景。小图为同步的原始深度输入(左,红)与世界模型重建(右,绿)。
Clean 与部分遮挡两档合计 39/40 成功,唯一失败在平台地形。完全遮挡档楼梯 5/5 全过,平台、沟、混合各 0/5——完全遮住相机就去掉了预判平台边缘与沟宽所需的视觉线索,仅靠本体感受不足以在测试条件下通过这些障碍。这个结果与仿真扫描里「楼梯是外部感知可选地形」的划分一致,也是作者承认的能力边界。
图 4(a) 是最关键的过渡案例:在同一段混合地形里,机器人在相机被遮住的状态下爬上楼梯,随后感知恢复,继续通过沟与下楼梯。这一串动作测的是「短暂外部感知丢失再重新获取」过程中的连续性。去噪能力则由图 1(b) 展示:污染但仍有信息量的原始深度,配上保留了可通行结构的 WM 重建;表 2 的部分遮挡行是它受控的定量对应。
除物理遮挡外,图 4(b,c) 还测了真实传感器伪影与室外部署:闪光污染在原始深度里造成大片无效区域,而 WM 重建保住了主要的可通行结构;室外平台、草地、楼梯把策略暴露给植被引起的深度伪影,这类伪影超出仿真器的噪声通道。
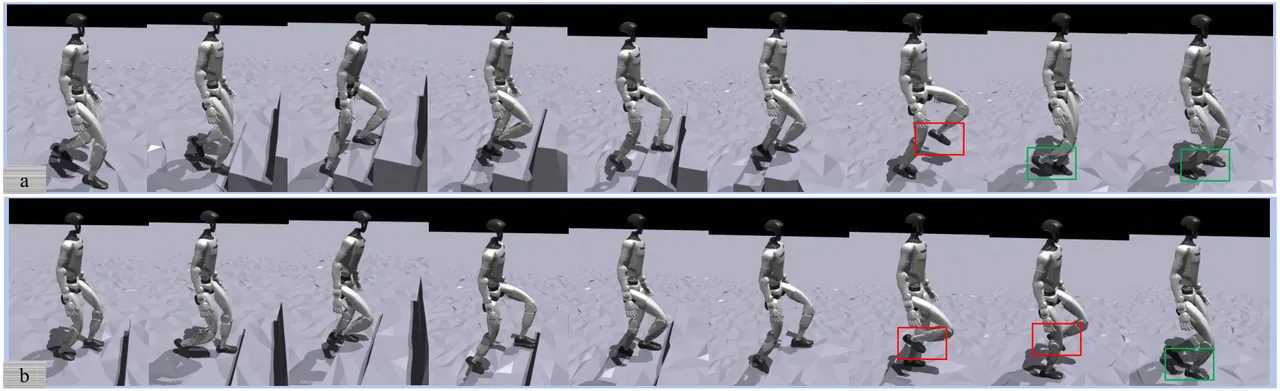
图 5(论文 Figure A1):完全遮挡下的楼梯—平地恢复。同一段四级上行楼梯到平地的过渡,相机全程遮住,频闪式 rollout。红框标出机器人已经到平地后仍不必要的楼梯式高抬腿,绿框标出恢复到稳定平地步态。(a) 有 WM 特征 dropout 时,CAP 多抬一次就回到平地行走;(b) 没有 dropout 时,策略连续两步保持楼梯式高抬腿才恢复。
这个案例研究回答的是「特征 dropout 到底修了什么」。它在 Clean/Noisy 锚点上几乎无效,因为那两个锚点根本不暴露它针对的失效区。设置是:机器人在相机完全遮挡下爬四级上行楼梯,然后从最后一级踏上平地。此时深度不可用,WM 只能靠先验向前预测,而先验是按训练地形分布拟合的,于是继续「看见」并不存在的楼梯——这就是过冲区。有 dropout 时策略多迈一次高抬腿就切回平地步态,没有 dropout 时要多迈两次。差别只有一步,但它是定性的行为差异,而且作者只给了定性证据,没有量化指标。
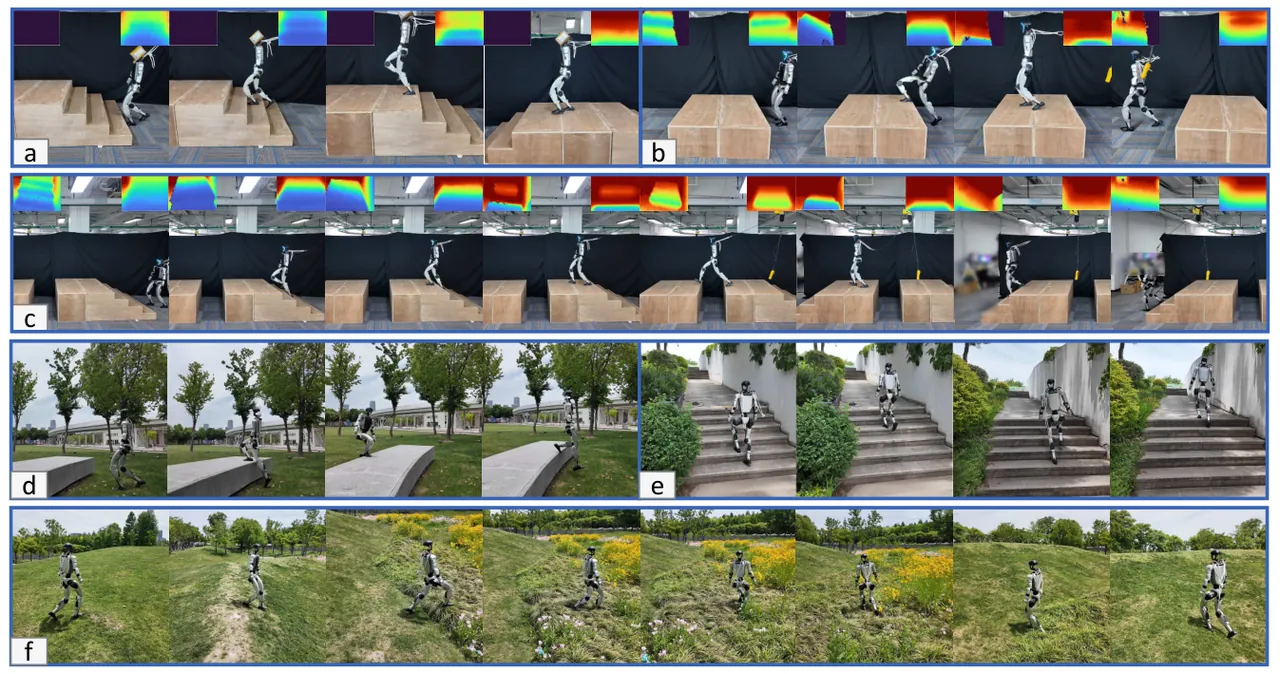
图 6(论文 Figure A2):图 4 之外的补充真机片段。室内面板为受控的楼梯、平台、混合地面试验并带同步原始深度小图;室外面板为平台边缘、室外楼梯与草地/植被场景的迁移,含深度伪影。
讨论:这项工作真正改变了什么
第一,它把「感知鲁棒」从门控问题重述为表征学习问题。切换式方法的隐含前提是「先判断感知可不可靠,再决定用不用」,而可靠度判断本身需要一个检测器,检测器又需要阈值,阈值在验证集上选(本文的 Binary-switch 从十个候选里选到了最大的 $16\beta_0$)。CAP 绕开了这一整条链:不判断可靠度,而是训练编码器把污染输入映射到能重建干净深度的潜空间,让「用不用」变成融合权重的连续结果。占空比低于 1% 这个数字很有说服力——它说明在有连续融合可用时,硬切换分支基本不会被选中。
第二,输入—目标解耦是这篇论文最值得复用的技巧。DreamerV3 的 RSSM 是现成的,MoE 是现成的,$\beta$-VAE 是现成的,深度噪声注入也不是新东西。真正的新意是让解码器的监督目标不再是编码器的输入:一个「旋转稳定的干净深度」。这一处改动同时买到了去噪映射和坐标系对齐两件事,而且没有引入任何新模块或新超参。对照 MGDP——它用对比 U-Net 从污染输入重建干净目标,思路同源,但只评了中等程度的像素级污染,且仍留在感知策略范式内,没有覆盖到完全失效端。
第三,它给「优雅退化」提供了可测量的定义。以往说一个策略鲁棒,通常是给一组污染下的成功率;本文把它变成一条跨八档感知质量的曲线,并区分了外部感知必需地形与可选地形两种期望行为:前者要平滑下降,后者要收敛到盲走参考线。这个评测口径本身比某个具体数字更有迁移价值。
局限与风险
作者在结论里明确承认的边界有三条。其一,CAP 尚未处理感知条件行走边界处的安全问题:大的分布外几何误差(例如显著的相机外参漂移)仍可能让去噪后的感知不可靠。其二,在必须依赖外部感知的地形上完全丢失感知时,降级到盲走必须配上从失败踏步或易摔姿态中恢复的能力,而这部分论文没有做。其三,未来方向被指向可靠度估计、风险感知动作选择与安全恢复——也就是说,当前系统不知道自己什么时候不该走。
除作者自陈之外,还有几处需要读者自行打折。真机定量结果每格只有 $n=5$ 次试验,「19/20」与「39/40」这种量级的差异在 5 次试验下没有统计意义,完全遮挡档的 0/5 也只能说明能力缺失、不能量化缺失程度。仿真评测固定使用单一 0.8 m/s 前进指令,且难度固定在 $d\in[0.8,1.0)$ 的高难档,所以表 1 的数字不能外推到变速或中低难度场景。Binary-switch 是作者自己在 CAP 框架内对二元切换范式的受控改写,而不是 RENet 的逐字复现(附录 B.2 已声明),所以「切换范式不如连续融合」这个结论的强度受实现选择影响。WM 过冲只有那一个定性案例支撑,缺量化指标。代码尚未释出,附录里的超参表是目前唯一的实现依据。
结论与展望
CAP 用三件东西组成一个单阶段策略:一个被训练成去噪器的世界模型编码器(输入污染深度、重建旋转稳定的干净深度)、一个控制频率上共活的本体感受变分编码器,以及输入侧噪声课程加潜变量侧特征 dropout 的耦合退化训练。仿真与 Unitree G1 实验共同说明,这套设计把部分感知失效转化为同一策略内的渐进降级,而不是感知到盲走的离散交接。
对具身智能这条线来说,它的价值在于给出了一个可操作的替代方案:当你发现系统在传感器退化时崩掉,第一反应不该是加一个可靠度检测器再切换分支,而是检查感知编码器的重建目标——如果它重建的是自己的输入,那它就没有任何动机去恢复被污染的信息。把目标换成干净参考,去噪能力是免费得到的副产品。剩下的工程难点从「怎么判断感知坏没坏」转移到「怎么定义那个干净参考」,后者在深度相机场景里恰好是可以从仿真真值渲染出来的。