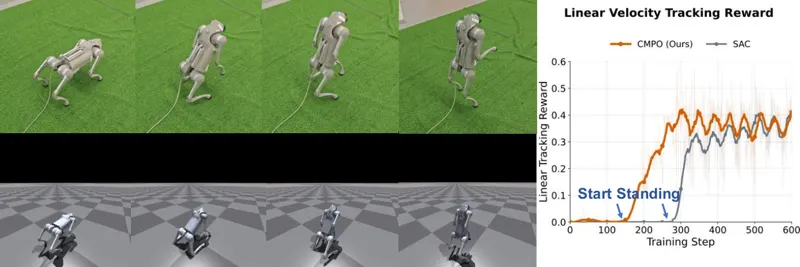
分块式基于模型的策略优化CMPO 将策略与世界模型的时间粒度统一为动作块和潜状态块,使多步想象轨迹只需一次前向计算即可完成,同时保留可微价值展开与闭环控制。方法在 HumanoidBench 的 19 个高维人形任务上验证训练效率和梯度稳定性,并在 Unitree Go2 双足站立任务上完成仿真到实机部署。Weixi Song, Donglin Wang, Yong-Lu Li · 59次阅读 · 2026年10月10日人形机器人Model-Based RL2026年10月10日
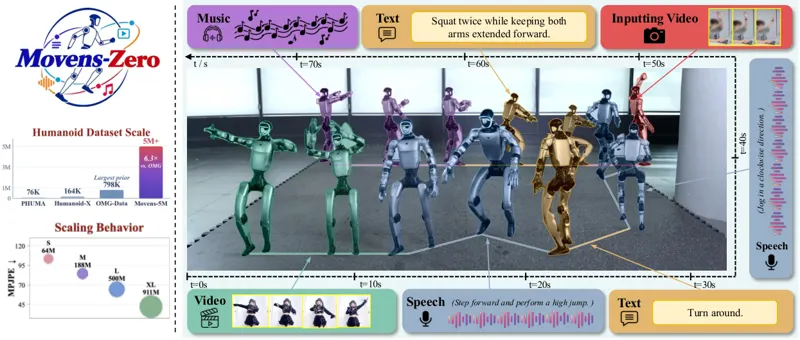
Movens-Zero:用大规模人类视频扩展人形动作基础模型Movens-Zero 从互联网人类视频构建五百万条可执行人形动作,统一文本、视频、语音与音乐条件,并以实时分块闭环驱动 Unitree G1。Wendong Bu, Tinghong Ye, Qizhou Wang · 66次阅读 · 2026年10月30日人形机器人Humanoid Motion Foundation Model2026年10月30日
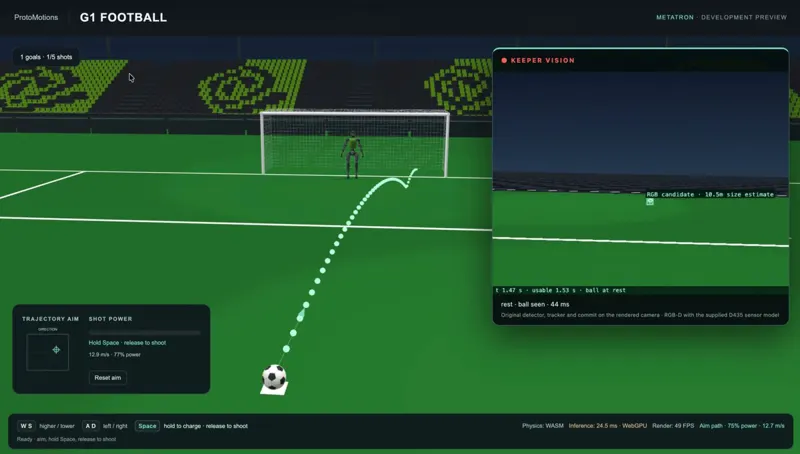
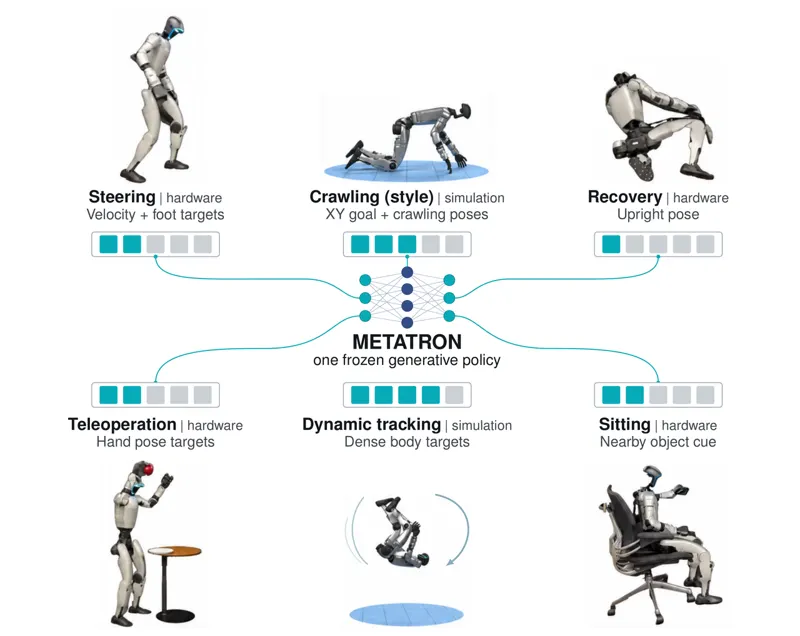
METATRON:面向人形机器人的可提示全身执行层METATRON 将生成式全身策略与可编程技能层结合,用稀疏身体目标、速度、风格和场景提示驱动单一冻结的 Unitree G1 策略,无需任务级重训。Chen Tessler, Yifeng Jiang, Alec Otto · 316次阅读 · 2026年10月27日人形机器人全身控制2026年10月27日

 0:28