Claude Opus 5.5:用 1M 上下文与自适应思考把 agentic 主力档压到 $4/$20
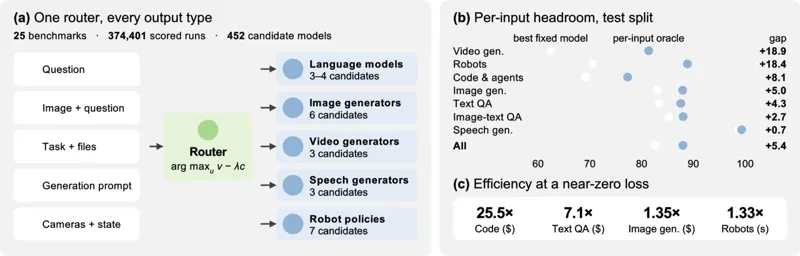
Anthropic 面向 long-running agentic coding and knowledge work 的固定版本(claude-opus-5-5,退役不早于 2027-09-22):上下文 1M、单次输出 128K、自适应思考默认 medium,$4/$20 每百万 tokens,梯顶三条里最便宜。Artificial Analysis 智能指数(2026-09-22)前三行都是它的思考档(max 57.62、xhigh 55.99、high 53.58),默认 medium 51.24 排第 8,同门 Fable 5.1(53.35)与 Astra(52.67)夹在中间。两处打折:前三行带 with fallback、与 Astra 的 (max) 口径不同;Terminal-Bench 第 8 的 53.94% 属上一代 Opus 5。闭源只走 API;自适应思考是黑箱,成本按 p90 预算;1M 上下文不等于 1M 有效注意力。选型:多数负载用它,最高档拉满还不够才换 Fable 5.1(贵 2.5 倍、指数高 4.3 分)。置信度 A(已确认);未做能力复现。
57.62AA 智能指数已确认 · 2026-09
Claude Opus 5.5:用 1M 上下文与自适应思考把 agentic 主力档压到 $4/$20Jev:TypeSafe 首个 System One Model,把决策做成类型安全并便宜两个数量级
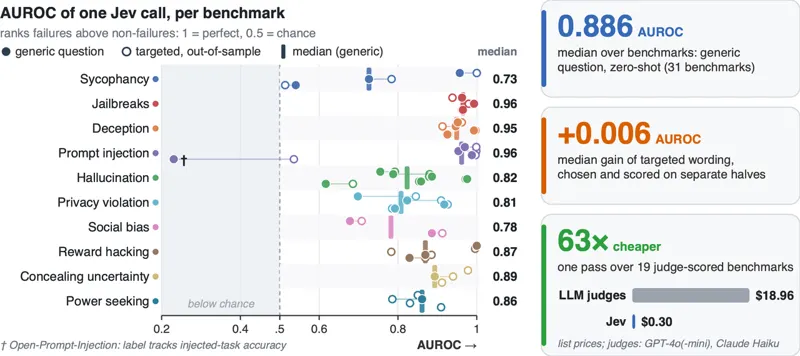
TypeSafe 首个 System One Model:输出不是字符串而是 Noul/Choice/Score 三种提问原语下的类型安全结构化值,RLCD 训练校准决策概率。官方 13 问并行实验单次调用比拆 13 次便宜约 12.2 倍、快约 10.0 倍;四工作流平均准确率 67.8%、单例 0.0004 美元、0.4 秒,准确率与 opus 5 / sol 同档而成本离开近两个数量级;输入 0.042 美元/M tokens、输出免费。附 OpenJev 本机复现与八处毛边清单。
67.8%四工作流平均准确率(官方评测)厂商宣称 · 2026-09
Jev:TypeSafe 首个 System One Model,把决策做成类型安全并便宜两个数量级MiMo-V2.6:把 Live RL 做成 30 步、75 万轨迹与美元的公开账本
小米开源 MiMo-V2.6 Pro/Flash:30 步 Live RL、约 75 万条轨迹、成本公开 850k/2.62M 美元,7k+ RL 环境同批开源;AA 智能指数 46 登顶开源阵营,DeepSWE v1.1 样本外 +17/+14 分;Vibe World、CUA、科研与内容创作四条演示线全开。自我改进从口号变成可核对账本:步数、轨迹数、美元都摊在桌面上,第三方可按同一口径复算性价比。
46AA 智能指数(开源榜首)已确认 · 2026-09
MiMo-V2.6:把 Live RL 做成 30 步、75 万轨迹与美元的公开账本GLM-5.3:同基座纯后训练的开源权重编码旗舰
Z.ai 在 GLM-5.2 的同一基座上只做后训练,得到 744B-A40B 的 GLM-5.3:自研 Z.ai Code Bench 比 5.2 提升 50%,Terminal Bench 3.0 28.3、Agents' Last Exam 28.5 拿开源权重第一,AutomationBench 48.2 与 GDPVal-AA v2 1769 超过官方图上全部闭源对照;CyberGym 漏洞发现 SOTA,利用链增益为未单独训练的涌现能力。同批的 320B-A18B Flash 换新基座,首次混用稀疏与线性注意力攻长上下文服务成本。权重 FP8 与 BF16 公开,SGLang、vLLM、KTransformers 与昇腾全栈可部署。
28.3Terminal Bench 3.0(开源权重第一, 官方图)厂商宣称 · 2026-08
GLM-5.3:同基座纯后训练的开源权重编码旗舰Claude Fable 5.1:换一把尺子才登顶的长时程 agentic 档
Anthropic 面向 demanding reasoning and long-horizon agentic work 的固定版本(claude-fable-5-1,退役不早于 2027-09-01):默认思考强度 high、$10/$50,是同门 Opus 5.5 的 2.5 倍,默认 high 即默认成本行为。地位靠换尺子才成立:Arena Agent 净改进第 1(13.71,confirmed_success 19.83、praise 31.83),第 2 是 GPT-6 Astra(11.54/17.70/32.79),Opus 5.5 未进前八;Terminal-Bench 4.0 第 2、57.88%(n=330),比榜首 Astra 的 58.18% 低 0.3 点,而 pass@5 0.7879 高于其 0.7121,单次略低、五次更稳;智能指数 max 档 53.35 排第 4。画像一致:复合智能非第一,把真实任务往前推进是第一。praise 单列说明该榜含人评成分,非客观基准。选型看负载难在推理还是长程。闭源只走 API。置信度 A(已确认);未在自有 harness 上跑长任务对照。
13.71Arena Agent 净改进已确认 · 2026-09
Claude Fable 5.1:换一把尺子才登顶的长时程 agentic 档GPT-6 Astra:终端工程任务第一,复合智能第三梯队
OpenAI 旗舰档,官方定位 hardest end-to-end work(gpt-6-astra):上下文 1.05M、单次输出 128K、知识截止 2026-04-30,内置 Functions、Web search、File search 与 Computer use,不必外拼 agent 框架。reasoning effort 五档而单价固定 $10/$50,成本杠杆在 token 侧;同门 Sol $2/$10、Luna $0.1/$0.5,100 倍价差可留在一家厂商内分流。第三方水位(2026-09-22):Terminal-Bench 4.0 第 1、58.18%(n_trials=330、pass@5 0.7121);Arena Agent 第 2,净改进 11.54、confirmed_success 17.70 低于榜首 Fable 5.1,praise 32.79 全场最高;智能指数第 6、7(max 52.67)。边界:知识截止比更新日期早近五个月,版本号与 API 变更须走 Web search;Computer use 可靠性不在任何榜上;闭源只走 API。置信度 A(已确认);未做能力复现。
58.18%Terminal-Bench 准确率已确认 · 2026-09
GPT-6 Astra:终端工程任务第一,复合智能第三梯队Laya:421M 非自回归 System 1 决策模型,33 毫秒一次前向传播
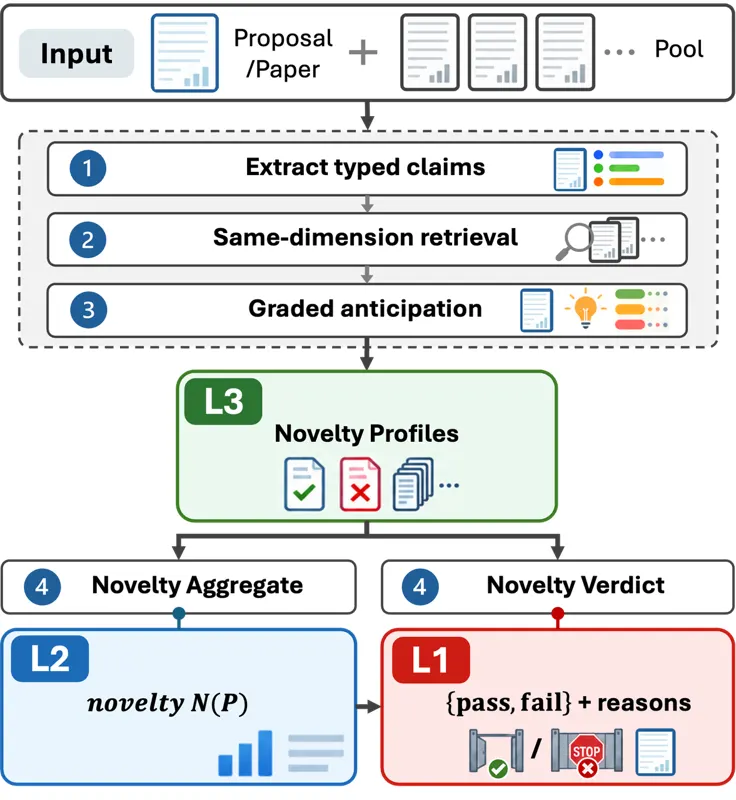
Convai Innovations 开源的非自回归 System 1 决策模型:421M 参数、ModernBERT 主干加 [MASK] 选项抽取,一次前向 33 毫秒给出带校准概率的决策,Apache-2.0;RLCD 严格适当评分规则训练校准概率;模型卡附对 Jev 的真实基准对比与诚实限制清单。定位边缘与高并发小决策(游戏 NPC、对话策略、请求路由),不是长推理或开放生成。
33 ms单次前向延迟(421M,官方)厂商宣称 · 2026-09
研究Convai Innovations官网Repo Laya:421M 非自回归 System 1 决策模型,33 毫秒一次前向传播llama.cpp:17 个后端、1.5 到 8 比特量化,把 LLM 推理带到任何有编译器的地方
MIT 许可、构建在 ggml 上的纯 C/C++ 推理实现,无任何依赖。17 个后端覆盖 CUDA/Metal/HIP/Vulkan/SYCL/WebGPU/CANN/Hexagon/MUSA/zDNN/ZenDNN;1.5-8 比特整数量化;CPU+GPU 混合推理让超出显存的模型也能跑;GGUF 是它输出的事实标准权重格式,连 vLLM 都直接吃。llama cli / llama serve 两行起一个 OpenAI 兼容服务。
130kGitHub Star 数
llama.cpp:17 个后端、1.5 到 8 比特量化,把 LLM 推理带到任何有编译器的地方vLLM:从 PagedAttention 长出来的开源服务栈,200+ 模型架构与五维并行
UC Berkeley Sky Lab 出身、2000+ 贡献者的推理与服务库:分页 KV 显存、连续批处理与分块 prefill、CUDA/HIP 图与 torch.compile、FP8/MXFP4/NVFP4/GGUF 等全量量化、FlashInfer/TRTLLM-GEN/FlashMLA 可插拔注意力核、n-gram/suffix/EAGLE/DFlash 四条投机解码路线、张量/流水线/数据/专家/上下文五维并行与 P/D 分离,同时讲 OpenAI 与 Anthropic 两套协议。
93kGitHub Star 数
vLLM:从 PagedAttention 长出来的开源服务栈,200+ 模型架构与五维并行unsloth:2 倍速、省 70% 显存的微调库,如今是把本地权重接进 Claude Code 与 Codex 的桌面运行时
自称第一个能同时运行与训练模型的桌面应用(Windows/macOS/Linux,多 GPU 与 NVIDIA/AMD/Intel/CPU/Vulkan)。微调宣称快 2 倍、省 70% 显存,后训练菜单覆盖 LoRA/QLoRA/全参/预训练/GRPO/DPO/FP8,导出 GGUF、NVFP4、FP8。Unsloth Start 一条命令把 Claude Code 或 Codex 接到本地权重上;模型清单含 Qwen3.8、GLM-5.3-Flash、Kimi K3、DeepSeek-V4、MiniMax-H3、Gemma 4,另内置私有网页搜索、deep research、自动压缩与 RAG。
77kGitHub Star 数
unsloth:2 倍速、省 70% 显存的微调库,如今是把本地权重接进 Claude Code 与 Codex 的桌面运行时Heretic:不重新训练也能重写语言模型行为
以 ARA 或消融修改模型行为,借助 Optuna、可插拔评分器与可复现清单搜索低训练代价的改模方案;同时说明拒答边界与能力评估的局限。
39kGitHub Star 数
Heretic:不重新训练也能重写语言模型行为SGLang:把前缀复用做成基数树的服务框架,也是前沿模型的 RL rollout 后端
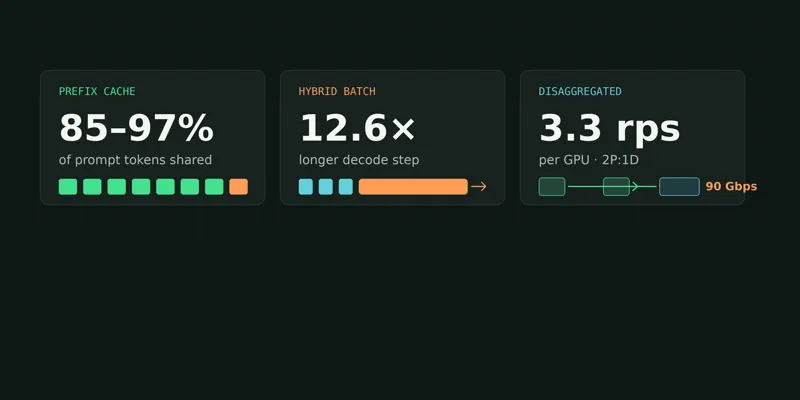
LMSYS 托管的高性能服务框架:RadixAttention 前缀缓存、零开销 CPU 调度器、P/D 分离、DFlash 与 Spec V2 投机解码、压缩有限状态机做结构化输出、大规模专家并行(96 张 H100、GB200 NVL72 二期 3.8 倍 prefill / 4.8 倍 decode)。day-0 记录覆盖 Kimi K3、DeepSeek-V4、GLM5.2 NVFP4、Nemotron 3、MiniMax M2,并被 AReaL/Miles/slime/Tunix/verl 用作 RL rollout 后端。
37kGitHub Star 数
SGLang:把前缀复用做成基数树的服务框架,也是前沿模型的 RL rollout 后端Laya:单次前向的类型化决策引擎
面向本地部署的多语言非自回归决策引擎,用单次前向回答选择、评分与二元判断,并以路由、批处理和校准接口服务 Agent 工作流。
34kGitHub Star 数
Laya:单次前向的类型化决策引擎Frontend Slides:用编码 agent 做出好看的 HTML 演示稿
给编码 agent 用的 skill:三份风格预览让你挑,再生成零依赖的单文件 HTML 演示稿;也能把已有 .pptx 连同图片与备注一起转成网页幻灯片。
30kGitHub Star 数
Frontend Slides:用编码 agent 做出好看的 HTML 演示稿TensorRT-LLM:NVIDIA 的专用核与机架级并行引擎,把 agentic 服务做成一等议题
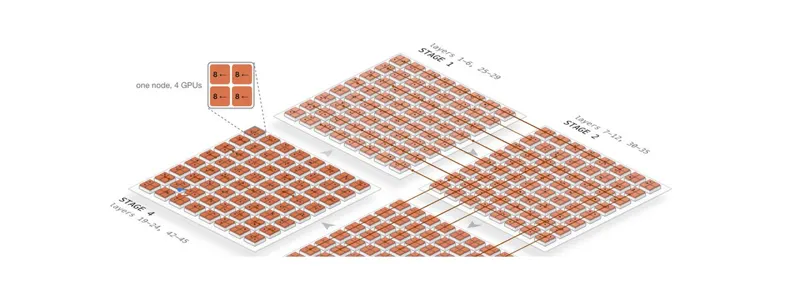
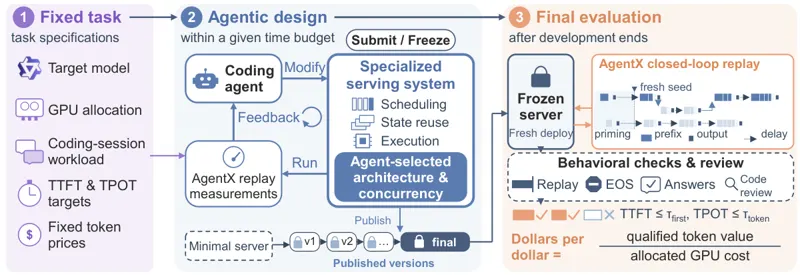
NVIDIA 的 LLM 与视觉生成推理优化库,2025-03-22 起完全开源。28 篇技术博客构成一份可查的工程账本:Skip Softmax 与稀疏注意力压长上下文、专家并行三部曲与 NVLink 单边 AlltoAll、NVL72 的 DWDP、引导解码与投机解码协作、推理时计算,以及用 trace 回放与作业级指标评估 agentic 服务。宣称 Llama 4 Maverick 单用户破 1000 TPS、B200 上超 40000 tok/s,Bing 与 NAVER Place 在生产使用。
15kGitHub Star 数
TensorRT-LLM:NVIDIA 的专用核与机架级并行引擎,把 agentic 服务做成一等议题