Claude Opus 5.5:用 1M 上下文与自适应思考把 agentic 主力档压到 $4/$20
Anthropic 面向 long-running agentic coding and knowledge work 的固定版本(claude-opus-5-5,退役不早于 2027-09-22):上下文 1M、单次输出 128K、自适应思考默认 medium,$4/$20 每百万 tokens,梯顶三条里最便宜。Artificial Analysis 智能指数(2026-09-22)前三行都是它的思考档(max 57.62、xhigh 55.99、high 53.58),默认 medium 51.24 排第 8,同门 Fable 5.1(53.35)与 Astra(52.67)夹在中间。两处打折:前三行带 with fallback、与 Astra 的 (max) 口径不同;Terminal-Bench 第 8 的 53.94% 属上一代 Opus 5。闭源只走 API;自适应思考是黑箱,成本按 p90 预算;1M 上下文不等于 1M 有效注意力。选型:多数负载用它,最高档拉满还不够才换 Fable 5.1(贵 2.5 倍、指数高 4.3 分)。置信度 A(已确认);未做能力复现。
57.62AA 智能指数已确认 · 2026-09
Claude Opus 5.5:用 1M 上下文与自适应思考把 agentic 主力档压到 $4/$20Claude Fable 5.1:换一把尺子才登顶的长时程 agentic 档
Anthropic 面向 demanding reasoning and long-horizon agentic work 的固定版本(claude-fable-5-1,退役不早于 2027-09-01):默认思考强度 high、$10/$50,是同门 Opus 5.5 的 2.5 倍,默认 high 即默认成本行为。地位靠换尺子才成立:Arena Agent 净改进第 1(13.71,confirmed_success 19.83、praise 31.83),第 2 是 GPT-6 Astra(11.54/17.70/32.79),Opus 5.5 未进前八;Terminal-Bench 4.0 第 2、57.88%(n=330),比榜首 Astra 的 58.18% 低 0.3 点,而 pass@5 0.7879 高于其 0.7121,单次略低、五次更稳;智能指数 max 档 53.35 排第 4。画像一致:复合智能非第一,把真实任务往前推进是第一。praise 单列说明该榜含人评成分,非客观基准。选型看负载难在推理还是长程。闭源只走 API。置信度 A(已确认);未在自有 harness 上跑长任务对照。
13.71Arena Agent 净改进已确认 · 2026-09
Claude Fable 5.1:换一把尺子才登顶的长时程 agentic 档GPT-6 Astra:终端工程任务第一,复合智能第三梯队
OpenAI 旗舰档,官方定位 hardest end-to-end work(gpt-6-astra):上下文 1.05M、单次输出 128K、知识截止 2026-04-30,内置 Functions、Web search、File search 与 Computer use,不必外拼 agent 框架。reasoning effort 五档而单价固定 $10/$50,成本杠杆在 token 侧;同门 Sol $2/$10、Luna $0.1/$0.5,100 倍价差可留在一家厂商内分流。第三方水位(2026-09-22):Terminal-Bench 4.0 第 1、58.18%(n_trials=330、pass@5 0.7121);Arena Agent 第 2,净改进 11.54、confirmed_success 17.70 低于榜首 Fable 5.1,praise 32.79 全场最高;智能指数第 6、7(max 52.67)。边界:知识截止比更新日期早近五个月,版本号与 API 变更须走 Web search;Computer use 可靠性不在任何榜上;闭源只走 API。置信度 A(已确认);未做能力复现。
58.18%Terminal-Bench 准确率已确认 · 2026-09
GPT-6 Astra:终端工程任务第一,复合智能第三梯队Jev:TypeSafe 首个 System One Model,把决策做成类型安全并便宜两个数量级
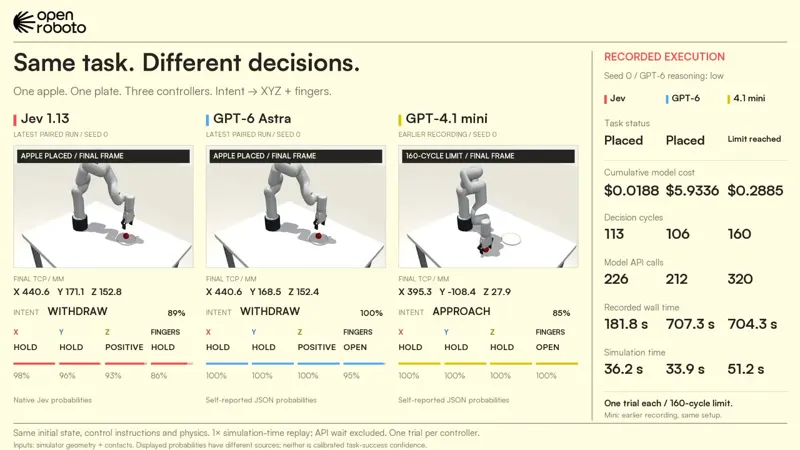
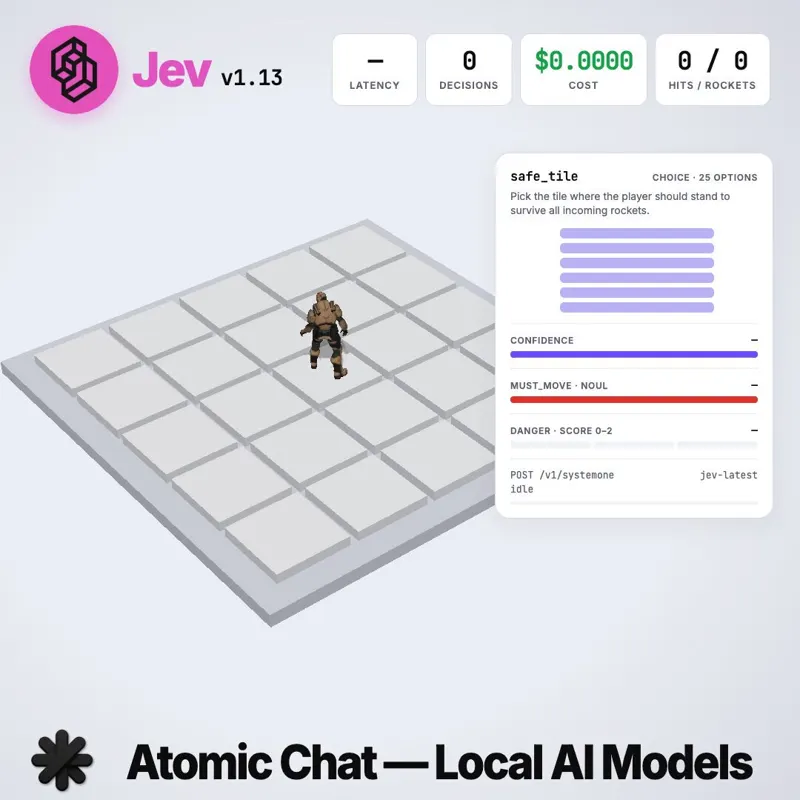
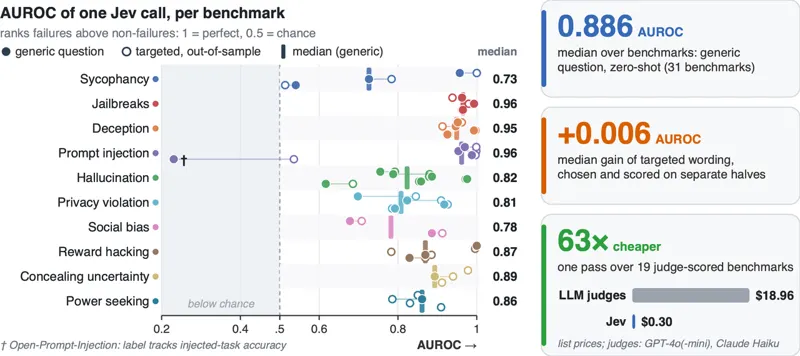
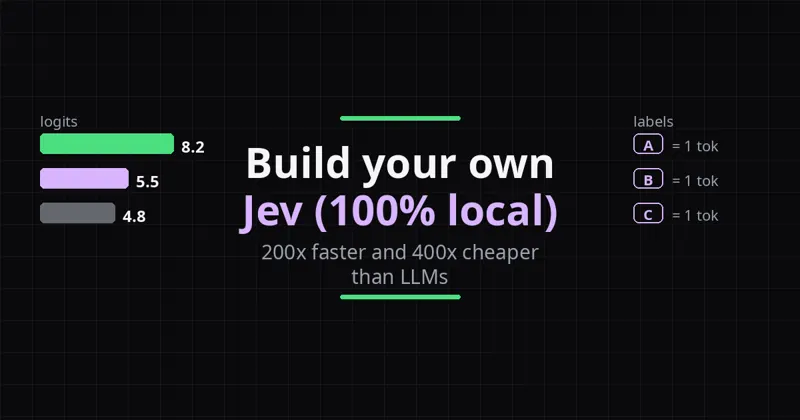
TypeSafe 首个 System One Model:输出不是字符串而是 Noul/Choice/Score 三种提问原语下的类型安全结构化值,RLCD 训练校准决策概率。官方 13 问并行实验单次调用比拆 13 次便宜约 12.2 倍、快约 10.0 倍;四工作流平均准确率 67.8%、单例 0.0004 美元、0.4 秒,准确率与 opus 5 / sol 同档而成本离开近两个数量级;输入 0.042 美元/M tokens、输出免费。附 OpenJev 本机复现与八处毛边清单。
67.8%四工作流平均准确率(官方评测)厂商宣称 · 2026-09
Jev:TypeSafe 首个 System One Model,把决策做成类型安全并便宜两个数量级MiMo-V2.6:把 Live RL 做成 30 步、75 万轨迹与美元的公开账本
小米开源 MiMo-V2.6 Pro/Flash:30 步 Live RL、约 75 万条轨迹、成本公开 850k/2.62M 美元,7k+ RL 环境同批开源;AA 智能指数 46 登顶开源阵营,DeepSWE v1.1 样本外 +17/+14 分;Vibe World、CUA、科研与内容创作四条演示线全开。自我改进从口号变成可核对账本:步数、轨迹数、美元都摊在桌面上,第三方可按同一口径复算性价比。
46AA 智能指数(开源榜首)已确认 · 2026-09
MiMo-V2.6:把 Live RL 做成 30 步、75 万轨迹与美元的公开账本Laya:421M 非自回归 System 1 决策模型,33 毫秒一次前向传播
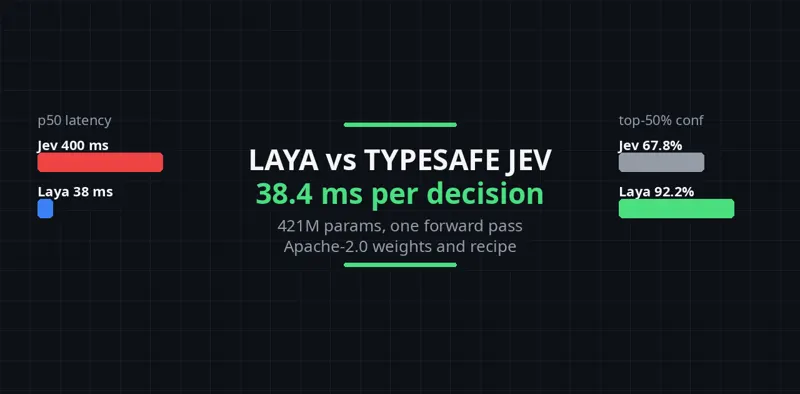
Convai Innovations 开源的非自回归 System 1 决策模型:421M 参数、ModernBERT 主干加 [MASK] 选项抽取,一次前向 33 毫秒给出带校准概率的决策,Apache-2.0;RLCD 严格适当评分规则训练校准概率;模型卡附对 Jev 的真实基准对比与诚实限制清单。定位边缘与高并发小决策(游戏 NPC、对话策略、请求路由),不是长推理或开放生成。
33 ms单次前向延迟(421M,官方)厂商宣称 · 2026-09
研究Convai Innovations官网Repo Laya:421M 非自回归 System 1 决策模型,33 毫秒一次前向传播OpenResearch:把编码智能体变成研究智能体的本地优先实验工作台
OpenResearch(orx)是 alphaXiv 开源的本地优先研究工作台:单个 Rust 二进制把 Claude Code、Codex、OpenCode、Cursor 与 Google Antigravity 变成能查文献、提假设、跑实验、沉淀产物的研究智能体。它以 git 实验树与固定运行契约为骨架,用修复/补位/晋升/停止四步自动研究循环驱动实验,运行日志与运行清单是唯一证据。本文基于 v0.2.13 源码精读与内置 nanochat 演示实测撰写。
6.2kGitHub Star 数
OpenResearch:把编码智能体变成研究智能体的本地优先实验工作台