
OPEN SOURCE DEEP DIVE
VISTA:让多模态模型直接看像素玩通 ARC-AGI-3 的视觉框架
MIT 的 VISTA 只给通用多模态模型三样东西:原始 PNG 观测、自由语言推理、无损保存全部环境帧的视觉记忆,然后让它去玩 ARC-AGI-3。以 Claude Opus 5.0 为后端时 25 个公开游戏、183 关全部通关,RHAE 满分 100,动作数比首次人类玩家少 56%;换成 GPT-5.6 Sol 也有 98.27 分——全程不做程序合成。
把多模态模型直接放进陌生世界
VISTA(VISTA: A Visual Harness for Reasoning in an Interactive World)来自麻省理工学院,作者为 Qiushi Han、Keya Hu、Linlu Qiu(三人共同主导)与 Cathy Wu、Kaiming He,博客发布于 2026 年 8 月 5 日,代码以 MIT 许可证开源。它要回答的问题很直接:一个通用多模态模型,只靠"看"和"想",能在一个完全陌生的交互世界里走多远?
它的做法是把三样东西交给模型,其余一概不给:环境的原始 PNG 观测、自由形式的语言推理空间、以及一份无损保存全部历史帧的视觉记忆。没有编译成代码的世界模型,没有任务定制的规划器,没有微调。在 ARC-AGI-3 的 25 个公开游戏(共 183 关)上,以 Claude Opus 5.0 为后端时 VISTA 全部通关,胜率 100%,Relative Human Action Efficiency(RHAE)满分 100,且只用了首次人类玩家 56% 的动作数;换成 Codex CLI 上的 GPT-5.6 Sol,平均分 98.27,同样 25 个游戏全部通关。
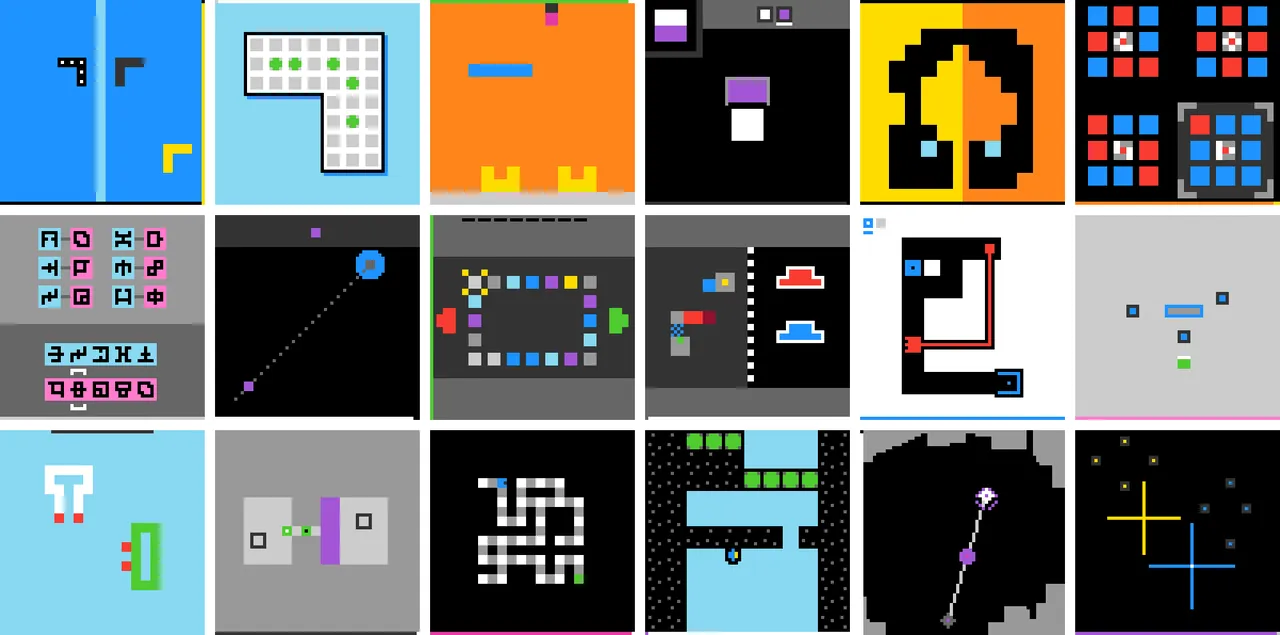
ARC-AGI-3 考的是什么
ARC-AGI-1 与 ARC-AGI-2 是静态的输入输出变换:给网格、给示例、推规则。ARC-AGI-3 换成交互式视觉游戏:开局没有说明、没有规则、没有目标,智能体每一步只能看到当前状态与可用动作,靠动作的后果去反推世界如何运转。一个游戏由若干关卡组成,关卡共享底层机制但引入新物件、新布局或新约束,第三关悟出的规律必须能带进第七关。
评分同时看完成度与效率。RHAE 以首次人类玩家的动作数为基准:通关且动作数不超过人类基准得满分,通关但更费动作得部分分,没通关零分;后面的关卡权重更高,最终分数按游戏平均。只有环境动作计入总数,内部推理与只读查看免费——这正是 VISTA 设计所依赖的不对称。
设计一:感知就是原始像素
智能体直接读 2D PNG 图,中间不做任何符号化预处理。具体而言它收到一张 512×512 的当前渲染状态图:官方 64×64 帧经 8 倍最近邻放大,格与格之间画 1 像素网格线。模型从未被告知世界是 64×64 的网格,PNG 就是它拿到的全部。它还可以请求放大查看棋盘任意矩形区域,因此信息访问在原则上是完整的:没有东西被隐藏,只是还没被看。
保持感知原始的意义在于:模型必须动用自己的视觉先验,而作者确实观察到它会自发形成与发现视觉概念,而不是被喂一份物件清单。这套设计也不绑定 2D,后文会看到同一套 harness 跑在 3D 渲染上。
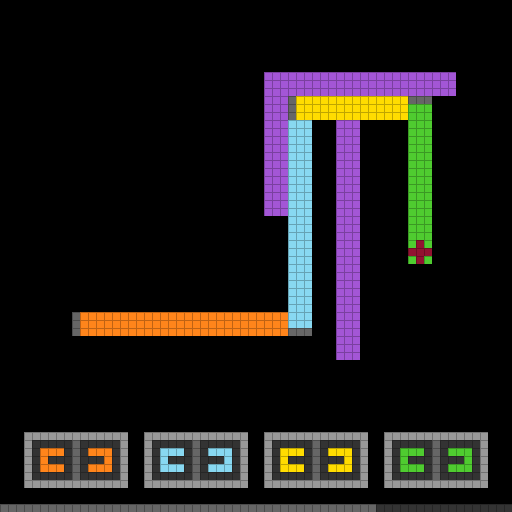
设计二:推理用自由语言
观测被自然语言转成假设:推理什么、用什么语言、想多久,全部由模型自己决定。它可以记笔记、随证据修正假设、再用假设指导下一步动作。刻意的对照组是程序化世界模型,也就是 ARC-AGI 排行榜上的主流做法:Schema、Tycho、Retrodict 等把探索轨迹蒸馏成可执行的游戏重建——状态表示、转移规则、目标条件,可以对着历史观测校验、可以搜索选动作。
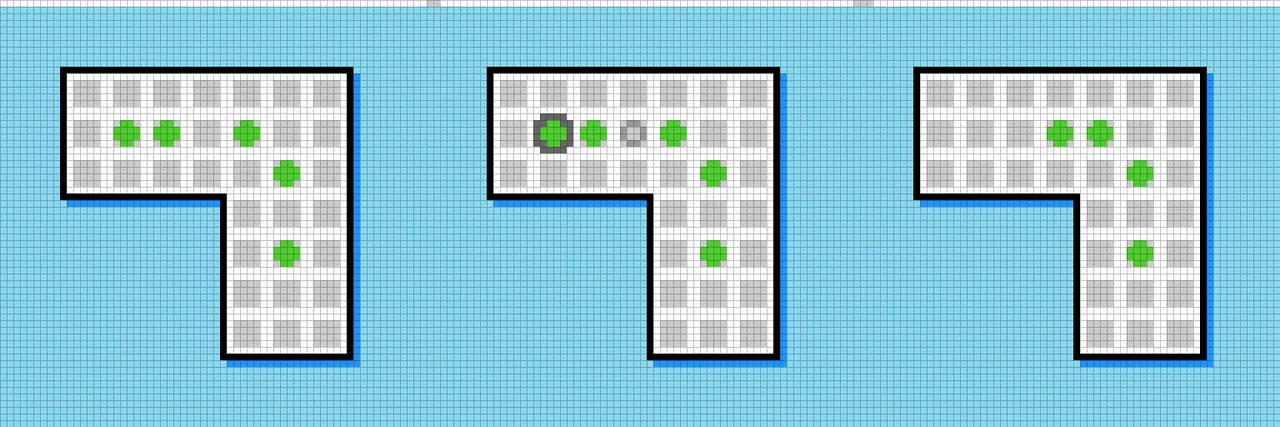
VISTA 的主张是:导向一个好动作的大部分推理并不需要可执行。博客用 LF52 的跳跃机制说明这一点。要为这条机制写一个忠实的程序,得命名棋盘、每个物件的坐标、动作合法条件与它产生的状态更新;Schema 团队为 LF52 发布的世界模型约 4,000 行 Python,文中展示的移动生成函数是 71 个函数之一、还调用了其中三个。而 VISTA 智能体写进笔记的三句话,足以让它完美通关:
- 绿色棋子在间距 48px 的灰洞上做标准正交跳:点源点,再点两格外的空落点;被跳过的普通绿子移除。
- 紫/粉色底座是固定的常驻跳桩,任何可动棋子都可以越过它,跳桩保留。
- 红色十字是可动的常驻跳子/跳桩;红与绿互跳时双方都不移除,因此交替跳能让一对常驻棋子沿直线推进。
一页笔记对四千行 Python,赢的是笔记。语言是隐式的、模糊的,程序是显式的、可执行的——而在这个基准上,模糊已经够用。
设计三:无损视觉记忆
标准 VLM/LLM 智能体唯一的记忆是 KV cache:隐式、压缩、有损、受上下文窗口限制,最早被牺牲的恰恰是旧帧的视觉细节。VISTA 换成显式档案:环境返回的每一帧都按回合与帧号索引、以原始分辨率保存,不做任何摘要式丢弃。
智能体用两个工具取用这份档案。inspect 把更早的状态、中间动画帧或放大的空间区域通过与实时观测相同的视觉通道重新调回视野,也可以一次请求多个视图做只读对比;read_pixels 对选定区域返回精确颜色采样,用于肉眼难辨的离散细节。作者称之为帧级、区域级、像素级的"显式注意力机制":哪个过去时刻重要,由模型决定,而不是由固定流水线决定。
| 记忆机制 | 保留什么 | 丢失什么 | 如何取回 |
|---|---|---|---|
| 上下文窗口 | 近期回合,以 token 与 KV cache 激活形式存在 | 窗口外的一切;压缩机制决定丢什么,旧视觉细节被压缩或丢失 | 对剩余内容做隐式注意力 |
| 程序化世界模型 | 蒸馏成代码的观测:状态、转移、目标条件 | 重建未建模的一切,以及历史帧本身 | 执行重建 |
| 文字笔记 | 模型自己对过程的描述 | 没写下来的一切;丢什么由模型选择 | 重读自己的文字 |
| 无损视觉记忆(VISTA) | 每一返回帧的原始分辨率,按回合与帧号索引 | 无 | inspect 与 read_pixels,由模型自行决定 |
笔记仍然存在,但只是补充而非记忆本体:GUIDE.md 存跨关卡仍有用的紧凑高层模型,WORKING.md 是当前关卡的草稿纸。
循环、笔记与四行提示词
一个智能体从首次观测玩到通关。每回合三步:观察当前视觉状态与可用动作;用自由语言推理——假设、预测、规划;调用 play 执行恰好一个游戏动作。一个动作产生的所有帧(含中间动画帧)按序进入视觉记忆,最后返回的帧成为下一观测。回看可用但可选:是否复查某个过去时刻是模型的决策,不是循环里的固定步骤。
提示词里有两个词承担了大部分设计重量:compact 要求模型把观测组织成高层抽象(奥卡姆剃刀式),revisable 允许新证据修正模型而非往上堆。每次 play 之前要求模型简述预期看到什么,之后简述所有可见变化(无论是否符合预期)——一条廉价的预测误差回路,让游戏模型保持诚实。接近上下文上限时,模型写一段简洁的续接状态,然后在全新上下文里从当前视觉状态继续;笔记、视觉记忆与动作历史都还在,交接损失的是连贯性,不是证据。
完整指令短到可以全文引用:
# Visual game task
Complete the game with as few game actions as possible.

Build and use a compact, revisable model of the game and its current state. Update it as new evidence changes what is supported.

Before each `play`, briefly state what you expect to see. Afterward, briefly state all visible changes, expected or not.

Keep concise, durable, revisable game understanding in `GUIDE.md`; use `WORKING.md` as a scratchpad when useful.工具面同样小:play 执行游戏动作,inspect 回看选定帧与区域,read_pixels 采样精确颜色,history 回看历史动作与结果,外加两个笔记文件。
结果:25 个游戏全通,183 关全过
两个后端各自独立跑完 25 个公开游戏,全程同一提示词、同一工具、同一推理设置。Claude Code CLI 上的 Opus 5.0(xhigh)完成全部 183 关:平均分 100.00,25 个游戏全部满分,共 7,542 个游戏动作,对照人类首次玩家的 17,135——少 56% 的动作换来满分横扫。Codex CLI 上的 GPT-5.6 Sol(max)同样完成 183 关,平均分 98.27、22 个满分游戏;差的 1.73 分集中在少数关卡,模型在那里多花了动作去发现机制或从错误模型中恢复,共 10,063 个动作。
| 后端 | 运行时 | 推理强度 | 平均分 | 通关游戏 | 满分游戏 | 动作数(智能体 / 人类) |
|---|---|---|---|---|---|---|
| Claude Opus 5.0 | Claude Code CLI | xhigh | 100.00 | 25 / 25 | 25 / 25 | 7,542 / 17,135 |
| GPT-5.6 Sol | Codex CLI | max | 98.27 | 25 / 25 | 22 / 25 | 10,063 / 17,135 |
分游戏表格能看出效率从哪来:ar25 用 270 个动作对人类 748;cn04 用 235 对 789,其中第 4 关 30 步对人类 300 步;ft09 第 1 关 4 步对人类 43 步。反例也有信息量:bp35 第 5 关 56 步对人类 33 步、g50t 第 6 关 59 步对 54 步——正是推断模型需要修补的关卡。
在排行榜上的位置
真正值得对比的不是人类,而是目前占据 ARC-AGI 社区排行榜顶部的程序合成系统——其中多数是与博客相隔数天发布的同期工作。按作者的说法,VISTA 是已知第一个不做程序合成就拿到满分或接近满分成绩的系统;而同样不做程序合成的官方基线,Opus 5.0 只有 30.16、GPT-5.6 Sol 只有 13.33。
| 系统 | 程序合成 | 模型 | 推理强度 | RHAE |
|---|---|---|---|---|
| 官方最小接口 | 否 | GPT-5.6 Sol | max | 13.33 |
| 官方最小接口 | 否 | Opus 5.0 | high | 30.16 |
| Schema | 是 | GPT-5.6 Sol | xhigh 后 max | 95.35 |
| Schema | 是 | Opus 4.8 后 Fable 5 | max | 98.98 |
| ewma_sv_v1.6 | 是 | GPT-5.6 Sol | xhigh | 98.97 |
| Retrodict | 是 | GPT-5.6 Sol | max | 99.86 |
| Tycho | 是 | GPT-5.6 Sol | max | 100.00 |
| Tycho | 是 | Opus 5.0 | xhigh | 100.00 |
| VISTA(本项目) | 否 | GPT-5.6 Sol | max | 98.27 |
| VISTA(本项目) | 否 | Opus 5.0 | xhigh | 100.00 |
Schema 行的回退值得细看:先以 xhigh 跑 Opus 4.8 与 Sol,任何低于 80 分的游戏再用 Fable 5 与 Sol max 重跑,取每游戏较高分。对照之下,一页笔记加一份帧档案,干了编译器该干的活。
换表示,不换智能体
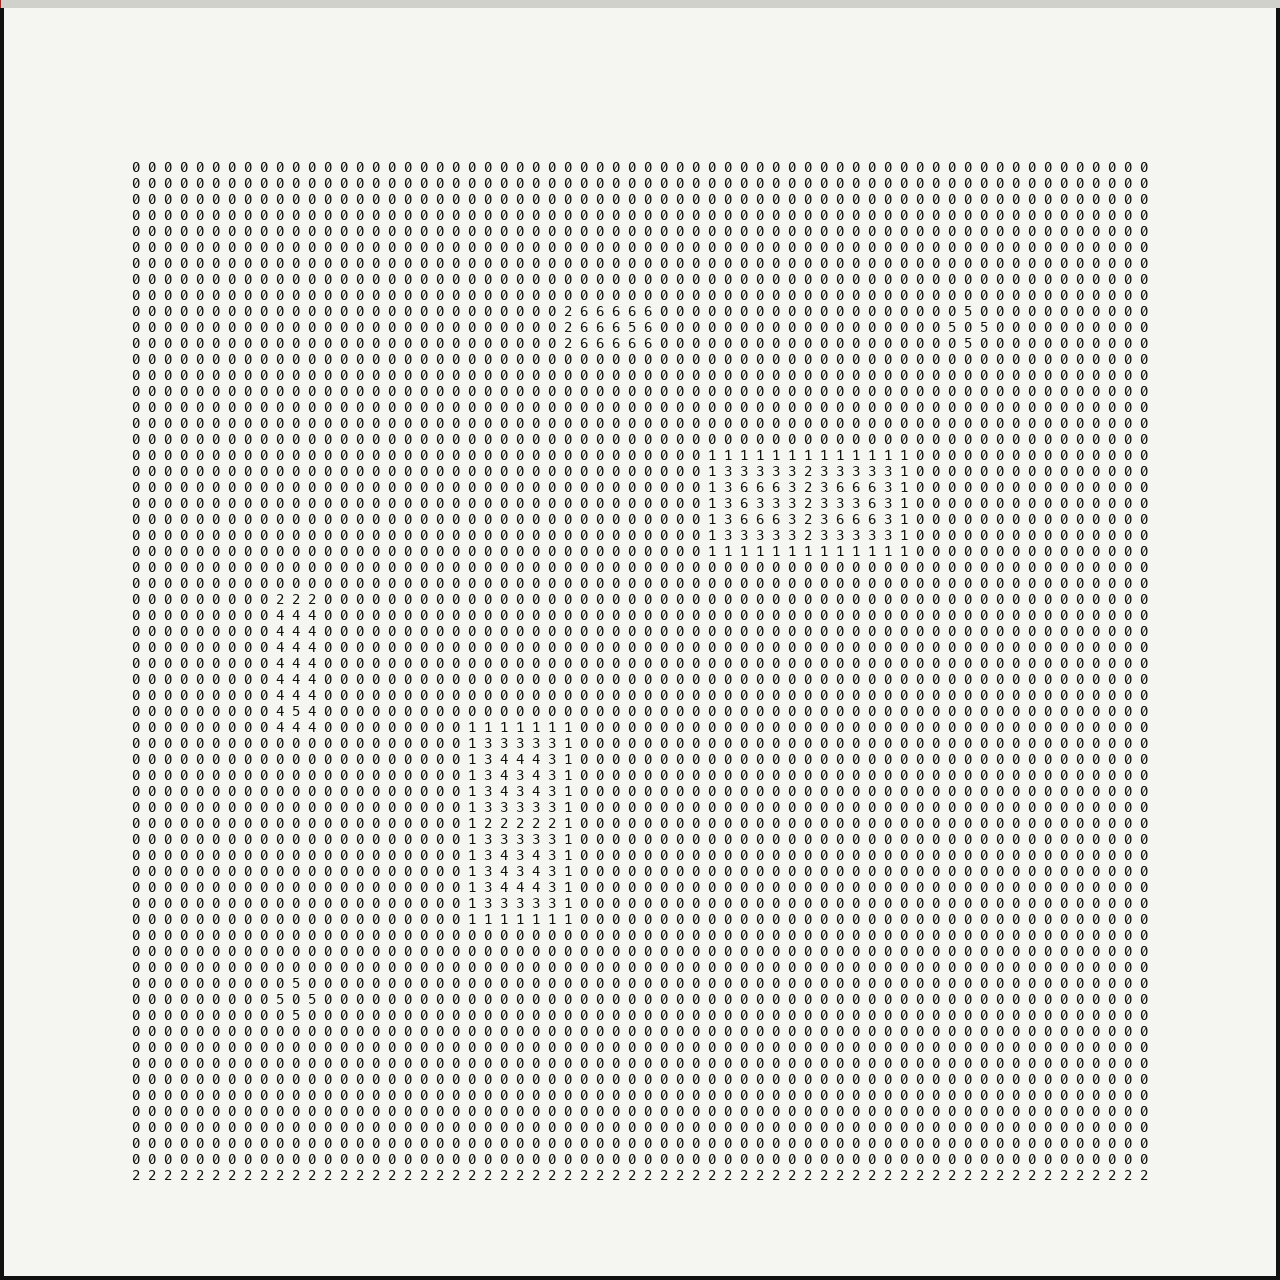
由于 harness 把观测当作不透明的感官输入,同一个世界可以用不同维度递交。博客测了三种:1D 文本网格(64×64 整数,一个整数一种颜色)、原始 2D 图、同一游戏的 3D 渲染。三种映射完全可逆、理论上信息等价——但实践中并不支持同样的计算。
VISTA 分别只靠某一种表示玩 S5I5(把两条彩色结构延伸到各自目标)与 CD82(把画布变换成参考图)。三种设置下它都推断出了两个游戏的玩法并完成第 1 关;三次是独立轨迹,并非相同动作序列。文本网格能玩但更费 token;3D 渲染也能玩,是作者指向具身环境的那一支——那里的观测更接近人类感知物理世界的方式。
怎么跑起来
VISTA 运行在 Linux x86_64,需要 Python 3.12+ 与 Docker Engine,外加两个运行时之一:Codex CLI 0.145.0 或 Claude Code 2.1.220。online 与 competition 模式需要 ARC Prize 平台的 ARC-AGI-3 API key;offline 模式可玩 ENVIRONMENTS_DIR 提供的本地游戏文件。从仓库检出后:
python3 -m venv .venv
.venv/bin/python -m pip install --upgrade pip
.venv/bin/python -m pip install -e .
cp .env.example .env
chmod 600 .env
把 ARC key 写进 .env(ARC_API_KEY 与 ARC_BASE_URL=https://three.arcprize.org),登录所选运行时(Codex CLI 用 codex login;Claude Code 用 setup-token 后把 token 填进 CLAUDE_CODE_OAUTH_TOKEN),再构建对应的 player 镜像:
# Codex CLI player
docker build -t arc3-codex-player:0.1 -f Dockerfile.codex-player .

# Claude Code player
docker build -t arc3-claude-player:0.1 -f Dockerfile.claude-player .
单游戏与全量扫描:
# 单个游戏、单个后端
.venv/bin/python scripts/run_arc3_codex.py --game-id s5i5 --model gpt-5.6-sol --effort max
.venv/bin/python scripts/run_arc3_claude.py --game-id s5i5 --model opus --effort xhigh

# 全部 25 个公开游戏,并行 2 路
./scripts/run_batch.sh --runtime codex --mode online --model gpt-5.6-sol --effort max -j 2
./scripts/run_batch.sh --runtime claude --mode online --model opus --effort xhigh -j 2
每次运行都会记录完整轨迹——游戏动作、公开模型输出、视觉查看与智能体笔记——博客里每个游戏的 replay 链接就是这些记录。
边界与下一步
作者对结果的边界说得很清楚:模型既有的能力是成功的关键因素,harness 只是一种简单而有效的激发方式。两个后端都发布于公开 ARC-AGI-3 游戏之后,无法排除训练时见过这些游戏的可能,私有游戏集才是泛化的真正检验。ARC-AGI-3 是试验台,不是目标。
目标在设计本身:原始高维观测、自由语言推理、对过去经验的无损召回,这三样都不绑定 ARC。作者把 VISTA 定位为任意交互环境的模板,而 3D 表示的结果是迈向他们真正关心的方向的第一步——更接近物理世界的具身环境,智能体要靠"看"和"动手"去发现一个地方如何运转。