Laya 开源解读:421M 非自回归 System 1 决策模型,33 毫秒一次前向传播
Convai Innovations 开源非自回归决策模型 Laya:ModernBERT 主干加 [MASK] 选项抽取,RLCD 严格适当评分规则训练校准概率;附 README 诚实限制与对 Jev 的真实基准。
2026 年 9 月 18 日,独立研究者 Nandakishor M 以 Convai Innovations 的名义在 GitHub 上推了一个叫 laya 的仓库。五天后它突破 19,000 star,背后的模型权重冲上 Hugging Face 热门榜前列。Laya 是一个非自回归的「System 1」决策模型:给它一个状态(一封邮件、一张工单、一份 JSON 文档)和一组带类型的问题,它在一次前向传播里返回带类型的决策、每个选项上的概率分布和一个校准过的置信度,全部来自一个 4.21 亿参数的双向编码器。不生成任何 token,所以没有东西需要解析,也没有东西可以幻觉。
这个时间点不是巧合。Laya 公开前三天,TypeSafe AI 刚刚开放同类接口形态的闭源模型 Jev 的早期访问,我们此前对那次发布的解读是本文的天然前篇。Laya 在所有意义上都是 Jev 的开源答案:同样的三种决策原语,同样的 RLCD(面向校准决策的强化学习)训练哲学,Apache-2.0 协议、可以自己托管的权重,以及一份花了异常多篇幅告诉你模型在哪里会失败的 README。这篇文章完整走一遍:为什么生成式 LLM 是反射式决策的错误工具,Laya 的架构如何从 [MASK] token 里抽出决策,让概率变诚实的严格适当评分规则数学,基准测试到底说明了什么,以及宣传稿没有写的那些诚实限制。
一、真正的问题:用生成式 LLM 做反射式决策
每一条现代 AI 流水线里都藏着同一个瓶颈:一个生成式大语言模型被拿去做结构上极其简单的决策。客服工单进来,要有人知道它归哪个组;邮件落地,要有人知道它是不是钓鱼;提示词打到 API,要有人知道它是不是越狱尝试;严重度量表写着 0 到 3,要有人选一档。为这些事调用一个 8B 或 70B 的生成模型是字面意义上的大材小用:你要等 500 到 2,000 毫秒让 token 逐个流出来,按 token 付推理费,然后再写正则或 JSON 解析器,从一段从未承诺过格式干净的自由文本里抠出一个标签。
更深的失败在认识论层面。当 LLM 打印 confidence: 0.95 时,它是在预测一串听起来很自信的 token,数字背后没有任何数学校准。这些流水线真正需要的是卡尼曼意义上的系统一模型:反射般快、对自己的不确定性诚实、便宜到能塞进热循环里。Laya 的目标是普通硬件上 30 到 40 毫秒,且概率是被训练成真的,而不是被打印成看起来真的。
二、三种决策原语,一次前向传播
Laya 接收一个状态加一个或多个带类型的问题,在一次并行前向传播里评估全部问题。原语恰好三种,返回形状定义了每一种:
- choice:从字典形式的判据中选一个选项;返回选中的标签、每个候选的概率和置信度。适合部门路由、意图识别、主题分类。
- score:把状态放到 0/1/2/3 这样的有序量表上;返回期望分值(可以是小数)、各档概率和置信度。适合客户不满程度、紧急度、危害严重性。
- noul:用校准过的 $P(\text{true}) \in [0, 1]$ 回答布尔问题。适合钓鱼、垃圾邮件、越狱、流失风险。
由于输出空间被限制为概率和数字,模型从不生成文本。它不可能幻觉出一个不在你选项集合里的标签,也不可能吐出格式损坏的 JSON,因为它根本不吐文本。它确实有的失败模式是「在你给的选项里挑错」,更安静,下文会回到这一点。
三、架构:4.21 亿参数与一个 [MASK] 技巧
这条研究脉络很重要。2025 年 3 月,Nandakishor M 发表 arXiv:2503.23303,用冻结的序列嵌入加一个独立的 PPO 价值网络逐轮预测销售转化。它能工作,但不是端到端,也无法在运行时吸收新问题。2025 年 9 月的第二篇论文(arXiv:2510.01237)给出了 schema 化决策的框架。Laya 是把这条工作线重构成一个通用、横向的 System 1 引擎,而作者对自己动机的表述非常直接:他在一家拿了钱的实验室把同一个想法包装成产品的一年之前,就把这东西做出来了。
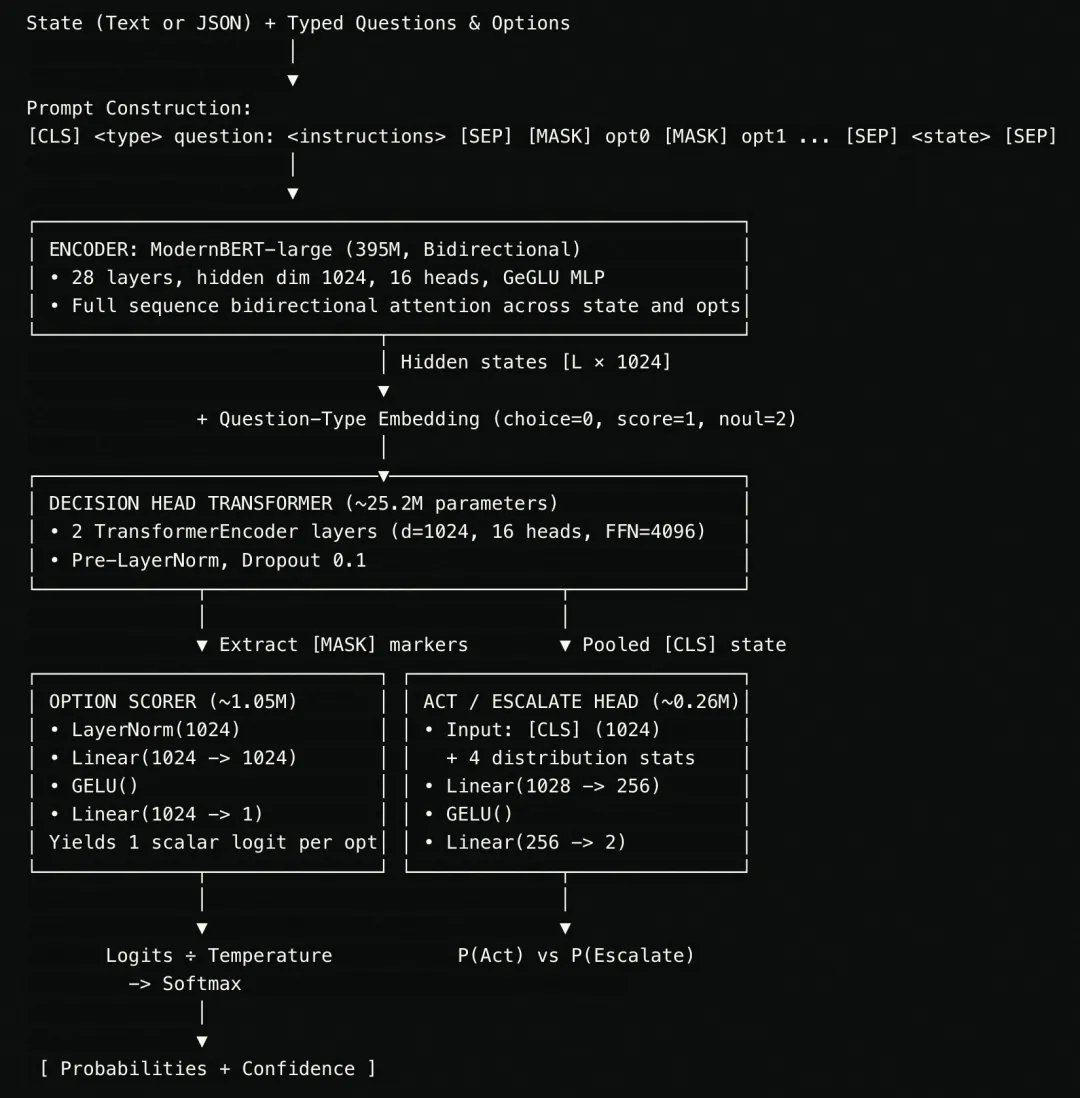
[MASK] 的提示构造、ModernBERT-large 编码器、两层决策头 Transformer,然后并行的选项评分器与行动/升级头。ModernBERT-large 主干
编码器是 ModernBERT-large:3.95 亿参数、28 层、隐藏维度 1024、16 个注意力头、宽度 2624 的 GeGLU 中间层,以及支持 8,192 token 的旋转位置嵌入(RoPE)。因为它完全双向,每个 token 同时关注整个状态和所有选项——这正是在固定选项集上做决策所需要的、而因果解码器给不了的东西。
在 [MASK] 位置抽取选项
对每个问题,build_sequence 例程把提示封装成每个选项恰好拥有一个 [MASK] token 的形式:
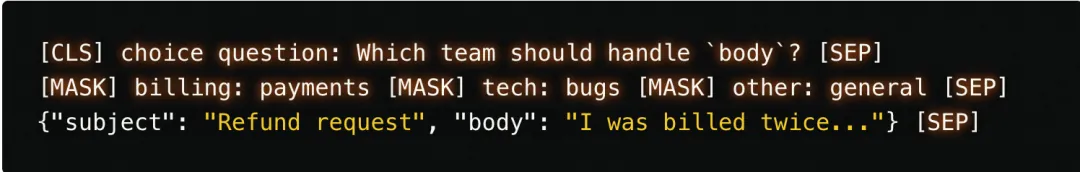
[MASK],选项渲染为 label: description,然后是状态。决策从 mask 位置读出,而不是生成出来。经过编码器和一个两层决策头 Transformer(约 2,520 万参数,pre-LayerNorm,dropout 0.1)之后,torch.gather 精确抽取这些 mask 位置上的隐藏状态。一个选项评分器 MLP 把每个 1024 维状态投影成一个标量 logit,对属于该问题的所有选项做 softmax 得到候选分布:
$$p_k = \frac{\exp(z_k / T)}{\sum_j \exp(z_j / T)}$$
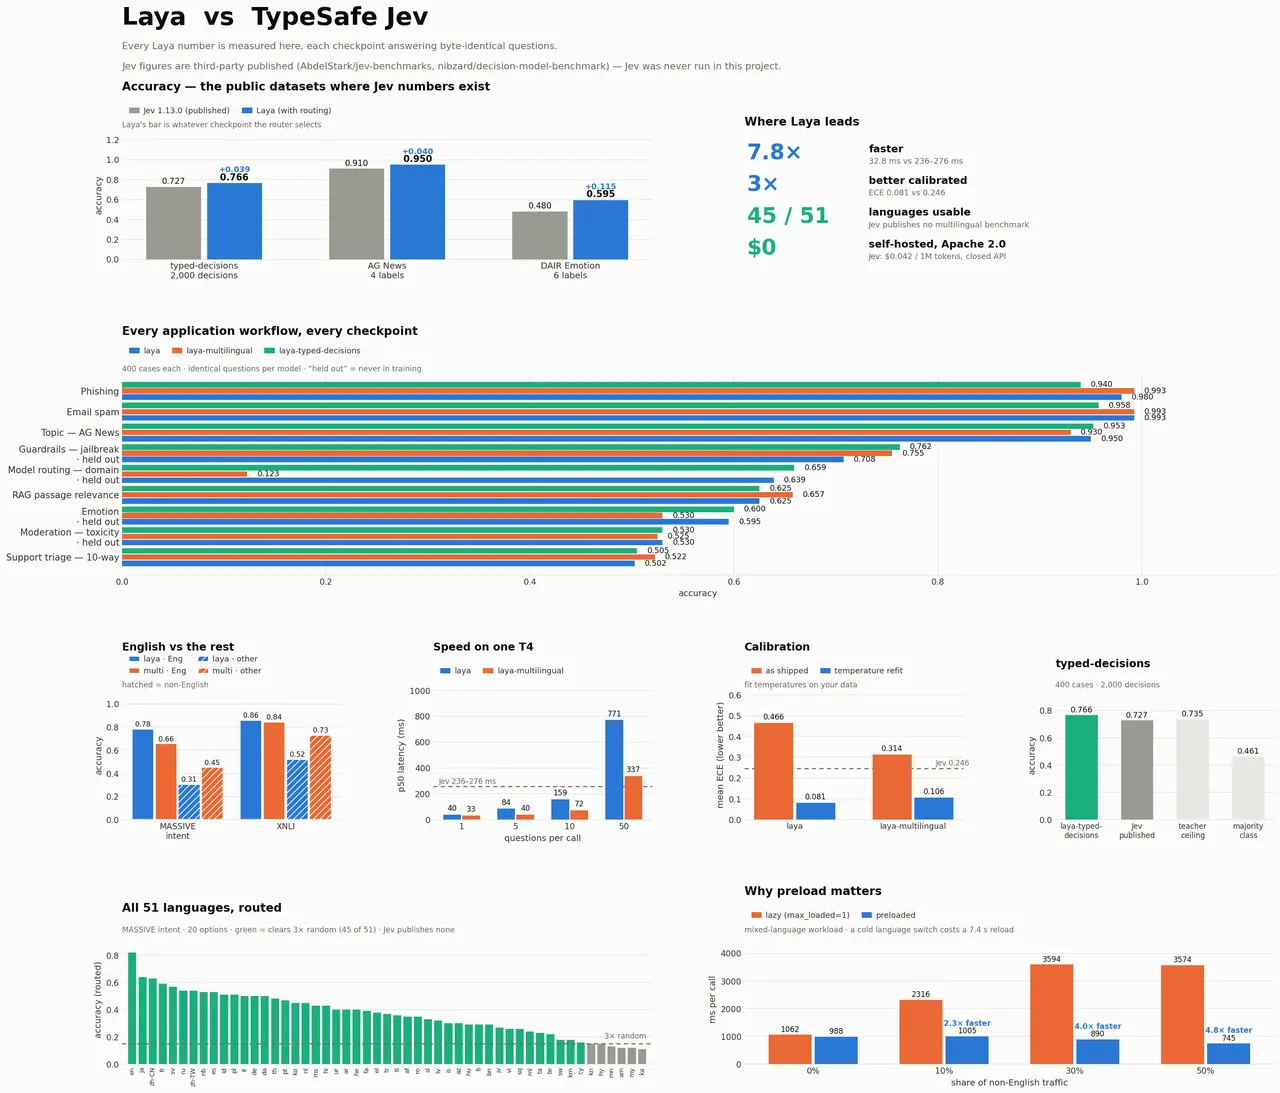
其中 $T$ 是按问题类型和选项数量分别拟合的温度。这个温度不是装饰:两个出厂检查点都是过度自信的,在留出数据上按(问题类型、选项数)重拟合一个温度后,英文检查点的平均期望校准误差从 0.466 降到 0.081,多语检查点从 0.314 降到 0.106。而多语检查点出厂时根本没有拟合过温度。
行动/升级决策头
真实的自动化需要知道什么时候不该相信自己。Laya 加了第二个头:取池化后的 [CLS] 状态(1024 维),拼接四个分布特征——最大概率 $\max(p)$、前两名差值 $p_{(1)} - p_{(2)}$、归一化熵 $H(p)/\log K$、选项预算比 $K/255$。这个 1028 维向量经过一个两层 MLP,输出 $[P(\text{act}), P(\text{escalate})]$。后文限制一节会看到,这个头恰恰是 README 告诉你暂时不要信的那个组件。
多个问题,一次前向传播
关于同一封邮件的 5 个问题变成 5 条序列,打包进一个批次;ModernBERT 在一次前向传播里处理完,GPU 上约 35 毫秒。跨状态的批处理是同一思路的上一层:predict_batch 把多个状态对同一组问题打包进共享的前向传播,在 RTX 5060 Ti 上单决策延迟从约 10 毫秒降到约 1 毫秒。T4 上公布的数字是单问题 32.8 毫秒、10 问一批时每问 7.2 毫秒,吞吐 103 到 332 问/秒。
四、RLCD:诚实概率背后的数学
有趣的问题不是怎么让模型准确,而是怎么让它的概率为真。RLCD(面向校准决策的强化学习)用决策理论回答它。
为什么交叉熵和朴素 RL 都会破坏校准
用交叉熵训练分类器,
$$\mathcal{L} = -\sum_k y_k \log q_k$$
损失只有在获胜 logit 趋于无穷时才最小化:无论是否应当如此,模型都被推向确定性。二元奖励(对 +1、错 0)的朴素强化学习也好不到哪去。期望奖励为
$$\mathbb{E}[r] = \sum_k q_k \, y_k \cdot 1 = q_{y}$$
策略梯度把最高概率推向 1.0、其余全部推向 0.0。朴素 RL 通过摧毁校准来最大化准确率,你得到的是一台自信地犯错的机器。
把严格适当评分规则当奖励
修法是让奖励成为一个严格适当评分规则。评分规则 $S(q, y)$ 在结果 $y$ 发生时为报告分布 $q$ 的模型打分;当且仅当期望得分在 $q = p$(真实分布)处唯一最大时,它才是严格适当的。报告诚实概率,否则损失奖励:不存在别的最优点。Laya 的复合奖励组合了三个这样的规则,
$$\begin{aligned} R(q, y) = {} & S_{\log}(q, y) \\ & + 0.5\, S_{\text{sph}}(q, y) \\ & - 1.0\, S_{\text{rps}}(q, y) \end{aligned}$$
各管一件事。
对数评分,
$$S_{\log}(q, y) = \sum_k y_k \log \max(q_k, 10^{-12})$$
在真实结果被赋予低概率时重罚;下限截在 $-9.21$(即 $\log 10^{-4}$)保持梯度有限。球面评分,
$$S_{\text{sph}}(q, y) = \frac{\sum_k y_k q_k}{\sqrt{\sum_k q_k^2}}$$
有界于 $[0, 1]$,奖励把概率质量放到正确类别上,同时避免纯对数损失的极端梯度尖峰。排序概率评分用于有序 score 问题,
$$\begin{aligned} S_{\text{rps}}(q, y) &= \frac{1}{K-1} \sum_i \Delta_i^2 \\ \Delta_i &= \mathrm{CDF}_q(i) - \mathrm{CDF}_y(i) \end{aligned}$$
度量两个累积分布之间的平方距离,于是真值为 3 时猜 2 相对猜 0 会获得奖励。减去它教会模型量表上的距离,而不只是 argmax。
策略梯度:带组基线的 REINFORCE
训练用纯策略梯度,监督式交叉熵损失为零。对每个问题,训练器采样 $G = 8$ 组带噪候选 logit 向量,
$$z_{\text{noisy}} = z + \epsilon, \quad \epsilon \sim \mathcal{N}(0, \sigma^2)$$
并把噪声投影成跨选项和为零($\epsilon - \bar{\epsilon}$),因为给所有 logit 加同一个常数会在 softmax 里抵消。探索标准差 $\sigma$ 从 1.0 衰减到 0.3。每个带噪向量定义分布 $q_{\text{noisy}} = \mathrm{softmax}(z_{\text{noisy}})$,奖励 $r = R(q_{\text{noisy}}, y)$,优势相对组均值计算,GRPO 风格,
$$A = \frac{r - \mathrm{mean}(r)}{\mathrm{std}(r) + 10^{-6}}$$
策略损失用采样 logit 的高斯对数概率,
$$\mathcal{L}_{\text{policy}} = -\mathrm{mean}\left( A \cdot \log \pi(z_{\text{noisy}} \mid z) \right)$$
成本敏感的行动头,以及 62.5% 从哪来
行动头从 {act, escalate} 中采样,按成本矩阵取奖励:行动且正确 $+1.0$,行动但错误 $-3.0$,升级给人工 $-0.5$。记 $p_c = P(\text{correct})$ 为一次自动行动正确的概率,则自动行动有利可图当且仅当
$$\begin{aligned} p_c (1.0) + (1 - p_c)(-3.0) &> -0.5 \\ 4\,p_c &> 2.5 \\ p_c &> 0.625 \end{aligned}$$
于是策略自己学会只在置信度高于 62.5% 时行动。这个阈值不是凭手感调的超参数,而是「一次错误的自动行动相对一次人工复核值多少钱」的算术后果。改成本矩阵,阈值跟着动。
五、TD(lambda) 建模多轮轨迹,与泄漏修复
2025 年 3 月的论文用 PPO 跨对话轮次预测销售转化,并暴露了一个值得记住的泄漏 bug:在第 1 轮就喂入整段对话的嵌入,模型就读到了自己的未来。Laya 的修复是结构性的:对话被切成递增的前缀(第 1 轮、第 1-2 轮、第 1-3 轮……),模型永远只看到截至当前轮的上下文,训练用以蒙特卡洛回报为目标的时序差分学习,TD($\lambda = 1.0$):
$$\begin{aligned} V(s_t) & \leftarrow V(s_t) + \alpha \left[ G_t - V(s_t) \right] \\ G_t & = \sum_{k \geq t} \gamma^{k-t} r_k \end{aligned}$$
$\lambda = 1.0$ 时,早期轮次直接对着对话的真实终局结果训练,而不是从模型自己的猜测自举,于是模型学到的是哪些早期对话模式真正预示着转化或流失。
六、置信度即归一化熵
每个答案都带一个 $[0, 1]$ 的置信度,由它自己分布的形状算出:
$$\begin{aligned} \text{confidence} & = 1 - \frac{H(p)}{\log K} \\ H(p) & = -\sum_k p_k \log p_k \end{aligned}$$
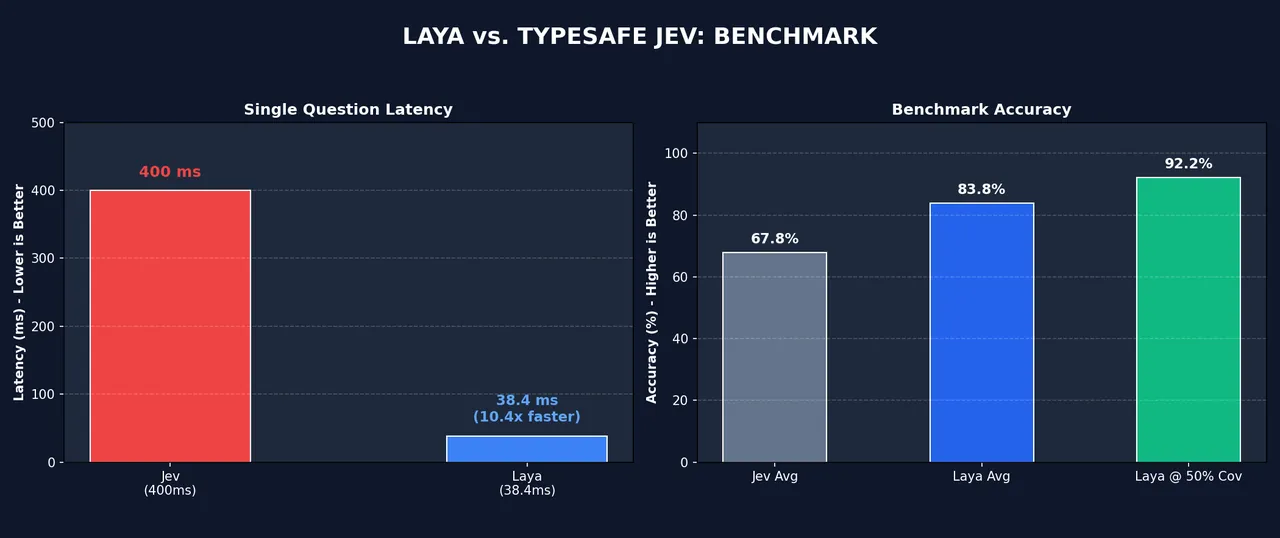
其中 $K$ 是选项数。完全均匀 $p_k = 1/K$ 时熵为 $\log K$,置信度恰为 0.00;完全尖峰时熵为 0,置信度 1.00。它是一个离散度统计量,不是学出来的头——这正是下面选择性自动化曲线有意义的原因:只接受置信度最高的前 50% 预测,准确率从 83.8% 升到 92.2%。
七、数据流水线:不走合成捷径
造这种模型最诱人的办法是让 LLM 批量生成合成问题和标签。作者的论证是:这恰好踩中了上面那个校准陷阱——在合成标签上训练的模型,校准的对象是生成 LLM 的错误与幻觉,而不是现实。Laya 的流水线使用 100% 人工标注的公开数据集,覆盖客服路由与意图、蕴含与事实核查、内容安全的人类共识标签、真实越狱与提示注入攻击、帮助性与正确性的人类量表评分,以及带已验证结局的多轮 SaaS 销售与客服对话。为了堵住捷径学习,流水线动态打乱选项顺序、改写问题表述、在原始文本与嵌套 JSON 状态之间交替,并注入随机干扰问题。
有一处保留意见应该放在这里:2025 年 SalesRLAgent 的摘要提到该早期数据集中含 GPT-4o 生成的合成对话,而「零合成捷径」的说法针对的是当前流水线。两句话讲的是不同的流水线,但对照论文读的读者应该注意到这个差别,而不是直接继承口号。
八、基准测试,以及怎么读
headline 评测覆盖 25,424 个问题:23,024 个任务内问题,加 2,400 个来自训练期间从未见过的任务家族的零样本问题,并与 TypeSafe 公布的 Jev 数字对比。
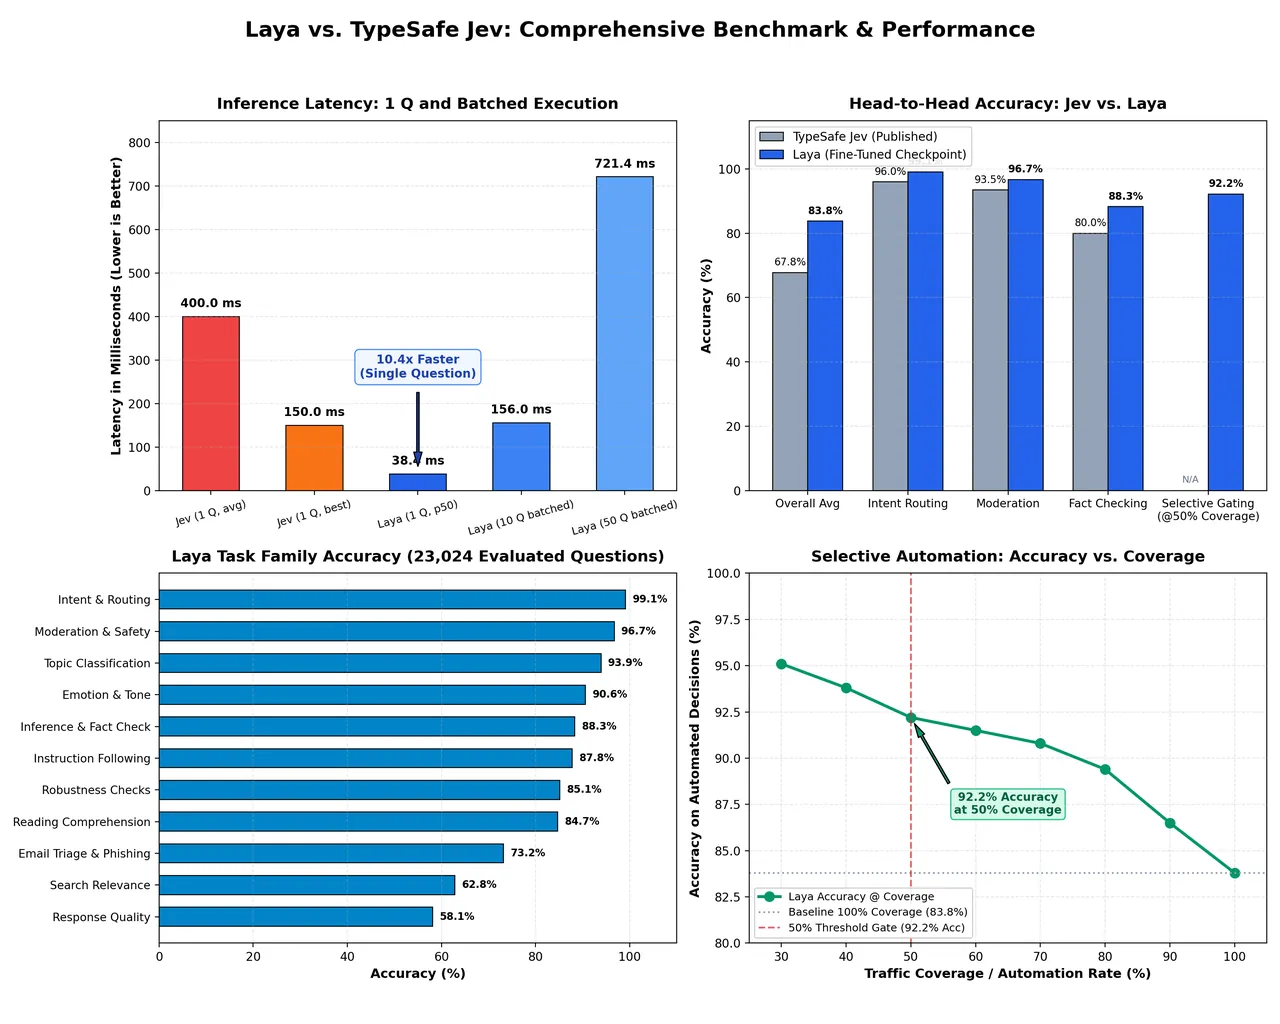
| 指标 | TypeSafe Jev(公布值) | Laya(微调检查点) | 读法 |
|---|---|---|---|
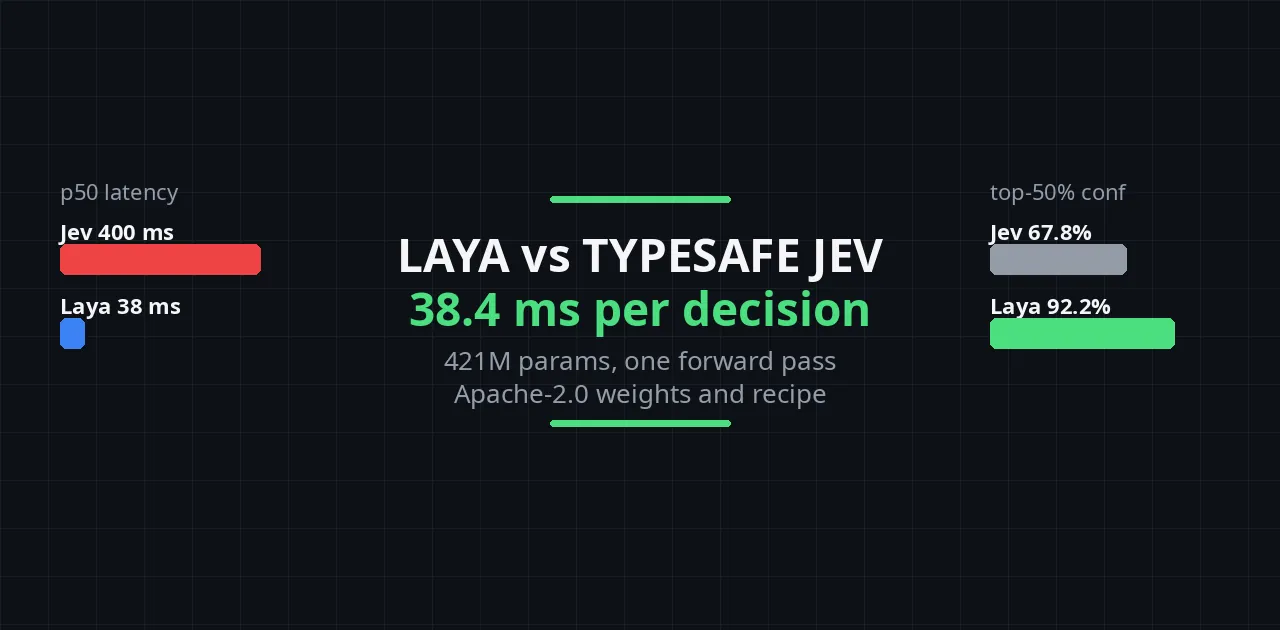
| p50 延迟,1 问 | 典型约 400 ms(70-500 ms;最佳 150 ms) | 38.4 ms(p95 42.1 ms) | 均值约 10 倍,对 Jev 最佳情形约 4 倍 |
| 10 问批处理 | 串行约 1,500 ms / 约 400 ms | 156.0 ms(p95 158.4 ms) | Laya 答 10 问的时间 Jev 答 1 问 |
| 50 问批处理 | 数秒 / 触发限流 | 721.4 ms | 高吞吐小批处理区间 |
| 工作流准确率 | 4 个生产工作流 67.8% | 任务内宏平均 83.8% | +16.0 个点,但见下文保留意见 |
| 意图与路由 | 约 95-98% 一致率 | 99.1%(ECE 0.009) | 路由任务校准误差近乎为零 |
| 审核与内容安全 | 约 92-95% 一致率 | 96.7%(ECE 0.061) | 安全边界清晰 |
| 选择性自动化,前 50% 置信度 | 宣称可升级人工 | 92.2%(ECE 0.041) | 做门控时真正重要的那个数 |
| 权重与代码 | 闭源 API | Apache-2.0,可自托管 | 数据主权、隔离网络部署 |
| 推理成本 | 每百万输入 token 0.042 美元 | 自托管 0 美元 | GPU、Mac MPS 或 CPU 皆可 |
23,024 个任务内问题的分族表展示了模型在哪里强、在哪里只是可用:意图与路由 99.1%、审核 96.7%、主题分类 93.9%、情绪与语气 90.6%、蕴含与事实核查 88.3%、指令遵循任务内 87.8% / 零样本 86.3%、鲁棒性检查 85.1%、阅读理解 84.7%、邮件分流与钓鱼 73.2%、搜索相关性 62.8%、回复质量评分 58.1%。2,400 个留出问题的零样本宏平均为 65.1%,被情绪(58.3%)与情感评分(36.2%)两个族拖低。
两个独立测量从另一侧让延迟结论站得住。第三方 Jev 基准仓库(AbdelStark/jev-benchmarks 与 nibzard/decision-model-benchmark)测得 Jev 的 p50 为 236 到 276 毫秒,而不是营销引用的 150 毫秒最佳情形;对照之下 Laya 路由后单问 32.8 毫秒约快 7.8 倍。README 的共享基准表里,每个 Laya 数字都是 Router().predict(...) 的真实返回:typed-decisions 上 0.766 对 Jev 公布的 0.727,高于 0.735 的教师自一致上限,Brier 分数好 2.4 倍。
九、宣传稿没有说的部分
微信推文和 dev.to 长文是发布稿;README 的「Honest limits」一节才是工程文档,它会改变你部署这个模型的方式。五条最重要。
基础检查点零样本接近随机。在 typed-decisions 上,未微调的检查点得 0.362 与 0.342,对照 0.318 的随机基线和 0.461 的多数类基线。被反复引用的 0.766 来自在该基准自己的训练 split 上微调过的检查点。Laya 是一个适合快速特化的底座,不是零样本决策引擎。任何不带上微调限定就引用 0.766 的写法都是在误读表格。
高棉语准确率 0.000,置信度 95.2%。英文检查点在非拉丁文字上崩溃,同时保持 maximal 自信——这正是置信度门控救不了你的情形:门看到 0.952,把垃圾放行。这正是 Router 存在的原因:在前向传播之前用不到 0.5 毫秒的纯 Python 检测文字系统,再分派到多语检查点。在测试的全部 51 种语言上,英文检查点宏平均 0.227、宏 ECE 0.733,只有 23 种语言超过随机 3 倍;路由后是 45/51。
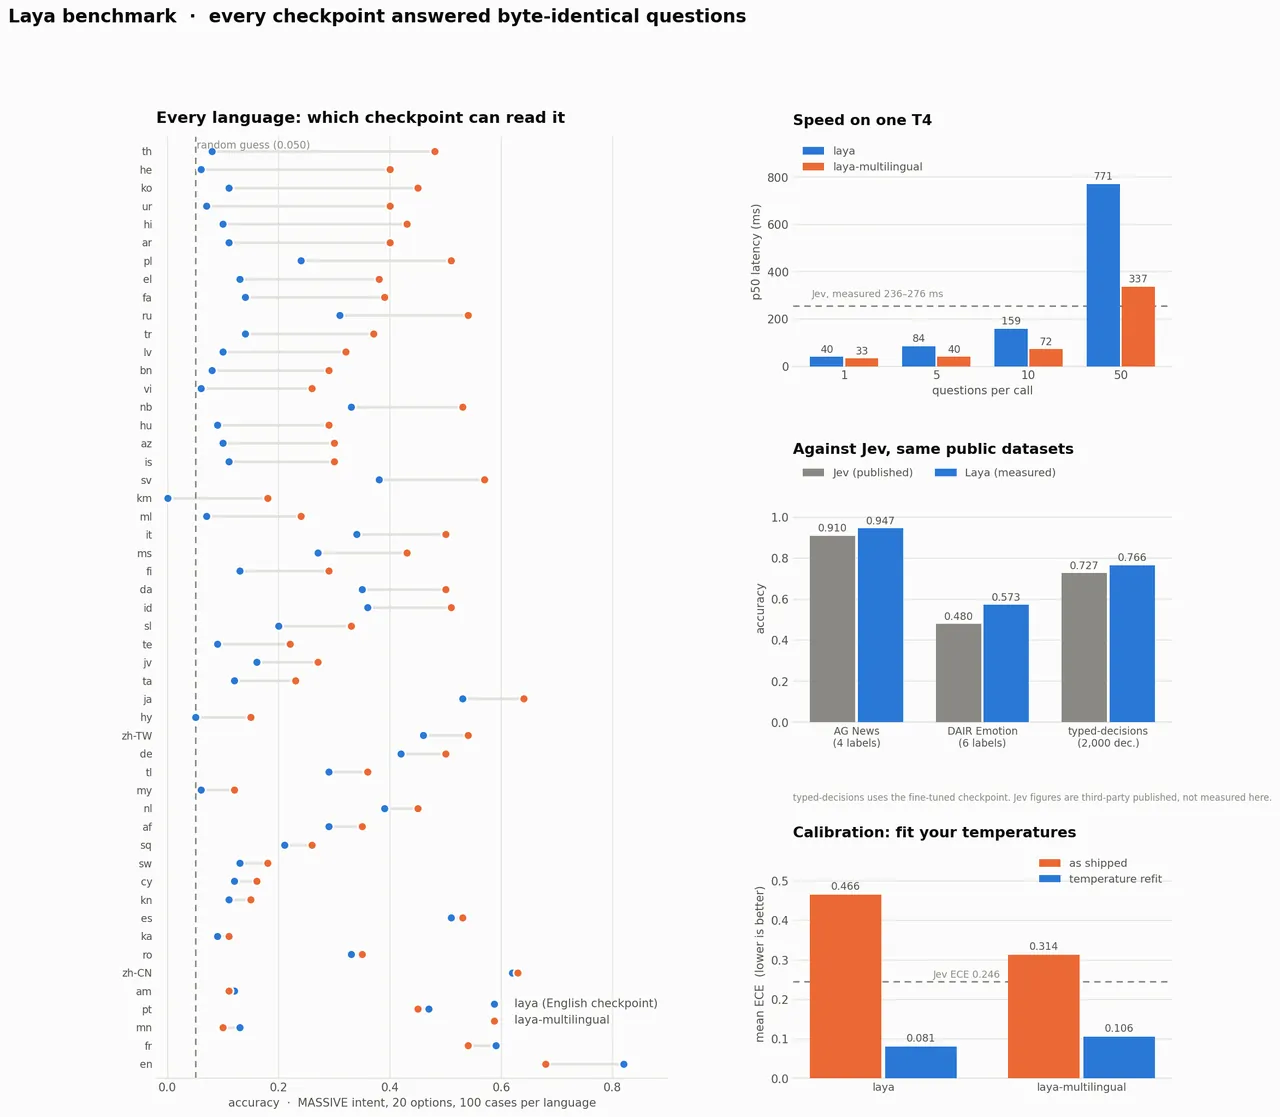
高基数 choice 问题撞 token 预算。选项共享固定的 head_max_len 预算(英文检查点 192 token,多语 256)。Banking77 的 77 个标签摊下来每个标签只有约 3 到 4 个 token,准确率掉到 0.425,而 Jev 在 72 个标签上得 0.870、开箱支持最多 255 个选项。绕行办法是运行时调高 head_max_len、用 predict_shortlist 做基于嵌入的短名单,或自己把标签集拆成粗问题和细问题。
noul 可能跟着标签走而不是跟着状态走。默认渲染用 false: / true: 作为两个选项字符串,在英文检查点上这对标签可能主导答案,对明显为正的输入返回自信的「no」(issue #156)。多语检查点在 score 问题上有相关的位置偏置,几乎不选列在第一位的档位(#131)。两者都有文档化的绕行——覆盖模型侧标签,或用中性键的两选项 choice——并且都附带同一条指示:在你自己的数据上验证。
act_probability 目前不带可用信号。它对几乎所有输入读 1.0,原始 logit 与正确性反向(396 条标注决策上 AUROC 0.30)。请改用 confidence 做门控,同一批数据上它达到 AUROC 0.77。架构一节描述的行动/升级头是真实存在的,但它不是今天该接进生产的门。
还有两个较小的不对称:Jev 与教师完整分布的匹配更好(soft accuracy 0.580 对 Laya 的 0.471);Laya 出厂原始 ECE(0.213)差于 Jev 公布的 0.144,直到温度拟合把它带到 0.081。这里的校准是随检查点一起发布的拟合产物,不是架构的免费性质。
十、跑起来,以及 Jev 兼容面
包是一行命令,pip install laya(撰文时 v0.3.8),权重在 Hugging Face 与 ModelScope 上。推荐入口是路由器:
from laya import Router

router = Router(preload=True)   # 全部检查点驻留内存;语言切换只花 <1 ms

state = {
    "from": "user@company.com",
    "subject": "Charged twice on March invoice",
    "body": "Hi, we were billed twice for invoice 4411. Please refund the duplicate today.",
}
questions = {
    "department": {
        "type": "choice",
        "instructions": "Which department should handle this email?",
        "criteria": {
            "billing": "invoices, payments, refunds",
            "technical": "bugs, outages, system errors",
            "sales": "pricing, new contracts",
            "other": "everything else",
        },
    },
    "urgency": {
        "type": "score",
        "instructions": "How urgent is this request?",
        "criteria": ["not urgent", "soon", "critical deadline or blocking issue"],
    },
    "churn_risk": {"type": "noul", "instructions": "Does the user threaten to cancel or leave?"},
    "is_phishing": {"type": "noul", "instructions": "Is this email a phishing or scam attempt?"},
}

result = router.predict(state, questions)   # 一次前向传播,GPU 约 33 ms
a = result["answers"]
print(a["department"]["choice"], a["department"]["confidence"])  # billing, 0.94
print(a["urgency"]["score"])                                     # 1.84 / 2.0
print(a["churn_risk"]["noul"])                                   # 0.892
print(a["is_phishing"]["noul"])                                  # 0.008
因为概率是被训练成校准的,门控逻辑可以保持无聊:
dept = a["department"]["choice"]
conf = a["department"]["confidence"]

if conf >= 0.85:
    route_automatically(dept)
else:
    send_to_human_triage(dept, reason=f"Low confidence ({conf:.2f})")
在 0.85 的门上,公布的曲线意味着你以 92.2% 的精确率自动化大约一半流量,把真正棘手的另一半升级给人工。部署选项还包括 Jev 兼容的 HTTP 服务器(laya-serve 说 POST /v1/systemone,TypeSafe 客户端改个 base URL 就能迁移)、MCP server、LangChain/LangGraph 的路由与护栏节点、TypeScript 包、ONNX 与 TileLang 快速路径,以及 impossibl 提供的免费托管端点,与 TypeSafe 的 System One API 线兼容。微调 notebook 在 Kaggle 免费的 2xT4 GPU 上跑完整闭环——建数据集、RLCD 训练、温度拟合、评估、推 Hub——约 3 万问跑 4 个 epoch 需 4 到 5 小时。
十一、对 agent 与机器人 harness 的含义
我们对 Jev 的解读结尾写过:System 1 模型争的不是 LLM 的活,而是 agent harness 里那些「每次都要叫一次前沿模型太贵太慢」的位置——这条轨迹要不要人看、这个工具结果是否合规、感知状态是否满足某条前置条件、这一帧该执行哪个离散动作。Laya 把这个位置放到了那些根本不能把数据发给闭源 API 的团队够得着的地方——在机器人与工业场景里,这往往比成本更是硬约束。
回路能闭合的最强证据是一个有文档的特化,而不是 demo:把 Laya 作为 browser-use/jev-ultrafast(与 Jev 相同的请求格式)里的操作与目标决策头。约 45 个候选里的 element top-1 从零样本 0.10 升到单张 16 GB GPU 微调后的 0.66,真实任务成功率从 0% 到 62%,每步 17 到 23 毫秒。把它当模板读:一个 4.21 亿参数的双向编码器,在你自己的状态和自己的选项集上特化,坐在一个 VLM 永远跟不上的控制回路里。社区向华为昇腾 NPU 的移植报告 batch size 1 下相对 CPU 34 到 71 倍加速,这是这类模型让边缘部署变得可信的方向。
诚实的读法与 README 给的相同:把 Laya 当作适合快速特化的底座。零样本数字接近随机,多语故事需要路由器,高基数标签集需要短名单,行动头还不是门。换回来的是 Apache-2.0 权重、一份能在免费 GPU 上复现的训练配方,以及一个校准度被测量、被拟合、被公布出来的概率——而不是一个营销形容词。对控制回路而言,这就是「可以认证的组件」与「只能寄希望的组件」之间的区别。
上线前清单
- 在你自己的状态与选项集上微调;不要把零样本基础检查点放进决策路径。
- 在留出数据上按(问题类型、选项数)拟合温度,每次重训后重拟合;陈旧的 bucket 温度会静默掩盖新的拟合。
- 在前向传播之前按文字系统路由;永远不要让置信度门控成为唯一的语言防线,因为自信失败模式恰恰是「高棉语 95.2%」。
- 避免在
choice里用布尔词标签,检查noul的标签敏感性;用语义键或不透明键,并在自己的检查点上验证。 - 默认预算下选项集控制在约 20 个以内,否则调高
head_max_len、用嵌入短名单,或拆粗/细问题。 - 自动化门控用
confidence而不是act_probability;阈值像 62.5% 那个数字一样,从你自己的成本矩阵推出来。 - 为「在你给的选项里挑错」这类静默错误建监控:类型安全意味着没有解析器会替你报警。
整理自魔搭 ModelScope 社区微信公众号推文(2026-09-21)、作者 dev.to 工程长文、GitHub 仓库及其 BENCHMARKS.md、Hugging Face 模型卡;star 数与检查点元数据于 2026-09-23 核实。原文中的推广性内容(关注引导、打赏按钮)已删除。
- 原文(微信公众号·魔搭ModelScope社区):Laya 开源:比 Jev 快 4 倍!421M 参数,33 毫秒完成 System 1 决策
- 作者工程长文:dev.to: I built non-autoregressive decision models a year ago...
- 代码:NandhaKishorM/laya(Apache-2.0)
- 权重:convaiinnovations/laya、laya-multilingual、laya-typed-decisions;魔搭镜像 convaiinnovations/laya
- 前序论文:arXiv:2503.23303、arXiv:2510.01237
- 本站相关解读:TypeSafe Jev 与 System One Model 品类、自己动手造一个 Jev 级决策模型
原文来源:ModelScope Community (WeChat)https://mp.weixin.qq.com/s/9SJf3nhK25rZcZwQNTg7mw