PAPER DEEP DIVE
HIL-UMI:把 VLA 人在环后训练搬离机器人本体
HIL-UMI 用手持 UMI 夹爪做人机在环 VLA 后训练:人在演示时,同一观测流上并行跑当前策略但不执行其预测,用 Energy Score 比较人类动作块与策略动作分布,超阈值即判为分布外(OOD)并触发定点采集;另一条回路上,在线优势预测偏低的片段被收来重训基于任务进度的优势估计器,再由它给数据打二元优势标签做优势条件行为克隆(ACBC)。四个真机任务上持续优于 SFT,Stack Cube 三轮后 TPS 84→100;对比真机 HG-DAgger,Clean Up Table 每帧采集时间 73.40ms 对 412.99ms,快 5.63 倍且末轮 TPS 高约 5 分。
论文元信息
| 项目 | 内容 |
|---|---|
| 标题 | HIL-UMI: Bringing Human-in-the-Loop Post-Training of Vision-Language-Action Models to Universal Manipulation Interface |
| 作者 | Zimu Han, Yiming Zeng, Jiyao Zhang, Zihao Zhao, Yuanfei Wang, Yixiang Jin, Shiqi Li, Shuangben Chen, Wei Huang, Ruodai Li, Hui Shen, Hao Dong(通讯作者) |
| 机构 | 北京大学、西安交通大学、京东科技(JD Technology)、PrimeBot |
| 提交 | 2026-09-17,arXiv:2609.20659(cs.RO) |
| 链接 | arXiv 摘要页 · arXiv 全文 · 项目页 |
| 代码状态 | 未开源。项目页为纯前端渲染、未挂代码入口;以标题与作者名检索 GitHub 亦无实现仓库,本文未提供公开代码 |
| 硬件平台 | 采集端为自制手持 UMI 设备(AgiBot OmniPicker 夹爪 + Meta Quest 3 手柄/头显 + RealSense D405 腕部相机 + D455 第三人称相机);评测端为 Franka Panda 机械臂;在线推理用单张 RTX 4090D |
一句话总结
HIL-UMI 把人在环(human-in-the-loop)VLA 后训练从机器人本体上搬下来:人手持 UMI 夹爪演示时,当前策略在同一观测流上并行做 $N=10$ 次随机推理但不执行其预测,用 Energy Score 度量人类动作块与策略动作分布的分歧、超过阈值即判定分布外(OOD)并触发定点采集;另一条回路把"优势估计器低估进度"的片段收为硬样例迭代重训优势模型,最后在新旧混合数据上做优势条件行为克隆(ACBC)。四个真机任务上它持续优于 SFT,Stack Cube 三轮后 TPS 从 84 升到 100,而每帧采集耗时 73.40ms,只有真机 HG-DAgger(412.99ms)的 1/5.63。
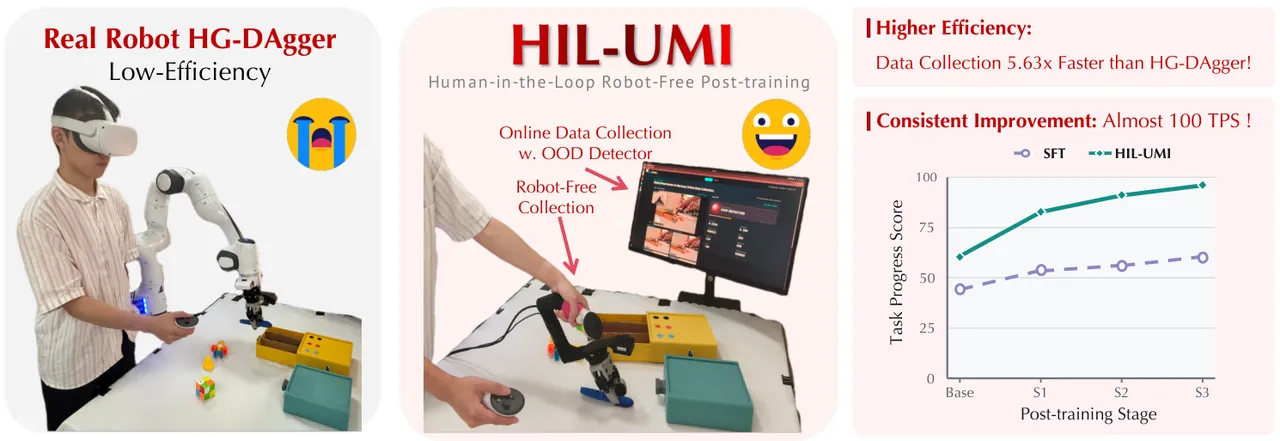
图 1:论文 teaser。左侧真机 HG-DAgger 需要策略在机器人上 rollout 并由人接管干预,采集效率低;中间 HIL-UMI 用在线 OOD 检测器做策略引导的无机器人采集;右侧给出两条 headline 结果:采集快 5.63 倍、Clean Up Table 上 TPS 接近 100。
研究背景与动机
大规模视觉-语言-动作(VLA)模型从多样化的机器人数据与视觉-语言数据中获得了宽泛的操作先验,是下游机器人学习的强初始化。但"宽泛的能力"不等于"在具体部署中可靠":目标本体、观测布置、工作空间、动力学与所需精度都可能与预训练分布不同。任务级后训练因此是通用表征与真实闭环行为之间的关键桥梁,对长时序与高精度操作尤其如此——局部的微小误差会直接决定整任务成败。
当前主流的后训练范式是在真机上采任务演示、再做监督微调(SFT)。这条路线留下两个没有被解决的核心问题。其一是协变量偏移与误差复合:静态演示主要覆盖专家访问过的状态,策略一旦犯小错就会滑入演示未覆盖的区域,再多的"名义数据"也补不上这些由策略自身诱导出的 OOD 状态。其二是模仿目标的"平等主义":标准行为克隆对每条演示样本一视同仁,不区分哪些片段真正推动了任务进度、哪些只是冗余的名义动作。
人在环后训练对这两个问题的回应更直接。DAgger 在学习者访问的状态上查询专家动作并并入训练集,直接扩展了对策略诱导状态的覆盖;HIL-SERL 等真机变体把实时人工干预接进强化学习;RECAP 则把演示、机器人自主经验与专家遥操作纠正一起纳入优势条件策略训练,同时解决覆盖与数据效用两个问题,并在困难真机任务上取得强结果。但这类方法的纠正信号最终仍依赖真机 rollout 或人工接管:硬件与操作员成本高、难以跨操作员与跨地点并行扩展,而遥操作本身也让长时序、高精度演示难以规模化采集。
Universal Manipulation Interface(UMI)提供了摆脱真机的另一条路:便携、低成本的手持夹爪直接记录与机器人兼容的观测与动作,人用手直接演示可以自然表达复杂而精确的行为,便携性又允许跨操作员、跨地点采集。FastUMI、MV-UMI、HiFi-UMI 等后续工作分别在硬件简化、第三人称视角与轨迹保真度上推进,HiFi-UMI 甚至证明仅用 UMI 数据的后训练可以逼近真机遥操作的水平。但它们的实时反馈针对的是传感与采集质量,而不是"当前策略的预测"——采集仍然围绕数据保真与一般覆盖,无法定向补策略自身的盲区。
HIL-UMI 正是要填这个空位:它让"人在环"的迭代性与策略感知性保留下来,同时把数据采集与机器人部署彻底解耦。人在手持 UMI 演示的同时,当前策略在同一观测流上预测动作(但不执行),人类演示与策略预测之间的分歧决定当前状态是否 OOD、是否值得在此追加数据。论文的三点贡献由此展开:一个把迭代式 VLA 后训练搬离机器人本体的 UMI 人在环框架;一个在采集过程中比较人类动作轨迹与策略轨迹分布的实时 OOD 检测方法,以及每轮更新优势模型并做 ACBC 的迭代工作流;以及在四个长时序或高精度真机任务上相对 SFT 的持续增益、相对 HG-DAgger 更高的性能与采集效率。
预备知识
UMI 的数据形态是理解全文的前提。操作员手持夹爪以 30Hz 记录同步的观测 $o_t$(腕部相机加第三人称相机)与人类动作块 $H_t=(h_{t,1},\ldots,h_{t,T})$;一条演示 $\tau_i=\{(o_{i,t},a_{i,t})\}_{t=0}^{L_i-1}$ 就是一条观测-动作序列。动作 $a_k=(p_k,R_k,g_k)$ 由末端位置、姿态旋转与夹爪命令三部分构成,这与 Franka 评测臂的动作空间同构,因此 UMI 数据可以直接用于机器人策略训练。
第二个前提是策略的"可采样性"。本文基座策略采用开源的 $\pi_{0.5}$,属于流匹配(flow-based)VLA:给定观测与指令,它可以随机采样出多条动作块轨迹,而不是输出单一确定性动作或高斯分布。这意味着"策略的动作分布"可以用经验样本近似,但也意味着没有解析似然可用——后文选择 Energy Score 而非似然比做 OOD 判据,正是出于这一点。
第三个前提是优势条件行为克隆(ACBC)与"两观测优势估计器"。RECAP 一系的工作表明,把"这条数据好不好"显式写进条件(prompt 里附加正/负优势标签),策略就能在训练时利用次优数据、在推理时偏向高优势行为。本文沿用这一思想,但把优势来源换成一个回归器 $f_\psi(o_u,o_v,c)$:输入相隔若干帧的两个观测与指令,直接预测从 $o_u$ 到 $o_v$ 的相对任务进度,避免"两次独立预测再相减"带来的误差复合。
方法详解
总体循环与基座初始化
记任务指令为 $c$,初始 UMI 数据集为 $\mathcal{D}_0=\{\tau_i\}_{i=1}^M$。后训练以轮次 $r=1,\ldots,R$ 推进,每轮为两个目的各自采集一份新数据:$\mathcal{D}_r^A$ 用于 refine 优势估计器,$\mathcal{D}_r^P$ 用于改进策略,且两条采集流分配相等的帧预算,即 $|\mathcal{D}_r^A|=|\mathcal{D}_r^P|$。轮次开始之前先做基座初始化:给 $\mathcal{D}_0$ 赋进度目标、训练出 $f_{\psi_0}$,再用 $f_{\psi_0}$ 给同一批数据打二元优势标签,直接以 ACBC 得到基座策略
$$\theta_0=\arg\min_\theta\ \mathbb{E}_{(o,a,b)\sim\mathcal{D}_0}\left[\ell_{\mathrm{BC}}\bigl(\pi_\theta(\cdot\mid o,c^b),a\bigr)\right], \qquad (1)$$
其中 $\ell_{\mathrm{BC}}$ 是策略原生的动作预测损失,$b$ 是优势标签,$c^b$ 是附加了标签的指令。注意这一步只用了基座数据:它决定了 HIL-UMI 的"起点"本身就不是普通 SFT,而是优势条件克隆(后文图 5 中 HIL-UMI 的 Base 点高于 SFT 正源于此)。每轮的内部顺序是:先在线跑 $f_{\psi_{r-1}}$ 采 $\mathcal{D}_r^A$;再让 $\pi_{\theta_{r-1}}$ 与人类 UMI 演示并行运行、在策略动作分布被判为 OOD 的片段采 $\mathcal{D}_r^P$;然后在平衡混合集上从 $\psi_{r-1}$ 继续训练得 $\psi_r$;最后用 $f_{\psi_r}$ 构造带优势标签的训练集、从 $\theta_{r-1}$ 继续 ACBC 得 $\theta_r$。
策略 OOD 采集:用 Energy Score 比较人与策略
论文对 OOD 的操作化定义是"模型训练数据中表征不足的任务情境",并用"模型预测与人类演示的不一致"来标记它:人类动作块与策略预测动作分布分歧过大,或演示明明在推进任务而优势预测却偏低。策略侧的采集发生在观测 $o_t$ 处:操作员产出人类动作块 $H_t$ 的同时,系统在同一观测与指令下做 $N=10$ 次随机策略推理
$$A_t^{(n)}\sim\pi_{\theta_{r-1}}(\cdot\mid o_t,c),\qquad n=1,\ldots,N, \qquad (2)$$
作为策略动作块分布的经验近似。采样与 UMI 采集并发进行,但比较只在一个人类动作块完整观测之后才做。比较的度量是动作块距离:把第 $k$ 个动作写成 $(p_k,R_k,g_k)$ 后,在统一坐标系下定义
$$\rho^2(A,B)=\frac{1}{T}\sum_{k=1}^T\left[\lambda_p\lVert p_k^A-p_k^B\rVert_2^2+\lambda_R\,d_R(R_k^A,R_k^B)^2+\lambda_g\lVert g_k^A-g_k^B\rVert_2^2\right], \qquad (3)$$
其中姿态差异用 $\mathrm{SO}(3)$ 上的测地距离
$$d_R(R_1,R_2)=\arccos\!\left(\frac{\operatorname{tr}(R_1^\top R_2)-1}{2}\right). \qquad (4)$$
系数取 $(\lambda_p,\lambda_R,\lambda_g)=(0.5,0.25,0.25)$。有了点到点的距离,再用经验 Energy Score 度量"单个人类动作块"与"策略样本分布"之间的分歧:
$$\operatorname{ES}(H_t)=\frac{1}{N}\sum_{n=1}^N\rho\bigl(A_t^{(n)},H_t\bigr)-\frac{1}{2N(N-1)}\sum_{n\neq m}\rho\bigl(A_t^{(n)},A_t^{(m)}\bigr). \qquad (5)$$
第一项是策略样本到人类动作的平均距离,第二项是策略样本自身的离散度修正。二者相减使判据不会退化成"平均逐点误差":策略分布过散时,样本到人的距离被抬高;分布塌缩到远离人类动作的一点时,又拿不到多样性折扣。它既不需要高斯假设、也不需要显式似然,因此天然适配流匹配策略。Energy Score 大,说明人类解法落在策略预测分布之外,该状态区域即被操作化地视为 OOD。于是 HIL-UMI 的策略 OOD 检测器为
$$\delta_t^P=\mathbb{I}\!\left[\operatorname{ES}(H_t)>\tau_P\right], \qquad (6)$$
阈值 $\tau_P$ 跨所有任务共享。一旦某个完整动作块触发 $\delta_t^P=1$,操作员就从当前状态开始录一段专家演示、直到当前子任务完成;重复这一过程得到 $\mathcal{D}_r^P$。整个更新因此被集中在"当前策略的动作分布覆盖不到人类解法"的状态上,而全程不需要执行策略。
优势 OOD 采集:收"被低估的进步"
第二条采集流针对优势估计器本身。轮次 $r$ 中,只要 $t\geq K$,就用上一轮估计器对相隔 $K$ 帧的观测对估计相对任务进度:
$$\widehat{A}_t^{\mathrm{online}}=f_{\psi_{r-1}}(o_{t-K},o_t,c),\qquad \delta_t^A=\mathbb{I}\!\left[\widehat{A}_t^{\mathrm{online}}<\tau_A\right]. \qquad (7)$$
$\tau_A$ 按任务用初始估计器 $f_{\psi_0}$ 校准:在基座数据 $\mathcal{D}_0$ 上评估相隔 $K$ 帧的观测对,取经验分位点 $\kappa_0$ 为预测优势前 $\eta$ 比例($\eta=0.3$)的截断值——该截断同时用于基座数据的优势打标——然后令 $\tau_A=\kappa_0/2$,使采集阈值自适应不同任务在固定时间间隔下的进度尺度。其语义是:假设操作员正在演示推进任务的行为,那么预测值低于校准阈值的片段,就是估计器"可能低估了任务进度"的地方,即优势模型的硬样例。触发后同样从当前状态录到子任务结束,得到 $\mathcal{D}_r^A$。
优势模型:线性进度目标与片段化回归
$f_\psi(o_u,o_v,c)$ 直接回归从 $o_u$ 到 $o_v$ 的相对进度,而不是两次独立预测相减,以此压低估计的复合误差。为同时容纳完整的基座 episode 与后训练轮次里"到子任务结束即截断"的片段,论文设计了线性进度目标。基座 episode 的进度为
$$z_{i,t}=\frac{t}{L_i-1},\qquad t=0,\ldots,L_i-1, \qquad (8)$$
并记基座 episode 的平均长度 $\overline{L}_0=\frac{1}{M}\sum_{i=1}^M L_i$(式 9)。迭代片段 $\sigma_{r,j}$ 长度 $L_{r,j}$ 只覆盖一个子任务,若仍赋 $[0,1]$ 的全程进度会高估其贡献,因此改为
$$z_{r,j,t}=\frac{t}{L_{r,j}-1}\cdot\frac{L_{r,j}}{\overline{L}_0},\qquad t=0,\ldots,L_{r,j}-1, \qquad (10)$$
使片段只跨越 $0$ 到 $L_{r,j}/\overline{L}_0$ 的进度区间,时间进度尺度与基座数据保持一致。训练时从同一条轨迹或片段中均匀采两个不同帧 $u,v$,带符号的回归目标为 $y_{u,v}=z_v-z_u$,并在多个时间跨度上优化均方损失
$$\mathcal{L}_A(\psi)=\mathbb{E}_{(o_u,o_v,y_{u,v})}\left[\bigl(f_\psi(o_u,o_v,c)-y_{u,v}\bigr)^2\right]. \qquad (11)$$
数据混合与两个模型的轮次更新
为平衡本轮硬样例与历史数据,论文定义混合算子
$$\operatorname{Mix}(\mathcal{D}_{\mathrm{new}},\mathcal{D}_{\mathrm{hist}})\triangleq\alpha\cdot\operatorname{Unif}(\mathcal{D}_{\mathrm{new}})+(1-\alpha)\cdot\operatorname{Unif}(\mathcal{D}_{\mathrm{hist}}), \qquad (12)$$
其中 $\operatorname{Unif}(\cdot)$ 表示均匀采样,$\alpha$ 取 0.5。优势估计器的训练集为 $\widetilde{\mathcal{D}}_r^A=\operatorname{Mix}\bigl(\mathcal{D}_r^A,\bigcup_{j<r}\mathcal{D}_j^A\bigr)$(式 13),从 $\psi_{r-1}$ 继续最小化式 (11) 得 $\psi_r$。策略侧的训练集对称地取 $\widetilde{\mathcal{D}}_r^P=\operatorname{Mix}\bigl(\mathcal{D}_r^P,\bigcup_{j<r}\mathcal{D}_j^P\bigr)$(式 14)。标签由更新后的估计器给出:它对 $\mathcal{D}_0$ 中每个合格样本在相同未来视野上打分
$$\widehat{A}_{r,t}=f_{\psi_r}(o_t,o_{t+K},c),\qquad t+K<L, \qquad (15)$$
再按基座数据取前 $\eta$ 分位截断 $\kappa_r$ 打二元标签:
$$b_{r,t}=\begin{cases}\mathbb{I}[\widehat{A}_{r,t}\geq\kappa_r], & (o_t,a_t)\in\mathcal{D}_0,\\[4pt] 1, & (o_t,a_t)\in\bigcup_{j=1}^{r}\mathcal{D}_j^P.\end{cases} \qquad (16)$$
即基座样本始终沿用"前 $\eta$ 为正、其余为负"的阈值规则,而所有新采的策略数据一律给正标签——它们本就是针对策略盲区采来的纠正信号。轮次 $r$ 的策略目标即
$$\mathcal{L}_{\mathrm{ACBC}}(\theta)=\mathbb{E}_{(o,a,b)\sim\widetilde{\mathcal{D}}_r^P}\left[\ell_{\mathrm{BC}}\bigl(\pi_\theta(\cdot\mid o,c^b),a\bigr)\right]. \qquad (17)$$
训练从 $\theta_{r-1}$ 继续,推理时使用正优势 prompt 以偏向推进任务的行为;更新后的 $\theta_r$ 与 $\psi_r$ 进入下一轮采集。工程上,两条 OOD 检测都在单张 RTX 4090D 上实时运行:策略 OOD 检测器把 $N$ 次随机采样并行化,延迟 112ms;优势 OOD 检测器延迟 93ms,足以支撑人在环的采集节奏。
flowchart TD
  subgraph S0["初始化 r=0"]
    D0["基座 UMI 演示 D0
线性进度目标 式8"] --> F0["训练优势估计器 f_psi0
回归 式11"]
    F0 --> B0["基座数据取前 eta=0.3 打二元标签
式16"]
    B0 --> T0["ACBC 得基座策略 theta0
式1"]
  end
  subgraph S1["轮次 r 的在线采集 Sec III-A"]
    AC["优势回路 f_psi r-1 评分 o_t-K 与 o_t
低于 tau_A 视为低估进度 录片段 式7"]
    PC["策略回路 N=10 次随机推理 式2
Energy Score 高于 tau_P 判 OOD 录制 式5 式6"]
  end
  subgraph S2["轮次 r 的模型更新"]
    AU["Mix 新+旧 继续训练优势估计器
式12 式13 得 psi_r"]
    PU["f_psi_r 重打标 混合数据上 ACBC
式14 至 式17 得 theta_r"]
  end
  T0 --> AC
  AC --> PC
  PC --> AU
  AU --> PU
  PU --> NX["theta_r 与 psi_r 进入轮次 r+1"]
  NX --> AC
图 2 对应的流程重绘:HIL-UMI 每轮先跑优势 OOD 采集、再跑策略 OOD 采集,随后依次更新优势估计器与策略(论文 Fig. 2)。
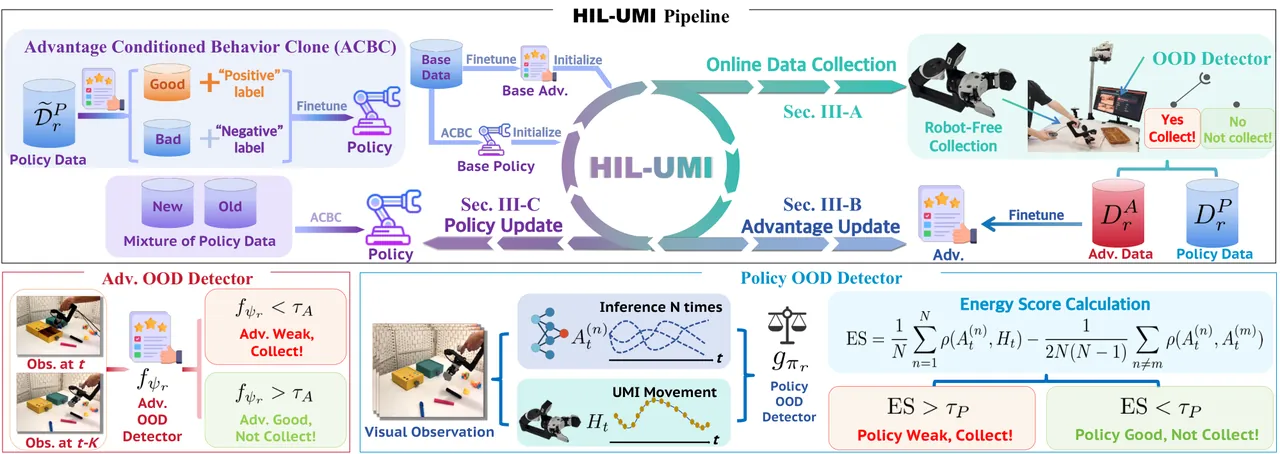
图 2:论文原图总览。上半环为"在线采集 → 优势更新 → 策略更新"的轮次循环,下半栏拆开两个检测器:优势检测器比较 $o_{t-K}$ 与 $o_t$ 的预测进度与 $\tau_A$,策略检测器用 $N$ 次推理与人类动作块 $H_t$ 计算 Energy Score 并与 $\tau_P$ 比较。
实验结果
任务、硬件与评测协议
采集端是自制的 UMI 设备(图 3):AgiBot OmniPicker 夹爪经定制连接件与 Meta Quest 3 手柄耦合,Quest 3 的头显-手柄追踪系统实时测量设备位姿,给出在线 OOD 检测所需的人类动作轨迹;RealSense D405 装在设备上采腕部视角,RealSense D455 提供固定第三人称视角,采集频率 30Hz。评测端统一为单条 Franka 臂,四个任务覆盖长时序与高精度两类(图 4):Fold Towel 要求把随机初始化的毛巾抹平、折两次并放入篮中;Clean Up Table 是家务式长时序任务——开黄抽屉、把三支笔放入颜色匹配的槽、关抽屉,再开蓝抽屉、收三个玩具、关抽屉;Stack Cube 抓紫立方叠到红立方上;Stamp 抓印章并对准纸上标记框,标记框长宽只比印章本体大 1cm。
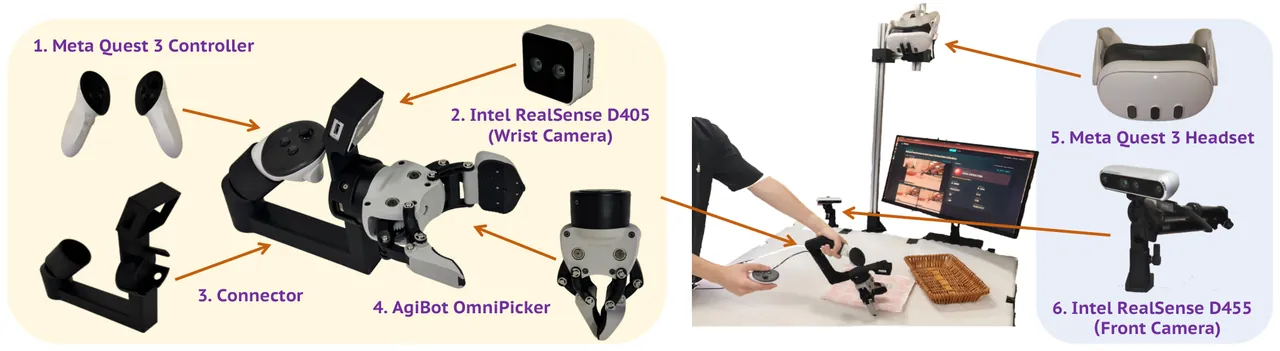
图 3:硬件组成。左:Quest 3 手柄、RealSense D405、定制连接件、AgiBot OmniPicker 夹爪的装配关系;右:采集现场,含 Quest 3 头显与 RealSense D455 第三人称相机。
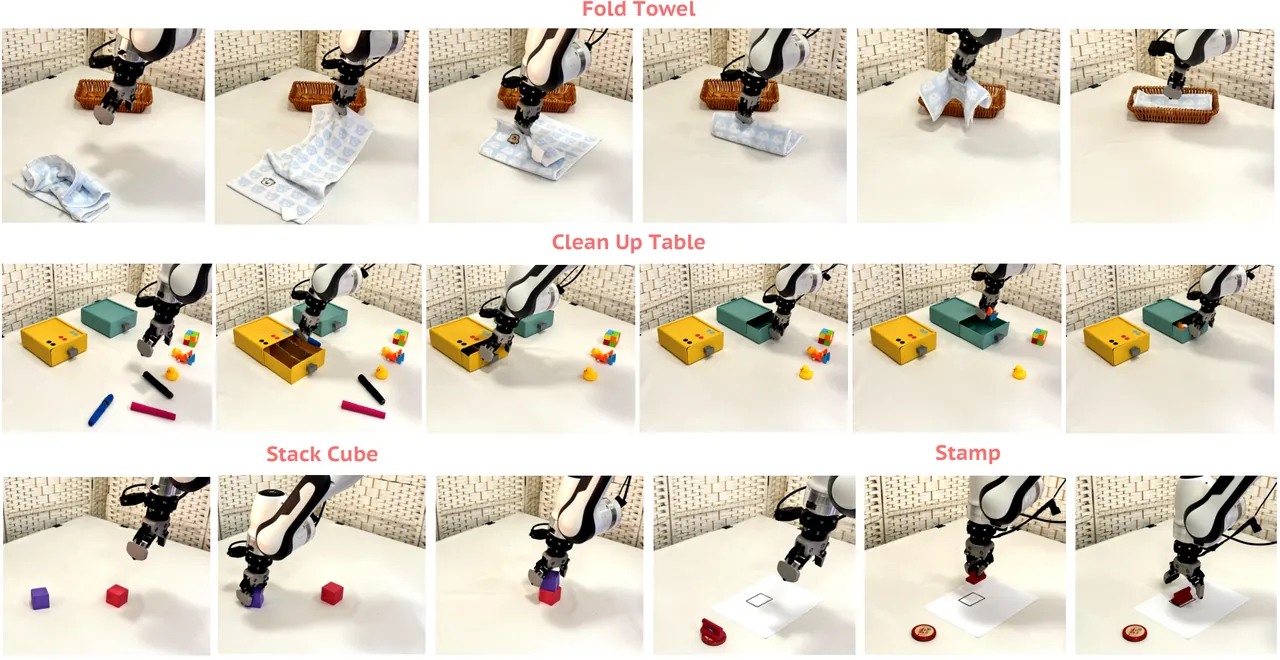
图 4:四个真机任务在 Franka Panda 上的执行序列:Fold Towel、Clean Up Table、Stack Cube、Stamp。
评测协议上,每个策略 checkpoint 在每个任务上跑 10 次试验,每次试验在 30cm × 60cm 工作空间内改变物体初始摆放以考察空间泛化;指标为 Task Progress Score(TPS),按预定义子任务给部分学分、满分 100,打分明细见表 1(例如 Fold Towel 每完成一个子任务 +25,毛巾起皱或错位每个子任务扣 5 分;Stack Cube 只抓住立方一个角扣 15 分)。
| 任务 | 子任务 | 分值 |
|---|---|---|
| Fold Towel | 抹平毛巾 / 完成第一次折叠 / 完成第二次折叠 / 放入篮中 | 各 +25 |
| Clean Up Table | 笔放入颜色匹配槽 ×3 / 收玩具 ×3 / 正确开抽屉 ×2 / 正确关抽屉 ×2 | 各 +10 |
| Stack Cube | 抓住紫立方 / 移到红立方附近 / 叠放到红立方上 | +30 / +30 / +40 |
| Stamp | 抓印章 / 移到标记框附近 / 姿态对准 / 印面接触纸 / 本体入框 | 各 +20 |
表 1:TPS 打分明细(论文 Table I)。
训练配置与数据预算
基座策略为开源 $\pi_{0.5}$。长时序任务(Fold Towel、Clean Up Table)基座数据 50 条演示、每轮新采预算 12000 帧;高精度任务(Stack Cube、Stamp)基座 80 条、每轮 2500 帧。SFT 基线在相同预算下采普通 UMI 演示做监督微调。共享实现配置见表 2:输入 224×224、动作视野 20、AdamW、策略学习率 1e-5、优势学习率 5e-5、余弦调度、warmup 500 步、batch 128、权重衰减 1e-10、每轮 5000 步;在线采集与 ACBC 侧 $N=10$、$(\lambda_p,\lambda_R,\lambda_g)=(0.5,0.25,0.25)$、$K=50$、$\alpha=0.5$、$\eta=0.3$。
| 超参数 | 取值 |
|---|---|
| 输入分辨率 / 动作视野 | 224×224 / 20 |
| 优化器 / 调度 | AdamW / 余弦,warmup 500 步 |
| 策略 / 优势学习率 | 1e-5 / 5e-5 |
| batch / 权重衰减 / 每轮步数 | 128 / 1e-10 / 5000 |
| 随机采样数 N / Energy Score 权重 | 10 / (0.5, 0.25, 0.25) |
| 优势评估间隔 K / 混合比 α / 正优势比例 η | 50 / 0.5 / 0.3 |
表 2:实现超参数(论文 Table II)。
主结果:同预算下 HIL-UMI 持续拉开差距
图 5 在相同每轮数据预算下比较 SFT、去掉优势模块的 HIL-UMI(w/o Adv.,把 ACBC 换成在混合数据上的普通微调)与完整 HIL-UMI。读图可以得到三层信息。第一,起点就不同:HIL-UMI 的 Base 点(式 1 的 ACBC 基座)在多数任务上已高于 SFT 的 Base——Stack Cube 上为 84 对约 48(与表 3 的 Base 列一致),Stamp 上约 75 对约 56——说明仅"用优势标签重读同一批基座数据"就已经带来增益。第二,轮次推进中 SFT 只有有限改善甚至短暂回退(Clean Up Table 的 SFT 曲线在 Iter2 到 Iter3 之间下行),而 HIL-UMI 四个任务单调上行,三轮后 Stack Cube 与 Stamp 达到 100、四任务平均约 95,SFT 平均停在约 59。第三,去掉优势条件后(w/o Adv.)曲线显著低于完整方法(Stack Cube 三轮 90 对 100、平均约 88 对约 95),因为它无法按效用区分数据、把推进任务的样例与次优样例同等对待。论文的解读是:单纯多采名义演示不足以覆盖当前策略会遇到的状态,而把预算集中在策略盲区、再用优势条件更新消化这些数据,才是同一采集预算下更有效的用法。
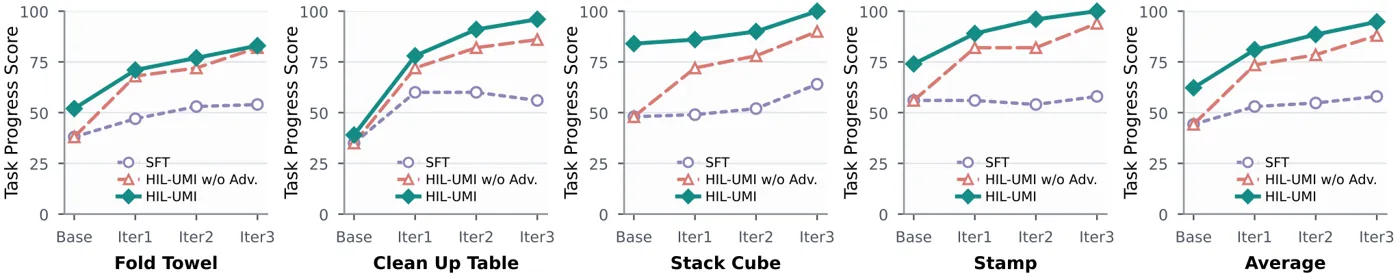
图 5:四个任务加四任务平均的 TPS 随后训练轮次变化(Base、Iter1–3),三条曲线为 SFT、HIL-UMI w/o Adv.、HIL-UMI(论文 Fig. 5)。
阈值消融:中等阈值最稳
表 3 在 Stack Cube 上固定一个阈值、变动另一个,考察两个在线触发器的敏感度,选定配置为 $(\tau_P,\tau_A)=(1.2,0.2)$。结果呈一致的"中间最好"形态:$\tau_P$ 过松(0.5)会收进策略本就与人类相当一致的低信息状态,三轮只到 90;过紧(2.0)漏掉有用的策略失败,三轮 96;$\tau_A$ 过松(0.3)引入冗余的优势 refine 数据、过紧(0.1)漏掉估计器错误,分别为 96 与 92。所有配置下 HIL-UMI 都优于 SFT,说明增益不依赖过度精调的阈值,而是覆盖与选择性的平衡。
| (τ_P, τ_A) | Base | Round 1 | Round 2 | Round 3 |
|---|---|---|---|---|
| (1.2, 0.2) | 84 | 86 | 90 | 100 |
| (2.0, 0.2) | 84 | 76 | 86 | 96 |
| (0.5, 0.2) | 84 | 80 | 72 | 90 |
| (1.2, 0.3) | 84 | 76 | 82 | 96 |
| (1.2, 0.1) | 84 | 82 | 82 | 92 |
表 3:Stack Cube 上在线采集阈值消融,TPS(论文 Table III)。
采集效率:每帧更贵,但每一帧都花在刀刃上
表 4 给出每帧采集耗时:HIL-UMI 在四个任务上都比 SFT 贵(Fold Towel 91.92 对 69.43ms、Clean Up Table 73.40 对 41.70ms、Stack Cube 89.89 对 77.04ms、Stamp 101.02 对 64.30ms),因为在线选择本身要等人完成一个被触发的子任务片段。但图 6(a) 把四任务平均 TPS 对累计采集时间作图后,HIL-UMI 的平均 TPS 稳步上行而 SFT 停滞甚至回退——额外开销被"围绕策略盲区采集、优先推进任务的监督"抵消。与真机 HG-DAgger 的对比更直接(图 6(b),Clean Up Table、相同每阶段预算):HIL-UMI 每个阶段 TPS 都更高、末阶段高出约 5 分;采集效率上 HG-DAgger 每帧 412.99ms,是 HIL-UMI 73.40ms 的 5.63 倍——避免机器人 rollout 的收益在此量化。
| 任务 | SFT (ms/帧) | HIL-UMI (ms/帧) |
|---|---|---|
| Fold Towel | 69.43 | 91.92 |
| Clean Up Table | 41.70 | 73.40 |
| Stack Cube | 77.04 | 89.89 |
| Stamp | 64.30 | 101.02 |
表 4:采集效率对比(论文 Table IV)。
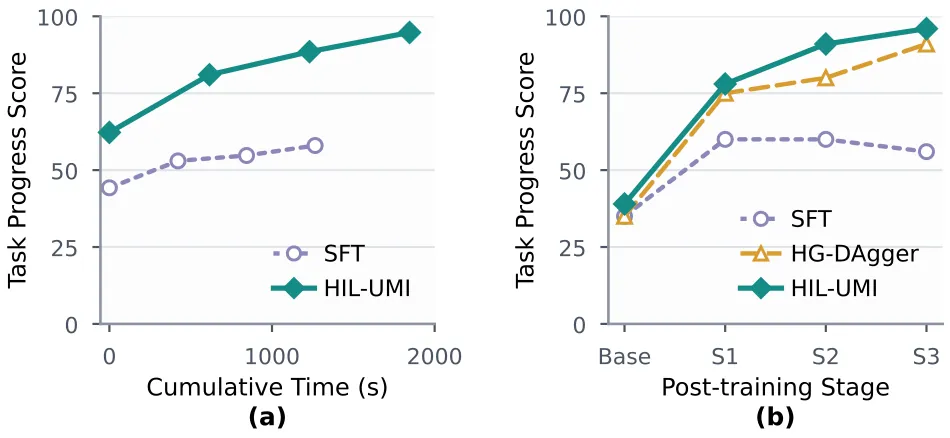
图 6:(a) 四任务平均 TPS 对累计采集时间,SFT 与 HIL-UMI;(b) Clean Up Table 上 SFT、HG-DAgger、HIL-UMI 随阶段(Base、S1–S3)的 TPS(论文 Fig. 6)。
局限性
其一,作者自述的边界是"单点采集":当前框架仍是一个操作员、一个地点顺序采集,论文把"跨地点并发采集的分布式后训练系统"列为未来工作。换言之,5.63 倍的每帧效率优势证明了"可以并行化"的潜力,但并行化本身(多操作员数据如何合并、阈值如何跨人校准)并未被验证。
其二,采集每帧更贵是设计内代价:表 4 中 HIL-UMI 的 ms/帧在四个任务上全部高于 SFT(最高 101.02 对 64.30)。论文用图 6(a) 的 TPS-时间曲线论证开销被抵消,但该论证建立在四任务平均与三轮以内的观测上;若任务的 OOD 触发极稀疏或极密集,单位时间的收益是否仍成立没有消融。
其三,从实验设计看,评测只覆盖单条 Franka 臂、四个任务与 $\pi_{0.5}$ 一个基座;UMI 的人类手部动作与机器人末端动作之间的本体差异(夹爪开合速度、力控、运动学极限)没有被显式建模,OOD 判据默认二者在同一动作空间可比。跨本体、跨基座策略的结论外推仍属开放问题。
其四,阈值与校准仍带手工成分:$\tau_P$ 跨任务共享但取值来自经验(消融只在一个任务上做),$\tau_A$ 需要按任务用基座数据校准 $\kappa_0$;优势估计器依赖视觉可辨的任务进度,对遮挡严重或进度难以从两帧观测判定的子任务(例如抽屉内部操作),回归目标本身就可能不可靠。此外每 checkpoint 每任务 10 次试验、TPS 为部分学分指标,与成功率口径的结论不宜直接互换。
总结与展望
HIL-UMI 的核心动作是一次"位置交换":把人在环后训练中原本发生在机器人 rollout 上的交互,搬到手持 UMI 的观测流上,用"策略预测 vs 人类演示"的分歧代替"策略执行 vs 人工接管"的交互。Energy Score 给了流匹配策略一个无需似然的分布级 OOD 判据,双回路采集把"策略盲区"与"优势模型盲区"分开定价,ACBC 与 Mix 算子则保证新旧数据在更新时不被互相淹没。四任务上相对 SFT 的持续增益、相对 HG-DAgger 的 5.63 倍采集效率,共同支撑了"后训练可以像数据采集一样分布式扩展"的论点。
这条路线的下一步也清楚:多操作员并发采集下的数据合并与阈值一致性、UMI 与机器人本体差距的显式建模、以及优势估计器在视觉进度模糊任务上的鲁棒性。若代码与采集协议随正式版本放出,HIL-UMI 的"策略引导采集"接口有可能成为 UMI 生态里继 HiFi-UMI 保真度之后的第二个标准组件。
金句
"This design preserves the iterative and policy-aware nature of human-in-the-loop learning while decoupling data collection from robot deployment."
(译:这一设计保留了人在环学习的迭代性与策略感知性,同时把数据采集与机器人部署解耦。——论文摘要)