Skip to content
← 标签

#模仿学习 (53)

SimpleVLN:不改架构释放原生多模态大模型的视觉语言导航能力

SimpleVLN:不改架构释放原生多模态大模型的视觉语言导航能力

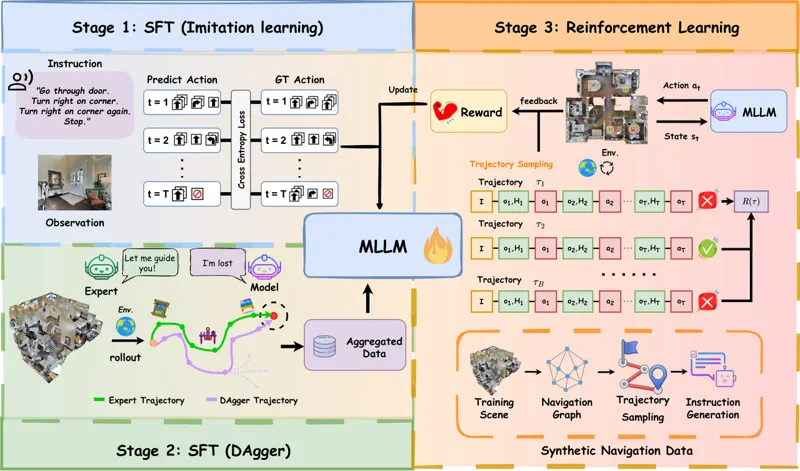
视觉语言导航(VLN)要求具身智能体把自然语言指令落到第一视角观测上并完成长程决策。现有方法大多靠任务专用结构补能力——全景拼接、3D 几何编码器、双系统分层决策——因此很难判断成绩里有多少来自 MLLM 本身。SimpleVLN 把问题反过来问:在引入任何任务专用模块之前,原生 MLLM 的导航潜力是否已经被榨干? 它的回答分三层。表述层:每次决策都重新构造一轮独立输入,即指令 + 当前观测 + 固定预算的全局-局部历史(默认全局 8 帧均匀采样、局部 1 帧),不再累积成越来越长的多轮对话;输出侧用动作块,一次推理给出多个基元动作(前进 0.25 m、左右转 15 度、停止)依次执行。数据层:R2R、RxR、ScaleVLN 的专家演示转成决策级监督样本,基于偏离度的 DAgger 在策略自己走到的状态上收集纠偏轨迹,RL 任务则在训练场景里自动合成新的起点-终点与指令。优化层:IL 到 DAgger 再到 RL 三段递进,RL 只用二值成功奖励(停在目标 3 m 内记 1 分),主结果用 DAPO 训 40 步。 只用单目 RGB、不改一行网络结构,Qwen3.5-9B 版在 R2R-CE 与 RxR-CE 的 val-unseen 上分别拿到 76.7% 与 80.1% 成功率,超过依赖全景、深度或里程计的现有方法;单次动作块决策耗时 293 ms。消融显示单轮输入把成功率从 35.7% 抬到 53.6%,DAgger 再贡献 7.5 与 8.1 个点。评测代码与八个权重已开源,并在 Daystar 四足机器人(Jetson Thor 机载)上完成真实环境验证。

Lingyi Hong, Weiren Cai, Jiayu Chen · 264次阅读 · 2026年10月16日
视觉语言导航具身智能
2026年10月16日
感知人形跑酷:通过动作匹配串联动态人类技能

感知人形跑酷:通过动作匹配串联动态人类技能

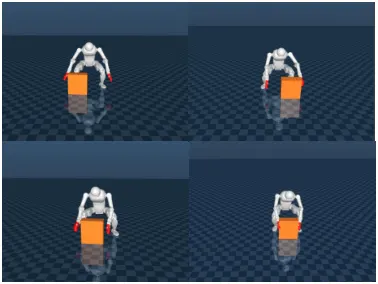
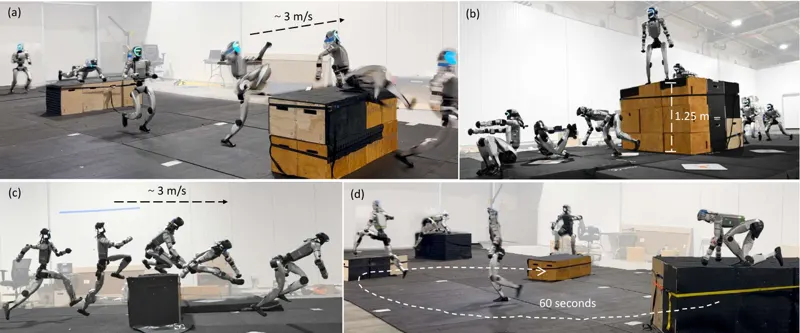
尽管人形机器人的运动控制近来已在多种地形上实现稳定行走,如何获得高动态人类动作那般的敏捷性与适应性,仍是一个开放问题。尤其是在复杂环境中的敏捷跑酷,不仅要求底层控制的鲁棒性,还要求类人的动作表现力、长时程的技能组合,以及由感知驱动的决策能力。本文提出感知人形跑酷框架 PHP(Perceptive Humanoid Parkour):一个模块化系统,使人形机器人能够在具有挑战性的障碍场地上自主完成长时程、基于视觉的跑酷。方法首先把动作匹配(motion matching)表述为特征空间中的最近邻检索,用它把重定向后的原子人类技能组合成长时程运动学轨迹;这一框架让复杂技能链既能灵活组合、又能平滑过渡,同时保留人类动态动作的优雅与流畅。随后,我们为这些合成动作训练基于动作跟踪的强化学习(RL)专家策略,并用 DAgger 与 RL 相结合的方式把它们蒸馏成单个基于深度图的多技能学生策略。关键在于,感知与技能组合的结合带来了自主的、随场景而变的决策能力:仅凭板载深度传感与一条二维速度指令,机器人就能自行判断应当跨过、爬上、撑越还是翻下几何形状与高度各不相同的障碍。我们在 Unitree G1 人形机器人上以大量真机实验验证该框架,展示了诸如攀爬最高 1.25 m(相当于机器人身高 96%)障碍这类高动态跑酷技能,以及在障碍被实时扰动时闭环适应的长时程多障碍穿越。

Zhen Wu, Xiaoyu Huang, Lujie Yang · 227次阅读 · 2026年2月17日
人形机器人跑酷
2026年2月17日
LoopWAM:从部署回放中闭环改进的通才机器人策略

LoopWAM:从部署回放中闭环改进的通才机器人策略

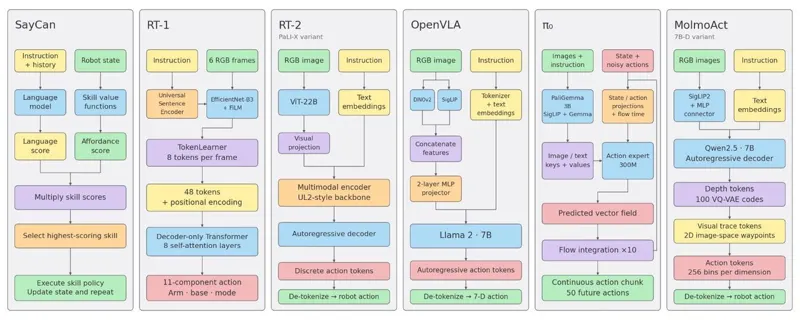
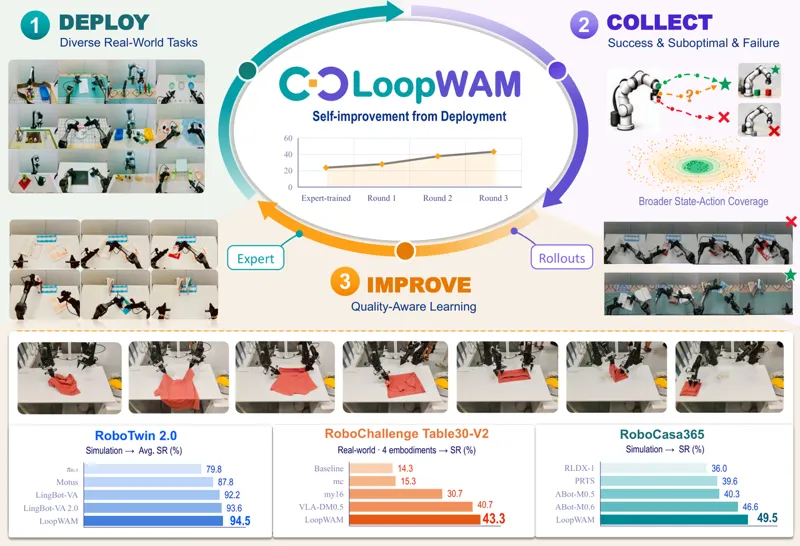
只堆专家示范,通才机器人策略并不会因为「上了真机」就变强:部署回放里既有成功,也有次优动作和彻底失败,逐个动作照抄会把坏行为一起学进去,而把失败样本直接丢掉,又丢掉了物理交互及其后果的证据。LoopWAM 是一个闭环的世界动作模型(world-action model),它直接从这份「全质量谱系」的回放里学习,回放既可以来自它自己,也可以来自别的已部署策略(X-VLA、π0.5)。方法上有三块互相咬合的设计:源相关噪声采样把行为学习与动作条件世界建模统一进同一个联合去噪目标——示范数据只对视频加噪、回放数据只对动作加噪,两条流在每一层的联合注意力里交互,学到的「后果」因此能直接参与动作生成;质量引导把质量分数写进指令后缀 Quality: q,部署时固定取最高档,使同一个模型既能被引导也能被评估;质量加权监督用 λ(q) 调节动作项的模仿强度(q=1,2 为 0.0,q=3 为 0.3,q=4 为 0.6,q=5 为 1.0),视频监督则在全质量段完整保留。模型由 Wan2.2-TI2V-5B 初始化,视频 DiT 30 层 3072 维、动作 DiT 30 层 1024 维,flow matching 训练。结果:RoboChallenge Table30-V2 上三轮「部署—采集—再训练」把成功率从 23.67% 拉到 43.33%(+19.7 个百分点),总分 36.10→56.80;RoboTwin 2.0 平均成功率 94.5%(用 LoopWAM、X-VLA、π0.5 三个策略共 22,500 条回放训练);RoboCasa365 总成功率 14.9%→49.5%,三项基准在对比方法中都是最好,且没有做额外的具身预训练。最难的叠衣服任务上,单任务后训练之后再跑两轮部署驱动改进,成功率从 13.20% 升到 55.56%。消融显示:完全不做质量引导只有 72.3%,粗粒度标注加上质量加权动作监督才到 94.5%。项目页 https://loop-wam.github.io/

Wenxuan Guo, Yingping Liang, Zhaoguo Wang · 364次阅读 · 2026年10月13日
世界动作模型自改进
2026年10月13日
PanTact:用可穿戴接触接口教会人形机器人全身灵巧性

PanTact:用可穿戴接触接口教会人形机器人全身灵巧性

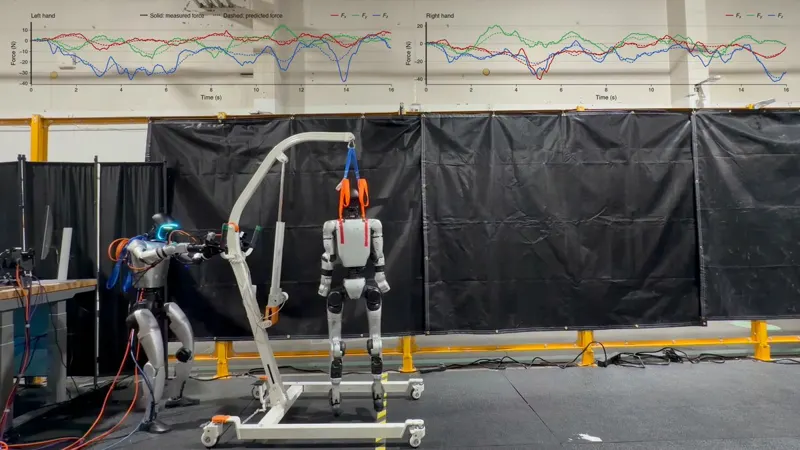
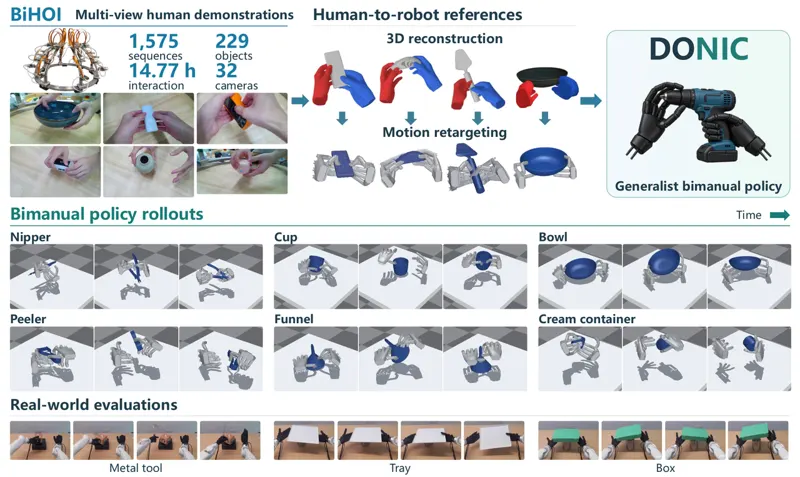
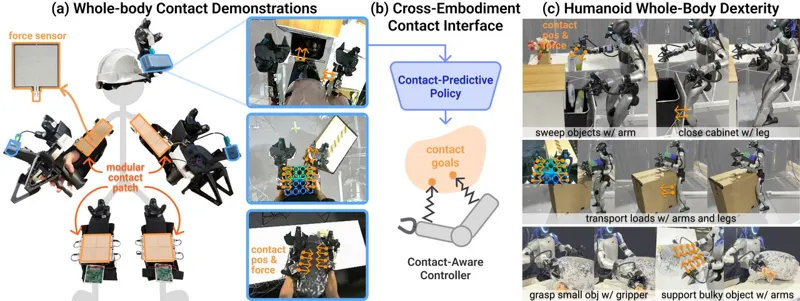
PanTact 把接触而不是关节轨迹当作人到机器人的迁移货币。可穿戴贴片由 44×44 mm 的 FSR 模块磁吸拼装,一块 50×50 mm 自研 PCB 以 1 kHz 同读 16 路,走带 CRC 的 RS-485 菊花链,每块贴片挂一个 Vive tracker 把传感器中心定位到世界系,接触状态按每通道自适应基线二值化,阈值 max(0.35β, r_min)。策略以身体遮蔽后的 3D 第一视角点云、双腕图像与本体感知为观测,10 Hz 预测 H=16 的动作块,内含 look-at 点、EEF 位姿与夹爪宽度、逐传感器接触目标(二值状态加 3D 位置)。控制器用软最小邻近距离 d(p,q)(T=0.02 m)把激活接触交给当前最近的机器人表面,并沿按压方向偏移 δ 形成虚拟目标以产生按压力,因此 G1 不装任何触觉传感器也能抱住物体。三种公式化实现各有代价:免训练的上身 IK、由 SONIC 执行稠密参考的 WBIK、PPO 在 4096 个仿真环境训 30k 迭代的稀疏接触跟踪器(50 Hz、29 关节、上身 8 / 全身 16 个接触槽)。29-DoF Unitree G1 实测:Grasp-and-Embrace 85%(上身 IK)与 80%(稀疏),Humanoid UMI 为 0;Sweep-and-Stow 端到端 90.63%,UMI++ 两阶段各 18.75%、端到端 0;Carry-and-Push 90% 对 40%。仿真回放消融显示加入接触目标后三种控制器接触距离都下降,EEF 精度几乎不受损。

Xu, Xiaomeng, Zhang, Han, Ruan, Zhian · 563次阅读 · 2026年10月8日
Whole-Body Manipulation触觉
2026年10月8日

MobileVISTA:生成式数据增强让移动操作扛住 15cm 站位偏差

MobileVISTA:生成式数据增强让移动操作扛住 15cm 站位偏差

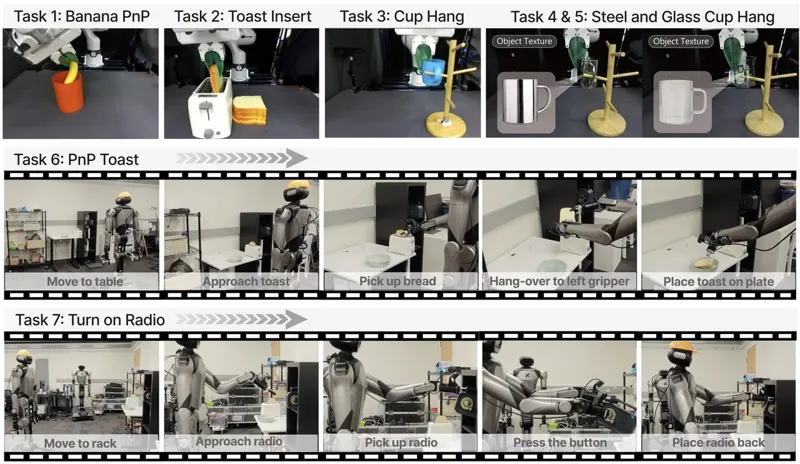
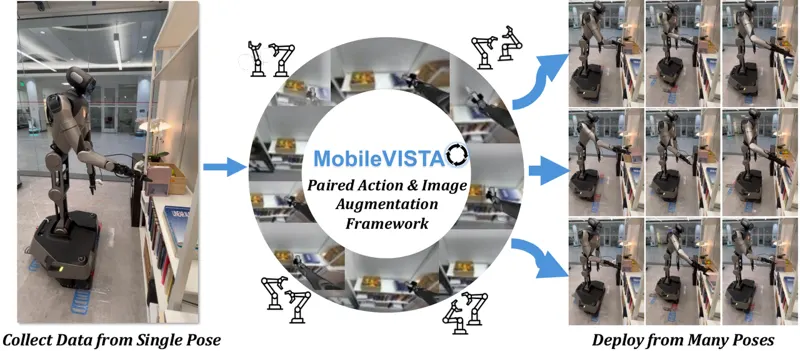
移动操作策略大多照着一个站位采的示范学出来,部署时底座偏几厘米,第一视角画面和末端轨迹就一起偏,成功率断崖式下滑。MobileVISTA 不重采数据,而是把已有示范「搬」到新站位。视觉侧先按 (r,θ)~(√u·15cm, 2πv) 采样盘面偏移与 ±5° 偏航,用天空盒掩码(仿真里 GR-1 标红、Franka 标黄;真机走 URDF 深度阈值 0.995 再膨胀 5px)把机器人抠掉,Open3D 反投影成点云、按相机外参升到世界系平移 Δp,再用重定向动作正运动学算出的新外参重投影,被遮挡的洞交给 E2FGVI 补,最后把机器人渲到新位置合成回去(仿真 512×512,真机 6× 上采样)。动作侧是闭式变换:p'_t=T⁻¹[p_t;1]、R'_t=R_inv_yaw·R(r_t)、夹爪原样透传,双臂绕中点偏航,再用 mink IK(FrameTask 1.0/1.0、PostureTask 1e-5、≤20 步)解回关节。数据量仿真 1:1(200→200)、真机 1:10(50→500)。GR-1 的 Can Sort 在 r=15cm 从微调 π0.5 的 0.320 提到 0.527,Pouring 0.460 对 0.013;双臂 Franka 的 Box 从基线最高的 0.087(DP3)提到 0.247,Drawer 0.413 反而高过仿真 oracle 的 0.393。真机 Book Stacking 随机站位抓到 17/25、放上书堆 13/25,三个基线只有 1-2/25。消融指向关键在「机器人几何随站位变」:只做动作变换几乎无增益(0.00-0.11),固定机器人几何会丢掉 Pouring +0.47、Can Sort +0.28、Box +0.24。补图质量 PSNR 也压过 GEN3C(Can Sort 25.02 对 16.29 dB),单帧耗时 2.39-4.31 分钟(L40S)对 GEN3C 的 13.65-16.85 分钟(H200)。

Wistreich, Suzannah, Tian, Stephen, Huang, Isabella · 320次阅读 · 2026年10月5日
移动操作Data Augmentation
2026年10月5日

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。