从 RT-1 到 MolmoAct 2:Vision-Language-Action 模型的演化史
从 SayCan、RT-1、RT-2 到 OpenVLA、π0 与 MolmoAct 2,梳理 VLA 演化中的动作表示取舍,并复现离散化实验。
引言
Vision-Language-Action 模型是我进入机器人学习社区、开始频繁使用 X 之后最常看到的概念之一。到了 2026 年,几乎每个关于机器人“GPT 时刻”的讨论都会提到它。让我感兴趣的是,机器人领域仍未就“究竟应该规模化什么”形成共识,研究者也在坚定押注不同路线,而 VLA 正是其中一条。
我想弄清这条路线是如何走到今天的:从 RT-1 到 MolmoAct 2,究竟发生了什么变化,又是哪些架构决策让这些系统真正工作起来。这篇文章会梳理这段演化、分析其中的取舍,并在途中加入一个小实验。更重要的是,它也是我更新自己机器人学习“世界模型”的一次尝试。
为什么我们需要 VLA?
假设机械臂正在执行一个抓取与放置任务,中途有人把箱子向左移动了两英寸。机械臂没有抓中,再试一次,还是失败,最后停了下来。
这不一定是传感器故障或标定问题。它暴露的是许多机器人系统的根本弱点:系统针对精确条件训练,条件稍有变化就会失效。机器人能看见,也能运动,却无法可靠地理解自己看到的内容,并据此决定下一步。
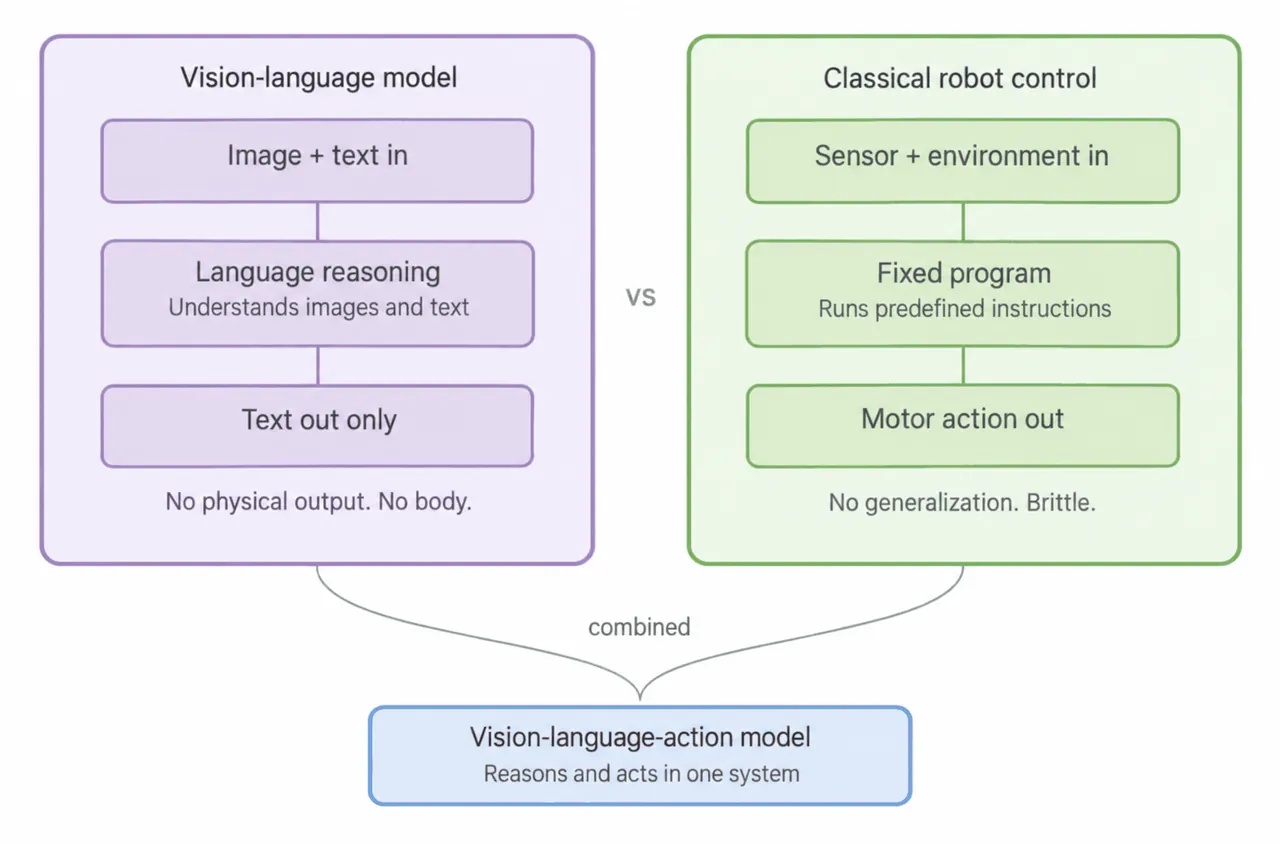
很长一段时间里,问题的两半各自都很有用,却没有真正连接起来。视觉语言模型已经变得相当强大。GPT-4V、Gemini 和 LLaVA 可以观察一张杂乱的桌面,回答杯子在哪里,或者指出少了什么。但它们无法伸手移动任何东西:
- 推理完全发生在模型内部。
- 输出没有连接到电机,也没有通往物理世界的接口。
- 它们擅长理解,却无法采取动作。
传统机器人控制则支撑工业自动化数十年。工业机械臂和抓放系统可以快速、精确且稳定,但能力范围通常很窄。一个系统往往只针对一项任务、一个环境以及一组特定条件编程或训练。物体移动几厘米、光照发生变化,或者场景中出现未见过的情况,系统就可能失效。
从这个意义上说,传统操作策略缺少泛化能力,因为它的行为更多是模式匹配,而不是对场景形成可迁移的理解。智能机器人需要泛化,而 VLA 提供了一条值得尝试的路径。
回头看,催生 VLA 的核心想法并不复杂:保留视觉语言模型的推理能力,再增加一种新的输出模态,也就是动作头。随后用机器人示范数据做端到端训练。早期结果显示,模型对场景的理解和指令跟随能力可以迁移到物理控制中,而且效果优于孤立的模仿学习策略。
什么是 Vision-Language-Action 模型?
简单来说,VLA 接收相机观测和自然语言指令,直接预测机器人命令。它用一套学习得到的策略替代原本彼此分离的感知、规划与底层控制模块。这样的架构可以泛化到训练中没有显式见过的条件,但泛化程度仍高度依赖模型、数据和后训练过程。
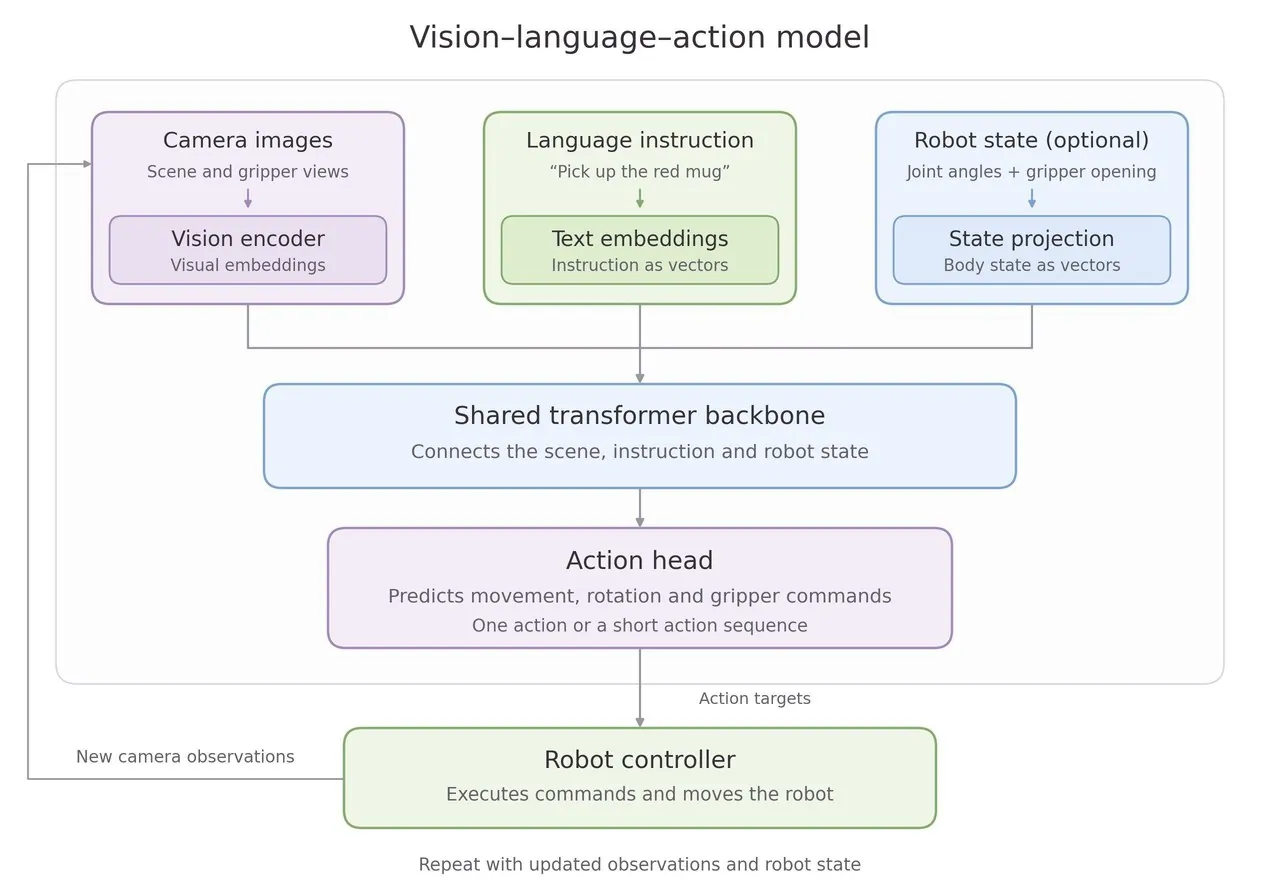
以一个红色杯子为例。你告诉机器人“拿起红色杯子”。相机图像经过视觉编码器,图像 patch 被转换为视觉特征 embedding;语言指令经过 tokenizer,变成文本 embedding。很多模型还会接收关节角、夹爪开合度等机器人状态,并将这些状态投影到同一套学习表示中。
随后,Transformer 将这些输入放在一起处理。对于“拿起红色杯子”这条指令,它会建立指令、图像中的杯子以及杯子相对夹爪的位置之间的联系。这种关系在模型内部形成,不需要在多个手工设计的模块之间传递。
动作头利用这些表示预测运动,例如夹爪位置、旋转和开合度如何变化。有些模型输出离散动作 token,有些直接输出连续值,也有模型使用 diffusion 或 flow matching。许多模型会一次预测未来多个动作,也就是 action chunk。
机器人控制器执行这些命令,获得新的图像和状态,再重复这一循环。训练时,VLA 通常从预训练 VLM 出发,使用包含图像、指令和对应动作的机器人示范来学习。示范的作用,是让模型学会如何把看到的场景和用户的要求连接到具体运动。
VLA 的简史
可乐罐演示
这可能是现代机器人学习中最具代表性的时刻之一。2023 年,Google 的一名研究者在桌上摆放了可乐罐,以及 Tom Cruise、Snoop Dogg 和 Taylor Swift 的照片,然后要求当时最新的机器人“大脑”RT-2 把可乐罐移到 Taylor Swift 的照片上。
RT-2 太大,无法直接在机器人本体上运行。机器人把机载相机图像一张一张传到 TPU 集群,集群再返回控制信号。由 RT-2 控制的机器人缓慢抓起可乐罐,动作并不流畅,但最终把它放到了 Taylor Swift 照片边缘。2025 年,团队成员 Karol Hausman 回忆说,正是那一刻让他确信这条路线会成功。
演示发生后不到一年,Hausman 和 RT-2 团队的许多核心成员离开 Google,组建了 Physical Intelligence。此后机器人能力有了明显提升。该公司后来的机器人“大脑”可以开挂锁、叠衣服、剥橙子、做烤奶酪三明治和咖啡,也能整理此前从未见过的卧室和厨房。
SayCan:用语言模型做任务规划
2022 年,也就是 ChatGPT 发布的那一年,Google 研究者开始探索大语言模型能为机器人做什么。最早的知名成果之一是 SayCan。它把 LLM 当作高层规划器,将复杂任务拆成子任务。例如清理洒出的液体时,SayCan 可以生成寻找海绵、拿起海绵、移动到液体旁等步骤。
当语言模型选择“拿起海绵”之后,另一个完全独立的神经网络会计算实际控制信号。这个网络通过模仿人类遥操作机器人完成各种小技能来训练。因此,SayCan 能做的只是从有限技能菜单中选择和排序,LLM 并没有学会将任意指令直接转换为运动的统一策略。
RT-1:学习统一的机器人策略
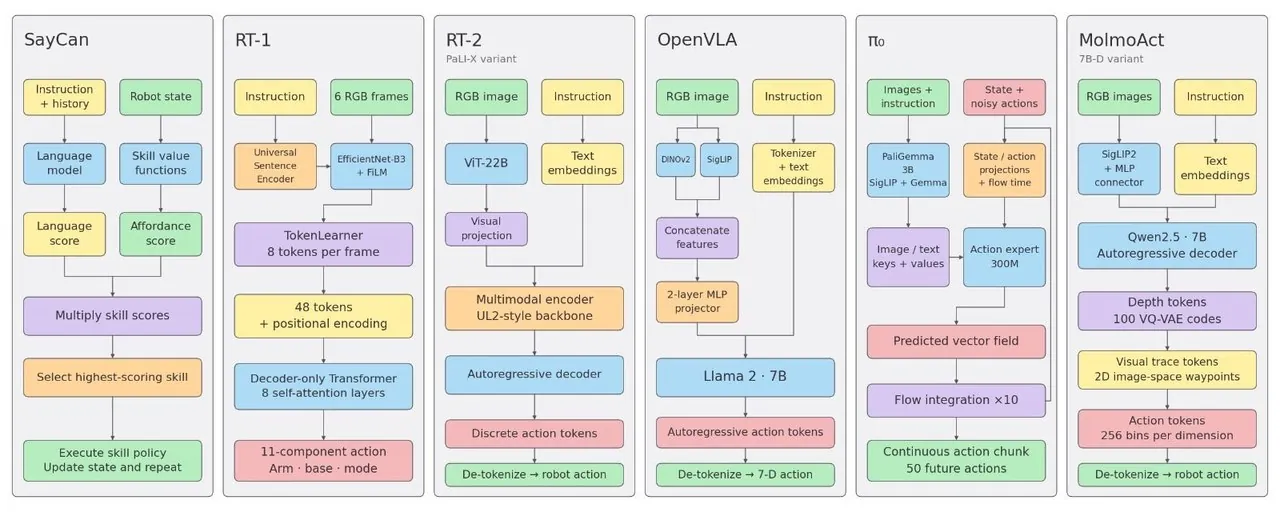
RT-1,也就是 Robotics Transformer 1,改变了这一点。Google Robotics 用超过 17 个月、来自 13 种机器人、覆盖 700 多项任务的 13 万条成功机器人 episode 训练它。核心思想是把自然语言指令和相机图像直接映射为离散动作 token,用于控制机械臂、底盘和模式选择。
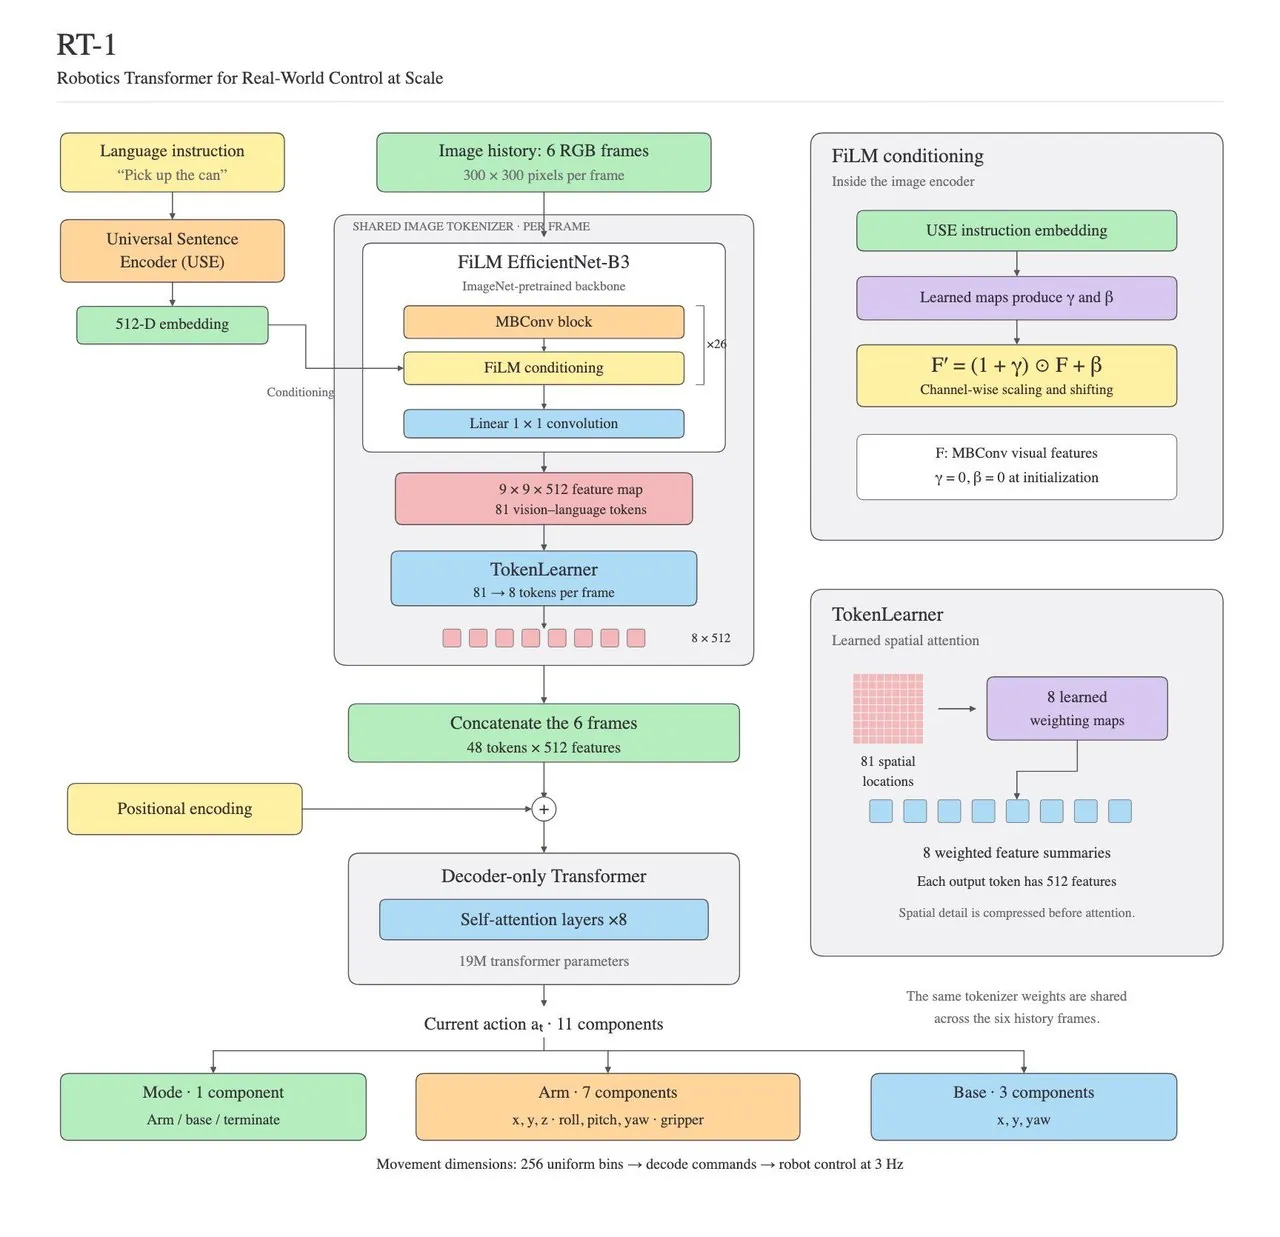
模型一次接收一条指令和六张图像,输出的动作共有 11 个分量:三维机械臂平移、三维机械臂旋转、一维夹爪命令、二维底盘平移、一维底盘旋转,以及一维模式选择,用于决定当前控制机械臂、底盘还是终止任务。
RT-1 由经过 FiLM 条件化的 EfficientNet、TokenLearner 和 Transformer 组成。语言首先通过 Universal Sentence Encoder 编码成固定长度向量。它不是执行显式推理的 LLM,而是为任务提供语义表示。
六张 300×300 图像分别经过 ImageNet 预训练的 EfficientNet-B3。编码器把每张图转换为 9×9 网格,每个位置对应一个 512 维特征向量,因此每帧有 81 个空间 token,六帧合计 486 个 token。
FiLM 条件化让指令能够改变视觉处理方式。语言 embedding 生成两组参数 gamma 和 beta,对视觉特征做缩放和变换。面对“打开抽屉”,模型可以更重视抽屉和把手;面对“拿起罐子”,则可以更重视罐子和夹爪。
直接对 486 个 token 做 self-attention 成本很高,所以 TokenLearner 把每帧的 81 个空间 token 压缩为 8 个学习得到的摘要。每个摘要都是整幅图像信息的加权组合:
$$z_k=\sum_i \alpha_{k,i}F_i$$
六帧因此变成 48 个 token,再送入具有八层 self-attention 的 decoder-only Transformer。完整模型约有 3500 万参数,其中 1900 万位于 Transformer 中。
Transformer 可以联合当前罐子的位置、前几帧中夹爪的位置、夹爪是否正在接近目标,以及指令要求完成什么。动作头最终输出离散 token。每个连续动作分量被分到 256 个 bin 中的一个,从而把控制问题转化为分类问题。RT-1 以约 3 Hz 运行:观察、预测一个动作、执行,然后重新观察。
训练采用 behavioral cloning。模型根据图像和指令学习复制专家的人类遥操作动作,数据包含 13 万条成功 episode 和 700 多种任务变化,如抓取物体、把物体放到彼此附近、打开或关闭抽屉。
RT-1 报告的成功率约为:训练中见过的任务 97%,未见指令 76%,存在视觉干扰物时 83%,全新背景 59%。成功率从 97% 降到 59%,说明扩大数据提升了鲁棒性,但环境泛化仍未解决。
RT-1 的主要贡献不是提出新的推理机制。它证明了一个单独的 Transformer 策略,可以用 behavioral cloning 覆盖大量不同的真实机器人任务,同时快到足以做闭环控制。SayCan 负责任务分解,RT-1 则用一个策略学会执行许多底层技能。
一个很有意思的结果是:减少任务种类,比单纯减少同一任务的重复示范数量,对泛化的伤害更大。这意味着看见大量不同行为,可能比在狭窄任务分布中收集海量重复演示更有价值。TokenLearner 也值得注意,因为它主动制造了信息瓶颈。策略因此更快,但它假设每帧八个摘要足以保留操作所需的全部信息。小物体和精细几何信息有可能在这一压缩过程中丢失。
实验一:动作离散化会损失多少信息?
RT-1 输出离散动作 token,因此每个连续命令都必须映射到有限集合中的一个值。为了理解这种舍入带来的信息损失,我从三组 LIBERO 示范中取出 843 个记录动作,把每个动作分量舍入到均匀网格,并比较每个维度使用 16、32、64、128 和 256 个值的版本。
正如预期,增加 bin 数量会降低重建误差。但还有另一个更重要的问题:这些 bin 应该覆盖多大的范围?可以把它想成在尺子上等距画刻度。刻度数量固定时,把尺子缩短,刻度会变得更密。范围内精度提高,但超出边界的值会被拒绝或裁剪。
我比较了两种版本:一种覆盖观测命令的完整范围,另一种只覆盖第 1 到第 99 百分位,超出范围的命令会被裁剪。图 5 给出了对应的平移 RMSE。
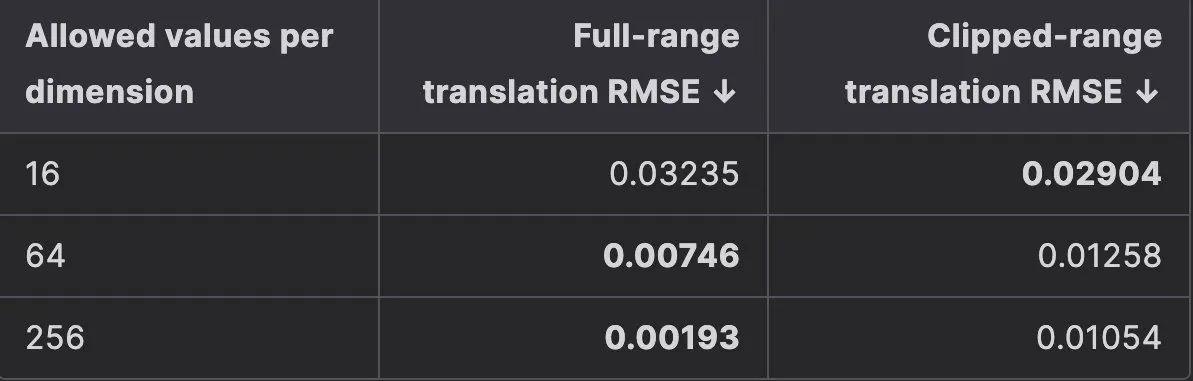
在 16 个 bin 时,裁剪稍有帮助,因为更细的刻度间距弥补了分布两端的信息损失。到 256 个 bin 时,完整范围的误差约低 5.5 倍。此时舍入本身已经很精细,拒绝极端值造成的损害反而超过了更高分辨率带来的收益。
我还检查了连续命令累积后会发生什么。单步误差更小,并不保证最终偏差更小,因为误差可能相互加强,也可能相互抵消。这个实验的关键结论是:动作分辨率同时取决于可用数值的数量和它们覆盖的范围。即便单步重建最好,也不必然意味着长时程行为会按比例改善。
RT-2:教视觉语言模型采取行动
RT-1 从机器人示范中学习,但它的语义知识基本局限于示范里出现的概念。经过网络数据训练的 VLM 已经知道更多,因为它们读过图像描述、视觉问答和语言数据。接下来的问题是:能否把已经理解图像和语言的 VLM 变成策略?
答案是肯定的。关键在于把动作当作另一种语言。VLM 接收一张图并回答“哪个物体是恐龙”,可以输出“绿色玩具”。RT-2 则被训练成接收图像和“拿起恐龙”,再输出类似“128, 91, 241, 5, 101, 127, 217”的序列,表示一条离散化机器人命令。
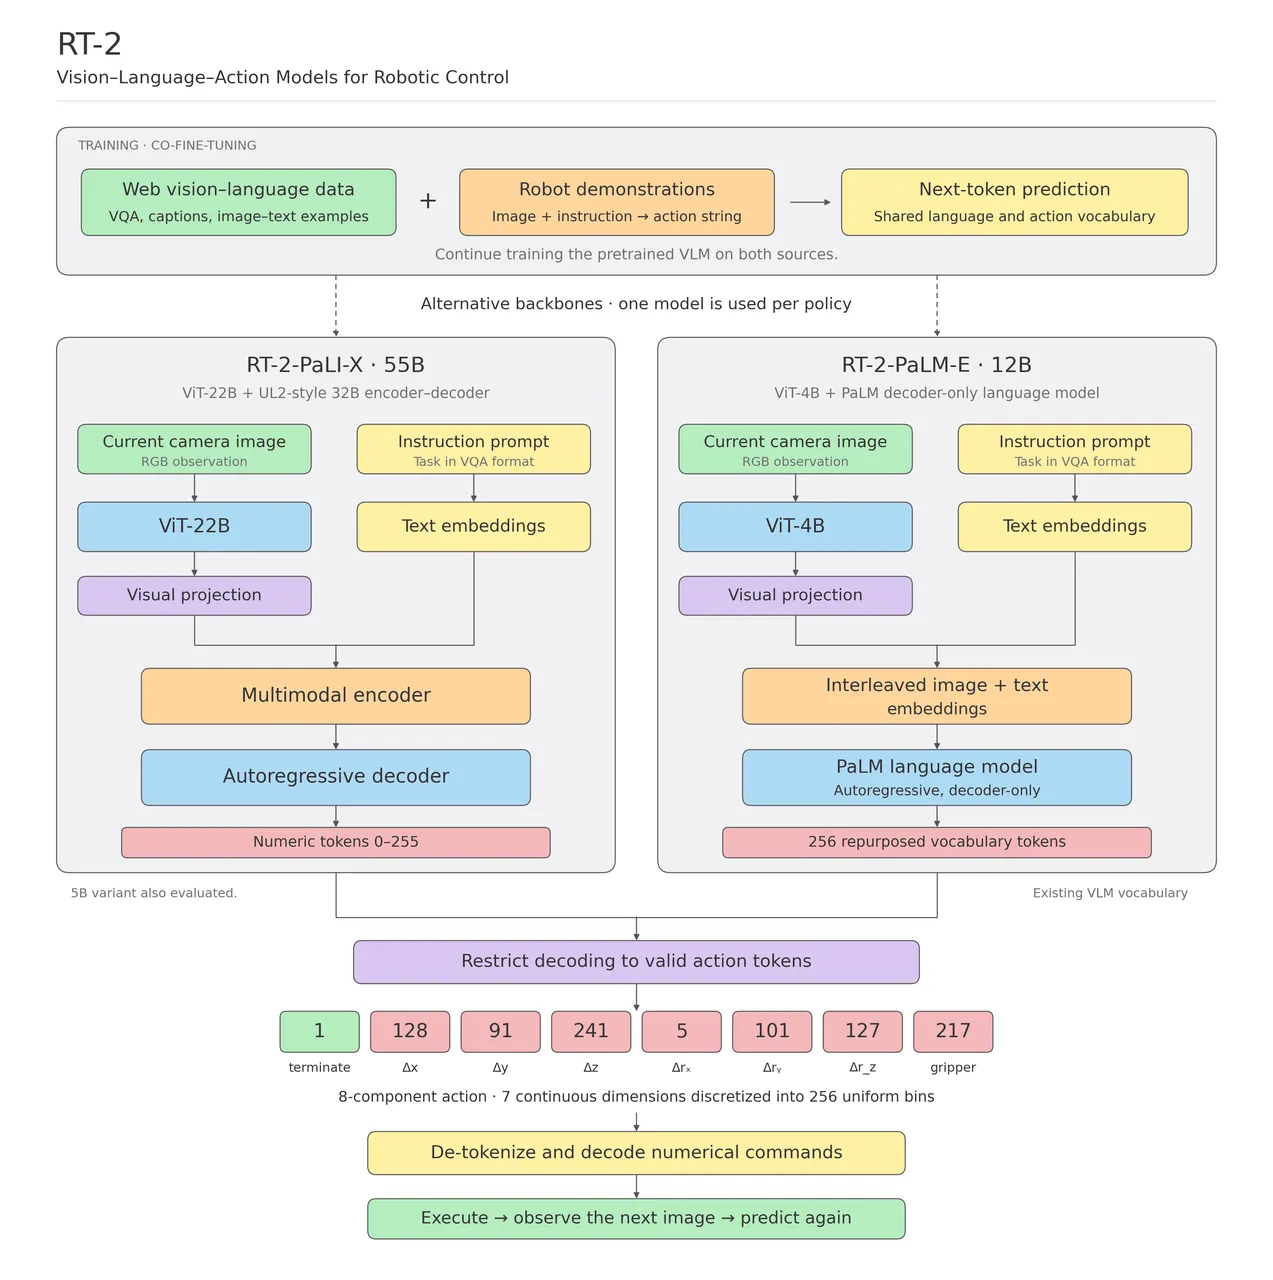
不同于 RT-1 的六帧历史输入,RT-2 的主要形式只使用当前图像。时间行为主要来自闭环执行:行动、观察新图像、再次行动。
RT-2 预测一个 8 分量动作,每个分量离散为 256 个 bin。论文使用两类 VLM。PaLI-X 测试了 5B 和 55B 版本;它的词表中本来就有编号低于 1000 的 token,因此动作值 154 可以直接使用已有 token。PaLM-E 测试了 12B 版本;作者保留 256 个很少使用的词作为动作 token。由于这些词是任意指定的,它们原先的语义与动作值之间没有有用关联。
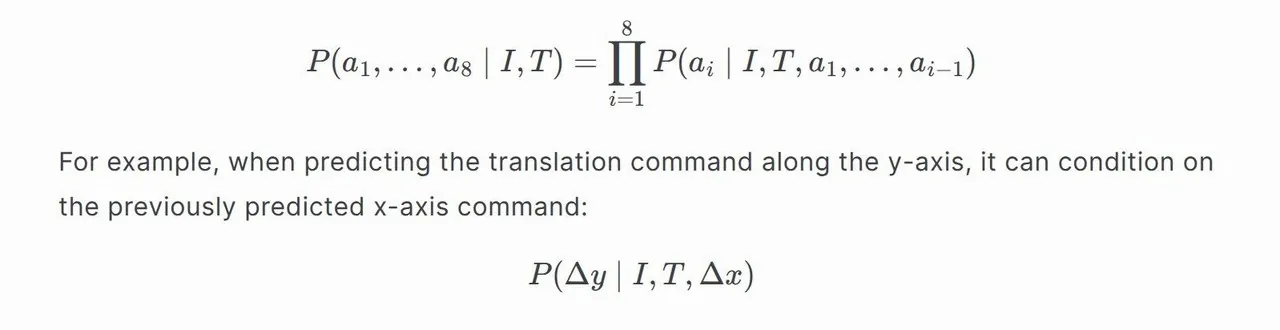
另一个重要概念是自回归动作生成。RT-2 依次生成八个动作 token。每个 token 都以图像、指令和此前已经生成的动作为条件:
$$P(a_1,\ldots,a_8\mid I,T)=\prod_{i=1}^{8}P(a_i\mid I,T,a_{1:i-1})$$
例如,预测 y 轴平移命令时,模型可以利用已经生成的 x 轴命令。
论文的消融实验比较了从零训练、普通微调和 co-fine-tuning。结果显示,预训练权重和保留网络数据都能提升泛化。这也解释了 Taylor Swift 演示为什么重要:Taylor Swift 不可能出现在机器人控制示范里。RT-2 必须把互联网规模预训练中学到的抽象概念和物理动作连接起来。这说明机器人策略可以利用远超机器人数据本身的图像、视频和文本知识。
这个演示为一个大问题给出了略带不确定性、但方向明确的肯定答案:语言和视觉模型可以被训练成机器人的“大脑”。RT-2 团队把这类模型命名为 vision-language-action,用同一个网络连接视觉、语言和动作。
Open X-Embodiment 与 RT-X:跨机器人学习
RT-2 证明,网络预训练 VLM 的知识可以迁移到机器人动作。下一个问题是:经验能否在不同机器人之间迁移?如果一台机器人学会拿起物体,它的示范能否帮助另一台机器人完成相同任务?
Open X-Embodiment 联合 21 家机构,汇集了 22 种机器人本体、527 项技能和超过 100 万条轨迹。不同机器人具有不同相机、动作空间和控制系统。为了让数据可以联合使用,项目统一了相机观测,并把动作转换为共同的七维表示:三维平移、三维旋转和一维夹爪开合。不过,坐标框架和控制惯例的差异仍然存在。
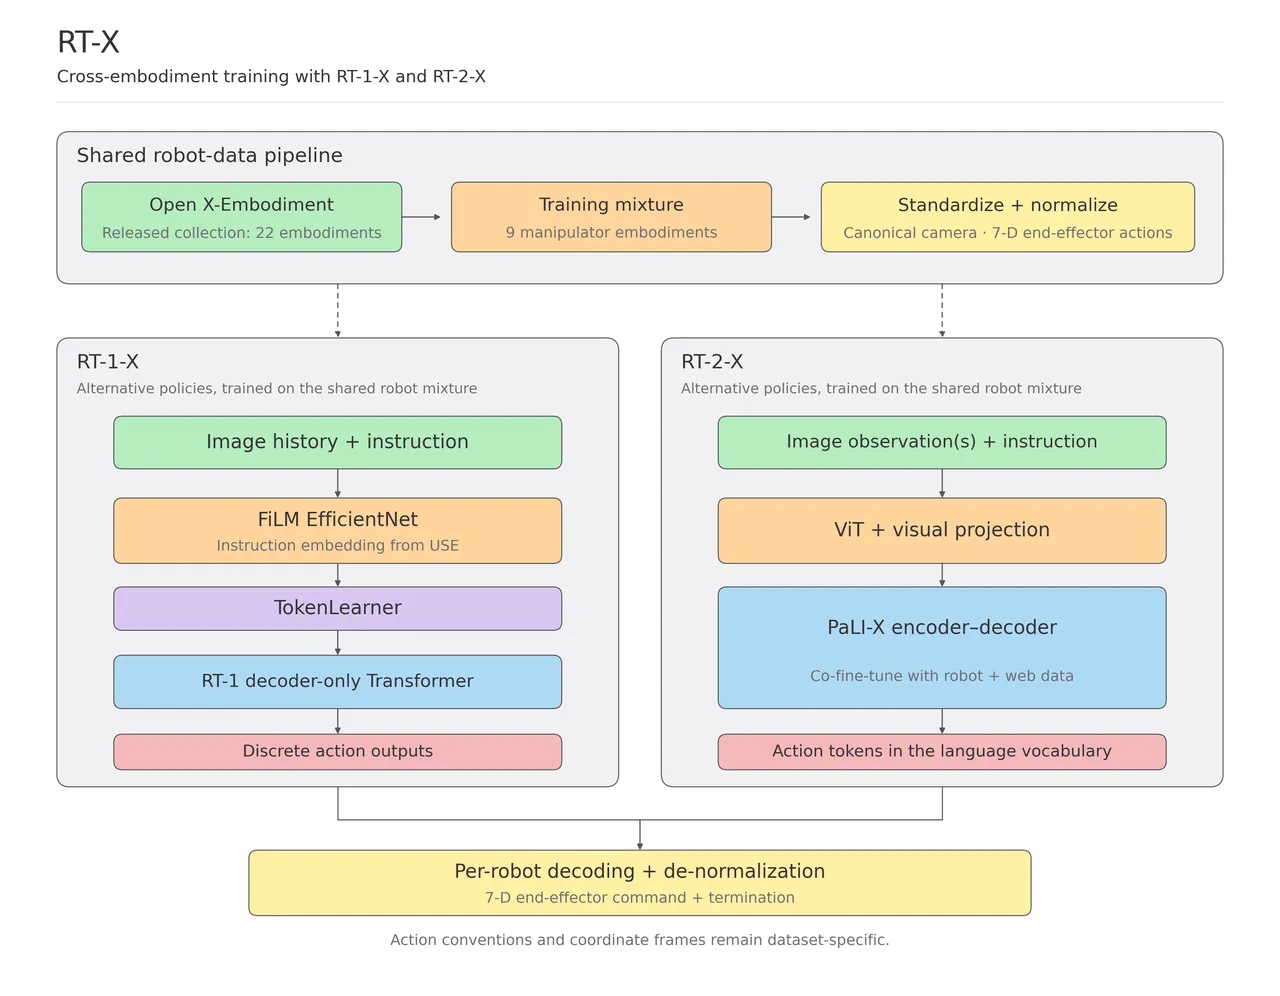
研究团队使用九种机器人本体的混合数据训练已有的 RT-1 和 RT-2 架构,得到 RT-1-X 和 RT-2-X。对于那些没有出现在 Google 自家机器人示范中、但存在于其他机器人数据里的技能,RT-2-X 达到 75.8% 成功率,而 RT-2 为 27.3%。经验显然可以跨越本体边界。
但更多数据并不总是有帮助。较小的 RT-1-X 很难拟合多样化的数据混合,有时甚至不如在单一机器人数据上训练的策略。仅仅汇集示范还不够,模型也需要足够容量来学习联合分布。
这引出了下一个问题:能否构建一个预训练机器人策略,使它容易适配新机器人、新相机配置和新动作空间?
Octo:模块化的开放通用策略
RT-X 说明,不同机器人的经验可以改善共享策略。一个实用的通用模型还需要能在新机器人上使用,而不必从头重训每个组件。Octo 正是为这种适配而设计。
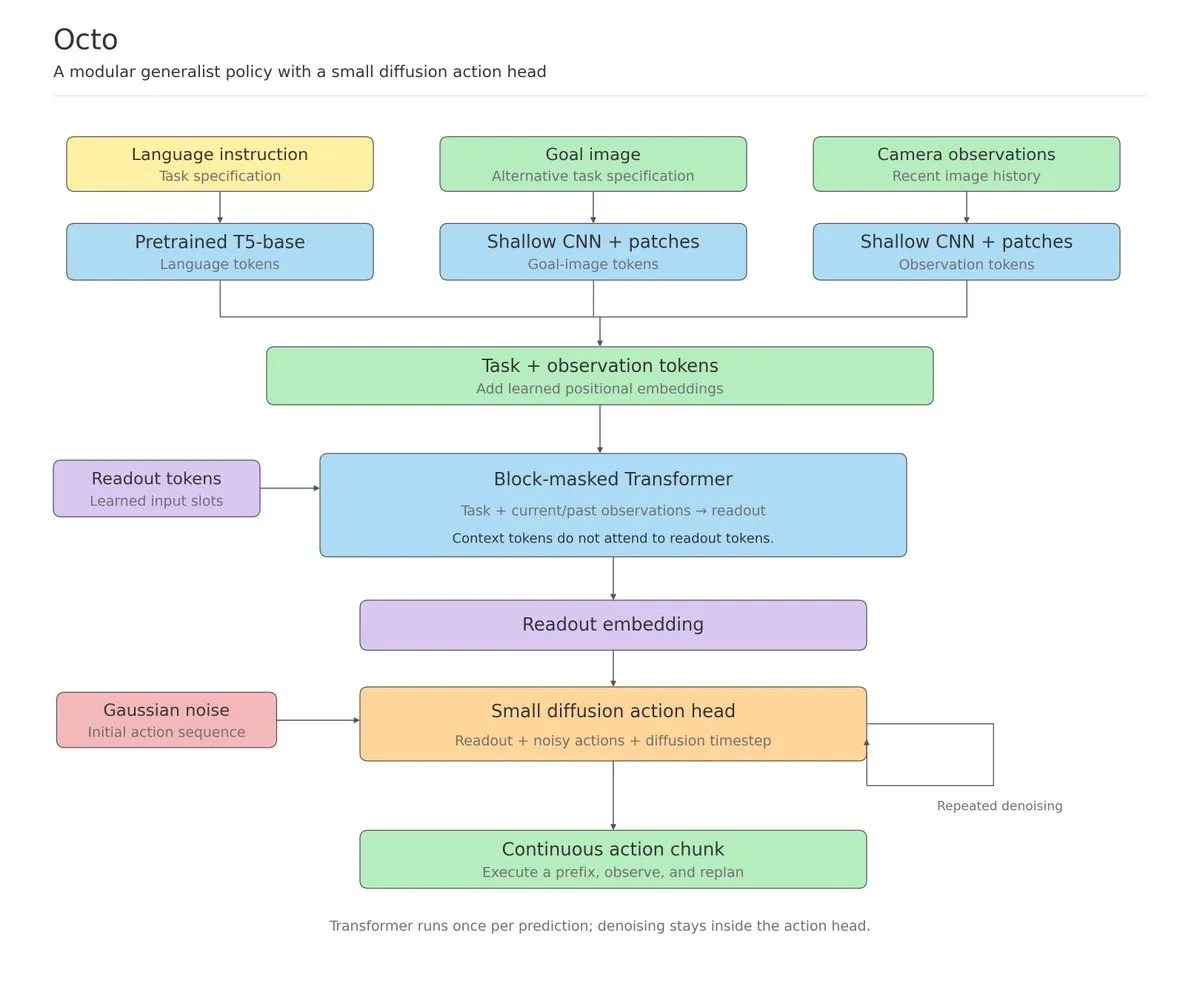
Octo 是一个开源通用机器人策略,使用来自 25 个 Open X-Embodiment 数据集的 80 万条示范预训练。它发布了两个版本:2700 万参数的 Octo-Small 和 9300 万参数的 Octo-Base。输入包括相机观测,以及语言指令或展示目标状态的目标图像。
其架构由输入编码器、Transformer 和 diffusion 动作头组成。预训练 T5 编码器把语言转换为语义向量;CNN 把相机图像和目标图像转换为 patch token;语言 token 与图像 token 一起送入 Transformer。
模型还加入了可学习的 readout token。这些 token 在 Transformer 内汇总指令和相机观测的信息,动作头再利用它们的输出预测命令。这种设计允许使用者在微调时增加新传感器或更换动作头,同时保留预训练 Transformer。
与 RT-1 和 RT-2 的离散动作 token 不同,Octo 使用 diffusion 头生成连续动作块。原因是同一场景和指令可能存在多种有效动作。例如绕过障碍去拿杯子时,机器人可以从左侧绕,也可以从右侧绕。用均方误差直接训练一个动作序列,可能把这些方案平均成一个朝障碍物前进的动作。Diffusion 可以表示多个有效模式,并采样其中一条轨迹,而不是做平均。它从随机噪声出发,在 Transformer 输出的条件下逐步去噪,生成机器人命令序列。一个值得注意的细节是:Transformer 每次预测只运行一次,反复去噪发生在更小的动作头内。
Octo 在九套真实机器人配置上做了评估。每个任务使用 100 条示范微调后,它在其中六套配置上的平均成功率为 72%,从零训练的策略为 20%。这意味着,只要有足够示范并完成微调,同一个预训练策略就能适配不同腕部相机或末端执行器命令。
OpenVLA:开源 VLA
OpenVLA 是一个 70 亿参数的开源 VLA,使用 Open X-Embodiment 的 97 万条机器人示范训练。它由视觉编码器、投影器和 Llama 2 语言模型组成。起点是预训练的 Prismatic-7B VLM,后者使用 SigLIP 和 DINOv2 两个视觉编码器。
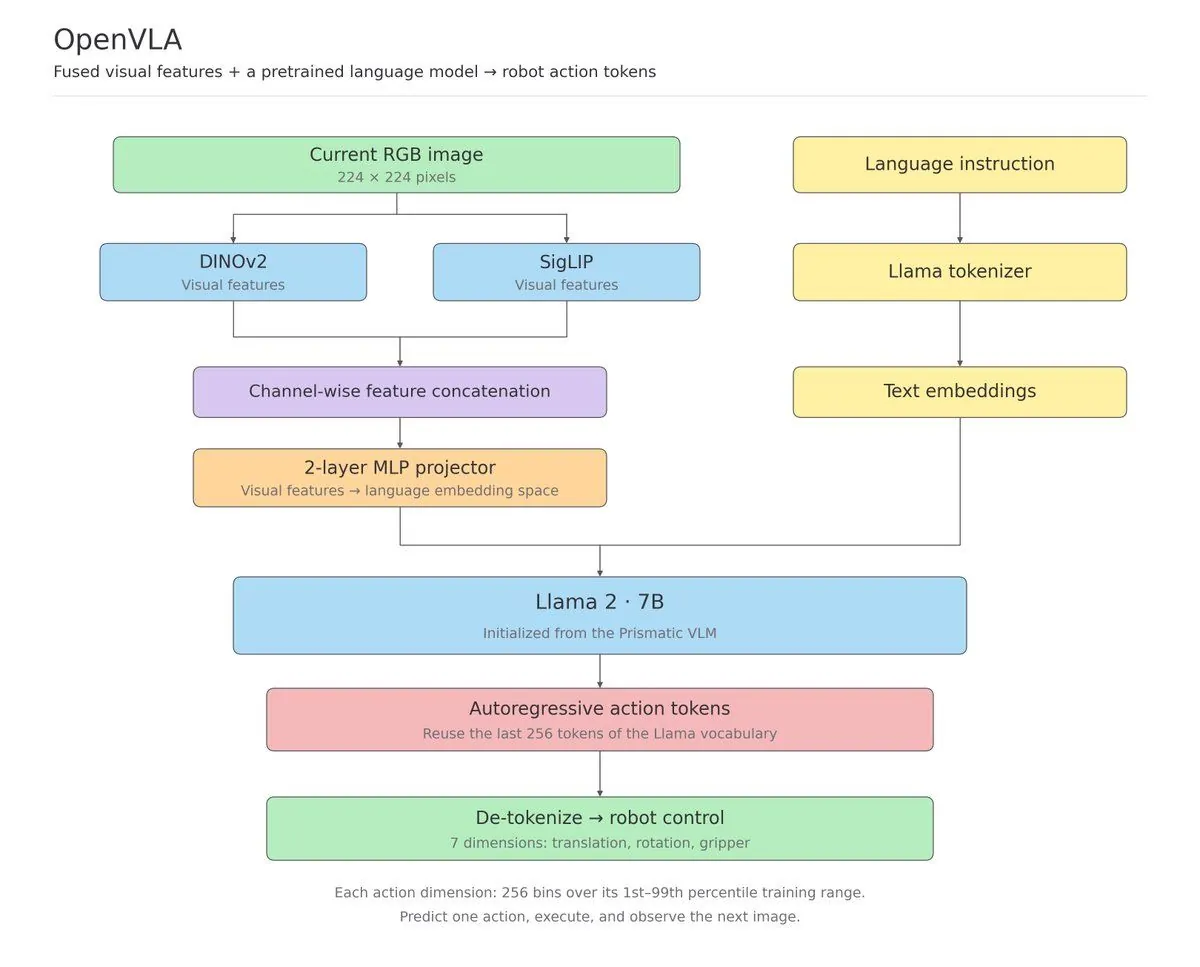
图像同时经过两个编码器,特征随后拼接。SigLIP 提供从图文匹配中学到的特征,DINOv2 则补充对感知和控制有用的空间信息。两层 MLP 投影器把组合表示转换为语言模型可以处理的 embedding。
OpenVLA 预测七维动作:三维平移、三维旋转和一维夹爪命令。与 Octo 的 diffusion 动作块不同,原始 OpenVLA 像 RT-2 一样自回归地一次预测一个动作。每个动作维度离散为 256 个 bin,并使用第 1 到第 99 百分位裁剪。模型复用 Llama 词表最后 256 个 token 作为动作 token。
在 WidowX 和 Google 机器人的 29 项任务上,OpenVLA 的平均成功率比规模大得多的 55B RT-2-X 高 16.5 个百分点。但两者的训练数据不同,因此不能把这一结果视为普遍的缩放定律。OpenVLA 也并非在所有任务上都更好。RT-2-X 更擅长需要机器人示范中不存在、但来自互联网概念的语义任务,例如 Taylor Swift 演示。OpenVLA 的机器人训练没有保留网络视觉语言数据,RT-2-X 则使用了 co-fine-tuning。因此,更好的机器人任务表现,并不意味着模型更好地保留了 VLM 的网络知识。
机器人应该如何预测下一步动作?
到这里,已经出现两大类方案。RT-2 和 OpenVLA 生成离散动作 token;Octo 以及后来的模型使用 diffusion 或 flow matching 生成连续动作块。对于需要精确、高频运动的灵巧任务,自然的问题是:能否同时保留预训练 VLM 的语义能力与连续动作生成能力?
π0:用独立动作专家生成连续动作
π0 是 Physical Intelligence 提出的 VLA,它将预训练 VLM 与专门的动作专家结合,生成连续机器人命令。我见过很多人讨论它,而演示视频确实说明了原因。在一个清理桌面的例子中,π0 有时会先把盘子叠起来再移动,而不是始终逐个抓取。叠衣服也需要持续调整,因为每次折叠都会改变观测。这些策略接受了任务特定的后训练,其能力并不只来自预训练 VLM。
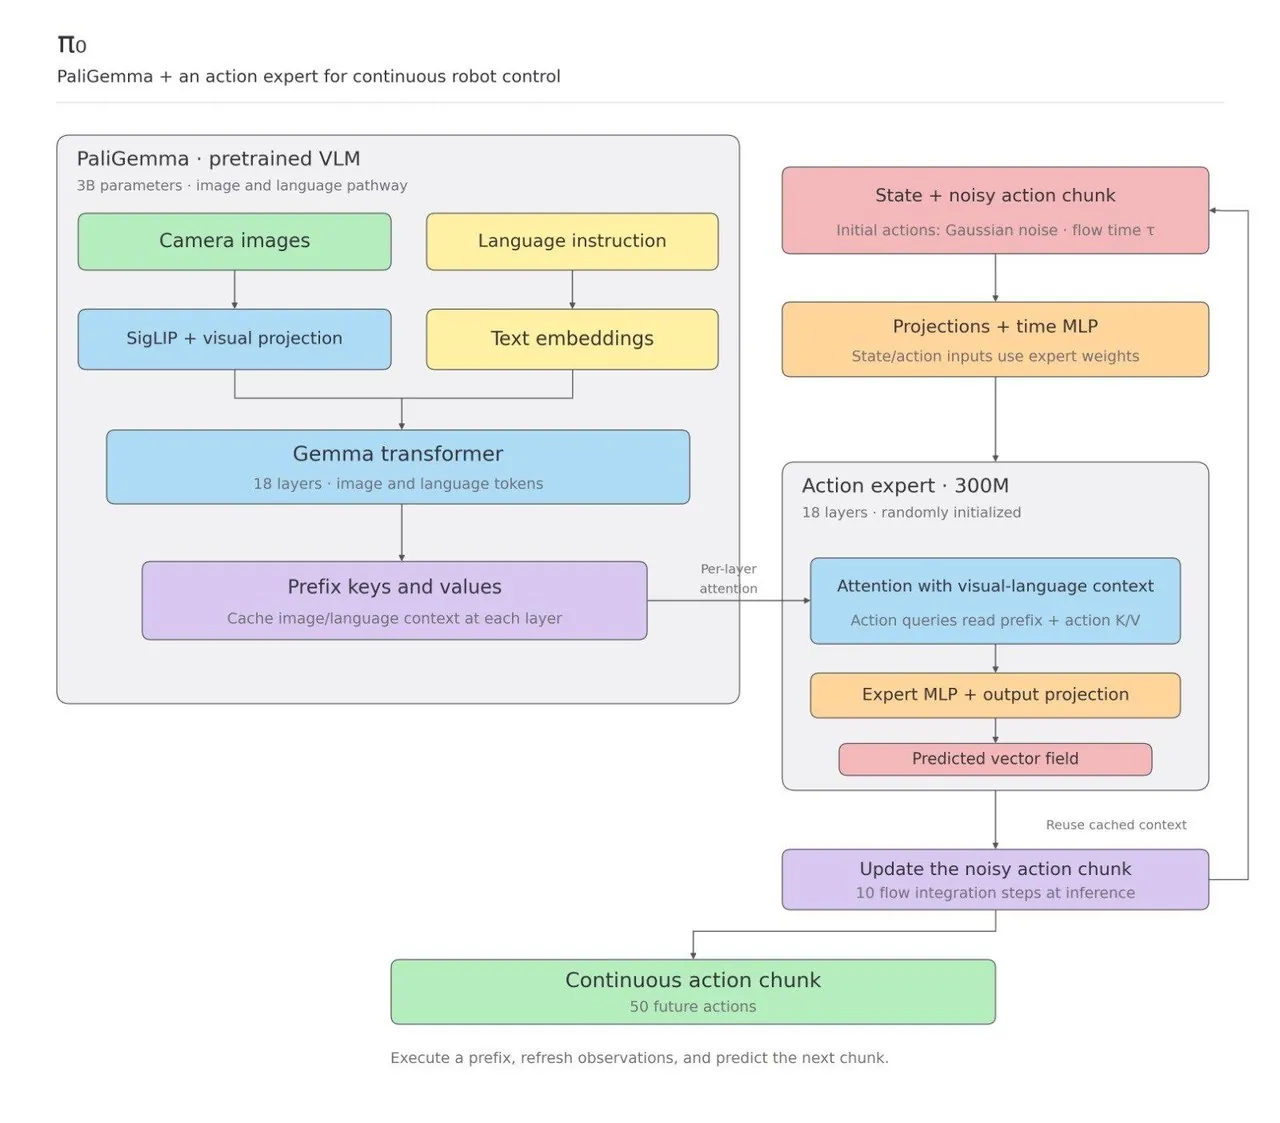
模型包含预训练的 30 亿参数 VLM PaliGemma,以及约 3 亿参数的动作专家。输入包括相机图像、语言指令和关节角等机器人状态,输出是未来 50 步动作组成的 action chunk。
π0 不输出离散 token,而是加入一个更小的 Transformer 作为动作专家。它沿用 Gemma 的架构,但更窄,并且随机初始化。动作专家通过 attention 使用机器人状态和 VLM 信息,生成连续运动命令。它采用 flow matching:从随机噪声开始,根据图像、指令和机器人状态反复更新候选动作块。所有细化步骤都在模型内部完成,最后由机器人执行动作块。
π0 把 VLM 预训练与连续动作生成结合起来,但生成每个动作块仍需多次细化。一次预测 50 个动作,也不意味着每个动作都基于最新观测。执行动作块中的多少步、何时重新规划,是另一个架构与部署选择。我正在单独研究这一取舍。
SmolVLA:小到可以微调的策略
看完那些数十亿参数的模型之后,SmolVLA 的规模显得格外实用。它有约 4.5 亿参数,约为 OpenVLA 的十六分之一。其真实世界基础模型使用公开社区数据集中不到 3 万条 episode 预训练。
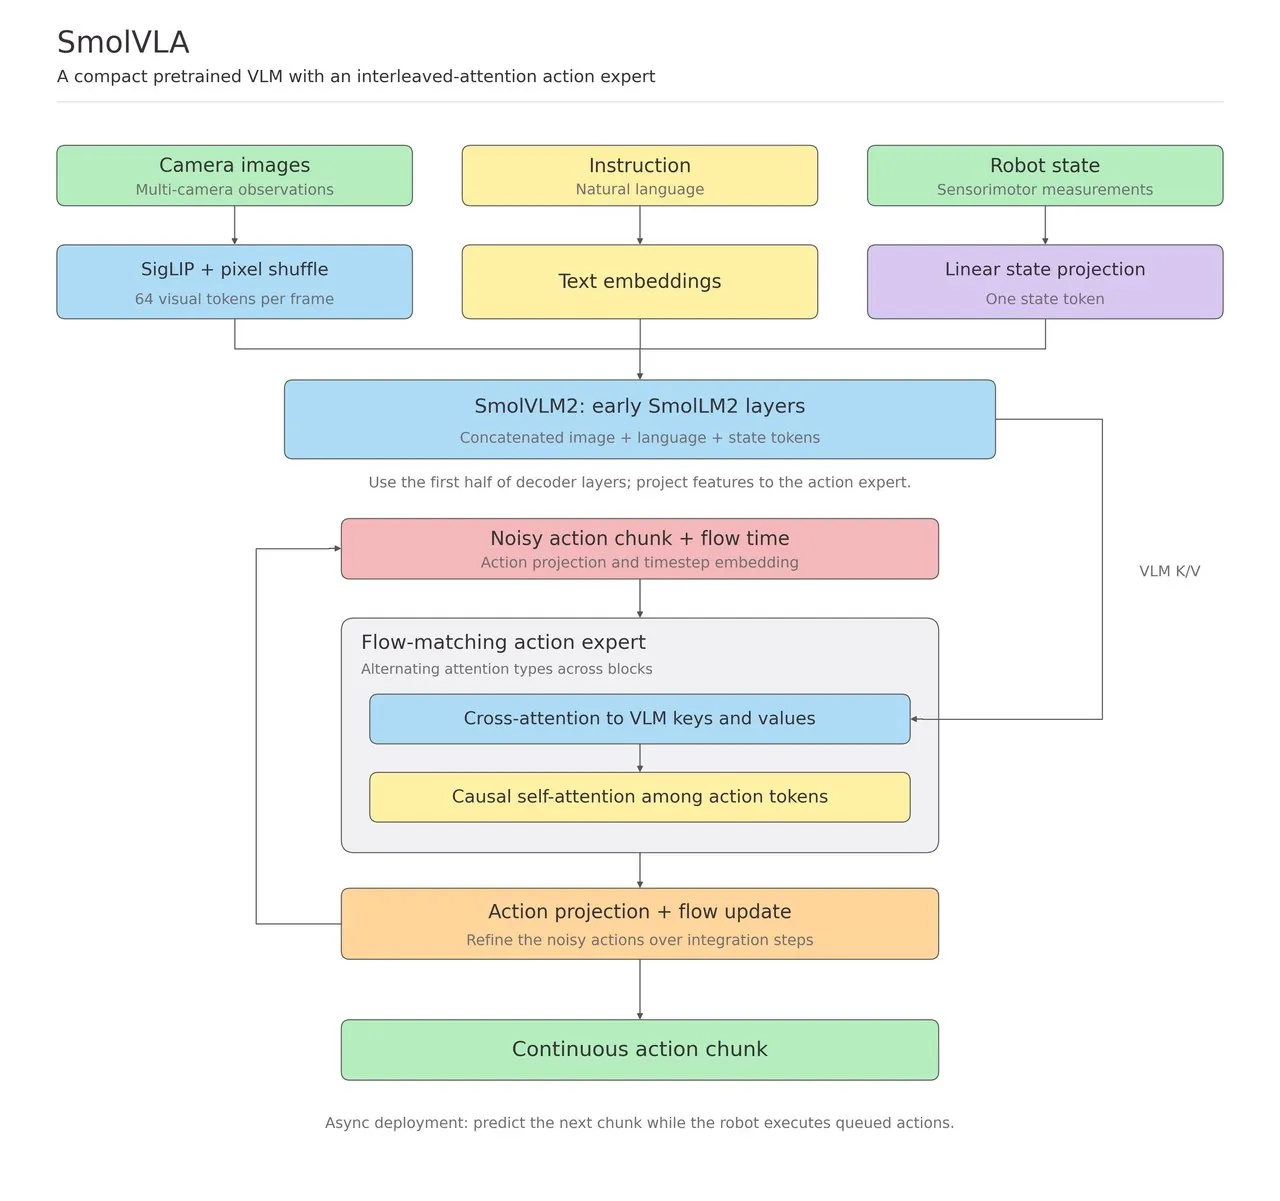
SmolVLA 使用 SmolVLM2,其视觉部分是 SigLIP 图像编码器,语言部分是 SmolLM2。它与 π0 一样采用 flow matching,输出连续动作块。它还有一个有趣的设计:只使用 VLM 语言解码器的前半部分,并把每帧图像缩减为 64 个视觉 token。动作专家不需要等待完整语言模型处理结束,就能使用视觉和指令特征。
模型采用异步推理。同步机器人可能在执行完当前动作队列后才请求下一次预测;SmolVLA 会在仍执行当前块时请求下一块,从而把任务吞吐量大约提高一倍,并减少等待时间。代价是队列中靠后的动作基于较早的观测,而不是每一步都有新图像。
我还使用 LIBERO 上训练的 SmolVLA checkpoint 做过实验,观察改变语言指令会如何影响行为。那部分结果将另写一篇。
MolmoAct:把空间推理显式化
阅读 MolmoAct 时,我想起自己实习期间做过的物体导航工作。方法虽然不同,但都在把空间信息明确表达出来,而不是期待网络隐式学会所有几何关系。
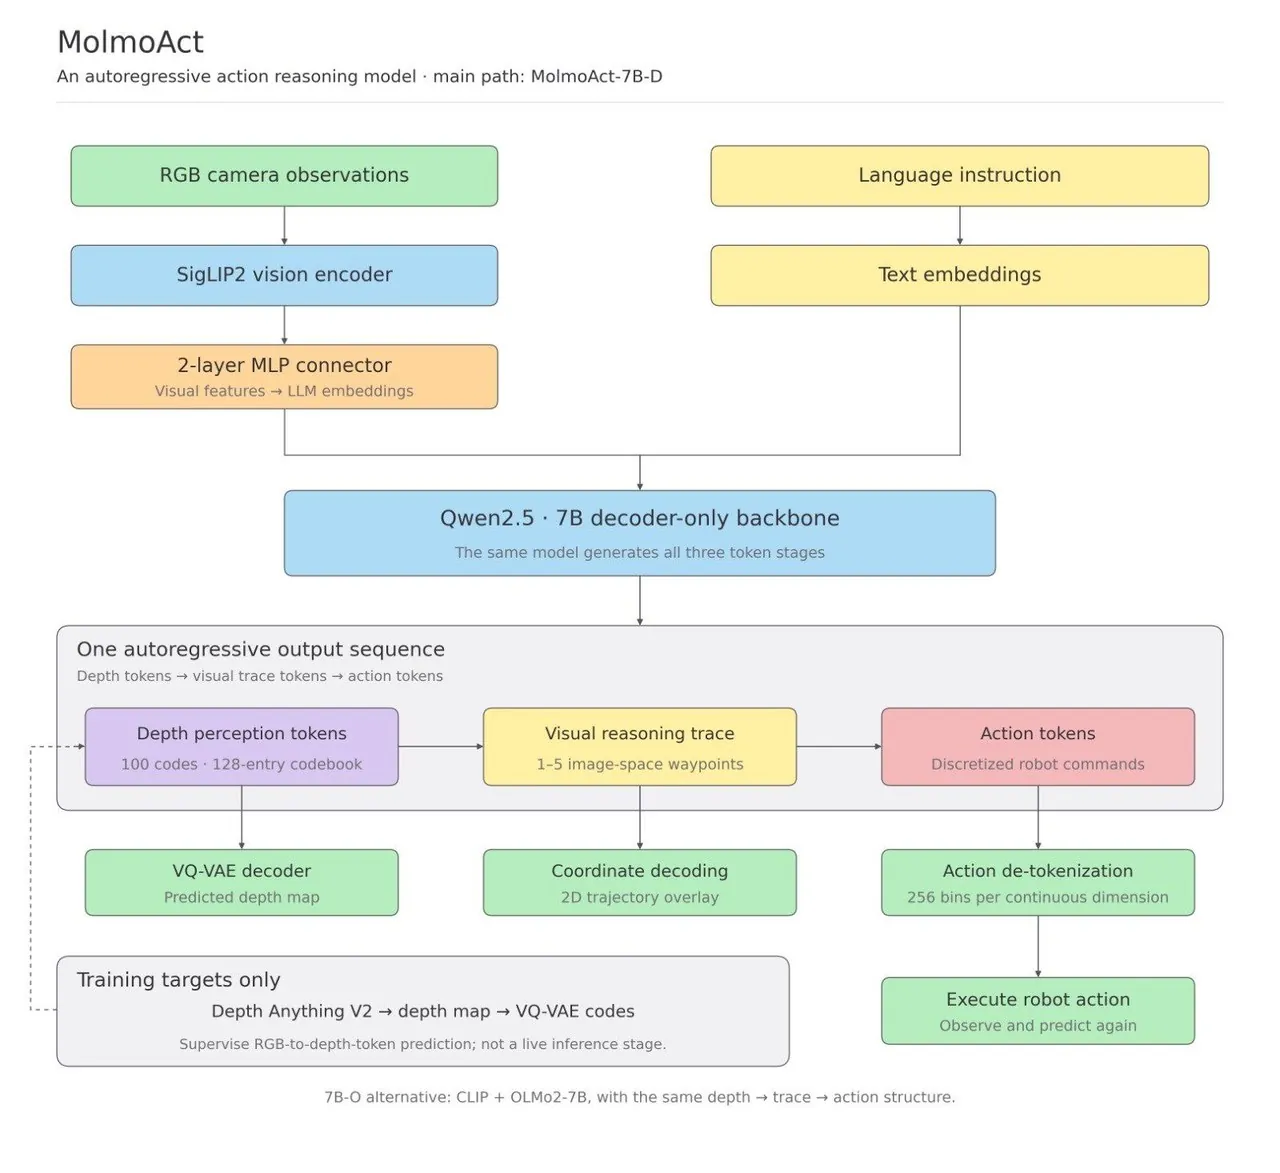
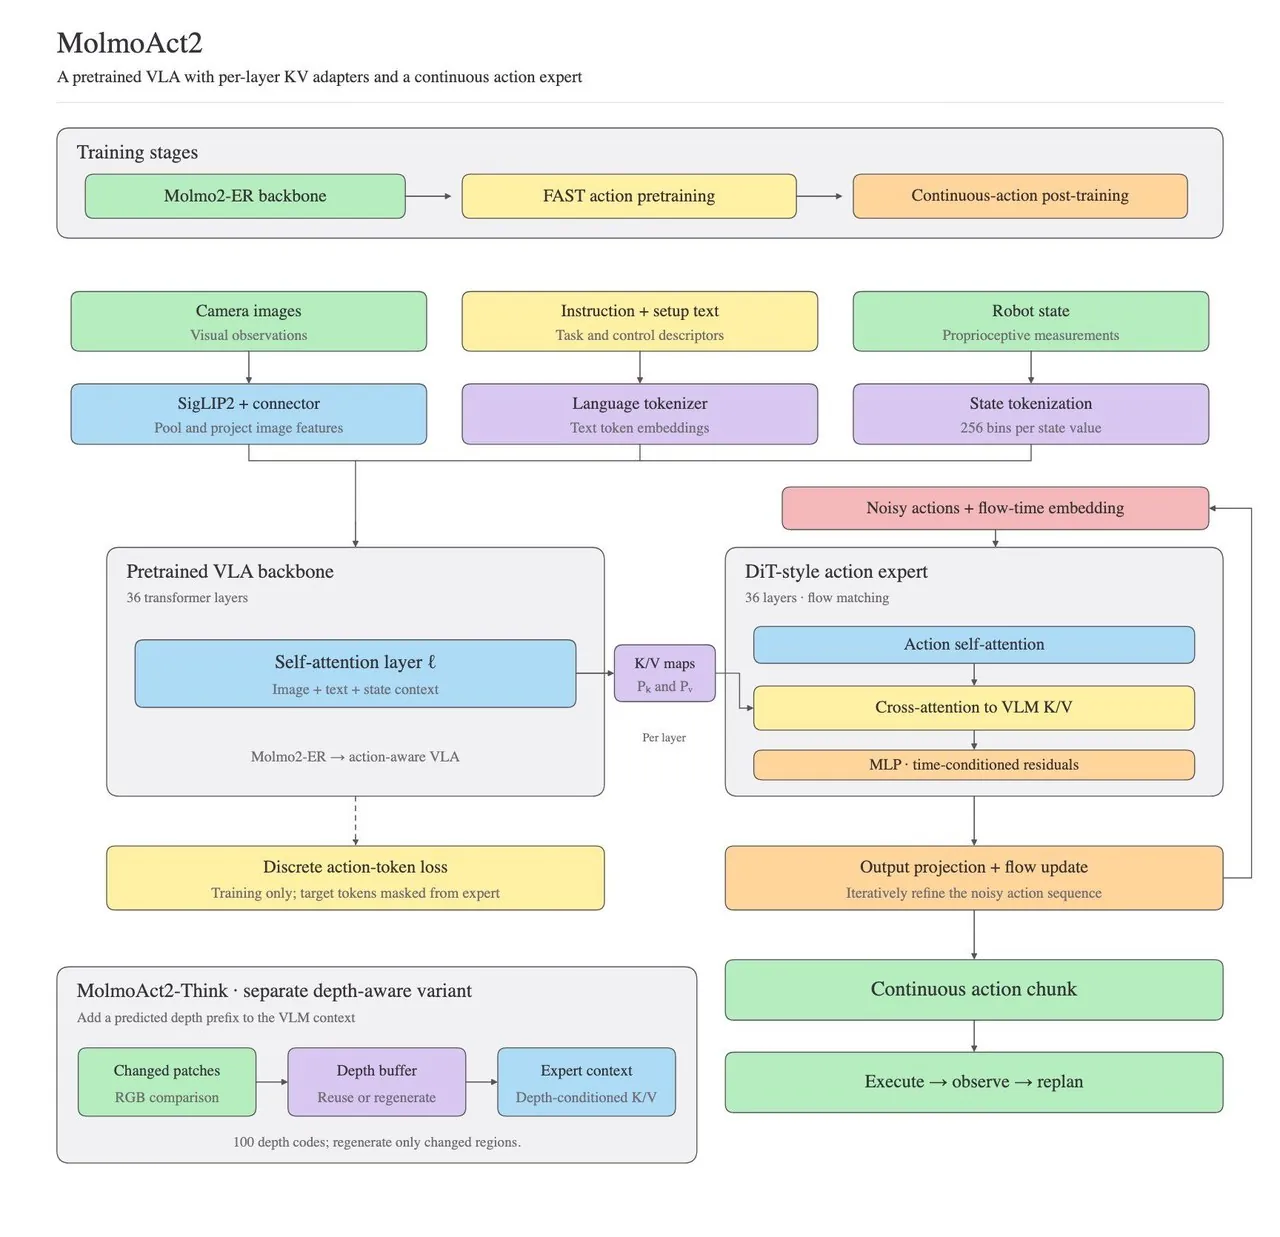
多数 VLA 直接把观测和指令映射为动作。MolmoAct 则引入三个阶段:预测深度、生成视觉轨迹、最后产生机器人动作。
深度部分使用 Depth Anything v2 和 VQ-VAE,把深度图压缩为 10×10 的离散 token 网格。这些 token 是训练目标,因此 MolmoAct 能学会直接从相机图像预测深度,推理时不需要运行外部深度估计器。
接下来,模型预测最多五个描述末端执行器预期路径的图像空间点,然后生成由八个离散机器人动作组成的动作块。这样做的优点是可检查:人可以看到模型预测的深度和预期运动,而不只是最终命令。代价是额外推理延迟;轨迹在图像空间中看起来合理,也不保证真实执行一定正确。
MolmoAct 2:更快的空间策略
MolmoAct 2 在初代基础上提升了空间推理,加入自适应深度预测和连续 flow matching 动作专家,因此明显更快、更实用。它仍保留中间空间推理,但动作生成路径更接近 π0 和 SmolVLA 使用的连续动作专家。
开放问题
读完这些论文后,我不断回到一个想法:示范可以教机器人从哪里开始,但机器人也应该从自己的错误中学习。这里讨论的大多数 VLA 主要通过模仿学习训练。强化学习可以利用真实交互反馈,进一步提升这些预训练策略。可在真实机器人上收集经验很昂贵,设计可靠奖励也很困难。因此,VLA 与 RL 不必是两条互斥路线。前者提供策略,后者提供通过经验改进策略的方法。
我也很关注 VLA 与世界模型的结合。除了预测下一步动作,模型能否同时预测执行该动作后会发生什么?这样机器人就可以比较不同动作、提前规划,甚至从想象 rollout 中学习。但世界模型预测不准会导致错误决策,额外计算也可能拖慢反应速度。最终收益取决于精度和延迟能否同时达标。
我不知道最终架构会是什么样。我的直觉是,从示范中学习、预测动作后果、通过经验持续改进,这三者都会发挥作用。它们的交叉是机器人学习中最值得探索的方向之一。
结论
我写这篇文章,是为了理解 VLA 如何演化,也为了更新自己对机器人学习的认识。从 SayCan 的语言规划,到 RT-1 的统一策略,再到 RT-2 对网络知识的迁移,以及后来的 π0、SmolVLA 和 MolmoAct,这个领域在相对短的时间内取得了显著进展。
但我不认为目前已经出现唯一胜出的路线。不同架构在泛化、动作精度、推理延迟和所需机器人数据量之间做出不同取舍。演示视频确实越来越惊艳,但“成功完成一次任务”和“在不受控环境中可靠完成任务”之间仍有很大差距。
我最有兴趣的部分,是亲手检验其中一些取舍。即便是很小的离散化实验,也说明 bin 数量和动作范围会显著改变策略产生的命令。
我还在研究 action chunk 大小和重新规划频率如何影响执行,以及 SmolVLA 等模型如何响应语言指令变化。后续文章会分享实验设置、结果和失败。
如果你做过类似问题,或者有值得尝试的实验建议,欢迎交流。
来源:Khushi(@starlitmatcha)发表于 X 的文章 “From RT1 to MolMoAct2: A brief history of VLAs”。本文是 RobotWorld 对原文的完整双语改编。
原文来源:X Article / Khushi (@starlitmatcha)https://x.com/starlitmatcha/status/2116918927913804223