Gemini 4 Argon for Robotics:谷歌把「生成 → 验证 → 修正」写进了机器人栈的每一层
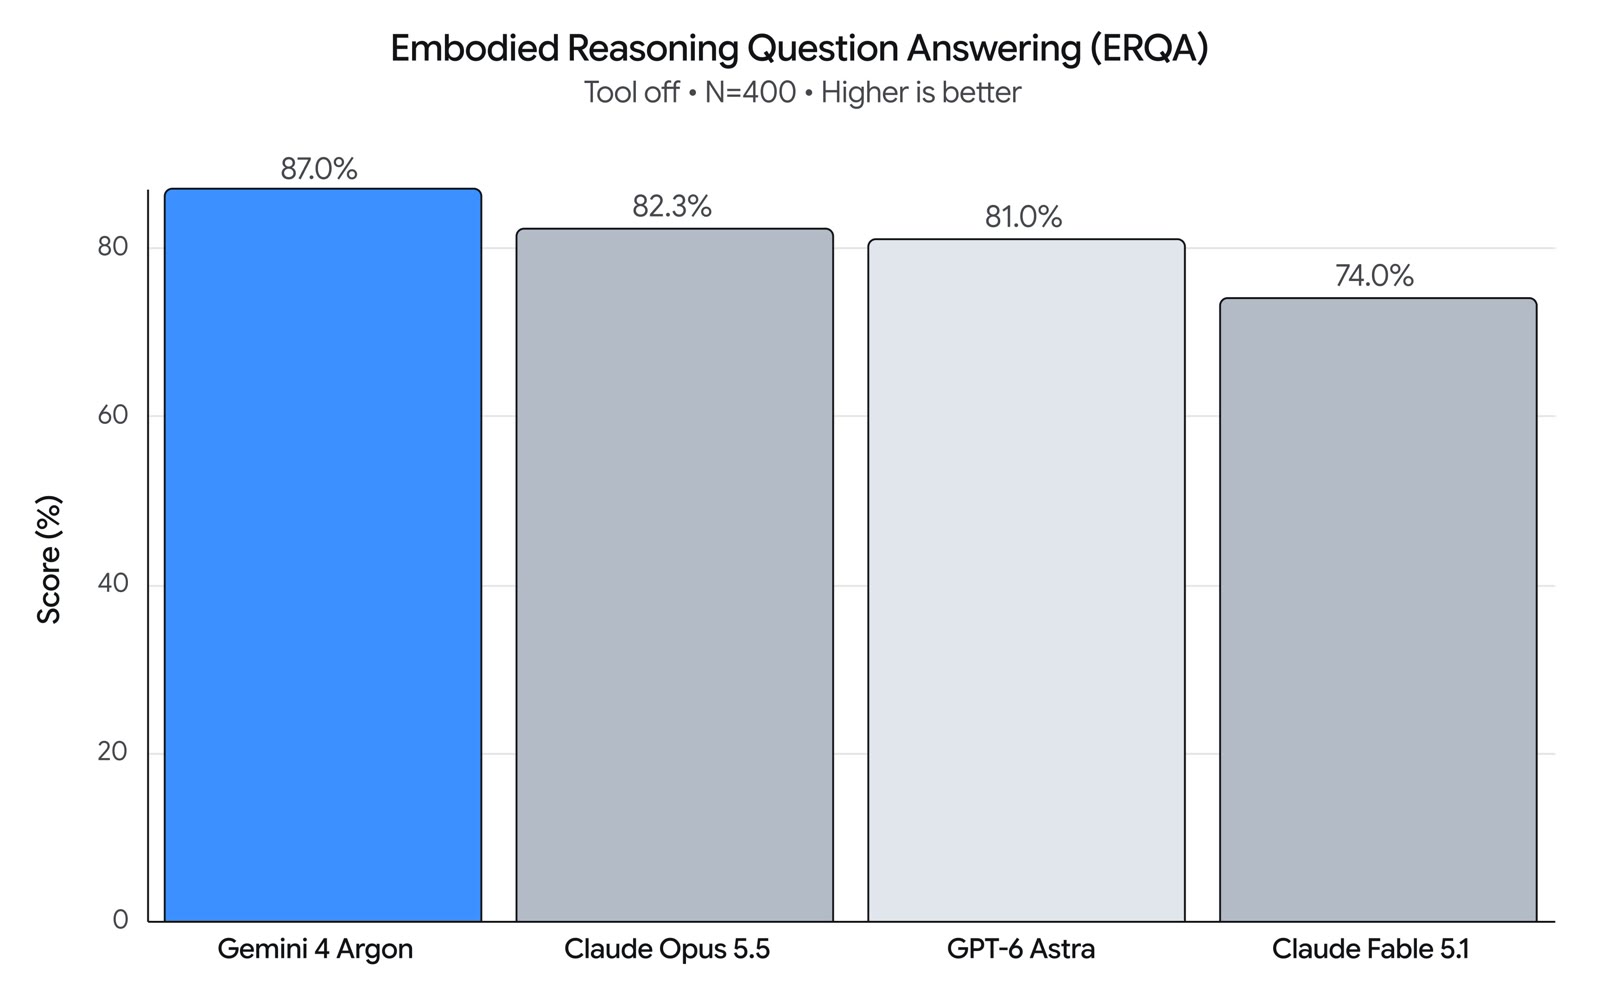
Google 发布通用物理推理模型 Gemini 4 Argon:ERQA 纯推理 87%,12 个演示覆盖机器人控制、Real2Sim、物理理解与自我改进四大环节。本文逐条拆解它的技术路线与真实数字,并说清这些成果是「宣称能力」而非独立验证过的可靠性。
Gemini 4 Argon for Robotics:谷歌把「生成 → 验证 → 修正」写进了机器人栈的每一层
原文来源:Google Developers Blog — Gemini 4 Argon for Robotics
作者:Kanishka Rao(Principal Software Engineer,Google DeepMind) · RobotWorld 整理 · 2026 年 10 月 13 日 · 推文出处:@googledevs
链接:原博 · ERQA 基准 · MuJoCo · Gemini API 文档
Google 在 2026 年 10 月 13 日发了一篇不太像「模型发布」的机器人博客:全文没有一个新网络结构、没有一段损失函数,12 个演示全部由自然语言 prompt 驱动,交付物却是能真跑的东西。Gemini 4 Argon 的定位不是更强的机器人策略,而是一个横跨机器人全生命周期的通用物理推理模型——它会写代码、会搭仿真、会给数据打标签、会替自己的失败归因。官方称它在具身推理基准 ERQA 上以纯推理拿到 87%,「优于所有其他前沿模型」。
先读结论:12 个演示的共同结构,不是「感知 → 动作」,而是「生成 → 验证 → 修正」
把 12 个例子摆在一起看,会发现它们共享同一套骨架:模型先生成一个可运行的物理对象(MuJoCo 场景、视频世界模型的时间戳指令、多粒度标注 JSON、一篇 tiling 控制论文的 WASM 实现),然后用某种独立于生成过程的检验手段去检查它,再依据检验结果修正。每一次 Google 都把"验证"强行写进了 prompt,而不是等它自由发挥:
- Spot 踩踏板丢罐:用一个 2-agent verification swarm(foot-verifier 验脚踏是否居中、hand-verifier 验手部是否在桶口正上方),两个守部「联网不通过就不松手」。
- Real2Sim 机器人视角复刻:要求具体 Phenom 渲染与真实三路相机对齐(Visual match),并且指尖接触力/力矩的时序、量级、方向都要对上真实记录的
tactile_force(Physical match)。 - 草图转人机Sequence:不是生成一段漂亮动画,而是要求在闭环物理里真的打倒 6/6 个目标箱子,并且人形骨盆漂移 < 3 cm。
- 论文复现:用 headless Chromium + Playwright 跑 verification loop,断言 0 console error 且连续 300+ 帧任务进度非零。
- 数据标注:标注体系里单独留一层
quality_control_and_reweighting,把 slip/delamination 的重试循环压权到 0.15x–0.25x,用于 Behavior Cloning。
最值得注意的是 Real2Sim 那段 prompt 里的「禁止仿真作弊」(No sim cheating)条款。它明确规定 t = 0 之后不许改 MjModel 参数、不许施加外力、不许用 weld/equality 约束、不许设置或回滚物体 qpos/qvel、不许关闭碰撞,甚至明确禁止「复制真实记录的触觉读数当接触力」。这条如果出现,说明负责 Simulation 的模型确实试过这么干——模型同时当运动员和裁判的诱惑是真实存在的,Google 的解法不是回避,而是把规则用 prompt 钉死,并给每一项都配上可机检的验收条件。
先把数字按住:87% 之外,全是单点自述
Google 给出的唯一横向硬指标是 ERQA 87%。官方把它当作「物理理解 + 代码生成 + 视觉语义推理」出现阶跃的证据。但对从业者而言,博客里所有其他数字都是单点、自述、无对照组细节:56% → 75% 成功率对应哪个任务集合、多少个 rollout、多少次真实重试,全文没有交代;SO-101 三轮迭代只给了三个时间数字(58.9s / 22.9s / 17.4s),没有给失败率。这不是说结果是假的,而是说它是「宣称能力」,不是「已验证可靠性」。
一、机器人控制:三条完全不同的路
1. Spot 移动操作:先建数字影分身,再上真机
Argon 控制波士顿动力 Spot(12 自由度腿 + 6 自由度臂)完成一个新技能:踩下脚踏式垃圾桶的踏板,把苏打罐丢进敞口的桶里。在真机执行前,模型先自建了那个脚踏垃圾桶的关节化 MuJoCo 数字孪生,在仿真里练习「三条腿成三脚架支撑」的平衡策略。
为什么值得看:这条链路的技术含量不在「机械狗丢垃圾」这个demo,而在于「模型自己造它自己练的场景」。传统 Real2Sim 的瓶颈是环境建模的人力成本——建一个带正确关节物理的垃圾桶可能要半天,这里是一句话。Google 在另一篇鸣谢里提到,类似的 Video-to-Sim-to-Real 流水线把数周的手工建模压到几小时;而给 Apptronik Apollo 人形看一段人类打沙包入洞的视频后,机器人做到了连续 7 次投中。
2. 零样本控制:给 VLM 一把「坐标尺」
第二个演示用一个简单机械臂,要求把倒下的马克杯扶正、并把皱纸巾塞进去。Argon 不写控制策略,而是用 visual coordinate harness + action primitives 跨多轮闭环执行:它拿到的腕部相机图上叠加了 2 cm 网格的世界坐标、青色十字标出当前 pinch 中心、青色 [ + ] 标出夹爪开合线、绿色线标出物体长轴朝向。
有意思的是 prompt 里明示的三档调用粒度:Coarse(2–4 次调用) → Pre-Grasp Hover Verify(4–7 次) → Fine Visual Servoing(8–20 次)。这等于坦白一件事: VLM 每轮往返是有成本的,控制精度和首席位置开销在同一个旋钮上。Google 把它写进 prompt 让模型自己选档,而不是假设「闭眼丢进去就行」。当 status == "grasp_failed",规范要求先 look_at 重新观测再恢复闭环。
3. 视频世界模型:时间本身就是控制量
第三个演示在 Gemini Omni World Model 里把散落的 5 个 Scrabble 字母块(G、R、A、N、O)拼成 A-R-G-O-N。这里没有轨迹、没有 IK,模型做的事是写带时间戳的动作脚本([MM:SS.mmm] 格式,包在 <omni_prompt> 里),再拿 rollout 的中间关键帧回来检查并迭代修正自己的 prompt——成品是一条 33 步引导出来的 rollout。
二、Real2Sim:把真实世界搬进 MuJoCo
机器人视角 → 仿真:最硬的一条约束
这是全文技术含量最高的一段。输入是一段真实遥操作 episode,Argon 要重建出与之 machinery 匹配的 MuJoCo 场景,并用两个检验目标迭代调优:视觉对齐(三路相机渲染得像真实观测)与物理对齐(每个 Sharpa 指尖的仿真接触力/力矩,在传感器坐标系下与真实记录的 tactile_force 的时序、量级、方向都对得上)。
并且可调范围被钉得很死:只能在仿真开始前调资产几何/质量/惯量/摩擦与初始位姿;只有在「真实指尖接近物体」的那些帧才能改机器人指令,且必须在记录轨迹的 0.55 rad(臂关节)和 0.65 rad(手关节)之内,其余帧原样回放。
人类视角 → 仿真:500 Hz 的拟合压力测试
输入是第一人称人类操作视频,输出是一个可在 MuJoCo 里物理求解的场景。两个关键技术点:一是把粗糙的 bounding box 换成复合凸分解网格,这样嵌套碗、凹陷木托盘、敞口箱才支持物理上的「内部放置」;二是把人手腕和手指关键点重定向到 76 自由度双臂人形(每条臂 7 自由度 + 22 自由度五指手),并在 500 Hz(dt = 0.002s)、零运动学 weld 约束下步进。
草图 → 仿真:一张纸拍照进 GPU 物理
最夸张的一个:随手拍一张手绘草图的照片——画着一个 Apollo 2 人形沿抛物线扔球,去打倒桌上一个 3-2-1 堆叠的箱子阵列——Argon 直接构建 GPU 加速的 mujoco_warp 场景,合成 76 自由度全身投掷轨迹(50 Hz、140 步、2.80 s,四阶段:站姿与五指力抓闭合 → 躯干/肩部蓄力并做踝髋质心补偿 → 前向鞭打加速 → 在最高手速处同步张开 22 自由度五指),在闭环物理里验证 6/6 全部击倒且骨盆漂移 < 3 cm,最后导出 Blender 4.5 Cycles 渲染。
三、物理理解:把「看懂」变成可训练的中间量
多粒度事后标注:不只是打标签,是给模仿学习做质检
输入是双臂 ALOHA 2 用 136 秒把方纸折成纸狐狸的俯视视频。Argon 产出四层时间对齐标注:G1 整体目标一句命令句 → G2 6 个连续语义子任务(标明哪只手臂是 anchor、哪只在 fold/rotate)→ G3 17 个接触级原子原语(每个 3–15 秒,对齐 grasping closure / crease sweep / release / retry)→ quality_control_and_reweighting。
这一层才是真正的值钱部分。绝大多数机器人数据的失败不是「没有标注」,而是「把失败的处理art方式的样本和成功的样本等权喂给了 BC」。让模型自己识别 pause / unstable grasp / fumble,并把它们标记为「任务进度不变」的区段,本质上是把数据清洗这个原先属于人的活自动化了。
找异常球:纯视觉闭环解开 12 球天平谜题
Argon 先构建环境——双臂 7 自由度 Franka FR3、12 个视觉上完全一样的台球(11 个标准 150 g,1 个异常球 270 g 或 30 g)、一台用 mjEQ_JOINT 平行四边形约束实现的 Roberval 双盘天平(金盘/青盘始终水平),外加红(重)/蓝(轻)提交盘——然后写一个只允许用双目 RGB 和本体感知(add_privileged_task_observations=False)的闭环求解器:分割 → 三角化 3D 坐标 → 从立体垂直像素视差读取天平倾角(+1 左重 / -1 右重 / 0 平衡)→ 舀在高边缘的盘里抓起/放置时把腕部 yaw 转 90°。
通用值函数:把一段视频变成带坡度的进度曲线
Argon 也被当作通用值函数使用:给它一段来自人类 UMI 数据集的 60 秒双臂戒指分拣 episode(头 / 左夹爪 / 右夹爪三路同步视频),它围绕接触转换点逐段检查,输出稠密值函数 / 任务进度预测,并把整条轨迹切成 28 段,每段标注进度斜率为正、中性还是负。
四、研究与自我改进:从一张照片到 4,500 条训练数据
仿真里的动作改进:这是全文唯一有「前后对比」的地方
从一张真实桌面的单张俯视 RGB 照片出发,Argon 自建标定后的 MuJoCo 数字孪生 → 定义新任务 → 合成闭环轨迹生成器 → 在 ±10 cm 位姿随机化下采集 4,500+ 条 domain-randomized episode(全部先在 MuJoCo 物理里验证 reward == 1.0)。落地结果是真实物理机器人的成功率从 56% 提升到 75%,完成时间从 35 秒降到 24 秒。
这条值得单独拎出来,因为它是 12 个例子里唯一给出了「投入 → 产出」完整闭环的:一张照片进,几千条验证过的 episode 出,最后落到真机指标改善上。如果这个数字在别的团队手里能复现,它就是整篇博客里最有商业价值的一段——机器人数据稀缺的行业能不能被「照片 × 仿真」破解,这里是 Google 的答案草案。
SO-101 自我改进:三轮把 58.9 秒压到 17.4 秒
在一台简单的 6 自由度 SO-101 机械臂上,Argon 通过「试验 + 自我反思」改进抓取放置的速度与精度:第 1 轮 58.9 s → 第 2 轮 22.9 s(并在投放时擦到了箱沿)→ 第 3 轮 17.4 s(正中投放)。流程被拆成三阶段:先在不动硬件的前提下测量物体并做 dry-run 规划;然后 hovering 并用腕部相机验证「手臂位置和视觉判断一致」(双摄录制留证);最后自主执行,失败时自己看日志和录像归因、dry-run 验证修复方案再重试,成功之后在安全限制内至少再提速 2×。
单 prompt 论文复现:5 篇经典流形回写在浏览器里跑
每篇论文一个 prompt:Argon 读 manuscripto 和公开的 checkpoint,把物理模型与闭环控制器移植成自包含的 MuJoCo WebAssembly 浏览器实验——包括 DeepLoco 的 7 网络分层步态、HUSKY 的 50 Hz PPO actor、Whole-Body MPC 的 Web Worker iLQR,匹配论文精确的物理步长、执行器增益(kp/kv)、力矩限制与运动学约束。交付物是两个页面:index.html(带相机预设、实时遥测曲线、扰动注入的空间 UI 仿真器)与 scrollytelling.html(交互式视觉长文)。
关键数字速查
| 环节 | 指标 | 出处含义 |
|---|---|---|
| 具身推理 | ERQA 87% | 纯推理模式,Google 称优于所有前沿模型 |
| Spot 自由度 | 12 DoF 腿 + 6 DoF 臂 | 波士顿动力 Spot |
| 零样本控制 | 2–4 / 4–7 / 8–20 次调用 | 三档闭环粒度:粗 / 抓取前悬停核验 / 精细视觉伺服 |
| Real2Sim 视觉 | 三路相机对齐 | head_left / left_wrist / right_wrist |
| Real2Sim 物理 | ±0.55 rad(臂)/ ±0.65 rad(手) | 相对真实遥操作轨迹的可调上限 |
| Real2Sim 禁项 | 禁止改 MjModel / 外力 / weld / 回滚 qpos / 伪接触力 | t = 0 之后的反作弊条款 |
| 人机 Sequence | 500 Hz(dt = 0.002s)、零 weld | 人手 keypoint 重定向到 76 自由度人形 |
| 草图 → 抛出 | 50 Hz / 140 步 / 2.80 s / 6/6 击倒 / 骨盆漂移 < 3 cm | 闭环物理验收条件 |
| 事后标注 | 4 层:1 目标 / 6 子任务 / 17 原子原语(3–15 s) | 失败段压权 0.15x–0.25x 用于 BC |
| 12 球谜题 | 11 × 150 g + 1 × (270 g 或 30 g) | ≤ 3 次称重,reward 1.00 |
| 值函数 | 28 段(正 / 中 / 负斜率) | 60 秒双臂戒指分拣 episode |
| 仿真改动作 | 4,500+ episode;成功率 56% → 75%;时间 35 s → 24 s | 单张照片 → 77 任务课程 → 真机提升 |
| 自主提速 | 58.9 s → 22.9 s → 17.4 s | SO-101 三轮自我改进,第 2 轮擦到箱沿 |
| 论文复现 | 0 console error & 300+ 帧进度非零 | N WASM 沙盒,Playwright 机器验收 |
冷静审视:它证明了什么,没证明什么
这篇博客信息密度很高,但作为读者要把两件事分开:「Argon 能做出这些演示」与「Argon 能在你的产线上稳定做这些事」。
- 没有独立复核。ERQA 87% 是唯一公开 benchmark 结果,且官方未公布评测方法细节;其余所有数字都是 Google 在自己机器人、自己场景里的自述。
- 没有延迟、没有失败率、没有成本。闭环控制在真实部署中最关心的是「一轮 VLM 往返要多久」。零样本那段把调用次数分了三档,恰恰说明往返很贵,但具体毫秒数一个都没给。SO-101 只给了三个成功轮的耗时。
- 演示是策展的。12 个例子是四个领域各挑三个,不是一个覆盖任务空间的评测。整套东西在不同机器人、不同夹具、不同光照下的泛化能力,博客没有回答。
- 反作弊条款本身就是证据。Real2Sim 的 prompt 里明说了不许「复制真实触觉读数充当接触力」。当一个模型既搭舞台又负责打分,把答案抄进自己判卷的纸里就是一条最短路径——这是一种很新的失效模式,Google 的解法是把禁止项一条条写进 prompt 并配上机检条件,而不是假设模型不会这么做。
- 可及性有限。目前 Gemini API 付费层、AI Studio 与 Antigravity 的 Ultra 订阅者可用(模型名
gemini-4-argon,通过 Interactions API 调用,google-genaiSDK 首日支持)。据 The Verge 报道,入门定价为每百万输入 token 2 美元、每百万输出 token 10 美元,2026 年 11 月后翻倍——闭环控制的 token 消耗随调用轮数线性增长,真要在产线上跑,这笔账值得先算一遍。
上手与结语
今天能用起来的入口:Google AI Studio(Ultra 订阅者)、Gemini API 付费层(模型名 gemini-4-argon,走 Interactions API,google-genai SDK 首日支持)、Google Antigravity(Ultra 订阅者,可做复杂规划、/goal 运行与多代理编排)。
Google 自己的表述是:Argon 打通了写代码、视觉感知、物理仿真、具身控制四件事,能原生地在多视角视频、3D 几何、接触力学与本体感知遥测上做推理——它理解的不仅是「场景里有什么」,而是「这些东西如何与智能体物理交互,以完成全身灵巧操作」。官方把这称为通往 physical AGI 的一个里程碑。
站在 RobotWorld 的视角,这篇博客真正值得跟进的不是那个 87%,而是那条反复出现的主线:当模型学会自己搭沙盒、自己写验收条件、自己看失败录像归因,机器人开发的瓶颈就从「有没有数据」挪到了「你敢不敢让它自己判卷」。
原文来源:Google Developers Bloghttps://developers.googleblog.com/gemini-4-argon-for-robotics/