Skip to content
标签

#机器人操控 (52)

记忆即计划:基于记忆锚定规划的世界-动作建模

记忆即计划:基于记忆锚定规划的世界-动作建模

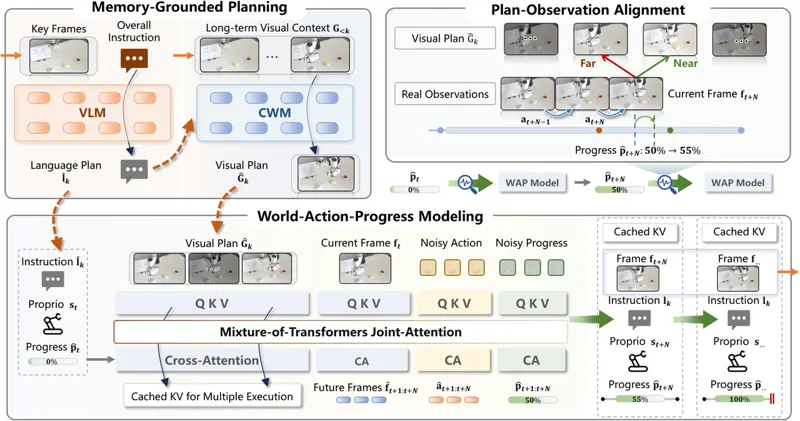
主流机器人策略把动作预测写成马尔可夫形式,只看当前观测或固定短窗口,但长时程操作往往是非马尔可夫的:决策所需的信息早已离开视野。MaP-WAM 提出「记忆即计划」:已完成的片段被记为「语言指令 + 稀疏视觉上下文」的结构化多模态情景记录(每段均匀采样 8 帧),规划时由微调的 Qwen3.5-4B 语言规划器给出下一段语言计划,再由基于 WAN-2.2-5B 的因果世界模型从长时视觉上下文生成对应的视觉计划,两者组成记忆锚定计划;执行侧的 World-Action-Progress(WAP)模型用 Mixture-of-Transformers 架构联合预测动作块、未来视觉 latent 与执行进度,进度作为一等模态参与条件与反馈。执行器只以固定长度的计划为前缀,上下文不随历史增长,块因果注意力让规划与执行两侧都可做 KV 缓存;计划-观测对齐用当前观测与视觉计划帧的像素差校准递归进度估计,进度门控(阈值 0.95)触发片段切换并把真实观测重采样写回记忆。RMBench 九个记忆依赖任务平均成功率 83.3%(最强基线 LingBot-VA 为 77.1%),真机 Franka Research 3 两个任务 88% 与 68%、平均 78.0%;1700 帧历史下全上下文执行器显存超 80GB 直接 OOM,而 WAP 保持约 827ms 每动作块的近似恒定延迟。局限:依赖基准自带的片段标注、未做自动分段;计划-观测对齐用免训练的像素差度量,复杂视觉场景下可换学习型相似度。

Sizhe Zhao, Haozhe Xie, Weiyu Zhao2026年9月10日
世界动作模型Long-Horizon MemoryMemory-Grounded Planning2026年9月10日
Harness VLA:用记忆引导的智能体把冻结 VLA 驾驭成可靠的操作原语

Harness VLA:用记忆引导的智能体把冻结 VLA 驾驭成可靠的操作原语

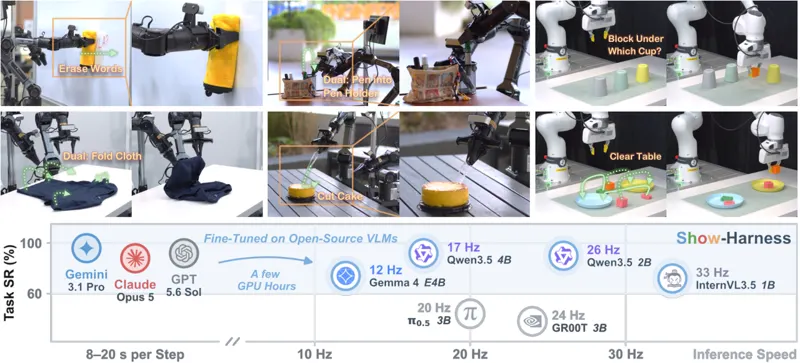
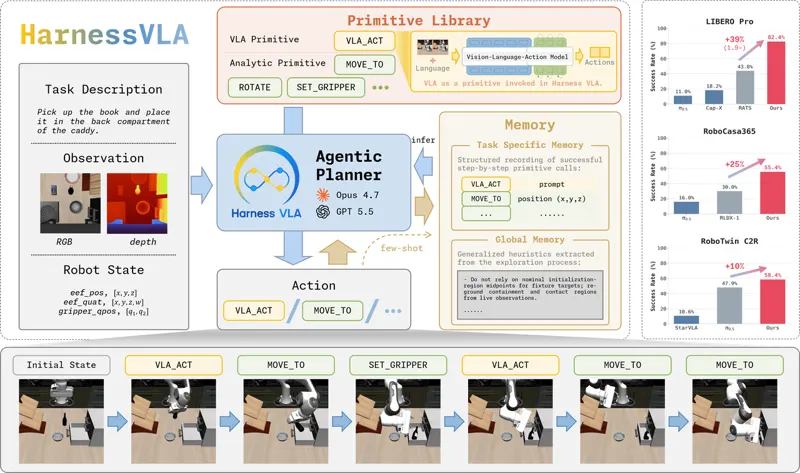
语言条件操作既需要精确的富接触控制,也需要对语言、场景和长时程的稳健推理。端到端视觉-语言-动作(VLA)模型提供强大的局部视觉运动技能,但它们是在分布内任务轨迹上训练的,在语义重定向、目标重绑定、空间布局偏移和局部接触不稳定等部署扰动下常常失效。LLM 编码智能体提供互补的语义与组合推理,但纯解析原语在不规则抓取、受限放置和铰接物体交互上表现很差。本文提出 Harness VLA,一个记忆增强的智能体框架:它把一个冻结的 VLA 暴露为可重试的富接触原语,并与一个小型固定的解析原语库组合,用于接地、暂存、搬运、导航和释放。框架不去扩大技能库,而是从任务特异的执行轨迹、全局成功规则和失败模型中学习这些固定原语的工作范围。通过把语义重接地、非接触执行和 VLA 重暂存上提到规划器,同时把冻结 VLA 留给局部富接触阶段,Harness VLA 在不微调的前提下把预训练 VLA 扩展到其原始轨迹分布之外。在被扰动的桌面操作、家庭厨房操作和 clean-to-randomized 双臂操作上,Harness VLA 在 LIBERO-Pro 和 RoboCasa365 上分别比最强相关基线高出 38.6 和 27.1 个百分点,并在 RoboTwin C2R 上达到 58.4%。代码开源于 https://github.com/RLinf/RPent 。

Yixian Zhang, Huanming Zhang, Feng Gao2026年7月9日
视觉语言动作模型机器人操控LLM智能体2026年7月9日