PAPER DEEP DIVE
PACE:面向分块插入策略的时序角色触觉条件化
接触密集的精密插入要求机器人把视觉对准与触觉调整结合起来。现有视觉-触觉分块策略通常把触觉反馈压进单一生成通路,持续接触状态、突变接触事件以及动作将造成的未来接触后果只能被隐式混合建模。PACE 将同一条触觉流拆成三种时序角色:用指数平滑的持续接触状态逐层调制动作块生成;用短窗触觉差分构成事件线索,通过门控残差只修正动作块最前面的部分;训练期再从解码器隐状态预测未来触觉增量,以辅助表示学习。该结构保留动作块的时间连续性,同时让慢变的接触阶段和快变的碰撞、卡滞获得不同处理路径。五个真实插入任务平均成功率为 90.7%,比纯视觉和单通路触觉融合基线高 44 个百分点以上;在 ManipulationNet 六种几何与间隙配置上平均成功率为 88.7%,0.1 毫米工业级间隙下仍保持较高成功率。消融显示 Phase、Event 与 Pred. 互补,跨信号实验覆盖六维触觉力、六轴力/力矩和关节电流,跨架构实验表明该原则可用于扩散策略。
论文信息:Zhiyuan Chen、Shixiong Xu、Shuai Chen、Yangwei You,北京小米机器人技术有限公司。arXiv:2610.16308v1。项目页:pace-insertion.github.io。
代码状态:本文尚未提供公开代码。项目页明确表示代码、模型和数据集会在后续发布,因此本解读不虚构源码文件、函数映射或实现细节;涉及网络结构的描述均来自论文正文和图表。
一句话总结
PACE 把一条触觉信号拆成“缓慢变化的接触阶段”“瞬时的接触事件”和“训练期预测未来触觉变化”三种时序角色,再分别用嵌入式条件调制、门控残差修正和辅助预测头接入动作分块策略,使原本只看视觉的 ACT 与 Diffusion Policy 能在高精度插入任务中获得稳定而快速的闭环修正。
研究背景与动机
精密插入是机器人操作中很典型的接触密集任务。机器人需要把销钉、连接器、USB 插头或钥匙送入狭窄孔位,而视觉往往只能看到物体是否大致对齐。真正决定成功与否的,是销钉尖端碰到孔沿之后出现的微小力变化、接触方向变化、卡滞和滑移。相机遮挡、透明或反光表面、标定误差和亚毫米级间隙会让视觉策略在最后几毫米失去可靠信息。
动作分块策略为这个问题提供了较强的动作生成骨架。ACT 通过 Transformer 一次生成一段未来动作,Diffusion Policy 则从扩散过程生成多步动作块。动作块减少了逐步决策带来的抖动,也让策略能够利用历史上下文。然而,标准动作分块主要依赖视觉 token、本体状态和示教分布。触觉输入如果只是被简单拼接进条件向量,模型虽然“看见”了力,却不一定理解当前接触已经进入哪个阶段,也不一定知道这次力突变需要立刻改写块内前几步动作。
作者观察到,触觉信息在控制中并不是以同一种时间尺度起作用。接触状态会随着插孔深度缓慢演进,适合形成连续上下文;碰撞、跨过孔沿和姿态突然偏转则表现为短时差分,需要快速响应;而未来触觉变化又能够作为一种训练监督,迫使策略内部表征提前编码“接下来接触会怎样”。把这三种需求压进一个同质的触觉 token 或单一融合层,容易让慢变量淹没快事件,或者让辅助信号与动作生成的职责混在一起。
PACE 的核心主张因此不是简单地“给 ACT 加触觉”,而是给同一触觉流分配不同的时间角色。Phase 负责表达任务进程,Event 负责局部纠错,Pred. 负责塑造可预测的内部状态。三者共享原始触觉证据,却以不同路径进入网络。这个设计把触觉条件化从一次静态融合,改造成围绕动作块生命周期的动态控制。
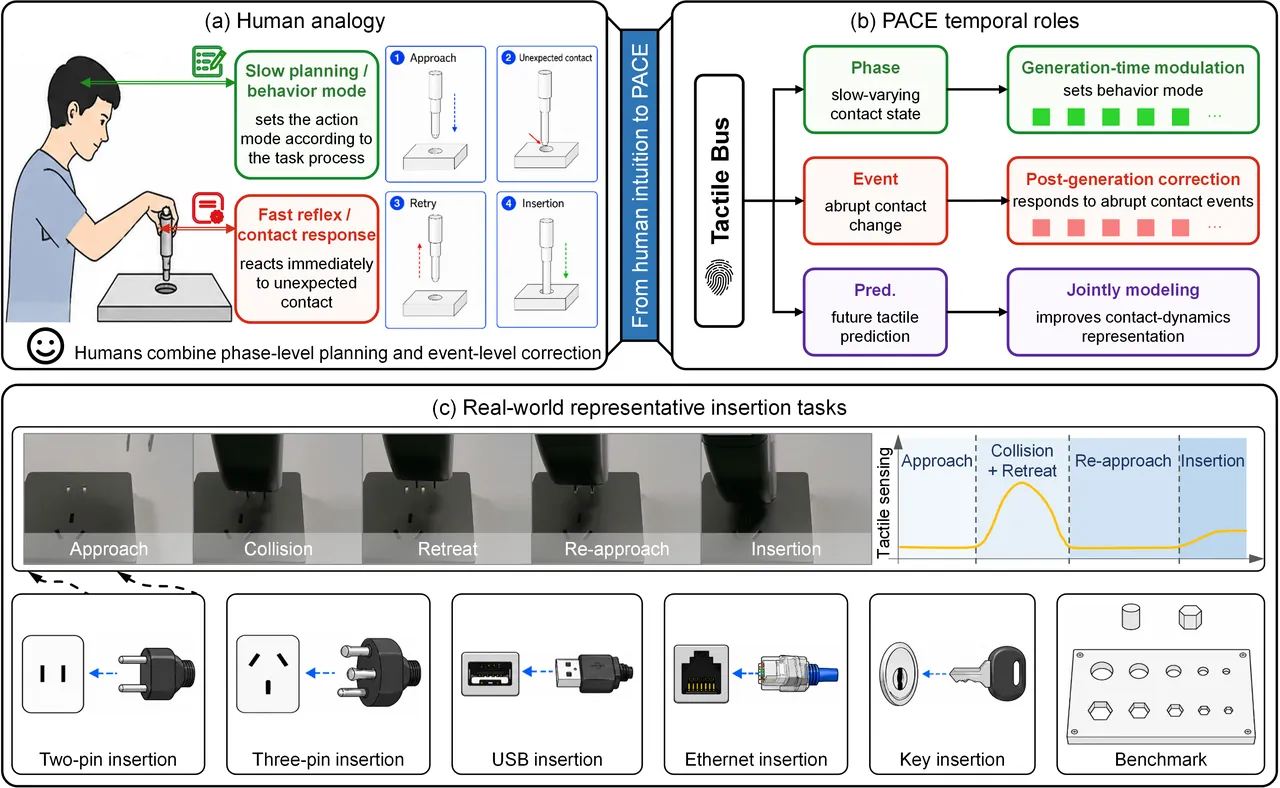
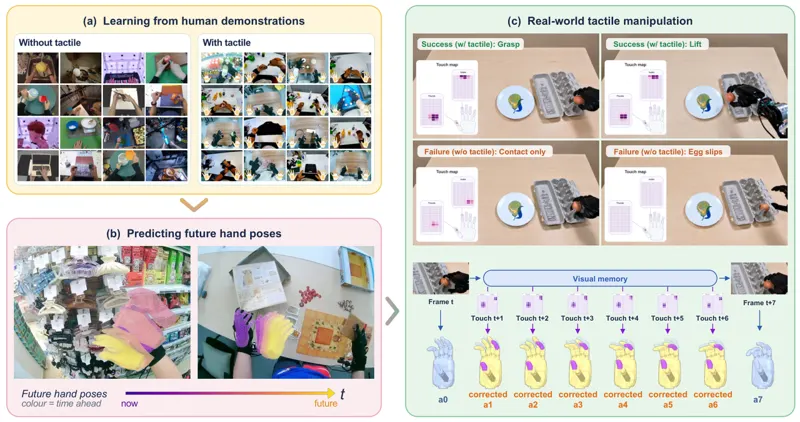
图1:论文用三种时序角色概括触觉条件化,并展示真实插入任务中的接触场景。
预备知识:动作分块与触觉条件
设当前观测为视觉、本体状态与触觉读数的组合,策略在每个控制时刻输出未来 $H$ 步动作。本文为 ACT 设置的默认动作块长度为 $H=20$,动作维度为 7,控制频率为 20Hz,因此一个块覆盖约 1 秒的未来运动。策略可以只根据块的前几步执行,也可以在执行完整个块后重新观测。动作分块能否适应接触,关键在于块内动作是否还保留被最新触觉纠正的入口。
ACT 的 Transformer 编码器把视觉与状态信息压成上下文,解码器再结合 CVAE 隐变量生成动作序列。PACE 保持这一骨架不变,只在编码器上施加阶段条件,并在生成后的动作块上做局部事件修正。它没有另造一个大型触觉基础模型,而是用很小的模块改变信息流。这个选择让方法可以嫁接到 ACT 与 Diffusion Policy,也使额外参数和延迟保持在可接受范围。
触觉序列记为 $\mathbf{w}_t$。论文实验中的主触觉输入为 6 维信号,并额外测试六轴力/力矩与 7 维关节电流作为替代反馈。网络需要同时处理绝对接触强度、短窗变化量和未来变化量。PACE 用指数移动平均提取慢分量,用差分窗口提取快分量,再用辅助头预测下一步触觉增量。三路信号对应三种明确的时间粒度。
方法详解
一、整体架构:围绕动作块安排三类触觉角色
PACE 的输入仍包含视觉、机器人状态和历史动作。Phase 分支对触觉序列做平滑,得到连续接触状态,再通过逐层 FiLM 仿射参数改变编码器特征。Event 分支使用长度为 $T_w=4$ 的短窗差分,生成与当前接触变化有关的嵌入,再预测动作块前 $h_{\text{corr}}=5$ 步的门控残差。Pred. 分支只在训练阶段存在,从解码器隐状态预测未来归一化触觉增量。
三个角色并非串行流水线,而是在不同层级上同时约束网络。Phase 影响编码器上下文,决定动作生成时对当前接触阶段的整体判断;Event 影响动作块输出,负责快速局部修正;Pred. 影响训练目标,提升隐状态对未来接触变化的可预测性。推理时移除 Pred. 分支,只保留 0.575M 参数,因此额外的在线延迟小于 0.3ms。
flowchart TD
  T[Tactile history] --> S[EMA contact state]
  T --> D[Short-window delta Tw=4]
  S --> F[Layer-wise FiLM on encoder]
  V[Vision and robot state] --> E[ACT encoder]
  F --> E
  E --> B[Action chunk decoder H=20]
  B --> G[Generated action chunk]
  D --> R[Event embedding and gate]
  R --> C[Residual correction on first 5 actions]
  G --> C
  C --> A[Executed corrected chunk]
  B --> P[Training-only tactile delta head]
  P --> L[Auxiliary prediction loss]
  L --> E
这张图体现了 PACE 与“早期拼接触觉”的关键差异。触觉不是只进入一次输入,而是分别进入上下文、动作块和训练目标。离线时所有分支共同塑造表示;在线时只留下对控制真正有用的两个入口,避免预测头增加闭环负担。
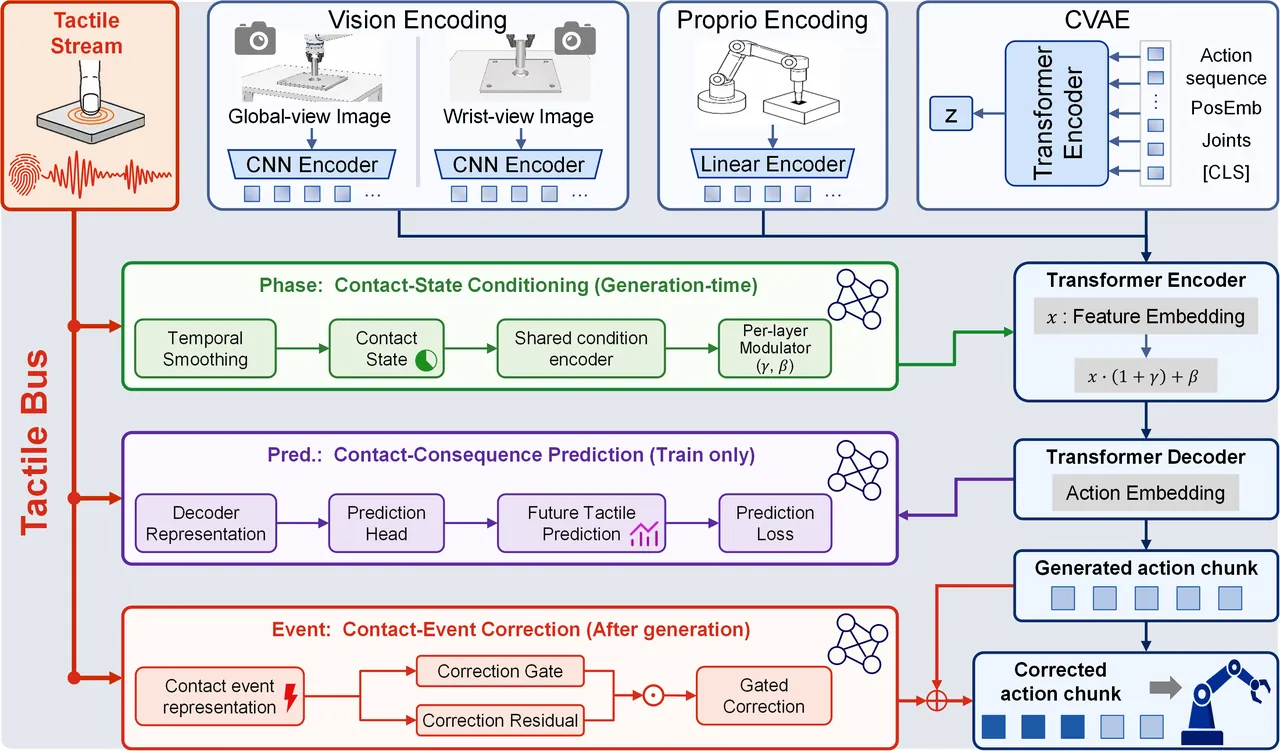
图2:PACE 将 Phase 调制、Event 残差和训练期触觉预测接到 ACT 动作块上。
二、Phase:用慢触觉状态控制整段动作的上下文
Phase 的目标是回答“现在处于插入的哪个接触阶段”。原始触觉读数有噪声,单帧尖峰可能来自摩擦、振动或传感器量化误差。PACE 先对触觉向量做指数移动平均,形成稳定的接触状态。平滑系数越小,状态越平滑但响应越慢;系数越大,瞬时扰动越容易进入编码器。论文默认 $\alpha=0.05$,强调阶段量应当反映持续性接触,而不是替代 Event 的快速检测职责。
$$ \mathbf{w}^{\text{state}}_{t}=(1-\alpha)\mathbf{w}^{\text{state}}_{t-1}+\alpha\mathbf{w}_{t} $$式中的 $\mathbf{w}^{\text{state}}_t$ 是第 $t$ 个控制时刻的平滑触觉状态,$\mathbf{w}_t$ 是当前原始读数。该状态被送入一个小型映射网络,为 Transformer 编码器的每一层产生缩放和偏置。与只在输入前拼接一个触觉向量相比,逐层 FiLM 让接触阶段能够在多个表征深度上重新分配视觉与状态特征的权重。
$$ (\gamma^{l}_{s},\beta^{l}_{s})=\phi^{l}_{\text{phase}}(\mathbf{w}^{\text{state}}_{s}) $$ $$ \widetilde{\mathbf{h}}_{l}=(1+\gamma^{l}_{s})\odot\mathrm{LN}(\mathbf{h}_{l})+\beta^{l}_{s} $$其中 $l$ 表示编码器层,$\mathrm{LN}$ 是层归一化,$\gamma^{l}_{s}$ 与 $\beta^{l}_{s}$ 是接触状态 $s$ 对应的仿射参数,$\odot$ 表示逐元素乘法。这里用 $s$ 表示被条件化的动作块或决策时刻,而不是每一帧都重新改写整套上下文。这样同一条慢触觉状态可以稳定地影响一个动作块,符合阶段信号的持续属性。
Phase 的设计还有一个隐含约束:它只改变已有编码器特征,不改变动作块长度,也不直接覆盖输出。因此当接触阶段判断错误时,Event 仍有机会通过短窗门控修正前五步。Phase 提供“背景”,Event 提供“冲击”,二者是互补关系。消融结果也支持这一点:移除 Event 后平均成功率下降到 66.7%,说明仅有阶段条件不足以处理快速接触变化。
三、Event:用短窗差分和前五步残差争取反应时间
精密插入中的关键事件持续时间很短。销钉从孔沿滑入孔口、插头因角度错误突然卡住、夹爪与物体之间发生微小滑移,都会让触觉向量在几十毫秒内发生变化。若把这些变化继续平均,最有用的瞬时证据会被抹平;若让模型重新生成整个动作块,又可能破坏已经合理的后续轨迹。PACE 因此把 Event 限定为“检测变化并修正动作块的头部”。
网络先对触觉做归一化,再计算当前时刻与 $T_w-1$ 步之前之间的差分。差分向量再拼接其 L2 范数,显式提供总体变化强度。论文默认 $T_w=4$,在 20Hz 控制下覆盖约 0.15 秒的历史;修正范围 $h_{\text{corr}}=5$,约 0.25 秒。这个时间窗足以把立即执行的几步从错误方向拉回,但不会把整段未来动作都交给短时噪声重写。
$$ \bar{\mathbf{w}}_{s}=\mathcal{N}(\mathbf{w}_{s}) $$ $$ \Delta\mathbf{w}_{s}=\bar{\mathbf{w}}_{s}-\bar{\mathbf{w}}_{s-T_{w}+1} $$ $$ \mathbf{e}_{s}=[\Delta\mathbf{w}_{s},\|\Delta\mathbf{w}_{s}\|_{2}] $$$\mathcal{N}$ 表示训练数据统计得到的归一化,$\Delta\mathbf{w}_s$ 是短窗触觉差分,$\mathbf{e}_s$ 是事件嵌入。门控网络从事件嵌入产生逐维系数,残差网络从动作块 $\mathbf{W}_s$ 产生修正量。门控不是恒定的,而是根据当前触觉变化决定修正强弱:没有明显事件时,网络可以保留原始动作;发生强变化时,门控放大残差。
$$ \mathbf{g}_{s}=\sigma(\phi_{\text{gate}}(\mathbf{e}_{s})) $$ $$ \mathbf{R}_{s,0:h_{\text{corr}}-1}=\phi_{\text{res}}(\mathbf{W}_{s}) $$ $$ \mathbf{A}^{\text{corr}}_{s,0:h_{\text{corr}}-1}=\mathbf{A}^{\text{gen}}_{s,0:h_{\text{corr}}-1}+\mathbf{g}_{s}\odot\mathbf{R}_{s,0:h_{\text{corr}}-1} $$$\mathbf{A}^{\text{gen}}$ 是原始动作块,$\mathbf{R}$ 是残差,$\mathbf{g}$ 是门控,最终只改写前 $h_{\text{corr}}$ 步。加法残差让网络在默认情况下接近原策略,只有事件证据足够时才偏离。这一结构比直接把事件 token 拼接到输入更容易控制影响范围,也让“反应快”与“保持动作块平滑”不再直接冲突。
从控制角度看,这种局部修正相当于在动作块内部建立一个低延迟的反射层。视觉和阶段上下文决定动作的大方向,最近几次触觉差分决定是否在前 0.25 秒内改道。执行器仍能获得连续动作块,策略也不需要因为每个触觉尖峰就重新启动一次完整的 Transformer 推理。
四、Pred.:用未来触觉预测塑造训练期表示
Pred. 分支处理的是另一种时间角色:它不是当前动作的条件,而是训练期间对未来的约束。对每个训练样本,论文计算相邻触觉帧的归一化增量,把这个增量作为回归目标。辅助头从动作解码器的隐状态预测未来 $H$ 步触觉变化。若策略的内部状态只能解释当前观测,却无法预判接触将如何演变,预测误差就会把梯度传回编码器和解码器。
$$ \Delta\mathbf{w}^{\text{gt}}_{t}=\mathcal{N}(\mathbf{w}_{t})-\mathcal{N}(\mathbf{w}_{t-1}) $$ $$ \mathcal{L}_{\text{pred}}=\left\|\phi_{\text{pred}}(\mathbf{z}_{s:s+H-1})-\Delta\mathbf{W}^{\text{gt}}_{s:s+H-1}\right\|_{2}^{2} $$$\mathbf{z}$ 表示与动作块对应的解码器隐状态,$\Delta\mathbf{W}^{\text{gt}}$ 是真实未来触觉增量序列。这个辅助任务与动作重建共享表示,但不需要在推理时继续运行。总损失由动作损失、ACT 原有的 KL 项和预测损失组成,默认 $\lambda_{\text{kl}}=10$,$\lambda_{\text{pred}}=0.05$。较小的预测权重既能提供结构化监督,又不会压过动作学习。
$$ \mathcal{L}=\mathcal{L}_{\text{act}}+\lambda_{\text{kl}}\mathcal{L}_{\text{KL}}+\lambda_{\text{pred}}\mathcal{L}_{\text{pred}} $$消融中移除 Pred. 后平均成功率从 90.7% 降到 85.3%。这说明未来触觉预测并非主导动作生成的另一个控制器,而是一种有效的表示正则化。它迫使网络在动作块生成时提前考虑后续接触,减少“动作已经生成完,直到执行受阻才发现下一阶段不同”的滞后。
五、参数成本与可迁移性
PACE 的基础 ACT 主干为 83.87M 参数,完整方法新增 0.841M,约为基础模型的 1.0%。推理时移除 Pred. 后保留 0.575M 参数,额外计算延迟小于 0.3ms。对 20Hz 控制而言,这一延迟远低于 50ms 的控制周期。方法的主要成本来自逐层 FiLM 和局部残差,而不是重新训练一个大规模触觉编码器。
论文还把 PACE 接到 Diffusion Policy。原始 DP 为 310.5M 参数,加入 PACE 后增加 3.6M,约占 1.2%。跨架构实验中,视觉 DP 从 18.3% 提升到 88.3%,提升 70.0 个百分点。这个结果比单一 ACT 实验更能说明方法针对的是“动作分块如何吸收触觉”,而不是 ACT 独有的某个偶然实现。
六、与简单触觉融合的区别
Tactile Concat 把触觉向量与视觉和状态拼接,模型理论上也能学习阶段与事件,但没有显式分离时间尺度。Tactile Cross-Attention 让动作 token 查询触觉 token,能够选择相关信息,却仍把快速事件和慢速阶段放在同一注意机制中。PACE 的差别在于为三种信号指定了不同的作用位置:Phase 改编码上下文,Event 改动作块头部,Pred. 改训练目标。
实验结果显示了这种结构化的价值。在五个真实任务上,Tactile Cross-Attention 平均成功率为 39.3%,Tactile Concat 为 46.0%,完整 PACE 为 90.7%。差距并非几个样本的波动,而是在每个单任务上都接近翻倍或更多。尤其是 USB 与网线这类细长、容差小的物体,PACE 仍分别达到 28/30 与 27/30。
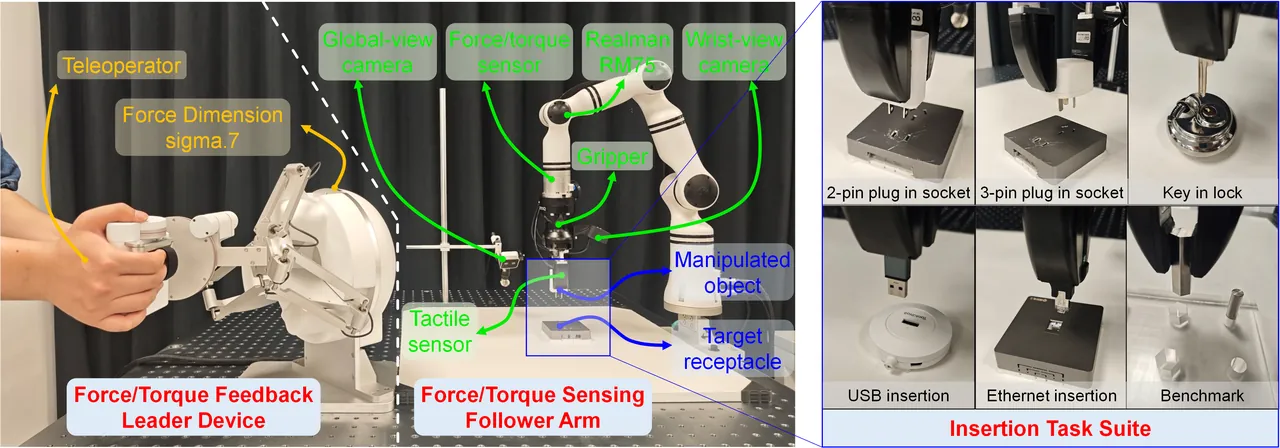
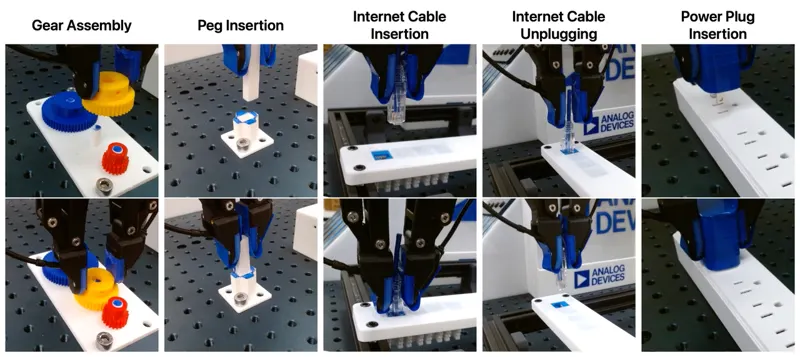
图3:力反馈遥操作平台、五类真实插入任务,以及用于模拟接近工业场景的 ManipulationNet。
实验设置与主结果
论文在五类真实插入任务上评估:2-pin、3-pin、USB、Ethernet 与 Key。每种方法在每个任务上执行 30 次试验。训练使用带力反馈的遥操作示教,控制频率为 20Hz。所有方法共享相近的视觉与动作接口,重点比较触觉条件化的接入方式。
| 方法 | 2-pin | 3-pin | USB | Ethernet | Key | 平均 |
|---|---|---|---|---|---|---|
| 视觉 ACT | 4/30 | 4/30 | 2/30 | 1/30 | 4/30 | 10.0% |
| 视觉 DP | 5/30 | 6/30 | 4/30 | 3/30 | 5/30 | 15.3% |
| π0 | 6/30 | 8/30 | 4/30 | 4/30 | 6/30 | 18.7% |
| ACT + 触觉交叉注意力 | 10/30 | 15/30 | 11/30 | 9/30 | 14/30 | 39.3% |
| ACT + 触觉拼接 | 13/30 | 17/30 | 12/30 | 13/30 | 14/30 | 46.0% |
| PACE | 27/30 | 29/30 | 28/30 | 27/30 | 25/30 | 90.7% |
视觉策略的表现说明仅靠外观无法覆盖插入末段。视觉 ACT 平均只有 10.0%,视觉 DP 为 15.3%,即便使用视觉语言动作模型 π0,也仅达到 18.7%。接入触觉后,普通融合方法把成功率提升到四成左右,证明触觉本身有信息量;但 PACE 继续拉到 90.7%,说明“如何组织触觉时间信息”与方法是否使用触觉同样重要。
五个任务中,3-pin 对空间方向和接触分布的要求更复杂,PACE 仍达到 29/30。Key 是最困难的任务之一,最终为 25/30。它比 USB 和网线更容易出现夹持滑移与旋转,因此成功率略低,但相对 46.0% 的强基线仍保持明显优势。作者没有用平均成功率掩盖任务差异,而是保留了每个任务的具体试验数,便于判断失败集中在哪类几何。
为了避免只在桌面实验装置上有效,论文还在 ManipulationNet 上测试圆柱与六边形销钉,覆盖 3mm、1mm 与 0.1mm 三种间隙。0.1mm 间隙接近工业精密装配的苛刻范围,视觉与单纯位置控制几乎没有容错空间,力反馈成为判断孔沿与姿态偏差的主要依据。
| 销钉几何 | 3mm 间隙 | 1mm 间隙 | 0.1mm 间隙 |
|---|---|---|---|
| 圆柱销钉 | 25/25 | 22/25 | 21/25 |
| 六边形销钉 | 24/25 | 22/25 | 19/25 |
六种几何与间隙组合的平均成功率为 88.7%。圆柱销钉在 0.1mm 仍达到 21/25,六边形销钉为 19/25,后者对旋转与角向对齐更敏感。结果的意义不只是绝对值,而是 PACE 没有依赖某一种特定销钉形状:阶段调制、事件残差与训练期预测在不同几何上仍能形成统一控制逻辑。
消融、替代反馈与跨架构验证
论文的消融实验直接检验三种时序角色是否都必要。移除 Pred. 后成功率为 85.3%,移除 Phase 后为 78.7%,单独移除 Event 后降到 66.7%。其中 Event 的贡献最大,因为动作块生成后如果没有任何局部改写通道,短时接触变化只能等下一次整块重规划。Phase 和 Pred. 则分别从上下文与表示学习层面改善策略。
| 配置 | 平均成功率 | 相对完整 PACE 的变化 |
|---|---|---|
| 完整 PACE | 90.7% | 基准 |
| 移除 Pred. | 85.3% | -5.4 个百分点 |
| 移除 Phase | 78.7% | -12.0 个百分点 |
| 移除 Event | 66.7% | -24.0 个百分点 |
| 仅 Phase | 60.0% | -30.7 个百分点 |
| 仅 Phase,动作块 H=10 | 49.3% | -41.4 个百分点 |
“仅 Phase,H=10”进一步说明阶段条件不能替代局部事件闭环。缩短动作块会让策略更频繁重规划,理论上增加反馈机会,但若没有专门的事件残差,成功率仍只有 49.3%。这反驳了“只要把动作块缩短,触觉自然就能生效”的简单假设。PACE 的有效性来自让最新事件明确进入当前块的头部,而不是单纯增加重规划次数。
方法也没有绑定 6 维触觉。使用默认 6 维触觉时成功率为 93.3%,改用六轴力/力矩为 90.0%,改用 7 维关节电流为 88.3%。力/力矩与关节电流的信息结构不同于触觉阵列,但仍能获得接近结果。这说明 PACE 更关心反馈信号的时序角色,而不是要求某种固定传感器格式。关节电流结果稍低,可能因为它同时受到重力、摩擦、传动与负载耦合影响,接触事件的信噪比不如专用触觉。
跨架构迁移的结果从 DP 18.3% 到 DP+PACE 88.3%,提升 70.0 个百分点。ACT 与 DP 的动作生成机制差异很大,前者通过 CVAE 与 Transformer 解码动作块,后者通过扩散去噪生成动作。PACE 能在两者上生效,说明“阶段条件 + 事件残差 + 未来触觉预测”不是依赖某一特定动作头的小技巧,而是一种可以套在动作分块外层的接口。
论文还比较了 RDP 与 PACE。PACE 在 2-pin 上为 29/30,在 Key 上为 27/30;RDP 分别为 19/30 与 12/30。RDP 也尝试利用触觉或反应式信息,但 PACE 的领先表明把事件修正限定在动作块前部、同时用慢状态调制编码器,能更有效地兼顾长期动作结构与短时接触反应。
机制分析:网络是否真的在用 Phase 与 Event
高成功率本身不能证明设计按预期工作,论文因此分析了两个分支的统计行为。Phase 嵌入在不同接触强度分箱之间存在显著差异,单因素方差分析得到 $F=8.36$、$p<10^{-4}$、$\eta^2=0.236$。这表示阶段表示确实随接触强度变化,而不是学习到一个与触觉无关的常量。
Event 分支也表现出与接触变化率的一致性。事件修正幅度与接触变化率正相关,相关系数 $r=0.356$、$p<0.001$。相关性不是因果证明,但至少说明门控残差不是随机噪声:当触觉短窗变化更大时,网络倾向施加更强修正。结合移除 Event 后的大幅性能下降,可以认为局部动作修正通道承担了实际控制功能。
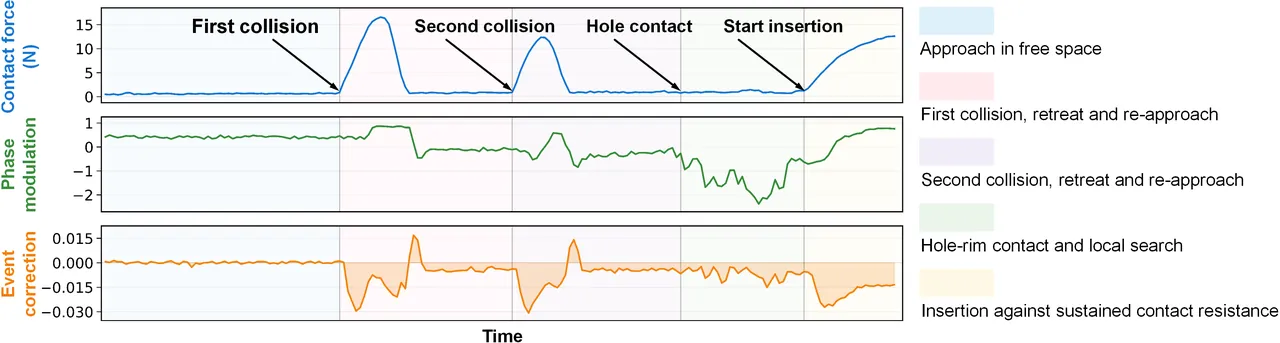
图4:完整插入过程中的力曲线、阶段条件与事件修正,展示了慢状态和短时变化的配合。
图 4 把方法放回到一次完整插入轨迹中观察。接触建立后,触觉强度并非单调上升,而是在孔沿、姿态调整和滑入过程中出现多次变化。Phase 呈现较平滑的状态演进,Event 则对短窗变化更敏感。两者在时间轴上的差异正好对应网络结构中的分工:Phase 适合作为整块动作的背景,Event 适合在前五步中快速抵消偏差。
示教质量与触觉反馈的作用
力反馈不仅影响策略推理,也影响示教数据质量。论文比较了开启与关闭力反馈时的遥操作演示,并用策略成功率、力方差、轨迹间偏差与峰值力评估。PACE 在 2-pin 任务上使用开启反馈的示教达到 29/30,关闭反馈时为 21/30;ACT + Tactile Concat 对应为 17/30 与 7/30。相同策略对示教质量更敏感,说明数据中的力信息会改变策略可学习的接触行为。
关闭力反馈后,力方差从 4.8 增加到 12.7 N²,意味着操作过程中的接触力更不稳定;轨迹间偏差从 1.07 增加到 1.92 N,说明不同演示之间的一致性下降;峰值力从 $10.0\pm2.2$ N 增加到 $16.7\pm7.1$ N,显示失误时的冲击更强。力反馈帮助操作者感知孔沿与卡滞,减少盲目施力,这对精密插入和硬件安全都有直接价值。
这部分实验也暴露了一个容易被忽略的训练问题:触觉策略的上限不只取决于模型结构,还取决于演示是否真正包含可辨识的触觉因果。如果示教者在没有力反馈时反复碰撞、依靠视觉试错完成插入,数据中的接触事件会包含大量偶然修正和高力冲击。网络可能学会复现这些粗糙动作,尤其是 Event 分支会把冲击当成正常模式。
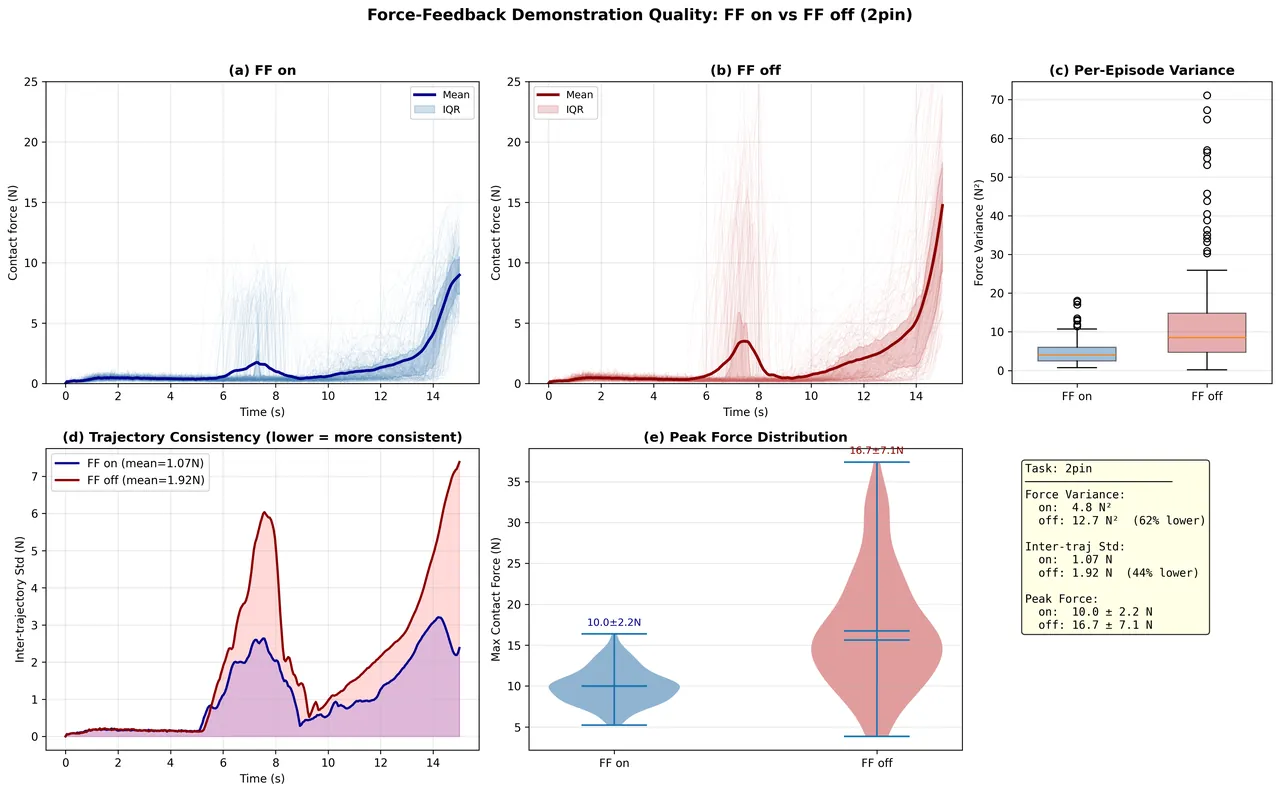
图5:开启与关闭力反馈的示教质量对比,包括成功率、力方差和峰值力等指标。
示教质量分析对实际部署很有价值。很多系统把“传感器装上了”当作完成,却忽略了遥操作者能否实时利用反馈、教学界面是否提供足够带宽、传感器标定是否随工具更换而更新。PACE 结果表明,同样的触觉网络在不同演示条件下差距明显,数据采集流程本身是系统性能的一部分。
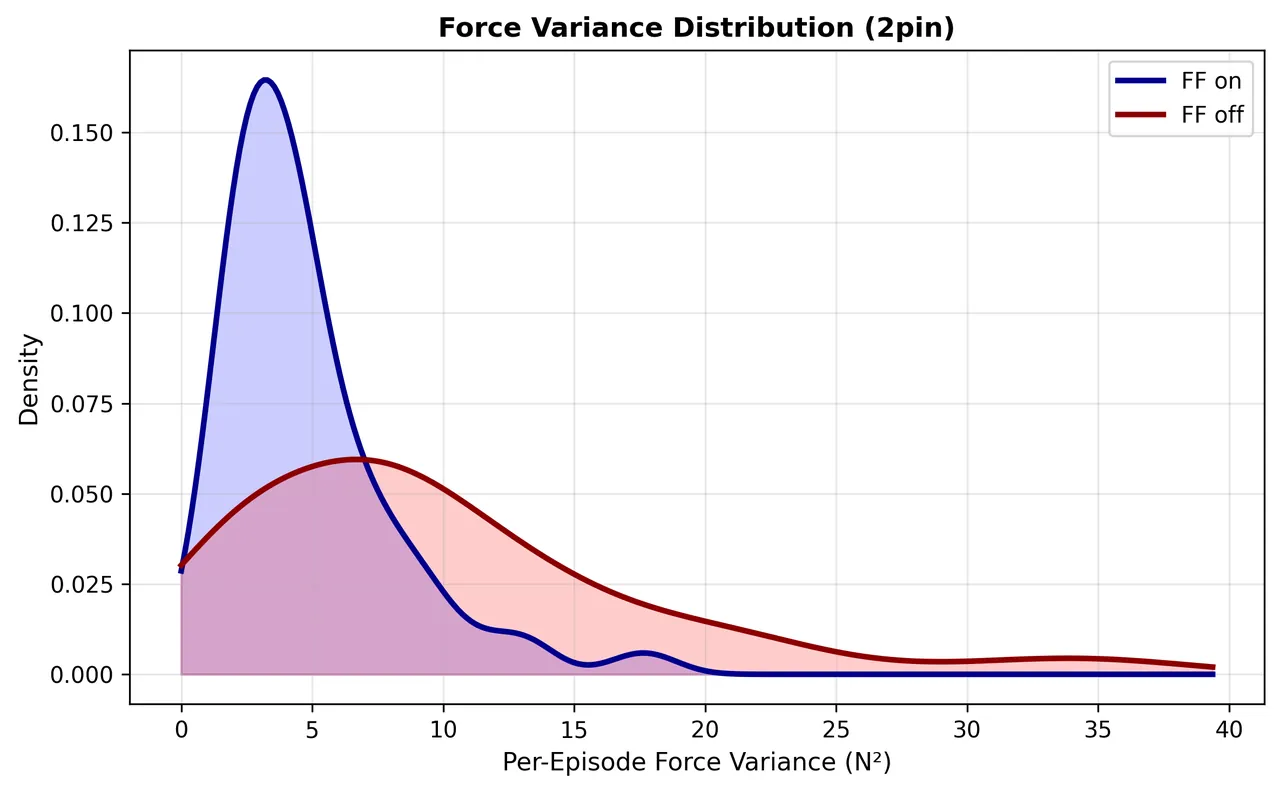
图6:单回合接触力方差的分布。力反馈示教整体分布更集中,关闭反馈时出现更长的高方差尾部。
失败机制:PACE 仍然不是万能接触控制器
论文没有只报告成功案例,还分析了真实失败。第一类失败是回撤高度不足,同时抬升与横移动作发生耦合。机器人没有先把销钉完全退出孔沿,就开始斜向移动,导致销钉尖端以孔沿为支点转动。此时触觉会显示局部受力,但动作方向本身被几何约束锁住,简单的局部残差无法恢复足够间隙。
第二类失败来自多次修正累积。策略每次检测到接触偏差都会改写动作块头部,但如果每次都改变接触点而没有重新建立稳定姿态,销钉倾角会逐步累积,最后卡死在孔内。这说明 Event 分支需要“修正强度”之外的安全约束,例如限制连续同向修正次数、检测接触点是否稳定,或在多次修正后主动执行受控回撤。
第三类失败与夹爪材质有关。硅胶夹爪对窄平物体的横向剪切抵抗较弱,在旋转或侧向接触时更容易发生滑移。触觉策略可以识别到接触变化,却不一定能区分“物体在孔沿偏转”与“物体相对夹爪滑动”。如果缺少夹爪内触觉或更丰富的腕部力/力矩信息,PACE 只能通过外部接触反馈间接推断,恢复空间有限。
局限性
第一,作者明确承认方法只在精密插入场景中验证。擦拭、推拉、可变形物体操作和双臂装配等任务具有不同的接触拓扑与力分布,尚未测试。PACE 的 Phase/Event/Pred. 角色是否足以覆盖这些任务,还是需要增加接触拓扑、摩擦状态或形变预测,仍不能从现有实验下结论。
第二,Event 分支使用固定的平滑系数、窗口长度和修正步数。$\alpha=0.05$、$T_w=4$、$h_{\text{corr}}=5$ 在本文任务中有效,但真实接触的时间尺度会随物体刚度、控制频率和插入速度变化。作者提出未来可以让这些时间常数随接触阶段学习或自适应调整。目前的方法需要针对新硬件和新任务重新调参,自动泛化能力仍有限。
第三,Pred. 只在训练期使用,推理时没有把未来触觉预测用于候选动作筛选或安全规划。虽然辅助头改善了表示,但策略并不能在动作执行前比较多个动作块“未来会造成多大的接触力”。若预测头在线保留并接入安全约束,可能进一步减少高力冲击和不可逆卡死,但也会增加推理成本,作者尚未验证这种闭环形式。
第四,PACE 假设物理反馈具有足够信息量。弱接触、传感器校准不准、漂移或线缆干扰会降低事件检测质量。尤其是 0.1mm 级间隙下,接触强度很小,Phase 可能长时间停留在低接触区间,Event 差分也更容易受噪声影响。方法本身没有提出独立的传感器健康监测或自适应校准机制。
从系统部署角度看,还有数据覆盖与安全边界问题。真实插入收集成本高,不同插座、物体材质和装配公差会造成分布变化。Event 残差虽然只改前五步,但仍可能把动作推向未示教区域。实际系统需要力上限、工作空间限制、碰撞保护和失败后自动回撤,不能把策略成功率当作唯一安全指标。
总结与展望
PACE 的贡献可以概括为一种时间角色分解。它没有把触觉视为静态附加输入,而是分别让慢状态调制编码器、短窗事件修正动作块头部、未来变化监督解码器表示。这样的设计尊重了触觉在接触任务中的多尺度本质,同时保持动作分块策略的原有结构,不需要为每个角色重建整套网络。
实验证据比较完整:五个真实任务的逐项成功率、ManipulationNet 的不同销钉与间隙、三组消融、三种反馈信号、ACT 与 DP 两种架构、RDP 对比、Phase 与 Event 机制统计,以及示教质量分析。最重要的数字是 90.7% 对 46.0% 的强融合基线,以及移除 Event 后降到 66.7%。它们共同支持“事件残差不是装饰,而是动作块快速闭环的核心接口”这一结论。
下一步最自然的方向是让时间尺度和修正强度自适应。若网络能根据接触状态估计当前是接近、孔沿接触、姿态调整还是滑入阶段,就可以动态选择短窗长度和修正范围。其次是把未来触觉预测从辅助损失扩展为执行前筛选,对高风险动作块提前限速或回撤。最后是把力反馈示教、传感器校准与硬件设计纳入统一流程,因为数据质量直接决定触觉策略的上限。
对机器人开发者而言,PACE 提供了一个清晰的工程启示:给动作块接触觉,不应只问“把触觉拼到哪里”,还要问“触觉在什么时间尺度上改变哪一步决策”。阶段信息负责理解任务,事件信息负责争夺反应窗口,预测信息负责提前塑造表示。把这三件事混在一起,模型会变复杂;把它们放在正确的位置,才会变成可靠的接触闭环。
金句
触觉不是动作块旁边的一项输入,而是沿时间展开的控制角色:慢状态决定当前该怎样做,快事件决定接下来几步要不要改。