PAPER DEEP DIVE
T-WLA:慢视觉,快触觉
T-WLA 以共享历史视觉记忆连接慢速视觉与高频触觉残差修正,在 EgoTouch、Tachin 与四项真机接触操作上提升精度和成功率。
论文元信息
标题:T-WLA: Bridging Slow Vision and Fast Touch(T-WLA:连接慢视觉与快触觉)
作者:Kaichen Zhou、Yuzhen Chen、Hannah Yao、Chonghe Jiang、Rao Fu、Xihang Yu、Wei Dai、Bashar Kabbarah、Haoyu Chen、Ishita Goluguri、Zhiyang Dou、Haonan Chen、Fangneng Zhan、Mengyu Wang、Wojciech Matusik、Antonio Torralba、Paul Pu Liang(麻省理工学院、哈佛大学、加州大学戴维斯分校、加州大学伯克利分校;前三位作者贡献相同)
链接:arXiv:2610.28814v1 [cs.RO],2026-10-20;全文 https://arxiv.org/abs/2610.28814 ;项目页 https://anonymous-submission-20.github.io/T-WLA.github.io/
代码状态:论文摘要写有“Videos and codes are available”,项目页也确实提供了四类真机演示、手部姿态示例与总览视频;但截至本次采集,项目页没有任何代码仓库入口,GitHub 按标题与方法名搜索也没有找到公开实现。因此本文目前可复现的是方法结构与训练配方,代码权重尚不可得。下文会把论文陈述与项目页现状分开标注,不把“声称开源”当作“已经开源”。
一句话总结
T-WLA 把视觉策略当作低频规划器:每 39.7 Hz 生成一段动作块和一份可复用的历史视觉记忆;再让一个 119.1 Hz 的轻量触觉编辑器只改“还没执行的动作”,从而在两次视觉更新之间用触觉残差修正动作,最终把四项真机接触操作的平均成功率从 17.0% 提到 50.0%,并把手指关节 MPJPE 降低约 30%。
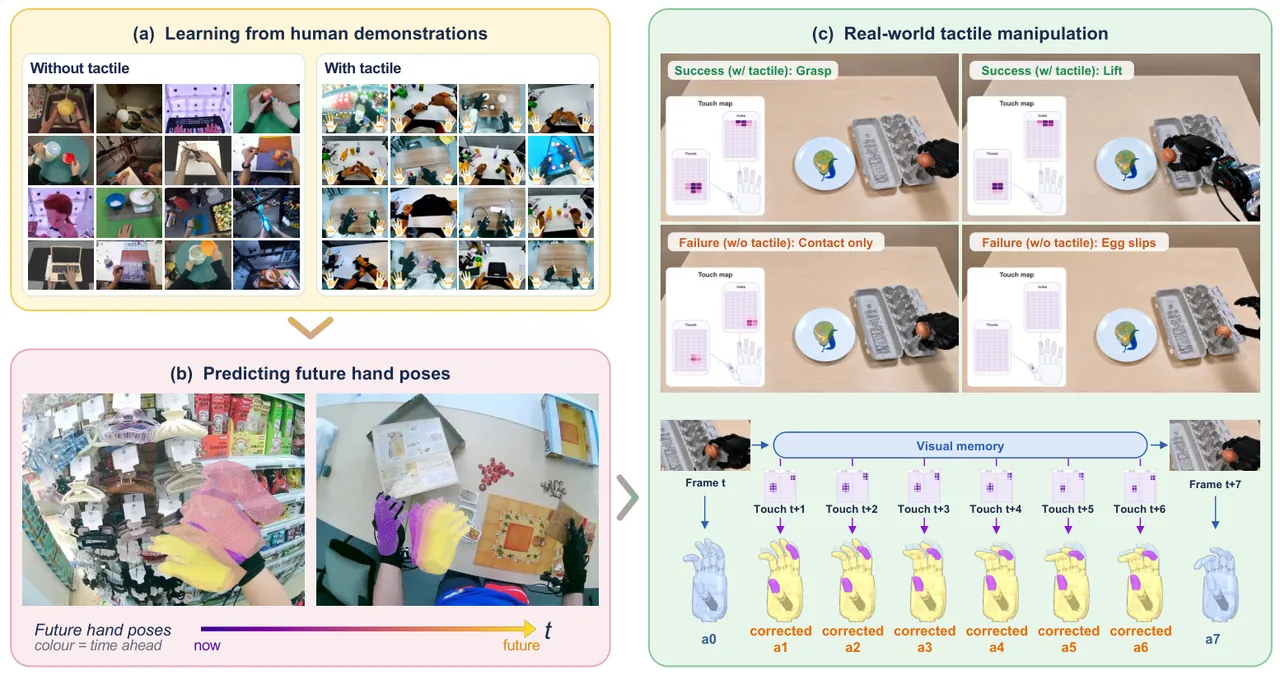
图 1:T-WLA 总览(论文 Fig. 1)。(a) 人类示教有触觉与无触觉的对比;(b) 预测未来手部姿态;(c) 真机触觉操作:有触觉时能纠正抓握与抬升,无触觉时鸡蛋滑落。
研究背景与动机
接触密集操作有一个天然的时间尺度错位:视觉模型看到的是几十毫秒前的画面,而接触状态可能在几毫秒内改变。插头刚碰到插座、纸杯边缘刚开始滑、薄纸被指尖夹住的那一瞬,相机未必能分辨,触觉却已经感知到压力与接触位置的变化。
现有视觉—语言—动作模型大多只按视觉时钟运行。每次新图像到来,模型重新编码场景、理解指令、生成一整段动作;如果接触条件在下一帧之前变化,策略只能等下一次视觉推理,或者用固定控制律硬撑。重跑视觉主干会带来延迟,而单靠触觉又缺少任务语义与场景上下文:触觉知道“碰到了”,却不知道“正在做哪一步、接下来该往哪里修正”。
动作分块缓解了决策频率问题:一次预测多步动作,降低调用大模型的次数。但动作块也把响应性锁住了——块内动作原本按旧观察生成,新接触到来时若不能改写剩余动作,就会错过修正窗口。实时分块、双向解码、流式扩散等工作在加速或重选动作块,却没有回答一个更细的问题:如何在不重跑视觉的情况下,只修正当前块里尚未执行的那部分。
触觉基础模型与多速率控制提供了另一条线索。T-Rex 让视觉与触觉走不同频率的专家,ViTaR 用残差分支把触觉接到冻结策略上,Reactive Diffusion Policy 用快速潜空间控制器修正慢速扩散策略。T-WLA 与它们的区别在于:视觉分支不仅输出动作,还输出一份历史感知的视觉记忆;这份记忆同时被触觉编辑器复用,成为视觉规划与触觉修正之间的共享接口。
论文的核心问题因此可以写成一句:当视觉很慢、触觉很快时,能否让触觉只负责“在已有计划上做局部残差”,从而既保留任务语义,又获得毫秒级响应?T-WLA 的答案是肯定的,但它对这个答案加了边界条件——基础动作块在两次视觉更新之间必须仍然是一个有用的参考。
预备知识
动作分块。策略一次输出 H 步动作,执行其中若干步后再重新规划。它可以降低大模型调用频率,却会引入“块内动作过期”的问题。
条件流匹配。视觉动作专家与预测头用条件流匹配学习从噪声到动作或未来潜变量的速度场,推理时通过若干步积分生成样本。
FiLM 调制。Feature-wise Linear Modulation 用一组条件向量产生逐通道的缩放 γ 与偏置 β,把一种模态的信息注入另一种模态的特征。T-WLA 用触觉上下文调制动作特征。
多速率控制。视觉分支与触觉分支以不同频率运行:视觉负责语义与长程计划,触觉负责局部接触与短时修正。多速率的难点不在“两个频率”,而在两份表示如何共享而不互相拖慢。
方法详解
3.1 系统总览:一份记忆,两条时间线
设 t 为视觉更新索引,τ 为两次视觉更新之间的触觉更新索引。视觉分支接收当前 RGB 图像 It、任务指令、视场信息与机器人状态,输出历史感知的视觉记忆 MVt,再由动作专家生成 H 步基础动作块:
$$A_{t}^{\mathrm{base}}=f_{\mathrm{act}}\left(M_{\mathrm{V}}^{t}\right)\tag{1}$$
触觉分支接收更高频的压力序列 Tt,τ。在视觉更新之间,MVt 与 Atbase 都被缓存,触觉编辑器只计算一个残差,并把它加到基础动作块上:
$$\widehat{A}_{t,\tau}=A_{t}^{\mathrm{base}}+\Delta A_{t,\tau}\tag{2}$$
这里的 ΔA 不是重新生成一整段动作,而是只在“有效且尚未执行”的动作位置上生效。每个触觉更新都相对于同一份原始基础块计算,而不是在上一次修正结果上继续累加;这样可以避免误差在多次触觉更新中滚雪球。
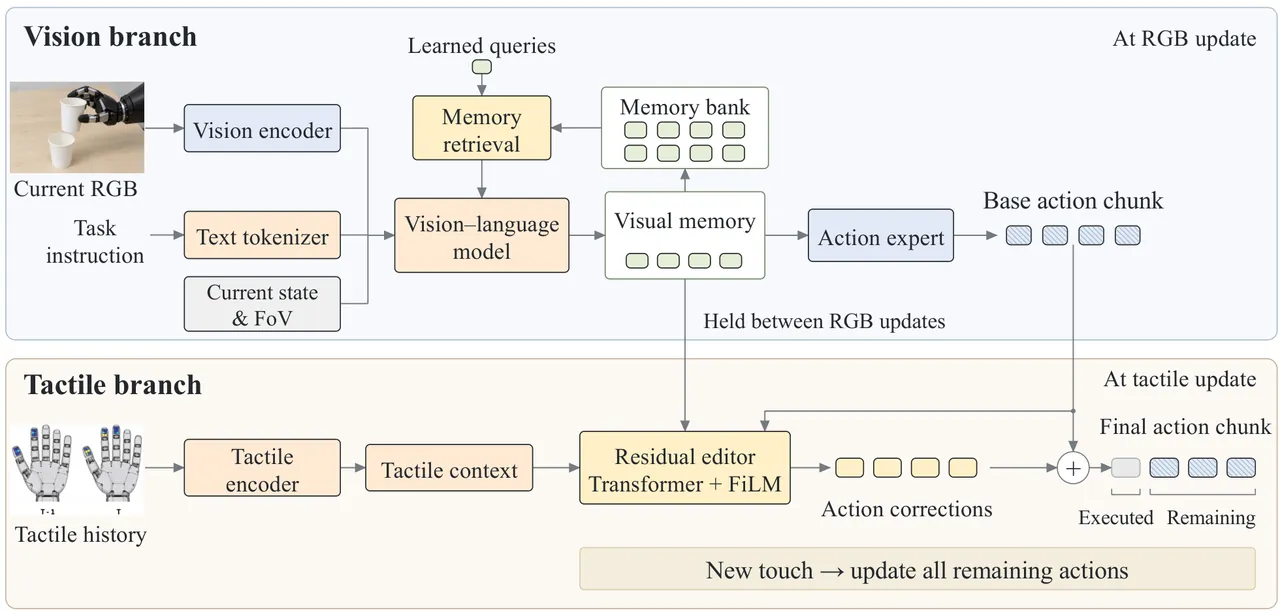
图 1:T-WLA 双速率架构(论文 Fig. 2)。上半区视觉分支在 RGB 更新时生成基础动作块与视觉记忆;下半区触觉分支在触觉更新时复用缓存记忆,只修改剩余动作。
3.2 历史感知的视觉记忆
当前图像可能遮挡过去可见的信息,也可能让“刚刚如何接近物体”变得模糊。T-WLA 不把整段图像序列反复送进视觉主干,而是维护一个紧凑的记忆库。库中保存最近 K 组视觉输出记忆 token,每组有 S 个槽位。视觉更新时,一组可学习的查询 QV 从历史库 BVt−1 中检索输入记忆:
$$M_{\mathrm{V},\mathrm{in}}^{t}=\mathcal{M}_{\mathrm{V}}\left(\mathcal{B}_{\mathrm{V}}^{t-1},Q_{\mathrm{V}}\right)\tag{3}$$
检索到的历史再与当前图像 token Et、指令 token Lℓ、视场 token ct、状态 token St 一起进入视觉主干,得到当前视觉记忆:
$$M_{\mathrm{V}}^{t}=f_{\mathrm{V}}\left(E_{t},L_{\ell},c_{t},S_{t},M_{\mathrm{V},\mathrm{in}}^{t}\right)\tag{4}$$
随后记忆库按时间追加新记忆,只保留最近 K 组。实现上 S=8、d=960、K=8;检索使用两个预归一化交叉注意力块,15 个注意力头、前馈宽度 2560,并用槽位嵌入与年龄嵌入告诉模型“这是第几个记忆槽、是几次视觉更新之前的记忆”。年龄按视觉更新计数,不按触觉事件计数,因此触觉频率再高也不会污染视觉历史的时间尺度。
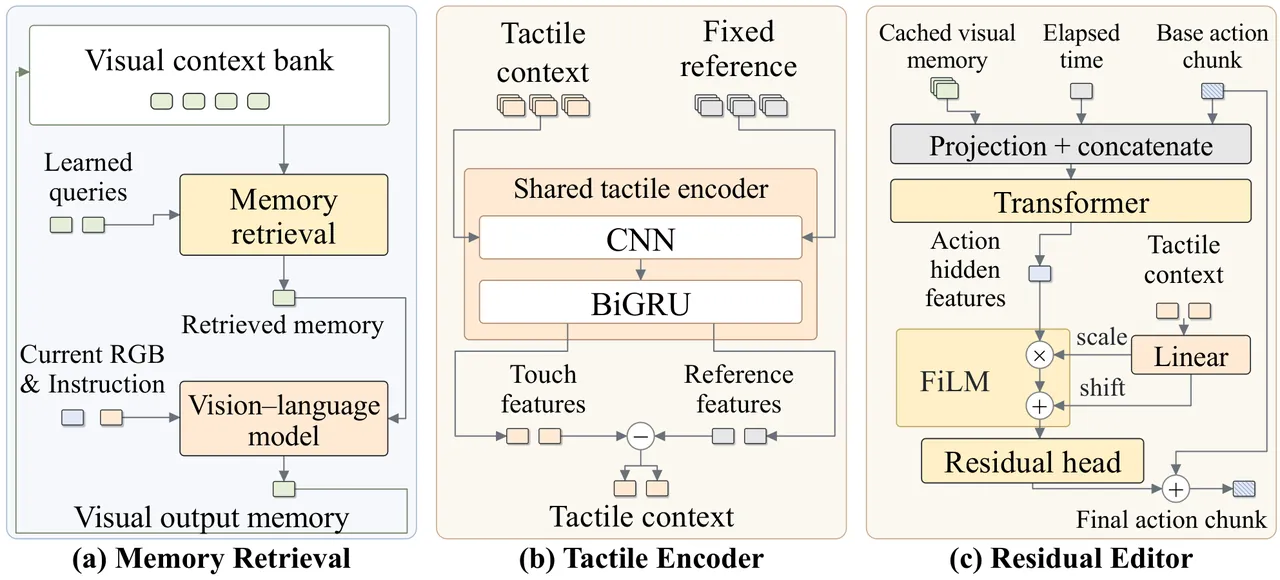
图 2:记忆—编辑器接口(论文 Fig. 3)。(a) 学习查询从视觉上下文库检索历史,再与当前图像和指令融合;(b) 触觉历史与固定参考分别编码后相减;(c) 触觉上下文经 FiLM 调制动作特征,残差头输出修正量。
3.3 触觉上下文:编码“变化”,而不是绝对压力
每只手使用最近 8 帧、每帧 21×21 的压力图。无效时间步补零,左手压力图沿水平方向翻转,使左右手共享同一空间约定。压力与传感器有效性掩码作为两个输入通道,经过三层 5×5 卷积(32 通道、padding=2、ReLU、2×2 最大池化),得到 128 维逐帧特征;再送入双向 GRU(每方向隐藏维 120),把最终前向状态与初始后向状态拼接为 240 维并投影到 64 维,最后做 L2 归一化。
关键设计是参考相减。同一编码器分别编码当前触觉历史 Ht,τr 与固定的手部参考历史 Hrefr,两者相减得到相对触觉上下文:
$$Z_{t,\tau}^{r}=v_{t,\tau}^{r}\left[F_{\mathrm{T}}\left(\mathcal{H}_{t,\tau}^{r}\right)-F_{\mathrm{T}}\left(\mathcal{H}_{\mathrm{ref}}^{r}\right)\right]\tag{5}$$
其中 v 是有效性门,只有编码历史通过校验且最近一帧触觉有效时才为 1,否则整只手输出零。参考不是缓存嵌入,而是每次前向都重新编码的原始压力窗口;这样参考路径也能收到梯度,不会变成一个僵死的常量。相减之后不再归一化,保留触觉变化的幅值信息。
为什么需要时间窗口?单帧压力图只能说明“此刻压到了哪里”,看不出滑动、挤压累积或接触建立的速度。8 帧历史让编码器看到接触的演化,而双向 GRU 只在已观测窗口内运行,不回看未来触觉,保证因果性。
3.4 残差编辑器:用触觉给动作特征做 FiLM
编辑器先把视觉记忆与基础动作 token 投影到 256 维,并加入模态、动作位置与已用时间嵌入。时间输入是 10Δt,单位为秒;这样模型能区分“当前块的第 2 步”和“第 10 步”,知道哪些动作已经执行、哪些还可修改。编辑器是一个两层预归一化 Transformer:8 个注意力头、前馈宽度 1024、GELU、零 dropout,只有动作位置对应的输出 Hact 进入残差读出。
每只手的 64 维触觉上下文经过无偏置线性层,产生 FiLM 的缩放 γ 与偏移 β,对动作特征做逐通道调制;残差头再把它映射回动作空间:
$$U^{r}=W_{\mathrm{out}}^{r}\left[\gamma^{r}\left(Z^{r}\right)\odot H_{\mathrm{act}}+\beta^{r}\left(Z^{r}\right)\right]\tag{6}$$
$$\Delta A_{t,\tau}=\sum_{r\in\{\mathrm{L},\mathrm{R}\}}m_{\mathrm{edit}}^{r}\odot U^{r}\tag{7}$$
其中 meditr 同时交叠三件事:可编辑的动作位置、该手的动作通道、该手是否有效。没有触觉输入的手得到零修正;已经执行的动作不会被改写。输出投影零初始化,因此训练开始时 ΔA=0,模型从“完全相信基础动作块”出发,再逐步学会修正。
这个结构把触觉的作用限制在“局部动作编辑”而不是“重新规划”。视觉记忆提供任务与场景,基础动作块提供正在执行的计划,时间提供剩余动作的位置,触觉只负责回答:在这份计划上,接下来几步应该往哪个方向偏多少。
3.5 因果接触门与动作掩码
论文还给出一个可选的接触过滤版本:只在当前压力历史真的出现接触时启用触觉修正。对每只手 r,取每帧有效传感器点上最大的五个压力值求平均,再看历史中是否有任意一帧超过阈值 η=0.25:
$$c^{r}=\mathbf{1}\left[\max_{j\in\mathcal{J}_{r}}\frac{1}{5}\sum_{u\in\operatorname{Top5}\left(P_{j,r}|_{\mathcal{S}_{r}}\right)}P_{j,r,u}\geq\eta\right]\tag{8}$$
这个门只使用已经观测到的压力,不看未来接触标签。被门控掉的手保留基础动作,但它的动作条目不计入零误差样本,避免“没有接触”被当成“修正正确”。同样,接触门也交叠到动作监督掩码与未来压力掩码上。
3.6 预测监督:未来图像与未来压力只在训练时存在
只有动作监督,模型可能学到“能复现示教动作、但不理解接触后果”的表示。T-WLA 因此加入两个训练期辅助目标:未来图像预测与未来压力预测。未来图像使用冻结图像编码器提供的未来潜变量作为目标;触觉上下文通过一个学习到的适配器,只修改预测路径的视觉记忆条件,不修改控制路径缓存的那份记忆。
未来压力预测则以视觉记忆、触觉上下文与“未来将要编辑的动作窗口”为条件,预测后续压力。这里把动作窗口 detach,防止压力损失反向穿过动作读出;但梯度仍可通过触觉上下文更新共享触觉编码器。压力目标覆盖 441 个传感器点,并按训练集均值与标准差标准化:
$$y_{u}^{r}=\frac{P_{u}^{+,r}-\mu_{u}^{r}}{\max\left(\sigma_{u}^{r},10^{-3}\right)}\tag{9}$$
两个预测头在推理时全部移除,因此不增加部署延迟。它们的作用不是“想象未来再规划”,而是迫使视觉记忆与触觉特征包含与后续交互有关的动力学信息。
3.7 分阶段训练与损失
训练分三步。第一步,用条件流匹配训练视觉动作专家,同时用动作损失与未来图像损失监督视觉分支。第二步,在 EgoTouch 的同步触觉—手部姿态历史上,用对称对比损失预训练触觉编码器;相似度 Sij=αuiTpj,同步对为正样本、批内其它对为负样本。第三步,冻结视觉分支,缓存视觉记忆与基础动作块,训练触觉编码器、残差编辑器、触觉条件适配器与压力预测器。
视觉动作损失采用分组平衡的均方误差:先对每个动作分量组求组内均方误差,再对有有效样本的组等权平均。这样手掌局部关节、腕部平移、腕部旋转不会因为通道数不同而被某一组主导。编辑器损失则对每个样本内每个非空组先求 Smooth L1 平均,再对监督样本等权平均:
$$\mathcal{L}_{\mathrm{edit}}=\frac{1}{|\mathcal{B}_{+}|}\sum_{b\in\mathcal{B}_{+}}\frac{1}{|\mathcal{G}_{b}|}\sum_{g\in\mathcal{G}_{b}}\frac{\sum_{j}\sum_{d\in\mathcal{D}_{g}}m_{b,j,d}^{\mathcal{E}}\rho\left(e_{b,j,d}\right)}{n_{b,g}}\tag{10}$$
其中 e 是修正后动作与示教动作之差,ρ 是 Smooth L1,m 是有效可编辑掩码;没有有效组的样本不计入分母。另加一个残差幅值惩罚,防止编辑器用大幅修正掩盖基础动作块的问题:
$$\widehat{\mathcal{R}}_{\Delta}=\frac{\sum_{b,j,d}m_{b,j,d}^{\mathcal{E}}\left(\Delta A_{b,j,d}\right)^{2}}{\sum_{b,j,d}m_{b,j,d}^{\mathcal{E}}}\tag{11}$$
最终编辑器目标可以概括为“修正动作要准、修正量要小、未来图像与未来压力的表示要有信息”。视觉分支冻结也意味着触觉训练不会破坏视觉先验;代价是两分支不能端到端联合优化,作者把联合微调列为未来扩展。
3.8 动作表示与时间对齐
手部动作块有 H=16 个动作位置,每个位置 192 维;其中 138 维是运动数据,54 维是 padding。每只手 69 维:腕部平移增量 3 维、腕部欧拉旋转增量 3 维、掌部局部关节坐标 63 维。视觉分支 39.7 Hz,触觉编辑器 119.1 Hz;触觉修正的已用时间从当前活动块开始计时,而不是用触觉更新序号推断,从而在不同频率下仍能对齐到正确的动作位置。
未来压力条件使用“接下来 8 个已编辑动作”的窗口。窗口起点为 k0=⌈fcmdΔt⌉,其中 fcmd 是动作命令频率;超出动作块的位置补零并标为无效。这个窗口只服务辅助预测,不改变控制器的动作执行逻辑。
3.9 方法流程总览
flowchart TD
  subgraph VIS["视觉分支 39.7 Hz"]
    RGB["当前 RGB 图像"] --> VE["视觉编码器"]
    LANG["任务指令"] --> TX["文本 tokenizer"]
    STATE["机器人状态与视场"] --> VLM
    VE --> VLM["视觉语言模型"]
    BANK["视觉上下文库 最近 K 组"] --> RET["学习查询检索 8 槽 960 维"]
    RET --> VLM
    VLM --> VM["视觉记忆 M_V"]
    VM --> AE["动作专家 条件流匹配"]
    AE --> BASE["基础动作块 H=16 步"]
    VM --> BANK
  end
  subgraph TAC["触觉分支 119.1 Hz"]
    TOUCH["过去 8 帧 21x21 压力图 左右手"] --> ENC["共享 CNN 加 BiGRU"]
    REF["固定参考压力窗口"] --> ENC
    ENC --> Z["参考相减后的触觉上下文 Z"]
    BASE --> EDIT
    VM --> EDIT["残差编辑器 Transformer 加 FiLM"]
    Z --> EDIT
    TIME["已用时间与动作位置"] --> EDIT
    EDIT --> DA["动作残差 仅未执行位置"]
    DA --> FINAL["修正后的剩余动作块"]
    BASE --> FINAL
  end
  VIS -. "训练期未来图像预测" .-> AUX["辅助预测头 推理时移除"]
  TAC -. "训练期未来压力预测" .-> AUX
图 3:T-WLA 方法流程。视觉分支生成并可复用历史视觉记忆与基础动作块;触觉分支在两次视觉更新之间,以触觉上下文、缓存记忆、基础动作块与已用时间为条件,只修正未执行动作。
实验结果
4.1 触觉条件下的手部动作预测
论文先在 EgoTouch 与 Tachin 上评估“给定视觉与触觉,预测 100 ms 后的手部动作”。EgoTouch 按其五个原生环境分别报告,再做宏平均;Tachin 使用完整留出测试集。所有方法使用同一预测时域与同一触觉编码器/预测头预算,T-Rex 与 T-WLA 保留各自的多速率接口。
T-WLA 在三个指标、所有 EgoTouch 环境与 Tachin 上都取得最低误差。最明显的优势在手指关节:腕部相对 MPJPE 相对各自最强基线降低约 30.0%(EgoTouch)与 27.0%(Tachin)。腕部平移与旋转也有改善,但幅度更小——这符合方法定位:触觉编辑器主要修正手指与接触细节,而不是替代视觉预测整只手的全局轨迹。
| 方法 | EgoTouch 平移 (cm) | EgoTouch 旋转 (°) | EgoTouch 手指 MPJPE (cm) | Tachin 平移 (cm) | Tachin 旋转 (°) | Tachin 手指 MPJPE (cm) | 触觉频率 (Hz) |
|---|---|---|---|---|---|---|---|
| VITRA + 触觉 | 4.08 | 6.27 | 0.50 | 1.48 | 4.55 | 0.63 | 58.2 |
| SmolVLA + 触觉 | 4.10 | 6.28 | 0.50 | 1.50 | 4.20 | 1.28 | 69.0 |
| MemoryVLA + 触觉 | 4.18 | 6.34 | 1.34 | 1.55 | 4.39 | 1.87 | 15.0 |
| T-Rex | 4.16 | 6.29 | 1.14 | 1.54 | 4.25 | 1.08 | 17.16 |
| T-WLA | 3.96 | 6.10 | 0.35 | 1.39 | 4.17 | 0.46 | 119.1 |
表 1:触觉条件下的未来手部动作预测(论文 Table 1)。EgoTouch 为五环境宏平均,Tachin 为完整留出测试集;误差越低越好。
值得注意的是,T-WLA 不是靠降低触觉更新率换取精度:它的有效触觉修正率是 119.1 Hz,而最快的报告基线只有 69.0 Hz。也就是说,它在更高频修正的同时误差更低,说明轻量残差路径的“计算预算—精度”关系确实比重新跑大模型更划算。
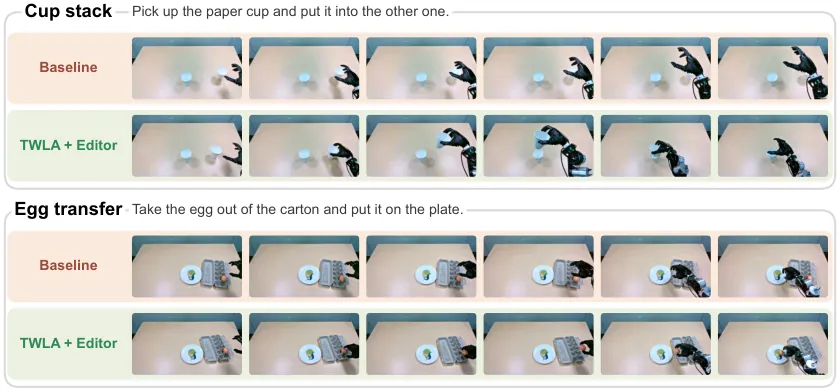
图 4:杯叠放与鸡蛋转移的代表性真机轨迹(论文 Fig. 5)。每列展示起始、接触与目标阶段;上排为 T-WLA 成功,下排为基线失败。
4.2 真机接触密集操作
真机平台是双臂 Linker A7black,每侧 7 自由度机械臂加 Linker Hand L6 灵巧手,指尖带触觉传感;工作区上方用 Intel RealSense D435i 提供第一视角。示教由操作者佩戴 Wuji 数据手套采集手指关节,腕部由 HTC VIVE Tracker 3.0 跟踪,两个 SteamVR 基站定位,不需要 VR 头显。每个任务只采 30 条遥操作示教。
四个任务分别是:鸡蛋转移(蛋壳与托盘之间的微小滑动很难从图像看出)、单张纸拾取(夹得太松会滑、太紧会皱)、纸杯套叠(既要抓稳又不能捏扁,还要对齐)、纸袋拖拽(袋内负载变化会改变指尖受力)。这些任务共同测试:触觉能否在视觉已经给出的动作上,补足“抓握是否稳、是否该收力、是否该继续推进”的信息。
| 控制器 | 鸡蛋转移 | 单张纸拾取 | 纸杯套叠 | 纸袋拖拽 | 平均 |
|---|---|---|---|---|---|
| SmolVLA | 0 | 28 | 0 | 39 | 16.75 |
| SmolVLA + 触觉 | 0 | 30 | 1 | 37 | 17.00 |
| T-Rex | 4 | 3 | 22 | 63 | 23.00 |
| T-WLA 无触觉 | 18 | 72 | 17 | 82 | 47.25 |
| T-WLA | 21 | 78 | 17 | 84 | 50.00 |
表 2:四项真机接触操作的成功率(%,论文 Table 2),每个任务 30 条示教;平均为四项等权。
几个数字值得拆开看。第一,T-WLA 的视觉分支单独使用(无触觉)已经达到 47.25%,明显高于 SmolVLA 的 16.75%,说明历史视觉记忆与动作专家本身就是强基线;触觉带来的 2.75 个百分点是“在强视觉基线上的增量”,不是把弱策略硬拉起来。第二,触觉增益在单张纸拾取最大(72→78),符合薄纸对夹持力非常敏感的先验。第三,纸杯套叠停在 17%,说明抓握稳只是任务的一部分,对齐与放置失败无法靠指尖触觉解决——这也是论文没有回避的失败模式。第四,VITRA 与 MemoryVLA 在同样 30 条示教下没有成功 trial,说明“会预测手部姿态”不等于“会闭环操作”。
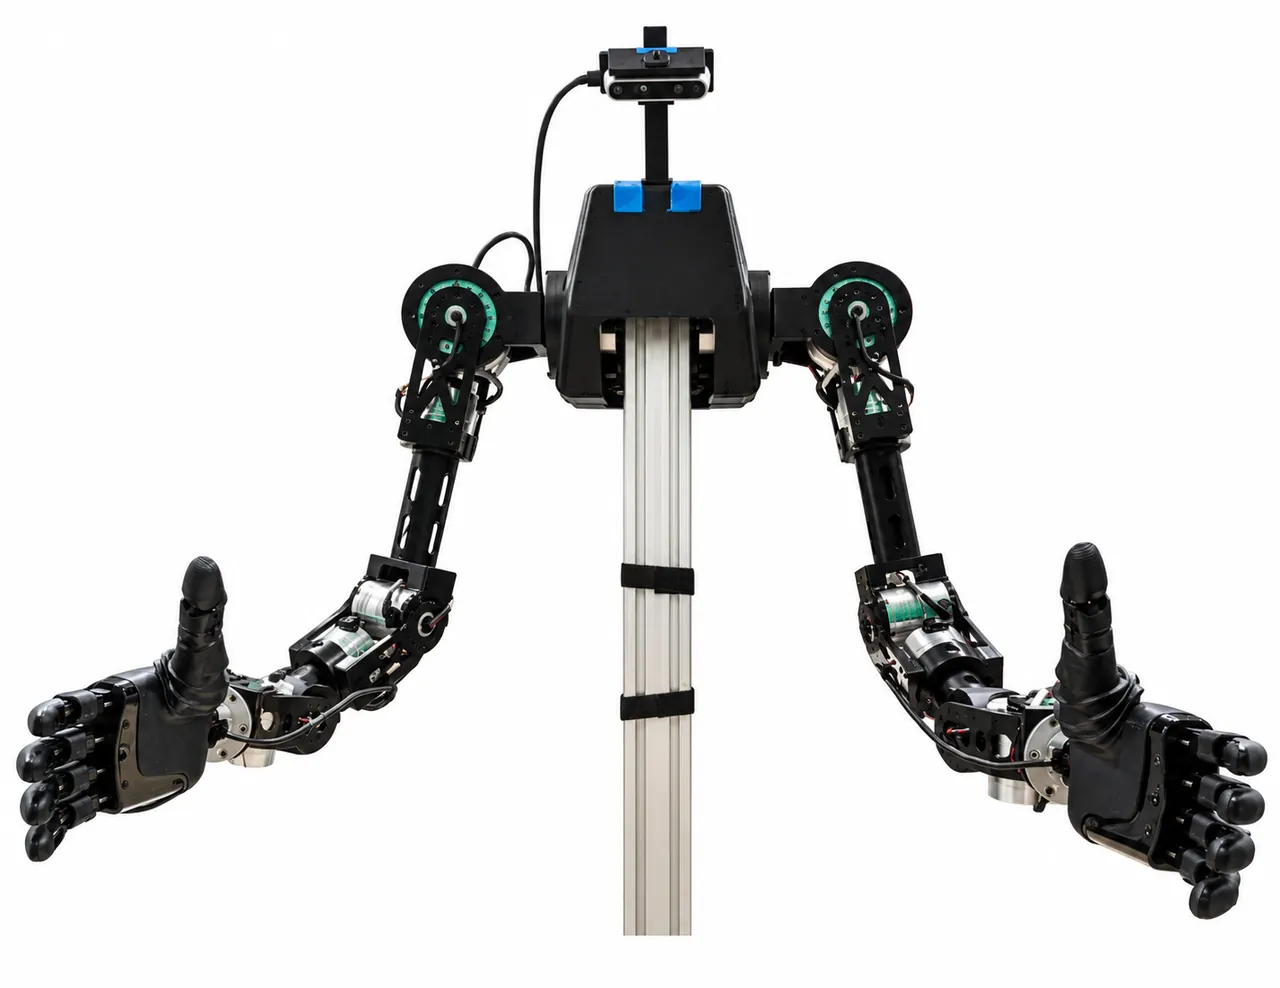
图 5:真机平台(论文 Fig. 6a)。双臂 Linker A7black 与 Linker Hand L6,上方装有 RealSense D435i 第一视角相机。
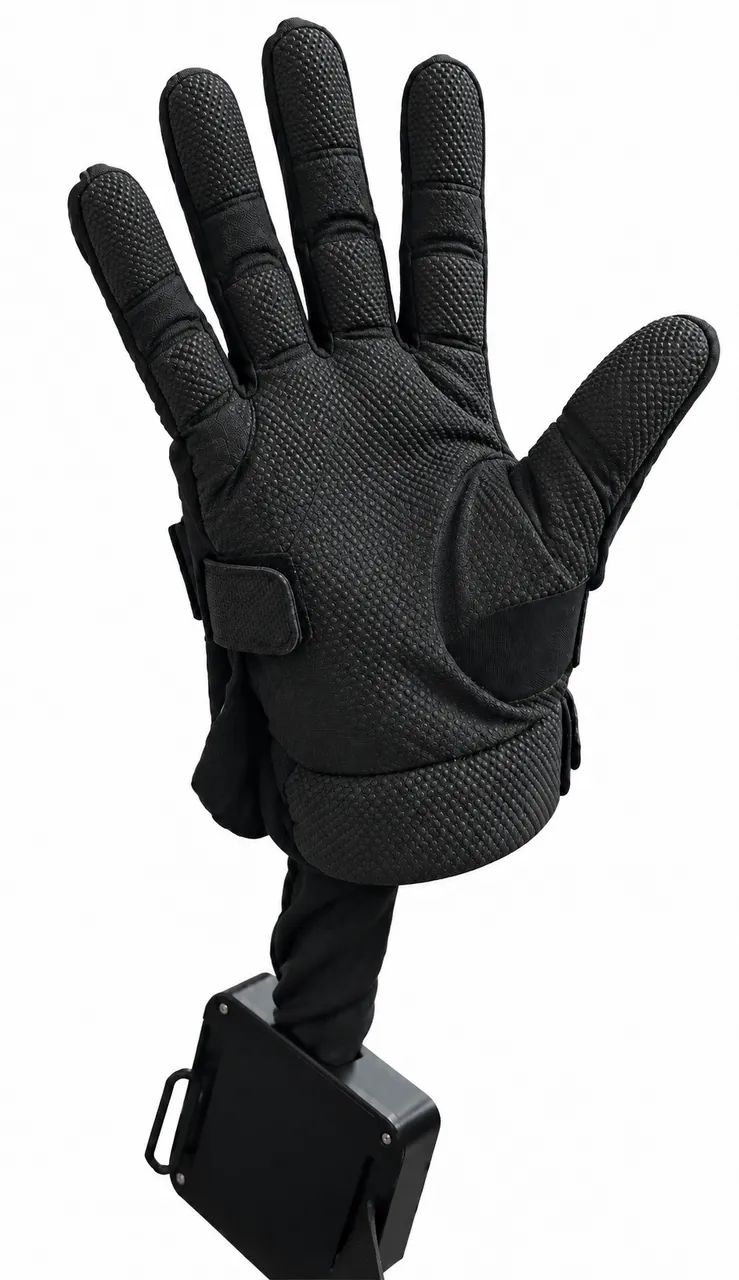
图 6:示教用 Wuji 数据手套(论文 Fig. 6b),负责捕捉手指关节;腕部位姿由 VIVE Tracker 记录。
4.3 消融:触觉、记忆与预测监督各自贡献多少
消融在匹配预算下逐项拆解。去掉触觉输入,手指关节误差上升 22.9%(EgoTouch)与 8.7%(Tachin),是所有消融里最大的一项;去掉循环记忆,则更影响腕部预测,Tachin 平移与旋转误差分别上升 21.6% 与 9.4%;把记忆从 K=8 缩短到 K=4,六项指标平均变差 2.3%;去掉未来图像与未来压力两个世界预测目标,平均变差 1.0%。
| 变体 | EgoTouch 平移 | EgoTouch 旋转 | EgoTouch 关节 | Tachin 平移 | Tachin 旋转 | Tachin 关节 |
|---|---|---|---|---|---|---|
| 无触觉输入 | 4.010 | 6.200 | 0.430 | 1.450 | 4.400 | 0.500 |
| 无循环记忆 | 4.070 | 6.280 | 0.370 | 1.690 | 4.560 | 0.490 |
| 短记忆 K=4 | 3.980 | 6.150 | 0.360 | 1.480 | 4.310 | 0.460 |
| 无世界预测(触觉+视觉) | 3.963 | 6.113 | 0.353 | 1.413 | 4.283 | 0.463 |
| 无世界预测(仅触觉) | 3.962 | 6.112 | 0.352 | 1.412 | 4.263 | 0.462 |
| T-WLA | 3.960 | 6.100 | 0.350 | 1.390 | 4.170 | 0.460 |
表 3:触觉、记忆与预测监督消融(论文 Table 3)。每个指标越低越好。
一个细节很能说明问题:去掉循环记忆后,EgoTouch 的手指误差反而从 0.350 升到 0.370、Tachin 从 0.460 升到 0.490,幅度不如“无触觉”大;但腕部特别是 Tachin 平移从 1.39 暴增到 1.69。这说明记忆对“整只手在空间中的连续性”更重要,触觉对“手指局部接触”更重要,两者不是同一个能力的重复。
4.4 没有触觉时,视觉分支仍然能打
论文额外做了纯视觉实验:训练与评估都去掉触觉,只保留 RGB、指令、姿态历史、循环记忆与视觉动作专家。T-WLA 在 GigaHands 五个活动族平均取得 0.65 cm 平移、3.64° 旋转、0.43 cm 关节误差;相对 SmolVLA 分别降低 25.3%、15.9%、54.7%。在 OakInk2 上为 0.44 cm、1.38°、0.37 cm;在 TACO 上旋转与关节误差最低,平移 0.75 cm 略高于 SmolVLA 的 0.72 cm,但仍比 VITRA 低 22.7%。
这个结果很重要:它说明 T-WLA 不是“把视觉做差、再靠触觉补回来”的系统。视觉记忆与预测监督本身就提供了强动作先验;触觉是在这个先验之上做局部修正。也因此,真机无触觉版本仍能达到 47.25%,而不是退化成只能等待触觉的控制器。
4.5 关键数字汇总
| 项目 | 数值 |
|---|---|
| 视觉 / 触觉更新率 | 39.7 Hz / 119.1 Hz |
| 动作块长度 | H=16;每位置 192 维,其中 138 维运动、54 维 padding |
| 视觉记忆 | S=8 槽,d=960,K=8 组历史;检索 15 头、前馈 2560 |
| 触觉编码 | 每手 8 帧 21×21;3 层 CNN 32 通道;BiGRU 120×2;输出 64 维 |
| 残差编辑器 | 256 维、8 头、前馈 1024、FiLM;输出零初始化 |
| 真机示教 / 任务 | 每任务 30 条,共 4 任务 |
| 真机平均成功率 | 50.0%(无触觉 47.25%;SmolVLA 16.75%) |
| 手部预测提升 | 手指 MPJPE 降低 30.0%(EgoTouch)/ 27.0%(Tachin) |
局限性
论文明确提到的边界:方法假设“两次视觉更新之间的基础动作块仍然是有用参考”。如果视觉规划一开始就把手引向错误位置,触觉编辑器只能在错误计划上做局部修补;论文观察到 SmolVLA 的失败往往是手在远离目标处闭合,根本没有建立可修正的接触。另一条边界是触觉只解决抓握相关失败:纸杯套叠仍停在 17%,说明对齐、插入、放置等非抓握阶段不会被指尖压力自动修好。
我们的判断:其一,50.0% 的平均成功率虽然比 17.0% 大幅提升,但绝对值仍不足以支撑“通用灵巧操作已解决”的结论;四项任务、每项 30 条示教、单一双臂平台,样本规模有限。其二,触觉硬件是 Linker Hand L6 的指尖阵列,方法依赖压力图的空间布局与 441 个压力点;换传感器、换手型或触觉缺失时,参考相减与接触门是否需要重新标定,论文没有给出跨传感器实验。其三,视觉分支与触觉分支分阶段训练、视觉冻结,虽然稳定,但可能错过联合优化能带来的收益;作者也只把联合微调写成“proposed extension”。其四,论文声称代码可用,但项目页目前没有代码入口,复现门槛仍高。
总结与展望
T-WLA 的贡献不是“再加一个触觉分支”,而是把视觉记忆变成两种时间尺度的共享接口:慢速视觉用它生成基础动作,快速触觉用它做残差修正。基础动作块提供任务语义与长程计划,触觉上下文提供接触变化,FiLM 与残差头把两者接到一起;未来图像与未来压力只在训练时监督表示,推理时完全移除。实验上,手指关节预测的 30% 改善与真机 50.0% 的平均成功率说明这条“共享记忆 + 异步残差”的路线确实有效。
下一步最值得看的是三件事:第一,把视觉与触觉从分阶段训练推进到联合微调,让触觉修正的梯度也能改视觉记忆;第二,把方法扩展到更多传感器与更多手型,验证参考相减与接触门是否仍然成立;第三,解决“基础计划错误”与“非抓握阶段失败”这两类触觉无法单独修复的问题,可能需要让触觉不仅修正动作,还能触发重新规划或切换技能。
金句
“视觉提供任务与场景,触觉提供接触的即时变化;真正缺的不是另一种模态,而是让两者共享同一份记忆的接口。”
“触觉编辑器不是重新生成计划,而是在基础动作块上,只改写尚未执行的那一部分。”
“当基础动作把手带到错误的位置时,再快的触觉也只能在错误的计划上做局部修补。”