PAPER DEEP DIVE
时序视触觉学习:抬起前预判灵巧抓取稳定性
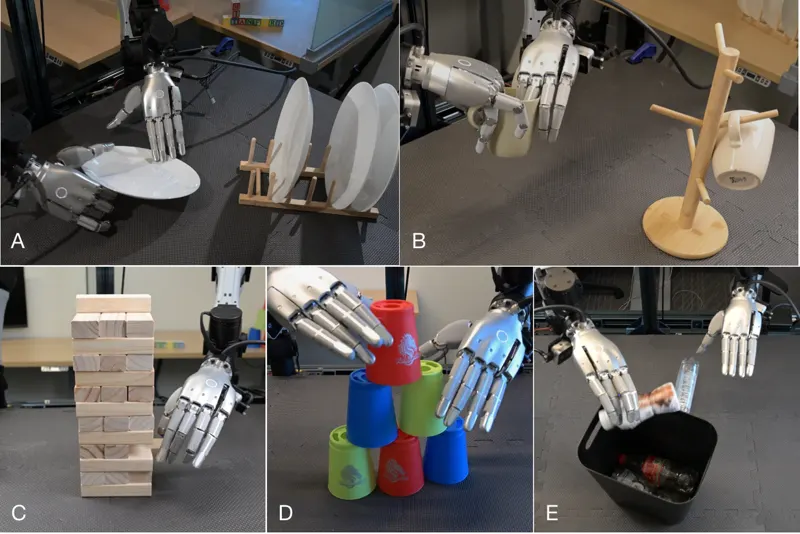
机器人抓取研究大多用视觉选位姿、配平行夹爪,而人是靠指尖触觉几乎不失手。TU Dresden LASR Lab 把问题改成「抬起之前这只多指手抓稳了没」:7 自由度 xArm7 + 16 自由度 Tilburg Hand,四指尖各嵌一颗 Digit 360,用 200 个物体(刚性 105、可形变 95)自动采集 10000 次抓取,全程录外部 RGB-D、本体感知与四路触觉(相机/音频/IMU/气压),SAM 3 检测抬起后物体高度自动打标(与人工核验一致率 92.34%)。模型是以抓取起始为锚点的 3 秒观测窗:16 帧 RGB 与触觉图像走 VideoMAEv2-Base,本体感知 100 步、音频等 224 步走 Transformer,四指触觉先跨模态融合再跨时间跨手指分解注意力,最后注意力融合输出稳定概率。5 折物体不相交验证下视觉+本体+触觉 83.55%,去掉触觉掉到 79.56%;触觉分辨率 1x1→112x112 准确率 79.40%→83.55%;把触觉冻结成最后一帧掉 2.07 个百分点。真机上把它当在线门控(阈值 0.95,最多重抓 5 次),20 个训练集外物体上执行抬起的成功率 82.0%,比无触觉门控高 10.5 个百分点。约 1.2TB 数据集已在 OPARA 公开。
论文元信息
标题:Temporal Visuo-Tactile Learning for Dexterous Grasp Stability(时序视触觉学习用于灵巧抓取稳定性)
作者:Ken Nakahara、Aleksei Buvailik、Prokhor Kotov、Roberto Calandra(德国德累斯顿工业大学 LASR Lab)
链接:arXiv:2610.10283(2026-10-07 提交)· 项目页 lasr-lab.github.io/dexterous-grasp-stability · 数据托管于 OPARA(约 1.2 TB)
代码状态:已发布。仓库 lasr-lab/dexterous-grasp-stability(MIT 许可,数据为 CC BY-NC-ND 4.0),含 HDF5 试验浏览器 data_viewer.py 与多模态重采样器 resample.py;模型训练代码未包含在内。
一句话总结
用四颗 Digit 360 指尖传感器和一万次真实多指抓取,这篇论文给出了一个可复核的答案:在抬起之前判断"抓稳了没有",信息主要在高分辨率、随时间变化的触觉里;把这个判断做成在线门控后,真机执行抬起的成功率比无触觉门控高 10.5 个百分点。
研究背景与动机
多指手的稳定抓取不是一个"从图像里选一个抓取位姿"的问题。稳定性取决于接触如何形成、接触力如何在手指闭合的过程中演化、载荷如何在多个指尖之间分配、以及手开始抬起的那一刻接触是否还撑得住。这些量几乎全部发生在指尖与物体之间几平方厘米的界面里,外部相机看到的是手背和外壳,而不是接触本身。人类操作物体的方式恰好相反:Johansson 与 Flanagan 的经典工作表明,人在抓取与操作中高度依赖指尖触觉信号,日常抓取的成功率接近完美。
机器人抓取的主流文献走的却是另一条路:从视觉观测中估计抓取位姿,执行机构大多是两指平行夹爪。这条路线在箱式拣选等场景已经足够好用,但它把"抓稳"这件事外包给了夹爪的几何自锁与力控闭环,回避了"在抬起之前预测结果"这个问题。当执行机构换成多指灵巧手,接触配置变得多样、包络抓取成为常态,视觉选位姿的裕度就迅速消失了。
视触觉学习这条线索其实早就存在。Calandra 等人在 2017 年的"The Feeling of Success"中首次用端到端模型证明触觉有助于预测抓取结果,2018 年的后续工作进一步把预测器用于 model-guided regrasp。但这些工作建立在平行夹爪与早期 GelSight/DIGIT 传感器上,回答不了多指手的问题:哪些感知模态对稳定性预测信息量最大?触觉的空间细节与时间动态各自贡献多少?这些信号应当如何建模?
硬件条件在近两年发生了变化。Digit 360 把一颗鱼眼内窥镜相机、麦克风、气压计与 IMU 装进一个半球形指尖,单指即可输出高分辨率触觉图像与多路动态信号;Sparsh-X 一类工作用约百万次接触交互预训练了跨模态触觉表征。传感器足够丰富、数据足够便宜之后,"系统性回答"才第一次成为可能。本文正是把这个机会用满:它不提出一个新的花哨架构,而是用一万次抓取把"感知什么、保留多少空间与时间细节、怎么融合"这三个工程问题逐一量化。
因此本文的贡献是三条:其一,采集并公开一个一万次多指抓取、200 个物体的多模态数据集,全程同步记录外部 RGB-D、本体感知与四路指尖触觉;其二,在物体不相交的交叉验证下系统比较模态组合与静态/时序编码器,并用受控输入消融分离触觉空间分辨率与时间动态的作用;其三,把学到的预测器部署为真机上的在线"抬起或重抓"门控,在训练集外物体上取得比无触觉门控更高的执行抬起成功率。
预备知识
视觉型触觉传感器。这类传感器把一块弹性接触面的形变转成图像:GelSight 用光度立体恢复接触几何,TacTip 用仿生软体光学指尖,DIGIT 把成本与体积压到可以装进手指。Digit 360 是这一谱系的最新一代,半球形接触面配内部鱼眼相机,另加音频、气压与惯性测量,因此"触觉"在这里不是一个标量,而是一组异构时间序列。
抓取稳定性预测。任务定义为:给定抬起之前的观测,预测抬起之后物体能否被保持而不掉落。解析的抓取质量度量(force closure、grasp quality)需要已知接触几何与摩擦模型,在真实硬件上很难可靠获得;手调阈值的触觉控制器又难以覆盖多样物体。端到端学习把这个问题变成二分类,把"接触力学"交给数据去隐式表达。
时序多模态编码的工具箱。视频预训练模型(VideoMAEv2)为短clip提供强先验;factorized attention 把"时间"与"手指"两个维度拆开做注意力,避免联合注意力的二次开销;modality mask 让网络在某一传感器流缺失时仍能前向。这三件工具构成了本文网络的骨架。
方法详解
任务形式化。给定抬起前抓取阶段的一个观测窗 $\mathbf{s}_{t:t+T}$,学习一个函数预测抓取成功概率
$$f_{\theta}(\mathbf{s}_{t:t+T}) = p(o=1 \mid \mathbf{s}_{t:t+T}) \in [0,1]$$
其中标签 $o=1$ 表示物体被成功抬起并保持不掉落。网络在一万次抓取试验上以二元交叉熵为损失训练:
$$\mathcal{L}(\theta) = -\frac{1}{N}\sum_{i=1}^{N}\left[\, o_i \log f_{\theta}(\mathbf{s}_i) + (1-o_i)\log\left(1-f_{\theta}(\mathbf{s}_i)\right) \right]$$
这个形式化里最关键的限制是时间方向:输入只允许来自抬起之前的窗口。这不是建模偏好,而是部署约束——门控必须在抬起动作发生之前给出判断,否则"重抓"就失去了意义。
观测窗与输入表示。窗口以抓取起始(grasp initiation)为锚点、长 3 秒、止于抬起开始之前。外部 RGB 与四路触觉相机各取 16 帧 clip,统一缩放到 $256\times 256$ 再裁剪到 $224\times 224$,同一 clip 内各帧使用相同裁剪坐标;训练时每个样本同时给一个中心裁剪与一个随机裁剪,等价于每轮把样本数翻倍,评估只用中心裁剪。本体感知表示为 100 步序列,每步含 16 个手关节角与 6 维末端位姿;每个指尖的音频、IMU、气压分别表示为 224 步序列:音频是 256-bin 的对数幅度谱,IMU 是三轴加速度,气压是标量读数。图像支路用预训练 VideoMAEv2-Base 加时序 Transformer,触觉图像编码器在四指之间共享权重;其余序列支路各用一个 Transformer 序列编码器。
指内跨模态融合。触觉支路内部,相机、音频、IMU、气压四路编码特征先重采样到共同时间网格,再在每个时间步由一个 modality-fusion Transformer 合并,权重跨手指共享。由于真实硬件上某一传感器流可能整段缺失,融合与后续聚合都带 modality mask:缺失的流以掩码标记,网络学会不依赖它。仓库 resample.py 中 _fill_finger_touch 的掩码约定是"该模态缺失处为 1.0",全 1 的一行意味着这个指尖没有贡献任何触觉信息。
跨时间与跨手指的分解注意力。四指的时序 token 随后进入权重共享的 factorized Transformer 块:先沿时间做注意力、再沿手指做注意力,而不是在"时间×手指"的联合序列上做全注意力。其后接一个轻量的指特异性残差适配器,用来吸收每根手指的系统性偏差(装配差异、凝胶老化、标定偏移),再沿时间池化,得到每根指尖一个 token。这一步的设计意图很明确:跨手指的共性用共享权重学,手指个性用残差小修,避免为四指各训一套参数。
跨模态注意力融合与预测头。RGB token、本体感知 token、四个指尖 token,与 16 个可学习 fusion token 一起拼进一个 512 维共享空间,由 3 层、8 头注意力的 Transformer 联合处理;可学习 token 的作用是给跨模态证据提供"便签纸",让视觉看到的物体姿态与触觉看到的接触形变能在同一组向量里互相引用。更新后的支路 token 经 mask-aware pooling 聚合,送入两层 MLP 预测头(512 维隐层、LayerNorm、GELU、dropout 0.2),最后经 sigmoid 输出成功概率。
在线门控:抬起或重抓。部署时机器人先到达物体附近、闭手到一个采样抓取配置;预测器评估以抓取起始为锚点的 3 秒窗;只有当预测概率超过预定阈值才抬起,否则松手、对末端施加一个小位移、再采样一次抓取。真机实验中阈值固定为 0.95(测试前经验设定),每个 episode 允许一次初始抓取加最多五次重抓,六次拒绝触发 no-lift reset:机器人回原点并恢复物体初始姿态。门控因此不是控制器,而是一个"试错预算分配器"——它决定哪些抓取值得消耗一次抬起。
数据与标签:把标注变成物理测量。每次试验开始时物体被随机放在 $200\,\mathrm{mm}\times 400\,\mathrm{mm}$ 桌面工作区内(臂基坐标系下 $x\in[650,850]\,\mathrm{mm}$、$y\in[-200,200]\,\mathrm{mm}$)。系统用 SAM 3 以文本提示在外部 RGB 中分割物体,用掩码质心、深度图与标定外参估计物体在臂基坐标系下的中心;末端目标(定义在中指根部)叠加平移扰动(默认 $x,y\in[-50,50]\,\mathrm{mm}$、$z\in[-25,25]\,\mathrm{mm}$,按物体尺寸与数据集平衡调整)与偏航采样($[-20^{\circ},20^{\circ}]$);16 个手关节目标在标定范围内独立均匀采样(多数关节 15–20°,食/中/无名指 MCP 关节 45°);闭手由 50 个位置控制路点线性插值、名义 50 Hz 下发。闭手与观测窗结束后直接抬升 100 mm;若物体被抬起并保持 3 秒不掉落则记 $o=1$。标签自动化的判据是抬升前后物体高度差:
$$o = 1 \iff h_{\text{post}} - h_{\text{pre}} \geq 50\,\mathrm{mm}$$
高度由 SAM 3 掩码、深度与外参估计;当抬升后 SAM 3 检测失败(例如被手遮挡)时,回落到一个基于指尖位移的 logistic 模型,位移由命令与观测的 16 自由度手配置之差推断。自动标签与人工核验标签在全部一万次试验上一致率为 92.34%(9234/10000),混淆矩阵为:自动判稳且人工判稳 4361、自动判稳而人工判否 415、自动判否而人工判稳 351、双否 4873。数据集接近平衡:47.1% 稳定、52.9% 不稳定。
方法流程图(基于本文真实架构绘制):
flowchart LR
  subgraph WIN["3s pre-lift window (anchored at grasp initiation)"]
    RGB["external RGB 16 frames"]
    PRO["proprio 100 steps
16 joint angles + 6D EE pose"]
    TC["tactile camera 16 frames x4"]
    AU["audio 224 steps x4
256-bin log spectra"]
    IM["IMU 3-axis acc x4"]
    PR["pressure scalar x4"]
  end
  RGB --> VE["VideoMAEv2-Base + temporal Transformer"]
  PRO --> PT["Transformer sequence encoder"]
  TC --> TE["VideoMAEv2-Base + temporal Transformer
weights shared across fingers"]
  AU --> AT["Transformer"]
  IM --> IT["Transformer"]
  PR --> RT["Transformer"]
  TE --> IF["intra-finger modality-fusion Transformer
common temporal grid + modality mask"]
  AT --> IF
  IT --> IF
  RT --> IF
  IF --> FA["factorized attention over time and fingers
+ finger-specific residual adapters"]
  FA --> POOL["pool over time -> one token per fingertip"]
  VE --> FUS["attention fusion: 6 sensing tokens + 16 learnable tokens
3 layers x 8 heads, dim 512"]
  PT --> FUS
  POOL --> FUS
  FUS --> MP["mask-aware pooling"]
  MP --> HEAD["2-layer MLP head + sigmoid"]
  HEAD --> GATE{"p >= 0.95 ?"}
  GATE -->|yes| LIFT["lift 100 mm"]
  GATE -->|no| REGRASP["release, small EE offset,
resample grasp (max 5 regrasps)"]
这张图与论文 Fig. 3 一一对应:四条感知支路在指内先合、在指间再合、最后与视觉和本体感知在全局注意力里合;门控阈值 0.95 与最多五次重抓来自 Sec. VI-B 的部署协议。
实验结果
协议。离线评估用 5 折物体不相交交叉验证:每一折留出若干物体的全部试验,衡量的是对未见物体实例的泛化。所有模型训练 100 个 epoch,AdamW,batch size 4,初始学习率 $10^{-6}$,weight decay $10^{-4}$,余弦调度加 0.03 warmup 比例;准确率取末轮 checkpoint、以 0.5 为阈值,报五折均值与标准差。每个输入消融都从头训练一个独立模型。
模态:触觉是主要增量,触觉相机是触觉里的主要增量。VideoMAEv2 骨干下的模态消融中,touch-only、vision–touch、vision–proprioception–touch 的均值准确率分别为 82.64%、83.52%、83.55%;从 vision–proprioception–touch 中去掉触觉,准确率掉 3.99 个百分点到 79.56%。vision–proprioception–touch 相对 touch-only 的优势只有 0.91 个百分点(五折配对 t 检验 $p=0.035$),而它与 vision–touch 几乎持平,说明本体感知在已有视觉时贡献有限。把触觉支路收窄到只用触觉相机得 83.41%,与全模态触觉的 83.55% 相差无几;单独用音频、IMU 或气压只有 79.60–79.94%,与无触觉基线(79.56%)同档。
| 触觉支路输入(视觉+本体保留) | 准确率 [%] |
|---|---|
| 全部 Digit 360 模态 | 83.55 ± 1.58 |
| 仅触觉相机 | 83.41 ± 1.30 |
| 仅音频 | 79.60 ± 1.46 |
| 仅 IMU | 79.94 ± 1.50 |
| 仅气压 | 79.93 ± 1.10 |
| 无触觉(vision + proprio) | 79.56 ± 1.60 |
骨干:时序建模的价值大于预训练来源。三种编码设计的对比中,只编码最后一帧的静态 ResNet-50+MLPs 基线得 79.79%,说明抬起前的最终状态本身已有信息;ResNet-Transformer 升到 81.42%;VideoMAEv2 基模型到 83.55%。把触觉 RGB 换成与 clip 首帧的绝对差(背景减除)得 82.58%,略低于原始帧的 83.55%——这与 VideoMAEv2 在大规模 RGB 视频上的预训练分布一致:原始帧保留了颜色、光照与凝胶外观的稳定线索。把四指表征在跨模态融合之前先池化成单个 touch token(local fusion)得 83.24%,与 global fusion 的 83.55% 只差 0.31 个百分点,说明跨手指上下文大部分已被前面的 factorized 注意力编码。
| 编码设计(vision+proprio+touch) | 输入窗口 | 准确率 [%] |
|---|---|---|
| 静态 ResNet-50 + MLPs | 仅最后一帧 | 79.79 |
| ResNet-50 + 时序 Transformer | 3 s 窗口 | 81.42 |
| VideoMAEv2-Base + 时序 Transformer | 3 s 窗口 | 83.55 ± 1.58 |
| 同上,触觉帧做背景减除 | 3 s 窗口 | 82.58 ± 1.94 |
| 同上,四指先池化为单 token | 3 s 窗口 | 83.24 ± 1.61 |
空间分辨率与时间动态:两个受控消融给出因果式证据。骨干对比同时改变了架构、容量与预训练,因此论文用输入扰动单独分离时间信息、用面积下采样单独分离空间信息。空间侧:把触觉帧面积下采样到 $1\times1$(只保留每帧 RGB 均值)得 79.40%,与无触觉基线 79.56% 无异;准确率随分辨率陡升到 $28\times28$ 的 82.51%,之后变缓,在 $112\times112$ 与 $224\times224$ 都到 83.55%——空间接触模式有价值,但收益在高分辨率端递减。时间侧:把某一路的最后一帧在窗内重复(保留末态、抹掉窗内变化),vision-only 与 touch-only 都下降,proprioception-only 几乎不变;在 vision–proprioception–touch 模型中,重复触觉掉 2.07 个百分点,再重复视觉或本体还会进一步下降;对外部 RGB 与四路触觉相机施加同一个随机置换(保留全部帧与流间对齐、打乱时间顺序)掉 1.62 个百分点。结论是:起作用的不只是"接触长什么样",还有"接触如何变化"。
| 触觉帧空间分辨率 | 1×1 | 28×28 | 112×112 | 224×224 |
|---|---|---|---|---|
| 均值准确率 [%] | 79.40 | 82.51 | 83.55 | 83.55 |
手指:拇指的对置接触是视觉补不回来的信息。把指特异性输入(关节角,启用触觉时含对应 Digit 360 流)限制到手指子集后,proprioception-only 跨子集的准确率跨度达 11.84 个百分点,加上视觉后只剩 0.59,vision–proprioception–touch 则为 3.82——外部视觉几乎能补回被砍掉的关节状态,却补不回被砍掉的指尖接触。相对同子集的 vision–proprioception,触觉在拇指上带来 +3.06 个百分点、中指 +1.35、食指 +0.14;全指配置最高(83.55%),拇–中子集紧随其后(83.41%)。描述性分析给出同一幅图景:按末帧检测到的接触数分组,成功率从 0 接触的 6.9% 单调升到 1/2/3/4 接触的 26.5%、58.2%、70.0%、76.8%;两接触组合中含拇指的为 47.3–66.4%,不含拇指的只有 19.6–25.2%。基于同一检测器的启发式规则"拇指与至少另一指接触即判稳"在全部一万次试验上得 73.07%,远高于 52.9% 的多数类基线,但仍低于所有学习型 touch-only 模型(静态 78.59%、ResNet-Transformer 79.98%、VideoMAEv2 82.64%)——二值接触检测只覆盖了稳定性信号的一部分,剩下的在每根指尖内部的空间模式、指间关系与时间演化里。
真机:门控的收益与代价都被如实报告。四个策略在 20 个训练集外物体上各执行 10 次抬起:触觉门控(vision+proprio+touch)82.0%(164/200),无触觉门控 71.5%,随机门控 47.5%,直接抬起 49.5%;物体级配对 t 检验给出触觉对无触觉 $p=0.003$、对随机门控 $p<0.001$,而随机门控与直接抬起之间无统计差异($p=0.48$),说明收益不来自"弃权+重试"本身。把弃权计入分母的保守 episode 级成功率为 59.2% / 54.8% / 38.2% / 49.5%,排序不变。一个干净的判别力探针来自随机门控:它的接受与否与预测器分数无关,其 200 次执行抬起中,预测分数高于阈值的 89 次成功 86.5%(77/89),低于阈值的 111 次只成功 16.2%(18/111)——预测器确实在区分稳与不稳,而不是靠少抬来刷成功率。四个策略消耗的抓取候选数为 779 / 690 / 764 / 200,no-lift reset 次数为 77 / 61 / 49 / 0:触觉门控用更多的抓取尝试换更少的失败抬起。
| 真机策略(20 个未见物体) | 执行抬起成功率 | episode 级(含弃权) | 抓取候选数 | no-lift reset |
|---|---|---|---|---|
| 触觉门控(V+P+T) | 82.0% (164/200) | 59.2% | 779 | 77 |
| 无触觉门控(V+P) | 71.5% | 54.8% | 690 | 61 |
| 随机门控(接受率 25%) | 47.5% | 38.2% | 764 | 49 |
| 直接抬起 | 49.5% | 49.5% | 200 | 0 |
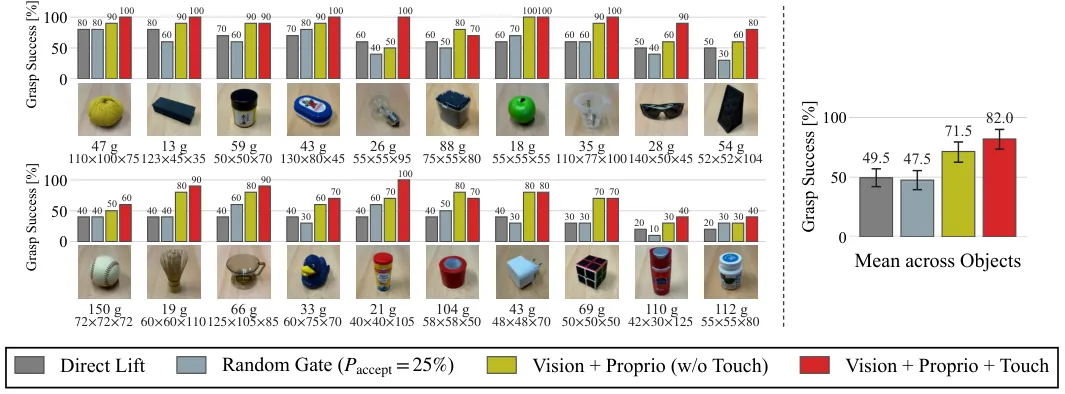
图 7(论文 Fig. 11):20 个训练集外物体上四种策略的逐物体成功率与物体均值。触觉门控(红)在多数物体上领先,均值 82.0% 对无触觉门控的 71.5%。
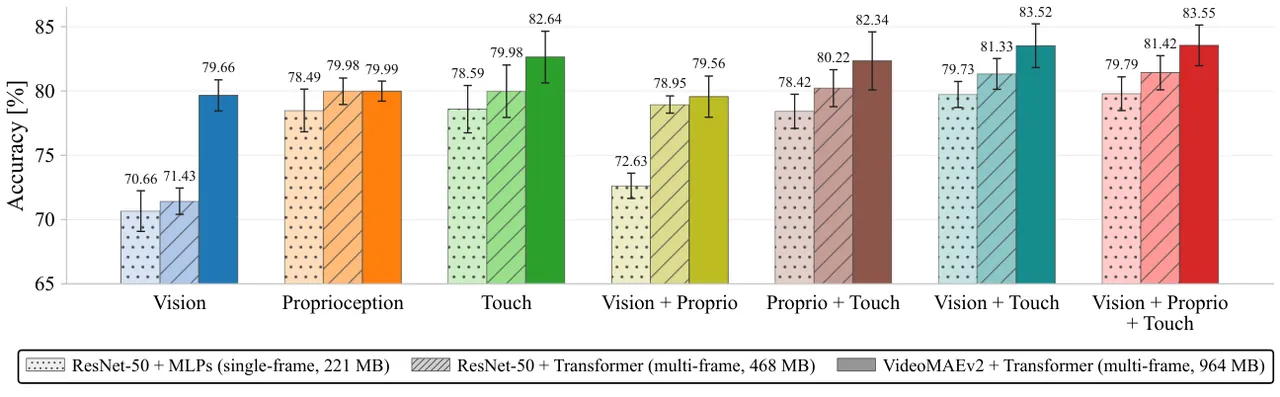
图 6(论文 Fig. 6):模态与编码骨干消融。含触觉的模型整体领先,多帧模型一致优于单帧静态基线,VideoMAEv2 基模型最好。
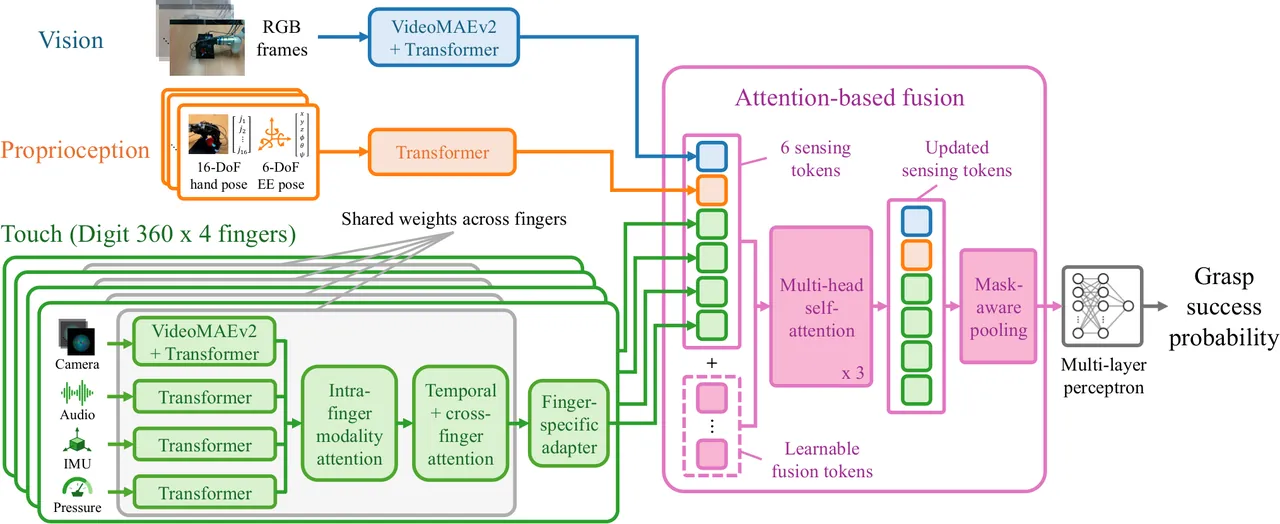
图 3(论文 Fig. 3):网络架构。视觉与本体感知各一条支路;四指触觉在指内跨模态融合、再跨时间与跨手指做分解注意力,经指特异性适配器后与全局注意力融合,输出抓取成功概率。
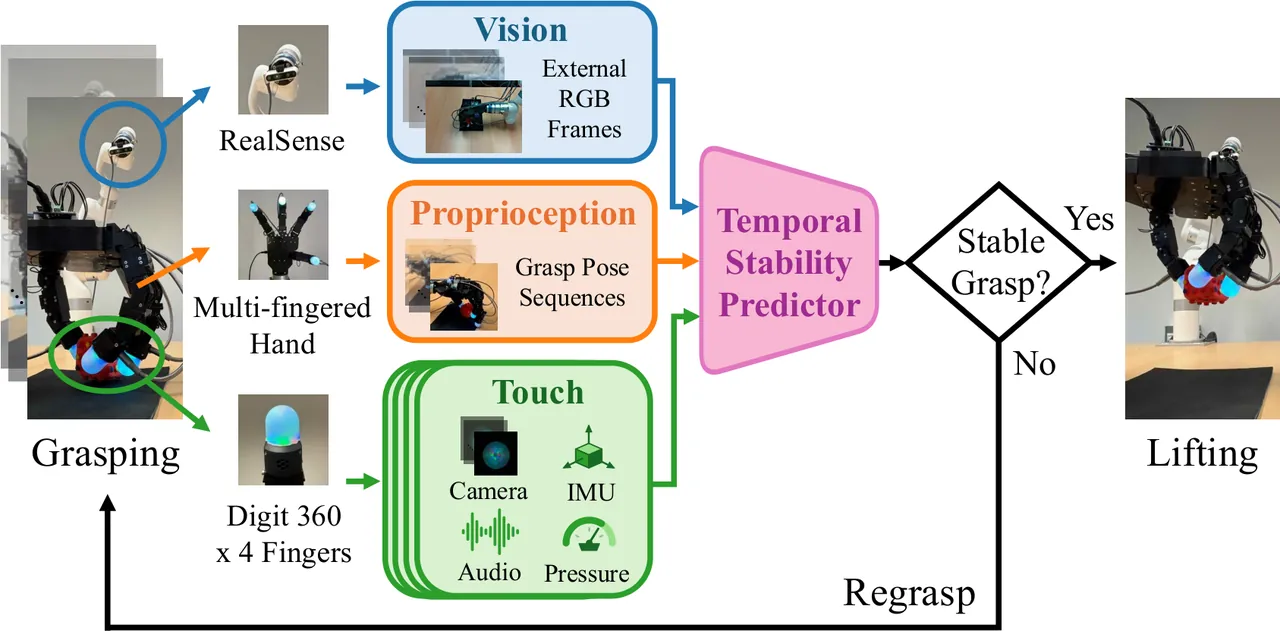
图 1(论文 Fig. 1):总览。抓取执行中机器人通过外部视觉、本体感知与四颗 Digit 360 观测物体与指尖接触,时序预测器估计抬后稳定性并在线门控抬起或重抓。
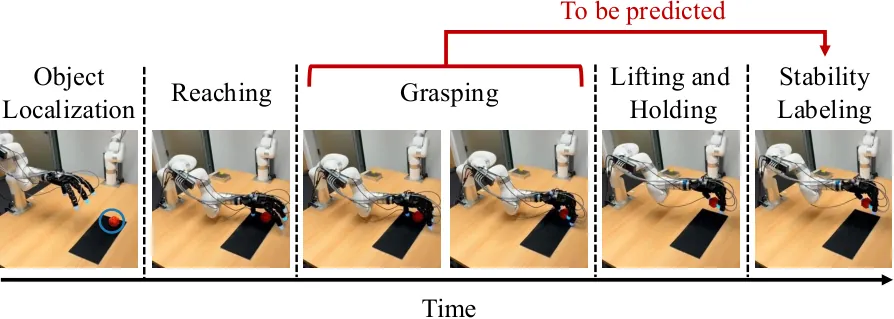
图 5(论文 Fig. 5):自动采集时间线。定位、随机reach与抓取、抬升、按物体高度变化打稳定标签,全程多模态连续记录。
数据规模与标签质量。子采样实验显示准确率随数据量单调上升;单模态中 vision-only 在数据减少时退化最快,touch-enabled 模型对"物体覆盖变少"更鲁棒。标签侧,自动管线与人工核验一致率 92.34%;作者在同一批录像上的后续工作用学习型抬后检测器把一致率推到 99.14%(融合本体、触觉视频、接触音频与外部视觉),仅用手部局部信号(本体+触觉视频+接触音频)也有 98.60%,仅本体感知 97.75%——自动标注并不依赖外部相机的视角与标定,这对换工作台或换周边设备的复用很重要。物体集合本身也值得记录:200 个物体质量跨 1.94–244.4 g(中位 32.34 g),包围盒体积跨 42.3–1210 cm³(中位 216.3 cm³),刚性 105 个、可形变 95 个,塑料 107、硅胶 23、金属 16 为最大材料组;逐物体成功率从 7.1%(Meta Quest 手柄)到 90.6% 不等,17 个物体低于 25%、15 个高于 75%。
局限性
作者自述之一:质量不在输入里。真机实验中三个最重物体(Nutella 罐 244 g、金枪鱼罐 229 g 等)的成功率仍停留在 40–60%。作者的解释是:抬起前局部看似合理的接触,不保证在负载下仍能提供足够支撑,而物体质量并不是预测器的显式输入。这等于承认当前预测器学到的是"接触几何与动态的稳定性",而不是"接触力与重力之比"。
作者自述之二:非相机触觉流是被浪费还是真无信息,仍是开放问题。音频、IMU、气压单独使用都贴近无触觉基线。作者明确说这既可能是这些信号在此任务中信息量低,也可能是共享编码器与融合设计没有用好它们;Sparsh-X 这类按模态特定窗口预训练的编码器因与本文同步 3 秒窗不匹配而未被纳入,作者把它列为可能的改进方向。
作者自述之三:接触分析是观察性的。附录 C 的接触数/接触组合分析中,接触是被检测而非被控制的,各组试验在许多其他维度上并不可比;接触检测器阈值靠人工目视设定,稀有接触组合的样本量少、置信区间宽。
我们的判断之一:单一工作点与弃权口径。阈值 0.95 是测试前经验设定的单点,论文没有给阈值敏感性或精度–召回曲线;"执行抬起成功率"把 no-lift reset 排除在分母之外,保守 episode 级口径下触觉门控是 59.2%,与直接抬起 49.5% 的差距缩小到约 10 个百分点但代价是 77 次复位。读这篇论文时应同时看两个口径,否则会高估门控的免费收益。
我们的判断之二:开环抓取 + 门控 ≠ 闭环触觉控制。闭手阶段是 50 个路点的开环位置控制,触觉既不修正轨迹也不调节握力;门控只做"这次抓要不要抬"的筛选。因此 10.5 个百分点的提升应理解为"更好的试错预算分配",而不是"更好的抓取控制"。作者自己也把闭环触觉控制与 action-conditioned 预测器列为未来工作。
总结与展望
这篇论文的价值不在于某个新模块,而在于它把"触觉对灵巧抓取到底有没有用、用在哪"这个长期靠直觉回答的问题,变成了一组可以复核的测量:模态消融给出触觉的边际贡献(+3.99 个百分点),分辨率消融给出空间细节的边际贡献(1×1 到 112×112 的 +4.15 个百分点),时间消融给出动态的边际贡献(冻结触觉时间维 −2.07 个百分点),手指消融给出多指接触中视觉补不回来的那部分(拇指 +3.06 个百分点),真机门控给出部署形态下的净收益(+10.5 个百分点)。五条证据链指向同一个结论:高分辨率、随时间变化的指尖接触,是多指抓取稳定性最强的可学习信号。
作者列出的方向包括:把候选动作作为输入、从部署中收集的重抓试验持续学习,把预测器扩展为 action-conditioned 模型以给 reach 与闭手轨迹打分;把门控用作 learned grasp planner 的 proposal-agnostic 抬前 critic;在抬升过程中引导闭环触觉控制;引入多视角或深度以补足视觉几何;以及把二值标签扩展为滑移起始、接触丢失等更细的事件标签。对做灵巧操作系统的团队,这篇论文还留下一个更直接的工程结论:在买更贵的手之前,先给指尖装上高分辨率触觉,并把"抬不抬"交给一个看过一万次失败的模型。
金句
"Manipulating objects around us almost always starts with grasping them."——操作我们周围的物体,几乎总是从把它们抓起来开始;而抓起来之前,指尖已经知道答案。