PAPER DEEP DIVE
Agile-WAM:面向接触丰富机器人控制的敏捷触觉世界动作模型
Agile-WAM 从零训练一个不含交叉注意力的「视觉-触觉-动作」流匹配骨干,把融合观测潜变量直接当作流的源,一次前向同时生成动作块与未来视觉/触觉潜变量,并按「视觉看远、触觉看近」做多时域监督;9 个仿真与 5 个真机接触丰富任务成功率最高,单次推理 10.35 ms(96.6 Hz),真机相对最强基线提升 29.4%。
论文元信息
标题:Agile-WAM: An Agile Tactile World Action Model for Contact-Rich Robot Control
作者:Hanchu Zhou, Brendan Lynch, Raman Goyal, Dechen Gao, Begum Kasap, Boqi Zhao, Junshan Zhang(UC Davis 与 Analog Devices,工作完成于 Analog Devices 实习期间)
链接:arXiv:2609.20761 · 项目主页
代码状态:截至采集时本文代码尚未公开,项目主页标注「Code (coming soon)」。其直接骨干 VITA 已开源(ucd-dare/VITA),仿真平台 ManiFeel 亦开源(purdue-mars/manifeel),可作为方法复现的参照实现。
一句话总结:Agile-WAM 用一个从零训练、不含交叉注意力的「视觉-触觉-动作」流匹配骨干,把融合后的观测潜变量直接当作流的源分布,一次性联合生成动作块与未来视觉/触觉潜变量,并以「视觉看远、触觉看近」的多时域监督匹配两种模态各自的时间尺度,从而在 9 个仿真与 5 个真实接触丰富任务上以约 10 毫秒级推理延迟取得最高成功率。
研究背景与动机
世界动作模型(World Action Model, WAM)是近两年机器人学习里一条清晰的新路线:策略不再只学「观测到动作」的映射,而是同时预测世界接下来会变成什么样、以及自己该做什么。预测未来观测迫使表征去捕捉场景中密集的运动与交互信息,而把未来状态与动作放在一起建模,又让表征学会把物理动力学的演化与动作控制连接起来。于是策略获得了一种结构化的「前瞻」能力,生成的动作与它预期中世界的走向更一致,而不是对当前帧的即时反射。
但仅靠视觉,物理交互是看不全的。这一点在接触丰富的操作中尤其尖锐:视觉上看几乎一样的两帧,可能对应完全不同的物理状态——末端执行器以不同的力压在同一个刚性物体上,画面差别微乎其微,而需要的动作调整却精细且关键。触觉传感恰好补上这一通道:它直接感知局部接触、力与滑动。因此触觉已经成为学习精密操作策略越来越重要的一路输入。
最近一批工作开始把触觉接进世界动作模型,做法通常是把一个大规模预训练的视频生成骨干扩展出触觉与动作分支。这条路证明了显式建模触觉动力学确实有利于接触丰富操作,但代价也很直接:大骨干在推理时带来可观的算力与显存开销,难以部署到机载资源受限、又要求高控制频率的机器人平台上。这就把问题逼到了一个根本性的提问上:能不能做一个足够敏捷、以触觉为中心的世界动作模型,既能跨平台灵活部署,又保留世界模型的预测收益?
作者的回答从一个被普遍忽视的物理事实出发:视觉与触觉本来就活在不同的时间尺度上。相邻视觉帧高度冗余,外观变化平滑而缓慢;而触量力场(TacFF)信号一旦接触就可能突变。对两者施加同一个预测时域是偷懒且错配的:视觉看太近,帧间几乎没有变化,监督信号近乎平凡,学不到有意义的动力学;触觉看太远,又会糊掉那些决定成败的高频接触细节。这个「时域错配」正是本文要修的东西。
于是 Agile-WAM 的两条设计主线浮现出来。其一,不去微调大视频模型,而是从零训练一个紧凑的流匹配骨干,并让融合后的观测潜变量直接充当流的唯一源分布,从而在生成过程中彻底免去反复注入观测的条件化模块(如交叉注意力),把复杂度砍下来。其二,引入多时域多模态预测:视觉潜变量在较大的时间偏移上接受监督,触觉潜变量则盯住下一帧,让每种模态的监督都落在它自己「有信息」的时间尺度上。两条线合在一起,目标是一个既会预测未来、又跑得起控制频率的世界动作模型。
预备知识
世界动作模型与触觉世界动作模型。WAM 的核心是联合建模「未来观测」与「动作」。已有的触觉扩展(如 Tactile-WAM、VTAM、Dream-Tac)大多建立在大型预训练生成骨干之上,用非对称注意力等机制把触觉接进视频模型。Agile-WAM 与它们的分歧点不在「要不要预测触觉未来」,而在「用什么规模的骨架去预测」。
触量力场(TacFF)。本文的触觉观测不是单维力标量,而是一张有空间结构的力场图:仿真中为 10×14 的传感点阵,每点测量力的大小与 x、y 方向,构成 10×14×3 的张量;真实硬件上是 Analog Devices 的 32×32 压阻阵列。因为它在结构上「像一张图」,作者直接用一个从零训练的 ResNet-18 作为触觉编码器,与视觉编码器并列。
流匹配与无噪声流策略。流匹配学习一个连续向量场,把样本从源分布搬运到目标分布,推理时只需解一段常微分方程,步数少、质量高,因而适合连续动作生成。更近的一支工作(VITA、FlowPolicy 等)发现:把源分布从高斯噪声换成「由观测派生的有信息表征」,可以做成无噪声流策略,大幅减少采样步数。Agile-WAM 继承这一思想,并把「源是观测潜变量」从只生成动作推广到同时生成动作与多模态未来。
方法详解
问题形式化:联合预测动作与未来潜变量
在环境步 $t$,机器人收到多模态观测 $O_t=\left[O_t^{\mathrm{vis}},\,O_t^{\mathrm{tac}},\,q_t\right]$,其中 $O_t^{\mathrm{vis}}$ 是视觉观测、$O_t^{\mathrm{tac}}$ 是触量力场、$q_t$ 是本体感知状态。策略不再只输出动作,而是建模一个联合分布 $\pi\left(a_{t:t+H},\,z_t^{\mathrm{future}}\mid O_t\right)$:一次前向同时给出长度为 $H$ 的动作块 $a_{t:t+H}$(实际只执行前 $h$ 个动作再重规划),以及未来观测的潜变量 $z_t^{\mathrm{future}}=\left[z_{t+h_{\mathrm{vis}}}^{\mathrm{vis}},\,z_{t+h_{\mathrm{tac}}}^{\mathrm{tac}}\right]$。作者的论点很明确:联合预测未来与动作,会逼着表征去捕捉那些与接触丰富控制直接相关的细微物理动力学,而不是退化成观测到动作的简单映射。
视觉-触觉-动作流匹配:观测即源,免去条件化
传统流策略从高斯噪声出发,并在去噪过程中通过交叉注意力等条件模块反复注入观测。Agile-WAM 反其道而行:用学习到的编码器分别编码图像与 TacFF,再与本体感知 $q_t$ 拼接、经线性投影融合成观测潜变量 $z_0$,让它直接作为流的唯一源分布。流的目标则被切成三块 $z_1=\left[z_1^{a},\,z_1^{\mathrm{vis}},\,z_1^{\mathrm{tac}}\right]$,分别对应动作潜变量、未来视觉潜变量与未来触觉潜变量;源与目标被构造成相同维度以满足流匹配的要求。沿流时间 $\tau\in[0,1]$ 定义线性插值
$$z_{\tau}=(1-\tau)\,z_0+\tau\,z_1,$$其目标速度场为 $z_1-z_0$。一个轻量流网络 $v_\theta$ 通过下式学习这条视觉-触觉-动作的速度场
$$\mathcal{L}_{\mathrm{FM}}=\mathbb{E}_{\tau,\,z_0,\,z_1}\left[\left\|v_\theta(z_\tau,\tau)-(z_1-z_0)\right\|_2^2\right].$$由于感知信息已经整体嵌入源 $z_0$,$v_\theta$ 在 ODE 积分期间不需要任何额外的观测条件化模块。推理时当前观测只编码一次得到 $z_0$,随后解
$$\frac{dz_\tau}{d\tau}=v_\theta(z_\tau,\tau),\qquad z_{\tau=0}=z_0,$$从 $\tau=0$ 积到 $\tau=1$(显式欧拉、6 步),得到联合潜变量 $\hat z_1=\left[\hat z_1^{a},\,\hat z_1^{\mathrm{vis}},\,\hat z_1^{\mathrm{tac}}\right]$,再由动作解码器解出动作块并执行。这正是推理延迟能压到 10 毫秒级的结构性原因:观测只进一次,生成过程里没有昂贵的注意力条件化。
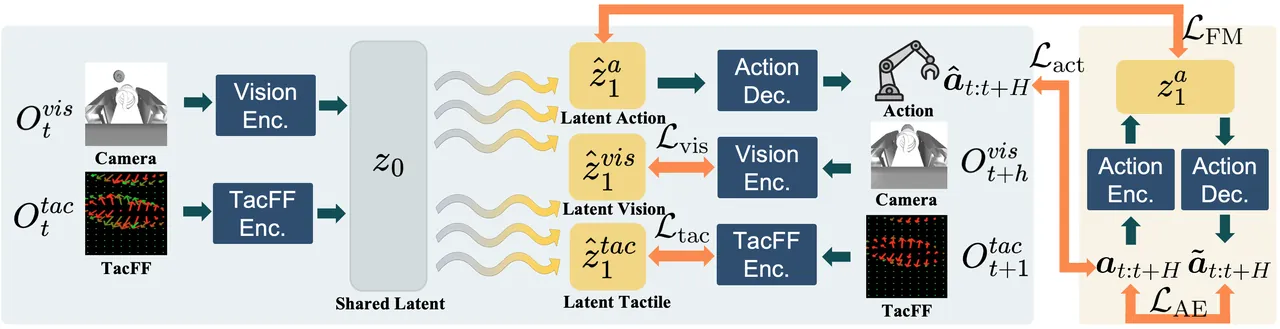
图1:Agile-WAM 总览。视觉与 TacFF 观测经各自编码器融合为共享源潜变量 z0;流匹配骨干一次性生成动作潜变量、未来视觉潜变量与未来触觉潜变量;动作自编码器提供结构化动作潜空间,多时域监督让视觉看 t+h、触觉看 t+1。
动作自编码器与「双重动作监督」
流的目标里含动作潜变量 $z_1^a$,但潜空间若无约束很容易塌缩或漂移。作者沿用 VITA 的做法,引入动作编码器 $E_a$ 与解码器 $D_a$ 构造结构化动作潜空间
$$z_1^{a}=E_a(a_{t:t+H}),\qquad \tilde a_{t:t+H}=D_a(z_1^{a}),$$并以重构损失端到端训练
$$\mathcal{L}_{\mathrm{AE}}=\left\|a_{t:t+H}-D_a(E_a(a_{t:t+H}))\right\|_1.$$关键在于推理时解码器吃到的不是编码器产出的目标 $z_1^a$,而是 ODE 生成的 $\hat z_1^a$。为弥合「训练目标潜变量」与「推理生成潜变量」之间的差距,作者在训练时额外把 ODE 生成的潜变量也送进解码器,并在动作空间施加监督
$$\mathcal{L}_{\mathrm{act}}=\left\|a_{t:t+H}-D_a(\hat z_1^{a})\right\|_1.$$这条损失的梯度会穿过动作解码器与整段 ODE 积分过程,把生成出来的潜变量直接锚定到可执行的真实动作上。式 (1) 与式 (2) 合起来,既稳住了动作表征,又缩小了训练/推理潜变量的分布差——这是无噪声流策略里最容易被忽视、却最影响落地手感的一环。
多时域多模态预测:视觉看远,触觉看近
多模态世界建模的一个核心难题是模态间时间尺度不一致。连续视觉帧冗余度高,相邻帧预测几乎给不出学习信号;触觉却可能在极短时间内因接触或受阻而剧烈变化,长时域预测会抹平这些细节。作者据此构造不同时间偏移的目标潜变量
$$z_1^{\mathrm{vis}}=E_{\mathrm{vis}}\left(O_{t+h_{\mathrm{vis}}}^{\mathrm{vis}}\right),\qquad z_1^{\mathrm{tac}}=E_{\mathrm{tac}}\left(O_{t+h_{\mathrm{tac}}}^{\mathrm{tac}}\right),$$其中触觉取下一帧 $h_{\mathrm{tac}}=1$,视觉取与推理时执行动作长度一致的较长偏移 $h_{\mathrm{vis}}=h$(实验中为 8)。较长的视觉时域逼模型去捕捉真正有意义的场景演化,而不是塌缩成复制当前帧;较短的触觉时域则保住突变的接触信息。解出 ODE 后,联合潜变量被拆成三支,在潜空间接受监督
$$\mathcal{L}_{\mathrm{vis}}=\left\|\hat z_1^{\mathrm{vis}}-z_1^{\mathrm{vis}}\right\|_2^2,\qquad \mathcal{L}_{\mathrm{tac}}=\left\|\hat z_1^{\mathrm{tac}}-z_1^{\mathrm{tac}}\right\|_2^2.$$注意监督发生在潜空间而非像素空间:这提供了一个紧凑的学习目标,让共享的流表征去捕捉两种模态中与任务相关的演化,而不必付出高维观测生成的昂贵代价。完整训练目标为五项加权和
$$\mathcal{L}_{\text{Agile-WAM}}=\lambda_{\mathrm{FM}}\mathcal{L}_{\mathrm{FM}}+\lambda_{\mathrm{AE}}\mathcal{L}_{\mathrm{AE}}+\lambda_{\mathrm{act}}\mathcal{L}_{\mathrm{act}}+\lambda_{\mathrm{vis}}\mathcal{L}_{\mathrm{vis}}+\lambda_{\mathrm{tac}}\mathcal{L}_{\mathrm{tac}}.$$flowchart LR CAM["Camera O_t^vis
wrist RGB"] --> VENC["Vision Encoder
ResNet-18 pretrained"] TAC["TacFF O_t^tac
force field grid"] --> TENC["Tactile Encoder
ResNet-18 from scratch"] PRO["Proprioception q_t"] --> FUSE["Concat + Linear
source latent z0"] VENC --> FUSE TENC --> FUSE FUSE --> FLOW["Flow matching v_theta
6-step Euler ODE
no cross-attention"] FLOW --> ZA["action latent z1^a"] FLOW --> ZV["visual latent z1^vis"] FLOW --> ZT["tactile latent z1^tac"] ZA --> ADEC["Action Decoder D_a
chunk H=16 run h=8"] AENC["Action Encoder E_a
on ground truth a"] --> ZAT["target z1^a"] ZAT --> FLOW ADEC --> LACT["L_act vs a_t:t+H"] AENC --> LAE["L_AE reconstruction"] FV["Future camera O vis t+8"] --> VENC2["Vision Enc"] --> LV["L_vis"] ZV --> LV FT["Next TacFF O tac t+1"] --> TENC2["TacFF Enc"] --> LT["L_tac"] ZT --> LT
图1补:按论文方法绘制的数据流。源潜变量 z0 只编码一次;流一次性产出三支潜变量;视觉监督落在 t+8、触觉监督落在 t+1,动作监督同时走编码器路径(L_AE)与 ODE 生成路径(L_act)。
实验结果
仿真:ManiFeel 上九个接触丰富任务
仿真在 ManiFeel 基准上进行:7 自由度 Franka Emika Panda,夹爪装 TacFF 传感器(10×14×3),训练与评估都只用 256×256 的腕部相机——腕视角在夹爪接触物体时经常被遮挡,这恰好放大了触觉的价值。每个任务用官方数据集中 20–50 条示范训练。对照包括纯视觉扩散策略 DP、视觉+触觉扩散策略 DP-VT、Tactile-WAM(作者按其核心组件 Tactile Asymmetric Attention 在 ManiFeel 官方触觉扩散实现中复现)、以及纯视觉 VITA 与加上触觉的 VITA-VT。动作块 $H=16$、执行 $h=8$;VITA 系与 Agile-WAM 用 6 步 ODE,DP 系用 100 步去噪。
| 仿真任务 | Agile-WAM | VITA-VT | VITA | Tactile-WAM | DP-VT | DP |
|---|---|---|---|---|---|---|
| Bulb Screw | 92.67±2.49 | 87.33±0.94 | 71.33±0.94 | 4.00±0.00 | 4.67±2.49 | 5.33±0.94 |
| Gear Assembly | 70.67±2.49 | 68.67±1.89 | 68.33±0.47 | 68.00±1.63 | 58.67±6.18 | 58.67±1.89 |
| Power Plug Insertion | 59.33±0.94 | 63.33±3.27 | 54.67±3.40 | 61.33±2.49 | 58.00±3.27 | 53.67±1.25 |
| Peg Reorientation | 42.00±1.63 | 28.67±0.94 | 41.33±4.11 | 34.67±2.49 | 28.00±2.83 | 22.00±1.63 |
| Peg Insertion | 49.33±0.94 | 47.33±2.49 | 44.00±1.67 | 40.00±9.80 | 20.67±13.20 | 21.33±18.86 |
| USB Insertion | 62.00±5.89 | 59.33±9.43 | 55.33±4.11 | 44.67±8.06 | 38.00±2.83 | 41.33±5.25 |
| Ball Sorting | 92.00±0.00 | 90.00±3.27 | 72.00±7.12 | 45.33±0.94 | 74.67±5.25 | 38.67±3.40 |
| Object Search | 50.67±2.49 | 36.00±2.83 | 40.00±3.27 | 33.33±2.49 | 13.33±0.94 | 14.67±3.40 |
| Nut Bolt Threading | 92.67±2.49 | 92.00±2.83 | 86.67±4.71 | 13.33±2.49 | 72.00±3.27 | 4.67±0.94 |
表1:仿真成功率(%)。Agile-WAM 在九项中八项领先;唯一落后的 Power Plug Insertion 上 VITA-VT 以 63.33 略胜。值得注意的是 Tactile-WAM 在 Bulb Screw、Nut Bolt Threading 上几乎失效(4.00 / 13.33),说明「把触觉接进大骨干」并不自动带来收益。
真实世界:五个任务与纠正行为
真实实验用 7 自由度 Flexiv Rizon 4,腕部 Intel RealSense D405(320×240、30 FPS),夹爪装 Analog Devices 32×32 压阻触觉阵列(30 Hz),每任务用 Meta Quest 3 遥操作采 50 条专家示范,每策略每任务评 20 回合。作者刻意在示范里混入「第一次没对准、需要纠正」的轨迹:在腕视角被遮挡的条件下,策略必须一边保持足够接触以获取有信息的触觉,一边避免压坏物体或夹爪。
| 策略 | Gear Assembly | Peg Insertion | Power Plug Insertion | Internet Cable Insertion | Internet Cable Unplugging |
|---|---|---|---|---|---|
| Agile-WAM | 0.80 (16/20) | 0.55 (11/20) | 0.65 (13/20) | 0.30 (6/20) | 0.85 (17/20) |
| VITA-VT | 0.55 (11/20) | 0.60 (12/20) | 0.35 (7/20) | 0.15 (3/20) | 0.75 (15/20) |
| VITA | 0.75 (15/20) | 0.25 (5/20) | 0.25 (5/20) | 0.20 (4/20) | 0.20 (4/20) |
表2:真实世界成功率。Agile-WAM 五任务合计 63/100,VITA-VT 为 48/100、纯视觉 VITA 仅 33/100;摘要所称 29.4% 的相对增益,与「逐任务相对最强基线再取平均」的口径吻合(约 29.5%)。
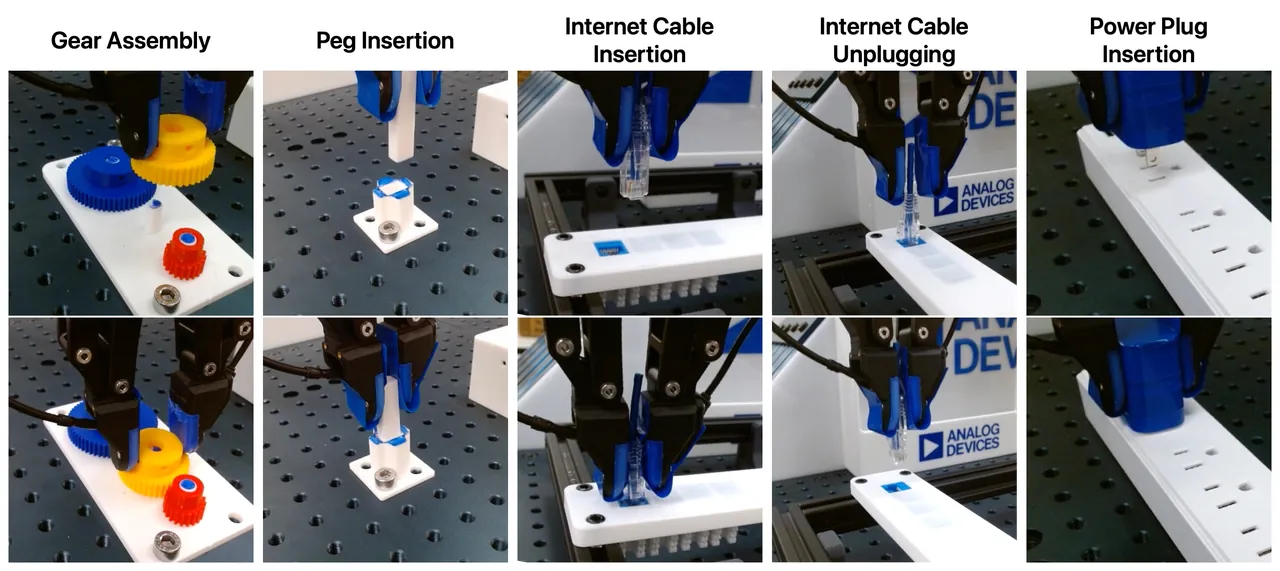
图2:真实世界五个接触丰富任务:齿轮装配、销插入、网线插入、网线拔出、电源插头插入。
纠正行为是真实实验里最有说服力的部分。以销插入为例:销接近底座时腕视角被销本身部分遮挡,视觉上很难判断销是对准了孔还是顶在孔缘。Agile-WAM 会依据触觉反馈让销沿表面滑动、朝孔的方向搜索,直到成功插入;齿轮装配中,中间齿轮卡住无法啮合时,它检测到停滞并做纠正性的拧转,直到齿轮对齐落位。相比之下,纯视觉的 VITA 对接触状态几乎无感知;VITA-VT 虽有触觉输入,却常常学不出稳定的恢复行为,第一次失败后要么卡住、要么盲目硬推。这正说明「动作-未来联合建模」让表征同时抓住了视觉演化与局部接触动力学。
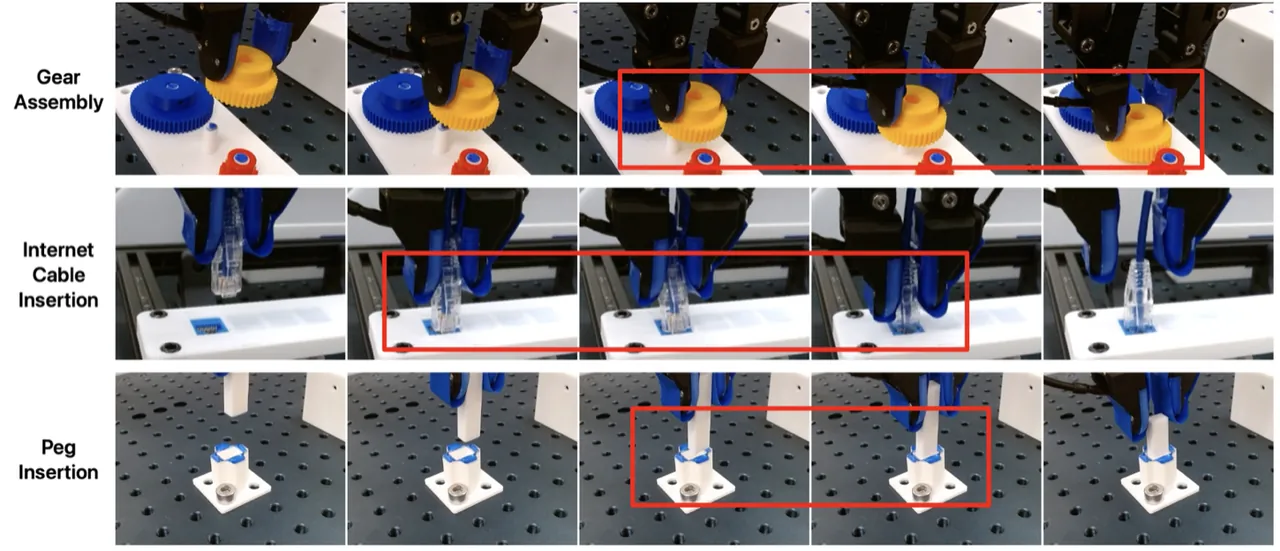
图3:纠正行为序列。红框标出纠正阶段:初始对位失败后,Agile-WAM 在视觉被遮挡的情况下轻保持接触、借触觉搜索正确插入位置。
推理效率:世界模型也可以跑在控制频率上
效率在单张 RTX 4090、FP32、batch 1 下测量,动作块长度 16,取 50 次平均。Agile-WAM 单次推理 10.35±0.14 毫秒、对应控制频率 96.62 Hz;作为对照,VITA 为 9.71 毫秒 / 102.99 Hz,VITA-VT 为 10.52 毫秒 / 95.06 Hz,而 DP、DP-VT、Tactile-WAM(TAAM)分别是 408.59 / 420.34 / 636.34 毫秒,控制频率只有 2.45 / 2.38 / 1.57 Hz。也就是说 Agile-WAM 的控制频率约为扩散策略的 40 倍、约为 Tactile-WAM 的 60 倍。作者指出,虽然 Agile-WAM 与 VITA 共用同一轻量流匹配骨干,但额外加入了触觉编码与更大的联合潜空间,而这些开销因模型紧凑、可在 GPU 上并行而几乎可以忽略——这正是「敏捷」二字的量化含义,也暗示了向机载边缘平台部署的可能。
| 模型 | 推理时间 (ms) | 相对 | 控制频率 (Hz) | 相对 |
|---|---|---|---|---|
| Agile-WAM | 10.35±0.14 | 1.07× | 96.62 | 0.94× |
| VITA | 9.71±0.11 | 1.00× | 102.99 | 1.00× |
| VITA-VT | 10.52±0.14 | 1.08× | 95.06 | 0.92× |
| DP | 408.59±0.47 | 42.08× | 2.45 | 0.02× |
| DP-VT | 420.34±0.36 | 43.29× | 2.38 | 0.02× |
| TAAM (Tactile-WAM) | 636.34±0.90 | 65.53× | 1.57 | 0.02× |
表3:推理效率对比(RTX 4090、FP32、batch 1、50 次平均)。需要指出:摘要中的 11.9 毫秒与表3 的 10.35 毫秒并不一致,论文未解释这一差异,读者引用时应以表3 的测量口径为准。
消融:世界建模、模态组合与时域设计
消融围绕三个问题展开。第一,收益究竟来自「联合建模未来」还是仅仅来自「更大的潜空间」?作者保留扩大的预测头但关掉 $\mathcal{L}_{\mathrm{vis}}$ 与 $\mathcal{L}_{\mathrm{tac}}$,结果成功率从 92.7±2.5 掉到 86.7±4.1,甚至低于直接去掉预测头的 87.3±0.9——说明提升主要来自联合动作-未来建模本身,而非额外容量。第二,预测哪些模态最有效?在视觉+触觉输入下,只预测视觉(87.3±1.9)、只预测触觉(86.0±1.6)或都不预测(87.3±0.9)都不如两者 jointly 预测(92.7±2.5);而在纯视觉输入下,预测视觉未来(90.7±2.5)显著优于不预测(71.3±0.9)。结论是:世界建模在被预测模态与可用观测模态一致时最有效。第三,时域怎么设?「视觉 +8、触觉 +1」的 92.7±2.5 优于「都 +1」的 90.7±2.5 与「都 +8」的 88.7±2.5,直接验证了多时域设计的动机。预测损失权重上,$\lambda=1.0$ 的 92.7±2.5 明显好于 0.0 的 86.7±4.1 与 0.1 的 87.3±3.4。
| 消融维度 | 设置 | 成功率 (%) |
|---|---|---|
| 预测头 | 预测头 + 预测损失(完整) | 92.7±2.5 |
| 预测头 | 无预测头 | 87.3±0.9 |
| 预测头 | 有预测头但无预测损失 | 86.7±4.1 |
| 预测模态 | VT 输入 + VT 预测(完整) | 92.7±2.5 |
| 预测模态 | VT 输入 + 仅 V 预测 | 87.3±1.9 |
| 预测模态 | VT 输入 + 仅 T 预测 | 86.0±1.6 |
| 预测模态 | V 输入 + V 预测 | 90.7±2.5 |
| 预测模态 | V 输入 + 无预测 | 71.3±0.9 |
| 预测时域 (vis, tac) | (+8, +1) 多时域(完整) | 92.7±2.5 |
| 预测时域 (vis, tac) | (+1, +1) | 90.7±2.5 |
| 预测时域 (vis, tac) | (+8, +8) | 88.7±2.5 |
| 预测损失权重 | 1.0(完整) | 92.7±2.5 |
| 预测损失权重 | 0.0 | 86.7±4.1 |
表4:消融结果(读自论文图5)。完整模型的 92.7±2.5 与表1 中 Bulb Screw 一项吻合,故消融应是在该代表性仿真任务上报告。
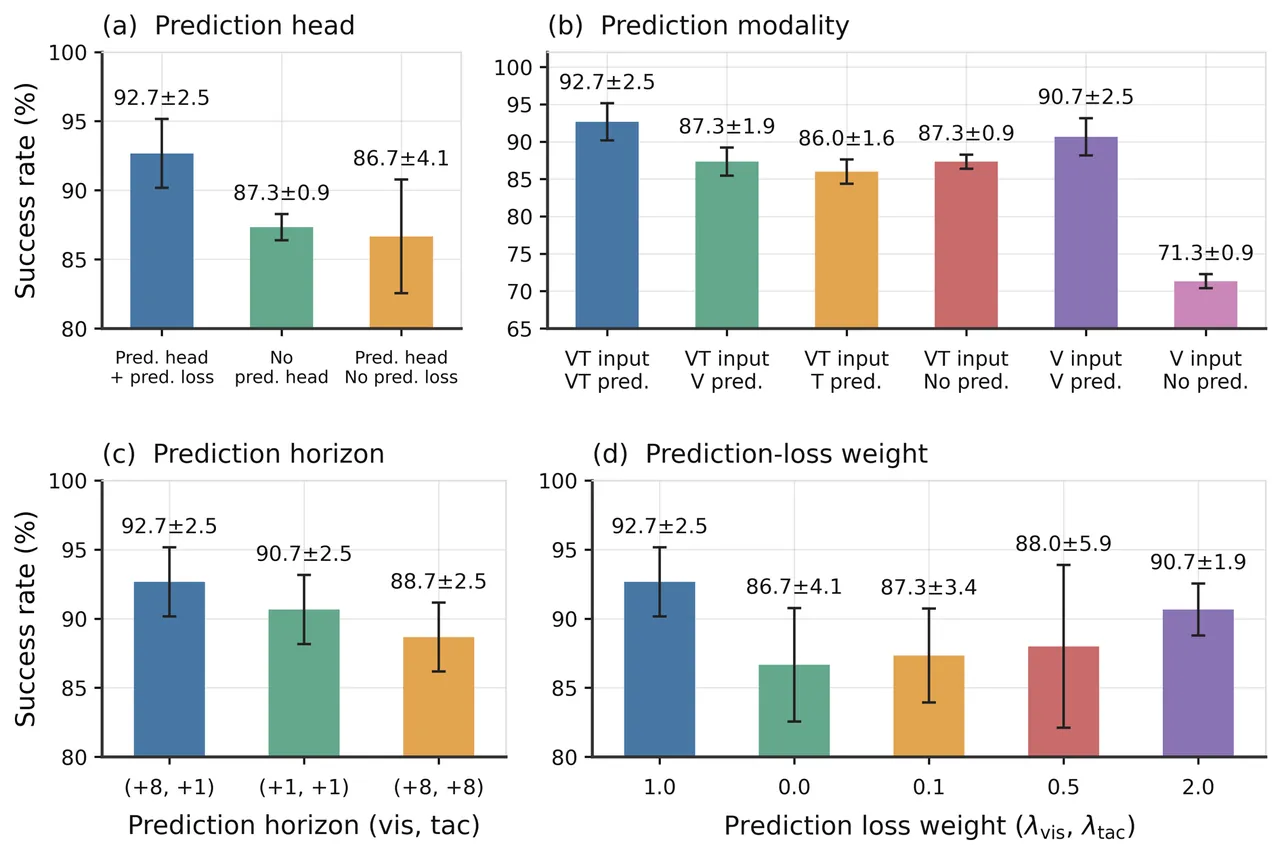
图4:四组消融。(a) 预测头与预测损失;(b) 预测模态组合;(c) 预测时域;(d) 预测损失权重。
局限性
其一,世界只存在于潜空间。Agile-WAM 的未来预测是潜变量层面的监督,不生成像素级未来帧。这换来了效率,但也意味着它无法像视频世界模型那样输出可供人检视、或供下游视觉规划/想象式推理使用的可视化未来;「世界模型」在这里更准确的说法是一个被未来预测正则化的动作策略表征。
其二,实验面较窄、且依赖特定触觉硬件。作者自述实验集中在 ManiFeel 仿真与单一真实平台(Flexiv Rizon 4 + Analog Devices 32×32 压阻阵列),真实任务每任务仅 20 个评测回合;触觉编码器针对 TacFF 这类「像图」的力场设计,对其它形态的触觉传感(如光学触觉 GelSight、单维力/力矩)能否直接迁移,论文没有给出证据。真实任务中较难的 Internet Cable Insertion 成功率也只有 0.30,说明方法离稳健部署仍有距离。
其三,可复现性与口径问题。代码尚未公开,两个关键基线(Tactile-WAM、VITA-VT)是作者自行复现/改造的版本,第三方难以核对;摘要的 11.9 毫秒与表3 的 10.35 毫秒不一致、消融未明确说明任务,也削弱了数字的可追溯性。此外策略为单任务策略,不含语言或高层指令条件化,距离通用操作策略还有明显一步。
总结与展望
Agile-WAM 的贡献不在于「又一个世界动作模型」,而在于给出了一条反直觉但被数据支撑的路径:世界模型不必建立在庞大的预训练生成骨干之上。当源分布就是融合观测本身、当条件化模块被整体移除、当每种模态的未来监督落在它自己有信息的时间尺度上时,一个从零训练的紧凑流匹配骨干就能同时拿到最高成功率与毫秒级延迟。九仿真加五真实任务、以及把「容量」与「联合建模」分离开的消融,让这条结论站得住。对机器人开发者而言,它提示了一个务实的方向:在接触丰富、高频率的控制场景里,先把感知融合与监督时域设计对,比把模型做大更划算。若后续公开代码并把触觉编码器推广到更多传感形态、把潜空间未来与可视化未来打通,这条「敏捷世界模型」路线有望成为机载部署的默认选项之一。
金句:世界模型不必庞大——当流的源就是观测本身时,预测未来与生成动作可以共用一条轻到能跑在控制频率上的流。