PAPER DEEP DIVE
SkeleWAM:把操作场景压成稀疏三维骨架
世界动作模型通常把未来状态表示为视频或视觉 latent,几何只被隐式编码且夹带与控制无关的外观。SkeleWAM 只保留机器人关节、物体中心与交互点三类三维路标,用同一副骨架同时做动作生成与未来骨架预测,训练期用后者作辅助监督、推理期完全省掉,在 LIBERO-Plus 上以 57.1M 参数取得 85.9% 零样本成功率,超过 2B 参数的 Cosmos-Policy 3.7 个百分点。
SkeleWAM: Skeleton World-Action Modeling for Efficient Robotic Manipulation
Juyi Sheng、Hua Wang、Mengyuan Liu(北京大学)
arXiv:2610.02120v1 [cs.RO],2026-10-01 · 项目主页
代码状态:本文未提供公开代码。arXiv 全文与项目主页均未给出代码仓库链接,项目主页只提供论文 PDF、演示视频与图片资源。
一句话总结
世界动作模型(WAM)通常把未来状态表示成视频或视觉 latent,但这些表示只隐式地编码了几何,还带着与控制无关的外观信息;SkeleWAM 的做法是只保留机器人关节、物体中心与交互点这三类三维路标,用一副稀疏骨架同时承担动作生成与未来骨架预测,训练时用「预测未来几何」当作辅助监督、推理时完全不需要它,在 LIBERO-Plus 上以 57.1M 参数拿到 85.9% 的零样本成功率,超过 2B 参数的 Cosmos-Policy 3.7 个百分点。
一、研究背景:从 VLA 到世界动作模型
基于学习的机器人操作已经从任务专用的视觉运动策略,进化到通用机器人基础模型。ACT 从视觉观测里学动作块(action chunk),Diffusion Policy 与 DP3 分别用 2D 和 3D 视觉表示建模表达力更强的动作分布。随着预训练与机器人数据集规模扩张,通用策略与视觉-语言-动作(VLA)模型——RT-2、Octo、OpenVLA、$\pi_0$、$\pi_{0.5}$——在 increasingly 广泛的任务与环境上展示出能力。
世界动作模型(WAM)在此之上多走一步:同时建模机器人动作生成与未来状态预测。后者提供了额外监督,让模型学到「操作场景在机器人动作下如何演化」。问题出在状态的表示方式上——许多已有 WAM 把未来状态表示成生成的视频或学习到的视觉 latent。
论文对这条路线提出两点质疑。第一,latent 预测确实比显式生成视频便宜,但 latent 里保留的信息在很大程度上由底层视觉编码器及其预训练目标决定,不是由任务需要决定。第二,也是更关键的一点:压缩视觉观测本身并不会把控制所依赖的几何变量隔离出来——机器人物体的空间配置与相对运动这些真正支配交互的量,仍然淹没在外观信息里。
于是论文提出一个更根本的问题:机器人-物体结构的稀疏表示能否支撑有效的世界动作学习,同时大幅降低模型复杂度?
作者的关键观察是:操作场景中与控制最相关的部分,可以表示为机器人与被操作物体上的一组稀疏三维路标。机器人用其关节的三维位置表示,每个物体则用中心加一组交互点表示——中心刻画整体空间位置,交互点标识与机器人接触、操作相关的位置。
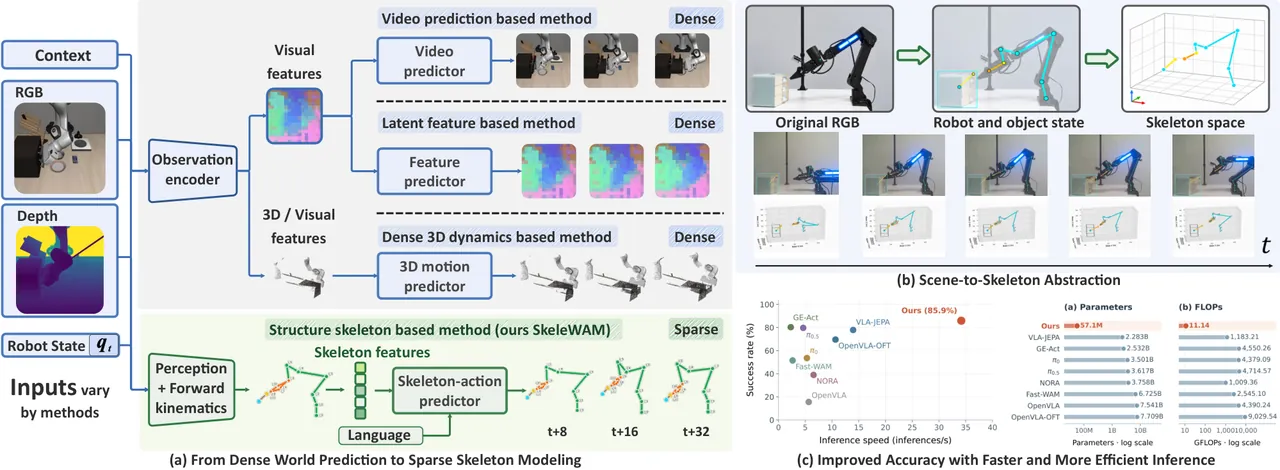
图1:稀疏骨架状态让世界动作建模变高效。已有 WAM 把未来状态表示为视频、视觉 latent 或稠密三维动力学;SkeleWAM 则把 RGB-D 观测与机器人状态转成稀疏三维骨架(机器人关节、物体中心、交互点),训练时联合学习动作生成与未来骨架预测。
这三类路标各自对应一个明确的分工:关节位置刻画机器人构型,物体中心给出稳定空间参考,交互点标出操作相关的接触区域。合在一起是一副完整的、与外观无关的「可操作骨架」——这正是论文标题里 Skeleleton(骨架)与 WAM(世界动作模型)的合成含义。
二、相关工作与 SkeleWAM 的位置
视觉运动策略与 VLA 模型。视觉运动策略学习从观测到机器人动作的直接映射。ACT 预测时间上连贯的动作块,Diffusion Policy 与 DP3 分别用图像与三维点云观测建模多模态动作分布。VLA 模型引入预训练视觉-语言表示做语言条件的多任务控制:RT-2 与 OpenVLA 把视觉语言表示适配到动作生成,$\pi_0$ 与 $\pi_{0.5}$ 通过流匹配与异构协同训练改进连续控制与泛化。更近期的工作用 OpenVLA-OFT、$\pi_0$-FAST、NORA 分别改进策略适配、动作编码与模型紧凑性。共同的局限是:这些策略主要优化动作预测,并不显式建模操作场景在机器人动作下如何演化。
世界动作模型。为了刻画这种演化,WAM 在动作学习之上叠加未来状态预测。WorldVLA 与 UniVLA 联合建模动作生成与视觉世界演化,DreamZero、GE-Act、Cosmos-Policy 利用预训练视频模型做机器人控制与规划,VLA-JEPA 用预测未来 latent 目标表示替代像素重建,Fast-WAM 则保留未来视频预测作为协同训练目标、但在推理时去掉未来生成。论文对这条路线的判词是:latent 目标确实降低了计算成本与对像素重建的依赖,但视频与视觉 latent 都只隐式表示交互几何,而不是把它参数化为显式的状态变量。
SkeleWAM 的位置由此确定:它把当前与未来状态直接定义在由机器人关节、物体中心与交互点组成的稀疏三维骨架空间里。这样未来几何预测可以在训练期监督表示学习,而推理时完全不需要它——这与 Fast-WAM 对视频所做的「只在训练期协同训练」是同一个想法,只是把对象从像素/latent 换成了显式几何状态。
三、预备知识:问题形式化
给定语言指令 $\ell$、当前 RGB-D 观测 $o_t$ 与机器人本体感知状态 $q_t$,目标是生成一个动作块:
$$\mathbf{A}_t = \left[\mathbf{a}_t, \ldots, \mathbf{a}_{t+H_a-1}\right] \in \mathbb{R}^{H_a \times d_a} \tag{1}$$
其中 $\mathbf{a}_{t+i} \in \mathbb{R}^{d_a}$ 是单个机器人动作,$H_a$ 是动作horizon,$d_a$ 是动作维度。场景则被表示成稀疏三维骨架:
$$\mathbf{S}_t = \Phi_{\psi}(o_t, q_t, \ell) \in \mathbb{R}^{N \times 3} \tag{2}$$
$N$ 是骨架节点数,$\Phi_{\psi}$ 就是 3.2 节定义的骨架提取器。训练时还额外定义未来骨架序列 $\mathbf{S}_t^+ = [\mathbf{S}_{t+\delta_1}, \dots]$,用于 3.4 节的辅助监督。
这里有一个值得注意的设计取舍:$\Phi_{\psi}$ 不含可学习参数需要反传的部分——机器人路标由正运动学(forward kinematics)算出,物体路标由一个预训练且在训练中冻结的感知网络从 RGB-D 估计。换句话说,骨架是「在线构造」的状态,而不是学出来的表示。
四、方法详解
4.1 骨架世界表示
整个场景骨架由机器人关键点与任务相关物体路标组成。对第 $m$ 个物体,定义:
$$\mathbf{P}_{t,m} = \left[\mathbf{c}_{t,m}; \mathbf{u}_{t,m,1}; \ldots; \mathbf{u}_{t,m,L_m}\right] \in \mathbb{R}^{(1+L_m) \times 3} \tag{5}$$
其中 $\mathbf{c}_{t,m}$ 是物体中心,$\mathbf{u}_{t,m,j}$ 是它的第 $j$ 个交互点。完整骨架把所有这些拼起来:
$$\mathbf{S}_t = \left[\mathbf{J}_t; \mathbf{P}_{t,1}; \ldots; \mathbf{P}_{t,M}\right], \quad N = N_r + \sum_{m=1}^{M}(1+L_m) \tag{6}$$
$\mathbf{J}_t \in \mathbb{R}^{N_r \times 3}$ 是机器人关节与末端执行器位置,$M$ 是物体数,分号表示沿节点维拼接。连接关系定义了骨架的组织方式:机器人节点遵循运动学连通性,每个物体中心连接到它自己的交互点。节点的身份、顺序与连接关系在整个时间上保持一致——模型只预测节点坐标。所有坐标都在共享的机器人中心坐标系下表达,并用训练集统计量归一化。
「共享机器人中心坐标系」这个细节值得强调:它意味着相机视角变化被部分吸收掉了。论文后面的消融会给出这一点的直接证据——在相机扰动下 93.4% 的成功率,远高于所有基线。
3.2 双专家架构与块注意力掩码
语言指令被编码为 $\mathbf{C}^\ell = \mathcal{E}_{\mathrm{lang}}(\ell)$。三个独立的输入适配器把当前骨架、带噪动作块、带噪未来骨架序列映射成 token:
$$\mathbf{X}_t^c = \phi_c(\mathbf{S}_t), \quad \mathbf{X}^a_{t,\tau_a} = \phi_a(\widetilde{\mathbf{A}}_{t,\tau_a}), \quad \mathbf{X}^s_{t,\tau_s} = \phi_s(\widetilde{\mathbf{S}}^+_{t,\tau_s}) \tag{7}$$
其中 $\tau_a$ 与 $\tau_s$ 是噪声时间,与环境时间步 $t$ 不同。当前骨架不受生成噪声扰动——它始终是干净的条件。
架构沿用 Fast-WAM 的两专家 Mixture-of-Transformers 设计:世界专家以共享参数处理当前与未来骨架 token,动作专家处理动作 token,两个专家都以 $\mathbf{C}^\ell$ 为条件。三组 token 按 $(\mathbf{X}_t^c, \mathbf{X}^a_{t,\tau_a}, \mathbf{X}^s_{t,\tau_s})$ 排列时,块注意力掩码定义为:
$$\mathbf{M} = \begin{bmatrix} 1 & 0 & 0 \\ 1 & 1 & 0 \\ 1 & 0 & 1 \end{bmatrix} \tag{8}$$
行索引 query 组、列索引 key/value 组,1 表示允许、0 表示屏蔽。当前骨架 token 只在自己组内注意;每个预测组都注意当前骨架与自己,但动作与未来骨架 token 之间互不注意力。输出头在单次前向里同时预测动作向量场 $\hat{\mathbf{v}}^a_\theta \in \mathbb{R}^{H_a \times d_a}$ 与骨架向量场 $\hat{\mathbf{v}}^s_\theta \in \mathbb{R}^{H_s \times N \times 3}$。
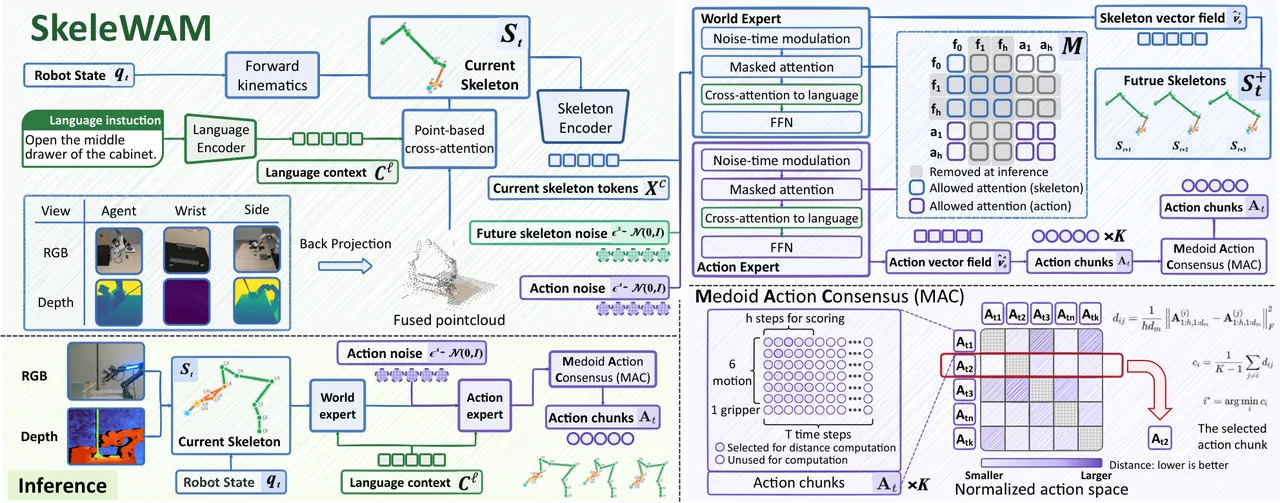
图2:SkeleWAM 总览。冻结的视觉感知与正运动学构造当前骨架;动作生成与未来骨架预测共享世界专家,推理时只保留前者。
3.3 训练目标:流匹配 + 联合监督
两个预测任务都用流匹配训练。给定演示对 $(\mathbf{A}_t, \mathbf{S}_t^+)$,采样形状匹配的标准高斯噪声 $\boldsymbol{\epsilon}^a$、$\boldsymbol{\epsilon}^s$ 与噪声时间 $(\tau_a, \tau_s) \sim \rho$ 于 $[0,1]^2$。插值路径是线性的:
$$\widetilde{\mathbf{A}}_{t,\tau_a} = (1-\tau_a)\mathbf{A}_t + \tau_a\boldsymbol{\epsilon}^a, \quad \widetilde{\mathbf{S}}^+_{t,\tau_s} = (1-\tau_s)\mathbf{S}^+_t + \tau_s\boldsymbol{\epsilon}^s \tag{9}$$
噪声时间 0 对应数据、1 对应高斯噪声。对应的目标向量场是噪声减去数据:
$$\mathbf{v}^a = \boldsymbol{\epsilon}^a - \mathbf{A}_t, \qquad \mathbf{v}^s = \boldsymbol{\epsilon}^s - \mathbf{S}^+_t \tag{10}$$
联合目标由两项构成,骨架项带权重 $\lambda_s$:
$$\mathcal{L}_{\mathrm{action}} = \mathbb{E}\left[\operatorname{MSE}\left(\hat{\mathbf{v}}^a_\theta, \mathbf{v}^a\right)\right], \quad \mathcal{L}_{\mathrm{skeleton}} = \mathbb{E}\left[\operatorname{MSE}\left(\hat{\mathbf{v}}^s_\theta, \mathbf{v}^s\right)\right] \tag{11}$$
$$\mathcal{L} = \mathcal{L}_{\mathrm{action}} + \lambda_s \mathcal{L}_{\mathrm{skeleton}}$$
这里有一个结构性的关键点:两项损失都更新世界专家。骨架损失监督未来几何预测,动作损失则经由当前骨架这一路径回传。也就是说,未来骨架预测不是一个并行的辅助头,而是塑造了动作专家所依赖的那份共享表示——这解释了为什么消融掉它会掉 5.8 个点(见 4.4)。
3.4 推理与 Medoid Action Consensus
推理时保留当前骨架处理与动作专家,砍掉未来骨架 token。从纯高斯噪声出发积分学到的动作向量场:
$$\frac{\mathrm{d}\widetilde{\mathbf{A}}_{t,\tau}}{\mathrm{d}\tau} = \hat{\mathbf{v}}^a_\theta\left(\widetilde{\mathbf{A}}_{t,\tau}, \tau; \mathbf{S}_t, \ell\right), \qquad \tau: 1 \rightarrow 0 \tag{12}$$
积分结果就是采样得到的动作块 $\mathbf{A}_t = \widetilde{\mathbf{A}}_{t,0}$。
由于是随机采样,论文提出 Medoid Action Consensus (MAC) 作为从多个候选里挑选的轻量策略。给定 $K \ge 2$ 个从独立噪声初始化生成的候选,在前 $h \le H_a$ 步、$d_m$ 个连续运动维度上算候选间的差异:
$$d_{ij} = \frac{1}{h d_m} \left\|\left(\mathbf{A}^{(i)}_t\right)_{1:h,1:d_m} - \left(\mathbf{A}^{(j)}_t\right)_{1:h,1:d_m}\right\|_F^2 \tag{13}$$
MAC 选平均差异最小的那个候选——也就是轨迹集合里的 medoid(中心点):
$$c_i = \frac{1}{K-1}\sum_{j \neq i} d_{ij}, \qquad i_{\mathrm{sel}} = \arg\min_i c_i, \qquad \mathbf{A}^{\mathrm{MAC}}_t = \mathbf{A}^{(i_{\mathrm{sel}})}_t \tag{14}$$
MAC 的好处很实在:既不需要奖励模型也不需要价值模型,而且避免了平均掉可能互不兼容的轨迹——这一点对操作任务尤其重要,两条都合理的轨迹平均起来往往是第三条不合理的。注意被选中的是完整动作块,包括未参与距离计算的维度。执行时取前 $H_e \le H_a$ 个动作,用最新观测更新骨架,然后重规划。$H_e$ 控制重规划频率,$h$ 只用于候选选择。
flowchart TD
    I[RGB-D 观测 o_t + 本体感知 q_t] --> P[冻结感知网络
估计物体中心与交互点]
    J[正运动学
机器人关节与末端位置] --> S[当前稀疏骨架 S_t]
    P --> S
    L[语言指令] --> E[编码为 C^l]
    S --> M[Mixture-of-Transformers
世界专家 + 动作专家]
    E --> M
    N[高斯噪声] --> M
    M --> A[K 个动作块候选]
    A --> MAC[MAC: 选 medoid
Eq.13-14]
    MAC --> EX[执行前 H_e 步]
    EX --> I
    M -.训练时.-> FS[未来骨架预测
辅助监督 Eq.11]
五、实验结果
5.1 设置
评测用完整的 LIBERO-Plus 基准,包含 10,030 个变体、七个扰动类别。报告的是零样本任务成功率——不在评测变体上微调。训练与评测都在单张 NVIDIA RTX 4090 上完成,训练 60K 步、有效批量 48,联合预测 $H_a = 32$ 个动作步与 8 个未来骨架状态。推理时用 10 步流积分、执行 $H_e = 16$ 个动作后重规划,MAC 采样 $K=3$ 个候选、在前 $h=10$ 个运动步上算共识,未来骨架预测完全省略。
基线覆盖两类:VLA 策略(OpenVLA、OpenVLA-OFT、NORA、UniVLA、$\pi_0$、$\pi_0$-Fast、$\pi_{0.5}$)与含世界建模/未来状态预测的方法(WorldVLA、Fast-WAM、VLA-JEPA、GE-Act、Cosmos-Policy)。另设 SkeleWAM (sim-state) 作为特权输入参照——它直接从仿真器状态取物体坐标,绕过视觉物体定位。
5.2 仿真主结果
| 方法 | 参数量 | 相机 | 机器人初始状态 | 语言 | 光照 | 背景 | 噪声 | 布局 | 总体 |
|---|---|---|---|---|---|---|---|---|---|
| OpenVLA | ≈7.5B | 0.8 | 3.5 | 23.0 | 8.1 | 34.8 | 15.2 | 28.5 | 15.6 |
| OpenVLA-OFT | ≈7.7B | 56.4 | 31.9 | 79.5 | 88.7 | 93.3 | 75.8 | 74.2 | 69.6 |
| NORA | ≈3.8B | 2.2 | 37.0 | 65.1 | 45.7 | 58.6 | 12.8 | 62.1 | 39.0 |
| UniVLA | ≈7B | 1.8 | 46.2 | 69.6 | 69.0 | 81.0 | 21.2 | 31.9 | 43.9 |
| $\pi_0$ | ≈3.5B | 13.8 | 6.0 | 58.8 | 85.0 | 81.4 | 79.0 | 68.9 | 53.6 |
| $\pi_0$-Fast | ≈3B | 65.1 | 21.6 | 61.0 | 73.2 | 73.2 | 74.4 | 68.8 | 61.6 |
| $\pi_{0.5}$ | ≈3.6B | 70.6 | 50.5 | 84.4 | 95.7 | 93.4 | 87.4 | 84.1 | 79.7 |
| WorldVLA | ≈7B | 0.1 | 27.9 | 41.6 | 43.7 | 17.1 | 10.9 | 38.0 | 25.0 |
| Fast-WAM | ≈6.7B | 16.4 | 44.5 | 68.9 | 78.2 | 53.7 | 37.7 | 60.7 | 51.5 |
| VLA-JEPA | ≈2.3B | 64.2 | 67.7 | 88.1 | 91.8 | 93.4 | 65.8 | 83.9 | 77.9 |
| GE-Act | ≈2.5B | 60.7 | 77.0 | 77.4 | 95.8 | 86.0 | 90.9 | 80.2 | 80.3 |
| Cosmos-Policy | ≈2B | 75.8 | 63.3 | 81.7 | 96.5 | 88.9 | 92.7 | 82.2 | 82.2 |
| SkeleWAM (ours) | ≈57.1M | 93.4 | 71.9 | 89.1 | 96.0 | 93.9 | 66.6 | 85.9 | |
| SkeleWAM (sim-state) § | ≈51.4M | 96.1 | 75.2 | 89.0 | 96.6 | 96.7 | 69.0 | 87.7 | 87.7 |
表1:LIBERO-Plus 零样本任务成功率(%),每任务 20 次试验。§ 表示特权仿真器输入。
参数量上的对比才是这张表最刺眼的地方:SkeleWAM 用 57.1M 参数拿到 85.9% 的总体成功率,而最强的观测式基线 Cosmos-Policy 用 ≈2B 参数拿到 82.2%——参数少约 35 倍,成功率高 3.7 个百分点。这一点直接支撑了论文的核心主张:把未来状态表示成稀疏几何,而不是视觉 latent,可以让模型复杂度大幅下降。
分项看,优势集中在「几何无关」的扰动上。相机扰动 93.4%,比 Cosmos-Policy 高 17.6 个百分点;语言 89.1%、光照 96.0%、背景 93.9% 都是观测式最好。论文的解读是:把机器人与物体状态放在共享的机器人中心坐标系里表示,等于把视角与外观变化从状态里消掉了,因此这类扰动几乎不影响策略。
唯一的短板是布局扰动:66.6%,明显低于 $\pi_{0.5}$ 的 84.1%。论文对此很诚实:稀疏几何观测本身不足以覆盖显著不同的空间排布。而 sim-state 版本(直接读仿真器坐标、绕过视觉定位)也只有 69.0%——这说明难点不只是视觉定位,而是策略本身对全新空间配置泛化不足。这一条把问题从「感知」推到了「泛化」,是全文最重要的自我限定。
sim-state 与 RGB-D 的总体差距只有 1.8 个百分点(87.7 对 85.9),相机与机器人初始状态扰动分别高 2.7 与 3.3 点,而语言表现基本持平(89.0 对 89.1)。论文据此说:冻结感知网络提供的骨架估计已经足够好,同时还有改进空间。
5.3 真机实验
真机平台是 ARX R5 机器人,配外部与腕部两台 RealSense 相机,工作空间含抽屉柜、方块与碗。每个方法在五个任务上各 20 次试验。
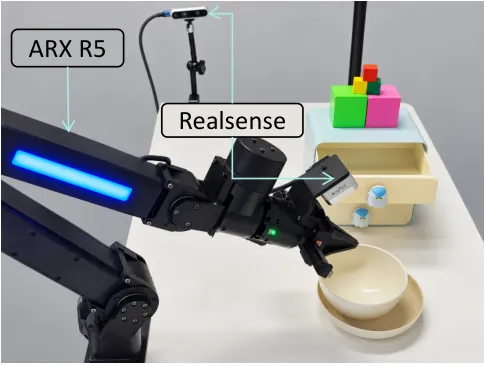
图4:真机实验设置。ARX R5 机器人配外部与腕部 RealSense 相机,在含抽屉柜、方块与碗的桌面工作空间内操作。
| 方法 | 开抽屉 | 关抽屉 | 叠方块 | 叠碗 | 方块入抽屉 | 平均 ↑ |
|---|---|---|---|---|---|---|
| Fast-WAM | 80 | 85 | 80 | 85 | 85 | 83 |
| $\pi_{0.5}$ | 80 | 80 | 70 | 75 | 75 | 76 |
| Cosmos-Policy | 85 | 85 | 90 | 90 | 85 | 87 |
| SkeleWAM (ours) | 80 | 90 | 90 | 95 | 90 | 89 |
表2:五个真机操作任务的成功率(%),每任务 20 次试验;平均数为跨任务非加权均值。
真机上 89% 的平均成功率,超过 Cosmos-Policy、Fast-WAM、$\pi_{0.5}$ 分别 2、6、13 个百分点,并在五个任务中的四个上取得最好或并列最好。值得注意的是开抽屉任务上 80% 低于所有基线——这也是唯一一个骨架表示可能不占便宜的任务类型,后面 4.4 的消融正好指向这一点。
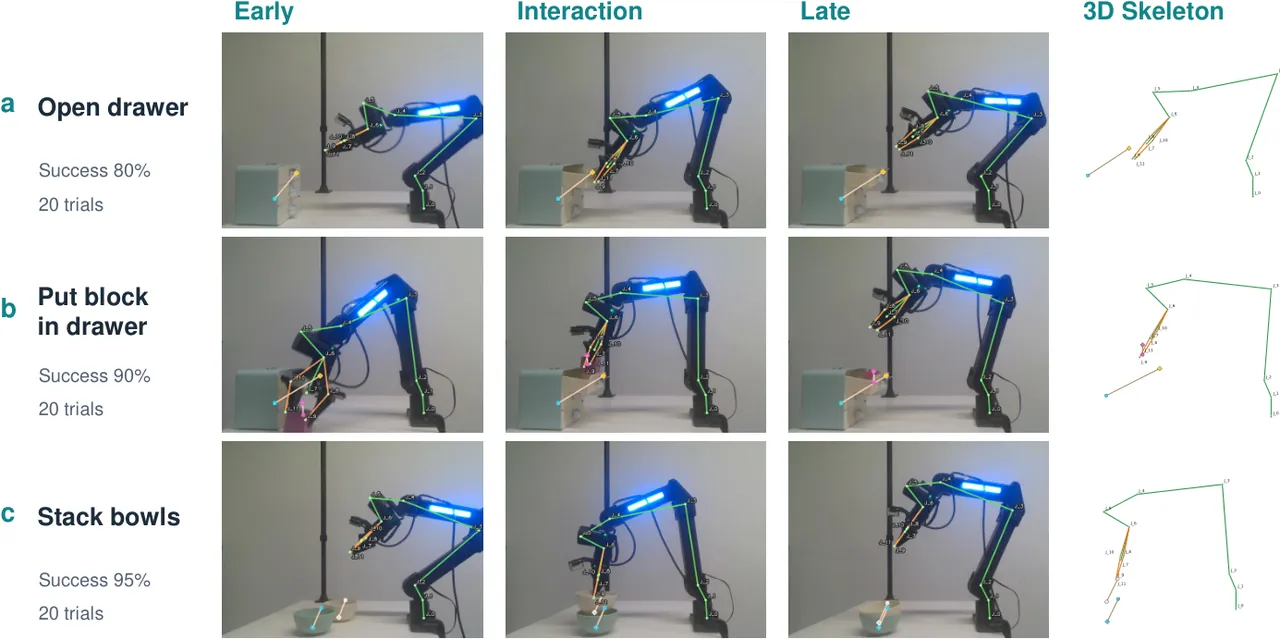
图3:真机定性结果。每一行展示开抽屉、方块入抽屉、叠碗三个任务中一次成功 rollout 的早期、交互与后期阶段,以及对应的稀疏三维骨架。
5.4 消融
论文消融了六个设计选择,训练数据、优化设置与评测变体全部固定,默认 $H_a=32$、$H_e=16$、$K=3$、$h=10$。
| 配置 | 成功率 (%) |
|---|---|
| (a) 物体骨架组成 | |
| 仅中心 | 82.3 |
| 仅交互点 | 77.7 |
| 中心 + 交互点(默认) | 85.9 |
| (b) 训练目标 | |
| 仅动作 | 80.1 |
| 动作 + 未来骨架(默认) | 85.9 |
| (c) 跨分支注意力 | |
| 无跨分支注意力(默认) | 85.9 |
| 未来骨架 → 动作 | 85.6 |
| 动作 → 未来骨架 | 84.8 |
| (d) 动作执行 horizon | |
| 5 步 | 80.7 |
| 16 步(默认) | 85.9 |
| 32 步 | 81.8 |
| (e) MAC 候选数 $K$ | |
| 1(无 MAC) | 84.2 |
| 3(默认) | 85.9 |
| 5 | 85.2 |
| 10 | 84.1 |
| (f) 共识窗口 $h$ | |
| 3 | 85.3 |
| 5 | 85.4 |
| 10(默认) | 85.9 |
| 16 | 85.7 |
表3 / 表4:模型侧与推理侧消融,均在 LIBERO-Plus 完整基准的 RGB-D 设置下进行。
三条值得单独读的结论。
物体的「中心 + 交互点」缺一不可。仅中心 82.3、仅交互点 77.7、两者结合 85.9。这说明二者承载的是互补信息:中心提供稳定的空间参考,交互点描述与操作相关的区域。只给交互点掉得最多(-8.2),说明没有稳定空间参考时,交互点本身难以定位。
未来骨架预测的贡献是真实的 5.8 个点(85.9 对 80.1)。由于两变体使用相同的仅动作推理流程,这 5.8 点完全来自训练期的辅助监督。论文的解读是:预测未来几何状态迫使共享的世界专家学到对动作生成有用的表示。而消融 (c) 更进一步——跨分支注意力带来的差异只有 0.3 点量级(85.9 / 85.6 / 84.8),远小于去掉辅助监督的跌幅。这两条合起来说明:收益来自「共享世界专家上的联合训练」,而不是两个预测分支之间的直接信息交换。这也带来一个实用好处:不需要跨分支注意力,推理时就可以把未来骨架分支整个移除。
MAC 是有收益的,但不是「越多越好」。$K=1$(无 MAC)84.2,$K=3$ 达到 85.9,但 $K=5$ 回落到 85.2、$K=10$ 掉到 84.1——性能并不随采样预算单调上升。共识窗口 $h$ 从 3 到 16 的波动只有 0.6 点(85.3 / 85.4 / 85.9 / 85.7),相当稳健。论文的解释也合理:候选越多,medoid 越可能落在「谁都不特别优」的中间轨迹上。
六、局限性
作者自述的第一条,也是全文最重要的一条:在大规模布局变化下仍然存在性能差距,说明稀疏几何本身不足以完全捕捉空间泛化所需的变化。论文把后续方向列为不确定性感知(uncertainty-aware)的感知、自适应的交互路标(adaptive interaction landmarks)、以及更丰富的关系结构,同时保持骨架表示的紧凑性。
作者自述的第二条:物体路标由冻结的预训练感知网络估计。这带来一个诚实的数字——sim-state 特权输入只比 RGB-D 高 1.8 点(87.7 对 85.9),说明冻结感知已经够用,但 sim-state 在相机与机器人初始状态扰动上仍分别高 2.7 与 3.3 点,感知误差确实存在、只是不是当前的主要瓶颈。
我的第三条判断:整条链路对「物体是可被一组固定交互点描述的」这个假设依赖很重。$L_m$ 个交互点是离线定义好的,拓扑(谁连谁)也是固定的。论文把「自适应交互路标」列为未来工作,正说明当前版本无法处理未曾见过的接触模式——比如需要抓住一个此前没标过交互点的把手边缘,或用不同部位施力。此外骨架只在当前观测上构造,不携带历史,因此像「抽屉已经拉开过」这类状态必须靠重规划隐式维持;论文也没有报告长时程任务下的误差累积。
第四条关于证据强度:真机实验只有五个任务、每任务 20 次试验,表格里所有数字都是 5 的倍数——这意味着单次试验就是一个百分点,89 对 87 的差距只有两次试验之差。论文诚实地报告了这一点(每任务 20 次、取非加权均值),但读者应把真机部分的 2 点领先当作方向性证据,而不是有统计显著性的结论。仿真部分的 10,030 变体则要扎实得多。
七、总结与展望
SkeleWAM 的贡献可以概括为一句话:世界动作模型的状态空间不必是视频或视觉 latent,一个稀疏的机器人-物体三维骨架就够了,而且便宜两个数量级。具体而言,它用关节、物体中心与交互点三类路标替代稠密视觉表征,让 57.1M 参数的模型在 LIBERO-Plus 上超过 2B 参数的 Cosmos-Policy,并在真机上以 89% 平均成功率领先三个基线。
组成消融还有一层论文没有明说的工程含义值得点出:交互点是离线定义的,因此必须有人去标注,而移除它们要掉 8.2 个点,说明这份标注不是可选的记录工作。这笔账是否划算取决于场景:如果物体种类固定、在上千次试验里反复使用,一次性标注交互点很便宜,却能换来论文里最大的单项消融收益;如果部署场景每个会话都出现新物体,这份前期成本就落在每个新物体上,而冻结感知网络还必须预测它从未被训练过的交互点。这大概也是「开抽屉」这个真机任务——抓取目标是把手而不是物体中心——成为骨架表示唯一没能超过所有基线的那一项的第二层原因。
更有意思的是两个「负结果」。第一,跨分支注意力几乎没用(0.3 点量级),真正有用的是在共享世界专家上做联合训练——这意味着更简单的架构(推理时直接砍掉一个分支)就够用。第二,MAC 候选数增加到 10 反而更差,说明随机采样轨迹的「中心」并不总比单条轨迹更好,这在直觉上并不显然。
它留下的开放问题也很清楚:布局扰动 66.6% 是全文最扎眼的数字,而且 sim-state 也只有 69.0%——这不是感知问题,是策略对全新空间配置的泛化问题。骨架表示把「状态里有什么」这个问题解决了,但没解决「策略如何在陌生布局里规划」。论文列出的三个方向——不确定性感知、自适应交互路标、更丰富的关系结构——都指向同一件事:骨架需要从「人工定义的固定拓扑」变成「能反映任务需求的可学习结构」。
金句
世界动作模型缺的不是状态表示,而是把几何从外观里剥出来的那一步。