PAPER DEEP DIVE
高效世界动作模型:1B 参数下的低成本未来想象
1B 参数世界动作模型,以紧凑视频专家、低分辨率未来潜变量与非对称去噪压低未来想象成本,真机每块 98 ms,成功率与 Motus 相当。
一句话总结
本文提出 Efficient-WAM:把世界动作模型的视频分支沿模型规模、未来 token 数、去噪步数三个维度同时压缩——从 WAN-2.2-5B 结构化切片并蒸馏出 0.8B 紧凑视频专家、把未来帧降到 192×160 使 token 数减为四分之一、再以训练免调的非对称去噪让视频只在前两次迭代更新——1B 参数模型在真机上以每动作块 98 ms 运行,成功率与 8B 的 Motus 相当。
一、研究背景与动机
世界动作模型(World-Action Models, WAMs)把未来视觉预测与动作生成显式耦合:给定当前观测 $o$、语言指令 $l$ 与机器人状态 $s$,模型同时预测未来视觉潜变量 $\mathbf{z}^{v}$ 与动作块 $a_{1:H}$。由于预测"场景将如何演化"迫使策略内化物理动力学与世界先验,WAM 被视为机器人学习中一条有吸引力的路线。
但这条路线的代价集中在视频分支。多数 WAM 直接继承视频生成器的重设计:大主干、稠密视觉 token、迭代去噪。以 Motus 为例,其在 RTX 4090 上每个动作块的推理时延为 3215 ms(Table 2),而一个 16 步动作块往往只对应机器人几百毫秒的执行时间——高保真未来预测把控制回路拖到远低于实时的速度,真机部署因此困难。
已有证据表明控制对视频保真度的容忍度高于直觉。VPP 显示即使把视频去噪压缩到单步,动作生成依然有效;Fast-WAM 进一步证明推理期完全跳过显式未来生成,WAM 仍可保持竞争力。两者共同指向一个事实:视频分支的计算量存在可观的下调空间,而下调之后"指引动作"的功能未必随之消失。
本文据此提出问题:一个精简的视频分支,能否在视觉保真度明显降低的情况下仍为动作生成提供有效指引?为把问题变成可工程化的设计,作者把视频侧推理成本写成三个可控因子的函数——活跃视频模型规模 $\mathcal{M}_{v}$、未来分辨率决定的 token 数 $N_{\text{tok}}^{v}(r_{v})$、视频去噪预算 $K_{v}$——并针对每个因子给出一个机制:紧凑视频专家、低分辨率未来潜变量、非对称视频-动作去噪。
与已有效率工作的分工也由此清晰:early-exit 与动态跳层主要削减策略主干的计算,扩散策略蒸馏与单步去噪主要加速动作采样;它们都不触及 WAM 特有的视频想象瓶颈。本文的贡献则是把这个瓶颈单独隔离出来,用消融实验逐一度量三个因子的收益,再用真机部署验证三者组合后的系统级效果。
二、预备知识
条件流匹配。两个分支均以条件流匹配训练:记干净目标(未来潜变量或动作)为 $\mathbf{x}_{0}$,噪声为 $\mathbf{x}_{1}\sim\mathcal{N}(0,I)$,插值路径为 $\mathbf{x}_{t}=(1-t)\mathbf{x}_{0}+t\mathbf{x}_{1}$,目标速度场为 $\mathbf{u}_{t}=\mathbf{x}_{1}-\mathbf{x}_{0}$;模型学习预测速度并以均方误差回归,采样从 $t=1$ 积分到 $t=0$。联合训练时视频与动作的噪声水平独立采样,这正是后文"非对称去噪"可以只改推理调度而不改训练的前提。
Mixture-of-Transformers。本文骨架是 MoT:视频流与动作流各自持有投影与 FFN 参数,配对层把两流的 $Q,K,V$ 沿 token 维拼接后做双向、无掩码的联合注意力,输出再切回各自流。于是当前观测 token、未来视频 token 与状态/动作 token 在同一注意力中互相可见,而参数量仍按流分离。
教师模型与视觉表示。视频教师为 WAN-2.2-5B(30 层 Transformer)。观测与未来帧经其配套 VAE 编码为潜变量后再 patchify 成 token;动作块长度 $H=16$,闭环执行。
三、方法详解
3.1 联合目标与视频侧成本分解
WAM 的联合预测目标写作 $p(\mathbf{z}^{v},a_{1:H}\mid o,l,s)$。实现上是两个耦合的流匹配专家:给定带噪未来潜变量 $\mathbf{z}^{v}_{t_{v}}$ 与带噪动作 $a^{t_{a}}_{1:H}$,模型同时预测两个速度场
$$(\hat{\mathbf{u}}^{v},\hat{\mathbf{u}}^{a})=F_{\phi,\theta}\!\left(\mathbf{z}^{v}_{t_{v}},\,a_{1:H}^{t_{a}},\,t_{v},\,t_{a};\,o,l,s\right)\qquad(1)$$
其中 $\phi,\theta$ 分别参数化视频与动作专家,$t_{v},t_{a}$ 为各自噪声水平。由于联合注意力是双向的,机器人状态与带噪动作会进入视频预测,未来视频表示也会进入动作生成——两个方向的信息流都是设计的一部分,而非副产品。
为把"效率"变成可操作的量,作者定义视频侧成本函数
$$\mathcal{C}_{\text{video}}=\mathcal{F}_{\text{video}}\!\left(\mathcal{M}_{v},\,N_{\text{tok}}^{v}(r_{v}),\,K_{v}\right)\qquad(2)$$
即成本由活跃视频模型规模、未来分辨率决定的 token 数、视频去噪步数三者决定。式 (2) 本身不做近似,它的作用是把后文三个机制各自锚定到一个因子上,使消融实验能够逐因子归因。
3.2 紧凑视频专家:结构化切片加蒸馏
深度压缩从 30 层降到 12 层,切片位置不是均匀抽样,而是由蒸馏锚点反推。隐状态锚点取教师第 1,4,8,14,20,30 层,覆盖浅层到深层的表征;运动锚点取第 11,17,23,30 层,把时序特征的监督集中在中后层。两个锚点集合共含 9 个不同层,再补入第 2,6,26 层填补间隔,得到 12 层切片。这样安排的直接好处是:每个蒸馏锚点都存在一个由教师对应层初始化的学生层,蒸馏的对齐关系在初始化时就已建立。
宽度压缩采用等间隔选择注意力头与 FFN 通道,并保留被选头的完整维度(head_dim 不变);实现上拷贝教师权重矩阵的对应行与列,偏置与归一化参数取匹配切片。学生视频专家为 hidden 2048、FFN 8192、16 头、head_dim 128,共 0.8B 参数。仓库配置 configs/robotwin/stage1_video_distill.yaml 把这条切片路线写成了显式映射:
# configs/robotwin/stage1_video_distill.yaml(节选)
dim: 2048
ffn_dim: 8192
num_heads: 16
num_layers: 12
head_dim: 128
teacher_layer_mapping: [1, 2, 4, 6, 8, 11, 14, 17, 20, 23, 26, 30]
distill:
  projection_dim: 256
  hidden_teacher_layers: [1, 4, 8, 14, 20, 30]
  motion_teacher_layers: [11, 17, 23, 30]
  lambda_hidden_schedule: [0.2, 0.1, 0.0]
  lambda_motion_schedule: [0.2, 0.1, 0.0]
  schedule_boundaries: [0.35, 0.75, 1.0]
其中 teacher_layer_mapping 即学生 12 层到教师 30 层的逐层对应,与论文 §3.2 的锚点叙述完全一致;lambda_hidden_schedule 与 schedule_boundaries 则对应 §3.5 中 $\lambda_{d}$ 从 0.2 退到 0.1 再退到 0 的三段调度。
紧凑视频专家与一个 hidden 768 的 12 层动作专家配对成 MoT。语言指令经 cross-attention 注入视频流;机器人状态被嵌入为动作流的第一个 token,其后拼接带噪动作。联合更新时,配对层把两流投影到匹配的 $Q,K,V$ 维度、沿 token 维拼接并做双向无掩码注意力,输出按流切回,各自使用独立的投影与 FFN。两专家合计约 1B 参数。
3.3 多尺度潜变量:当前观测高清、未来想象低清
稠密视频 token 的第二来源是未来帧的分辨率。本文的多尺度布局规定:每个动作块只使用最新观测,不跨块携带视觉记忆;当前观测在所有实验中都编码为 384×320。Efficient-WAM(结构基线)的未来帧同为 384×320;部署变体 Efficient-WAM-RT 在 VAE 编码前把目标未来帧下采样到 192×160,固定预测 horizon 下未来 token 数从 240 降到 60,即四分之一。
实现细节上,当前与未来潜变量分别 patchify 后拼接,位置编码按各自的网格生成(代码中为 condition 与 future 两套网格分别施加 RoPE),避免低分辨率未来借用高分辨率网格造成的坐标错配。推理时当前潜变量是固定输入条件,未来潜变量从噪声初始化,联合注意力在这一多尺度序列上运行。该布局只削减未来 token 与注意力成本,不牺牲当前观测的输入分辨率——感知入口保持高清,被压缩的只是"想象"。
3.4 非对称视频-动作去噪:视频只更新两次
对称的联合去噪在每一步采样都同时前向两个专家,而视频分支占其中大部分计算。本文的分配方案是训练免调的:视频预算 $T_{v}=2$、动作预算 $T_{a}=5$ 或 $10$,两次联合更新放在前两个动作迭代;视频调度用两步跨越完整的噪声到数据区间。每次联合前向都会缓存该步在每一 MoT 层产生的视频键与值;第二次联合更新之后只剩动作流前向——动作查询 attend 到缓存的视频 K/V 与当前动作 K/V,不再有任何视频前向。
缓存语义有三条:缓存的是去噪器中间特征而非最终预测;每次联合更新时刷新;每个新动作块重置。仓库 inference/robotwin/EfficientWAM/models/small_wam.py 把这三条落实为显式数据结构:
# inference/robotwin/EfficientWAM/models/small_wam.py(节选)
video_k = attn.norm_k(attn.k(norm_video)).view(batch, seq_len, heads, head_dim)
video_v = attn.v(norm_video).view(batch, seq_len, heads, head_dim)
video_k = self.compact_wan.apply_multiscale_rope(video_k, grid_sizes, freqs)
return video_k.detach(), video_v.detach()   # 缓存与当前计算图脱钩

def _empty_video_cache(self, seq_lens, grid_sizes, freqs):
    return {"video_k": [], "video_v": [], ...}   # 每个动作块重置
detach() 保证缓存不参与反传,_empty_video_cache 保证块间不泄漏;多尺度 RoPE 在入缓存前施加,使后续动作步 attend 到的键与联合步处于同一坐标系。真机推理模板 inference/real/runner.py 把同一调度暴露为配置项 video_refresh_steps,默认 [0, 1],即论文选定的"前两次迭代":
# inference/real/runner.py(节选)
video_refresh_steps=tuple(
    int(step) for step in infer_cfg.get("video_refresh_steps", [0, 1]))
3.5 三阶段训练目标
两个分支共用条件流匹配损失
$$\mathcal{L}_{\text{FM}}=\mathbb{E}\left[\operatorname{MSE}(\hat{\mathbf{u}},\mathbf{u}_{t})\right]\qquad(3)$$
期望覆盖数据、噪声与噪声水平,$\hat{\mathbf{u}}$ 即式 (1) 的预测速度。
阶段一:视频蒸馏。教师冻结,与学生共享带噪视频输入、噪声水平与条件。教师特征先 LayerNorm 再经固定 PCA 投影到 256 维;学生为每个锚点、每个损失单独学习 LayerNorm-线性投影。记投影后的学生与教师特征为 $\tilde{h}_{S,n}^{\ell}$ 与 $\tilde{h}_{T,n}^{\tau(\ell)}$($\tau$ 为学生层到教师层的映射),以余弦距离 $d(x,y)=1-\cos(x,y)$ 定义隐状态对齐损失;运动对齐则先把运动投影 token 在每个潜帧内做空间平均得 $m_{f}$,再取相邻帧差 $\Delta m_{f}=m_{f+1}-m_{f}$:
$$\mathcal{L}_{\text{hid}}=\mathbb{E}_{\ell\in\mathcal{A}_{h},n}\,d\!\left(\tilde{h}_{S,n}^{\ell},\,\tilde{h}_{T,n}^{\tau(\ell)}\right),\quad \mathcal{L}_{\text{mot}}=\mathbb{E}_{\ell\in\mathcal{A}_{m},f}\,d\!\left(\Delta m_{S,f}^{\ell},\,\Delta m_{T,f}^{\tau(\ell)}\right)\qquad(4)$$
阶段一总目标为
$$\mathcal{L}_{\text{stage-1}}=\mathcal{L}_{\text{video-FM}}+\lambda_{d}\left(\mathcal{L}_{\text{hid}}+\mathcal{L}_{\text{mot}}\right)\qquad(5)$$
视频流匹配系数恒为 1,$\lambda_{d}$ 按 0.2、0.1、0 三段退火;所有损失的期望都带各自损失专属的、按噪声加权的批权重(配置中的 sigma_aware 采样器)。教师与蒸馏投影器仅在阶段一使用。
阶段二:动作训练。挂上动作专家,优化 $\mathcal{L}_{\text{joint}}=\mathcal{L}_{\text{action-FM}}+0.01\,\mathcal{L}_{\text{video-FM}}$,视频参数冻结。值得注意的机制是:双向联合注意力使视频查询 attend 到动作的 K/V,因此视频损失可以穿过冻结的视频算子反传到动作专家——$\Delta\phi=0$ 但 $\nabla_{\theta}\mathcal{L}_{\text{video-FM}}\neq 0$。这给了动作专家一条"让未来更好预测"的梯度通道,而不需要解冻视频主干。
阶段三:联合微调。解冻视频 Transformer,与动作专家在同一 $\mathcal{L}_{\text{joint}}$ 下继续训练。三阶段统一使用 AdamW(weight decay $10^{-3}$)、全局 batch 128(16×8)、余弦学习率衰减与 bf16;阶段一、二学习率 $5\times10^{-5}$,阶段三视频 $10^{-5}$、动作 $5\times10^{-5}$。
flowchart TB
    subgraph ST1["Stage 1 视频蒸馏 教师冻结"]
        TEA["WAN-2.2-5B 教师 30 层"] --> SLI["结构化切片 12 层 0.8B 学生"]
        SLI --> HID["L_hid 匹配 token 隐状态余弦对齐"]
        SLI --> MOT["L_mot 相邻帧运动增量余弦对齐"]
    end
    subgraph ST2["Stage 2 动作训练 视频冻结"]
        HID --> JOA["双向联合注意力"]
        MOT --> JOA
        JOA --> ACT["动作专家 0.2B 经视频损失获得梯度"]
    end
    subgraph ST3["Stage 3 联合微调"]
        ACT --> UNF["解冻视频专家 同目标继续训练"]
    end
    subgraph INFER["推理 非对称去噪 Tv=2 Ta=10"]
        UNF --> S01["动作迭代 1 与 2 双专家联合前向 缓存每层视频 K/V"]
        S01 --> S03["动作迭代 3 至 10 仅动作前向 查询缓存视频 K/V"]
        S03 --> OUT["输出 16 步动作块 98 ms per chunk"]
    end
四、实验结果
4.1 设置
仿真在 RoboTwin 2.0 的 50 个双臂操作任务上进行,分 clean 与 randomized 两种视觉设置;两个变体均训练于 2,500 条 clean 与 25,000 条 randomized 演示,每任务每设置评测 100 次。Efficient-WAM 为结构基线(当前与未来均 384×320、视频与动作各 10 步去噪),用于隔离紧凑架构本身;Efficient-WAM-RT 启用全部三个效率机制(未来 192×160、2 与 10 步)。时延口径统一:排除首个 warm-up 调用,从图像与状态预处理之后计到动作反归一化结束,包含当前观测 VAE 编码与全部视频-动作去噪,不含一次性 T5 编码(其嵌入已缓存)、预测视频的 VAE 解码与保存、CPU 传输、观测获取与机器人执行;仿真与消融用单张 A800,真机用单张 RTX 4090。
4.2 仿真主结果
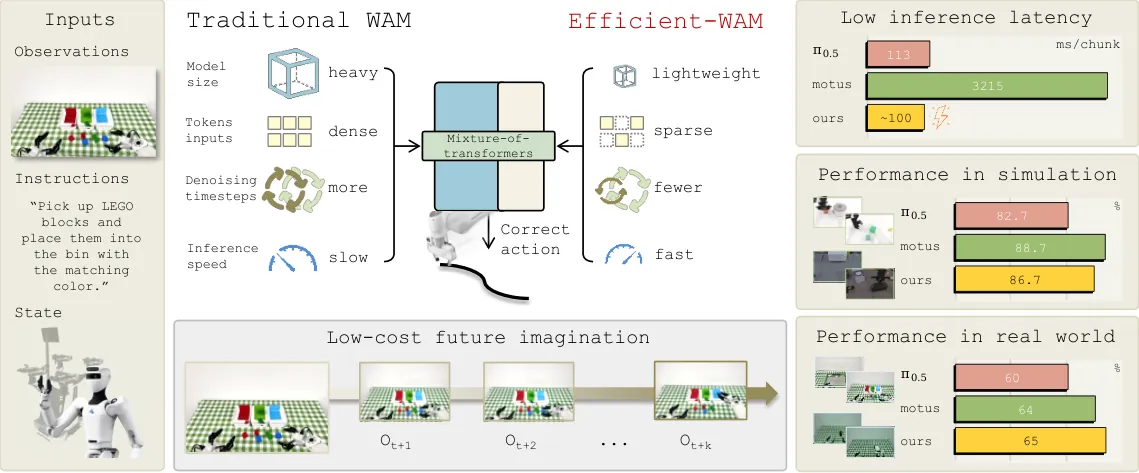
图 1(论文 Figure 1):Efficient-WAM 总览。右侧给出每动作块时延(π0.5 为 113 ms、Motus 为 3215 ms、本文约 100 ms)与仿真、真机成功率对照。
Table 1 中,1B 参数的 Efficient-WAM 取得 86.7% clean 与 85.7% randomized 成功率,与 4B 的 LingBot-VLA(86.5/85.3)和 5B 的 GigaWorld-Policy(86.4/85.0)同档,仅比 8B 的 Motus 低 2.0 个百分点;启用全部效率机制的 Efficient-WAM-RT 为 83.1/82.0,仍高于 π0(65.9/58.4)与 StarVLA-α(76.8/79.1)。Fast-WAM 报告了更高的 91.9/91.8,但其参数量约为本文六倍,且本文在推理期保留未来交互的同时跑得更快(§4.4 按本文协议复测原 Fast-WAM 为 381.6 ms/chunk,本文 139 ms)。这组数字说明压缩没有把控制性能压掉:在性能与参数之比上,本文处于 Table 1 中最靠前的档位。
| 方法 | Clean (%) | Random (%) | 参数量 |
|---|---|---|---|
| π0 | 65.9 | 58.4 | 3.3B |
| π0.5 | 82.7 | 76.8 | 3.3B |
| LingBot-VLA | 86.5 | 85.3 | 4B |
| UWM | 81.7 | 78.6 | 5B |
| GigaWorld-Policy | 86.4 | 85.0 | 5B |
| Motus | 88.7 | 87.0 | 8B |
| Fast-WAM | 91.9 | 91.8 | 6B |
| Efficient-WAM | 86.7 | 85.7 | 1B |
| Efficient-WAM-RT | 83.1 | 82.0 | 1B |
表 1(论文 Table 1 节选):RoboTwin 2.0 成功率;基线数字取自官方论文或技术报告。
4.3 真机实验
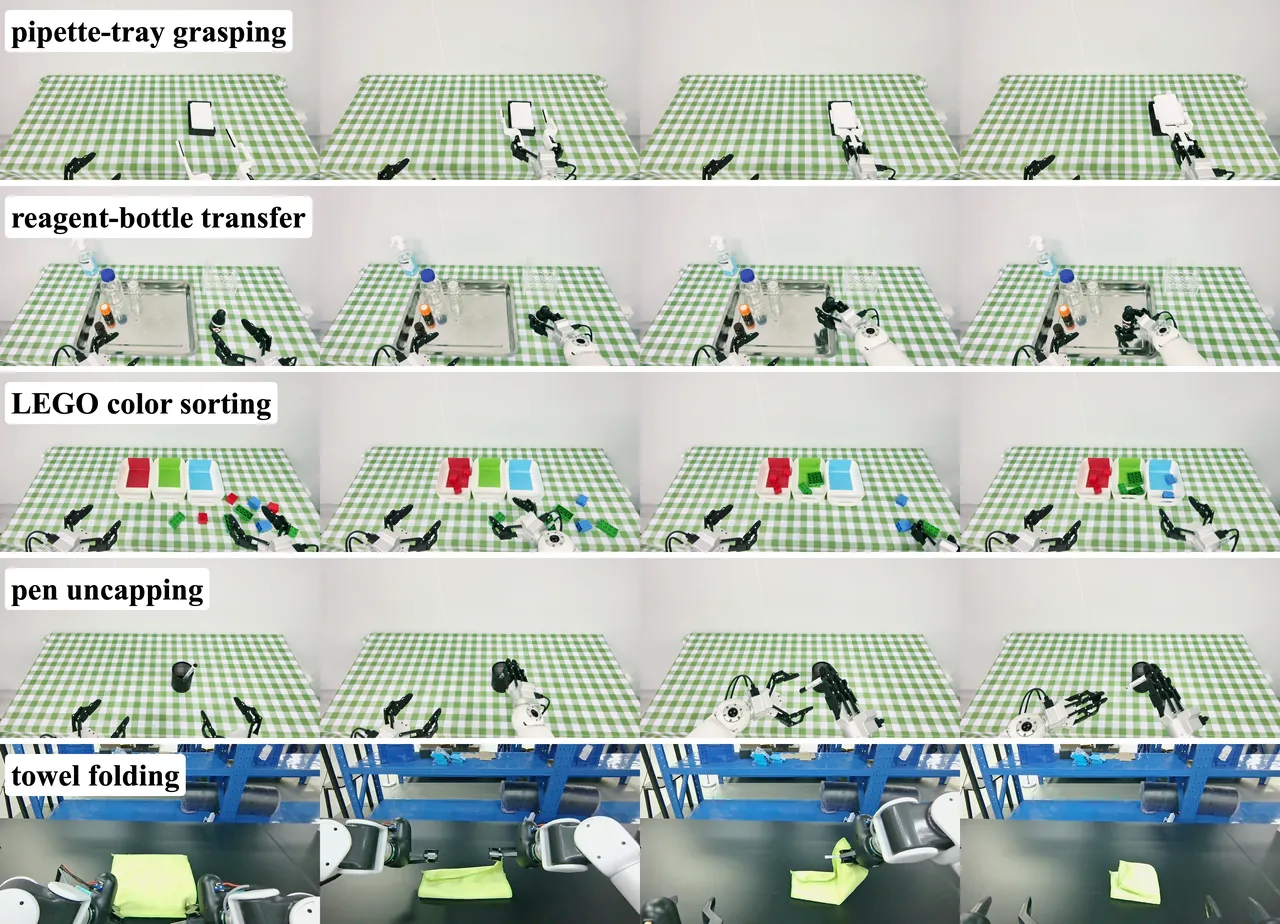
图 2(论文 Figure 3):五个真机任务,跨两个双臂平台;毛巾折叠的主相机视角仅用于可视化,不作为策略输入。
真机评测覆盖五个任务、两个平台(Figure 3 与 Figure 5):前四个任务在 Astribot S1 上完成,观测为头部与双腕共三路 RGB、状态为 31 维关节角;毛巾折叠在另一台双臂人形平台上完成,末端执行器为 Pika UMI,策略只观察两路鱼眼末端视图并使用 UMI 的相对位姿状态与动作表示。π0.5 从官方 base checkpoint 初始化、Motus 从 WAN-2.2-5B 初始化,两者均全参数监督微调;每个方法每任务一个独立策略,训练数据相同(Astribot 任务各 100 条演示、毛巾折叠 1,000 条 UMI 演示),每任务 20 次试验、单次上限 3 分钟。
结果上,Efficient-WAM-RT 五任务平均成功率 65.0%(100 次试验中 65 次成功),高于 Motus 的 64.0% 与 π0.5 的 60.0%;每动作块时延 98 ms,摊到 16 个动作即每动作 6.1 ms,而 Motus 为 3215 ms 与 200.9 ms——同一部署设置下快 30 倍以上。逐任务看,本文在笔帽拔除上三者最高(30%)、LEGO 颜色分拣与 Motus 持平(65%,π0.5 仅 30%),但在移液管托盘抓取上低于 π0.5(95% 对 100%)、毛巾折叠上三者最低(60%,π0.5 为 85%)。平均优势主要来自刚性物体任务,可变形任务仍是短板,这一点与后文的局限性分析互相印证。
| 真机任务 | π0.5 | Motus | 本文 |
|---|---|---|---|
| 移液管托盘抓取 | 100.0 | 85.0 | 95.0 |
| 试剂瓶转移 | 75.0 | 80.0 | 75.0 |
| LEGO 颜色分拣 | 30.0 | 65.0 | 65.0 |
| 笔帽拔除 | 10.0 | 25.0 | 30.0 |
| 毛巾折叠† | 85.0 | 65.0 | 60.0 |
| 平均成功率 (%) | 60.0 | 64.0 | 65.0 |
| 每块平均时延 (ms) | 113.0 | 3215.0 | 98.0 |
| 每动作摊算时延 (ms) | 7.1 | 200.9 | 6.1 |
表 2(论文 Table 2):真机评测。† 任务使用独立机器人平台与实验设置;时延在 RTX 4090 上按动作块计并摊算到 16 个动作。
4.4 消融:三个因子各自值多少
未来交互是否必要。作者构造 FastMask——把 Fast-WAM 的注意力掩码与推理方案移植到本文 MoT——作为"保留视频共训练但推理不生成未来"的对照(Table 3)。在 backbone、动作专家、训练数据、优化与评测协议完全一致的配对比较中,去掉未来交互使 Efficient-WAM 从 86.7/85.7 跌到 65.8/65.6(−20.9 与 −20.1 个百分点);全量 WAM-5B 在两种 batch 下也下降但幅度较小。同时作者按本文协议复测原 Fast-WAM,得 381.6 ms/chunk。结论有两层:在本文的 MoT 配置下未来交互是承重结构,Fast-WAM 的推理设计并非可插拔替换;而本文以 139 ms 的代价保留这份交互,比原 Fast-WAM 更快。
| 模型(batch) | 保留未来交互 | FastMask |
|---|---|---|
| WAM-5B (16×16) | 86.4 / 85.5 | 76.9 / 73.8 |
| WAM-5B (16×64) | 88.0 / 89.4 | 83.1 / 83.3 |
| Efficient-WAM (16×8) | 86.7 / 85.7 | 65.8 / 65.6 |
表 3(论文 Table 3):未来交互消融,clean 与 randomized 成功率。
紧凑专家与分辨率。Table 4a 给出视频专家从零训练的对照:随机初始化 69/68,结构化切片提升到 82/81,再加教师蒸馏到 87/86,接近全量 backbone 的 86.4/85.5,而每块时延从 2013 ms 降到 430 ms——切片与蒸馏各自贡献约 13 与 5 个百分点,说明预训练初始化与蒸馏在压缩后保住了世界先验。Table 4b 中未来 token 从 240 降到 126 再到 60,时延 430、396、377 ms,成功率 87/86、85/84、83/82:四分之一的 token 只换约 4 个百分点,是三个因子中性价比最高的一项。
| 视频专家变体 | 初始化 | 蒸馏 | Clean / Rand (%) | 时延 (ms/chunk, A800) |
|---|---|---|---|---|
| Full WAN (5B) | 教师全量 | — | 86.4 / 85.5 | 2013 |
| Compact 随机初始化 | 随机 | 否 | 69 / 68 | 432 |
| Compact 切片 | 结构化切片 | 否 | 82 / 81 | 426 |
| Efficient-WAM | 结构化切片 | 是 | 87 / 86 | 430 |
表 4(论文 Table 4a):紧凑视频专家的初始化与蒸馏消融;参数量仅计视频专家。
非对称去噪。Figure 4 扫描 $[T_{v},T_{a}]$ 配置:从 [10,10] 的 431 ms 与 87.1% 降到 [2,10] 的 139 ms 与 86.3%,时延 3.1 倍下降只付 0.8 个百分点;把两次视频更新改放到第 1 与第 8 次动作迭代([2,10] 星号变体)得 140 ms 与 86.2%,与默认的前两次几乎无差,故取前两次为默认调度。更激进的视频预算则明显伤性能:[1,10] 为 92 ms 与 79.3%,[2,2] 为 101 ms 与 84.1%。这条曲线是全文最有说服力的一张图:它把"视频更新次数"从架构常量变成可调旋钮,并标出了膝点。
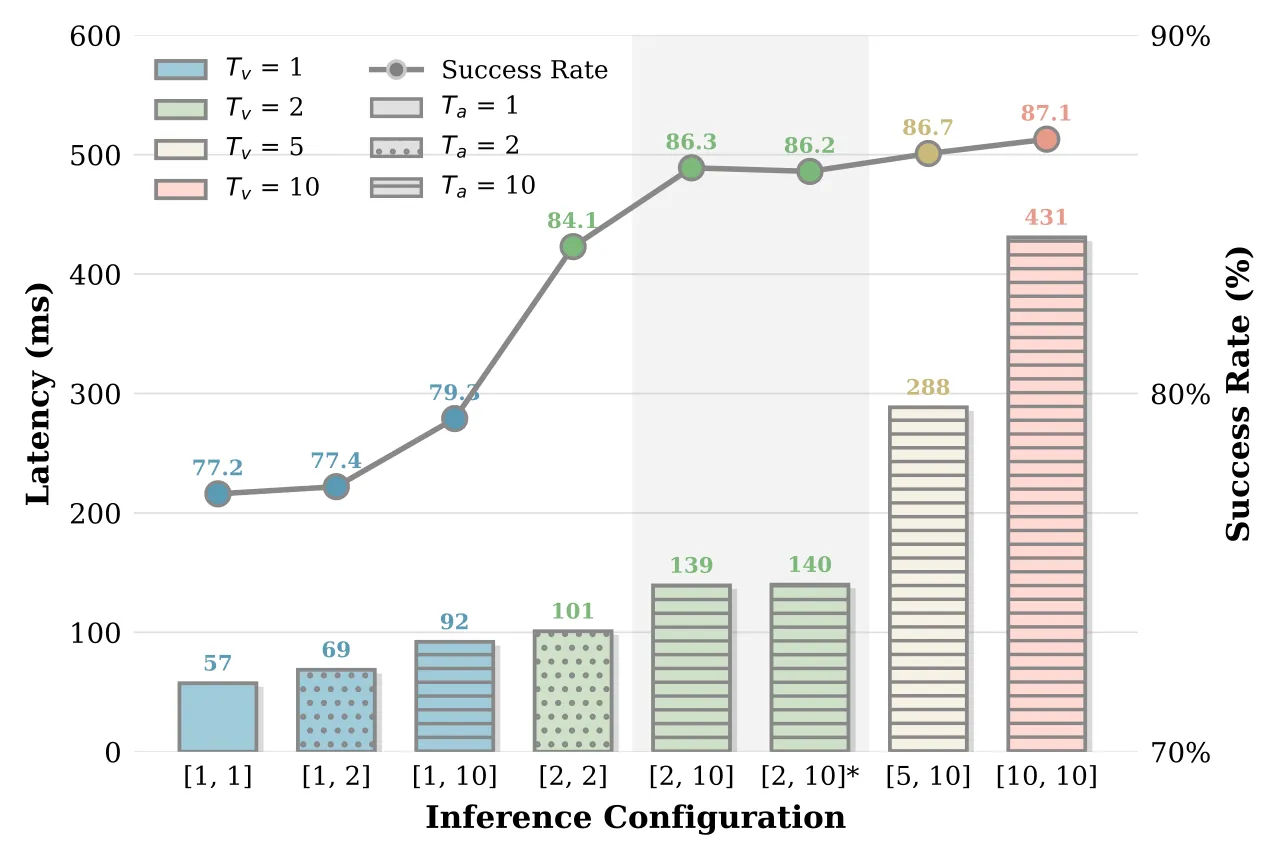
图 3(论文 Figure 4):RoboTwin 2.0(clean)上的时延与成功率权衡;阴影为选定配置 [2,10],星号为视频更新置于第 1 与第 8 次迭代的变体。
4.5 保真度与控制性能的解耦
为直接检验中心论点,作者在 RoboTwin hanging_mug 任务上只做视频生成、不接动作专家,比较紧凑 0.8B 专家与全量 WAN-2.2-5B 的预测保真度(Table 5):PSNR 从 21.66 dB 降到 18.82 dB,SSIM 从 83.18% 降到 79.16%——压缩后的未来预测确实更粗糙(Figure 7 与 Figure 8 的定性对比同样可见)。但同一紧凑专家在控制评测中的成功率与全量 backbone 接近(Table 4a)。"视频更糊"与"控制不降"同时成立,正是本文设计哲学的实证:未来分支的价值在于为动作提供指引,而非产出可供人观看的画面。
| 模型 | PSNR (dB) 越高越好 | SSIM (%) 越高越好 |
|---|---|---|
| WAM-5B | 21.66 | 83.18 |
| Efficient-WAM | 18.82 | 79.16 |
表 5(论文 Table 5):仅视频分支的未来预测保真度(RoboTwin hanging_mug)。
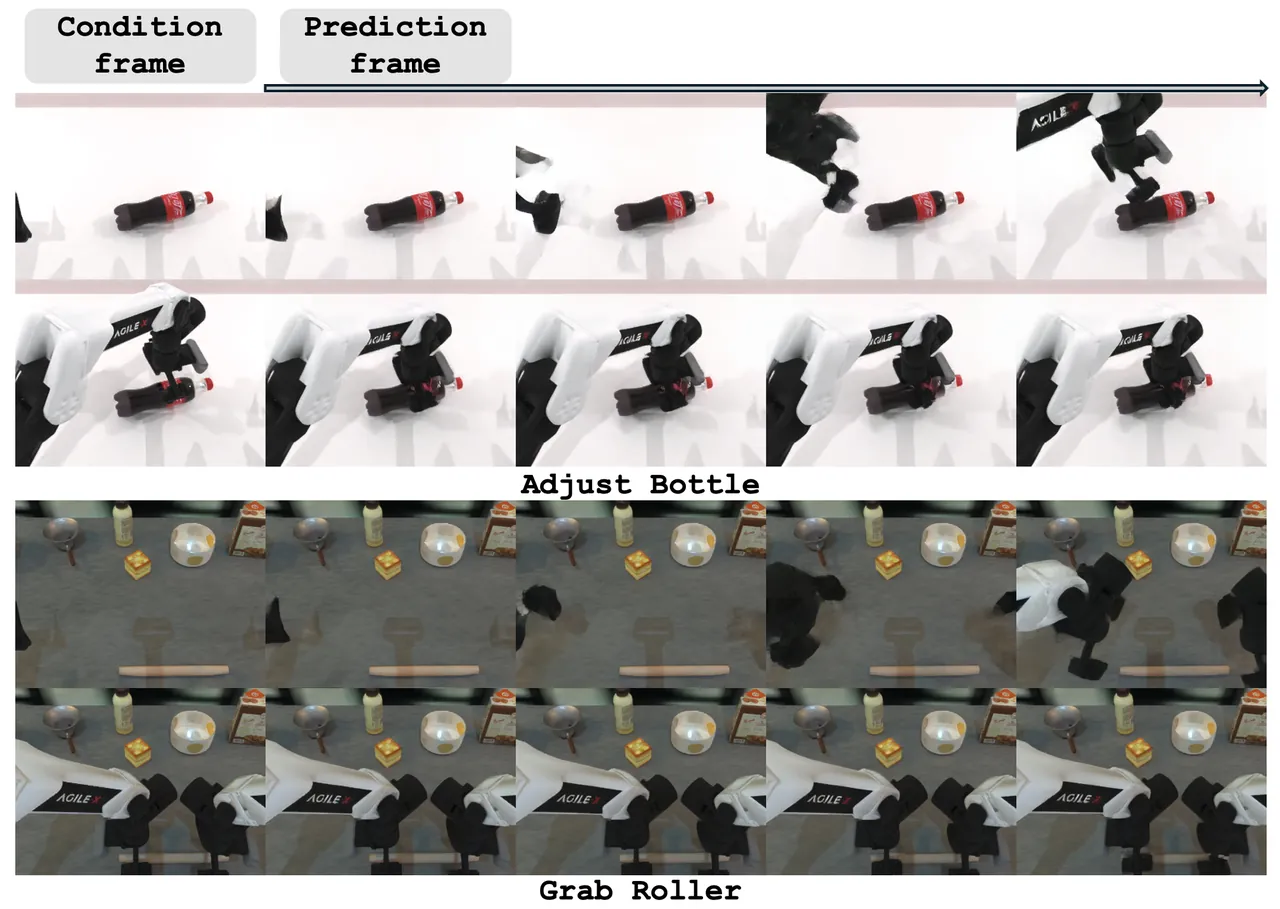
图 4(论文 Figure 7):全量 backbone WAM-5B 的未来预测,两个 RoboTwin 任务。
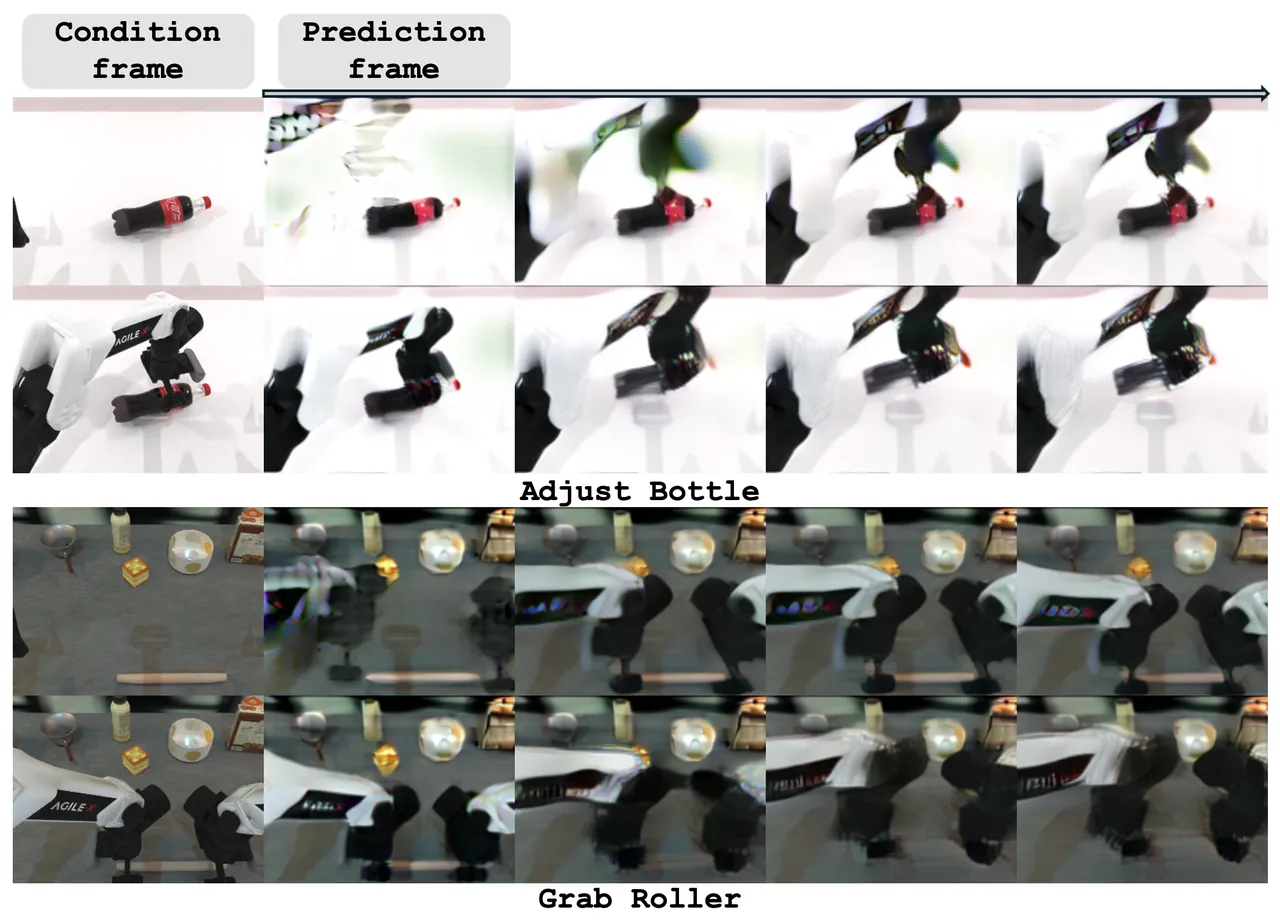
图 5(论文 Figure 8):Efficient-WAM-RT 的未来预测,明显更粗糙,但控制成功率接近。
失败案例(Figure 6)显示三个模型共有三类失败:抓取错位、漏看物体、非预期碰撞。π0.5 的特有失败包括留下未分拣的 LEGO 与碰倒笔筒,作者将其归因于仅 100 条演示下的任务适配不完全;两个 WAM 的特有风险则是对 UMI 采集与部署之间视觉差异的敏感性——毛巾演示全部来自单一 Pika UMI 设置,即使相机型号与参数一致,机载相机在近似视角下仍产生不同的图像与 VAE 潜变量。
五、局限性
作者自述其一:分辨率换速度的边界未探明。低分辨率未来预测以视觉细节换取推理速度;作者明确指出,需要更细空间精度的任务(例如穿线插入)可能仍需要更高分辨率的未来表示,而这一权衡在此类设置下尚未评估。
作者自述其二:相机外观偏移。UMI 采集与部署之间观察到的视觉差异(同型号相机、近似视角下图像与 VAE 潜变量仍不同)促使作者提出需进一步研究对相机变化的鲁棒性;毛巾折叠演示仅来自单一 Pika UMI 设置,是该偏移的直接来源。
我们的判断其一:可变形物体的证据面过窄且恰为弱项。真机评测每任务 20 次试验,五个任务中可变形物体仅毛巾折叠一项,而该任务上 Efficient-WAM-RT(60%)低于 π0.5(85%);平均成功率的优势由刚性物体任务贡献。"支持可变形物体操作"的结论因此证据不足,且与作者自述的外观偏移解释互为因果候选,难以分离。
我们的判断其二:时延口径与基线协议。98 ms 的部署数字不含预测视频的 VAE 解码与保存,也不含观测获取与机器人执行;若下游需要可视化预测未来或将其用于闭环校正,端到端墙钟会高于报告值。此外消融在 A800、真机在 4090,两套硬件的数字不宜直接相乘式外推;Table 1 的多数基线取自官方论文或技术报告而非同协议复跑(Fast-WAM 除外),跨方法比较因此携带协议方差。
六、总结与展望
Efficient-WAM 的贡献可以概括为一次成本分解、逐因子压缩、组合验证:以式 (2) 把视频侧成本拆为模型规模、token 数、去噪步数三个因子,分别用结构化切片蒸馏的 0.8B 紧凑专家、192×160 的四分之一未来 token、训练免调的 [2,10] 非对称去噪回应,再在 RoboTwin 2.0 与真机上验证组合效果。消融同时给出了一条反面证据——去掉未来交互会损失约 20 个百分点——说明被压缩的是想象的分辨率与步数,而不是想象本身。
对机器人学习者而言,这篇工作的可复用资产有三件:一份把 30 层视频教师切到 12 层仍保住先验的切片与蒸馏配方;一个"视频 K/V 缓存加动作-only 精化"的推理范式,可迁移到其它 MoT 型 WAM;以及一张标出膝点的时延-成功率曲线,供部署预算直接查表。展望方向则自然落在作者自述的两处空白:细空间精度任务的分辨率需求,以及跨相机外观的鲁棒训练。