PAPER DEEP DIVE
Rolling-WAM:把世界动作模型的去噪摊到每个重规划周期
南加州大学、布朗大学、复旦大学与丰田研究院提出 Rolling-WAM。世界动作模型(WAM)把未来视觉预测与动作生成耦合,但标准做法要求每个重规划周期把整个预测视野从纯噪声完整去噪一遍,延迟巨大、闭环反应迟钝。作者指出 receding-horizon 控制实际只执行视野的开头一小段,未被执行的尾巴含有价值却被丢弃。Rolling-WAM 维护一个滑动窗口,窗口内越靠未来的 chunk 噪声越高:滚动模式下 chunk j 的噪声为 σ((j-1+τ)/W),第一个 chunk 在周期结束时变干净,且满足 σ_{j+1}(0) = σ_j(1) 的衔接条件,因此窗口前移后被保留的 chunk 恰好处于新位置的起始噪声,可直接接着去噪。每个 chunk 仍走满 N 步,但计算被摊到多个周期,稳态每周期只需 N/W 步。默认 N=10、W=5、K=16,即维持 80 个动作的预测窗口而每次更新只跑 2 步去噪。注意力掩码上,每个动作 chunk 可 attend 整个窗口的视觉特征,动作之间的直接注意力仅限同 chunk,视频 token 不 attend 动作 token,训练与推理一致。结果:稳态重规划 215 ms 对比 Joint-WAM 的 978 ms,加速 4.5 倍,比不做未来想象的 Fast-WAM(548 ms)还快,且比两个 VLA 基线(285/296 ms)更快;LIBERO 98.1%、RoboTwin 2.0 93.3%(全场最高,且无具身预训练即超过预训练的 LingBot-VA)、Unitree G1 真机三任务 85.0%。消融显示窗口 W=5 最优而 W=8 掉到 69.5%,且跨 chunk 直接动作注意力反而有害——动作应借道共享视觉未来协调。
论文来源:arXiv:2609.30247(cs.RO),南加州大学(USC)+ 布朗大学 + 复旦大学 + 丰田研究院(Toyota Research Institute),2026 年 9 月 24 日提交,10 页。项目页 https://rolling-wam.github.io/。
一句话概括
World Action Model(WAM)把未来视觉预测和动作生成耦合在一起,效果不错但有一个致命工程问题:每个重规划周期都要把整个预测视野从纯噪声完整去噪一遍,延迟巨大、闭环反应迟钝。Rolling-WAM 的解法非常漂亮——把去噪摊到连续多个重规划周期上:维护一个滑动窗口,窗口内越靠未来的 chunk 噪声越高;每个周期只把马上要执行的那一个 chunk 彻底去噪,其余 chunk 只做部分精炼,窗口随新观测前移时被保留的 chunk 接着上次的进度继续去噪。结果:稳态重规划 215 ms vs Joint-WAM 的 978 ms,加速 4.5 倍,同时 LIBERO 98.1%、RoboTwin 2.0 93.3%、Unitree G1 真机 85.0%——不但没掉点,反而更好。
1. 问题的本质:滚动视野控制里的「反复推倒重来」
1.1 标准 WAM 的开销结构
在时刻 $t$,策略拿到观测 $o_t$、机器人状态 $s_t$、语言指令 $\ell$,预测动作序列 $a_{t:t+H-1}$;WAM 额外预测未来视频隐变量 $v_{t+1:t+H}$。联合建模的分布为:
$$p_\theta\!\left(a_{t:t+H-1}, v_{t+1:t+H} \mid c_t\right),\qquad c_t = (o_t, s_t, \ell)$$
闭环部署要求每个重规划周期内跑完多步去噪才能执行一个动作块。每一步去噪都要处理整条视频-动作序列,于是「周期性重规划」遇到「全序列联合去噪」,延迟被直接放大。
1.2 被丢掉的那部分计算
关键洞察在下一句:receding-horizon 控制实际上只执行预测视野的开头一小段。标准 chunk 采样器每个周期都从零开始把整条视野去噪到干净,而没被执行的那条「尾巴」明明含有对当前动作有价值的信息,却被丢弃而不是跨周期复用。
已有的加速路线基本是「减法」:干脆在测试时不生成未来视频(Fast-WAM),或者只跑一次视频专家把上下文缓存下来(Faster-WAM),或者蒸馏、砍模型、减 token。Rolling-WAM 选的是另一条路——不做减法,做「摊销」:把联合去噪过程本身摊到多个重规划周期上。
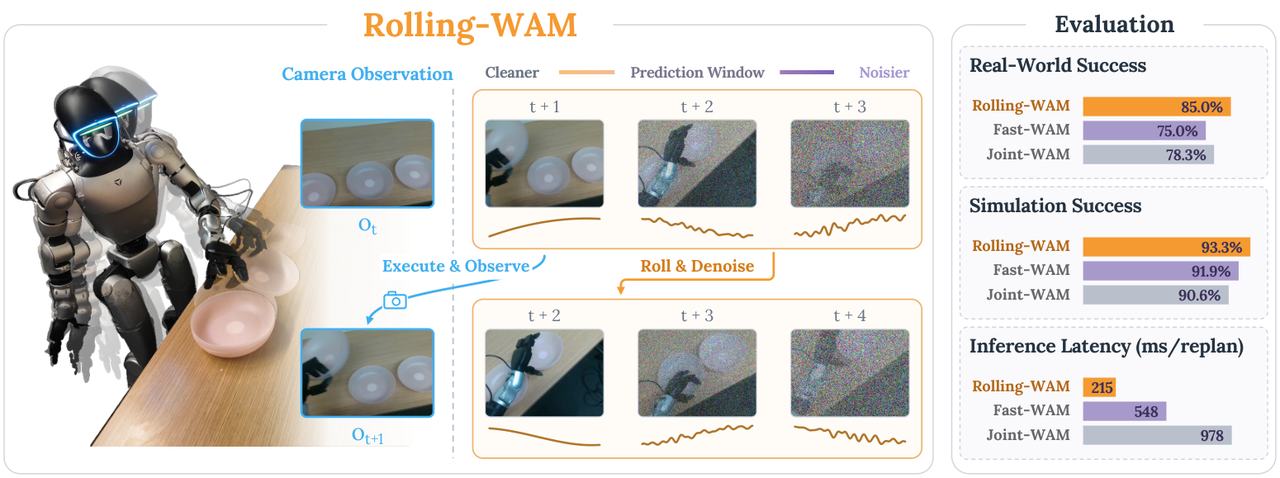
图 1:Rolling-WAM 总览——错峰噪声水平的滚动窗口,随窗口前移保留未来 chunk 继续去噪。
2. 方法:Rolling 去噪
2.1 窗口结构
把预测窗口切成 $W$ 个时间对齐的 chunk $X_{1:W}$,其中 $X_j = (v^{(j)}, a^{(j)})$。每个动作 chunk $a^{(j)} = a_{t+(j-1)K : t+jK-1}$ 含 $K$ 个动作,其对应的视频 chunk $v^{(j)}$ 覆盖同一物理区间的视频采样。总视野 $H = WK$,执行每次前进一个 chunk。
用 $\tau \in [0,1]$ 参数化单个重规划周期内的去噪进度,从开始的 $1$ 降到结束的 $0$。基础噪声表 $\sigma(\cdot)$ 单调增,$\sigma(1)=1$ 为纯高斯噪声,$\sigma(0)=0$ 为干净数据。
2.2 两种模式
(a) 滚动模式(rolling mode):第一个 chunk 必须在周期结束时变干净,其余每个 chunk 必须正好达到「前移一格后新位置所需的起始噪声」。给 chunk $j$ 分配噪声水平:
$$\sigma^{\text{rolling}}_j(\tau) = \sigma\!\left(\frac{j-1+\tau}{W}\right),\qquad j=1,\dots,W$$
当 $\tau$ 从 $1$ 降到 $0$,chunk $j$ 从 $\sigma(j/W)$ 走到 $\sigma((j-1)/W)$。第一个 chunk 变成干净数据,越靠后的 chunk 残留噪声越高。最关键的衔接条件:
$$\sigma^{\text{rolling}}_{j+1}(0) = \sigma^{\text{rolling}}_{j}(1),\qquad j=1,\dots,W-1$$
也就是说:第一个 chunk 被移走后,每个保留下来的 chunk 已经恰好处于它新位置的起始噪声水平,无需任何额外处理。再在末尾追加一个 $\sigma=1$ 的高斯噪声 chunk,配置就完整复原,可以进入下一周期。
(b) 初始化模式(initialization mode):episode 开头没有可继承的部分去噪预测,整个窗口从高斯噪声起步:
$$\sigma^{\text{init}}_j(\tau) = \sigma\!\left(\min\left(1,\ \tau + \frac{j-1}{W}\right)\right)$$
所有 chunk 起始于 $\sigma=1$,靠前的 chunk 更早开始去噪,靠后的 chunk 在轮到自己之前停在纯噪声。结束时 $\sigma^{\text{init}}_j(0) = \sigma^{\text{rolling}}_j(0)$,第一个 chunk 可执行,其余预测在窗口前移后进入滚动模式。
2.3 采样与执行:为什么能省
给每个 chunk 分配总共 $N$ 个去噪步,取 $N$ 为 $W$ 的倍数以便均摊。初始化阶段每步 $\Delta\tau = -1/N$,需要 $N$ 步进入滚动模式;此后的稳态重规划周期只需 $N/W$ 步就能产出下一个可执行动作 chunk(每步 $\Delta\tau = -W/N$)。
每步去噪对全窗口做联合更新,给定预测流速度 $f_{\theta,j}$,Euler 更新为:
$$\tilde{X}_j \leftarrow \tilde{X}_j + \left[\sigma_j(\tau+\Delta\tau) - \sigma_j(\tau)\right] f_{\theta,j}\!\left(\tilde{X}_{1:W}, \sigma; c_t\right)$$
第一个 chunk 干净后执行其中 $K$ 个动作,窗口滑动:移除已执行 chunk、保留剩余预测、追加高斯噪声新 chunk,机器人采集最新相机观测与状态来条件化下一周期。
A1 可执行"] A2["V2/A2 部分去噪"] A3["V5/A5 近纯噪声"] end A1 --> E1["执行 A1
取新观测 o"] E1 --> B1["Cycle 2: 窗口前移
保留 chunk 接着去噪
末尾追加高斯噪声 chunk"] B1 --> B2["只需 N/W = 2 步
→ 新的可执行 chunk"] B2 --> B3["... 稳态循环 ..."]
反直觉但重要的一点:每个 chunk 在被执行之前仍然走满了全部 $N$ 步,只是这些计算被分摊到了多个重规划周期。而且——在 $N$ 固定、GPU 并行度足够处理扩展窗口的前提下,窗口越大,稳态延迟反而越低。论文强调这条路子与 Fast-WAM / Efficient-WAM 那类优化正交,可以叠加使用。
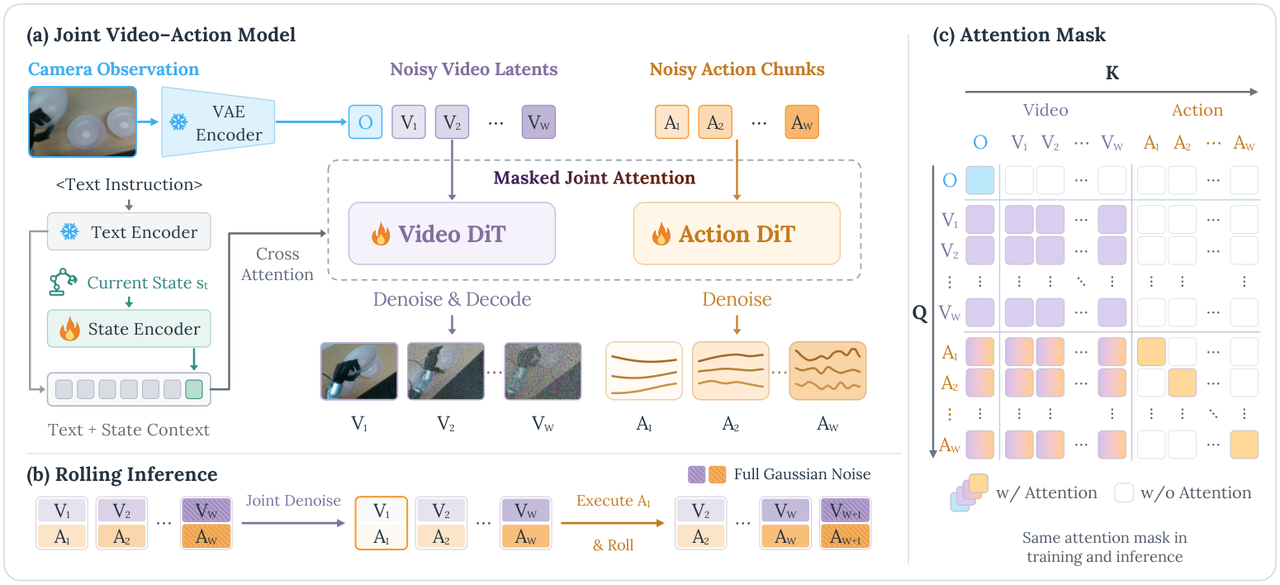
图 2:框架图——(a) 视频/动作专家的掩码联合注意力,(b) 滚动推理的窗口前移,(c) 训练与推理一致的注意力掩码。
2.4 架构与注意力掩码
模型是 MoT:预训练视频 DiT(Wan2.2-TI2V-5B 初始化,复用其文本编码器与 VAE)+ 轻量动作 Transformer(30 层、隐维度 $d_a=1024$、约 1B 参数,骨干由视频专家权重插值初始化)。联合训练两个专家与本体的本体感受编码器,VAE 与文本编码器冻结。
注意力掩码的设计是核心:
- 每个动作 chunk 可以 attend 整个预测窗口的视觉特征——这是「让动作看到超越自身执行区间的共享、演进中的视觉未来」的关键;
- 动作到动作的直接注意力被限制在同一 chunk 内;
- 视频 token 不 attend 动作 token。
同一个掩码在训练和推理时保持一致,避免训练/部署错配。视频与动作 token 各自按 chunk 级噪声水平做调制,使处于不同精炼阶段的预测能被联合处理。
2.5 训练目标
用 flow matching 训练。每个训练窗口采样 $\tau \sim \mathcal{U}(0,1)$,以概率 $\beta$ / $1-\beta$ 选滚动或初始化模式(论文用 0.8 / 0.2)。构造带噪目标:
$$\tilde{X}_j = (1-\sigma_j)X_j + \sigma_j \epsilon_j,\qquad \epsilon_j \sim \mathcal{N}(0, I)$$
视频与动作用独立高斯样本,网络预测条件速度,目标为 $\epsilon_j - X_j$。对模态 $q \in \{v, a\}$,逐 chunk 损失:
$$\ell^q_j = \left\| \left[f^q_\theta\!\left(\tilde{X}_{1:W}, \sigma; c_t\right)\right]_j - \left(\epsilon^q_j - X^q_j\right) \right\|_2^2$$
联合目标:
$$\mathcal{L} = \mathbb{E}\left[\frac{1}{W}\sum_{j=1}^{W} b_j\, w(\sigma_j)\left(\lambda_v \ell^v_j + \lambda_a \ell^a_j\right)\right]$$
其中 $w$ 对不同噪声水平加权,$\lambda_v, \lambda_a$ 平衡两个模态(论文都取 1),活动掩码 $b_j$ 排除仍被保持在纯噪声的初始化 chunk。两种模式都训练,同一个模型因此既会初始化预测窗口,也会在闭环执行中继续精炼它。
2.6 实现细节:一份可以照抄的配置表
论文把实现写得相当具体,对想复现的人很友好。视频专家从 Wan2.2-TI2V-5B 初始化,并复用它预训练好的文本编码器与 VAE;动作专家 30 层、隐藏维度 $d_a = 1024$、约 1B 参数,其骨干不是随机初始化,而是由视频专家的权重插值而来——这个技巧让动作专家一开始就有视觉先验。训练时联合更新两个专家与本体感受编码器,VAE 与文本编码器冻结。
优化器 AdamW,学习率 $10^{-4}$,权重衰减 $10^{-2}$,5% 线性 warmup 后余弦衰减,BF16 混合精度。视频与动作损失分别平均,$\lambda_v = \lambda_a = 1$。初始化与滚动模式以 0.2 / 0.8 的概率采样。两个模态共用同一条 shifted 噪声表 $\sigma(\tau) = \rho\tau / [1 + (\rho-1)\tau]$,取 $\rho = 5$,训练与推理一致。默认 $N=10$、$W=5$、$K=16$,稳态每周期 $N/W = 2$ 步,分类器无关引导尺度设为 1(即不使用 CFG)。
一句话概括这套配置的含义:模型的总预测视野是 $H = WK = 80$ 个动作,但它每次更新只需要 2 步去噪。这就是 4.5× 加速的算术来源——Joint-WAM 每次要为 16 个动作跑完整去噪,Rolling-WAM 每次为 80 个动作的窗口跑 2 步。
2.7 与同期工作的坐标关系
把 Rolling-WAM 放进 2026 年 WAM 加速的图谱里看,脉络很清楚:
| 路线 | 代表方法 | 核心做法 | 代价 |
|---|---|---|---|
| 移除测试时想象 | Fast-WAM | 部署时不生成未来视频,只保留训练期的预测监督 | 丢失显式的视觉预测 |
| 缓存未来上下文 | Faster-WAM | 单次视频专家前向提取未来上下文并缓存供动作去噪使用 | 上下文不再随观测更新 |
| 模型/采样压缩 | Efficient-WAM、Flash-WAM | 减小模型与视觉 token、减少去噪步数、模态感知一致性蒸馏 | 容量或质量受限 |
| 上下文复用 | MotusBrain、AHA-WAM | 回收部分联合去噪后的视觉特征;跨动作更新共享异步刷新的视觉上下文 | 需要额外的路由/刷新机制 |
| 执行重叠 | RTC(real-time chunking) | 推理与执行重叠,用动作 inpainting 对齐相邻 chunk | 不减少总计算量 |
| 摊销去噪(本文) | Rolling-WAM | 把联合去噪摊到连续多个重规划周期,窗口内错峰噪声 | 保留预测可能滞后于剧烈场景变化 |
与本文最亲近的是动作-only 的滚动扩散策略(Streaming Diffusion Policy、RNR-DP)——它们也维护部分去噪的动作缓冲区,但只处理动作,且多在任务专属策略的小规模设定上评估。Rolling-WAM 的推进在于:把滚动机制扩展到世界模型与动作生成的耦合上,让动作 token 能 attend 部分去噪的视觉未来,并在更宽的多任务设定上评估。
为什么「保留视觉想象」这件事本身重要
值得单独说一句。Fast-WAM 那条路线的结论其实是「测试时不需要未来想象」——如果成立,WAM 相对普通 VLA 的核心差异就被削弱了。Rolling-WAM 给出的是一个更有建设性的答案:不是未来想象没用,而是「每个周期从零完整生成一次未来」这个做法太贵。当去噪被摊销之后,保留未来视频生成的模型不但能跑赢不做想象的 Fast-WAM(215 ms vs 548 ms),在 RoboTwin 和真机上的成功率还更高。这对 WAM 路线是一个正向信号。
3. 实验
3.1 设置要点
三个基准:LIBERO(Spatial/Object/Goal/Long 四套件,跨四套件训一个策略,10 epoch,每任务 50 rollout)、RoboTwin 2.0(50 个双臂任务,Clean 与 Randomized 两设定,2,500 条干净 + 25,000 条随机化示范,每任务 100 rollout)、Unitree G1 真机(Doll Placement 放玩偶、Plate Stacking 叠三盘、Bead Pouring 倒珠子;320×224 第一人称 RGB + 43 维状态,输出 78 维动作 = 64 维 SONIC 运动隐变量 + 每只手 7 维指令;每任务 50 条示范 @10 Hz,7,500 步训练,每任务 20 次试验)。
默认配置:$N=10$ 步/chunk、$W=5$ 个 chunk、$K=16$ 动作/chunk,因此稳态每周期只用 $N/W = 2$ 步。噪声表 $\sigma(\tau) = \rho\tau / [1+(\rho-1)\tau]$,$\rho=5$。分类器无关引导尺度为 1。全程只用各基准自带的示范,没有做额外具身预训练。
3.2 LIBERO:不掉点
| 方法 | 具身预训练 | Spatial | Object | Goal | Long | 平均 |
|---|---|---|---|---|---|---|
| $\pi_0$ | ✓ | 96.8 | 98.8 | 95.8 | 85.2 | 94.1 |
| $\pi_{0.5}$ | ✓ | 98.8 | 98.2 | 98.0 | 92.4 | 96.9 |
| Motus | ✓ | 96.8 | 99.8 | 96.6 | 97.6 | 97.7 |
| LingBot-VA | ✓ | 98.5 | 99.6 | 97.2 | 98.5 | 98.5 |
| Fast-WAM | ✗ | 98.2 | 100.0 | 97.0 | 95.2 | 97.6 |
| Joint-WAM | ✗ | 99.6 | 99.4 | 98.2 | 96.8 | 98.5 |
| Rolling-WAM (Ours) | ✗ | 98.2 | 98.0 | 98.2 | 97.8 | 98.1 |
98.1%,与并列最佳的 LingBot-VA / Joint-WAM(98.5%)相差 0.4 个百分点,高于 Motus(97.7%)与 Fast-WAM(97.6%)。四个套件 97.8–98.2%,表现一致。
3.3 RoboTwin 2.0:反而更好
| 方法 | 具身预训练 | Clean | Randomized | 平均 |
|---|---|---|---|---|
| $\pi_0$ | ✓ | 65.9 | 58.4 | 62.2 |
| $\pi_{0.5}$ | ✓ | 82.7 | 76.8 | 79.8 |
| Motus | ✓ | 88.7 | 87.0 | 87.8 |
| LingBot-VA | ✓ | 92.9 | 91.5 | 92.2 |
| Fast-WAM | ✗ | 91.9 | 91.8 | 91.8 |
| Joint-WAM | ✗ | 90.8 | 90.3 | 90.6 |
| Rolling-WAM (Ours) | ✗ | 93.5 | 93.0 | 93.3 |
93.3% 平均,是所有对比方法里最高的,且 Clean 与 Randomized 之间只差 0.5 个百分点。这一点很值得注意:Rolling-WAM 完全没有做具身预训练,却超过了做了预训练的 LingBot-VA(92.2%)。论文的解释倾向于——同时精炼当前与未来预测,本身就可能带来更好的动作一致性。
3.4 延迟:核心卖点
在单张 NVIDIA A100 上、RoboTwin 2.0 设定、384×320 分辨率下测量稳态重规划延迟(含视觉编码与去噪、CUDA 同步,排除 warm-up 与初始化;没有用 torch.compile / TensorRT / 自定义 CUDA kernel)。三种方法每周期都执行 16 个动作。
| 方法 | 稳态重规划延迟 (ms) | 相对 Rolling-WAM |
|---|---|---|
| GR00T N1.7 | 285 | 慢 1.33× |
| $\pi_{0.5}$ | 296 | 慢 1.38× |
| Fast-WAM | 548 | 慢 2.5× |
| Joint-WAM | 978 | 慢 4.5× |
| Rolling-WAM | 215 | — |
两个常被忽略的细节:
- 它保留了未来视频生成,却比两个 VLA 基线还快(215 ms vs 285/296 ms)。
- 它维持 80 个动作的预测窗口,基线只预测 16 个——延迟降低的同时,每次更新还在精炼更长的未来。
窗口规模扫描($W$ 从 1 到 8,Rolling-WAM 用 $H=16W$,基线固定 $H=16$,总去噪预算 $N = W\lfloor 16/W \rfloor$):在 $W=5$ 时 Rolling-WAM 只需 322 ms,Fast-WAM 832 ms、Joint-WAM 1529 ms(2.58× / 4.75×);$W=6$–$8$ 时曲线走平,因为滚动去噪步数稳定在每周期 2 步。
3.5 真机 Unitree G1
| 方法 | Doll Placement | Plate Stacking | Bead Pouring | 平均 |
|---|---|---|---|---|
| $\pi_{0.5}$ | 55.0 | 70.0 | 60.0 | 61.7 |
| GR00T N1.7 | 75.0 | 65.0 | 60.0 | 66.7 |
| Fast-WAM | 85.0 | 80.0 | 60.0 | 75.0 |
| Joint-WAM | 70.0 | 100.0 | 65.0 | 78.3 |
| Rolling-WAM (Ours) | 85.0 | 100.0 | 70.0 | 85.0 |
85.0% 平均,五项里最高(Joint-WAM 78.3%、Fast-WAM 75.0%),且是一个策略跨三个任务训出来的。论文还给了一条很实在的定性观察:Rolling-WAM 在动作 chunk 边界处的执行更连续;Joint-WAM 的停顿更明显,有时会打断任务进度。这句其实是全篇最有力的论据——延迟不只是数字,它直接表现为机器人「卡不卡」。
3.6 消融
| 变体 | RoboTwin(6 任务) | LIBERO |
|---|---|---|
| Full Rolling(默认,无跨 chunk 动作注意力) | 78.2 | 98.1 |
| 加跨 chunk 双向动作注意力(A2A) | 76.3 | 97.9 |
| Constant 噪声,替换比例 $p=0.2$ | 74.7 | 97.9 |
| Constant 噪声,$p=0.5$ | 73.0 | 97.1 |
| Random 噪声,$p=0.2$ | 75.3 | 97.0 |
| Random 噪声,$p=0.5$ | 78.5 | 97.3 |
三个结论:
- 窗口不是越大越好。在 RoboTwin 六任务上,$W=5$ 达峰 78.2%,$W=3$ 是 77.3%,$W=8$ 掉到 69.5%。论文猜测:更远的视觉预测受当前观测约束更弱,对即将执行的动作块指导有限,窗口过长甚至可能有害。
- 训练时用与推理一致的错峰噪声表最好。Random($p=0.5$) 把 RoboTwin 抬到 78.5% 但 LIBERO 掉到 97.3%;没有任何替代方案能在两个基准上同时变好,所以默认保留完整 rolling 表。
- 动作之间的信息交换应该「借道视觉窗口」,而不是直接做跨 chunk 动作注意力。加上 A2A 后 RoboTwin 76.3% / LIBERO 97.9%,双双低于默认的 78.2% / 98.1%。
4. 我的读法
这篇论文的方法论价值高于它的指标价值。它做的事情本质上是把「receding-horizon 控制的丢弃」识别为一种计算浪费,然后从 rolling diffusion 那里借来一个现成的答案,安到 video-action 联合模型上。思路干净、实现改动不大、收益是实打实的一个数量级以内的常数因子(4.5×),而且与 Fast-WAM / Efficient-WAM / 蒸馏那类加速手段正交,可以叠加。
几个我认为特别值得注意的点:
- 「摊销」而不是「砍掉」。此前加速 WAM 的主流思路是移除测试时的未来视频生成——等于承认「视觉想象太贵,不做了」。Rolling-WAM 证明只要重新安排去噪顺序,视觉想象可以留着,而且能比不做视觉想象的 Fast-WAM 还快 2.5 倍。这对整个 WAM 路线的定位是一个正面信号。
- RoboTwin 上超过做了具身预训练的 LingBot-VA,说明窗口内跨 chunk 的视觉上下文确实提供了额外监督信号,不只是省算力。
- 消融里「A2A 反而变差」是个有意思的反直觉结果:动作块之间不该直接对话,应该通过共享的视觉未来间接协调。这暗示视觉预测在这里扮演的正是「协调介质」的角色。
- 真机观察(chunk 边界更连续、停顿更少)比任何表格都更能说明延迟为什么重要。
局限也说得很清楚:窗口与 chunk 大小的选择需要在不同动力学与控制频率的任务上进一步探索;尽管有观测反馈,被保留的预测仍可能跟不上剧烈场景变化而误导动作生成,长窗口下尤其明显;自适应窗口管理与异步执行是作者点名的下一步。另外,A100 上的 215 ms 是未经任何编译优化的数字,工程上还有明显空间。
一个工程视角的提醒
215 ms 这个数字是在单张 A100、未使用 torch.compile / TensorRT / 自定义 CUDA kernel的条件下测的。这意味着论文汇报的是一条相当保守的基线——实际部署时配合编译优化、更小的视频专家、或更激进的窗口配置,还有明显下降空间。反过来说,与它对比的 978 ms(Joint-WAM)同样未优化,所以 4.5× 这个比值本身是可信的相对结论,但两个绝对值都不应被当作部署上限或下限来引用。
另外,$W$ 与 $K$ 的选择带有明显的任务依赖性:论文在 RoboTwin 上扫出 $W=5$ 最优、$W=8$ 反而掉到 69.5%,但这组结论是在 10 Hz 控制、16 动作/chunk 的设定下得到的。换到更高控制频率或更长动作块的任务上,最优窗口很可能不同——这也是作者自己承认的局限。落地时把它当成一组需要重新扫的超参,而不是默认值,会更稳妥。
窗口大小背后的物理含义
还有一个容易被跳过、但我觉得挺关键的换算:$H = WK = 5 \times 16 = 80$ 个动作,在 10 Hz 控制下意味着模型始终在「想象」未来 8 秒。而 $W=8$ 时就是 12.8 秒。消融里 $W$ 超过 5 之后成功率下滑,一个很自然的解释是:超过某个时间跨度后,想象出来的视觉未来与真实将要发生的事情已经偏离到有害的程度,动作 token 再去 attend 它,等于在看一张越来越不靠谱的地图。
这也解释了为什么「跨 chunk 直接做动作注意力」会变差(78.2% → 76.3%)。窗口里被保留的远未来动作预测,质量比视觉预测更差——它们连观测的条件化都还没真正走到。让动作块之间只通过共享视觉未来间接协调,等于用相对可靠的媒介代替了不可靠的直接连接。这个设计选择背后是有道理的,不是随手为之。
与 ME-U0 的对照阅读
如果同时看同期理想汽车的 ME-U0(arXiv:2609.25627),会看到一个有意思的分工:ME-U0 关心的是「理解—预测—控制」怎么在架构上统一(子任务+可供性条件化视觉-动作联合生成),Rolling-WAM 关心的则是这套联合去噪在闭环里怎么算得起。前者加能力,后者降成本,方向正交——事实上 Rolling-WAM 明确说自己与模型/系统级优化是正交的,完全可以套在 ME-U0 那类架构上。对做工程的人来说,这两篇合起来基本勾出了 2026 年 WAM 路线的两个主要战场。
5. 资源
- 论文:arXiv:2609.30247
- 项目页:https://rolling-wam.github.io/
- 机构:USC(Physical Superintelligence Lab)、Brown University、Fudan University、Toyota Research Institute
- 致谢资助:NSF CPS #2434460