PAPER DEEP DIVE
DONIC:从人类演示学双手灵巧跟踪
DONIC 是首个跨操作类别与人类动作数据源联合训练的通用双手跟踪器;配套 BiHOI 多视角数据集含 1575 段序列、229 个物体,强调持续双手接触。方法以物体为中心的逐手奖励与 Clip-Centered Advantages 支撑 PPO 加行为克隆的闭环,单个检查点在未见轨迹与未见物体上分别取得 86.79% 与 57.32% 的成功率,无需任何微调。
论文元信息
标题:DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations(DONIC:从人类演示学习通用双手灵巧跟踪控制)
作者:Mingze Sun、Ziang Cao、Yuan Fei、Qiankuan Tao、Zihan Wang、Tianqi Liu、Junhao Chen、Haiwen Diao、Fangzhou Hong、Zhaoxi Chen、Ziwei Liu(全部作者单位均为 Ropedia;Ziwei Liu 为通讯作者)
链接:arXiv:2610.29997v1 [cs.RO],2026-10-21;全文 https://arxiv.org/abs/2610.29997 ;项目页 https://ropedia.github.io/DONIC ;代码 https://github.com/Ropedia/DONIC
代码状态:仓库目前只放出 bihoi_pipeline 一条数据重建管线(许可证 CC BY-NC 4.0),覆盖多视角掩码与度量深度、物体度量重建与六自由度跟踪、手物联合优化和重定向导出;论文主体的训练代码、检查点与 BiHOI 数据在 README 中标注为“coming soon”。因此今天可复现的是“把多视角录像变成机器人参考动作”这一段,策略训练本身尚不可复现。下文凡涉及数据管线的数字都与仓库脚本逐行对照过,涉及训练配方的数字则来自论文正文与附录。
一句话总结
DONIC 用“以物体为中心、按手分账”的奖励加上“按片段居中”的优势估计,让一个策略在 3,420 条来源异构的双手参考上联合训练;推理时单个检查点无需微调,在未见轨迹上取得 86.79% 成功率、在未见物体上取得 57.32%,比最强的双手基线分别高出 77.36 与 45.73 个百分点。
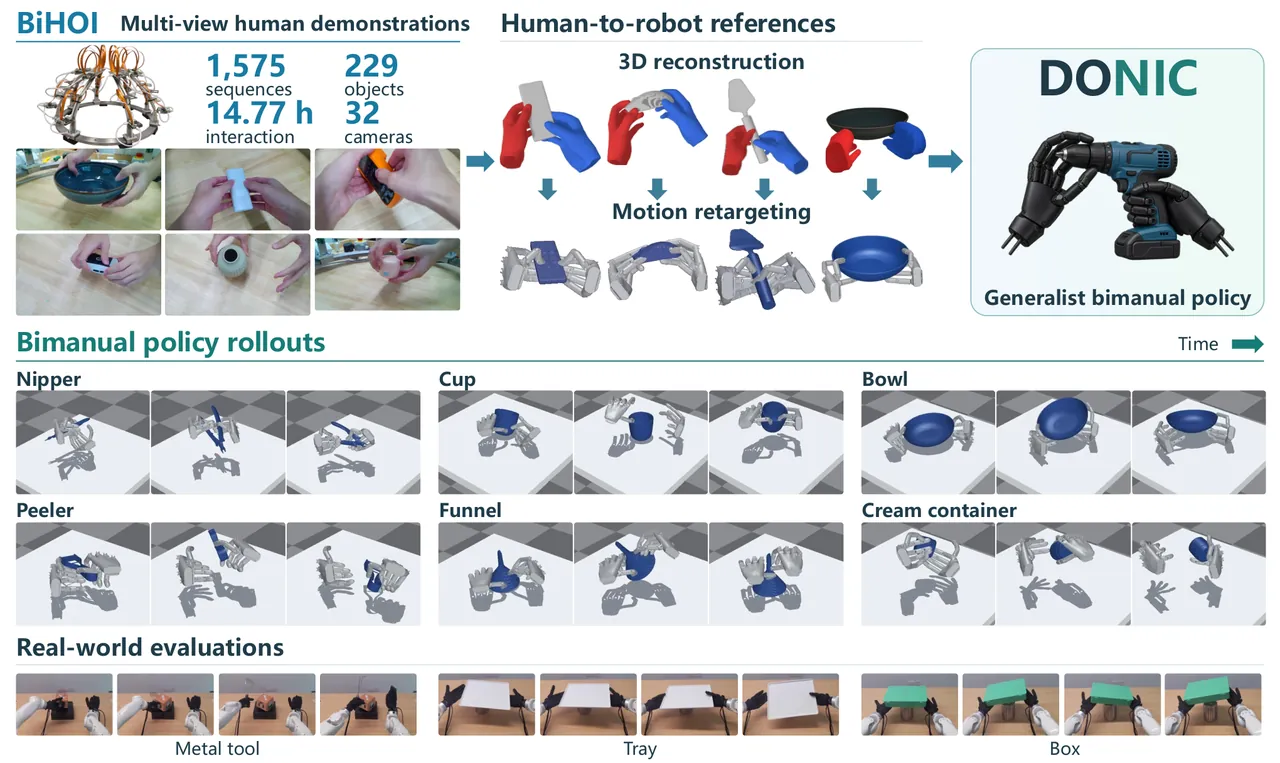
图 1:DONIC 总览(论文 Fig. 1)。左侧 BiHOI 提供多视角双手演示,经重建与重定向得到机器人参考;右侧 DONIC 用一个共享策略学习多种双手参考跟踪任务。
研究背景与动机
灵巧操作支撑家庭辅助、工业装配与辅助护理,但它要求的不是夹爪式的“抓住”,而是手指运动与不断变化的手物接触的精确协调:抓、翻转、再定位都依赖接触时序。把人类演示迁移到运动学不同的机器人手上已经很难,而要在物体与行为类别之间泛化更难。仿真就绪的物体资产与合成轨迹能造出大规模交互数据,却未必保留人类自然操作的结构;于是新一代跟踪器转向从人手—物体运动学习,但绝大多数仍停留在单手。
日常任务却常常是非对称双手协作:一只手稳住物体,另一只手去打开、旋转或重新摆放它。这催生一类“通用双手参考跟踪器”:从多样的人类运动学习,用一个策略控制不同物体与不同任务。论文把目标写得很克制——不是端到端从视频到真机,而是在仿真里跟踪重定向后的双手参考,并在留出轨迹与留出物体上不微调地评测。
做这件事有两个硬障碍。其一是数据:公开数据集里虽有双手操作,但“双手与物体都被完整跟踪、且双手持续接触”的序列稀缺,可用的协调模式有限。其二是训练:共享策略要面对不断变化的手角色与接触时序——手姿精度不等于操作成功,而要求双手同时满足接触条件又会掩盖其中一只手的进步;片段难度不均还会在优势估计里留下与参考相关的偏移,让难片段里本来有用的动作也被一致地打负分。
DONIC 的回答是三件套:一个以物体为中心、按手分账的奖励(物体运动反馈全程在线,每只手的接触只在参考要求它接触时被监督);Clip-Centered Advantages(CCA,在 GAE 之后减去每个片段自己的平均优势,去掉偏移但保留片段内部的差异);以及 PPO 与行为克隆的反馈环,把共享策略自己验证成功的执行回灌成演示。BiHOI 数据集则补齐数据侧:1,575 条多视角序列、229 个物体、14.77 小时,强调持续的双手接触。
预备知识
参考条件 PD 控制接口。策略不直接输出关节目标,而是输出一个有界修正量,叠加到“下一帧参考”上再 clamp 到关节极限,交给 PD 控制器执行;修正每一步都锚定在新的参考上,不累积。这个接口继承自 DexTrack 与 Dexplore 一系工作,DONIC 沿用它,把创新放在奖励与训练过程上。
PPO 与行为克隆的反馈环。轨迹专用策略(specialist)逐条优化通过回放筛选的参考,其成功 rollout 经回放验证后进入演示库;共享策略(generalist) periodically 在训练池上评测,它自己验证成功的执行也补进演示库,供后续 PPO+BC 更新。演示只来自训练参考,留出参考全程隔离。
MANO 与运动学重定向。人手用 MANO 模型表示(形状加姿态);重定向按位置式运动学拟合,把人手关键点逐帧拟合到机器人连杆上,关节极限作为硬约束,并以前一帧解初始化、加帧间正则。 smoothing 只发生在重定向之前。
开环回放筛选。以零策略修正开环回放每条候选参考,把结果分成六类:立即丢物体(A)、物体被弹飞(B)、接触但抬不起来(C)、部分执行(D)、跟踪但释放或收尾错误(E)、完整执行(F)。A 与 B 剔除,C 到 F 保留给闭环训练——C 保留的理由是开环抬不起来不代表闭环反馈救不回来。筛选决定“哪些参考有资格进训练”,与演示准入用的“验证”是两道不同的门。
BiHOI:为双手而采的多视角数据集
采集系统是一圈 32 台标定 RGB 相机环拍桌面工作区,分辨率 1920×1232、帧率 30 fps。互补视角支撑遮挡下的重建,标定提供统一的度量坐标系。BiHOI 含 1,575 条交互序列、229 个物体、14.77 小时唯一交互时长(约 160 万同步帧),物体覆盖家居用品、容器、餐具、工具与电子产品;参与者做自然的、以物体为中心的交互,而不是按固定动作模板表演。录制包含对称双手操作、非对称双手协调与协调的多物体操作。
数据集的卖点不是规模而是“双手同时接触”的密度。论文把接触比例的分母定义为“至少一只手在接触的帧”,在这个口径下 BiHOI 有 65.91% 的接触活跃时间是双手同时接触,比被分析的公开子集里最高的 H2O(38.57%)高出 27.34 个百分点。作为对照,公开训练池同口径只有 31.40%;若把分母换成全部帧,则只有 22.56%。口径写清楚,数字才可比——这一点论文做得比多数数据集论文严谨。
| 来源 | 采集方式 | 序列数 | 帧数 | 物体数 | 双手接触 (%) |
|---|---|---|---|---|---|
| BiHOI(本文) | 多视角 RGB | 1,575 | 约 1.60M | 229 | 65.91 |
| GRAB (2020) | 标记点 MoCap | 1,334 | 1.622M | 51 | 32.21 |
| OakInk2 (2024) | 多视角 RGB + MoCap | 627 | 4.01M | 75 | 24.97 |
| TACO V1 (2024) | 多视角 RGB + 第一视角 RGB-D | 2.5K | 5.2M | 206 | 15.69 |
| GigaHands (2025) | 多视角 RGB | – | 183M | 417 | 34.74 |
| H2O (2021) | 多视角 RGB-D | – | 571.6K | 8 | 38.57 |
| HOI4D (2022) | 第一视角 RGB-D | 4,000 | 2.4M | 800 | – |
| HO-Cap rev. (2025) | 多视角 RGB-D | 64 | 656K | 64 | – |
表 1:数据集概览(论文 Table 1)。双手接触比例为“双手接触帧 / 至少单手接触帧”,在被分析的录制上池化;BiHOI 的 14.77 小时按 30 fps 计、同步时间步只计一次。
从录像到机器人参考要走五个阶段:掩码与度量深度、物体度量重建与跟踪、参与者级手标定、手运动重建、手物联合精化。物体支路先用 SAM3 做两阶段掩码(所有相机的首帧排成跨相机序列、用单个物体提示初始化一致掩码,再逐相机做时间跟踪),用 Depth Anything 3 在标定内外参下出空间一致的深度,并以相机外参的尺度对齐把深度锚到米制;MV-SAM3D 从首帧多视角与掩码重建规范网格,回投影深度决定物理尺度;FoundationPose 恢复六自由度物体运动,用多视角位姿共识处理遮挡,共识失败时重注册。
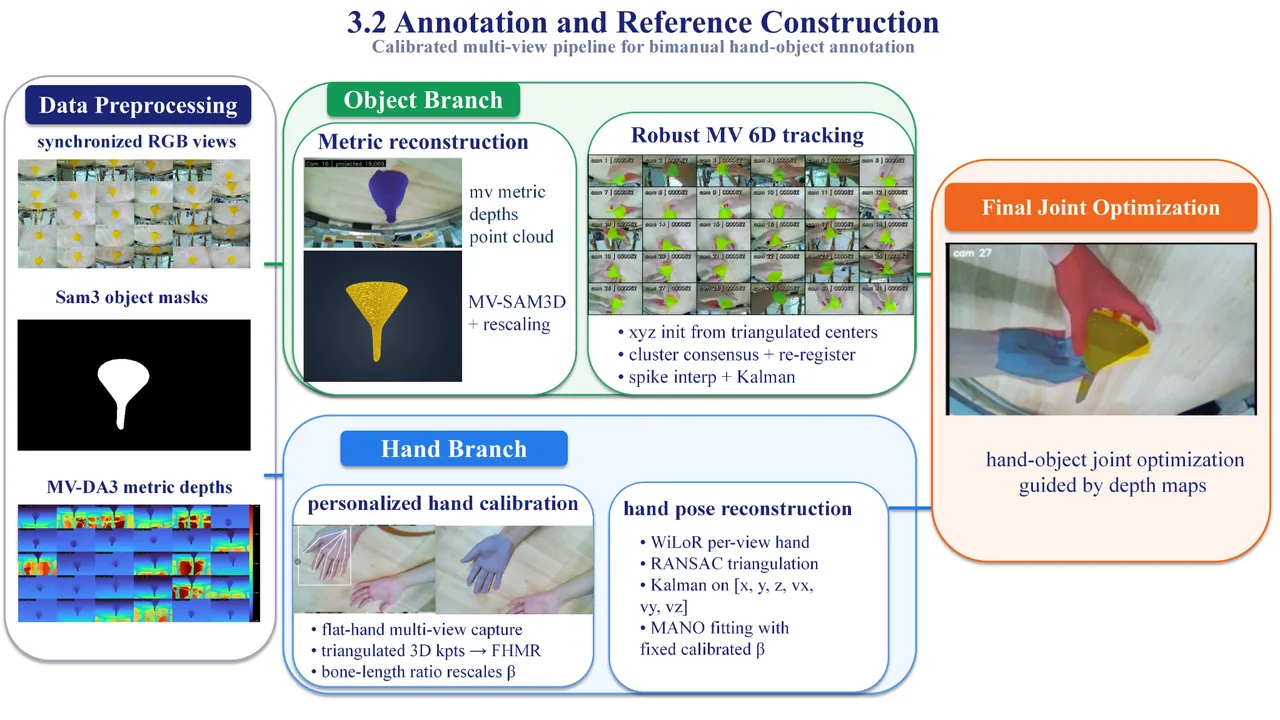
图 2:重建与标注管线(论文 Fig. S1)。同步多视角 RGB 先出 SAM3 掩码与度量深度;物体支路做度量重建与鲁棒多视角六自由度跟踪,手支路做参与者级标定与多视角手姿重建,最后用深度引导的手物联合优化收口。
物体尺度估计刻意避开“规范朝向”这个歧义量:对深度点云与网格采样各算鲁棒主成分跨度,去掉径向离群点后取 1–99 百分位跨度,沿三个主轴排序后逐轴相除,再取中位数:
$$s_{\mathrm{obj}}=\operatorname{median}_{k\in\{1,2,3\}}\frac{e_{k}^{\mathrm{depth}}}{e_{k}^{\mathrm{mesh}}}.\tag{B.2}$$
只转移尺度、保留规范网格自己的朝向;中位数让某一根被遮挡或估坏的轴不至于带偏整体。物体跟踪先用掩码最小面积矩形中心三角化初始化平移、以上一帧被接受位姿初始化旋转,再取可见掩码最大的十个视角各自用 FoundationPose 精化,候选位姿变换到世界系后按几何一致性分组共识;轨迹再经平移尖峰修复与卡尔曼滤波、SO(3) 上的旋转尖峰修复与滤波,最后对融合度量深度做交替 ICP 精化,剔除距离超过 3 cm 的对应点,几何项为点面与点线残差的 0.7/0.3 加权,平移与旋转修正被限制在输入的 3 cm 与 20° 以内。
手支路先做参与者级标定:每只手录一段平手序列,三角化出 21 关节的度量位置,标定初始 MANO 形状,并以 20 根骨骼长度之比估出物理尺度(因为 MANO 形状系数不是全局尺度参数);该标定跨序列复用。WiLoR 给每视角每只手 21 个图像关键点,逐关节用有效双视角对生成三角化假设,重投影残差低于 50 像素者为内点且至少三视角,选中假设再用全部内点重三角化。注意重建阶段按 10 fps 采样,与 30 fps 的采集率不同;每个关节用常速状态向量滤波,测量与加速度过程标准差取 0.01 m 与 0.12 m/s²,缺测时只做预测。MANO 拟合固定形状、只估姿态与全局运动。
最后手与物体在共享度量深度上联合精化,变量是逐帧手姿与全局变换、物体位姿以及全序列共享的一个物体尺度变量,目标为
$$\mathcal{L}=10\,\mathcal{L}_{\mathrm{SDF}}+\mathcal{L}_{\mathrm{reg}}^{h}+\mathcal{L}_{\mathrm{reg}}^{o}+\mathcal{L}_{\mathrm{smooth}}^{h}+\mathcal{L}_{\mathrm{smooth}}^{o}.\tag{B.5}$$
其中 SDF 项把重建几何对齐到由深度构建的符号距离场(MeshSDF 形式沿用 HO-Cap,用交互区 32 个深度视角、3 mm 体素),两个正则项保住手与物体的初始化,两个平滑项正则时间演化。优化分三段:先只开先验与平滑,再激活 SDF 对齐,最后固定位姿精修物体尺度。论文明确指出这里没有显式的接触、穿透、碰撞或吸附损失——手与物体的相对关系完全靠深度场间接约束,这是后面接触代理误差的一个源头。
标准化导出用右手系、+Z 向上的世界系,并保留从重建系到它的 4×4 变换;桌面定义为 z=0,由物体底部的第五百分位估出;MANO 用 45 维轴角姿态、不做 PCA,取平手均值且不加额外均值偏置;物体顶点保留规范坐标,不重中心、不翻轴、不镜像。重定向把每只手 15 个目标(五个 MANO 指尖、五个附加手指关键点、腕部重复五次)拟合到 Wuji 手连杆,SmoothL1 位置损失、过渡尺度 0.02 m,NLopt 优化且关节极限为硬约束,容差 1e-3,以前一帧解初始化、帧间正则 norm_delta 为 4e-3。源运动按 10 fps 解释、转成 30 fps 控制参考;重定向前清理用 30 fps 下每帧 0.10 m 的位移阈值、至多三次去尖峰。最后开环回放筛选按 A–F 六类决定参考资格。
方法详解
4.1 任务定义:一个策略,两只手,一个物体
给定双手与一个物体的参考,一个策略控制两只机器人手通过物理交互复现物体运动。对跨越 T 个控制步的片段,参考记为
$$\tau=\big\{(\hat{\bm{q}}^{L}_{t},\hat{\bm{q}}^{R}_{t},\hat{\bm{p}}^{o}_{t},\hat{\bm{R}}^{o}_{t})\big\}_{t=0}^{T}.\tag{1}$$
其中 t 是帧索引,h 取左或右,带帽量为参考量。每只手的配置含腕部坐标与手指关节角,共 d 个受控坐标;物体位置与朝向分别为三维向量与 SO(3) 旋转。两手配置拼接为 2d 维;不带帽的对应量是仿真状态。物体线速度的参考由有限差分得到。位置、旋转、线速度的单位分别是米、弧度、米每秒。训练沿用 DexTrack 的 PPO 加行为克隆组合,测试时跟踪未见轨迹与物体、不微调。
4.2 参考条件双手控制:观测 3016 维,动作 52 维
单个随机策略从观测预测两只手的关节动作。观测拼接两个按手分块,含本体感知、物体位姿与速度、即将到来的参考目标、参考状态误差、指尖到物体的距离向量;空间特征放在各自腕部航向系下。其后追加 basis point set 形状编码、物体尺度与质心、手的身份标识,以及固定的左手奖励权重;40 个接触力通道被置零——仿真力只用于奖励监督,不进策略输入。附录给出维度账:观测共 3,016 维,等于 2,884 维基础特征加 132 维物体描述子(128 维 BPS 加尺度加质心);每只手 6 个腕坐标加 20 个手指关节共 26 维,两手动作共 52 维。
策略输出有界修正,叠加到下一帧参考上形成 PD 目标:
$$\bm{q}^{\mathrm{pd}}_{t}=\operatorname{clamp}\!\left(\hat{\bm{q}}_{t+1}+\bm{s}\odot\bm{a}_{t},\ \bm{q}_{\min},\bm{q}_{\max}\right),\qquad \bm{a}_{t}\in[-1,1]^{52}.\tag{2}$$
向量 s 给出逐坐标的修正范围:腕部平移 0.1 m、腕部旋转 1.0 rad、手指关节 0.15 rad。修正每步锚定下一帧参考、不累积;PD 控制器执行目标,产生的状态供给下一步观测。
4.3 以物体为中心的按手奖励
手姿精度不保证接触、更不保证物体运动,而两只手可能异步介入、角色不同。因此奖励设计成“物体运动全程在线、每只手的接触只在参考要求时监督”。物体项同时看位置、朝向与线速度的一致性:
$$r_{t}^{\mathrm{obj}}=e^{-\kappa_{p}\|\bm{p}^{o}_{t}-\hat{\bm{p}}^{o}_{t}\|_{2}}\,e^{-\kappa_{R}\angle(\bm{R}^{o}_{t},\hat{\bm{R}}^{o}_{t})}\,e^{-\kappa_{v}\|\bm{v}^{o}_{t}-\hat{\bm{v}}^{o}_{t}\|_{2}}.\tag{3}$$
三个正系数控制对位置、旋转、速度误差的敏感度,实现取 (9, 2, 14)。乘积形式奖励“三者同时一致”,速度项专门惩罚“把动参考按住不动”的静止解;该项与接触门完全独立。
接触监督从参考里读出“哪些指尖此刻必须接触”:记该集合为 C,对指尖 i 记其到物体表面距离与仿真净接触力大小,用力与距离的双重指示函数估接触:
$$\alpha_{i,t}^{h}=\bm{1}[f_{i,t}^{h}>f_{\min}]\ \bm{1}[\delta_{i,t}^{h}<\delta_{\max}],\tag{4}$$
阈值取 f_min 为 0.5 N、δ_max 为 0.03 m。距离条件减少“把碰到别处的力算到物体头上”的误判,但论文也承认净力本身不指明碰撞对象,所以这始终是个代理。对至少有一个必需指尖的手,定义接近项与保持项:
$$r_{t}^{\mathrm{cont},h}=\frac{1}{|\mathcal{C}_{t}^{h}|}\sum_{i\in\mathcal{C}_{t}^{h}}\left[\zeta\, e^{-\kappa_{c}\delta_{i,t}^{h}}+(1-\zeta)\,\alpha_{i,t}^{h}\right],\qquad r_{t}^{\mathrm{hold},h}=\frac{1}{|\mathcal{C}_{t}^{h}|}\sum_{i\in\mathcal{C}_{t}^{h}}\alpha_{i,t}^{h}.\tag{5}$$
κ_c 取 30 每米、ζ 取 0.5。接近项在接触发生前把指尖往物体引;保持项度量“参考要求的接触此刻覆盖了多少”,允许合理的滑动与滚动,因此不是防滑条件。
接触奖励在“参与手集合”(参考此刻要求接触的那些手)上按固定手权加权平均,集合为空时记零:
$$r_{t}^{u}=\begin{cases}\dfrac{\sum_{h\in\mathcal{E}_{t}}w_{h}\,r_{t}^{u,h}}{\sum_{h\in\mathcal{E}_{t}}w_{h}},&\mathcal{E}_{t}\neq\varnothing,\\[4pt] 0,&\mathcal{E}_{t}=\varnothing,\end{cases}\tag{6}$$
手权固定为左手 0.5、右手 1,不做自适应。平均而非相乘是关键:一只手掉接触时另一只手的反馈仍在;把未参与的手排除在外,则避免在参考明确释放物体时还奖励“粘着”。
最后与继承自 Dexplore 的手跟踪项(腕、指关节、关键点一致性的逐手乘积链,其中物体位置与物体旋转子项权重置零以避免与物体项重复计分)加权求和:
$$r_{t}=(1+w_{L})\left[\beta_{\mathrm{hand}}\,r_{t}^{\mathrm{hand}}+\beta_{\mathrm{obj}}\,r_{t}^{\mathrm{obj}}+\beta_{\mathrm{cont}}\,r_{t}^{\mathrm{cont}}+\beta_{\mathrm{hold}}\,r_{t}^{\mathrm{hold}}\right],\tag{7}$$
β 取 (0.25, 0.45, 0.15, 0.15),和为一;(1+w_L) 只设奖励尺度。物体项拿到的权重最高,与方法定位一致:物体运动才是最终裁判。
4.4 从已验证演示学通用策略:CCA 与 PPO+BC
共享 PPO 批次里混着接触模式与协调需求各异的片段。GAE 把时间加权的价值残差累加成优势,但评论家在不同参考上的精度不均,会留下与片段相关的公共偏移:难片段里相对成功的转移也可能拿到一致的负优势。CCA 的做法极其朴素——按参考身份分组,减去组均值:
$$\widetilde{A}_{j}=A_{j}^{\mathrm{GAE}}-\frac{1}{|\mathcal{G}_{m(j)}|}\sum_{k\in\mathcal{G}_{m(j)}}A_{k}^{\mathrm{GAE}}.\tag{8}$$
分组按参考身份而非环境实例或时间阶段,因此同一条参考的并行 rollout 会贡献到同一个基线。只减均值、不除组内标准差,保留片段内部优势差异的尺度;调整发生在 GAE 之后,评论家与时间优势估计都不动,奖励也不动。论文自己点明:这只是均值平移,代数恒等式并不保证它是个无偏的策略梯度估计。
actor 损失把居中后的优势代入标准 PPO 裁剪目标,再加一项对演示库的状态配对回归:
$$\mathcal{L}_{\mathrm{actor}}(\theta)=\mathcal{L}_{\mathrm{PPO}}(\theta;\widetilde{A})+\lambda_{\mathrm{BC}}\,\mathbb{E}_{(\bm{o}^{D},\bm{a}^{D})\sim\mathcal{D}}\left\|\mu_{\theta}(\bm{o}^{D})-\bm{a}^{D}\right\|_{2}^{2},\qquad \lambda_{\mathrm{BC}}=50.\tag{9}$$
演示用独立采样预算(每个 minibatch 4,096 对),不进 PPO 的概率比也不进 GAE;评论家保持标准价值回归。演示准入要过两道门:导出 rollout 必须再次回放成功,且验证检查物体位移与参考要求的抬升。训练用 Isaac Gym 8,192 个并行环境,Adam 常学习率 2e-5,rollout horizon 64、PPO minibatch 16,384、每轮 6 个 epoch、裁剪半径 0.2、折扣 0.99、GAE 迹参数 0.95,每轮 524,288 条环境转移,每 25 轮存一次检查点。
4.5 方法流程总览
flowchart TD
  subgraph DATA["BiHOI 与公开数据"]
    CAM["32 台标定 RGB 相机 30fps"] --> MASK["SAM3 掩码 加 Depth Anything 3 度量深度"]
    MASK --> OBJ["MV-SAM3D 度量重建 加 FoundationPose 六自由度跟踪"]
    MASK --> HAND["WiLoR 关键点 加 参与者级 MANO 标定与拟合"]
    OBJ --> JOINT["深度引导的手物联合精化 10 倍 SDF 项"]
    HAND --> JOINT
    JOINT --> RET["重定向到 Wuji 手 加 开环回放筛选 A 到 F"]
    RET --> POOL["训练池 公开 1845 条 加 BiHOI 1575 条"]
  end
  subgraph LOOP["PPO 加 BC 反馈环"]
    POOL --> ROLL["8192 环境并行 rollout"]
    ROLL --> REW["以物体为中心按手奖励 物体 加 接触 加 保持"]
    REW --> GAE["GAE 优势"]
    GAE --> CCA["CCA 按片段减均值"]
    CCA --> PPO["PPO 裁剪目标"]
    ROLL --> VER["验证成功 位移 加 抬升 加 回放复现"]
    VER --> LIB["演示库 D specialist 加 generalist 成功"]
    LIB --> BC["BC 回归 系数 50 每批 4096 对"]
    PPO --> ACTOR["actor 损失"]
    BC --> ACTOR
    ACTOR --> POL["共享双手策略"]
    POL --> ROLL
  end
图 3:DONIC 方法流程。上段为数据侧:多视角录像经掩码与度量深度、物体与手两条重建支路、联合精化、重定向与筛选进入训练池;下段为训练侧:rollout 产生奖励与 GAE 优势,CCA 居中后进 PPO,验证成功的执行进演示库供 BC,两者合成 actor 损失更新共享策略。
实验结果
5.1 设置、指标与基线
训练参考从 GRAB、GigaHands、OakInk2、TACO、H2O 中筛选:双手与物体都被跟踪、且每只手在片段中某时刻接触物体(不要求同时接触),统一表示、重定向到 Wuji Hand V1 并过回放筛选,得 1,845 条公开训练片段;Ours+BiHOI 再加全部 1,575 条 BiHOI,训练池到 3,420 条。评测留两个 split:unseen-traj 是训练物体的 53 条未见轨迹,unseen-obj 是 164 条含留出物体的片段;两个 split 都不参与策略优化、specialist 训练与演示收集,所有方法同一 split、不微调、每方法一个检查点。
指标扩展 AdaDexTrack 的轨迹保真协议到双手:报告物体平移与旋转误差、腕部平移与旋转误差、20 个手指关节的平均关节误差;腕部误差用机器人正运动学对重定向参考计算,报告的手误差先取两手中较差者的轨迹均值、再对片段平均。成功率要求双手各自独立满足三条门槛:
$$\mathcal{K}(x^{o},x^{h})=\bm{1}\!\left[\frac{x_{p}^{o}+x_{p}^{h}}{2}\leq 10\ \mathrm{cm}\right]\bm{1}\!\left[\frac{x_{R}^{o}+x_{R}^{h}}{2}\leq\frac{\pi}{3}\right]\bm{1}\!\left[x_{f}^{h}\leq\frac{2\pi}{9}\right].\tag{D.6}$$
角门槛 π/3 与 2π/9 即 60° 与 40°。SR 用轨迹均值误差、双手取逻辑与;Comp 则逐帧判定再平均,因此后段的有效帧即使前面违例过也仍计分,它度量的是“满足条件的帧占比”而非“首次失败前的前缀长度”。基线为 DexTrack-bi 与 Dexplore-bi:用各自发布代码、把观测与动作接口改到两只 Wuji 手,共享 DONIC 的公开训练池、Isaac Gym、机器人模型与留出 split。
| 参数 | 取值 |
|---|---|
| 奖励权重 β(hand, obj, cont, hold) | (0.25, 0.45, 0.15, 0.15) |
| 物体项敏感度(位置, 旋转, 速度) | (9, 2, 14) |
| 接触代理阈值(力, 距离) | (0.5 N, 0.03 m) |
| 接触距离敏感度与接近权重 | (30 每米, 0.5) |
| 固定手权(左, 右) | (0.5, 1) |
| 并行环境 / BC 系数 / 每批演示对 | 8,192 / 50 / 4,096 |
| 恢复与物体扰动课程 | 关闭 |
表 2:奖励与通用策略训练设置(论文 Table S2)。奖励指数中的距离用米、旋转用弧度、速度用米每秒。
5.2 主结果:一个检查点通吃两个 split
| Split | 方法 | 物体平移 (cm) | 物体旋转 (rad) | 腕平移 (cm) | 腕旋转 (rad) | 手指 (rad) | SR (%) | Comp (%) |
|---|---|---|---|---|---|---|---|---|
| 未见轨迹 | DexTrack-bi | 41.86 | 2.3340 | 23.03 | 0.8296 | 0.6301 | 0.00 | 1.30 |
| Dexplore-bi | 14.73 | 0.8597 | 21.88 | 0.8412 | 0.3166 | 9.43 | 27.87 | |
| 去 CCA | 11.27 | 0.9585 | 4.34 | 0.2980 | 0.0433 | 81.13 | 62.72 | |
| 去接触门 | 10.26 | 0.9589 | 4.00 | 0.3013 | 0.0338 | 81.13 | 65.03 | |
| DONIC | 10.27 | 0.9277 | 3.96 | 0.2905 | 0.0372 | 86.79 | 67.62 | |
| DONIC+BiHOI | 9.74 | 0.8637 | 3.32 | 0.2818 | 0.0338 | 88.68 | 68.72 | |
| 未见物体 | DexTrack-bi | 127.87 | 2.3532 | 72.83 | 1.0629 | 0.6455 | 0.00 | 0.88 |
| Dexplore-bi | 17.92 | 1.1431 | 19.46 | 0.9509 | 0.3685 | 11.59 | 26.37 | |
| 去 CCA | 16.83 | 1.1464 | 5.52 | 0.3235 | 0.0378 | 48.17 | 43.89 | |
| 去接触门 | 17.61 | 1.2041 | 4.97 | 0.3386 | 0.0371 | 48.78 | 49.52 | |
| DONIC | 15.74 | 1.1310 | 4.58 | 0.3226 | 0.0373 | 57.32 | 54.69 | |
| DONIC+BiHOI | 13.96 | 1.1157 | 4.54 | 0.3206 | 0.0361 | 59.76 | 55.35 |
表 3:不微调的参考跟踪主结果(论文 Table 2)。每方法一个检查点跨两个 split;误差越低越好,SR 与 Comp 越高越好。
在 unseen-traj 上 DONIC 取得 86.79% 成功率与 67.62% 完成率,比更强基线 Dexplore-bi 高 77.36 与 39.75 个百分点;在 unseen-obj 上为 57.32% 与 54.69%,对照 Dexplore-bi 的 11.59% 与 26.37%。手部跟踪同样改善:腕部平移误差在未见轨迹上从 21.88 cm 降到 3.96 cm,在未见物体上从 19.46 cm 降到 4.58 cm。除 unseen-traj 的物体旋转外,DONIC 的所有报告误差都低于两个基线。由于 SR 与 Comp 要求双手同时达标,这些提升反映的是“双手协调地把事情做成了”,而不是某一只手单独准。
基线的失败模式也值得看:Dexplore-bi 手在动但物体几乎不动——它的奖励与参考范围探索在双手场景下没能把力传到物体上;DexTrack-bi 则丢掉手物对齐,specialist 蒸馏的接口在两只手上失配,未见物体上物体平移误差高达 127.87 cm。定性对比里 DONIC 两手配合复现参考的物体运动,而两个基线要么物体不动、要么手与物体脱节。
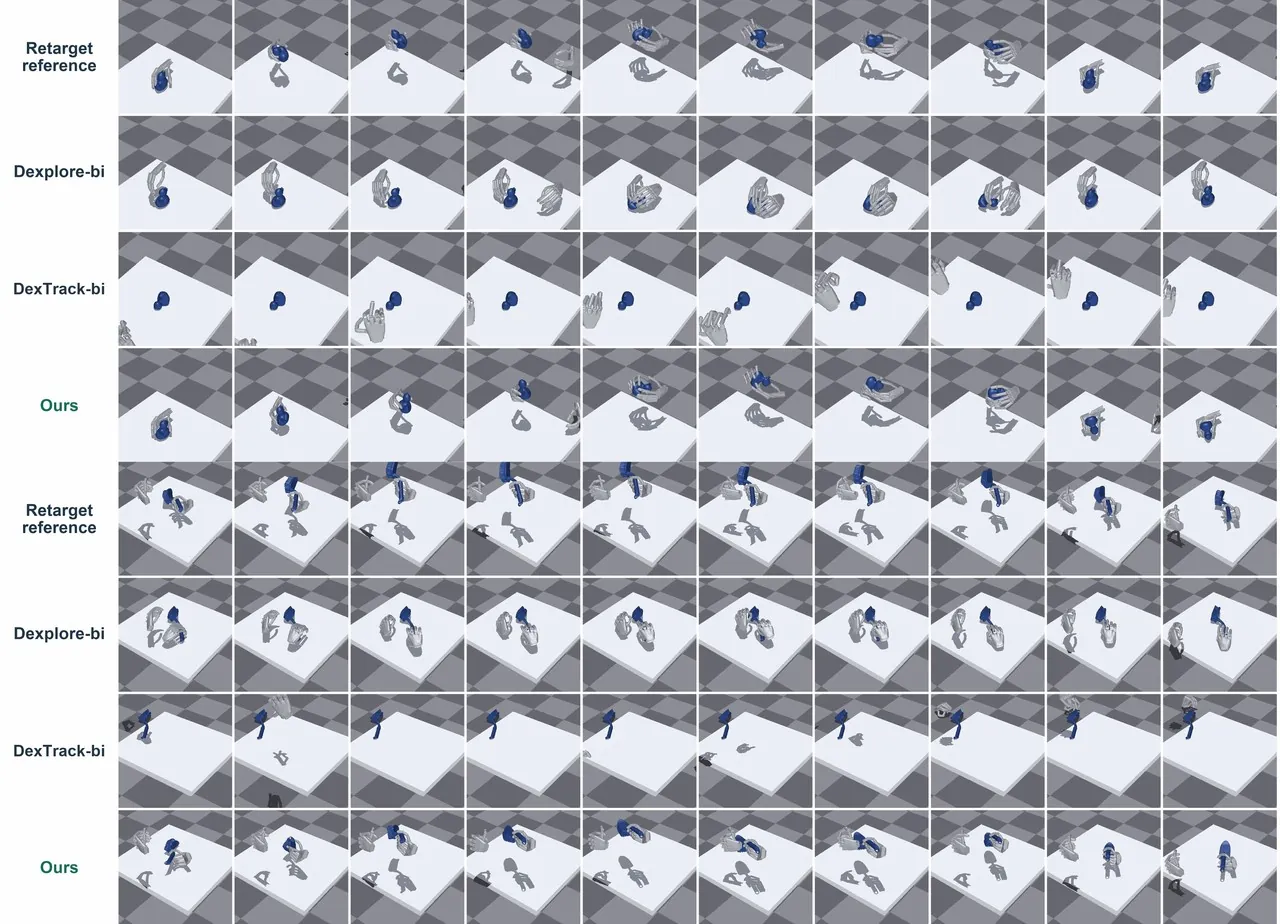
图 4:两条留出物体轨迹的定性对比(论文 Fig. 3)。每组四行依次为参考、Dexplore-bi、DexTrack-bi、DONIC,时间从左到右;DONIC 复现了参考的手物协调与物体运动。
5.3 消融:两个学习信号都必要,BiHOI 是净增量
去掉 CCA,成功率在未见轨迹上从 86.79% 掉到 81.13%、在未见物体上从 57.32% 掉到 48.17%,完成率同步下降且五项跟踪误差全部变差。去掉接触归属门(把力加距离的代理换成只看力大于 0.5 N),成功率掉到 81.13% 与 48.78%;有意思的是这个变体在个别误差上反而更低,但完成率在两个 split 上都更低——单看误差会得出错误结论,双手联合成功才是这套方法的目标函数。两个学习信号因此都被消融支持。
把全部 1,575 条 BiHOI 加进训练池(1,845 到 3,420 条),七个指标在两个 split 上全部改善:成功率到 88.68% 与 59.76%,完成率 68.72% 与 55.35%,未见物体平移误差从 15.74 cm 降 11.3% 到 13.96 cm,并在未见物体上全部指标排第一。训练库存与接触比例如下表:公开池里 H2O 的双手接触比例最高(38.57%),TACO 最低(15.69%),BiHOI 的 65.91% 是它们的近两倍。
| 来源 | 训练序列数 | 双手同时接触 (%) |
|---|---|---|
| GRAB | 505 | 32.21 |
| GigaHands | 592 | 34.74 |
| OakInk2 | 449 | 24.97 |
| H2O | 127 | 38.57 |
| TACO | 172 | 15.69 |
| 公开池合计 | 1,845 | 31.40(池化口径) |
| BiHOI | 1,575 | 65.91 |
| 公开池 + BiHOI | 3,420 | – |
表 4:训练库存与双手同时接触比例(论文 Table S1)。比例为双手接触帧除以至少单手接触帧、跨被分析录制池化;公开池若以全部帧为分母则为 22.56%。
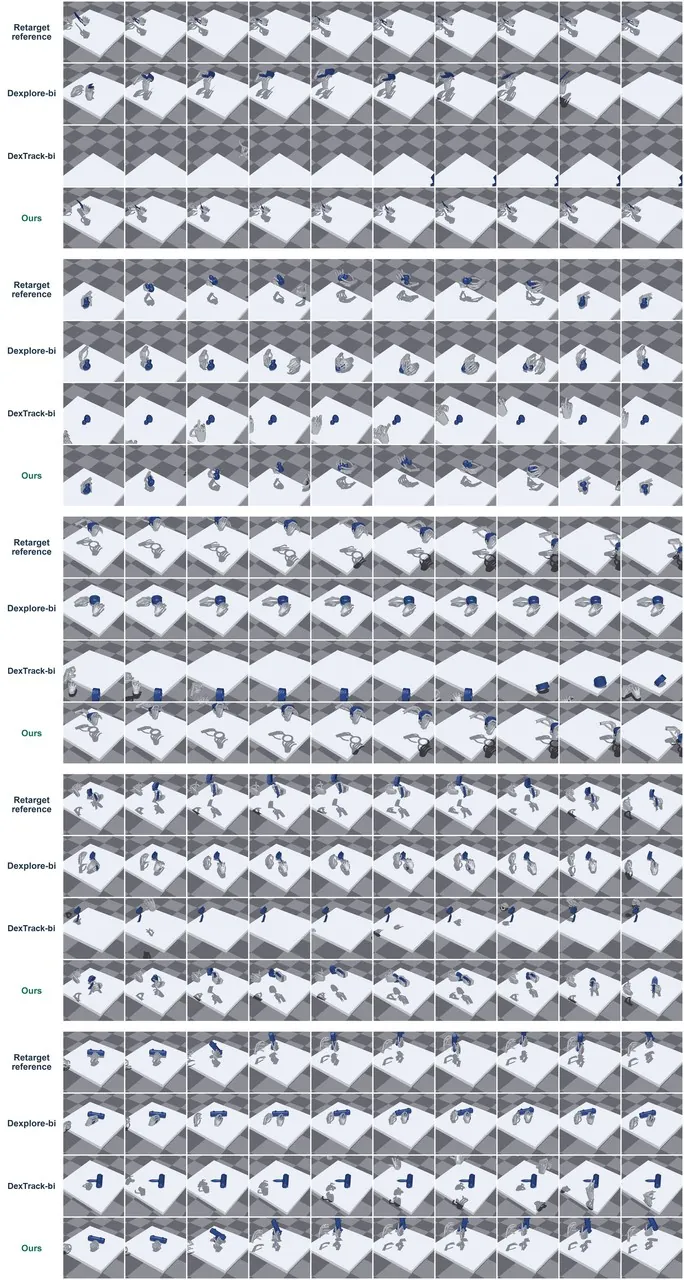
图 5:五组双手操作序列的定性对比(论文 Fig. S2)。每组内四行依次为参考、Dexplore-bi、DexTrack-bi、DONIC;基线表现为物体运动有限或手物对齐丢失。
代码对照
仓库放出的 bihoi_pipeline(CC BY-NC 4.0)与论文附录 B.2 的公式能逐行对上,这是本文少见的“公式即代码”的开源质量。物体度量尺度对应 run_mv_sam3d_metric_scale.py 的 estimate_metric_scale:鲁棒主成分 extent 用 1% 与 99% 百分位(robust_point_extent 的 q=0.01),三轴比例取中位数,与式 B.2 完全一致:
mesh_extent, mesh_center_robust, _ = robust_point_extent(mesh_pts, q=0.01)
ratios = np.asarray(real_extent_m, dtype=np.float64) / np.asarray(
    mesh_extent, dtype=np.float64
)
# Sorted PCA extents are orientation-independent up to axis permutation.
# Median across the three dimensions is robust to one imperfect/occluded axis.
scale = float(np.median(ratios))
导出表示里“桌面 z=0 取物体底部第五百分位”对应 export_standardized_mano_object_table_4rings_first500.py 的 estimate_table_height_from_object(默认 percentile=5.0,命令行 --table_bottom_percentile 默认 5.0),MANO 用 45 维轴角、非 PCA、平手均值,与附录 B.2 的导出约定一致。式 B.5 的权重与体素在联合优化脚本里是明文的命令行参数:
--joint_total_steps 160 \
--joint_sdf_steps 60 \
--w_sdf 10.0 \
--sdf_voxel_size 0.003 \
--sdf_expected_cam_count "$SDF_CAM_COUNT"
10.0 即式 B.5 里 SDF 项的十倍权重,0.003 即 3 mm 体素,160 与 60 步对应“先先验与平滑、后激活 SDF”的分段优化。一处口径差值得记下来:论文写采集用 32 台相机、联合精化用交互区 32 个深度视角,而这条脚本的相机列表与 rename_videos_31cam.py 的命名默认是 31 台(--sdf_expected_cam_count 校验的也是它),即管线默认把一台相机排除在 SDF 构建之外;读代码时不要把它当论文笔误,也不要当代码 bug,而是“采集 32、SDF 默认 31”的实现口径。训练代码、检查点与 BiHOI 数据尚未放出,策略侧的所有数字目前只能以论文为准。
局限性
作者自述(附录 D.6):定量实验只评仿真内、参考条件、单刚体物体的跟踪;无约束的目标条件操作与留出操作类别的泛化不在评测内;采集库存里的物体类型比单刚体表示更广(关节与形变物体在控制侧被当作固定网格加刚体位姿);接触监督是净力加距离的代理;重建没有显式接触或碰撞损失。
我们的判断还有四条。其一,BiHOI 在实验里只以“训练增量”的身份出现(Ours+BiHOI 一行),没有留出的 BiHOI 测试 split,因此这个数据集自身的泛化价值没有被独立度量——65.91% 的双手接触比例是描述统计,不是因果证据。其二,CCA 是经验均值平移,论文自己承认代数恒等式不等于无偏梯度估计;而且组均值要估得稳,依赖 8,192 个并行环境、每轮 52 万条转移的批量规模,小算力复现时同一片段的样本数变少,收益很可能缩水,这条设计的可迁移性存疑。其三,全部结论建立在 Isaac Gym 与 Wuji 手上,没有真机验证;0.5 N 与 3 cm 的接触代理阈值在仿真接触模型里调过,真机传感噪声与接触估计误差下是否仍成立未知。其四,SR 的双手门槛很严格,但也意味着失败案例没有被分解报告——57.32% 之外的那 42.68% 里,是哪只手、哪个阶段(接近、抓持、抬升、释放)失败,论文没有给出统计,读者无法判断剩余误差集中在哪里。
总结与展望
DONIC 的贡献不在某个新网络,而在把“双手”这件事拆成三个可独立验证的设计:数据上补持续双手接触的密度(BiHOI),奖励上把物体运动与按手接触监督解耦(以物体为中心的按手奖励),优化上把片段难度差异从优势里摘出去(CCA)。三者叠加,一个检查点在两类留出 split 上不微调地大幅超过双手化基线,且消融逐条支持每个设计。它给出的也是一条务实的路线:先用多视角重建与重定向把人类演示变成仿真里可执行的参考,再让强化学习在物理里把参考变成真的操作。
下一步值得盯三件事:留出 BiHOI 的独立评测与更长时程、多物体操作的扩展;从仿真到真机双手平台的迁移,尤其是接触代理阈值在真实传感下的标定;以及 CCA 在小批量、少环境设置下的行为——如果它只是大批量的红利,那它的普适性就要打折。对做双手灵巧操作的团队,BiHOI 的重建管线(已开源)今天就能用,策略侧则需等训练代码与数据放出。
金句
“手姿精度不等于操作成功:物体动没动,才是双手操作最终的裁判。”
“难片段里相对成功的动作,不该因为整条片段难而被一致地打负分——减掉片段自己的均值,留下片段内部的差异。”
“一只手掉接触时,另一只手的反馈必须还在;参考释放物体时,粘着不该被奖励。”