PAPER DEEP DIVE
GPT-6 Astra具身策略系统评测
六域评测GPT-6 Astra具身策略:混合控制RoboDojo成功率48%、导航RxR达92%,但手内操作与密集步态仍不可靠,推理延迟制约实用控制。
论文:Systematically Exploring the Capabilities of GPT-6 Astra as Embodied Policies
作者:Galbot Team(Xuchuan Chen、Xiaoqian Cheng、Yu Deng、Lihe Ding、Shaocong Dong、Xiangjun Gao、Haozhe Jia、Zekai Li、Zhoujian Li、Yunrui Lian、Sikai Liang、Chenghuai Lin、Dairu Liu、Jiahang Liu、Qingtao Liu、Yuxuan Ma、Zekun Qi、Jiayi Su、He Wang 等)
时间 / 分类:2026 年 9 月 · arXiv:2609.38537v1 [cs.RO]
链接:arXiv 摘要页 · 项目页 · 代码仓库(GPT-as-Policy) · 交互式网页报告
代码状态:已公开。匿名仓库 GPT-as-Policy 与项目页、网页报告一同发布,网页报告包含全部视频案例与逐任务轨迹。
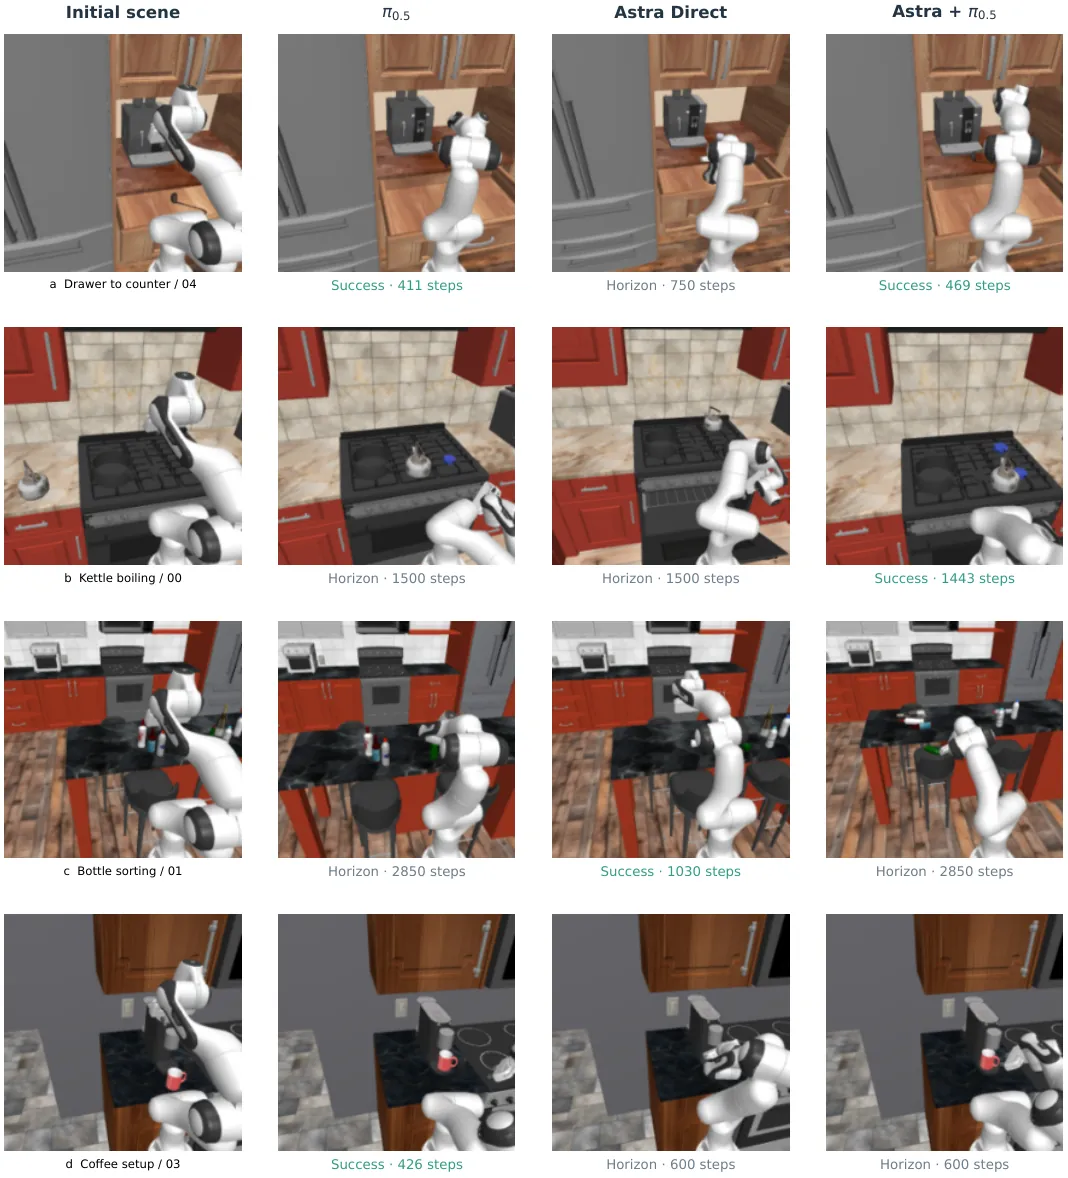
图 1:RoboCasa365 匹配物理起点上的对照。四行是四个任务/种子组合,列依次为初始场景、单独 π0.5、Astra Direct、Astra + π0.5 的终局画面;咖啡摆杯一例只有单独策略成功,回收瓶一例只有 Direct 成功。
一句话总结
这份报告把 GPT-6 Astra 当作能直接输出数值动作的策略,在夹爪操作、灵巧操作、移动操作、导航、运动、人形移动操作六个域中系统测量"会做任务决策"与"能可靠产生物理效果"之间的差距。
研究背景与动机
社区围绕 Astra 的实验已经展示出从三维场景理解、real-to-sim 工作流到机器人操作的多种可能。这些演示提出了一个必须正面回答的问题:当一个推理模型可以直接生成机器人动作时,它究竟能完成哪些任务、在哪些环节持续不可靠、以及它的每一次决策要花多少资源?只报告成功案例无法回答这个问题,因此评估必须同时覆盖成功与失败。
既有的相关工作大致分三类。一类是空间理解与面向机器人动作的推理;一类是视觉-语言-动作模型,例如 π0.5,它把观测与指令映射为从机器人经验中学到的动作;还有一是把语言或程序接入控制的方法,如 SayCan 选择可落地技能、Code as Policies 用程序组合感知与控制、Prompt a Robot to Walk 与 Natural Language as Policies 探索数值反馈控制。近期对 Astra 的操作评测也报告了任务间不均匀的表现。这些工作各自回答了局部问题,但缺少一个跨域、跨控制结构的统一测量。
本文的切入点是把"控制路径"作为一等公民。作者区分两种结构:Direct 指 Astra 自己生成机器人命令、由解析控制器(逆运动学加比例-微分控制)执行;Hybrid 指 Astra 与一个学习到的任务策略或全身控制器合作,要么审查并修改策略的动作提案,要么向冻结的控制器提供命令或运动参考。同一个模型在这两种结构下的表现差异,恰好暴露出哪些能力来自模型决策、哪些能力来自接口与控制器。
选择六个域也有明确意图。夹爪与灵巧操作检验抓取、局部修正与接触变化;移动操作加入底盘-手臂协调与多阶段目标;导航检验空间决策与停止判断;运动要求身体本身的协调运动;人形移动操作则把任务推进交给预训练全身控制器。每个研究保留其原生指标与协议,使结论的适用范围显式可见,而不是把所有结果压成一个总分。
预备知识:动作、接口与控制路径
在本文的术语里,一个"动作"是提交给机器人控制接口的一条命令:目标位姿、关节增量或导航移动都可以是动作。Astra 接收研究允许的观测,选出一个动作,再用执行后的反馈选择下一个动作。接口负责检查命令边界,环境负责判定任务是否成功;工具则支撑计算、图像检查与记录。这个闭环定义使得"策略"一词不再绑定某种网络结构,而是绑定到决策-反馈循环上。
Direct 与 Hybrid 的差别在于动作由谁产生。Direct 中 Astra 的命令不经过任何学习策略或全身控制器,逆运动学与 PD 控制即可实现;Hybrid 中则存在一个学习组件。在操作任务里,Hybrid 表现为 Astra 接受、修改或替换任务策略的动作提案,RoboCasa 还允许重写子目标指令;在人形控制里,Hybrid 表现为 Astra 向冻结的全身控制器提供密集运动参考、速度命令或稀疏身体目标。运动研究两者兼有:既有直接关节 PD 目标,也有交给 ScaleTrack 执行的参考。
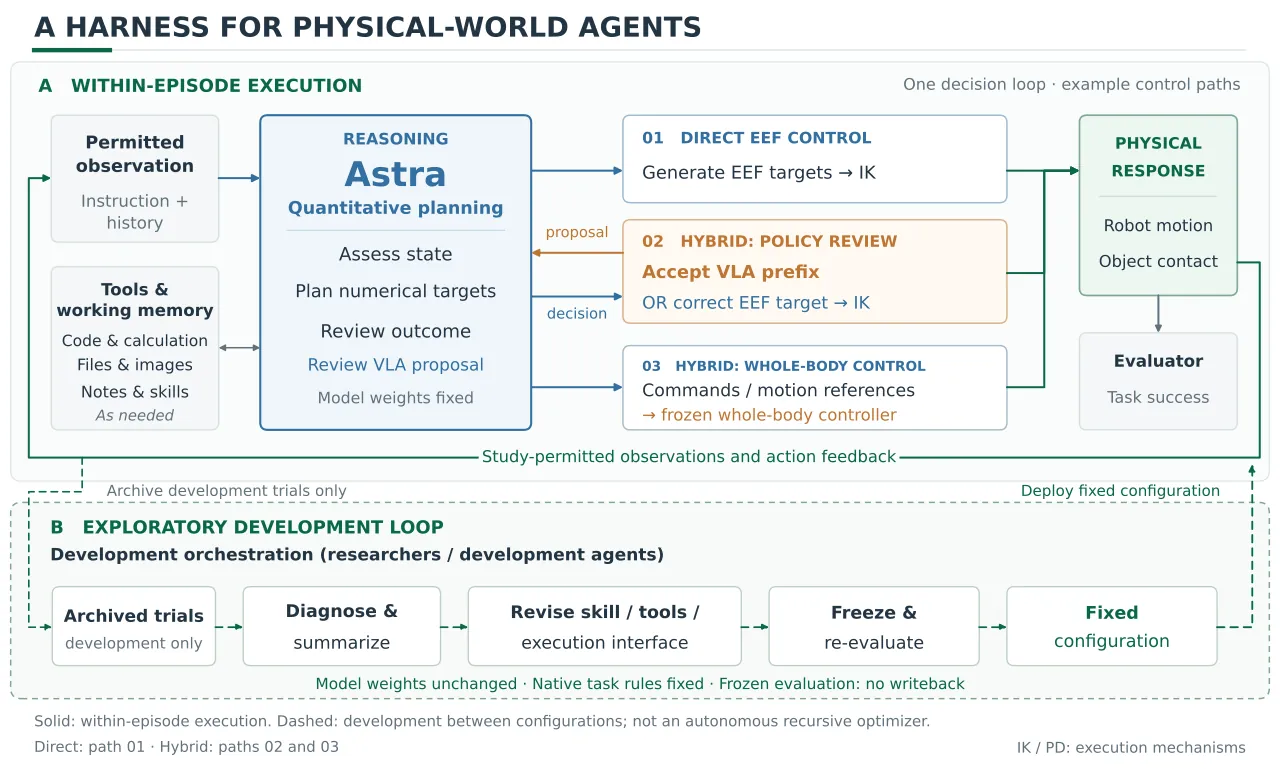
图 2:执行回路与开发回路。上半部分是单回合内的三种执行路径(Direct 末端控制、Hybrid 策略审查、Hybrid 全身控制),下半部分是研究者与开发智能体在评测之外修改指引、工具与接口的探索回路;模型权重在评测中保持冻结。
还有一个容易被忽略的区分:控制器频率与推理速度是两回事。控制器可以很快地执行动作,而 Astra 可能花长得多的时间决定下一条命令。当物理在推理期间暂停时,机器人运动时钟就不包含决策延迟。因此资源统计必须把控制步、动作段、模型请求、缓存输入/未缓存输入/输出 token 分开记录,而不能只看运动时长。
评测设计详解
夹爪操作。RoboDojo 与 RoboLab 上比较两套闭环结构。Direct 让 Astra 依据图像、本体感知、指令与执行历史生成双臂末端目标与夹爪命令,执行 1 到 5 个控制步后重新观测。Hybrid 让任务微调的 π0.5 提出一段 50 步关节空间序列,Astra 审查后要么执行其前 1 到 15 步,要么用 1 到 5 步的末端修正替换,两分支互斥。两种结构共用任务描述、成功判据、推理设置与末端执行接口。RoboDojo 按公开 π0.5 成功率分层选 10 个任务(最低区间 6 个、次低 2 个、较高两区间各 1 个),每任务每结构 5 次;RoboLab 则是单臂 Franka 的 10 个零样本任务,基线使用 DROID 训练权重。
灵巧操作。第一个基准用仿真 Sharpa 手覆盖抓取、取物、放置、插入、堆叠与重排,一个多任务 π0.5 在每任务 100 条演示(共 1000 条)上微调。Direct、单独 π0.5 与 Hybrid 在每任务同样 5 个未见案例上测试,仿真时长 20 到 60 秒。策略动作的维度由两个腕部位姿(3 个位置加 6 维旋转表示)与每只手 22 个关节角构成:
$$2\times(3+6)+2\times 22=62$$
评分采用 0 到 100 的部分完成分而非二元成功。对方法 m、任务 t、案例 i 的内部得分 s,任务分与总分按等权聚合:
$$S_{t,m}=\frac{100}{5}\sum_{i=1}^{5}s_{t,i,m},\qquad S_{m}=\frac{1}{10}\sum_{t=1}^{10}S_{t,m}.$$
完全得分要求任务特定的验证:保持的抓握或稳定的释放。第二个研究是 DexJoCo 的汉诺塔双盘堆叠,用双 Franka 加 Allegro 手完成两次有序转移;Astra 审查为该任务训练的固定 π0.5,接受动作前缀或修正腕部与手指目标,每回合最多 1500 个 50 Hz 控制步。第三个研究把"已建立抓握之后"单独拎出来:从保存的手/物状态出发,比较 Astra 直接关节命令与四个冻结的任务特定 RL 策略,物理起点配对但观测与决策频率不同。
手内研究用四元数测地误差度量朝向跟踪,达到目标要求误差低于 0.1 弧度:
$$e_{t}=2\arccos\!\left(\left|\langle q_{t},q_{t}^{\star}\rangle\right|\right),\qquad e_{q}(t)<0.1\,\mathrm{rad}$$
作为对照的 RL 策略用连续旋转奖励训练,其中包含误差倒数项、达标指示、动作平滑惩罚与接触奖励:
$$r_{t}=\Delta t\left[\frac{0.02}{e_{t}+0.1}+\mathbb{I}(e_{t}\leq 0.1)-10^{-6}\lVert\mathbf{a}_{t}-\mathbf{a}_{t-1}\rVert_{2}^{2}+0.02r_{t}^{\mathrm{contact}}\right]$$
平移与"平移加旋转"任务另有奖励设计。平移奖励惩罚位置误差平方、姿态漂移、力矩范数与做功,并重罚高度不足与倾斜:
$$\tilde{r}_{t}^{\mathrm{trans}}=-100e_{p,t}^{2}+10I_{p,t}-0.3D_{\mathrm{pose},t}-0.1D_{\tau,t}-2D_{\mathrm{work},t}-1000D_{z,t}-170D_{\mathrm{tilt},t}$$
其中 e 为位置误差、I 为达标指示。加入旋转后,奖励在平移奖励基础上替换指示项并加入朝向误差与趋近速度项:
$$\tilde{r}_{t}^{\mathrm{trans+rot}}=\tilde{r}_{t}^{\mathrm{trans}}-10I_{p,t}+10I_{p,t}I_{\theta,t}-2e_{\theta,t}^{2}+15v_{\mathrm{toward},t}+10I_{\theta,t}$$
Allegro 侧的执行规则是归一化关节目标增量累加:模型给出 16 维向量 a 后,原生控制器执行 q 目标更新并做关节限位裁剪:
$$q_{\mathrm{target}}\leftarrow q_{\mathrm{target}}+0.04167\,a$$
移动操作。RoboCasa365 上固定 15 个任务(原子 seen、复合 seen、复合 unseen 各 5 个),每任务 5 个种子,共 75 回合每条件。三个条件共享初始状态指纹、PandaOmron 机器人、控制器、任务时长与原生成功检查。Astra 只拿到三路 RGB 与末端/底盘/夹爪状态,没有物体位姿、接触真值、参考轨迹或中间奖励。Hybrid 额外接入一个冻结的多任务 π0.5 检查点,Astra 可以接受 20 步前缀、自己构造动作、或把策略指令重写为子目标。
导航。四个固定子集各 50 回合:R2R 与英文 RxR 的 val-unseen,以及 MP3D 与 HM3D 的 ObjectNav 验证集。Astra 只看一张 512×384 前视 RGB、指令或物体类别、步数计数与动作反馈;GPS、罗盘、深度、语义标签、目标坐标与评测距离全部 withheld。适配器把模型输出转成 0.25 米前进与 30 度转向的离散原语,预算 500 个原语。成功要求 VLN-CE 在目标 3 米内 STOP,或 ObjectNav 严格落在标注视点集合 1 米内。
运动与人形。运动研究保留 PASSAGE 的场景对齐 25×65 表示与冻结的 G1 ScaleTrack 控制器,只把其学习到的运动生成器换成 Astra;每次提案覆盖 0.5 秒 50 Hz 的根高度、投影重力、平面速度、偏航率与 29 个关节的位置速度,共 1625 个自洽数值。Astra 在同一开放 clutter 课程上做五次顺序尝试,后续尝试保留进展、跌倒与碰撞的文字总结,第五次前还获得一段重定向行走片段。人形部分在 HumanoidBench 的 30 个可执行任务上让 Astra 指挥冻结的 Humanoid-GPT 控制器,在 SIMPLE 的 6 个 L2 任务(每任务 10 场景)上用冻结的 ScaleBFM 并通过经验修订书面指引。
flowchart TD
  O[观测
RGB 图像 + 本体感知 + 执行历史] --> M{控制模式}
  M -->|Direct| D[Astra 输出末端目标
有界阻尼最小二乘 IK + PD 执行 1-5 步]
  M -->|Hybrid 操作| P[pi0.5 提出 50 步关节序列]
  P --> R[Astra 审查提案]
  R -->|接受前缀 1-15 步| E1[执行政策前缀]
  R -->|替换为 1-5 步修正| E2[Astra 末端修正]
  M -->|Hybrid 人形| H[Astra 给速度或稀疏五点目标]
  H --> W[冻结全身控制器 50 Hz]
  D --> PHY[物理响应
接触变化与任务判定]
  E1 --> PHY
  E2 --> PHY
  W --> PHY
  PHY --> O
图 3:本文评测的三条控制路径。Direct 由 Astra 直接产命令;Hybrid 操作中 Astra 审查或替换 π0.5 提案;Hybrid 人形中 Astra 向冻结全身控制器供命令。所有路径都回到观测形成闭环。
实验结果
夹爪操作:合作收益依赖任务结构。RoboDojo 上 Hybrid 成功 24/50(48%),Direct 13/50(26%),平均分 62.60 对 37.81;把公开结果重加权到同一任务与场景混合后,π0.5 只有 15.67% 成功率与 24.43 分。提升集中在长时程与接触敏感任务:序列模仿 53 对 0、搭塔 64 对 12、叠衣 100 对 40、投瓶 100 对 36;而语言分类与物体分类上 Direct 反而更高(60 对 38、100 对 71)。在 50 条 Hybrid 轨迹的 42750 个执行控制步中,36576 步(85.6%)跟随 π0.5,6174 步(14.4%)由 Astra 生成或修正——模型是选择性介入,而非接管。
RoboLab 的排序则完全相反:Direct 49/50(98%),Hybrid 46/50(92%),而 π0.5、Cosmos3-Nano-Policy、DreamZero 只有 36%、36%、34%。作者的解释很直接:RoboLab 以单臂语义取放为主,Direct 已能从当前观测规划;当一个零样本策略本身只有 36% 成功率时,它的提案未必是有用的先验,Hybrid 反而要花决策去修正一个不适应任务的候选动作。两个基准的对照说明,策略协助的价值取决于学习到的运动先验与任务的匹配程度。
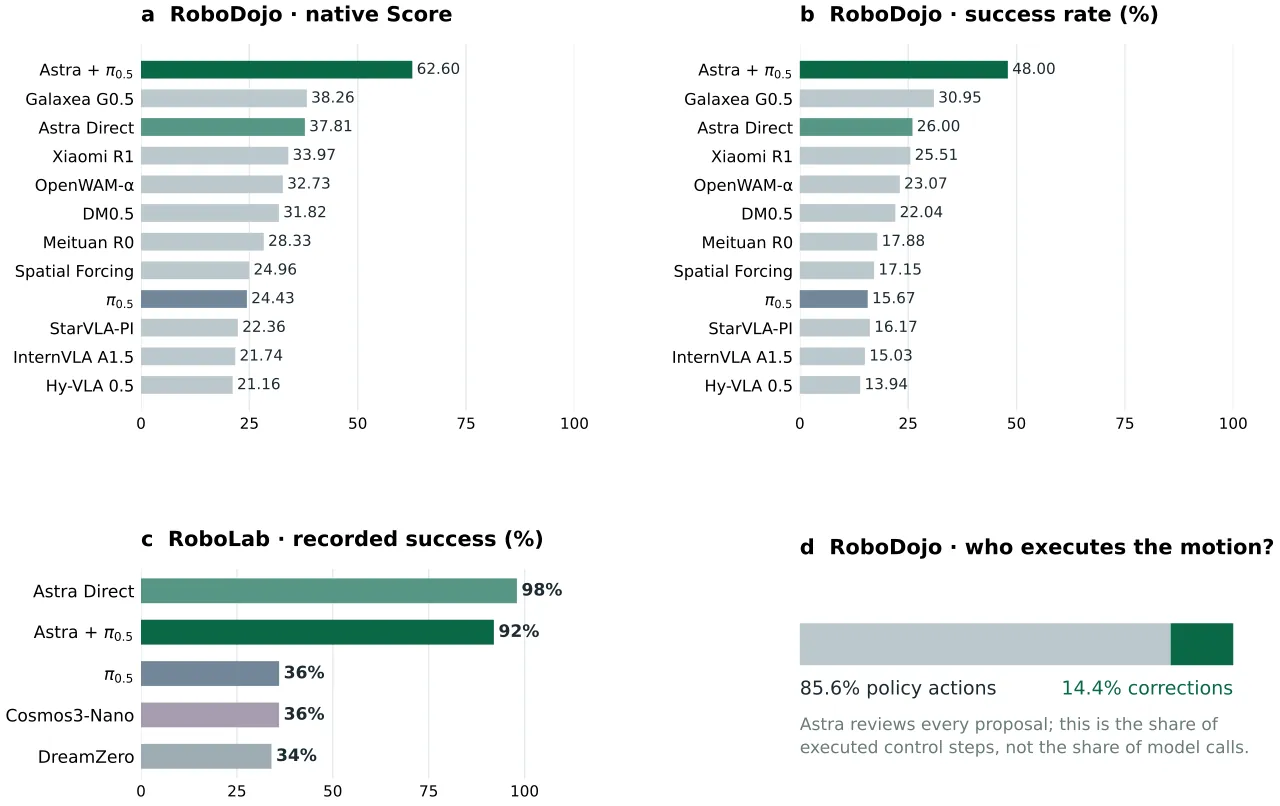
图 4:夹爪操作结果。(a)(b) RoboDojo 原生 Score 与成功率,Astra+π0.5 居首;(c) RoboLab 记录成功率,Direct 98% 最高;(d) Hybrid 执行步中 85.6% 来自策略、14.4% 来自 Astra。
| 基准与条件 | 成功率 | 平均分(0-100) | 说明 |
|---|---|---|---|
| RoboDojo · Hybrid | 24/50 = 48% | 62.60 | 10 任务 × 5 次,与 Direct 配对同种子 |
| RoboDojo · Direct | 13/50 = 26% | 37.81 | Score 用 48 个有效条目,成功率用全部 50 例 |
| RoboDojo · 公开 π0.5 重加权 | 15.67% | 24.43 | 重加权到同一任务与场景混合 |
| RoboLab · Direct | 49/50 = 98% | — | 零样本任务,9 个任务满分 |
| RoboLab · Hybrid | 46/50 = 92% | — | 比 Direct 少 3 条成功轨迹 |
| RoboLab · π0.5 / Cosmos3 / DreamZero | 36% / 36% / 34% | — | DROID 权重零样本迁移 |
灵巧操作:小比例修正带来大收益,但抓握获取仍是瓶颈。十任务基准上 Hybrid 平均 61.6 分,π0.5 为 44.2,Direct 仅 16.6;Hybrid 在全部十任务上高于 Direct,在八任务上高于 π0.5。麻将收纳、立蛋放置、瓶罐分拣的增益达 40、32、28 分。而 Astra 的介入只占 Hybrid 执行步的 11.98%。DexJoCo 汉诺塔堆叠在经验引导的十回合中完成 5 回合,73.6% 的执行步使用未修改的策略动作;这十回合与五次回顾共记录 6360 万 token,其中仅 13.6 万用于回顾——即便策略提供大部分物理动作,token 消耗仍主要发生在线控制阶段。
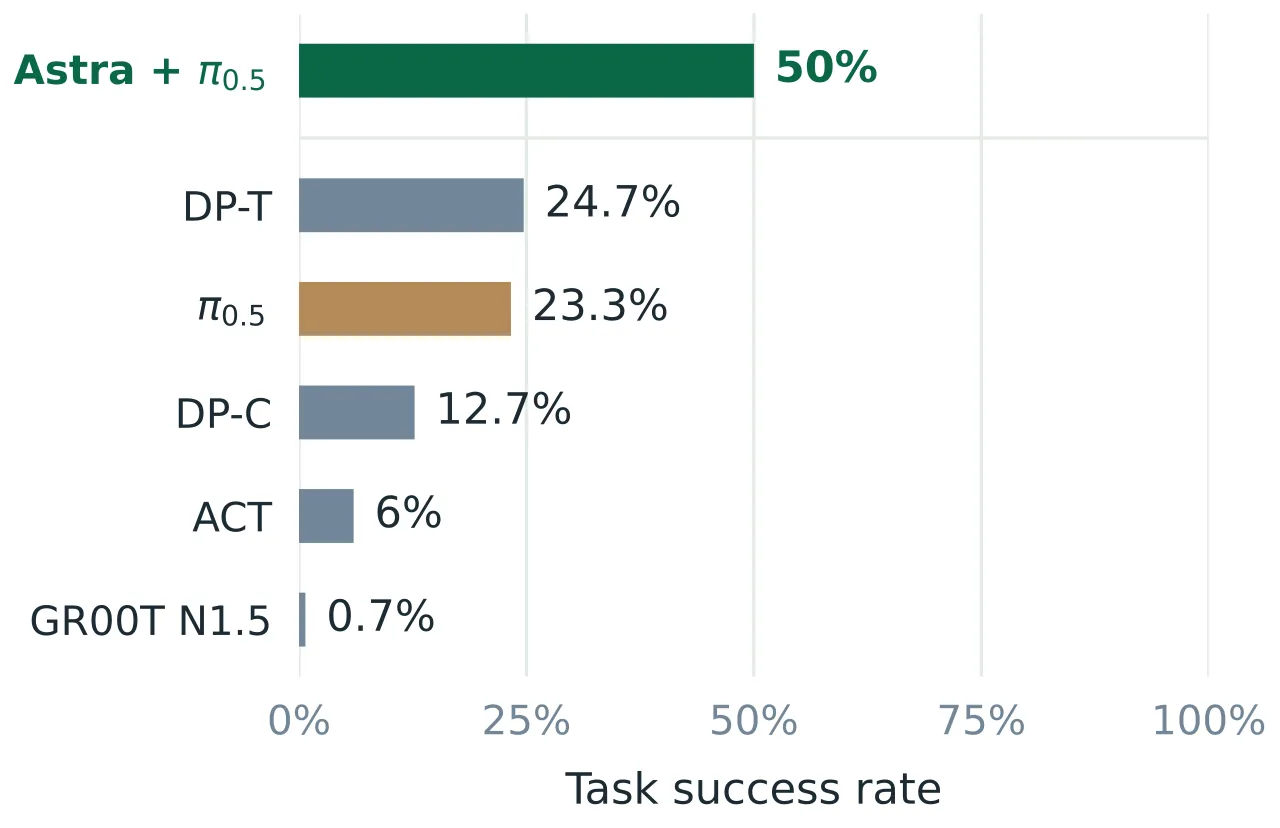
图 5:双盘堆叠成功率。Astra+π0.5 在经验引导回合中达 50%,高于 DP-T 24.7%、π0.5 23.3%、DP-C 12.7%、ACT 6% 与 GROOT N1.5 0.7%。
手内对照给出了最锋利的负面结果。圆柱旋转上 RL 在 76.90% 的步内保持目标朝向,Astra 只有 0.51%;立方体上为 63.50% 对 4.40%。立方体情形尤其说明问题:两种控制器都在五个时程内保住了物体,但 Astra 转得太慢——差距在"保持"与"推进"之间,而不是掉不掉物体。平移任务 Astra 成功 1/5、RL 4/5(终端误差 59.05 对 17.29 毫米);平移加旋转 Astra 0/5,RL 在匹配终点 4/5、15 秒后 5/5。Astra 的 120 次决策预算在 6.00 到 7.65 秒就用完,而 RL 在同样时长内已更好,因此更长的动作时程并不能解释差距。
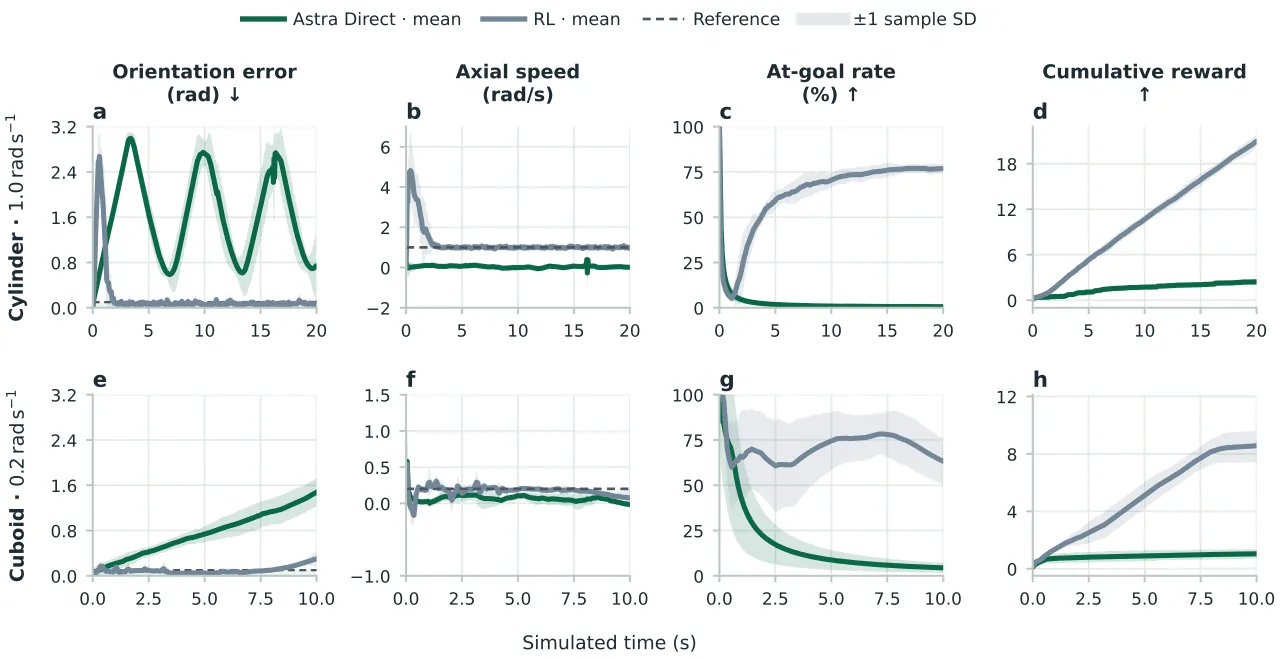
图 6:五个配对初始状态上的连续旋转。上排圆柱 20 秒、下排立方体 10 秒,列为朝向误差、轴向速度、累计达标率与累计奖励;Astra 的圆柱速度几乎为零,立方体缓慢落后于目标速度。
| 任务 | 控制器 | At-goal 步占比 | 误差(rad) | 速度 MAE |
|---|---|---|---|---|
| 圆柱 20 s | Astra Direct | 0.51% | 1.626 | 0.960 |
| 圆柱 20 s | 任务特定 RL | 76.90% | 0.173 | 0.276 |
| 立方体 10 s | Astra Direct | 4.40% | 0.742 | 0.143 |
| 立方体 10 s | 任务特定 RL | 63.50% | 0.096 | 0.063 |
移动操作:协助改变能力剖面而非整体抬高。RoboCasa365 上 Hybrid 完成 29/75(38.7%),Direct 25/75(33.3%),单独 π0.5 17/75(22.7%)。分组看,原子 seen 上 Hybrid 与单独策略同为 52% 而 Direct 只有 28%;复合 seen 上 Hybrid 28% 领先;复合 unseen 上 Direct 56% 反超 Hybrid 的 36%。配对起点上 Hybrid 独占 13 个成功、Direct 独占 9 个、共享 16 个,精确 McNemar 检验 p=0.5235,说明两者并非简单包含关系。66/75 回合使用了指令重写,重写指令条件化了 72.6% 的提案;执行步中 55.2% 来自被接受的策略动作、44.8% 来自 Astra。更值得警惕的是反向案例:CoffeeSetupMug 与 WashLettuce 在五个种子上两种 Astra 条件全败,而单独策略分别完成 3 例与 2 例——接入策略并不保证保留策略已有的成功。
导航:成功率领先,搜索效率暴露短板。四个子集上 Astra 取得 R2R 39/50(SR 78、SPL 65.27)、RxR 46/50(SR 92、SPL 77.25)、MP3D 28/50(SR 56、SPL 22.43)、HM3D 41/50(SR 82、SPL 43.69)。在相同回合列表、评分规则与原语预算下,本地评测的 LightNav-0、Uni-NaVid 7B、OmniNav Flow、NavFoM、SPAN-Nav 在所有有报告的子集上 SR 与 SPL 均低于 Astra,相对 LightNav-0 的 SR 增益为 20、20、36、16 个百分点。但 ObjectNav 的 SPL 只有 22.43% 与 43.69%:即便终点成功,绕路也被 SPL 惩罚,这正是成功率掩盖的低效搜索;MP3D 有 10 个回合、HM3D 有 5 个回合耗尽 500 步预算。

图 7:导航结果。(a) 四子集 SR 与 SPL;(b) 终止构成,成功 STOP、失败 STOP 与预算耗尽;VLN-CE 全部以 STOP 结束,ObjectNav 存在预算耗尽回合。
| 任务 / 数据集 / 划分 | 成功 | SR | SPL | nDTW | sDTW |
|---|---|---|---|---|---|
| VLN-CE / R2R / Val-Unseen | 39/50 | 78 | 65.27 | 72.20 | 59.35 |
| VLN-CE / RxR 英文 / Val-Unseen | 46/50 | 92 | 77.25 | 84.73 | 80.42 |
| ObjectNav / MP3D / Val | 28/50 | 56 | 22.43 | — | — |
| ObjectNav / HM3D / Val | 41/50 | 82 | 43.69 | — | — |
运动:五次顺序尝试仍不过密集参考接口。同一匹配课程上 PASSAGE 13.18 秒到达目标(进展 8.622 米、终误差 0.495 米);Astra 第一次尝试前进 1.561 米后跌倒,第二到四次保持直立但进展接近零,第五次直立 30 秒、行走 3.833 米、把目标距离缩短 2.598 米,仍停在主障碍区前 6.519 米。作者明确这五次是同一条适应轨迹的连续阶段而非独立试验。时间代价更直观:最后 30 秒回合用了 250 次同步调用,平均每次记录延迟 39.86 秒,而 PASSAGE 规划约 0.08 秒;物理在推理期间暂停。不含 Astra 的解析接口诊断同样不乐观:Five-point 与 WholeBody-14 在 6 课程 × 2 物理后端的 12 次 rollout 中严格成功均为 0,"到达并保持"分别 4/12 与 3/12,低天花板课程只有 1/6 与 0/6 到达终点。
| 规划器 / 尝试 | 结果 | 时间(s) | 进展(m) | 终误差(m) | 跌倒 |
|---|---|---|---|---|---|
| PASSAGE | 到达目标 | 13.18 | 8.622 | 0.495 | 否 |
| Astra 尝试 1 | 跌倒 | 9.80 | 1.561 | 7.556 | 是 |
| Astra 尝试 2 | 无进展 | 20.28 | -0.024 | 9.141 | 否 |
| Astra 尝试 3 | 无进展 | 8.00 | 0.012 | 9.104 | 否 |
| Astra 尝试 4 | 无进展 | 8.48 | 0.159 | 8.958 | 否 |
| Astra 尝试 5 | 到时终止 | 30.00 | 2.598 | 6.519 | 否 |
人形移动操作:命令选择强,阶段间接触弱。HumanoidBench 30 任务上 Astra 的平均原生回报 581.9,高于 TD-MPC2 的 338.2、SAC 的 42.7 与 DreamerV3 的 -41.9;分别在 16、19、25 个任务上超过三者,并在 13 个任务上超过三者最优、Kitchen 打平;六个任务均值达到原生阈值(Stand、Walk、Maze、Crawl、Push、Sit Simple)。Maze 1358.8 超过 1200 阈值,Reach 11430.2 略低于 12000。校准的影响也被量化:Walk 的步态时钟频率从 1.2 提到 1.8 Hz,在八个配对种子上把平均回报从 705.72 提到 746.60,而权重、命令速度与反馈规则都没变;1.25 m/s 的命令实际走出约 1.48 m/s。SIMPLE 的 L2 协议下 Astra 完成 50/60(83.3%),但 Handover 的原生成功并不要求纸箱在完全释放后保持稳定,失败案例中手指闭合或纸箱倾斜会被误判为稳固抓握。
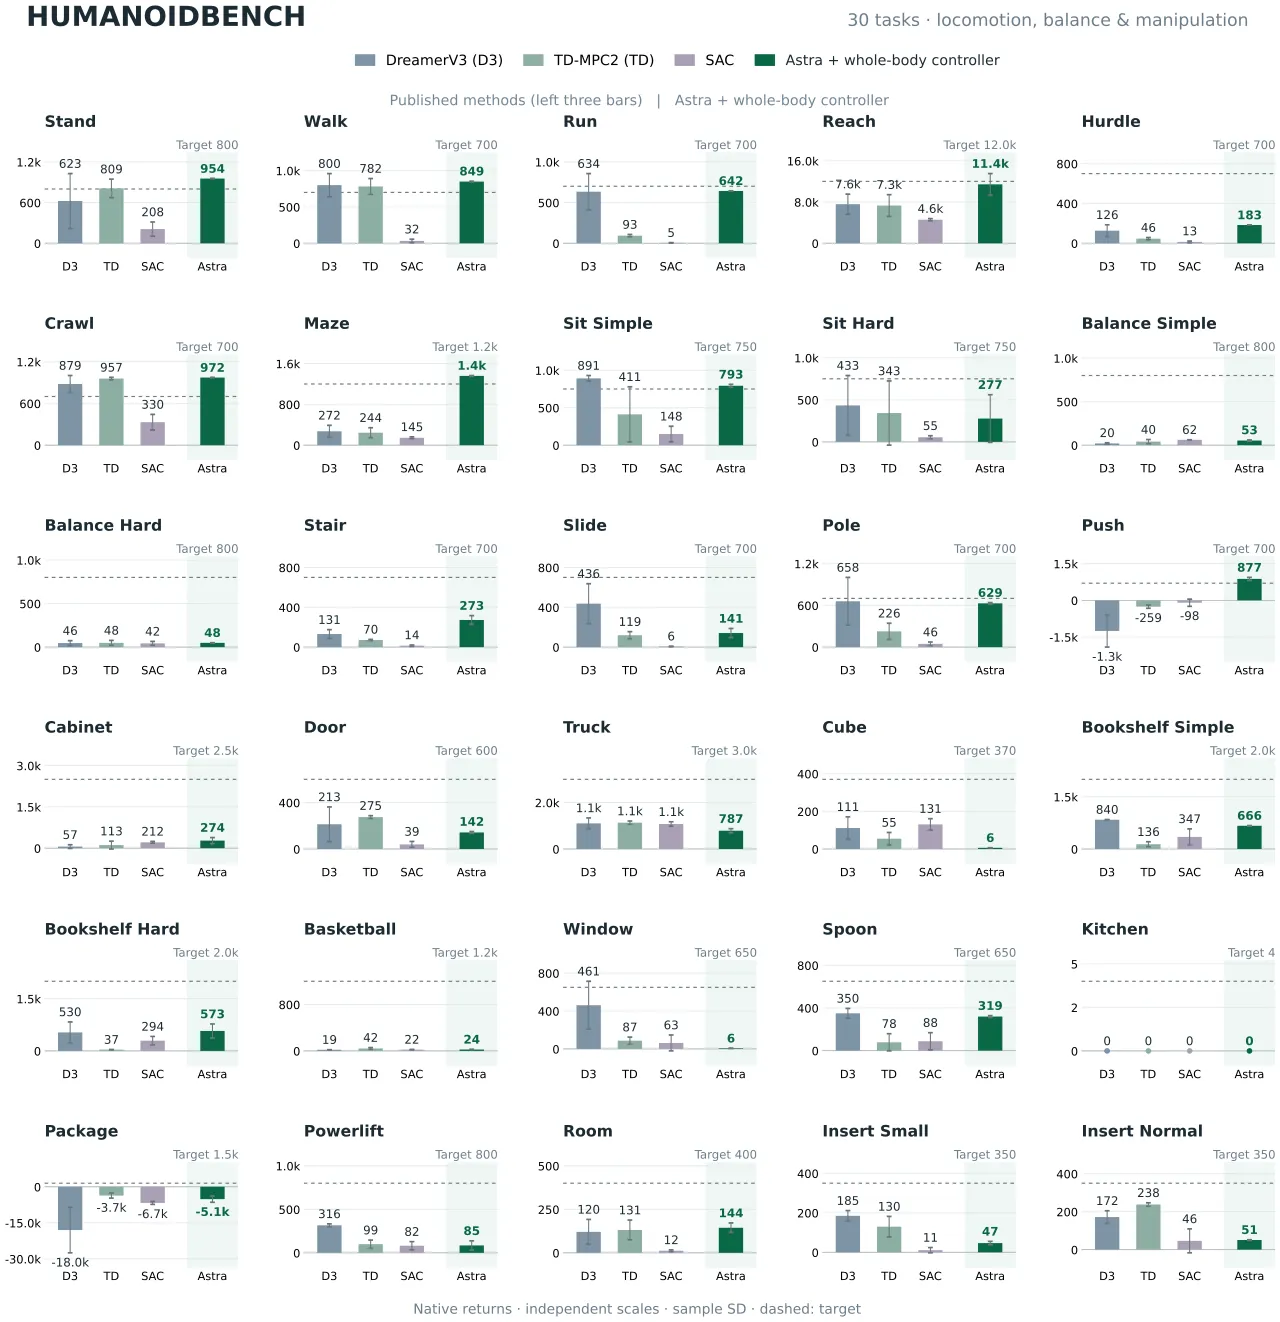
图 8:30 个 HumanoidBench 任务的平均回报与标准差,绿色为 Astra,其余为 DreamerV3、TD-MPC2、SAC 的公开结果;虚线为各任务原生阈值。
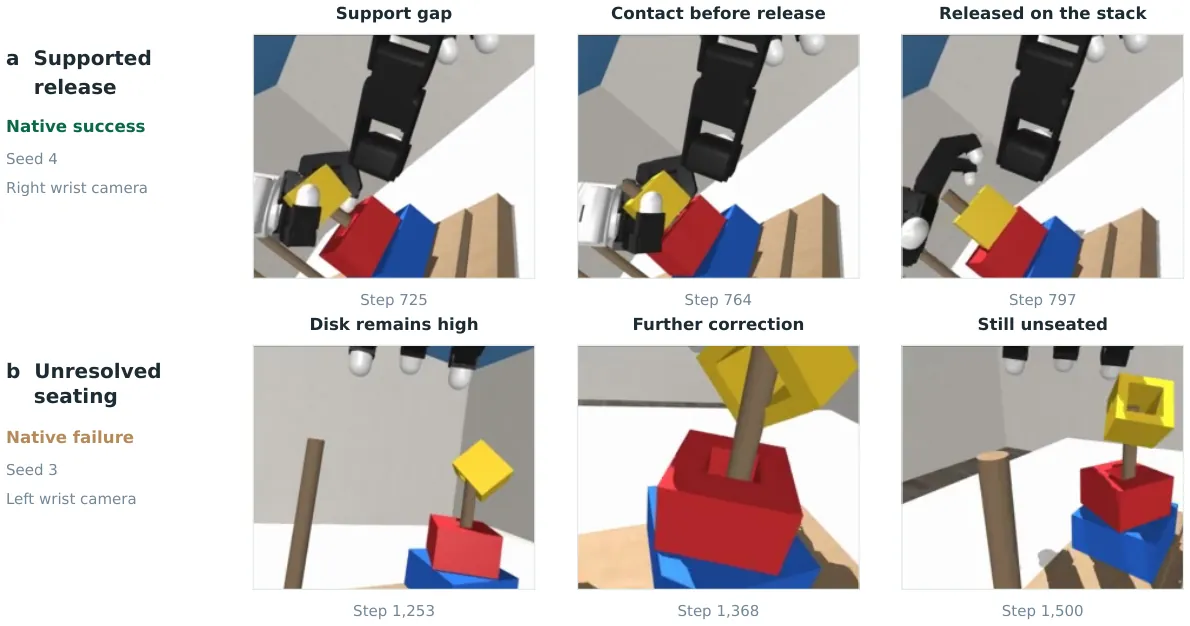
图 9:DexJoCo 腕部相机序列。(a) 成功回合中 Astra 先修正、再交还策略完成释放,释放后纸箱仍被支撑;(b) 失败回合中反复落座修正后小盘仍斜高于目标桩,直至步数上限。
资源账本:委托运动不等于委托审查。RoboDojo 每条件 50 个任务实例上,Hybrid 与 Direct 的总 token(含缓存输入)为 624762828 与 1132343772,其中缓存输入 607555840 与 1107349760,未缓存输入 15901963 与 22907448,输出 1305025 与 2086564;执行控制步 42750 对 38221,动作段 3776 对 7729。Hybrid 把总 token 降低 44.8%,但未缓存输入与输出仍然可观。RoboCasa 上 Direct 与 Hybrid 记录 7910 与 8941 次模型请求,每回合中位 85 与 108 次——Hybrid 减少了 Astra 自写的动作段,却记录了更多请求。第一性结论是:推理效率取决于审查频率,而不只取决于动作由谁生成。
| RoboDojo 指标 | Hybrid | Direct |
|---|---|---|
| 执行控制步 | 42,750 | 38,221 |
| 执行动作段 | 3,776 | 7,729 |
| 总 token(含缓存输入) | 624,762,828 | 1,132,343,772 |
| 缓存输入 token | 607,555,840 | 1,107,349,760 |
| 未缓存输入 token | 15,901,963 | 22,907,448 |
| 输出 token | 1,305,025 | 2,086,564 |
局限性
作者自述一:密集运动参考不可靠且代价高昂。五次顺序尝试无一到达目标,作者把这归因于接口本身:关节限位并不能保证参考自洽,根速度、肢体姿态与其演化必须描述相容的运动;跟踪器能跟随参考却可能走出原地踏步、多余接触或跌倒。同时 39.86 秒的平均调用延迟意味着"决策比它执行的运动慢得多",暂停物理只是实验里的权宜,真实场景不会等待。
作者自述二:直接手内控制落后于任务特定 RL,且协助可能丢失策略已有的成功。手内实验中 Astra 的达标步占比低于 RL 两个数量级;RoboCasa 上两种 Astra 条件在 CoffeeSetupMug 与 WashLettuce 全败而单独策略能完成。作者据此指出,保持当前抓握会阻碍继续运动所需的释放与重定位,而"检测错误、提出修正、验证效果"是三种不同的能力。
作者自述三:改进不等于可复现的成功。Push 的开发记录里有一次成功之后紧跟一次失败的重试;Handover 的固定流程在三个此前成功的场景上只通过两个的原生成功加额外保持检查;经验修订后的指引也未必在后续尝试中保留成功。诊断可以正确指出问题,却不保证下一条动作足够好。
我的判断:样本量与仿真边界。多数研究的每任务样本只有 5 个实例或 5 个种子,48%、98% 这类百分比的置信区间很宽,论文自己也只用描述性 Wilson 区间而不做显著性主张(唯一例外是 McNemar 的 p=0.5235)。全部结果来自 MuJoCo、Habitat、RoboCasa 等仿真环境,没有真机验证;导航的本地对比还改动了部分基线的相机设置,与它们的公开配置不完全可比。此外运动研究是单条适应轨迹,不能外推为"五次独立试验的平均能力"。
总结与展望
这份报告的价值不在于给 Astra 打一个总分,而在于把"决策"与"控制"拆开测量。导航上 Astra 以纯 RGB 观测领先本地对比系统;操作上 Hybrid 结构在长时程与接触敏感任务上显著优于 Direct,且只动用约一成到一成的执行步;人形上冻结全身控制器加命令选择能超过多个强化学习基线。与此同时,手内接触协调、密集运动参考与完成验证三处持续失败,且失败模式各不相同:有的是保持与推进的张力,有的是参考自洽性,有的是把"看起来对"误认为"已经对"。
对后续工作,论文给出的方向同样具体:合作策略需要同时学会何时介入与何时把控制交还策略;完成检查需要独立于动作生成的验证机制;资源账本要求把审查频率作为一等优化目标;而任何走向真机的尝试都必须把推理延迟与物理反馈变化速率放在一起评估。 Egocentric 视频到交互场景的管线(Chamfer-L1 从 35.93 毫米降到 24.73 再到加入 CAD 尺寸后的 12.14 毫米)则提示了另一条路:让模型自己搭建并修正感知-重定向工具链,但三个苹果转移案例中只有一个完成完整交互,说明几何合理并不等于物理交互成功。
金句
这些发现揭示了"有用的任务决策"与"可靠的物理控制"之间的差距。
稳定的抓握只是一个中间条件:持续操作要求一部分手指释放并重定位,而另一部分手指保持支撑。
委托运动并不必然委托审查运动的工作。
暂停物理让这种延迟在实验中可以容忍;真实场景不能假设会等待。
一个看似合理的移动理由,并不保证正确的目标判断或空间进展。