PAPER DEEP DIVE
ASENA:面向具身导航的自演化智能体
ASENA 是一套让人形机器人成为通用编码智能体可编程环境的具身智能体系统:智能体读取传感器、编写并执行程序、对照录制的执行证据修复失败,并在模型权重保持不变的前提下,把可复用的笔记与可执行技能沉淀进持久工作区。论文同时提出可选工具 ASENA-VLN,一个 4B 单目导航策略,基于路线指令、视觉问答与新构建的几何原子导航任务训练,可预测本体坐标系轨迹。独立评测中 ASENA-VLN 在 R2R 与 RxR 上分别取得 68.7% 与 70.2% 的成功率;与编码智能体结合后,学习型导航在两个 agentic 基准上各提升 11 个百分点成功率并缩短执行时间。持久工作区演化在十轮重复任务子集上把 R2R 成功率从 72% 提升到 98%、RxR 从 65% 提升到 89%。在具身问答上 ASENA 以更少交互步数取得最先进准确率,并在 Unitree G1 上无预建地图地演示了搜索、视觉检查、空间推理、合成手势与包含拾取、搬运、递交的移动操作。
论文元信息
标题:ASENA: Self-evolving Agents for Embodied Navigation(面向具身导航的自演化智能体)
机构:英伟达 GEAR 实验室、加州大学圣迭戈分校、德克萨斯大学奥斯汀分校
arXiv:2609.39207v2 · 项目主页:https://research.nvidia.com/labs/gear/asena
代码状态:论文正文与附录均未给出公开代码仓库,项目主页是唯一官方入口;附录公开了完整的系统规格(传感器清单、安全参数、指令格式与量化数据),可视为对复现的补偿性披露。
载体:Unitree G1 人形机器人(仿真环境为 Matterport3D 与 HM3D)
一句话总结
ASENA 把一台人形机器人变成通用编码智能体的可编程环境:智能体读传感器、写程序、对着录制下来的执行证据修 bug,并把可复用的笔记与技能沉淀进持久工作区;一个可选的 4B 单目导航策略负责吸收底层运动——全程不更新任何模型权重。
研究背景与动机
一个真正有用的人形机器人,任务从来不是"走到某处"这么简单。论文开篇给了一个具体请求:去看自动售货机里有没有某样零食,然后回来告诉我答案。要完成它,机器人得决定去哪里找、认出目标、记住用户站在哪儿、再把结论说出来。取物任务还要加上抓取规划、拿起、搬运与递交。导航只是其中一个环节,而下一步做什么,取决于机器人中途看到了什么。
学习型导航策略能提供"移动"这一能力,但它无法决定该检查什么、如何对物体下手、该向用户汇报什么。这些流程依赖现场的新观测,而且经常超出任何预定义技能库的覆盖范围。这正是 ASENA 要填的缺口:那些必须在任务进行中现场构造、现场修订的流程。
编码智能体天然适合这件事,因为它们本来就在"写代码、跑代码、对着报错改代码"的循环里工作。ASENA 的赌注是:只要机器人把感知、计算、仿真与动作统一暴露成一个可编程接口,并且把执行结果以智能体可回放的形式记录下来,同一个循环就可以直接指向物理机器人。
物理部署还带来两条硬性要求。其一,反馈必须与结果绑定:当动作偏离意图时,智能体需要有录制证据来定位并修复出问题的那段程序。其二,有用的流程必须能沉淀下来,让下一次任务从已有经验出发,而不是从零开始。ASENA 用 MCAP 执行记录与持久工作区分别回应这两点。
最后,把运动委托给专用策略,既能减少智能体反复决策的次数,也能覆盖那些难以用几何语言描述的行为(穿门、对齐物体)。于是有了 ASENA-VLN:一个轻量 4B 单目策略,且始终是"可选工具"——程序可以调用它、与几何导航混用,或完全不用它。
预备知识:三个部件
机器人接口层。在 G1 上,ASENA 暴露 360 度相机、激光雷达、里程计、躯干惯导与关节状态,另配一个标定过的头部 RGB/双目相机用于操作。身体运动由 SONIC 全身控制器执行,可选的 YAM 平行夹爪走独立控制器,语音走机载扬声器。感知、控制与安全操作都被封装成可调用的原子技能。
工作区。在第 $k$ 次修订时,工作区是一个二元组 $W_{k}=(N_{k},S_{k})$,其中 $N_{k}$ 存笔记、$S_{k}$ 存可执行技能。一个权重固定的编码模型在解题时查阅这份工作区。两次修订之间,另一个权重固定的改进器消费执行轨迹 $\mathcal{T}_{k}$ 与反馈 $f_{k}$,产出下一版工作区:
$$W_{k+1}=I_{\phi}(W_{k},\mathcal{T}_{k},f_{k}). \tag{1}$$
整个过程中模型与控制器权重保持不变。仿真里私有 worker 可以在两轮之间编辑工作区,而冻结评测期间禁止写入;在 G1 上,执行记录与可选的操作员反馈支持技能修订,此时机器人运动被禁用。
导航策略。ASENA-VLN 在 Qwen3-VL-4B-Instruct 之上扩展了专用词表:880 个轨迹 token 与 680 个像素目标 token,合计 $880+680=1343$ 个新增 token;视觉问答则保留模型原有文本词表。它最多吃入八帧按新近度加权的正视图,加一条结构化 JSON 指令,输出有界的本体坐标系轨迹。
方法详解
把程序锚定在机器人反馈上。编码智能体直接处理并可视化原始传感器输入,用来估计几何、检查物体、监控执行。每一次运行都存为一条 MCAP 记录,把传感器与机器人状态同动作、反馈、代码、可视化对齐起来。回放这些证据,智能体才能定位"执行在哪一步偏离了意图"并修复对应程序;同一批记录也喂给工作区修订。
导航是工具之间的选择。智能体既可以用几何工具规划运动——建激光雷达占据图、提候选路点、检查障碍间隙——也可以调用 ASENA-VLN 做语言条件导航。何时调用哪个工具、何时通过新观测检查进度、何时改计划,都由智能体自己决定。这是刻意的分工:几何工具负责智能体可验证的结构,学习策略负责难以显式描述的行为。
操作链路。SAM 2 的物体掩膜结合深度测量给出候选抓取位姿;需要更多选项时,系统用 GraspGenX 的学习型候选补充几何提案。逆运动学与运动规划把候选转成伸手、提起、搬运的轨迹。执行前系统会用实测关节状态重建手臂轨迹,并检查关节限位、采样自碰撞与场景间隙,包括提起与回撤过程中所持物体的间隙。
执行检查与安全兜底。生成的手势先在 MuJoCo 里在线校验姿态连续性、关节与运动限位、采样自碰撞;校验失败会把被违反的约束返回给智能体去修。物理运动需要校验与操作员批准双重通过,修订后的程序提出的动作同样如此。一个独立的导航守护层强制执行运动限制,并在里程计过期或电量过低时拒绝指令,另有心跳触发停机与手动急停作为额外保护。附录把这些限制量化得很具体:指令发布 10 Hz,平移速度限制在 0.12–0.35 m/s,距目标 0.5 m 内限速 0.25 m/s,到位容差 0.10 m 与 4 度,单条指令上限 2.0 m 与 180 度,活动任务心跳超时 3.0 秒。
策略的输入与输出。指令是一个结构化 JSON 对象,携带简洁的导航命令,并可选地带上期望终末位姿、锚定物体或运动约束;一个 1–5 的质量字段用于条件化生成,R2R/RxR 评测取 5。共享的自回归解码器最多预测八个累积的本体坐标系路点,每个路点表示为三元组 $(x,y,\theta)$。沿各轴的固定分箱把轨迹 token 转成显式运动目标,无需单独的连续动作头。
像素目标只是辅助监督。像素目标 token 鼓励模型在图像中定位它想去的位置。关键在于像素目标不可直接执行:它还需要一个额外的运动规划器,或在仿真里一个最短路跟随器。因此论文所有评测都用轨迹 token 的预测,而非像素目标。像素头是训练信号与调试把手,不是控制接口。
原子导航数据。一个可被调用的策略既要跟得完长路线,也要做得准短指令。作者在 MP3D 与 HM3D 中构建了九类原子导航任务:移动指定距离、转到目标航向、从给定方向接近物体、与目标对齐、进入房间、穿过门口、沿走廊行进、跨楼层移动。每类任务都用测地距离、可见性与场景几何生成并校验,保证每条指令描述的都是可行且可度量的运动;每条指令配对一条路点轨迹与辅助像素目标监督。
训练配比。ASENA-VLN 的训练混合了原子任务、短程物体导航、以及来自 R2R、RxR、ScaleVLN、SRDF 的视觉语言导航数据,再加入多视角视觉问答数据以强化空间理解。为了让训练匹配可调用接口,作者用 GPT-5.5 把原始导航指令重述为结构化 JSON 格式。最终检查点的优化步数少于 10K、训练样本(含重复)少于 5M,轨迹预测与空间问答按 3:1 混合;加权后轨迹池合计 28.422M、问答池合计 9.128M。
上机与量化。策略跑在 G1 的 Jetson AGX Thor 上,量化是绕不开的工程问题:PyTorch BF16 各组件延迟合计 2,806 ms,而 FP8 加精简词表降到 877 ms,即 $2806/877 \approx 3.20\times$ 加速,导出体积从 9.01 GiB 降到 4.53 GiB。解码仍是最大开销,683.4 ms,约占 FP8 总延迟的 78%。在 256 条留出输入上,FP8 加 BF16 视觉的版本与 BF16 模型在首个路点上一致率 91.41%,在整条轨迹上一致率 82.81%。
flowchart TD
  A["编码智能体
Codex / Claude Code"] -->|写程序| B["ASENA 接口层
感知 + 可调用工具"]
  B --> C["几何导航
激光占据图 + 间隙检查"]
  B --> D["ASENA-VLN 4B
可选本体轨迹"]
  B --> E["操作
SAM2 掩膜 + 深度 + GraspGenX + 逆运动学"]
  C --> F["机器人执行
SONIC 全身 + YAM 夹爪"]
  D --> F
  E --> F
  F --> G["MuJoCo 校验
限位 + 自碰撞"]
  G -->|批准| H["物理运动
导航守护 + 心跳"]
  H --> I["MCAP 执行记录
传感 + 动作 + 代码 + 反馈"]
  I -->|回放与修复| A
  I --> J["固定权重改进器
公式 1 工作区更新"]
  J --> K["持久工作区
笔记 N + 技能 S"]
  K -->|下个任务查阅| A
ASENA 闭环:程序写在可编程接口层上,经校验过的控制器执行,沉淀为 MCAP 证据,再由固定权重改进器蒸馏进持久工作区。
实验结果
独立导航能力。在 R2R 与 RxR 的 val_unseen 上,以 0.25 m 前进步长与 15 度旋转评测,ASENA-VLN-4B 在 R2R 上取得 3.52 m 导航误差、72.6 OSR、68.7 成功率与 64.2 SPL;在 RxR 上取得 3.90 m 误差、73.1 nDTW、70.2 成功率与 59.7 SPL。R2R 上四项指标全面领先。RxR 上则更微妙:误差与路线相似度明显占优(nDTW 73.1 对 Qwen-RobotNav-4B 的 68.6),但成功率(70.2 对 71.3)与 SPL(59.7 对 61.5)略逊于该基线——这与摘要中笼统的"最先进"表述之间存在张力,值得读者留意。
| 方法 | R2R NE ↓ | R2R SR ↑ | R2R SPL ↑ | RxR NE ↓ | RxR nDTW ↑ | RxR SR ↑ | RxR SPL ↑ |
|---|---|---|---|---|---|---|---|
| StreamVLN | 4.98 | 56.9 | 51.9 | 6.22 | 61.9 | 52.9 | 46.0 |
| NaVIDA | 4.32 | 61.4 | 54.7 | 5.23 | 67.0 | 57.4 | 49.6 |
| DualVLN | 4.05 | 64.3 | 58.5 | 4.58 | 70.0 | 61.4 | 51.8 |
| Qwen-RobotNav-4B | 4.22 | 66.9 | 60.5 | 4.15 | 68.6 | 71.3 | 61.5 |
| ASENA-VLN-4B | 3.52 | 68.7 | 64.2 | 3.90 | 73.1 | 70.2 | 59.7 |
独立单目 VLN-CE 结果(val_unseen;除 NE 以米计外均为百分比)。ASENA-VLN-4B 在 R2R 全面领先,在 RxR 上赢误差与 nDTW。
物体目标导航。与一个负责规划"去哪搜"的独立视觉语言模型配合后,ASENA 在 HM3D-v2 上取得 80.8/38.1 的成功率/SPL,在 OVON 的 seen、同义、unseen 三个划分上分别为 60.5/33.5、65.8/37.9、64.9/38.4,超过所有已发表基线,包括 ApexNav(76.2/38.0)与 ABot-N0(seen 上 55.3/32.1)。三个类别划分上表现一致,说明系统对物体描述的差异与寻路路线的差异都有容忍度。
智能体与策略互为补集。在每份 100 个任务的 R2R 与 RxR Agentic Split 上,分工是核心结论。以 Claude Sonnet 5 为后端时,加入 ASENA-VLN 让两个基准的成功率各提升 11 个百分点(R2R 从 61.0 到 72.0,RxR 从 50.0 到 61.0),平均每回合工具调用次数下降 59.2% 与 62.5%。换成更强的 GPT-6 Astra 后端,策略在 R2R 上几乎不增成功率(87.0 到 88.0),在 RxR 上甚至把成功率从 93.0 拉低到 86.0,但交互成本依旧减半(调用次数降 46.9% 与 51.0%)。值得注意的是,GPT-6 Astra 仅凭几何与程序化工具就在 R2R 上达到 87.0 成功率,逼近论文引用的人类水平 90%——编码智能体本身就是很强的零样本导航系统。
| 配置 | VLN 工具 | R2R SR ↑ | R2R SPL ↑ | R2R 调用/回合 ↓ | RxR SR ↑ | RxR SPL ↑ | RxR 调用/回合 ↓ |
|---|---|---|---|---|---|---|---|
| Uni-LaViRA(已发表) | – | 60.7 | 47.7 | – | 51.3 | 34.0 | – |
| ASENA-VLN-4B 独立 | – | 78.0 | 70.7 | – | 62.0 | 52.9 | – |
| ASENA(Claude Sonnet 5) | 关 | 61.0 | 34.2 | 83.32 | 50.0 | 31.9 | 103.83 |
| ASENA(Claude Sonnet 5) | 开 | 72.0 | 54.9 | 33.96 | 61.0 | 45.5 | 38.91 |
| ASENA(GPT-6 Astra) | 关 | 87.0 | 72.4 | 26.37 | 93.0 | 78.0 | 40.80 |
| ASENA(GPT-6 Astra) | 开 | 88.0 | 72.8 | 14.00 | 86.0 | 64.0 | 19.98 |
Agentic Split(各 100 个任务)。学习策略提升弱后端的成功率,并降低所有后端的交互成本。
不更新权重的自演化。对同一批 100 任务子集反复投放并给真值反馈,每轮由十六个高努力档的 Claude Sonnet 5 worker 执行,轮与轮之间由固定权重改进器更新规范工作区。十轮下来,R2R 成功率从 72% 升到 98%,RxR 从 65% 升到 89%,同时记录到的 worker 与改进器成本下降。带与不带 ASENA-VLN 的变体在 R2R 上最终成功率接近,但策略在更长的 RxR 指令上保持更明显优势,且在两个基准上都维持更高 SPL——工作区学会"做什么",策略保住"做得便宜"。
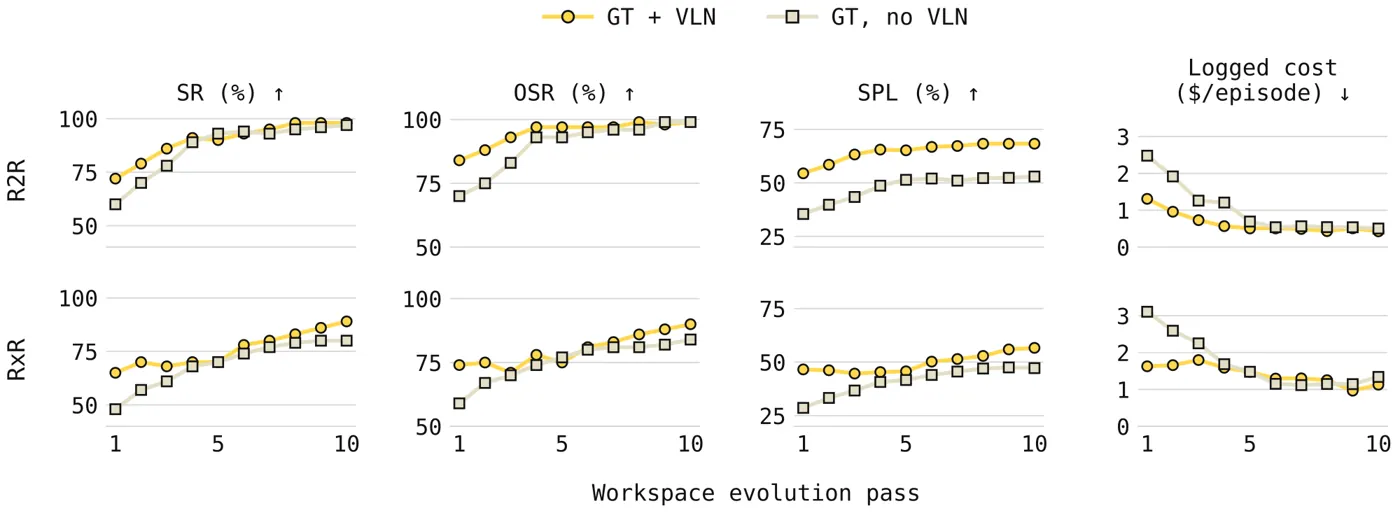
论文图 4:R2R 与 RxR Agentic Split 上十轮工作区演化的成功率、OSR、SPL 与每回合记录成本,对比带与不带 VLN 工具两条曲线。
具身问答。在 Explore-EQA 的传送协议下,每个回合对面积为 $A$ 的场景给定 $3\sqrt{A}$ 的名义步数预算,归一化探索步数即实际消耗占该预算的比例。ASENA 在高努力档取得 HM-EQA 81.2% 与 MT-HM3D 65.5% 的准确率,超过 FAST-EQA(69.2 / 50.5)与 Qwen-RobotNav(76.7 / 54.4)。低努力档下,演化到第 17 版的工作区在 MT-HM3D 上只用 0.08 的归一化步数,而 Qwen-RobotNav 为 0.19。在 132 条 MT-HM3D 问题上的配对消融显示,ASENA-VLN 把中位归一化探索步数降低约 19%,准确率几乎不变。
| 方法 | HM-EQA 准确率 ↑ | HM-EQA 步数 ↓ | MT-HM3D 准确率 ↑ | MT-HM3D 步数 ↓ |
|---|---|---|---|---|
| GraphEQA | 63.5 | 0.20 | 45.6 | 0.45 |
| FAST-EQA | 69.2 | 0.65 | 50.5 | 0.52 |
| Qwen-RobotNav | 76.7 | 0.15 | 54.4 | 0.19 |
| ASENA 手工配置(质量档) | 78.8 | 0.22 | 67.1 | 0.24 |
| ASENA 自演化第 17 版(低努力) | 74.8 | 0.13 | 64.9 | 0.08 |
| ASENA 自演化第 17 版(高努力) | 81.2 | 0.25 | 65.5 | 0.22 |
具身问答:准确率与归一化探索步数。演化工作区在低努力档用明显更省的探索换得接近的准确率。
真机演示。四个 G1 任务均不依赖预建地图。洗手间任务中机器人定位电梯厅附近的门,用在线地图找出一条更短的路线,再回来给用户指路;储物间任务中它检查饮水机与咖啡机,汇报"两台咖啡机";零食比对任务中它先看参考零食,再找到售货机核对是否有同款,最后用一个在线生成的全身手势回来作答;取物递交任务则串联导航、头部相机抓取定位、被检查过的手臂运动规划、YAM 夹爪拾取、边走边搬运,以及用逆运动学把物体送到接收者手掌上方再松爪。四个演示用同一套编程接口组合了导航、操作与沟通。
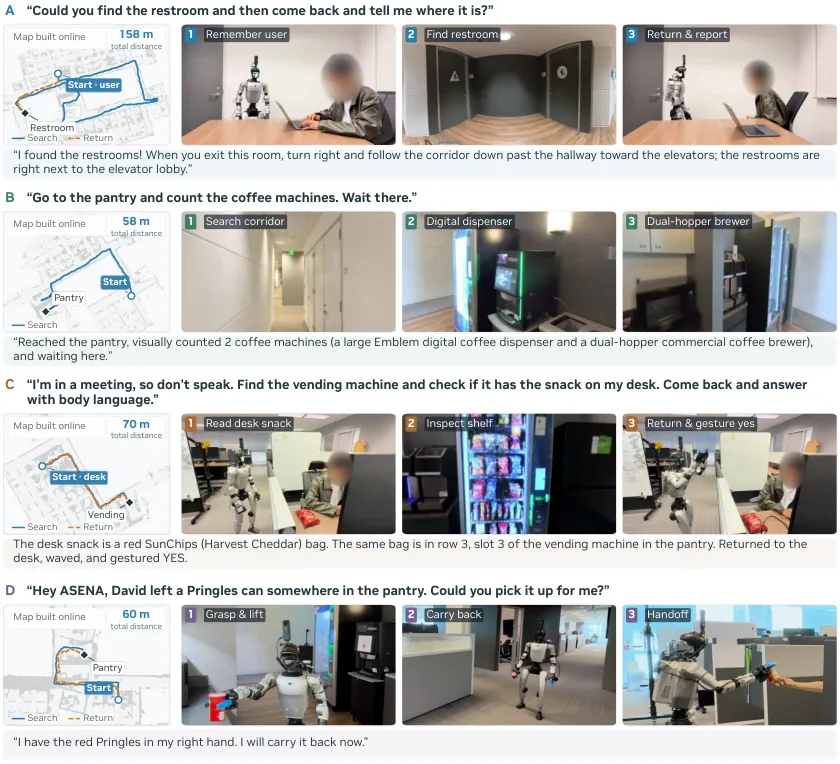
论文图 5:四个 G1 演示,把在线地图与录制轨迹同观测和动作并置;蓝色与橙色虚线分别标出搜索与返回段。
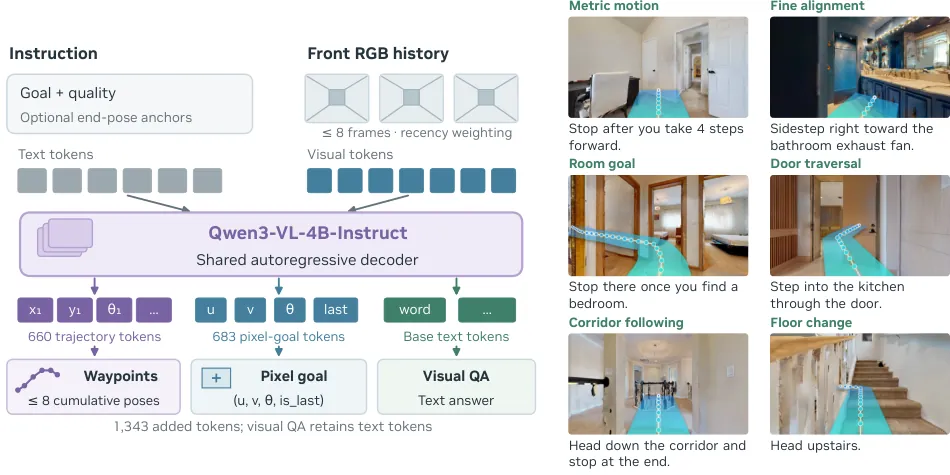
论文图 3:共享的 Qwen3-VL-4B 解码器与独立的轨迹、像素目标 token 块,右侧为带叠加路点的原子训练样例。
局限性
作者自述。G1 演示提供的是能力组合的定性证据,而非跨物体、跨布局、跨用户的系统性可靠性度量;真机任务耗时 10–20 分钟,更快的推理与执行对实用化至关重要。作者还指出:沉淀下来的技能尚未在新任务上评测,导航与操作在重复真机试验中的可靠性仍未度量,动态环境下的安全防护需要加强。
本文评估。数字本身还暴露两点。其一,工作区演化的增益是在"重复子集"上测得的:同样的任务、场景、指令与初始位姿在十轮中被反复投放,且反馈是真值,因此 72% 到 98%、65% 到 89% 证明的是对重复任务的沉淀能力,尚不能外推到未见任务。其二,策略并非总是正收益:在 RxR 上配合强后端 GPT-6 Astra 时,开启 ASENA-VLN 反而把成功率从 93.0 拉到 86.0;独立 RxR 对比中它的成功率与 SPL 也略逊于 Qwen-RobotNav-4B。学习导航的价值依赖后端如何把策略预测纳入自己的计划,论文自己的表格把这一点摊得很开。
总结与展望
ASENA 的贡献既是算法的,更是架构的:它把人形机器人当作一个"结果可录制、可回放"的编程环境,把改进定义为笔记与技能的修订而非权重的更新。在这个框架里,一个用几何原子任务训出来的 4B 单目策略成为可组合工具——它让弱编码后端的成功率提高 11 个百分点,让所有后端的交互成本减半;而工作区演化在权重全冻结的前提下,把 R2R 与 RxR 的重复任务成功率分别抬升 26 与 24 个百分点。作者列出的后续方向——在新任务上评测沉淀技能、度量重复真机试验的可靠性、为动态场景加固安全层、把演化扩展到策略与智能体自身——恰恰是把一个漂亮的系统结果推向通用配方所缺的那几组实验。
金句
"导航因此只是一个更大任务的一部分,而这个任务的下一步,取决于机器人观察到了什么。"