PAPER DEEP DIVE
3DG-VLN:视场内无人机精准视觉语言导航
提出视内导航任务 UAV-VLN-FOV 与 3DG-VLN 框架:用动态 3D 方向线索引导视觉语言航点预测,在线更新目标相对方向,让无人机精准抵达可见目标。
论文元信息
标题:See-and-Reach: Precise Vision-Language Navigation for UAVs within the Field of View(方法名 3DG-VLN)
作者:Fanfu Xue, En Yu, Yantian Shen, Zhikun Hu, Hongjun Wang, Yang Yang, Xindi Wang, Jiande Sun
论文链接:arXiv:2606.20045v1(2026-06-18) 代码状态:已公开,github.com/xuefanfu/3DG-VLN;数据集托管于 HuggingFace fanfuxue/UAV-VLN-FOV,模型权重托管于 fanfuxue/3DG-VLN
一句话总结
这篇论文把无人机视觉语言导航里「目标已经看见、但还没够着」的最后一段单独切出来,定义为 UAV-VLN-FOV 任务并用 10 米成功半径逼问终端精度,再给出一个吃高分辨率前视+下视双视图、由在线 3D 方向线索引导的航点预测框架 3DG-VLN,在自建基准上把成功率从 25.00% 提到 38.82%。
研究背景与动机
无人机视觉语言导航(UAV-VLN)要求飞行器根据自然语言指令和第一人称观测完成飞行任务。与地面 VLN 相比,空中空间的三维拓扑更开阔、更缺乏结构,成功导航需要多模态接地、三维空间感知与连续控制下的动态运动规划同时收敛。尽管已有工作在指令设计、数据集与模型框架上做了不少探索,终端抵达精度始终是一个被整体式评测掩盖的问题。
现有 UAV-VLN 研究大多把任务建模为「搜索+抵达」的整体过程:先在大范围环境里发现目标,再靠近目标。作者指出这种整体式形式化模糊了一个根本分歧——搜索阶段需要的是高层场景理解与长程发现能力,而抵达阶段(论文称为 see-and-reach 阶段)需要的是完全不同的能力组合:细粒度视觉定位与三维轨迹控制。两者被同一个指标捆绑评测时,终端精度的失败经常被探索阶段的错误所遮蔽。
这个分歧在高风险任务里是致命的。论文举的例子是灾后救援与应急物资投送:一旦某个应急补给站被视觉确认,任务成败就完全取决于飞行器能否精确接近到可以安全投放的距离。而当前 UAV-VLN 基准普遍采用宽松的 20 米成功半径,20 米的偏差足以把关键物资扔进无法抵达的地形。于是作者主张把抵达过程隔离出来单独评测,并把成功半径收紧到 10 米。
在「视场内」这一设定下,现有方法暴露出两个具体缺陷。其一,面向长程搜索设计的方法通常使用低分辨率观测,足以做场景级探索与粗定位,但低分辨率抓不住细粒度几何细节、分不清视觉相似的干扰物、也感知不到近处障碍,而这些恰恰是航点级规划与终端机动的前提。其二,已有方向引导方法依赖任务开始时算出的静态方向线索,飞行器一旦移动,累积的空间漂移就会让语言指令与当前第一人称视角严重错位。
针对这两点,论文形式化了 UAV-VLN-FOV:目标在起始位姿就位于视场内,智能体必须把语言指令与自我中心视觉证据直接翻译成可执行的三维航点计划,并在尺度剧变、部分遮挡、目标短暂出视场以及反应式避障的同时保持空间对齐。配套贡献是一个高分辨率基准(2,717 条轨迹、31,878 个「图像-指令-航点」元组、14 个乡村/城镇/城市场景、89 类目标)和框架 3DG-VLN。
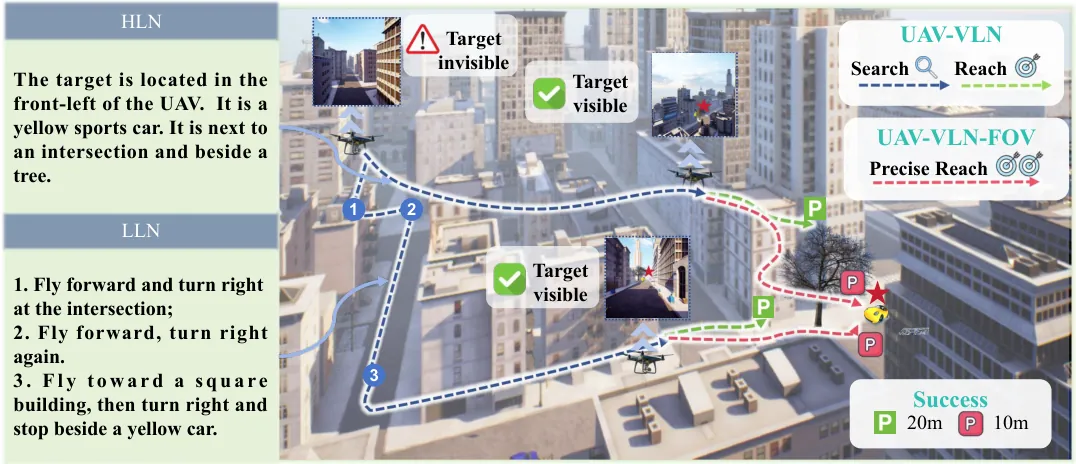
图1(论文 Fig.1):UAV-VLN 强调整体搜索-抵达过程,UAV-VLN-FOV 只关注目标已可见的 see-and-reach 阶段,左侧指令示例要求飞向路口旁的黄色车辆或黄色罐体。
任务形式化与预备知识
状态空间取 $\mathcal{S}\subset\text{SE}(3)$ 的子集,时刻 $t$ 的位姿为 $\mathbf{P}_{t}=(\mathbf{p}_{t},\mathbf{q}_{t})$,其中 $\mathbf{p}_{t}\in\mathbb{R}^{3}$ 是全局坐标、$\mathbf{q}_{t}\in\mathbb{S}^{3}$ 是姿态。每步观测是一个三元组 $\mathbf{X}_{t}=\{\mathcal{I},\mathcal{V}_{t},\mathcal{D}_{t}\}$:$\mathcal{I}$ 是高层语言指令;$\mathcal{V}_{t}=\{\mathbf{R}^{front}_{t},\mathbf{R}^{down}_{t}\}$ 是高分辨率前视与下视双视图,$\mathbf{R}\in\mathbb{R}^{H\times W\times 3}$,实验中为 1024×1024;$\mathcal{D}_{t}\in\{\textit{front, front-left, front-right, down}\}$ 是粗粒度三维方向线索,作为语义显式的空间先验。
动作空间是短程航点序列 $\mathcal{W}_{t}=\{\mathbf{w}_{t+k}\}_{k=1}^{K}$,$K=5$。每个航点 $\mathbf{w}_{t+k}=(\Delta x_{t+k},\Delta y_{t+k},\Delta z_{t+k})$ 表示无人机机体系下的前向、右向、下向相对位移,从而天然具备平移与旋转不变性,也便于飞控直接执行。策略是从观测历史到动作的确定性映射:
$$\mathcal{W}_{t}=\pi(\mathcal{I},\mathcal{V}_{\leq t},\mathcal{D}_{t};\theta)$$
评测沿用 SR、OSR、NE、SPL 四个指标,但成功判据被收紧。设终端位置 $\mathbf{p}_{T}$、目标位置 $\mathbf{p}_{tar}$、成功半径 $\delta=10$ 米(先前工作为 20 米),单条轨迹的成功定义为:
$$S=\mathbb{I}(\|\mathbf{p}_{T}-\mathbf{p}_{tar}\|_{2}\leq\delta)$$
这个看似简单的改动是全文的支点:它把「飞到目标附近区域」与「精确抵达目标近旁」区分开,使基准能够诊断终端控制保真度,而不是奖励区域级接近。
方法详解:3DG-VLN
3DG-VLN 的整体框架分为训练与推理两条线。训练阶段用自建基准对 Qwen2.5-VL-7B 做监督微调(LoRA 适配),让它学会从指令与双视图观测直接回归平滑航点;推理阶段则引入两个外挂模块:DeepSeek-V3.2 负责从指令中解析目标对象及其内在属性,开放集检测器 Grounding DINO 与在线三维方向更新模块负责在闭环飞行中持续提供方向引导。
高分辨率双视图观测。与长程 UAV-VLN 常见的 256×256 输入不同,3DG-VLN 以分辨率自适应的方式处理 1024×1024 的前视与下视图像,不做传统降采样。前视图承载目标形态与局部空间结构,下视图则覆盖机身正下方——那是前视相机在接近阶段最容易丢失目标的区域。消融中低分辨率变体(LR)在 Test 上 SR 仅 23.03%,比完整模型低 15.79 个百分点,说明细粒度视觉证据对目标接地与航点预测是刚需而非锦上添花。
方向线索的几何定义。论文定义机体系 $x,y,z$ 轴分别对应前、右、下。给定 UAV 姿态与目标位置,先把目标位移从全局系变换到机体系:
$$\mathbf{d}_{t}=\mathbf{R}(\mathbf{q}_{t})^{\top}(\mathbf{p}_{tar}-\mathbf{p}_{t}),\quad \alpha_{t}=\arctan2(d_{y},d_{x})$$
其中 $\mathbf{R}(\mathbf{q}_{t})$ 把机体系向量映射到全局系,其转置则做反向映射。偏航角 $\alpha_{t}$ 落入 ±15° 的前向扇区记为 front,左右各扩一个扇区得到 front-left 与 front-right;俯仰方向上,若满足下视条件则记为 down:
$$d_{z}/\|\mathbf{d}_{t}\|>\cos\phi,\quad \gamma_{front}=15^{\circ},\ \phi=\mathrm{FOV}/4,\ \mathrm{FOV}=90^{\circ}$$
即下视判定阈值取视场角的四分之一,与前向扇区半宽 15° 共同把连续方向压成四个语义 bin。这四个 bin 就是注入提示词的方向线索 $\mathcal{D}_{t}$,它不追求精确角度,而是给 VLM 一个稳定、可语言化的空间先验。
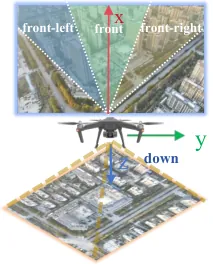
图2(论文 Fig.3):机体系下的四个方向 bin——front-left、front、front-right 覆盖前向扇区,down 指向机身正下方,下视相机正对该区域。
航点监督的坐标变换。训练标签同样在机体系下构造。对未来时刻 $t+k$,先算全局系位移再旋转到机体系:
$$\mathbf{w}_{t+k}=\mathbf{R}(\mathbf{q}_{t})^{\top}(\mathbf{p}_{t+k}-\mathbf{p}_{t})$$
推理时飞控侧做逆变换把相对航点还原为全局目标点:$\mathbf{p}_{t+k}=\mathbf{p}_{t}+\mathbf{R}(\mathbf{q}_{t})\mathbf{w}_{t+k}$。用机体系监督的好处是同一套视觉-语言证据在不同全局位姿下对应相同的输出分布,模型学到的是「相对我该怎么飞」,而不是背诵全局坐标。
监督微调目标。模型把航点序列作为文本 token 自回归生成,损失是标准的下一 token 对数似然:
$$\mathcal{L}_{SFT}=-\frac{1}{N}\sum_{t}\frac{1}{L_{t}}\sum_{\ell}\log p_{\theta}(s_{t,\ell}\mid \mathbf{X}_{t}, s_{t,<\ell})$$
其中 $s_{t,\ell}$ 是第 $t$ 步输出序列的第 $\ell$ 个 token,$L_{t}$ 为该序列长度。实现上以 LoRA 适配 Qwen2.5-VL-7B,在单张 A100-40GB 上训练 2 个 epoch,batch size 2、梯度累积 8 步、学习率 1e-4、warmup 比例 0.1;仓库中 travel_util.py 以 PeftModel.from_pretrained 加载 LoRA 权重,与论文描述一致。
在线三维方向更新。这是推理侧的核心机制。每一步先用 DeepSeek-V3.2 从指令中抽出目标对象与属性,再让 Grounding DINO 在前视与下视两张图上分别检测;一个视图被视为有效当且仅当它恰好返回一个检测框——多框意味着歧义,零框意味着目标不在该视图内。两视图都有效时下视优先,因为接近阶段目标更多落在机身下方。随后把检测框中心像素反投影为机体系射线:
$$f=\frac{W}{2\tan(\mathrm{FOV}/2)},\quad \mathbf{r}'_{cam}=\left(\frac{u-c_{x}}{f},\frac{v-c_{y}}{f},1\right),\quad \psi=\arctan2(r_{y},r_{x})$$
像素坐标经焦距 $f$ 与光心 $(c_x,c_y)$ 反投影到相机系,再经一个置换矩阵转到机体系(代码中 CameraModel 的 R_cam_to_body 正是 [[0,0,1],[1,0,0],[0,1,0]]),射线偏航角 $\psi$ 按 ±15° 离散化为四个 bin 之一,得到新的 $\mathcal{D}_{t}$。若本步没有任何有效视图,则沿用上一时刻的 $\mathcal{D}_{t-1}$,避免方向线索在遮挡瞬间跳变。代码中 classify_direction 的 ±15° 分箱、len(boxes)==1 的单框有效性判定、camera==1 的下视优先分支,与论文逐条对应。
闭环执行与停止规则。模型每次输出 $K=5$ 个航点并由飞控依次执行,执行期间持续重复「观测—检测—方向更新—预测」的闭环;停止判定沿用 TravelUAV 的策略,用开放集检测器配合深度估计,当深度除以 2.55 的归一化距离小于阈值时认为已抵达,对应代码 eval_qwenvl_direction.py 中的深度停止分支。
flowchart TD
  A["双视图观测 前视+下视 1024x1024"] --> B["Grounding DINO 开放集检测"]
  B --> C{"是否存在恰好一个检测框的视图"}
  C -- 否 --> D["沿用上一时刻方向线索"]
  C -- 是 --> E["下视优先 选定有效视图"]
  E --> F["框中心像素反投影为机体系射线"]
  F --> G["偏航角按正负15度离散为四个方向bin"]
  G --> H["方向线索与指令 双视图一起注入提示"]
  D --> H
  H --> I["LoRA 微调的 Qwen2.5-VL-7B 预测5个机体系航点"]
  I --> J["飞控执行航点 逆旋转回全局系"]
  J --> K{"深度停止规则是否触发"}
  K -- 否 --> A
  K -- 是 --> L["结束 按10米半径判定成功"]
上图把闭环推理拆成一条可审计的链路:方向线索不是训练时算好就不动的常量,而是每一步由当前观测重估的活变量;当检测不可用时回退到上一时刻线索,保证提示词里永远有一个空间先验。
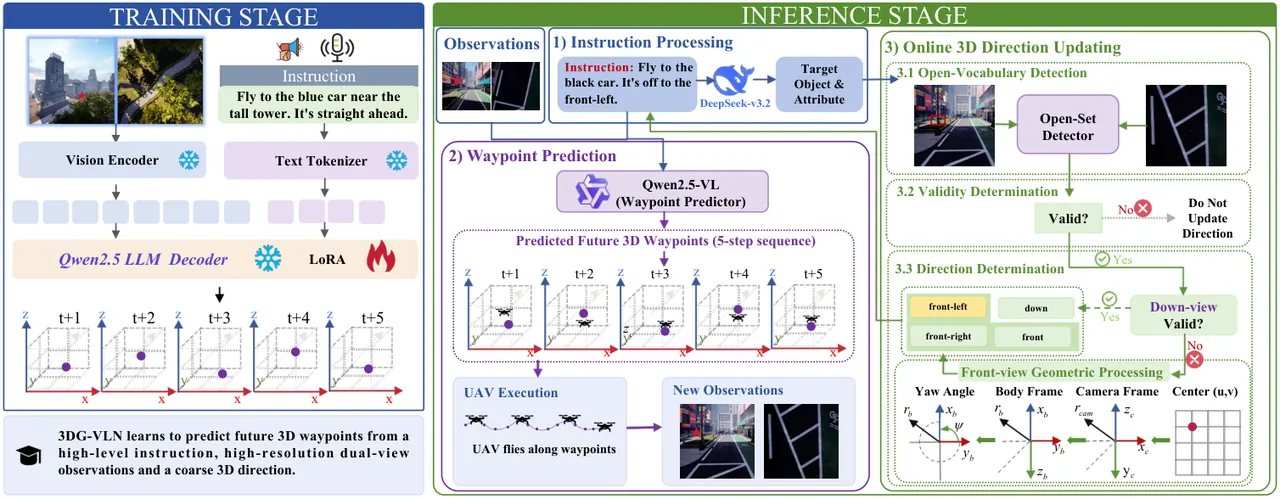
图3(论文 Fig.2):训练阶段用自建基准微调 Qwen2.5-VL 预测平滑航点;推理阶段由 DeepSeek-V3.2 解析目标与属性、在线方向更新模块提供方向引导。
实验结果
基准本身值得单独看:2,717 条轨迹划分为训练 2,228 条、Test 152 条、Test UO(未见物体)164 条、Test US(未见场景)173 条;尽管目标起始即见,最长轨迹仍达 138 米,指令平均只有 12 个词,比先前 UAV-VLN 数据集更短、更接近真实口令。轨迹长度分布呈右偏的单峰形态,说明「视场内」并不等于「近距离」。
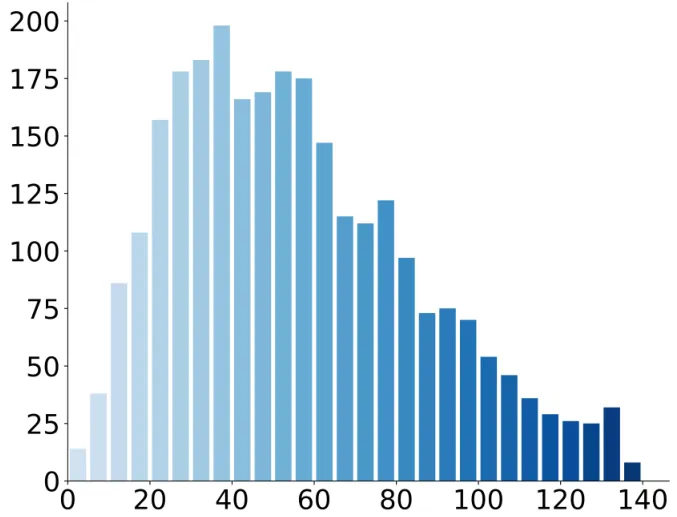
图4(论文 Fig.4b):轨迹长度分布,峰值约在 30-50 米,最长 138 米,视场内任务依然包含长程机动。
主结果如表 1。Random 与 Fixed 基线在三个测试集上 SR 几乎为零,未经航点监督的 Qwen2.5-VL-7B 也只有零星 oracle 成功,说明「目标可见」并不让任务变简单——开阔且非结构化的三维运动空间本身就足够难。相较当前 SOTA 的 TravelUAV,3DG-VLN 在 Test 上把 SR 从 25.00% 提到 38.82%(+13.82),OSR 从 30.26% 提到 55.92%,SPL 从 17.89% 提到 27.70%,NE 从 34.03 米降到 24.41 米;在未见物体与未见场景两个泛化集上同样全面领先,说明增益并非对训练场景的过拟合。
| 方法 | Test SR↑ | Test OSR↑ | Test NE↓ | Test SPL↑ | UO SR↑ | UO OSR↑ | US SR↑ | US OSR↑ |
|---|---|---|---|---|---|---|---|---|
| Random | 0.66 | 0.66 | 46.34 | 0.07 | 0.00 | 1.22 | 0.00 | 1.73 |
| Fixed | 0.00 | 3.29 | 46.30 | 0.00 | 0.00 | 2.44 | 0.00 | 0.00 |
| Qwen2.5-VL-7B | 0.00 | 3.29 | 42.31 | 0.00 | 0.00 | 3.05 | 0.58 | 2.31 |
| TravelUAV | 25.00 | 30.26 | 34.03 | 17.89 | 20.12 | 24.39 | 16.76 | 24.28 |
| 3DG-VLN | 38.82 | 55.92 | 24.41 | 27.70 | 28.05 | 39.63 | 21.39 | 35.84 |
表 1(论文 Table I 摘选):三个测试集上的主结果。3DG-VLN 在所有测试集的所有指标上优于 TravelUAV,OSR 的跃升尤其显著,说明模型不仅更常成功,也更常真正接近目标区域。
消融实验把两个设计选择的贡献拆得很干净(表 2)。把输入降到 256×256 的 LR 变体 Test SR 只有 23.03%;去掉方向线索的 3DG-W 为 25.00%;只用指令初始方向、不做在线更新的 3DG-S 为 34.87%;完整模型 38.82%。三个测试集上完整模型相对 LR 的 SR 增益分别为 15.79、9.76、4.05 个百分点,OSR 增益为 19.08、15.85、6.36 个百分点——高分辨率与方向引导各自独立贡献,且叠加后仍有余量。
| 策略 | Test SR↑ | Test OSR↑ | Test NE↓ | Test SPL↑ | UO SR↑ | US SR↑ |
|---|---|---|---|---|---|---|
| LR(256×256 低分辨率) | 23.03 | 36.84 | 35.03 | 17.05 | 18.29 | 17.34 |
| 3DG-W(无方向线索) | 25.00 | 44.08 | 29.86 | 17.31 | 22.56 | 17.34 |
| 3DG-S(仅初始方向) | 34.87 | 49.34 | 27.53 | 24.61 | 23.17 | 16.76 |
| 3DG-VLN(完整) | 38.82 | 55.92 | 24.41 | 27.70 | 28.05 | 21.39 |
表 2(论文 Table II 摘选):分辨率、方向线索、在线更新三个因素的消融。每一行去掉一个组件,性能单调下降,说明三者都是必要构件。
方向线索「何时重算」也被单独验证(表 3)。用长程任务开始时算出的旧方向(-O 行)进入 see-and-reach 阶段,TravelUAV 的 Test SR 为 24.34%,重算后为 25.00%;3DG-VLN 用旧方向只有 26.32%,在进入该阶段时重算则跳到 34.87%。再叠加闭环中的持续在线更新(34.87% → 38.82%),两级改进方向一致:方向线索必须跟着当前观测走。可视化也印证了这一点——3DG-VLN 会随目标在第一人称视图中的移动把线索从 front 更新到 front-right,而 3DG-S 抱着静态方向逐渐失去对齐。
| 策略 | Test SR↑ | Test OSR↑ | Test NE↓ | Test SPL↑ |
|---|---|---|---|---|
| TravelUAV-O(旧方向) | 24.34 | 26.97 | 34.81 | 16.58 |
| TravelUAV(阶段重算) | 25.00 | 30.26 | 34.03 | 17.89 |
| 3DG-VLN-O(旧方向) | 26.32 | 40.79 | 35.90 | 19.29 |
| 3DG-S(阶段重算) | 34.87 | 49.34 | 27.53 | 24.61 |
表 3(论文 Table III 摘选):旧方向线索与重算方向线索的对照,两级重算(阶段级 + 闭环级)都带来稳定增益。
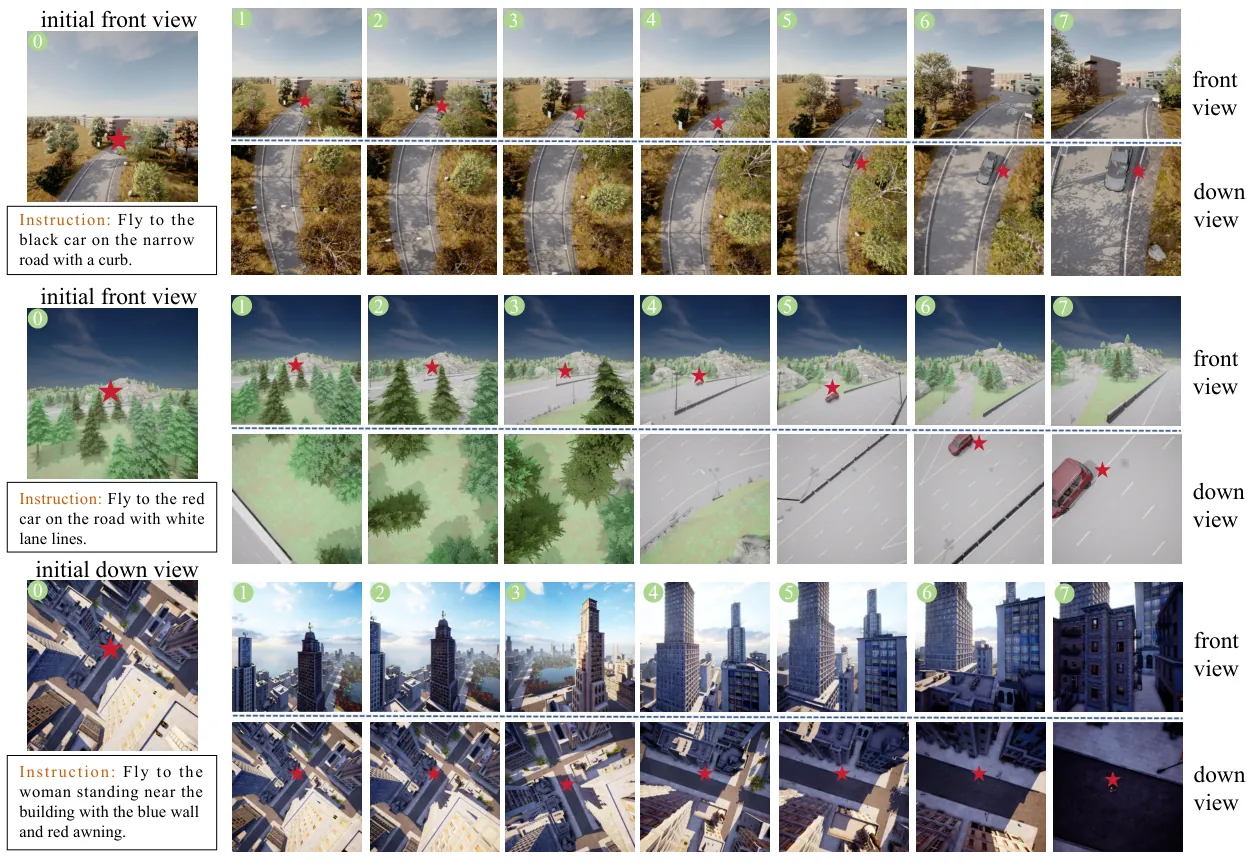
图5(论文 Fig.5):高保真仿真中的导航可视化,前视与下视双视图逐时刻给出,模型自主避障并抵达目标近旁。
真实世界试验只做定性展示:在光照变化与背景差异下,3DG-VLN 仍能把无人机引导到指定目标的近旁,而非仅仅接近目标区域,为仿真到现实的迁移提供了初步证据。需要注意这部分没有量化指标,只有轨迹截图。
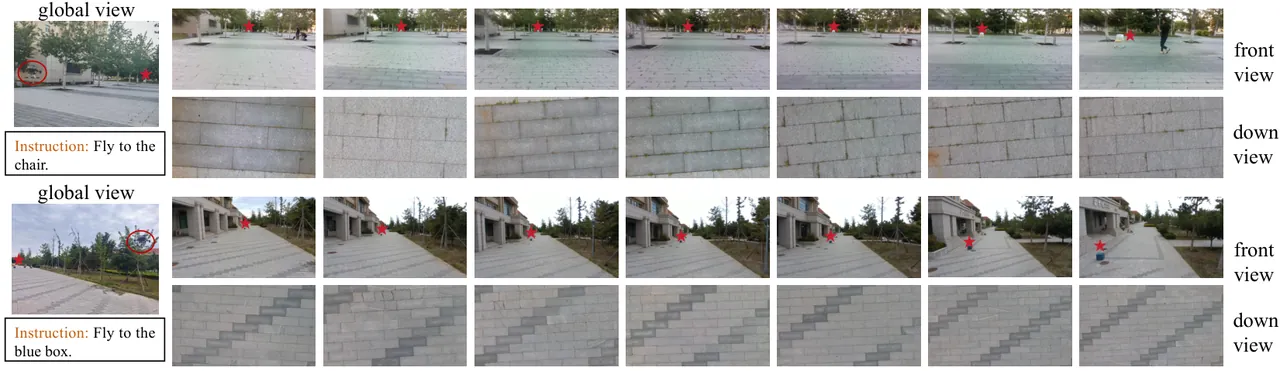
图6(论文 Fig.7):真实世界试验的逐时刻前视/下视观测,目标从远处逐渐占据画面中心。
局限性
作者自述:方向更新依赖外部开放集检测器。在线方向线索由 Grounding DINO 的检测框反投影而来,方向估计的质量直接受检测质量支配;检测漏检、多检或框心偏移都会污染方向线索。作者把「联合建模视觉接地、空间对齐与运动规划的一体化框架」列为未来工作。
单框有效性判据过于保守。「恰好一个检测框」才视为有效视图,意味着目标旁存在同类干扰物、或检测器给出两个候选框时,该帧的方向信息被整体丢弃、回退到上一时刻线索。在密集城区或多目标场景中,这会系统性地降低方向更新频率,而论文没有报告有效视图命中率这类诊断统计。
绝对精度仍然有限,真实世界缺乏量化。即便完整模型在 10 米半径下的 Test SR 也只有 38.82%,超过六成的尝试仍未达标;真实世界部分仅有定性截图,没有成功率与误差数字,仿真到现实的结论强度有限。此外 Test UO 上引入方向引导后 NE 略有上升,作者归因于未见物体下接地不确定导致的噪声方向线索,这恰好说明方向机制在分布外仍不稳定。
总结与展望
这篇论文的价值首先在于评测口径:把 see-and-reach 从整体式 UAV-VLN 中切出来、把成功半径从 20 米收紧到 10 米,让「终端精度」第一次成为可以被单独诊断的能力。在此口径下,高分辨率双视图与在线方向更新这两个看似工程化的选择被消融证明为必要构件,且二者的增益可以叠加。
方法论上,3DG-VLN 没有发明新的网络结构,而是把几何先验(机体系航点、四 bin 方向、像素反投影)以提示词的形式喂给一个 LoRA 微调的通用 VLM,再用外挂检测器在闭环中持续刷新先验。这种「VLM 出航点、几何模块出先验」的分工,为空中具身智能提供了一条可复现、可审计的路线;下一步的自然方向是把接地、对齐与规划收进同一个模型,摆脱对外部检测器的依赖。
金句
「通过把抵达过程隔离出来、并主张更严格的 10 米成功判据,我们试图回答空中具身智能的一个基本问题:智能体如何有效地把语言指令与视觉证据转化为可靠抵达目标近旁所需的精确三维机动。」(论文引言,译)