PAPER DEEP DIVE
LifelongCrossNav:面向跨楼层多目标导航的持久 3D 语义记忆
LifelongCrossNav 把「单 episode 内的顺序多目标导航」与「多层建筑中的楼梯通行」合并成同一个问题:用一张支撑感知的稀疏 3D 体素地图同时存放几何与目标无关的视觉-语言特征(SED/CLIP),使后续任意新目标都能按余弦相似度直接检索历史观测;统一策略在平面探索、楼梯穿越与 POI 导航之间按模式切换,并用七种体素状态、延迟楼梯晋升与类型感知的 3D A* 把楼梯从语义标签变成可规划的边。作者同时发布 HM3D-MFMON 基准(36 个场景、927 条三目标 episode,其中 288 条的完整目标序列可证明必须跨楼层)与因果正确的事后逐阶段评测协议。实验上,序列成功率从平面持久地图基线 OneMap 的 16.83% 提升到 29.13%,SPL 从 6.95% 提升到 9.64%;在必须跨楼层的子集上 OneMap 为 0.00%,LifelongCrossNav 达到 7.99%。消融显示后段条件 SPL 的增益来自历史语义检索(History-POI),而非单纯的几何持久化。代码以 MIT 协议开源。
论文:LifelongCrossNav: Persistent 3D Semantic Memory for Cross-Floor Multi-Object Navigation
作者:Zehui Li*、Zihao Sun*、Jiawei Xu、Zheqi He†、Xiaoqiang Zhang、Jing-Shu Zheng、Lu Liu、Dahui Gao、Xiuwan Chen†(* 共同第一作者,† 通讯作者)
机构:北京大学、北京智源人工智能研究院(BAAI)
链接:arXiv:2608.07079v1 · 全文 HTML · 项目页 · 代码仓库(MIT,release-v2.0 分支)
代码状态:已开源。仓库给出 SED、D-FINE、MobileSAM、SegFormer-B2 权重下载、HM3D-MFMON 数据集入口、927 条 episode 全量评测与 288 条跨楼层子集分析脚本;本文精读基于 release-v2.0 的源码快照。
一句话总结
LifelongCrossNav 把「一次 episode 内的多个物体目标」与「多层建筑里的楼梯通行」合并成同一个问题:用一张支撑感知的稀疏 3D 体素地图同时存放几何与目标无关的视觉-语言特征,使后续目标可以直接检索历史语义观测;统一策略在平面探索、楼梯穿越与 POI 导航之间按模式切换。在 927 条三目标 episode 上,它把序列成功率从平面持久地图基线 OneMap 的 16.83% 提到 29.13%;在必须跨楼层的 288 条 episode 上,OneMap 的序列成功率为 0,而它拿到 7.99%。
研究背景与动机
物体目标导航(ObjectNav)要求智能体在未见环境中探索并走到某一类物体的某个实例跟前。过去几年的进展集中在语义感知与探索策略上:开放词汇检测、视觉-语言前沿打分、在线 3D 场景图等手段让「找没见过的类别」变得可行。但这些工作几乎都默认两个简化:一次只给一个目标,以及环境是单层的。真实室内任务往往相反——机器人要先去厨房拿杯子、再上楼把杯子放到床头柜、最后回客厅关灯;目标是一个接一个揭示的序列,而建筑本身有楼梯、有上下重叠的房间。
已有研究把这两个需求分开处理。跨楼层方法(MFNP、ASCENT、TravExplorer)建模楼梯、楼层切换或楼层级推理,但只考虑单个目标,完成即结束,不需要为「下一个还不知道的目标」保留可查询的语义观测。多目标导航方法(MultiON、GOAT-Bench、OneMap)在目标序列之间保留环境信息,但其表示主要是平面或鸟瞰地图:竖直方向被压扁,上下重叠的走廊与楼梯井在图上互相覆盖,楼梯这条唯一的楼层连接要么不存在、要么不可通行。于是出现一个真空地带:平面持久记忆不知道路在竖直方向怎么走,跨楼层方法又不会为未来目标存语义。
作者用 lifelong 一词指代「episode 内持久」这一设定:环境与已积累的记忆在连续的目标子任务之间保持不变,只有目标文本在切换。这与跨 episode 的终身学习不同,却恰好是多目标导航的真实约束——第 3 个目标揭示时,机器人已经站在第 2 个目标旁边,它此前看到过的所有沙发、床、马桶都值得被记住,而不是推倒重建。问题因此变成:记忆既要目标无关(因为未来目标未知),又要能被任意新目标重新查询;地图既要保留高度(否则分不清二楼卧室与一楼客厅),又要给出可执行的楼梯连接(否则记忆再丰富也走不过去)。
LifelongCrossNav 的回答是把几何与语义放进同一套稀疏 3D 体素坐标:几何分支用支撑感知射线投射区分地板、楼梯与悬空,语义分支把 SED 稠密视觉-语言特征抬升到被观测的表面体素并做累积置信融合。两者共享坐标,于是「查询历史语义」与「规划一条能走的路」可以在同一张图上完成。统一策略再在四类候选(普通前沿、楼梯前沿、历史 POI、实时 POI)与四种模式(Basic Explore、Stair Explore、POI Navigation、Target Approach)之间切换,用同一个类型感知的 3D A* 求解。
配套的贡献是基准 HM3D-MFMON:从 HM3D v0.2 中挑出 36 个具备有效多层结构与楼梯连通的场景,生成 927 条三目标 episode,并从中验证出 288 条「必须跨楼层」(Cross-Floor-Required, CFR)子集——不完成至少一次楼层切换就不可能完成整条目标序列;首次强制切换发生在第 1、2、3 个子任务的分别有 102、101、85 条。由于后续子任务的起点取决于智能体自己为前一个目标选中的实例,作者还提出事后(post-hoc)逐阶段最短路径协议:每个阶段的最短路径分母从该阶段真实起点重算,且不使用未来目标,避免 oracle 路线为了讨好未来目标而牺牲当前目标的因果性。
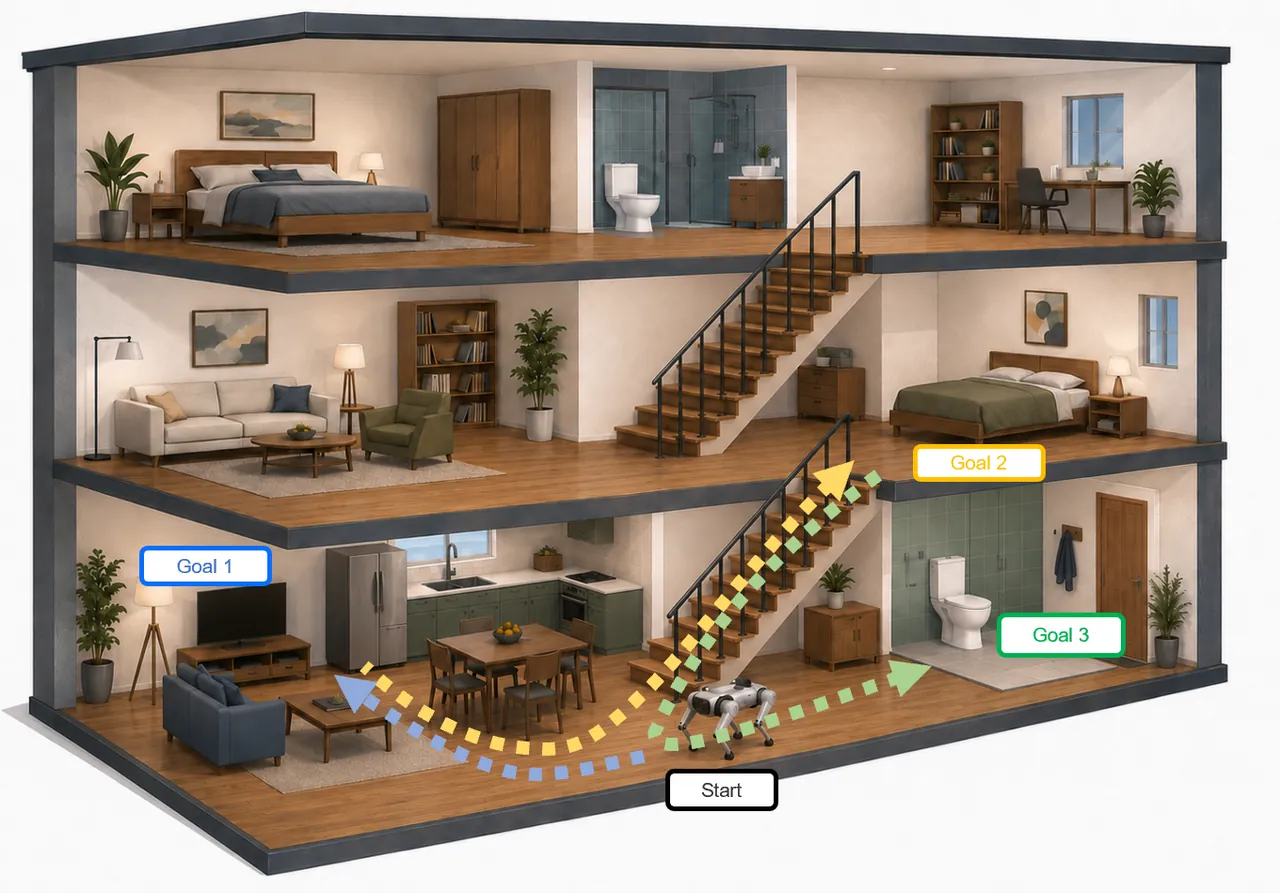
图 1:顺序多目标 ObjectNav 的概念示意。智能体从 Start 出发依次前往 Goal 1(电视)、Goal 2(床)、Goal 3(马桶),彩色轨迹是连续的目标子任务,其中包含穿过楼梯的跨楼层段。
任务设定与预备知识
每个 episode 由有序的 $K$ 个物体目标 $(g_{1},\ldots,g_{K})$ 定义。智能体在任意时刻只看到当前目标 $g_{k}$;只有当第 $k$ 个子任务成功完成,$g_{k+1}$ 才被揭示并激活。每步观测为自我中心 RGB 图 $I_{t}$、深度图 $D_{t}$、6-DoF 相机位姿 $T_{t}$ 与当前目标文本。动作空间是离散的:MoveForward 前进 $0.25$ m,TurnLeft、TurnRight、LookUp、LookDown 各转 $30^{\circ}$,以及 Stop。子任务成功的判定是:在有效目标实例的成功阈值内发出 Stop。HM3D-MFMON 中 $K=3$,类别集合为 chair、bed、toilet、plant、sofa、tv_monitor 六类,当前类别的全部有效实例都算合法目标。
记忆的生命周期是本文的关键设计:episode 内,3D 几何地图、楼梯状态与目标无关的视觉-语言体素特征跨目标保留;当新目标到来时,只重算它的文本嵌入与查询条件相似度场,而与旧目标绑定的 POI、导航路径、目标验证状态全部重置;独立 episode 之间所有状态清零。也就是说,「看到过什么」被保留,「正在追什么」被清空——这正是目标无关记忆与目标条件检索之间的分界线。
方法详解
支撑感知的 3D 体素地图
地图是稀疏体素集合而非平面栅格:有效深度像素反投影到相机系、经位姿变换到世界系后量化为体素。深度射线终点提供「被观测表面」证据,射线中途采样提供「自由空间」证据;只存被观测体素与局部推断的导航状态,因此地图随探索增量生长。与平面投影不同,体素保留高度,能区分竖直重叠的房间、走廊、平台与楼梯井。配置上体素边长 0.10 m,XY 索引范围 60×60 m,Z 方向约 ±30 m,膨胀半径 0.20 m,支撑搜索深度 0.40 m。
导航层面把观测空间抽象为四种功能体素:Occupied(被观测表面,含墙、家具、地板与尚未确认的楼梯候选)、Traversable(有可靠支撑的自由空间)、Stair(经语义与几何共同确认的楼梯表面)、Unsupported(向下搜索支撑失败的自由空间,是潜在下楼 transition 的几何证据)。对每个射线观测到的自由空间体素,系统在 0.40 m 的竖直范围内向下搜索第一个有效支撑:支撑属于普通表面则记 Traversable,属于已确认楼梯则记楼梯可通行,找不到支撑则记 Unsupported。发布代码把这一判定写成两个支撑集合加一段两阶段更新:SUPPORT_FLOOR = {OCCUPIED, FAKE_STAIR}、SUPPORT_STAIR = {STAIR, STAIR_EXPANDED},先对同一地图快照算出全部候选类型再一次性提交,使迭代顺序不影响结果;代码中还有第七种状态 FAKE_STAIR 表示「被拒绝或可撤销的楼梯证据」,它可供 A* 以高代价通过,但永远不能作为导航终点或前沿来源。
楼梯体素的确认是双通道的:SegFormer-B2 输出像素级楼梯掩膜(像素阈值 0.25、连通域最小 80 px),用深度与位姿抬升到 3D,再用局部高度变化、台阶趋势、空间连续性与支撑关系做几何验证(下楼确认阈值 0.48、几何阈值 0.65)。更重要的是「延迟晋升」:普通探索阶段即使出现上/下楼证据,Occupied 体素也不会被立刻改写成 Stair;只有当对应楼梯入口被走到并验证、控制器进入 Stair Explore 之后,被接受的表面体素才晋升为 STAIR,相邻占用体素可成为 STAIR_EXPANDED 以补齐稀疏观测的断口,被拒绝的证据保留为 FAKE_STAIR。这一延迟防止普通探索中的不确定楼梯观测直接污染跨楼层规划图。
持久 3D 语义记忆:目标无关特征,目标条件检索
语义分支采用 SED 稠密视觉-语言编码器:每帧 RGB 得到 $\mathbf{F}_{t}^{\mathrm{dense}}\in\mathbb{R}^{24\times 24\times 768}$ 的空间特征图,与 CLIP 文本嵌入空间对齐(release 代码注释直接写明 ConvNeXt-L 输出步长 32,768×768 输入对应 24×24 个空间位置,每位置投影到 768 维 CLIP 嵌入)。特征图双线性上采样到深度分辨率后,每个有效深度像素携带一个局部上下文视觉特征,并只写入其深度射线到达的表面体素——特征不穿过自由空间扩散,避免把「看到沙发」糊成「沙发上方整根空气柱」。
同一帧内多个像素量化到同一体素 $\mathbf{v}$ 时,用观测质量加权聚合:
$$\bar{\mathbf{f}}_{\mathbf{v}}^{(t)}=\frac{\sum_{p\in\mathcal{P}_{\mathbf{v}}}q_{p}\mathbf{f}_{p}}{\sum_{p\in\mathcal{P}_{\mathbf{v}}}q_{p}+\epsilon} \tag{1}$$
其中 $\mathcal{P}_{\mathbf{v}}$ 是落入该体素的像素集合,$\mathbf{f}_{p}$ 为像素特征,$q_{p}$ 为观测质量。观测质量本身由深度梯度与距离偏好共同决定:
$$q_{t}(u,v)=\left[1-\tanh\!\left(\gamma\left\|\nabla D_{t}(u,v)\right\|\right)\right]\cdot\exp\!\left[-\frac{(d_{0}-D_{t}(u,v))^{2}}{3\sigma_{d}^{2}}\right] \tag{2}$$
深度不连续处(物体边缘)与远离偏好距离 $d_{0}$ 的观测因此获得更小权重;实验中 $\gamma=0.20$、$d_{0}=1.0$ m、$\sigma_{d}=1.5$ m。跨帧的多视角融合是累积加权平均而非指数滑动平均:设 $\mathbf{F}_{\mathbf{v}}^{(t-1)}$、$C_{\mathbf{v}}^{(t-1)}$ 为已存特征与累积置信,$c_{\mathbf{v}}^{(t)}$ 为当前帧观测置信,则
$$\mathbf{F}_{\mathbf{v}}^{(t)}=\frac{C_{\mathbf{v}}^{(t-1)}\mathbf{F}_{\mathbf{v}}^{(t-1)}+c_{\mathbf{v}}^{(t)}\bar{\mathbf{f}}_{\mathbf{v}}^{(t)}}{C_{\mathbf{v}}^{(t-1)}+c_{\mathbf{v}}^{(t)}},\qquad C_{\mathbf{v}}^{(t)}=C_{\mathbf{v}}^{(t-1)}+c_{\mathbf{v}}^{(t)} \tag{3}$$
融合后的特征与置信在 episode 内跨目标子任务持久保存。当新目标文本 $q$ 激活时,其归一化文本嵌入 $\mathbf{t}_{q}$ 与每个带特征的体素做余弦相似度,得到一个查询条件的 3D 相似度场:
$$s_{q}(v)=\frac{\mathbf{f}_{v}^{\top}\mathbf{t}_{q}}{\|\mathbf{f}_{v}\|_{2}\,\|\mathbf{t}_{q}\|_{2}} \tag{4}$$
相似度场是查询的函数,不属于持久记忆本身;存储的体素特征在目标切换时一个字节都不变。对相似度场做 3D 邻域聚类,取排名最高的 4 个簇作为 History POI 候选,并为每个簇指派附近可达的导航位置。于是「历史语义检索」不需要固定的检测器类别表:任何能用文本描述的物体都可以回查记忆,这是它相对 YOLO 类实时检测的互补之处。
统一导航策略:四类候选与四种模式
策略的候选集合为 $\mathcal{C}_{t}=\mathcal{P}_{t}^{\mathrm{live/history}}\cup\mathcal{F}_{t}^{\mathrm{trav}}\cup\mathcal{F}_{t}^{\mathrm{desc}}\cup\mathcal{F}_{t}^{\mathrm{asc}}$,默认优先级是 POI 高于普通前沿、普通前沿高于下楼前沿、下楼前沿高于上楼前沿。Basic Frontiers 是普通探索期的三种平面候选:Traversable Frontier 位于受支撑可通行体素与真正未知空间的边界;Descend Frontier 位于可通行空间与 Unsupported 或 FAKE_STAIR 的边界,提示潜在的下楼口;Ascent Frontier 由楼梯语义证据、RGB-D 台阶几何与多帧一致性生成,其导航位置仍留在当前探索平面上的潜在上楼入口附近。控制器先探索当前楼层可达的 Traversable Frontier,只有当没有可达的普通前沿时才考虑 Descend 与 Ascent;默认先试下楼,但顺序可按最近一次成功的楼层切换方向自适应调整。
Stair Frontiers 是方向感知的推进边界,从当前已确认的楼梯体素簇中提取,其高度随观测到的楼梯而变化,使智能体能在楼梯结构内继续向上或向下推进。Live POI 来自可配置的目标检测接口:对 HM3D 六类目标(被 MS-COCO 覆盖)用 YOLOv7(置信度 0.70),类别之外改用 YOLO-World,再用 MobileSAM 提取掩膜、深度与位姿恢复 3D 位置。History POI 即上一节的检索结果。被选中的候选会获得一个短暂的承诺期,使增量地图更新不会引起目标频繁切换——承诺是稳定性机制,不是第五类候选。
四种模式各自约束规划图的准入体素与连通性。Basic Explore 在当前可通行区域上使用严格的 26 邻接图,选中的目标保持在当前探索层;它把 Descend 与 Ascent 目标只当作入口提案,不主动穿越未确认的楼梯体。POI Navigation 使用常规 26 邻接图,并在目标 POI 位于另一层时复用此前已建立的楼梯连通。Stair Explore(即 StairSem 模式)准入已确认的楼梯状态与楼梯支撑的空气层,把端点邻域扩展到 1.0 m 物理球内以连接稀疏的楼梯观测,同时用请求的上/下方向约束竖直进展、抑制无关平台或相邻梯段;活跃楼梯会话保持控制权,不被普通前沿或无关语义候选打断。Target Approach 在 Live POI 附近选择安全观测位,做局部路径规划与离散视角修正,只 refinement 相机位姿、目标掩膜与停止决策,不发起新的跨楼层探索。
所有模式共用一个类型感知的 3D A*。启发式是当前体素到目标的 3D 欧氏距离 $h(n)=\sqrt{(i_{x}-g_{x})^{2}+(i_{y}-g_{y})^{2}+(i_{z}-g_{z})^{2}}$,转移代价为 $c(n,n^{\prime})=\|n-n^{\prime}\|_{2}+p(\tau_{n^{\prime}})$,其中类型惩罚 $p$ 为:TRAVERSABLE 与 TRAVERSABLE_STAIR 取 0,STAIR 取 4,STAIR_EXPANDED 取 5,FAKE_STAIR 取 10。惩罚的取向是偏好稳定的受支撑空气、同时保留对已确认楼梯的访问;FAKE_STAIR 只作为高代价兜底,永远不被选为导航终点。普通规划优先非膨胀体素;当某模式显式允许膨胀端点时其转移代价乘 2;若智能体已身处膨胀可通行区域,规划器可临时保留膨胀状态让它离开,随后恢复严格规划。StairSem 图刻意宽松:它验证每条边存储的端点,但作者明确声明不保证长边沿途每个中间采样点的连续扫掠体积碰撞认证——这是对稀疏楼梯观测的务实妥协,也是本文的一个已知边界。
最终的目标接近与验证是闭环的最后一环:获得稳定目标证据后,把检测掩膜投影到 3D 并选择附近安全观测位(内部接近距离 1.30 m);接近过程中按检测置信度、掩膜质量、可见性、观看方向与 3D 距离五项准则持续验证。到达 History POI 或 Live POI 本身并不完成子任务,当前目标观测必须通过验证;验证成功才激活下一个目标并保留几何地图、楼梯结构与目标无关语义记忆,验证失败则回到候选选择继续探索。配置中的 enable_history_poi 开关正是 w/o H-POI 消融的实现位置:关掉它只禁用 History POI 的生成与选择,持久 SED 特征图、累积融合、Live POI、支撑感知建图、楼梯感知与跨楼层规划全部保留。
flowchart TD
  A[RGB-D 帧 + 6-DoF 位姿 + 当前目标文本] --> B[支撑感知 3D 体素地图
Occupied Traversable Stair Unsupported]
  A --> C[SED 稠密编码 24x24x768
质量加权聚合 式1 式2]
  C --> D[累积置信融合 式3
目标无关语义体素记忆]
  B --> E{候选优先级
POI 普通前沿 下楼 上楼}
  D -->|目标文本余弦检索 式4
Top-4 簇 History POI| E
  A -->|YOLOv7 或 YOLO-World + MobileSAM
Live POI| E
  E -->|存在可达 POI| F[POI Navigation
26 邻接 A* 可复用楼梯连通]
  E -->|仅普通前沿| G[Basic Explore
Traversable 优先 再 Descend 再 Ascent]
  E -->|楼梯入口已验证| H[Stair Explore StairSem
方向感知 Stair Frontier + 1.0 m 球邻接]
  F --> I[Target Approach
置信度 掩膜 可见性 朝向 距离 五重验证]
  G --> E
  H -->|多帧确认到达新平台| E
  I -->|验证失败 拉黑该 POI| E
  I -->|验证成功 激活下一目标| J[保留几何与语义记忆
重置 POI 路径与验证状态]
  J --> E
方法流程图:按论文第 3 节与附录 E、F 绘制的闭环结构。几何分支与语义分支共享同一套体素坐标,策略在四种模式间切换,验证失败会回到候选选择而非终止。
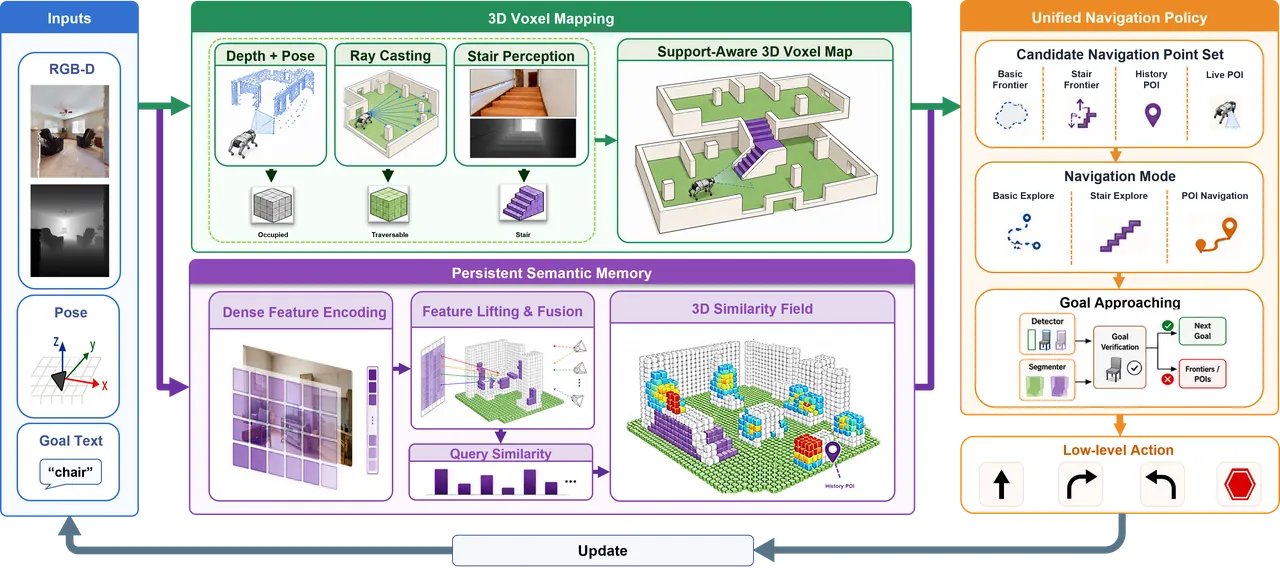
图:论文图 2,系统总览。左侧为输入(RGB、深度、位姿、目标文本),中部上排是 3D 体素建图(深度+位姿、射线投射、楼梯感知、支撑感知体素图),中排是持久语义记忆(稠密特征编码、特征抬升与融合、3D 相似度场),右侧是统一导航策略(候选集、导航模式、目标接近)。
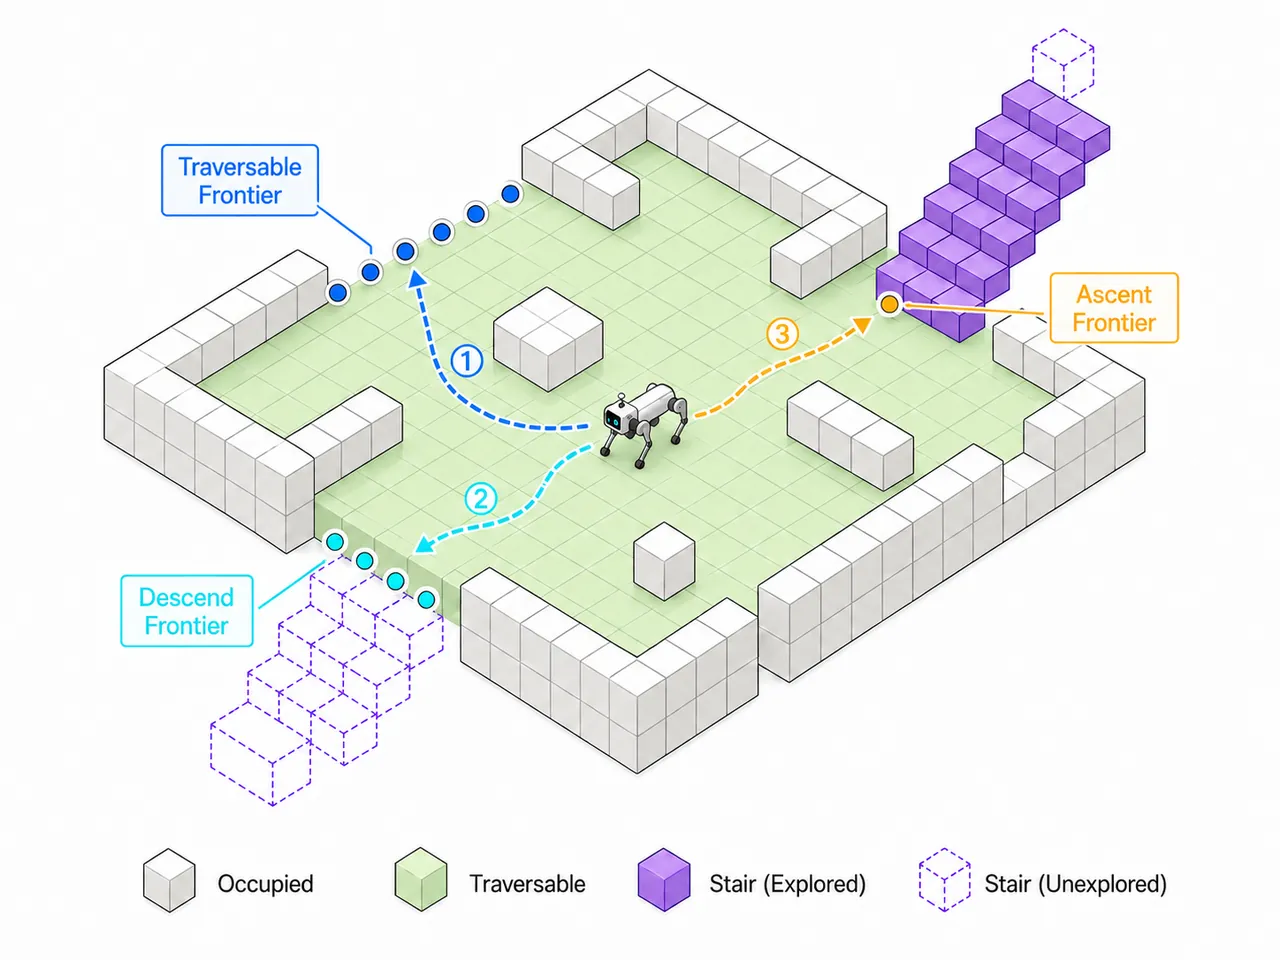
图:论文图 3,Basic Frontier 的三种类型与默认优先级:① Traversable、② Descend、③ Ascent;虚线楼梯表示尚未探索的跨楼层结构,图例给出 Occupied、Traversable、Stair(已探索与未探索)四类体素。
基准与评测协议
HM3D-MFMON 建立在 HM3D v0.2 及其语义标注之上:36 个具备有效多层结构与楼梯连通的场景,927 条三目标 episode,六个目标类别;CFR 子集 288 条,其整条目标序列不完成至少一次楼层切换就无法完成。评测设置冻结为:RGB/深度 640×640、水平视场 90°、相机高度 0.88 m、episode 动作预算 1200 步、成功半径 1.50 m、navmesh 智能体身高/半径 1.50/0.10 m、最大攀爬 0.30 m 与 60° 坡度;全部实验在单张 NVIDIA RTX 5090(32 GB)上完成,Habitat-Sim/Lab 0.2.4。
顺序多目标评测的难点在于分母:单目标 ObjectNav 的起点与类别固定,最短测地距离可以事先算好;而顺序任务中第 $k$ 阶段的起点取决于智能体为第 $k-1$ 个目标选中的实例与完成位置。对整条序列做全局最优路由可以消除歧义,但那条路由用到了尚未揭示的未来目标,可能为了靠近未来目标而故意不选当前类别最近的实例,违反顺序任务的因果信息约束。作者因此采用事后逐阶段最短路径:记 $\mathbf{x}^{\mathrm{start}}_{i,k}$ 为第 $k$ 个目标激活时智能体的真实位置,$\mathcal{X}_{i}(g_{i,k})$ 为当前类别全部实例的合法可导航观测位,则
$$d^{*}_{i,k}=\min_{\mathbf{x}\in\mathcal{X}_{i}(g_{i,k})}d_{\mathrm{geo}}\left(\mathbf{x}^{\mathrm{start}}_{i,k},\mathbf{x}\right) \tag{5}$$
其中 $d_{\mathrm{geo}}$ 是导航网格上的测地距离。该参考只依赖本阶段真实起点、当前目标与其合法实例,不使用未来目标,因此不同智能体可以用与各自前序选择一致的最短路径被公平比较。逐目标路径效率为
$$\mathrm{SPL}_{i,k}=\mathrm{SR}_{i,k}\frac{d^{*}_{i,k}}{\max\left(d^{*}_{i,k},\,l_{i,k}\right)} \tag{6}$$
序列级指标沿用 MultiON 的 SR、SPL、PR、PPL:PR 是已完成目标占比,PPL 对成功前缀按路径效率加权。阶段级则报告条件指标与全局指标:在顺序终止协议下第 $k$ 个子任务只有在前序全部完成时才执行,令 $\mathrm{SR}_{i,0}=1$,到达阶段 $k$ 的 episode 数为 $\sum_{i}\mathrm{SR}_{i,k-1}$,于是条件成功率为 $\mathrm{SR}^{\mathrm{cond}}_{k}=\sum_{i}\mathrm{SR}_{i,k}\,/\,\sum_{i}\mathrm{SR}_{i,k-1}$,条件 SPL 为 $\mathrm{SPL}^{\mathrm{cond}}_{k}=\sum_{i}\mathrm{SPL}_{i,k}\,/\,\sum_{i}\mathrm{SR}_{i,k-1}$;全局指标对全部 $N$ 条 episode 平均、未执行子任务记零,并满足级联关系 $\mathrm{SR}^{\mathrm{global}}_{k}=\mathrm{SR}^{\mathrm{global}}_{k-1}\cdot\mathrm{SR}^{\mathrm{cond}}_{k}$。条件指标隔离「到达该阶段的 episode 内部」的表现,全局指标额外保留前序失败的级联效应;对三目标 episode,$\mathrm{SR}^{\mathrm{global}}_{3}$ 就等于 episode 级 SR。发布代码中这一协议落在 eval/habitat_multi_evaluator.py:object_nav_gen.get_geodesic(pos, sim, obj, correct_start=True) 从本阶段真实起点重算测地距离,再按 spl = min(1.0, best_dist / max(path_length, best_dist)) 得到阶段 SPL。
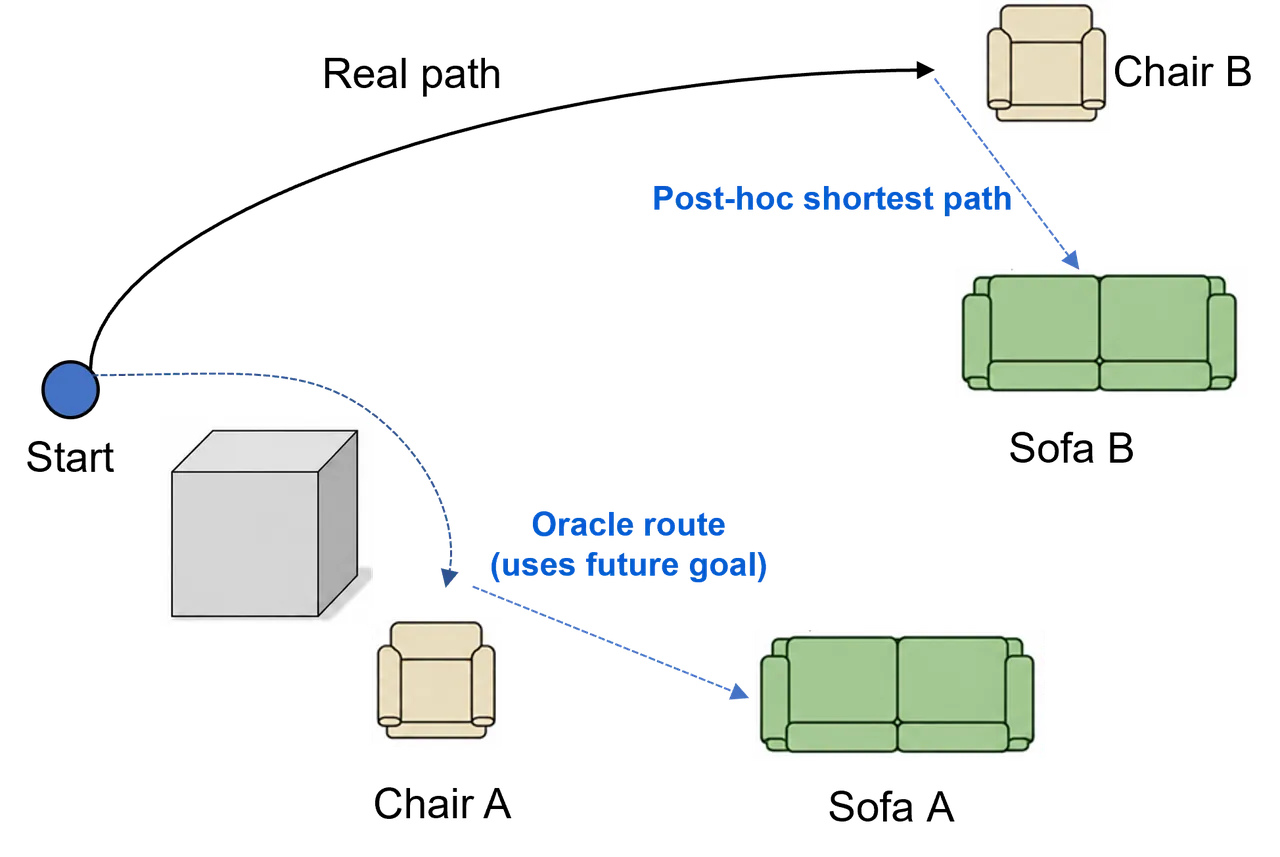
图:论文图 4,事后逐阶段最短路径评测。全局最优(oracle)路线会依赖尚未揭示的未来目标,而 post-hoc 最短路径只从本阶段真实起点重算,保持因果性。
实验结果
多目标导航:平面持久记忆在楼梯前失效
主对比对象是 OneMap——它维护一张可跨目标复用的开放词汇 2D 语义地图,是平面持久记忆的代表。在全部 927 条 episode 上,LifelongCrossNav 的序列 SR/SPL/PR/PPL 为 29.13/9.64/48.40/16.70,OneMap 为 16.83/6.95/33.69/14.03:序列完成率接近翻倍,说明 3D 支撑感知表示确实支撑了更多涉及竖直空间探索的子任务。关掉 History POI 的变体(w/o H-POI)SR/PR 略高(29.77/48.54)但 SPL/PPL 明显更低(8.46/14.91 对 9.64/16.70),说明历史检索的收益主要体现在路径效率而非成功率上。
| 方法 | SR ↑ | SPL ↑ | PR ↑ | PPL ↑ |
|---|---|---|---|---|
| OneMap(平面持久语义地图) | 16.83 | 6.95 | 33.69 | 14.03 |
| w/o H-POI(关历史检索) | 29.77 | 8.46 | 48.54 | 14.91 |
| LifelongCrossNav | 29.13 | 9.64 | 48.40 | 16.70 |
表 1:论文表 1,全部 927 条 HM3D-MFMON episode 的顺序多目标导航结果(%)。
CFR 子集上的差距更具决定性:OneMap 的序列 SR 与 SPL 均为 0.00(PR 18.52、PPL 7.97),即它能完成一些前序子任务,但从未完成过任何一条必须跨楼层的完整序列;LifelongCrossNav 为 7.99/2.35/29.17/9.75,w/o H-POI 为 7.29/1.91/28.94/9.16。作者的解释很直接:CFR 中能走到后段的 episode 其前序同层子任务已完成,剩下的目标大概率带着未解决的楼层切换;没有显式楼梯表示与跨楼层连通,平面语义地图给不出可执行解。绝对数值不高(7.99%)正说明该子集的难度——它把「跨楼层」从可选项变成必选项。
| 方法 | SR ↑ | SPL ↑ | PR ↑ | PPL ↑ |
|---|---|---|---|---|
| OneMap(平面持久语义地图) | 0.00 | 0.00 | 18.52 | 7.97 |
| w/o H-POI(关历史检索) | 7.29 | 1.91 | 28.94 | 9.16 |
| LifelongCrossNav | 7.99 | 2.35 | 29.17 | 9.75 |
表 2:论文表 2,288 条 Cross-Floor-Required episode 的顺序多目标导航结果(%)。
阶段级条件指标:后段效率来自历史语义复用
条件指标把「记忆是否真的省路」量化了出来。在全部 episode 上,三种方法的第 1 阶段条件 SR 分别为 54.58/70.33/70.33(OneMap / w/o H-POI / LifelongCrossNav),第 3 阶段为 56.73/65.40/63.68;条件 SPL 的差异更清楚:第 2 阶段 24.81/25.68/32.28,第 3 阶段 30.81/25.56/34.58。两种持久记忆方法都在后段变得更省路,而 w/o H-POI 几乎不变——这一对照说明后段效率增益主要来自复用历史语义观测,而非几何探索本身。CFR 子集上条件 SPL 不再单调上升(后段目标仍可能需要未见楼层的探索与额外楼梯穿越),但完整框架在后段仍优于两个对照:第 3 阶段 20.54 对 w/o H-POI 的 12.62、OneMap 的 0.00,说明跨楼层之后历史检索依然有用。
| 方法 | Cond SR k=1 | k=2 | k=3 | Cond SPL k=1 | k=2 | k=3 |
|---|---|---|---|---|---|---|
| OneMap(全部 927) | 54.58 | 54.35 | 56.73 | 23.46 | 24.81 | 30.81 |
| w/o H-POI(全部 927) | 70.33 | 64.72 | 65.40 | 25.26 | 25.68 | 25.56 |
| LifelongCrossNav(全部 927) | 70.33 | 65.03 | 63.68 | 25.26 | 32.28 | 34.58 |
| OneMap(CFR 288) | 42.36 | 31.15 | 0.00 | 17.82 | 16.26 | 0.00 |
| w/o H-POI(CFR 288) | 55.56 | 43.13 | 30.43 | 19.00 | 19.43 | 12.62 |
| LifelongCrossNav(CFR 288) | 55.56 | 43.13 | 33.33 | 19.00 | 23.38 | 20.54 |
表 3:按论文图 5 至图 8 读取的阶段级条件 SR / 条件 SPL(%)。全局指标(论文表 11、12)与条件指标满足级联关系,例如全部 episode 上 LifelongCrossNav 的全局 SPL 在第 2、3 阶段为 22.71 与 15.82,显著高于 w/o H-POI 的 18.06 与 11.64。
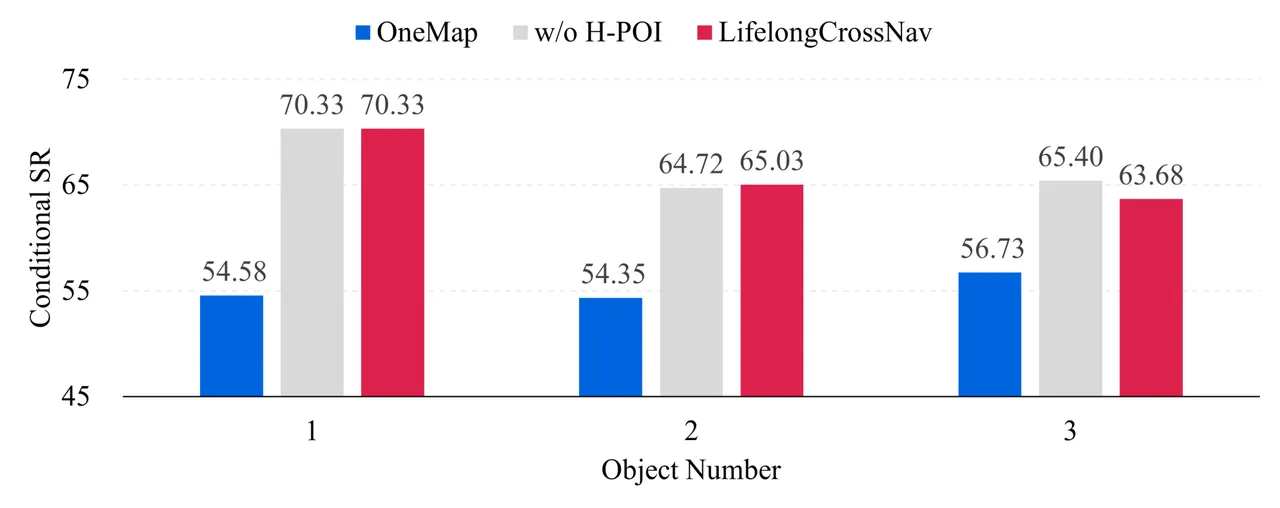
图:论文图 5,全部 927 条 episode 的阶段条件 SR。LifelongCrossNav 全程高于 OneMap;第 3 阶段 w/o H-POI 略高(65.40 对 63.68),其成因在失败分析中讨论。
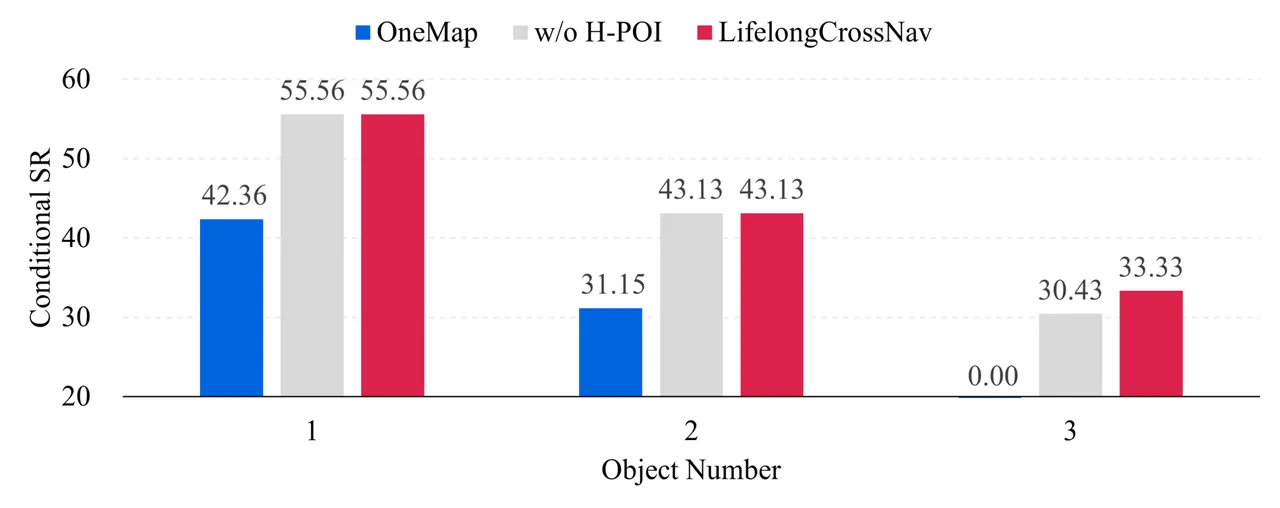
图:论文图 7,288 条 CFR episode 的阶段条件 SR。OneMap 在第 3 阶段归零:凡能走到第 3 目标的 CFR episode,其剩余目标必然带着未解决的楼层切换。
单目标辅助评测与失败分析
作为辅助验证,作者在 HM3D ObjectNav 验证集(2000 条单目标 episode)上对比 12 个代表方法。LifelongCrossNav 取得 SR 59.7 / SPL 28.0,不使用在线 LLM 推理即与 BeliefMapNav(61.4/30.6)、ApexNav(59.6/33.0)同档,低于 ASCENT(65.4/33.5)与 XGX(72.9/35.7),高于 OneMap(55.8/37.4)的成功率但 SPL 更低。作者的解读是:多层策略优先探索当前楼层、之后才激活跨楼层候选,这一保守顺序在单层 episode 上会多走路。这张表的价值在于说明跨楼层机制没有把单目标能力做坏,但也要承认它不是单目标 SOTA。
| 方法 | 零样本 | 多层 | LLM 推理 | SR ↑ | SPL ↑ |
|---|---|---|---|---|---|
| XGX | 否 | 否 | 否 | 72.9 | 35.7 |
| ASCENT | 是 | 是 | 是 | 65.4 | 33.5 |
| BeliefMapNav | 是 | 否 | 是 | 61.4 | 30.6 |
| SGM | 否 | 否 | 否 | 60.2 | 30.8 |
| LifelongCrossNav | 是 | 是 | 否 | 59.7 | 28.0 |
| ApexNav | 是 | 否 | 是 | 59.6 | 33.0 |
| MFNP | 是 | 是 | 是 | 58.3 | 26.7 |
| InstructNav | 是 | 否 | 是 | 58.0 | 20.9 |
| OneMap | 是 | 否 | 否 | 55.8 | 37.4 |
| VLFM | 是 | 否 | 否 | 52.5 | 30.4 |
表 4:论文表 3 的节选,HM3D 单目标 ObjectNav 验证集结果(%)。
失败分析解释了 w/o H-POI 在表 1 中 SR/PR 略高的现象:配对 episode 分析把它归因于少量结果反转——History POI 检索改变了被选中的目标实例或接近视角。按类别统计(论文表 4、5),History POI 减少了局部规划失败、探索不完整与不可达候选三类失败(例如 plant 的卡住失败 59 对 58、sofa 的未达失败由探索不足主导),但增加了误检:bed 类别的误检失败从 133 升到 163,因为历史 POI 会把智能体引向替代实例与替代视角,YOLOv7 在这些视角上偶尔把床认成外观相近的沙发,触发不必要的接近与验证失败。作者的结论是:目标验证是当前剩余误差的主要来源,而 SPL/PPL 与后段条件 SPL 的一致增益才是历史检索更可靠的证据。
代码对照:论文方法在 release-v2.0 中的落点
仓库以 OneMap 代码库为底座重构为 3D 版本,结构清晰:mapping/voxel_map.py 是支撑感知体素地图,mapping/feature_map.py 是 SED 特征投影与融合,mapping/navigation3d/ 下是 frontier 管理、POI 管理、楼梯提案与楼梯穿越,planning_cpp/ 是 C++ 规划内核,eval/ 是 Habitat 评测与事后指标,config/mon/ 是冻结配置。以下几处与论文公式逐行对应。
其一,观测质量权重(式 2)在 mapping/feature_map.py 中就是两行张量运算,参数名与论文表 7 完全一致(gradient_factor: 0.2、optimal_object_distance: 1.0、optimal_object_factor: 1.5,即 $\sigma_{d}$):
scores = ((1 - torch.tanh(gradient_magnitude * self.gradient_factor)) *
          torch.exp(-((self.optimal_object_distance - depth) / self.optimal_object_factor) ** 2 / 3.0))
其二,累积置信融合(式 3)在同一文件的 fuse_maps 中实现为「新置信加旧置信做分母、两加权平均、置信累加」,与论文强调的 cumulative weighted average 而非 EMA 的表述一致(代码中分支名仍叫 EMA,是沿袭 OneMap 的命名):
confidence_denominator = confs_new + confs_old
weight_1 = torch.nan_to_num(confs_old / confidence_denominator)
weight_2 = torch.nan_to_num(confs_new / confidence_denominator)
self.feature_map[idx] = self.feature_map[idx] * weight_1.unsqueeze(-1) + values * weight_2.unsqueeze(-1)
self.confidence_map[idx] = confidence_denominator
其三,支撑分类(附录 D 式 13 的集合定义)在 mapping/voxel_map.py 顶部以 frozenset 常量给出,且 TARGETABLE_TYPES = PATHABLE_TYPES - {FAKE_STAIR} 一行正是论文「FAKE_STAIR 可通行但不可作为终点」的规则;支撑更新采用两阶段提交(先提案后提交)以避免迭代顺序影响结果。其四,w/o H-POI 消融在 config/mon/planning_conf.yaml 中就是一个布尔开关 enable_history_poi: True,与附录 G 对消融边界的描述(只关 History POI 生成与选择)吻合;同文件还能逐项对上表 7 的冻结值:objectnav_found_distance: 1.3、history_poi_objectnav_match_xy_m: 1.0、stair_sem_session_radius_m: 2.5、segformer_stair_pixel_threshold: 0.25、segformer_stair_min_area: 80、descend_pitched_conf_threshold: 0.48、descend_geometry_threshold: 0.65、object_found_min_box_area_ratio: 0.015625(即 1/64 图像面积)、object_found_min_mask_voxels: 10。其五,事后评测协议在 eval/habitat_multi_evaluator.py 中体现为 get_geodesic(pos, sim, obj, correct_start=True) 加上 spl = min(1.0, best_dist / max(path_length, best_dist)),并且加载场景时会 recompute_cross_floor_navmesh(sim),注释说明 HM3D 自带 navmesh 对若干楼梯与平台连接过粗——运行时运动与事后测地评测必须共用同一套跨楼层几何。
一处值得记录的差异:论文正文写的是 YOLOv7(六类)+ YOLO-World(开集),而 release-v2.0 的配置注释标明 yolov7_confidence 与 using_ov 已是 legacy 字段,当前评测 actor 使用 D-FINE-X(dfine_confidence: 0.8)加 SegFormer 做目标与楼梯感知,并额外引入 SED 的 found 确认(sed_found_threshold: 0.15)。阅读代码时应以配置注释为准区分「论文快照」与「当前 release」,本文实验数字均取自论文正文与补充材料。
局限性
作者自述的第一条局限在结论中:未来工作才研究真实世界部署与更鲁棒的跨楼层导航,即全部结论来自 Habitat 仿真,楼梯感知依赖仿真深度与位姿的理想性,真实传感器的噪声、动态物体与光照变化未被检验。作者自述的第二条局限在失败分析中:目标验证是剩余误差的主要来源,History POI 引来的替代视角会让 YOLOv7 把床误认成沙发(bed 误检失败 163 对 133),说明检索与检测之间的闭环仍不稳固。作者自述的第三条边界在附录 F:StairSem 的长边只验证存储端点,不声称沿途连续扫掠体积的碰撞认证,稀疏楼梯观测下的规划在理论上留有缺口。
笔者的补充判断有三。其一,lifelong 的语义是 episode 内持久:附录 B 明确独立 episode 之间所有状态重置,因此该方法不跨 episode 积累任何记忆,命名上的「终身」比跨 episode 终身学习弱一档,读者不应外推。其二,事后协议虽然因果正确,但分母依赖各智能体自己的前序选择,跨方法比较的是「各自轨迹下的效率」而非同一参考路线下的效率;条件指标缓解了这一点,全局指标保留了级联,但两者都无法完全消除选择偏差,CFR 子集 7.99% 的绝对成功率也意味着结论的统计功效受限于 288 条样本。其三,多层保守顺序在单目标场景付出代价(SPL 28.0 低于 OneMap 的 37.4 与 ASCENT 的 33.5),且六类别、三目标、HM3D 单场景族的设定离开放世界的长序列任务仍有距离;把目标序列拉长到十个以上时,体素记忆的内存与检索延迟如何伸缩,论文没有给出数据。
总结与展望
LifelongCrossNav 的贡献可以压缩成一句话:把「记住看到过什么」与「知道怎么走过去」放进同一张支撑感知的 3D 体素图。前者靠目标无关的 SED/CLIP 体素特征与累积置信融合,使任意新目标都能余弦回查;后者靠七种体素状态、延迟楼梯晋升与类型感知的 3D A*,使楼梯从语义标签变成可规划边。HM3D-MFMON 与事后逐阶段协议则给社区提供了一个因果正确的顺序多目标评测口径。实验上,它对平面持久记忆基线的优势在 CFR 子集上最为尖锐(序列 SR 7.99 对 0.00),消融则把后段效率增益准确归因到历史语义检索。对做具身导航的工程团队而言,这篇工作的可复用资产是具体的:支撑分类的两阶段更新、楼梯会话的方向约束、以及把消融做成配置开关的做法,都直接写在开源代码里。
展望方向也由此清晰:把支撑感知建图与楼梯会话搬到真实机器人(作者自述的首要未来工作)、用更强的开放词汇验证器替换固定检测器以压掉 bed/sofa 类误检、以及研究跨 episode 的真正终身记忆——当同一栋楼被反复服务时,第 n 次任务理应比第 1 次更快,而当前框架每次都在从零建图。
持久记忆的价值不在于记住更多,而在于让第 k 个目标少走前 k-1 个目标已经走过的路;而当目标在另一层时,记忆还必须记得楼梯在哪里。