PAPER DEEP DIVE
感知人形跑酷:通过动作匹配串联动态人类技能
尽管人形机器人的运动控制近来已在多种地形上实现稳定行走,如何获得高动态人类动作那般的敏捷性与适应性,仍是一个开放问题。尤其是在复杂环境中的敏捷跑酷,不仅要求底层控制的鲁棒性,还要求类人的动作表现力、长时程的技能组合,以及由感知驱动的决策能力。本文提出感知人形跑酷框架 PHP(Perceptive Humanoid Parkour):一个模块化系统,使人形机器人能够在具有挑战性的障碍场地上自主完成长时程、基于视觉的跑酷。方法首先把动作匹配(motion matching)表述为特征空间中的最近邻检索,用它把重定向后的原子人类技能组合成长时程运动学轨迹;这一框架让复杂技能链既能灵活组合、又能平滑过渡,同时保留人类动态动作的优雅与流畅。随后,我们为这些合成动作训练基于动作跟踪的强化学习(RL)专家策略,并用 DAgger 与 RL 相结合的方式把它们蒸馏成单个基于深度图的多技能学生策略。关键在于,感知与技能组合的结合带来了自主的、随场景而变的决策能力:仅凭板载深度传感与一条二维速度指令,机器人就能自行判断应当跨过、爬上、撑越还是翻下几何形状与高度各不相同的障碍。我们在 Unitree G1 人形机器人上以大量真机实验验证该框架,展示了诸如攀爬最高 1.25 m(相当于机器人身高 96%)障碍这类高动态跑酷技能,以及在障碍被实时扰动时闭环适应的长时程多障碍穿越。
论文元信息
标题:Perceptive Humanoid Parkour: Chaining Dynamic Human Skills via Motion Matching(感知人形跑酷:通过动作匹配串联动态人类技能,简称 PHP)
作者:Zhen Wu*、Xiaoyu Huang*、Lujie Yang*(共同一作)、Yuanhang Zhang、Xi Chen、Pieter Abbeel†、Rocky Duan†、Angjoo Kanazawa†、Carmelo Sferrazza†、Guanya Shi†、C. Karen Liu†(* 同等贡献,† Amazon FAR 团队联合负责人;机构:Amazon FAR、UC Berkeley、CMU、Stanford University)
链接:arXiv:2602.15827(v1 2026-02-17,v2 2026-05-06,RSS 2026)· arXiv HTML 全文 · 项目主页 · 视频
代码状态:✅ 已发布。github.com/amazon-far/php_parkour 放出了三段完整链路:motion_matching/ 是动作匹配数据生成包(含 G1 骨架、技能注册表、场景与可视化器),wbt_training/ 是 IsaacSim 上的教师训练与学生蒸馏配置(依赖固定版本的 amazon-far/holosoma 子模块),scripts/download_assets.py 按 release-assets.json 里的 SHA-256 清单校验下载动作库、示例 motion/terrain 数据集与 sanitized 的 depth_backbone.onnx + student.onnx,可在 MuJoCo 里直接跑 sim2sim。发布物刻意不含原始 .pt 与教师 checkpoint;社区已有一份 mjlab 移植。
一句话总结:PHP 把游戏动画工业里的动作匹配(motion matching)搬进机器人学习,先在特征空间里用最近邻检索把重定向后的原子人类技能与走跑动作缝成稠密的长时程运动学参考,再为每条技能训一个带特权信息的跟踪专家,最后用 DAgger 加 PPO 的混合目标把它们蒸馏成单个深度图策略;Unitree G1 只靠板载深度相机和二维速度指令,就能自主决定跨、爬、撑越还是翻下障碍,爬上 1.25 m(自身身高 96%)的墙用时 3.63 s,并在障碍被随机挪动约 0.5 m 时闭环改线完成 48 s 连续穿越。
研究背景与动机
人形机器人的行走已经不稀奇:盲走能上下坡、能走楼梯,加上感知之后能踩稀疏落脚点、能跨沟。真正没解决的是敏捷性——人类通过快速选择并串联全身动态技能,穿越尺度差异极大的地形。作者把跑酷选作这一目标的自足试验场,理由很实际:跑酷同时压满了动态强度、感知耦合与技能数量三个维度,任何一项松掉都不算完成。
论文把跑酷拆成三个互相纠缠的难点。第一,技能本身高度动态且接触丰富:爬上接近或超过自身身高的墙、在零点几秒内撑越障碍,都要求在人形机器人巨大的高维动作空间里做有效控制。第二,这些技能必须与外感受(视觉)紧耦合,才能适应环境变化并对突发扰动做出快速反应。第三,要走出孤立动作、跑完整条障碍场地,就必须把许多高动态技能压进同一个视觉运动策略,而这件事随技能数量与多样性的增长迅速变难。
人类动作数据是学这类行为的必需品——跳跃、翻滚、空翻这些技能靠奖励整形几乎写不出来。但高动态数据天生稀缺:捕捉快速、接触丰富的动作需要专门装置与细致筛选,数据集里每个技能往往只有一两条示范、每条只有几秒。稀缺不是跑酷独有的问题,它适用于所有动态人类技能。而长时程任务偏偏两头都要:技能内部要有足够变化去适应不同的接近方式,技能之间还要有平滑自然的过渡。几秒长的孤立片段既给不出前者,也给不出后者。
已有路线在这两处都不顺手。四足上可以从零用奖励整形学出 parkour,但这套做法迁移到人形会因全身控制维度爆炸而失效,所以现有的感知人形大多停留在低动态地形:上下楼梯、走稀疏地形、踩低平台。为降低探索难度,主流做法是教师—学生:先用特权状态训专家,再用 DAgger 蒸馏出视觉学生;本文沿用这个范式,但发现纯 DAgger 对高动态人形技能不够用,因此给它补上一个 RL 目标——这与 Extreme Parkour 那类「先蒸出强 DAgger 策略、再单独 RL 微调到未见地形」的用法不是一回事。AMP 走另一条路,让单一策略学出一个技能分布、过渡由 RL 探索自发涌现,代价是把手工奖励换成从动作数据学出的风格奖励;它在动画与四足上有效,但人形真机演示至今局限于走路、踏步、搬箱这类不那么敏捷的技能。还有一类工作用生成式运动学模型(如 MDM)在线合成中间过渡轨迹,交给 DeepMimic 式跟踪控制器执行;问题是这些模型在跑酷常见的低数据区间轨迹质量明显下降,要么靠昂贵的迭代式协同训练把动作救回来,要么靠滚动时域重规划——而带感知的实时重规划开销很大。
本文的选择是把动作匹配当作运动学参考的来源。这项技术在游戏与角色动画里已经成熟,简单、可控、且输出质量高,但在机器人里此前只被用在相对简单的四足行为上。作者的判断是:动作匹配通过检索与缝合片段,能把一个稀疏动作库稠密化——在不同接近距离、朝向与时机上生成多样过渡,同时保留捕捉动作本身的真实感。论文的三条贡献由此展开:一条高效的运动学技能组合流水线;一个把多个专家蒸馏成单一视觉运动策略、支持无缝过渡的可扩展训练框架;以及在真实人形机器人上零样本迁移的深度策略,实现多种障碍上的高动态跑酷。
预备知识
动作匹配。它原本解决的是交互式角色控制:在每一帧或每个过渡点,从大型动作数据库里挑出「运动特征与当前姿态及期望未来行为最匹配」的那一帧,然后把播放头跳过去继续顺放。整套机制只有三个要件——一个特征空间、一次最近邻检索、一小段过渡混合。它不学任何模型,也不做优化,因此对数据量几乎没有要求,代价是需要人工设计特征与标注过渡窗口。
基于参考动作的强化学习。DeepMimic 式的跟踪奖励把「与参考动作的偏差」写成若干高斯核,逐项度量身体关键点的位置、姿态、线速度与角速度误差;BeyondMimic 与 OmniRetarget 把这一套工程化,前者提供人形跟踪的奖励、终止与随机化配方,后者负责把人类动作重定向到具体机器人骨架。本文的专家训练直接沿用这两者的设定,只在一处做了关键改动(放开全局跟踪以学到恢复行为)。
教师—学生蒸馏。仿真里可以廉价拿到真机上没有的量:骨盆的全局位姿、地形高度图。于是先在特权观测下训出高质量专家,再让学生只看本体感受与深度图,用 DAgger 反复询问专家「你在这个状态下会怎么做」,把专家行为克隆进学生。DAgger 的固有短板是它是逐步的模仿损失,不看整条 episode 的成败——这正是本文要补的那一刀。
方法详解
整条流水线是三段式的模块化结构(对应论文 Fig. 2):动作匹配把原子跑酷技能与走跑组合成长时程运动学参考轨迹;每个技能用带特权信息的 RL 动作跟踪训出一个单技能教师;多个教师用 DAgger 与 RL 的混合目标蒸馏成一个基于深度的学生策略,然后零样本上真机。三段各自可替换,这也是作者强调「modular」的原因。
flowchart TB
    A["Human mocap clips"] --> B["OmniRetarget to 29-DoF Unitree G1"]
    B --> C["Atomic skill library + locomotion database
each clip paired with a box terrain"]
    C --> D["Manual annotation: start s_k, end e_k, entry window H_k"]
    D --> E["Motion matching synthesis
nearest-neighbor search in 27-D feature space"]
    E --> F["Long-horizon references: locomotion to skill to locomotion
paired velocity commands + terrain variants"]
    F --> G["Per-skill expert policies
privileged state + 0.7 m x 0.7 m height scan
adaptive sampling of failure regions"]
    G --> H["Distillation: DAgger + PPO hybrid loss
curriculum on lambda_D, termination relaxed 0.5 m to 1 m"]
    H --> I["Single depth-based multi-skill student
3-layer CNN + 5-layer MLP, 16384 envs, 20K iters"]
    I --> J["Zero-shot sim-to-real on physical G1
depth camera 30 Hz + discrete 2D velocity command"]
    J --> K["Autonomous skill selection: step over, climb on, vault, drop off
closed-loop adaptation to displaced obstacles"]
    F -.-> L["Randomization: approach distance, obstacle width up to 1.5 m,
dims +-5 cm, yaw +-45 deg, distractor boxes"]
    L -.-> H
图1:PHP 的三段式流水线(依据论文 Fig. 2 与第 III 节绘制)。左侧数据支路由动作匹配生成 motion-terrain 配对,中间是特权专家,右侧是混合目标蒸馏出的深度学生;虚线是贯穿数据与训练的随机化项。
1. 特征空间与最近邻检索
所有动作片段先用 OmniRetarget 重定向到 29 自由度的 G1,逐帧存成机器人构型 $\bm{q}_{i}=(\bm{p}_{i},\bm{r}_{i},\bm{\theta}_{i})$,其中根平移 $\bm{p}_{i}\in\mathbb{R}^{3}$、根四元数 $\bm{r}_{i}\in\mathbb{R}^{4}$、关节角 $\bm{\theta}_{i}\in\mathbb{R}^{29}$。每一帧另外预计算一个匹配特征 $\bm{x}_{i}\in\mathbb{R}^{27}$,全部表达在角色自身坐标系下,由三块拼成:未来根轨迹 $\bm{t}_{i}\in\mathbb{R}^{12}$(未来 0.33 s、0.67 s、1 s 三个时刻的平面位置与朝向)、局部足端状态 $\bm{f}_{i}\in\mathbb{R}^{12}$(左右脚在根坐标系下的位置与线速度)、根速度 $\bm{h}_{i}\in\mathbb{R}^{3}$。为了扩大覆盖,作者把全部片段做了镜像增广;每条跑酷片段还手工拟合了一个与之对齐的箱形地形。
运行时,查询特征 $\hat{\bm{x}}_{t}$ 由当前构型 $\bm{q}_{t}$ 与一个二维速度指令拼出:足端状态与根速度直接取自当前状态,未来轨迹部分则由指令算出。检索就是一次带约束的最近邻:
$$i_{t}^{\star}=\arg\min_{i\in\mathcal{C}_{t}}\;\|\hat{\bm{x}}_{t}-\bm{x}_{i}\|^{2}, \tag{1}$$其中 $\mathcal{C}_{t}$ 是用户指定的「即将执行的技能」所对应的搜索窗口。检索每隔 $M$ 帧做一次,或者在指令速度发生显著变化时立即触发;选出 $i_{t}^{\star}$ 后把播放头切到该帧并顺放,直到下一次检索。切换处套一小段混合窗口以避免不连续。
把二维指令变成未来轨迹用的是临界阻尼弹簧模型。设弹簧位置 $\bm{s}$、速度 $\dot{\bm{s}}$、目标 $\bm{s}_{\text{goal}}$、阻尼参数 $y>0$,记 $\bm{j}_{0}=\bm{s}_{0}-\bm{s}_{\text{goal}}$、$\bm{j}_{1}=\dot{\bm{s}}_{0}+y\,\bm{j}_{0}$,则任意未来时刻 $\tau$ 有闭式解
$$\bm{s}(\tau)=e^{-y\tau}\big(\bm{j}_{0}+\tau\bm{j}_{1}\big)+\bm{s}_{\text{goal}}. \tag{2}$$平面位移用「速度空间里的弹簧」——弹簧位置对应平面速度、其导数对应加速度——再对闭式速度积分得到未来根位置:
$$\bm{p}(\tau)=\bm{p}_{0}-\frac{\bm{j}_{1}}{y^{2}}e^{-y\tau}+\frac{-\bm{j}_{0}-\tau\bm{j}_{1}}{y}e^{-y\tau}+\frac{\bm{j}_{1}}{y^{2}}+\frac{\bm{j}_{0}}{y}+\bm{u}^{\text{cmd}}_{t}\,\tau, \tag{3}$$逐分量作用在平面上;朝向则把弹簧直接加在航向角 $\psi$ 上、朝 $\psi^{\text{cmd}}_{t}=\mathrm{atan2}(u^{\text{cmd}}_{t,y},u^{\text{cmd}}_{t,x})$ 收敛,用式 (2) 在同样三个时刻取值即可,不需要积分。混合过渡用的是 inertialization:在切换瞬间算出「当前播放动作与目标动作之间的偏移量」,切换后把该偏移叠加到输出上保证连续,再用同一个临界阻尼弹簧(目标设为零)把偏移逐渐衰减掉。
2. 长时程轨迹合成:把走跑当成万能接头
本文的用法与游戏不同:动作匹配在这里是离线的运动合成模块,目的是一次性生成大批长时程参考。组合形式固定为「行走/奔跑 → 跑酷技能 → 行走/奔跑」。之所以所有技能都经由共享的行走流形路由,是因为走跑本身就是最通用、最可复用的接头;这样一来,异构技能之间也能得到一致的过渡,而不需要为每一对技能专门捕捉过渡片段——这正是可扩展组合的关键。
数据结构上维护一个行走库 $\mathcal{D}_{\text{loco}}=\{(\bm{x}_{i}^{\text{loco}},\bm{q}_{i}^{\text{loco}})\}$ 和一组技能库 $\{\mathcal{D}_{k}\}$,每个技能 $k$ 一个。每条技能片段配一个对应的地形资产,并手工标注技能起止帧 $(s_{k},e_{k})$。此外定义一个长度依技能而定的入障窗口:
$$\mathcal{E}_{k}:=[\,s_{k}-H_{k},\;s_{k}\,], \tag{4}$$它对应主接触动作之前的接近阶段——只有落在这段里,切入片段才有意义。以撑越为例,$\mathcal{E}_{k}$ 覆盖的是起跳前的最后几步,从而排除掉在非预期阶段切入的过渡。三种模式的规则很干净:行走阶段用 $\mathcal{C}_{t}=\mathcal{D}_{\text{loco}}$ 跑标准检索并顺放;需要进入技能 $k$ 时把 $\mathcal{C}_{t}$ 收窄到 $\mathcal{E}_{k}$,用式 (1) 匹配到入障帧后切换过去,并按匹配帧上的「地形—根」偏移把配对地形摆到机器人当前根位姿上;此后片段顺放到标注的终止帧 $e_{k}$,期间禁用动作匹配,以原样保留接触丰富的人类动作;到达 $e_{k}$ 后再把 $\mathcal{C}_{t}$ 放回 $\mathcal{D}_{\text{loco}}$ 恢复检索与顺放。
数据集就是把这套流程反复 roll out。每条轨迹从站立开始,进入由二维速度指令驱动的行走阶段:速度取两档(低 1 m/s、高 2 m/s),转向取五个方向($-90^{\circ}$、$-45^{\circ}$、$0^{\circ}$、$45^{\circ}$、$90^{\circ}$);随后切入技能 $k$ 并顺放片段,技能期间指令设为直行($0^{\circ}$)但保持前一行走段的速度档;到 $e_{k}$ 后回到行走并再走 2 s 才停。整个过程把逐时刻的速度指令与生成的运动学参考 $\{\bm{q}_{t}\}$ 一并记录下来,形成配对数据供后续策略训练使用。
3. 过渡密度:让「刚好来得及」的那一步被采样到
作者把 transition density 当成一等公民来经营。动作匹配天然允许一个技能从特征空间中邻近的多种行走状态进入,于是同一个技能可以得到跨越不同接近距离与步态相位的多样化入口——起跳前多垫一步、或从跑步周期的不同相位发起撑越——这就把入障前状态的分布显著加密。论文举的例子很直观:把初始接近距离从 3.9 m 改到 4.8 m,检索引擎会被迫选出不同的步序,进而落到左腿领先或右腿领先这样截然不同的入障姿态上。
为了防止策略学到非因果的捷径(比如靠「已经走了多少秒」「迈了几步」来预判技能触发),入障前行走段的时长从 $[0.1,3]$ s 里均匀采样,平均间隔 0.3 s。这类多样的 motion-terrain 配对逼迫策略基于当下上下文做反应,是「在不同距离与时机下都能可靠触发正确技能」的前提。
地形随机化则在保持参考可行的前提下提升鲁棒性:障碍宽度从参考所需的最小值一直采到 1.5 m,其余尺寸在 $\pm 5$ cm 内扰动,障碍偏航角在 $\pm 45^{\circ}$ 内随机。另外在参考轨迹附近放置尺寸与位姿随机的干扰箱,用于提升对无关物体的鲁棒性、减少真机上的过拟合。
4. 专家策略:动作跟踪加特权全局观测
专家的观测包括参考关节位置/速度、参考骨盆位姿误差、骨盆线速度与角速度、关节位置/速度、上一时刻动作,另外给一块 0.7 m × 0.7 m 的高度扫描,让专家能适应地形随机化。与 OmniRetarget 不同的是,本文打开了全局跟踪:专家能拿到骨盆的全局位置与速度,因而可以学到恢复行为。理由很具体——参考动作与地形是紧耦合的,小的漂移或时机误差会迅速累积,必须被纠正才能留在预定轨迹上。这些特权量在硬件上拿不到,但可以由学生从视觉输入里推断出来。
另一个不能省的部件是自适应采样:优先从失败更频繁的区域采样 rollout 起点。作者直说,没有它,高墙攀爬专家根本收敛不到有意义的行为。奖励、终止与域随机化沿用 BeyondMimic:DeepMimic 式跟踪奖励,配动作变化率、关节限位与碰撞惩罚,基于跟踪误差的提前终止,以及轻量随机化。跟踪项写成高斯核形式,身体位置与姿态两项为
$$r_{\text{pos}}=\exp\!\Big(-\big(\tfrac{1}{|\mathcal{B}_{\mathrm{target}}|}\textstyle\sum_{b\in\mathcal{B}_{\mathrm{target}}}\|\mathbf{p}^{\mathrm{des}}_{b}-\mathbf{p}_{b}\|^{2}\big)/0.3^{2}\Big),\quad r_{\text{ori}}=\exp\!\Big(-\big(\tfrac{1}{|\mathcal{B}_{\mathrm{target}}|}\textstyle\sum_{b\in\mathcal{B}_{\mathrm{target}}}\|\log(R^{\mathrm{des}}_{b}R_{b}^{\top})\|^{2}\big)/0.4^{2}\Big), \tag{5}$$其中 $\mathcal{B}_{\mathrm{target}}$ 是被跟踪的身体部位集合,$\mathbf{p}^{\mathrm{des}}_{b}$、$R^{\mathrm{des}}_{b}$ 是参考量,$\log(\cdot)$ 取旋转误差的轴角表示;线速度与角速度两项同形,尺度分别为 $1.0^{2}$ 与 $3.14^{2}$,另有 anchor 位置与姿态两项(尺度 $0.3^{2}$ 与 $0.4^{2}$),六项权重均为 1.0。正则项包括动作平滑度 $\|\mathbf{a}_{t}-\mathbf{a}_{t-1}\|^{2}$(权重 $-0.1$)、关节限位越界($-10.0$)与非期望自接触 $\sum_{b\notin\mathcal{B}_{\mathrm{ee}}}\mathbf{1}[\|f^{\mathrm{self}}_{b}\|>1\,\text{N}]$($-0.5$)。动作是关节 PD 目标,除以固定动作尺度归一化;由于 RL 探索困难,所有专家的动作尺度统一设为 1,而不用 BeyondMimic 的启发式取值。域随机化覆盖静摩擦 $\mu_{\text{static}}\sim\mathcal{U}[0.4,1.3]$、动摩擦 $\mathcal{U}[0.4,1.1]$、恢复系数 $\mathcal{U}[0,0.5]$、躯干质心偏移($x$ 方向 $\pm 2.5$ cm,$y$/$z$ 方向 $\pm 5$ cm)以及持续 1–3 s 的根部速度推力扰动。
5. 蒸馏:给 DAgger 补一刀 RL
从多个专家学一个统一策略,常规做法是 DAgger 式模仿。它对踏步这类较容易的动作有效,但对攀爬与撑越这类高动态技能不够。作者给出的诊断很有说服力:这些技能依赖短暂而高幅值的扭矩爆发,而逐步的模仿目标不看 episode 结果,因此不会显式偏好这类高扭矩动作。举个具体例子——让根位置偏高或偏低、但关于参考对称的两个动作,DAgger 损失可以完全相同,然而只有偏高那条真正越过了障碍。在 76 cm 障碍上,纯 DAgger 学生会稳定地卡在引体阶段:手放的位置准确,却发不出把躯干抬起来的那一下爆发。
解法是在 DAgger 旁边并行加一个带课程的 PPO 目标:
$$\mathcal{L}=\lambda_{\text{PPO}}\,\mathcal{L}_{\text{PPO}}+\lambda_{D}\,\mathcal{L}_{D},\qquad \lambda_{\text{PPO}}+\lambda_{D}=1, \tag{6}$$作者特别澄清 PPO 在这里的角色:它提供的是成功驱动的 exploitation 信号,鼓励策略用足专家已有的行为(例如那一下高扭矩),而不是去探索专家技能分布之外的东西。课程有三件事。第一,训练前半段线性调低 $\lambda_{D}$,并封在 0.1:
$$\lambda_{D}(k)=\max\!\left(0.1,\;1-\frac{k}{K/2}\right), \tag{7}$$$k$ 为当前迭代、$K$ 为总迭代数。第二,处理左右对称带来的多模态:很多技能有两种同样正确的镜像执行方式(跨栏可以左腿领先也可以右腿领先),而参考轨迹只记录其中一种;学生若执行了镜像模式,技能其实完成了,跟踪误差却很大,会被错误终止,这种伪失败信号会让 PPO 的奖励方差飙升。对策是把终止阈值从专家的 0.5 m 按同一条线性日程放宽到 1 m,让镜像模式不被过早杀掉。第三,自适应学习率与基于 KL 的探索控制只在 $\lambda_{\text{PPO}}$ 超过 0.1 之后才开启,避免早期噪声梯度的 PPO 把蒸馏带偏。
还有一处容易忽略但很关键的取舍:学生阶段关闭了 rollout 起点的自适应采样。它在专家阶段帮助聚焦失败区,但在学生阶段会欠采样那些「在仿真里不失败、执行却发抖」的边界片段——而正是这类片段在硬件上带来最大的 sim-to-real 落差。同时为避免技能间的数据不均衡,每个技能被等概率采样,技能内部再均匀采样。放宽终止也带来副作用:学生会访问到专家训练分布之外的状态(专家是在原终止阈值下训的,在这些区域给不出有意义的动作),因此当学生违反了专家的原始终止条件、但仍落在放宽后的条件内时,这些时刻的 DAgger 损失被直接关掉,只留 PPO 目标,以免注入错误监督。
作者还专门区分了自己与 Extreme Parkour 式后处理的不同:那边是先训出一个强 DAgger 策略、再用一个独立的 RL 阶段去适配未见地形;这边是在蒸馏过程中就用 RL 纠正模仿导致的保守性。另一个反向发现同样重要——DAgger 项必须全程在线:如果在课程结束后丢掉 DAgger 损失、只留纯 RL,策略往往会发展出抖动、不自然的行为,说明在高维动作空间里行为克隆目标是 RL 的关键正则。
6. 视觉、相机建模与 sim-to-real
学生的观测是本体感受(骨盆重力向量与角速度、关节位置与速度、上一动作)加深度图加二维速度指令。深度图用 Nvidia WARP 渲染以保证训练吞吐。相机标定方法很务实:在一组姿态下比对仿真与硬件里「机器人自身的可见部分」,用 ROI 重合度对齐;随后在标定值周围随机化外参——平移 2.5 cm、旋转 2.5°——以抵抗视角偏移与安装差异。深度噪声按既有工作注入,但刻意排除了高斯模糊,因为高速下模糊会把障碍糊掉。观测延迟在 60 ms 到 80 ms 之间随机,模拟硬件延迟抖动;此外还叠加 $\pm 3$ cm 的随机深度偏移与标准差 3 cm 的独立高斯噪声。板载深度相机工作在 30 Hz。
训练配置:3 层 CNN 作深度主干(输入分辨率 $58\times 87$,输出 32 维,全局平均池化后与本体感受拼接),5 层 MLP 隐藏维度 $[2048,1024,512,256,128]$,激活 ELU,16384 个并行环境,专家与学生都训 20K 次迭代。学生的初始噪声标准差只有 0.01(专家是 1.0),学习率 $3\times10^{-4}$(专家 $1\times10^{-3}$),mini-batch 96(专家 4),蒸馏损失用 MSE、DAgger 损失系数 10.0,课程在第 10000 个 epoch 收尾。这组数字合起来说明:蒸馏阶段几乎不靠随机探索,靠的是专家标签加成功信号。
7. 方法在开源代码里的落点
论文式 (1) 与式 (4) 在仓库里是一份声明式数据加一个掩码最近邻函数。motion_matching/motion_matching/scenarios/skill_registry.py 的 SKILL_REGISTRY 把每个技能的 search_ranges 写成 [(start_searching_frame, end_searching_frame, end_of_motion_frame), ...] 三元组,前两项就是 $\mathcal{E}_{k}=[s_{k}-H_{k},s_{k}]$,第三项就是标注的 $e_{k}$;例如 climb_76_up 是 [(70, 95, 411), (744, 769, 1085)],第二个元组是同一份片段的镜像副本(偏移 +674),对应论文「把所有片段做镜像增广」。每个技能还带 height_range(如 (0.0, CLIMB_76_TOP=0.76382022))与 terrains(box.obj 与 box_mirror.obj),即手工拟合的配对地形。
检索本体在 motion_matching/motion_matching/core/database.py::motion_matching_search_w_custom_ranges:先用 custom_search_ranges 把 search_mask 全置假再逐段打开,接着按 ignore_range_end=20 抹掉每个片段末尾若干帧,然后 feature_costs = ((features - query_normalized) ** 2).sum(axis=1)、costs[~search_mask] = np.inf、np.argmin——正是式 (1) 的向量化实现。紧随其后的 _prefer_earlier_mirror_on_tie 值得一提:当最优帧与其镜像同相帧的代价差在 MIRROR_TIE_EPSILON = 1e-4 以内时,强制选全局帧号更小的那个,注释说明真实查询代价差异量级在 1e-2 以上,所以这个 epsilon 只为消除镜像带来的数值不确定性、保证结果可复现。run.py::_step_transitions 实现了「locomotion → skill」那一刻的地形摆放:取当前根位姿与匹配帧根位姿算出 t_rot、t_pos,再作用到地形 metadata 的 pos 与 quat 上,与论文「按匹配入障帧的地形—根偏移摆放配对地形」逐字对应;self.search_time = 0.1(50 FPS 下即每 5 帧)就是式 (1) 的检索周期 $M$,而 force_search 分支对应「指令速度显著变化时立即检索」。
学生侧的对应关系集中在 wbt_training/config_values/depth_distillation.py:深度项 WarpDepthImageObsTerm 的参数是 resize=(58, 87)、latency_frame=(3, 4)、enable_holes=True、buffer_len=6——前两个正是表 VI 的 $58\times 87$ 输入与 60–80 ms 延迟随机化。教师观测组多出一个 which_motion 路由项,注释写明它会把「偏离轨道」的专家标成 $-1$,核心据此对这些行输出零教师动作,PhpDistillationPPO._dagger_loss 再把它们掩掉——这就是附录 B3 那句「在违反专家原始终止条件的时刻关闭 DAgger 损失」的实现。放宽终止阈值也落成一条课程 RelaxTerminationThresholds,curriculum_start_step=24_000、curriculum_end_step=240_000。仓库还比论文多走一步:PPO 权重不是单一标量日程,而是「残差门控」(ppo_gate_enabled、ppo_gate_low=0.5、ppo_gate_quantile_lo/hi=0.50/0.95、ppo_gate_ema_alpha=0.001、ppo_gate_warmup_samples=5e5),按阶段比较模仿残差来分配 PPO 权重,把式 (6) 的全局课程细化到逐技能相位。训练侧示例数据集也给出了规模感:locomotion 100 对 motion/terrain(118.3 MB)、低速踏步 56 对、高速踏步 60 对、低速与高速 climb-76 各 40 对,对应「五个教师」的设置。
实验结果
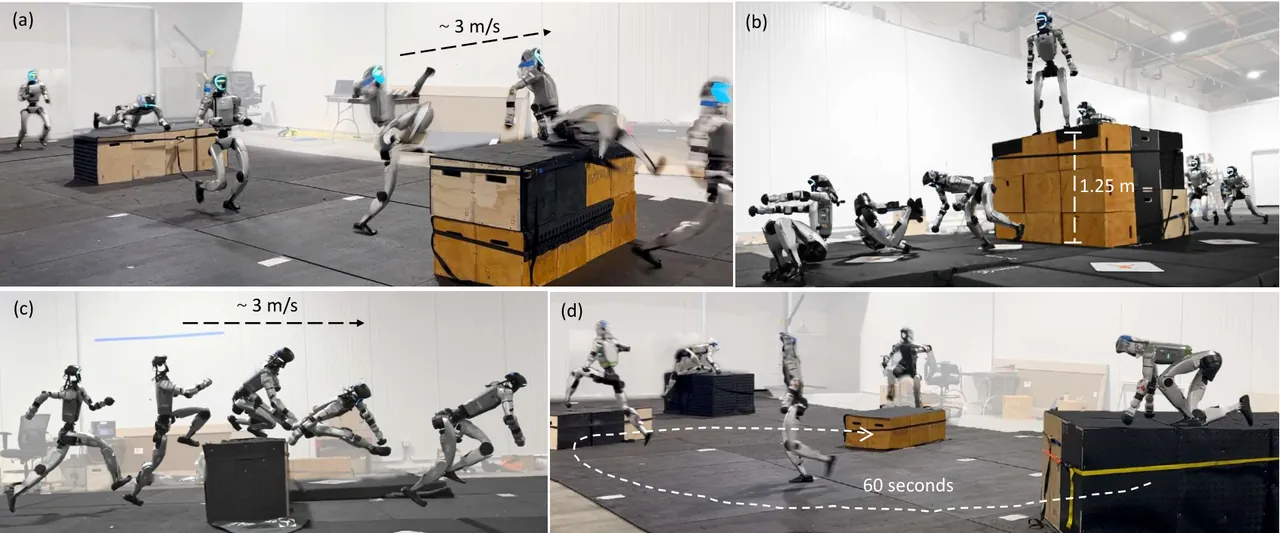
图2(论文 Fig. 1):G1 在板载感知下执行高动态长时程跑酷的四个瞬间——(a) 以约 3 m/s 先 cat vault 越矮障、紧接着 dash vault 越高障;(b) 爬上 1.25 m(身高 96%)的墙并翻下;(c) 约 3 m/s 的 speed vault;(d) 60 s 连续穿越复杂场地,自主选择技能并无缝衔接。
实验对象是 1.3 m 高、29 自由度的 Unitree G1。评测协议值得单独说明,因为它决定了数字该怎么读:每个任务要求机器人以固定指令速度(1.0 或 2.0 m/s)前进,越过一个指定高度、并带 $20^{\circ}$ 偏航随机化的单个障碍;为改变接近条件,1 m/s 任务的初始距离从 1.5–3.0 m 均匀采样,2 m/s 任务从 3.0–4.5 m 采样;每个任务评 100 个障碍实例,每个实例跑 5 次,共 500 次试验;成功的判据是越过障碍后再前进 1.5 m 且在固定时域内不倒。
1. 真机:把「人类水平敏捷」落到秒表上
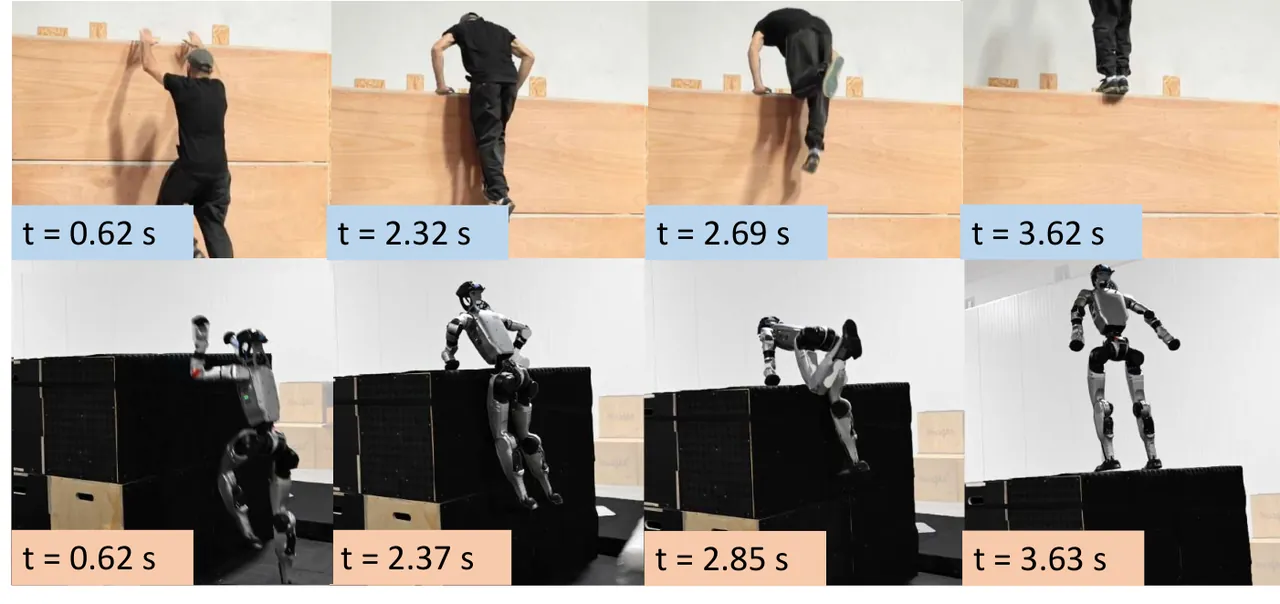
图3(论文 Fig. 4):高墙攀爬的人机并排对比。机器人从 toe-off 起 3.63 s 爬上 1.25 m 墙体。
最有说服力的一组结果是高墙攀爬的人机对照。作者让机器人与一名人类跑酷选手(取自公开视频)做同一个动作:高墙攀爬虽被视为基础技术,却需要相当的上肢力量与精确的全身协调,未经训练的人很难完成。机器人在 1.25 m 墙(自身身高的 96%)上从 toe-off 计时,3.63 s 爬上平台,节奏与人类相当;论文把关键事件逐段对齐——toe-off、pull-up、swing、stable stand——时序 closely matched。这个数字的含义不只是「爬上去了」:它说明跟踪误差没有把动作拖成缓慢的爬行,参考动作里的动态被策略保留了下来。
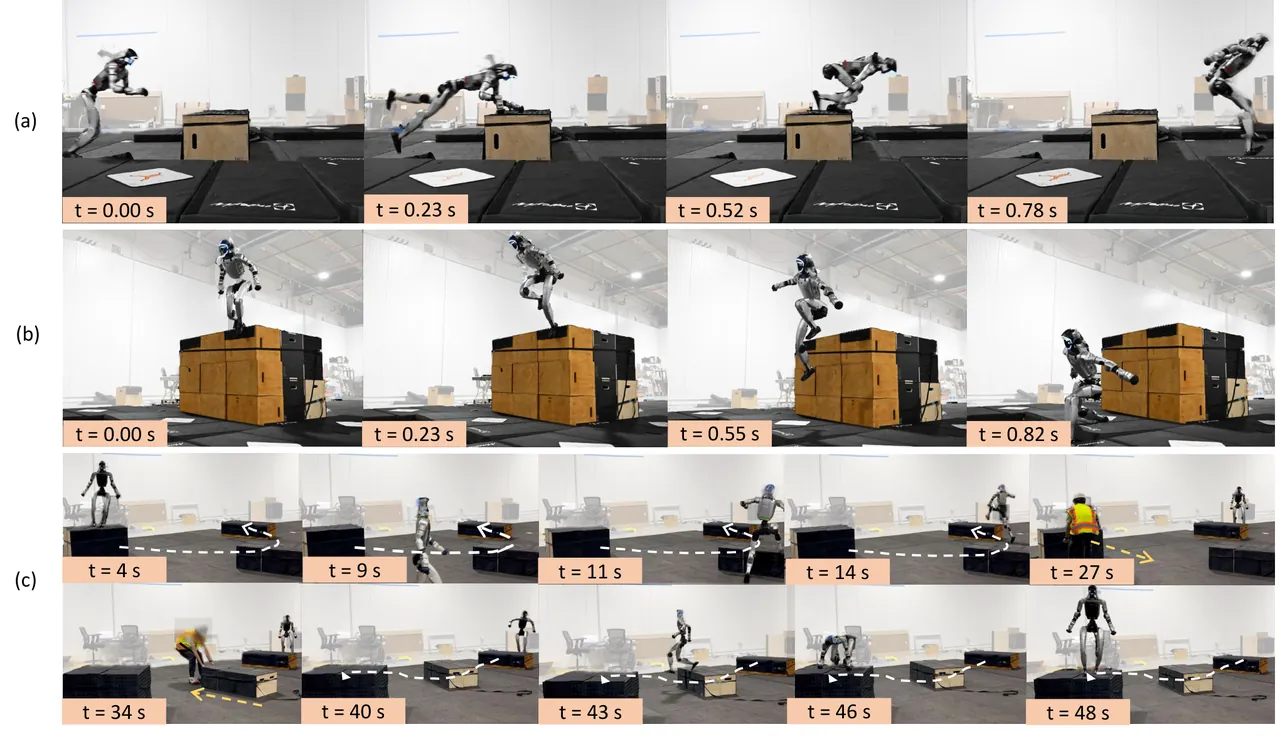
图4(论文 Fig. 5):真机结果。(a) cat vault;(b) 从 1.25 m 平台下落着陆;(c) 48 s 地形连续穿越,其间障碍被实时挪动,策略在线改线。
其余高动态技能同样给了量化指标。cat vault 越过一个 0.4 m 高、0.5 m 长的障碍,从 toe-off 到 toe-on 只用 0.8 s,前向位移超过 2 m(身高的 154%),峰值前向速度 3.41 m/s、平均 2.53 m/s——这组数字说明动量在接触过程中被有效保留,而不是每一步都重新加速。从 1.25 m 平台下落着陆时,机器人屈曲下肢关节吸收冲击并稳定姿态。
长时程部分是这套框架真正的卖点:训练数据里只有单障碍穿越,策略却能泛化到多障碍场地。作者把这归因于动作匹配的组合方式——通过共享行走段把技能串起来,并暴露多样的接近距离与时机,使策略在没有多障碍监督的情况下学会在障碍序列间可靠执行。真机上机器人把踏步、低墙与高墙攀爬组合成一次连续奔跑,视觉运动策略在线生成过渡;进一步,在执行过程中随机把多个障碍挪动约 0.5 m,策略通过调整接近路线与动作时机完成 48 s 的穿越。所有技能执行都是自主的,人只给出用于导航的简单二维速度指令。
2. 仿真基线:三个组件各自的贡献
作者用三个基线拆解贡献:人类参考动作、动作匹配的技能组合、两阶段教师—学生框架。Velocity Tracking 用 IsaacLab 标准的 G1 粗地形速度跟踪配方,纯奖励整形、无任何人类参考,并配 0.3 m 到 1.0 m 共 10 级的地形课程(2 m 助跑),而且直接吃特权高度图;Uncomposed Data 去掉动作匹配,只用未组合的行走数据与原子技能片段训练;End-to-end Depth 去掉蒸馏,用与学生相同的观测、与专家相同的跟踪奖励,从零训一个端到端深度策略。
| 方法 | 1.0 m/s · 36 cm | 1.0 m/s · 58 cm | 1.0 m/s · 76 cm | 2.0 m/s · 36 cm | 2.0 m/s · 58 cm | 2.0 m/s · 76 cm |
|---|---|---|---|---|---|---|
| Velocity Tracking(特权高度图) | 1.00 | 0.00 | 0.00 | 1.00 | 0.00 | 0.00 |
| Uncomposed Data(无动作匹配) | 0.06 | 0.02 | 0.00 | 0.37 | 0.27 | 0.07 |
| End-to-end Depth(无蒸馏) | 0.95 | 0.07 | 0.08 | 0.78 | 0.19 | 0.14 |
| PHP(本文) | 1.00 | 0.99 | 0.95 | 1.00 | 0.99 | 0.95 |
表1:不同指令速度与障碍高度下的成功率(论文 Table I,每格 500 次试验)。
三条基线的失败模式各不相同,读起来比数字本身更有信息量。Velocity Tracking 能过 36 cm,但在 58 cm 与 76 cm 上直接归零:它基本只依赖脚下踩踏,从未发现「用手臂支撑的全身攀爬」策略——即使给了特权高度图与地形课程,纯奖励整形也够不到这类动作,与既有 reward-shaping 工作的表现一致。Uncomposed Data 尽管能访问原子技能,成绩依然很差(1 m/s 下 0.06/0.02/0.00),典型失败是走到障碍前却爬不上去也跳不过去:没有显式的长时程组合,策略在训练里既没经历过技能过渡,也没在行走阶段观察障碍以准备接下来的技能。End-to-end Depth 能应付低障碍(0.95/0.78),但一到难任务就崩(0.07/0.08 与 0.19/0.14),说明从零 RL 的探索确实是瓶颈。本文方法在同样六格上给出 1.00/0.99/0.95 与 1.00/0.99/0.95。
3. 消融:数据密度、可扩展性与 RL 的角色
| 变体 | 1.0 m/s · 58 cm | 1.0 m/s · 76 cm | 1.0 m/s · 94 cm | 2.0 m/s · 36 cm | 2.0 m/s · 58 cm | 2.0 m/s · 76 cm |
|---|---|---|---|---|---|---|
| Extreme Distances(只留最近/最远) | 0.99 | 0.62 | 0.64 | 0.98 | 0.60 | 0.58 |
| Half Density(随机保留一半) | 0.95 | 0.32 | 0.57 | 0.99 | 0.85 | 0.81 |
| DAgger Only(去掉 RL) | 0.16 | 0.03 | 0.12 | 0.63 | 0.09 | 0.10 |
| DAgger + Alive Reward | 1.00 | 0.90 | 0.96 | 0.94 | 0.91 | 0.84 |
| DAgger + Root Tracking | 1.00 | 0.79 | 0.75 | 1.00 | 0.92 | 0.87 |
| 1/4 Training Envs | 0.97 | 0.00 | 0.59 | 0.94 | 0.65 | 0.58 |
| 1/2 Training Envs | 0.94 | 0.60 | 0.68 | 0.97 | 0.79 | 0.75 |
| 3-layer MLP | 0.99 | 0.02 | 0.00 | 0.98 | 0.89 | 0.81 |
| 4-layer MLP | 1.00 | 0.94 | 0.08 | 1.00 | 0.94 | 0.88 |
| PHP(完整) | 0.99 | 0.95 | 1.00 | 1.00 | 0.98 | 0.90 |
表2:动作匹配数据密度、蒸馏阶段 RL 策略、训练规模与网络容量的消融(论文 Table II)。
数据密度一组直接支撑了 transition density 的假设。只保留最小与最大接近距离(Extreme Distances)时,各任务成功率普遍下降,策略无法泛化到接触时机最要紧的中间距离;随机保留一半(Half Density)在难技能上掉得更厉害,尤其当剩余样本偏向距离区间一端时——1.0 m/s 下 76 cm 与 94 cm 的攀爬,局部密度不足会让手放置的时机变得不可靠(0.32 与 0.57)。完整数据集稠密覆盖接近条件,才能在各种距离下稳定执行。
RL 的角色是这篇论文最锋利的结论。去掉 RL 只剩 DAgger,成绩从 0.99/0.95/1.00 塌到 0.16/0.03/0.12;作者在 76 cm 障碍上观察到的失败非常具体:学生手放对了,却卡在引体阶段发不出那一下扭矩爆发,因为决定性的爆发只跨几个时间步,逐步模仿损失对「稍微低估一点」的动作几乎不惩罚。反过来,RL 项对奖励设计出人意料地不敏感:只用 alive/progress 奖励(不含跟踪项)能拿到 1.00/0.90/0.96 与 0.94/0.91/0.84,只用根部跟踪奖励是 1.00/0.79/0.75 与 1.00/0.92/0.87,都接近全身跟踪的完整方案。作者的解读是:与 DAgger 共同训练时,RL 主要充当补偿 DAgger 低估的成功驱动 exploitation 信号,而不依赖细致的任务整形——因此在扩展到更大技能集时,一个简单的 alive 奖励可能就够。
可扩展性一组的走向与从零训练相反。1/4 环境数时 76 cm 掉到 0.00,1/2 时 0.60,完整 16384 环境时 0.95;网络从 3 层 MLP(0.02/0.00)到 4 层(0.94/0.08)再到论文的 5 层(0.95/1.00),难度越高的任务越吃容量。作者的结论是:从零训练时增加 rollout 常因探索上限而收益递减,而蒸馏框架在模型容量与 rollout 吞吐两个方向上都能良好扩展——这对打算把技能集做大的团队是条有用的经验。
4. 技能库:稀缺性的量化画像
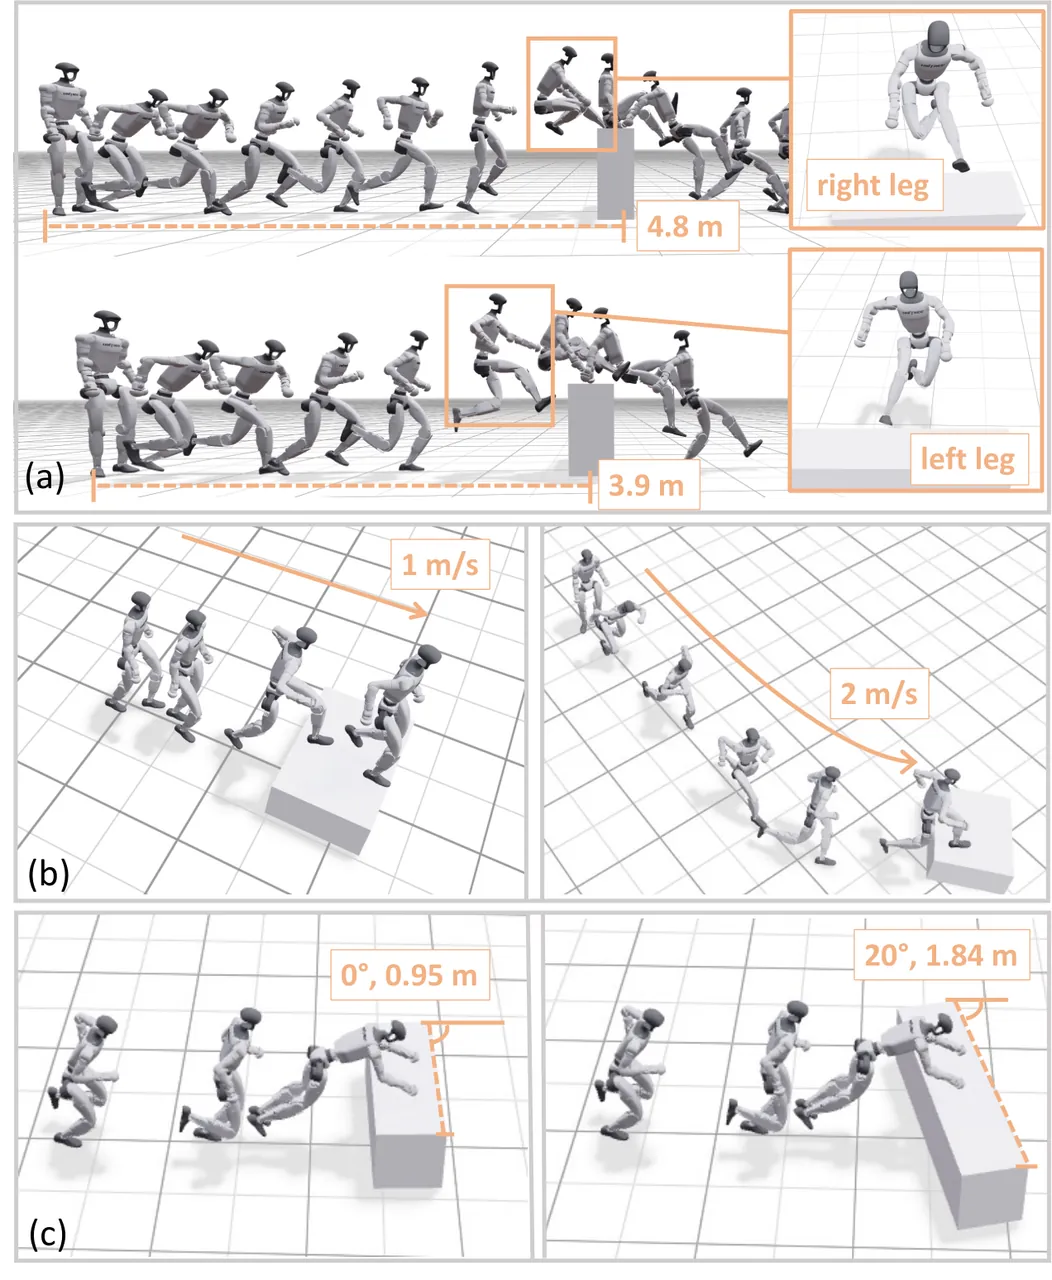
图5(论文 Fig. 3):动作匹配合成出的多样化变体。(a) 不同接近距离触发不同步态相位与入障姿态;(b) 多样的速度、方向与持续时间;(c) 随机化的地形位姿与形状。
| 技能类别 | 片段 | 总时长 (s) |
|---|---|---|
| 行走(共享过渡流形) | 站立 / 走 / 跑,指令速度 0.8–3.5 m/s | 495.5 |
| 跑酷技能 @ 1.0 m/s | Step (36 cm) | 2.2 |
| Climb (58 cm) | 12.1 | |
| Climb (76 cm) | 8.8 | |
| Climb (94 cm) | 10.3 | |
| 跑酷技能 @ 2.0 m/s | Step (36 cm) | 1.6 |
| Climb (58 cm) | 6.1 | |
| Climb (76 cm) | 4.4 | |
| Climb (94 cm) | 5.2 | |
| Climb (125 cm) | 5.9 | |
| Dash Vault | 5.0 | |
| Speed Vault | 3.1 | |
| 跑酷技能 @ 3.0 m/s | Cat Vault | 1.5 |
表3:动作库构成(论文 Table III)。行走片段 495.5 s,而每个原子技能只有 1.5–12.1 s——这正是「高动态数据稀缺」的量化画像,也是为什么必须靠组合而非采集来扩充。
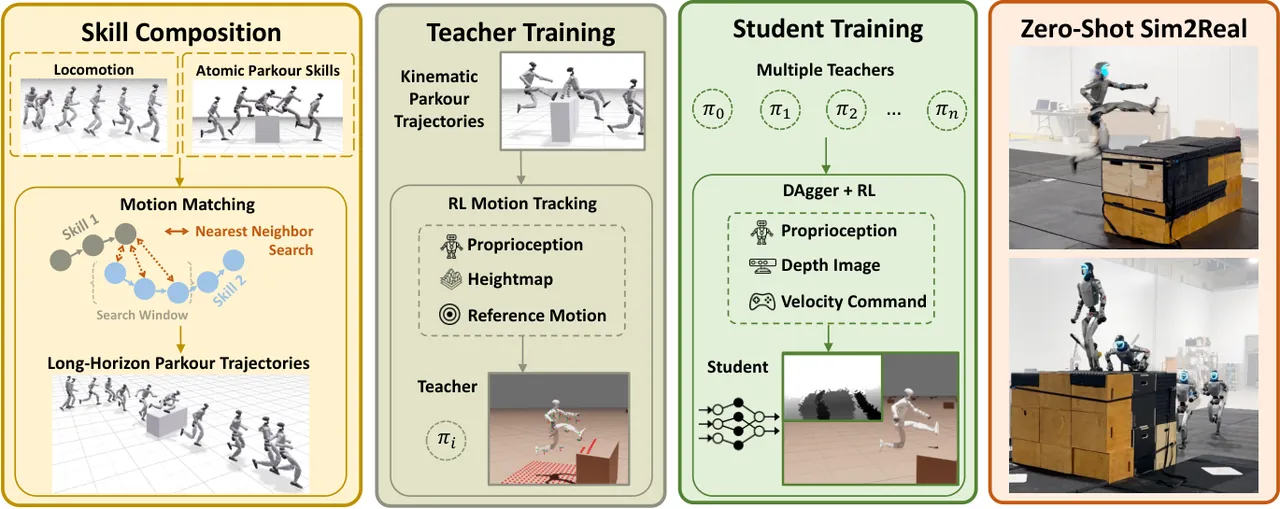
图6(论文 Fig. 2):系统总览。原子技能经动作匹配组合成长时程参考;单技能教师用特权信息做 RL 动作跟踪;多个教师经 DAgger 与 RL 的混合目标蒸馏成单个深度学生,零样本迁移到真机。
局限性
作者自述之一:缺语义场景理解。整套系统的决策完全建立在几何之上——深度图告诉策略「这里有一块多高的东西」,但不告诉它「这是一张桌子,可以撑手;那是一根栏杆,可以抓握」。作者认为引入语言等更丰富的条件信号,能对动作的多样性与风格做更细的控制。
作者自述之二:感知与硬件共同封顶了真机能力。短量程、窄视场的相机在高速奔跑时来不及把障碍几何看全,机器人被迫在感知模糊下提前承诺动作;同时硬件没有足够强的手或夹爪去与边缘、横杆交互,因此超过自身身高的攀爬与悬挂类动作根本没被测试。换句话说,1.25 m 不是方法的极限,而是「这台 G1 的手」的极限。
笔者判断之一:人工标注是这条流水线的隐形成本。每个技能都要手工标出起止帧 $(s_{k},e_{k})$、给定入障窗口长度 $H_{k}$,还要为每条片段手工拟合一个对齐的箱形地形(仓库里 SKILL_REGISTRY 的 30 处 search_ranges 与逐技能的 terrain/*.obj 就是这份人工账单)。动作匹配省下了学习过渡模型的钱,却把成本转移到了标注上;技能数量增长时,这部分不会自动 scale。
笔者判断之二:定量证据只覆盖单障碍。表1、表2 的全部数字都是「一个障碍 + 500 次试验」的成功率,而最抓眼的多障碍长时程穿越(48 s、60 s)只有真机定性展示,没有成功率、没有重复次数、也没有与多障碍基线的对比。同时参考轨迹是纯运动学的,不含动力学与接触力,重定向后对这台 G1 的质量分布是否始终可行,论文没有给出检验;评测指标也只有二值成功,没有动作自然度或能耗维度。此外对比对象全是自家消融基线,缺少与当前最强感知人形系统的横向比较,AMP 基线虽实现过(用 MimicKit,能稳定行走但过障大多失败)却因调参空间未充分探索而被排除在正式表格之外——作者对此坦承,但读者仍需自行折价。
总结与展望
PHP 的贡献可以压成一句话:把动作库变稠密的办法不是采更多数据,而是让已有片段互相接续。动作匹配用一次带窗口约束的最近邻检索,把几秒长的原子技能缝成跨越不同接近距离、步态相位与时机的长时程参考,顺带解决了「技能之间怎么过渡」这个人类动作模仿路线上最难的问题——不需要为每一对技能捕捉过渡,因为走跑就是那个共享接头。训练侧的结论同样清晰:专家负责动作质量,蒸馏负责把能力压进一个只看深度图的策略,而蒸馏必须是 DAgger 加 RL 的混合体——纯模仿学不出那一下决定性的扭矩爆发,纯 RL 又会抖成不自然的动作。数据密度、终止阈值放宽、镜像多模态、关闭学生阶段自适应采样这些看似琐碎的工程决定,每一个都在消融或真机表现里留下了可测的痕迹。
往后看,作者指出两条路:一是引入语义与语言条件,让「选择哪个技能」不再只由几何决定,从而对风格与多样性做更细的控制;二是更强的传感与手部硬件,把攀爬推到身高以上、把悬挂与栏杆交互纳入技能库。对做机器人学习的团队,这套配方里最可复用的其实不是跑酷本身,而是那条通用规律:当某个技能的数据只有几秒时,先用检索把它接到一个共享流形上做稠密化,再谈策略学习;以及,当你发现学生在关键几帧上「差一点力气」时,问题往往不在模仿数据不够,而在损失函数看不见成败。