PAPER DEEP DIVE
P-BFM:感知行为基础模型实现人形机器人地形自适应控制
P-BFM 用无监督 RL 把动作参考、目标状态与奖励函数统一编码进地形无关的意图空间,一个冻结策略凭深度感知在不同地形实现同一意图;配合显式根部指令 ERI,零样本迁移到 Unitree G1,未见动作恢复率 61.4%。
论文:P-BFM: Perceptive Behavioral Foundation Models for Humanoid Control via Unsupervised Reinforcement Learning(arXiv:2610.15833v1,cs.RO,2026-10-11)
作者:Xue Wang、Yitang Li、Yiming Zhang(共同第一),Siqin Wang、Junhan Sun、Zhihao Liu、Yaojie Shen、Jingbo Yuan、Hao Zhao、Qingdu Li(通讯)
机构:上海理工大学、RoboPartyLab、清华大学、浙江大学、哈尔滨工业大学
代码:github.com/Roboparty/UFO(已发布) · 项目页:roboparty.github.io/P-BFM
一句话总结
P-BFM 把「做什么动作」和「在什么地形上怎么做」拆开:用无监督强化学习把动作参考、目标状态、奖励函数全部编码进一个不含地形信息的意图空间,再让一个感知策略看着深度图自己去实现这个意图——同一个「向前走」的意图,在上楼梯时变成高抬腿离散踩踏,在斜坡上变成连续调整接触,全程不需要任何地形配对的演示数据。
研究背景与动机
人形机器人被设计出来是为了进入为人设计的环境:客厅、厨房、楼梯间、工地。要兑现这个设想,机器人需要一个可复用的技能空间和一套能执行大量技能的控制器。行为基础模型(Behavioral Foundation Models,BFM)近两年在这条路上进展很快——BeyondMimic 把鲁棒运动跟踪与引导扩散结合,合成并组合运动基元;NVIDIA 的 SONIC 用大规模动捕数据学统一全身控制器;而基于 forward–backward(FB)表示的一系方法(Meta Motivo、BFM-Zero、UFO)则让奖励函数直接指定潜在行为,一个控制器就能表现出多样的全身行为、抗扰动恢复和灵活的任务指定方式。
但真实世界的通用性不止于「会很多技能」,还包括「感知并适应周围环境」。这里有一个被长期回避的数据瓶颈:大量跟踪型 BFM 依赖演示,一旦扩展到感知控制,数据空间就从「动作」膨胀成「地形几何 × 动作」的组合。用配对演示覆盖这个组合空间几乎不可能,模型对未见组合的泛化也就无从谈起。已有工作试图用 terrain-aware 运动增广来缓解,但底层优化在某些与地面有丰富接触的行为上会产出次优参考动作;PMT 用离线参考优化加师生训练降低对演示的依赖,可参考合成与策略学习相互分离,既引入偏差,也很难扩展到「摔倒后爬起来」这类接触极丰富的行为。
P-BFM 的选择是换一条路:不让机器人模仿「地形配对的正确答案」,而是让它自己在复杂地形里交互、探索,从交互中学地形适应。这条路线建立在 FB 表示之上——FB 是一套无奖励(reward-free)框架,联合学习行为表示与以潜在变量为条件的策略,任务级奖励函数可以映射到潜在变量上再交给策略执行。奖励把机器人状态映为标量,指定「抬起手臂」「趴下」这类行为意图,探索驱动的框架让机器人无需为每一种「地形—动作」组合准备演示。
在这个框架里,有一条不变量值得注意:奖励指定的意图应该跨地形保持一致,而它的执行应当随地形几何而变。论文因此把「意图编码」与「感知驱动的执行」显式分开——反向表示只看身体状态、不吃地形输入,于是同一份奖励规格在不同地形上编出同一个潜在意图;策略则拿深度观测去把这个意图落到实处。
然而,纯潜在控制有一个互补的缺陷:无监督 RL 对根部运动的监督很弱,潜在变量保住了局部动作模式,却可能丢掉全局进度——机器人在障碍前原地踏步,或者越走越偏。论文的解法是 ERI(Explicit Root Instructions,显式根部指令):把全局运输(航向、平面速度)从行为意图里拆出来,作为显式指令喂给策略,局部全身适应仍然留给感知策略。这个拆法带来一个常规 BFM 不具备的特性:一个固定意图可以诱导出不同的、适配地形的行为——步高、步幅、姿态、落脚点和接触方式都会变,而不需要任何地形专属演示。
预备知识
论文把感知人形控制建模为部分可观测马尔可夫决策过程 $\mathcal{M}=(\mathcal{S},\mathcal{O},\mathcal{A},P,\Omega,\gamma)$,其中 $\mathcal{S}$、$\mathcal{O}$、$\mathcal{A}$ 分别是状态、观测与动作空间,$P$ 是转移动力学,$\Omega$ 是观测模型,$\gamma\in[0,1)$ 是折扣因子。策略的观测由四部分组成:本体感知及其历史 $o_{t}^{p}$、由 8 帧深度图时序聚合出的视觉特征 $h_{t}^{v}\in\mathbb{R}^{256}$、估计的根部速度 $\hat{\mathbf{v}}_{t}^{\mathrm{yaw}}$、潜在变量 $z_{t}$,外加全局航向与平面速度指令 $c_{h,t}$、$c_{v,t}$。动作 $a_{t}\in\mathbb{R}^{29}$ 是关节目标,由底层 PD 控制器执行:
$$a_{t}\sim\pi_{\theta}\left(\cdot\mid o_{t}^{p},h_{t}^{v},\hat{\mathbf{v}}_{t}^{\mathrm{yaw}},z_{t},c_{h,t},c_{v,t}\right)$$
潜在变量指定「想要什么行为」,视觉特征引导「怎么适配地形」,全局指令规定「航向与速度要求」。训练时允许使用特权信息(真实速度、地形信息),部署时只用板载传感器、潜在变量和指令。
FB 表示方面,设 $\rho$ 为参考状态分布,前向表示 $F:\mathcal{S}\times\mathcal{A}\times\mathbb{R}^{d}\rightarrow\mathbb{R}^{d}$ 与后向表示 $B:\mathcal{S}\rightarrow\mathbb{R}^{d}$ 中,每个潜在变量 $z\in\mathbb{R}^{d}$ 索引一个策略 $\pi_{z}$。策略 $\pi_{z}$ 的折扣后继状态测度用低秩分解近似:
$$M^{\pi_{z}}(ds^{\prime}\mid s,a)\approx F(s,a,z)^{\top}B(s^{\prime})\,\rho(ds^{\prime})$$
对下游状态奖励 $\tilde{r}$,对应潜在变量为 $z_{\tilde{r}}=\mathbb{E}_{s\sim\rho}[B(s)\tilde{r}(s)]$,于是 $Q_{\tilde{r}}^{\pi_{z_{\tilde{r}}}}(s,a)\approx F(s,a,z_{\tilde{r}})^{\top}z_{\tilde{r}}$,策略只需偏好内积大的动作。P-BFM 的关键用法是把奖励定义在身体状态特征上:$\tilde{r}(s)=r(\chi(s))$。奖励到潜在变量的映射因此只负责指定行为意图,随地形变化的执行完全交给以感知为条件的策略。
方法详解
P-BFM 的总架构由两块拼成:一块地形无关的意图空间,回答「做什么」;一块地形感知的执行器(actor),回答「怎么做」。预训练阶段同时学这两块——把深度观测编码为视觉特征用于地形感知,用 FB 表示学意图空间,再用判别器与辅助评论器训练 actor。
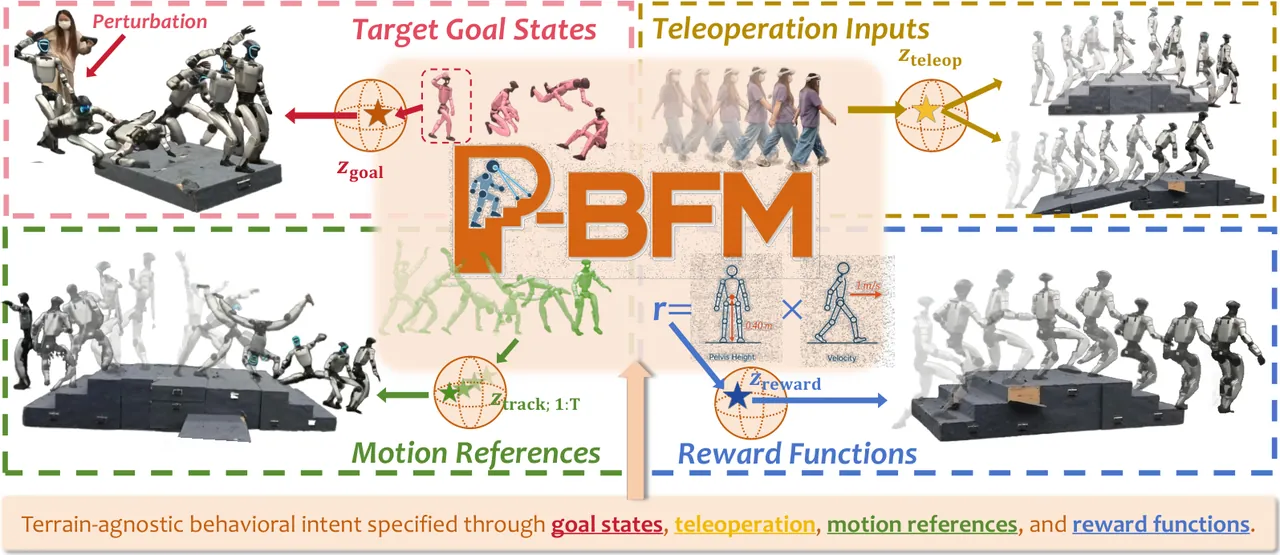
图1:统一意图空间。动作参考、遥操作输入、目标状态与奖励函数被映射进同一个地形无关意图空间,同一个意图在不同地形上由感知策略实现为不同行为。
感知整合。actor 的条件写为 $a_{t}\sim\pi_{\theta}\!\left(\cdot\mid o_{t}^{p},h_{t}^{v},\operatorname{sg}(\hat{\mathbf{v}}_{t}^{\mathrm{yaw}}),z_{t},c_{h,t},c_{v,t}\right)$,其中 $\operatorname{sg}$ 表示停止梯度。速度估计器 $\hat{\mathbf{v}}_{t}^{\mathrm{yaw}}$ 预测航向对齐坐标系下的三维根部线速度,它不接收潜在变量、全局指令或真实速度,只依赖可部署的板载观测,因此推理时可以直接用。它用自己的估计损失训练(用仿真速度做监督,更新估计器与深度编码器),而策略梯度经过估计速度时被截断——估计误差不会被策略「洗白」成对自身的依赖。
ERI:显式根部指令。对跟踪意图,$z_{t}$ 从一段短参考窗口编码行为,ERI 则从同一参考里取出显式的目标航向与平面速度。设 $\psi_{t}$、$\psi_{t}^{\star}$ 为当前与目标航向,$\mathbf{v}_{t,xy}^{\star}$ 为目标平面速度,指令编码为:
$$c_{h,t}=m_{h,t}\begin{bmatrix}1-\cos(\Delta\psi_{t})\\\sin(\Delta\psi_{t})\end{bmatrix},\quad\Delta\psi_{t}=\psi_{t}^{\star}-\psi_{t}$$
$$c_{v,t}=\begin{bmatrix}m_{v,t}R(-\psi_{t})\mathbf{v}_{t,xy}^{\star}\\m_{v,t}\end{bmatrix}$$
其中 $R(-\psi_{t})$ 把速度指令旋转进当前航向坐标系,$m_{h,t},m_{v,t}\in\{0,1\}$ 标记目标是否有效。零速度被视为有效的「停下」指令;随机或目标条件化的潜在变量不会自动获得参考速度目标。训练上,评论器 $Q_{H}$、$Q_{V}$ 分别从两个奖励学习:
$$r_{H,t}=-m_{h,t}\left[1-\cos(\psi_{t+1}^{\star}-\psi_{t+1})\right]$$
$$r_{V,t}=-m_{v,t}\,\ell_{\mathrm{Huber}}\!\left(\frac{\|\mathbf{v}_{t+1,xy}^{\mathrm{sim}}-\mathbf{v}_{t,xy}^{\star}\|_{2}}{\sigma_{v}}\right)$$
航向奖励用下一步的参考航向,速度奖励比较动作后的平面速度与当前指令。一个容易忽略但重要的设计是:$Q_{V}$ 只约束平面速度,垂直方向的运动仍然可以自由适配地形——这正是 ERI 不破坏地形适应性的原因。$\ell_{\mathrm{Huber}}(u)=u^{2}/2$($0\leq u\leq1$)否则 $u-1/2$,$\sigma_{v}$ 设定速度误差尺度。
预训练。后向表示实现为 $B(s)=B_{\phi}(x)$,$x=\chi(s)$ 含本体感知与特权身体状态,但不含深度、地形图或指令;前向表示 $F_{\psi}(\xi,a,z)$ 则通过 $\xi$ 接收历史、地形信息与指令。FB 分数 $Q_{\mathrm{FB}}(\xi,a,z)=F_{\psi}(\xi,a,z)^{\top}z$ 保证同一个目标身体状态或奖励无论什么地形都编码成同一个潜在变量。40 条平地的 LaFAN 序列提供行为提示与条件判别器 $D_{\omega}(x,z)$ 的正样本,不做任何地形专属的运动合成。$F$ 与 $B$ 用 FB Bellman 目标加正交正则训练。actor 最大化 FB 价值与各辅助评论器:
$$\mathcal{L}_{\pi}=-\overline{Q}_{\mathrm{FB}}-\alpha\sum_{k\in\{D,A,H,V\}}\lambda_{k}\overline{Q}_{k},\qquad\alpha=\operatorname{sg}\!\left(\mathbb{E}[|Q_{\mathrm{FB}}|]\right)$$
其中 $\alpha$ 取 FB 价值量级的停止梯度期望,起到自动平衡主目标与辅助项的作用——不同训练阶段 FB 价值尺度会变,固定权重要么压过辅助奖励、要么被压过,这个归一化让四项(判别器奖励 $Q_{D}$、物理辅助 $Q_{A}$、ERI 的 $Q_{H}$、$Q_{V}$)在任何尺度下都按同一比例参与。
零样本推理。全部参数冻结后,P-BFM 支持三类意图:跟踪意图(来自动作参考)、目标抵达意图(来自目标身体状态)与奖励意图(来自奖励函数)。三类意图都经过冻结的后向表示编码:
$$z_{t}=B_{\phi}\!\left(\chi(s_{t}^{\mathrm{align}})\right)\ \text{(跟踪)},\quad z_{t}=B_{\phi}\!\left(\chi(s_{t}^{\mathrm{goal}})\right)\ \text{(目标)},\quad z_{t}=\frac{1}{N}\sum_{i=1}^{N}B_{\phi}\!\left(\chi(s_{i}^{\mathrm{replay}})\right)\tilde{r}(s_{i})\ \text{(奖励)}$$
长度 $T$ 的参考序列取窗口编码;奖励指定期望行为时,非零向量归一化到范数 1,与训练时的潜在尺度匹配。遥操作复用跟踪接口,目标是在线重定向后的身体状态。部署时策略执行均值动作,ERI 指令在有效时随取随用。
下图概括了完整的数据流:预训练期 FB 表示在地形无关的身体状态空间上学意图空间,深度编码器与 actor 在仿真地形上交互;推理期三类任务规格各自编成潜在变量,汇入同一个 actor。
graph LR
  subgraph PRETRAIN["预训练(参数随后冻结)"]
    A1["动作参考 LaFAN×40"] --> B1["后向表示 Bφ
仅身体状态 · 无地形"]
    R1["奖励函数 r(χ(s))"] --> B1
    G1["目标身体状态"] --> B1
    B1 --> Z["地形无关意图空间 z"]
    Z --> ACT["感知 actor πθ"]
    D1["深度图 ×8 帧"] --> H1["视觉特征 h^v (256d)"]
    H1 --> ACT
    E1["ERI 指令 c_h, c_v"] --> ACT
    ACT --> FB["FB 价值 Q_FB"]
    ACT --> QD["判别器奖励 Q_D"]
    ACT --> QA["物理辅助 Q_A"]
    ACT --> QH["ERI 评论器 Q_H, Q_V"]
    FB --> LOSS["L_π = -Q̄_FB - α·Σλ_k Q̄_k"]
    QD --> LOSS
    QA --> LOSS
    QH --> LOSS
  end
  subgraph INFER["零样本推理(全冻结)"]
    M1["动作参考"] --> Z2["编码为 z"]
    G2["目标状态"] --> Z2
    R2["奖励函数"] --> Z2
    Z2 --> ACT2["同一个感知 actor"]
    DEP["板载深度 D435i"] --> ACT2
    ACT2 --> PD["PD 控制器"]
    PD --> J["29 维关节目标"]
  end
实验结果
实验设置。P-BFM 在 MJLab 中用 Unitree G1 模型训练,共 1.92 亿环境步,NVIDIA H200×8 约 10 小时,推理时全部参数冻结。评价指标包括关节角平均绝对误差 $E_{\mathrm{jpos}}$、根部水平速度误差 $E_{\mathrm{vel}}^{\mathrm{root}}$、根部航向误差 $E_{\mathrm{head}}^{\mathrm{root}}$、脚步滑移 FS(50 Hz 下平均位移,cm)与跟踪恢复率 RR。恢复判定为扰动移除后 5 秒内航向与水平速度误差同时进入容差并连续保持至少 1 秒。评价覆盖 7 类地形(平地、粗糙、上楼、下楼、高台、倒金字塔坡、箱式障碍),每类 10 个难度等级。
与通用人形控制基线的对比。基线选了两个有代表性的:UFO(同为 FB 表示的无监督 RL 框架)与 PMT(离线参考优化 + 地形感知跟踪)。论文坦诚说明了一点:PMT 完整训练集未公开,只能在其唯一发布的参考轨迹上评测,而 UFO 与 P-BFM 用更宽的 40 条 LaFAN 序列。即便如此,P-BFM 在关节位置、航向误差、脚步滑移上全面更低,恢复率大幅更高:
| 方法 | 已见动作(40 条 LaFAN) | 未见动作(994 条 SOMA) | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| $E_{\mathrm{jpos}}$ (rad)↓ | $E_{\mathrm{vel}}^{\mathrm{root}}$ (m/s)↓ | $E_{\mathrm{head}}^{\mathrm{root}}$ (°)↓ | FS (cm)↓ | RR (%)↑ | $E_{\mathrm{jpos}}$ (rad)↓ | $E_{\mathrm{vel}}^{\mathrm{root}}$ (m/s)↓ | $E_{\mathrm{head}}^{\mathrm{root}}$ (°)↓ | FS (cm)↓ | RR (%)↑ | |
| UFO | 0.15±0.06 | 0.65±0.46 | 49.6±29.3 | 0.092±0.050 | 3.4 | 0.16±0.06 | 0.37±0.27 | 28.9±23.9 | 0.066±0.047 | 16.6 |
| PMT | 0.21±0.04 | 0.20±0.08 | 8.8±7.7 | 0.078±0.029 | 2.4 | 0.46±0.09 | 0.86±0.27 | 84.4±22.5 | 0.205±0.103 | 0.5 |
| P-BFM | 0.11±0.04 | 0.25±0.12 | 6.9±5.4 | 0.043±0.026 | 41.2 | 0.13±0.06 | 0.21±0.12 | 6.7±4.7 | 0.026±0.016 | 61.4 |
表1:与感知型通用人形控制器的对比。已见动作上 PMT 只有一条发布轨迹,评测集不对等,结论宜作方向性参考。
最刺眼的数字是恢复率:UFO 3.4%、PMT 2.4%,P-BFM 41.2%(已见)与 61.4%(未见)。论文把这归因于端到端的交互式学习——运动适应来自与多样地形的直接交互,而不是离线参考优化。需要注意 PMT 的 0.20 m/s 速度误差(已见)确实优于 P-BFM 的 0.25,这是它在唯一轨迹上充分优化的结果,也反衬出评测集不对等的局限。
单一意图的地形自适应行为。实验用一个平地前走奖励函数推出潜在意图,再把同一个潜在变量拿到多种地形上评。策略并没有复刻固定的行走模式,而是自主改变步高、步幅、身体姿态与落脚点选择——上楼时高抬腿、离散选落脚点,坡地上则做连续的接触调整。训练中没有给过任何地形专属演示,这些适配行为完全从复杂环境的自主探索中涌现。
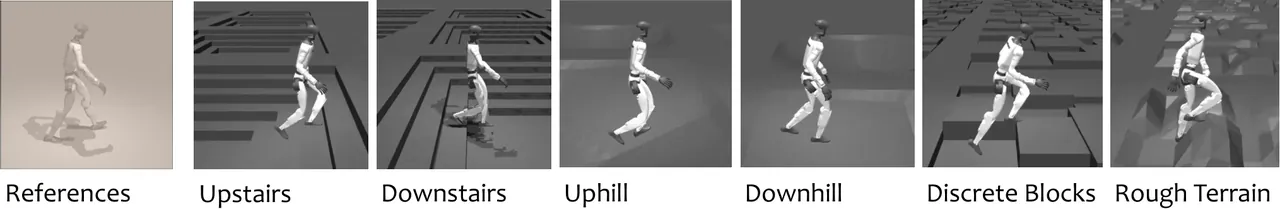
图3:同一前走意图的地形自适应行为。楼梯升降、坡地穿越、离散落脚点选择与粗糙地面迈步各不相同。
消融:ERI 的两个指令缺一不可。分别去掉航向指令与速度指令后,各自对应的指标明显退化:
| 方法 | 已见动作 | 未见动作 | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| $E_{\mathrm{jpos}}$ (rad)↓ | $E_{\mathrm{vel}}^{\mathrm{root}}$ (m/s)↓ | $E_{\mathrm{head}}^{\mathrm{root}}$ (°)↓ | FS (cm)↓ | RR (%)↑ | $E_{\mathrm{jpos}}$ (rad)↓ | $E_{\mathrm{vel}}^{\mathrm{root}}$ (m/s)↓ | $E_{\mathrm{head}}^{\mathrm{root}}$ (°)↓ | FS (cm)↓ | RR (%)↑ | |
| w/o head | 0.12±0.04 | 0.28±0.14 | 19.3±14.2 | 0.045±0.026 | 20.7 | 0.13±0.06 | 0.22±0.12 | 14.6±14.3 | 0.026±0.018 | 39.5 |
| w/o vel | 0.12±0.04 | 0.41±0.26 | 7.7±6.9 | 0.032±0.018 | 22.4 | 0.13±0.06 | 0.32±0.19 | 6.3±4.9 | 0.020±0.012 | 42.9 |
| P-BFM | 0.11±0.04 | 0.25±0.12 | 6.9±5.4 | 0.043±0.026 | 41.2 | 0.13±0.06 | 0.21±0.12 | 6.7±4.7 | 0.026±0.016 | 61.4 |
表2:全局指令消融。去掉航向指令机器人逐渐偏离目标方向;去掉速度指令则复现局部踏步但在困难地形前进展甚微。
有个反直觉的细节值得玩味:去掉速度指令后 FS(脚步滑移)反而是全表最低(0.032/0.020 cm)——机器人几乎不前进,自然没什么可滑。航向误差与速度误差的此消彼长也印证了两个指令各管一段:没有航向指令就漂,没有速度指令就原地踏步。完整版在保持参考行为的同时维持了目标航向与前进进度。
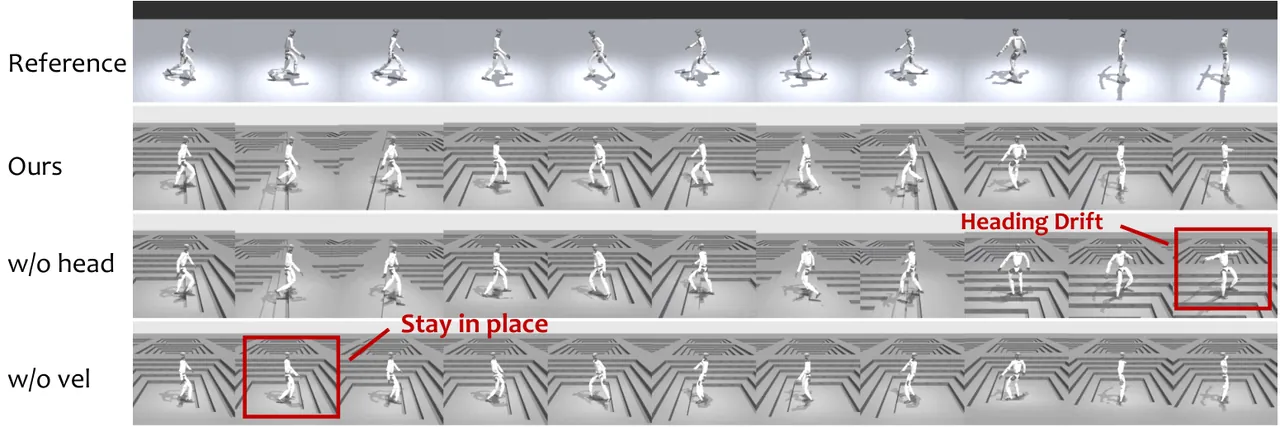
图4:消融定性对比。左:无航向指令出现漂移;中:无速度指令原地踏步;右:P-BFM 保持航向与前进。
真机验证。部署平台是装配 RealSense D435i 深度相机的 Unitree G1,覆盖遥操作、运动跟踪、目标抵达、奖励推断与抗扰动恢复五类任务。遥操作场景最能说明问题:同一份遥操作输入,在楼梯上变成高抬腿加离散落脚,在坡地上变成平滑连续的接触调整;机器人在与楼梯频繁接触的情况下仍保持预期的全身行为,还能从意外摔倒中恢复。
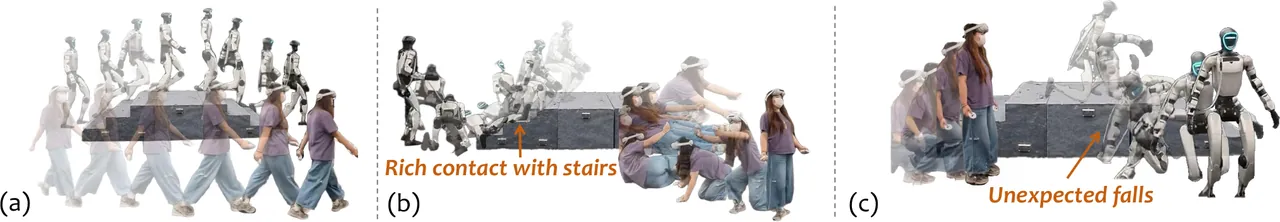
图5:真机遥操作。(a) 跟随遥操作行走意图并适配楼梯;(b) 与楼梯的丰富接触中保持全身行为;(c) 从意外摔倒中恢复。
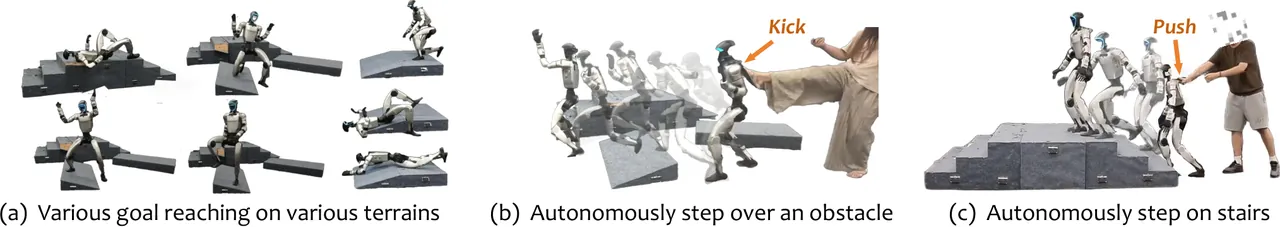
图6:真机目标抵达与地形感知恢复。
局限性
作者自述的局限。论文在结论中明确:行为泛化仍受训练期探索过的运动先验与地形多样性限制。更宽的动作数据集和更具挑战的地形(特别是需要复杂全身接触的)留给未来工作。换句话说,意图空间的「词汇表」边界由训练时的探索决定,意图空间之外的意图,感知策略再强也编码不出来。
评测口径的局限。主表的对比并不严格对等:PMT 只有一条发布轨迹,UFO 与 P-BFM 用 40 条 LaFAN,论文自己也声明「differing evaluation sets preclude a strictly matched comparison」。因此表1宜作方向性参考而非定论;PMT 在已见动作上更低的速度误差(0.20 vs 0.25 m/s)正说明这一点。
ERI 的适用边界。ERI 指令依赖有效目标掩码 $m_{h,t},m_{v,t}\in\{0,1\}$:随机采样或纯目标条件化的潜在变量不会自动获得参考速度目标,零速度被当作有效的停车指令。这意味着 ERI 的收益集中在「有参考可依」的跟踪类任务;对纯探索性意图,全局进度的监督仍然要回到 FB 价值本身。
总结与展望
P-BFM 的贡献可以压成一句话:把「意图」做成地形无关的常量,把「执行」交给地形感知的函数。无监督 RL 加 FB 表示提供了不含地形的意图空间,深度感知策略提供逐地形变化的实现方式,ERI 则补上无监督学习缺失的全局进度监督。三者拼起来的效果是:一个冻结策略同时支持运动跟踪、目标抵达、奖励推断、遥操作与地形感知恢复,并零样本迁移到真机 G1。
这条路线对「技能库 × 环境」组合爆炸问题给出了一种不靠堆演示的答案,也自然引出后续问题:意图空间的多样性如何随训练数据扩展而保持结构?当行为需要复杂全身接触(摔倒爬起、搬运中失衡)时,ERI 的平面速度约束是否足够?以及深度感知在光照剧烈变化、透明与反光表面上的可靠性,都还需要在更宽的硬件上验证。
金句:「教机器人做什么,让它自己决定怎么做。」P-BFM 把行为意图编码成地形无关的常量,把「怎么走」留给感知——同一个「向前走」,在楼梯上是抬腿,在坡地上是调接触,步法不是教出来的,是地形长出来的。