PAPER DEEP DIVE
SimpleVLN:不改架构释放原生多模态大模型的视觉语言导航能力
视觉语言导航(VLN)要求具身智能体把自然语言指令落到第一视角观测上并完成长程决策。现有方法大多靠任务专用结构补能力——全景拼接、3D 几何编码器、双系统分层决策——因此很难判断成绩里有多少来自 MLLM 本身。SimpleVLN 把问题反过来问:在引入任何任务专用模块之前,原生 MLLM 的导航潜力是否已经被榨干? 它的回答分三层。表述层:每次决策都重新构造一轮独立输入,即指令 + 当前观测 + 固定预算的全局-局部历史(默认全局 8 帧均匀采样、局部 1 帧),不再累积成越来越长的多轮对话;输出侧用动作块,一次推理给出多个基元动作(前进 0.25 m、左右转 15 度、停止)依次执行。数据层:R2R、RxR、ScaleVLN 的专家演示转成决策级监督样本,基于偏离度的 DAgger 在策略自己走到的状态上收集纠偏轨迹,RL 任务则在训练场景里自动合成新的起点-终点与指令。优化层:IL 到 DAgger 再到 RL 三段递进,RL 只用二值成功奖励(停在目标 3 m 内记 1 分),主结果用 DAPO 训 40 步。 只用单目 RGB、不改一行网络结构,Qwen3.5-9B 版在 R2R-CE 与 RxR-CE 的 val-unseen 上分别拿到 76.7% 与 80.1% 成功率,超过依赖全景、深度或里程计的现有方法;单次动作块决策耗时 293 ms。消融显示单轮输入把成功率从 35.7% 抬到 53.6%,DAgger 再贡献 7.5 与 8.1 个点。评测代码与八个权重已开源,并在 Daystar 四足机器人(Jetson Thor 机载)上完成真实环境验证。
论文元信息
标题:SimpleVLN: Towards Simple and Frontier Vision-Language Navigation
作者:Lingyi Hong、Weiren Cai(共同一作)、Jiayu Chen、Xinyu Zhou、Bailin He、Yunfei Guo、Qiao Sun、Boyu Ma、Jianfei Yang、Wenqiang Zhang(复旦大学、南洋理工大学、联想研究院;标注含共同项目负责人与通讯作者)
链接:arXiv:2610.23203(v1,2026-10-16,cs.RO)· arXiv HTML 全文 · 项目主页 · GitHub · HuggingFace 权重合集
代码状态:✅ 部分发布。github.com/simplevln/SimpleVLN 放出了完整的评测链路:687 行的 eval/vln/eval.py(Habitat 环境 + vLLM OpenAI 兼容端点上的导航 agent)、R2R-CE / RxR-CE 的 val_unseen 标注包(1839 / 3669 条 episode)与 Matterport3D 场景准备脚本、两份 Hydra 配置、结果断点续跑存储,以及 Qwen2.5-VL 3B/7B、Qwen3-VL 4B/8B、Qwen3.5 4B/9B 共八个 SFT 与 RL 权重。⛔ 训练侧不在其中:IL/DAgger/RL 的训练脚本、RL 任务合成管线、DAgger 偏离度阈值都没有公开,仓库本身也未声明 license(只有数据目录里的 CC-BY-4.0 与 MP3D 获取说明)。仓库 2026-10-15 创建、10-19 最近推送、10 stars。因此公开代码能复现的是「怎么评测」,不是「怎么训出 76.7%」。
一句话总结:不给 MLLM 加任何任务专用结构,只重做导航的输入组织(单轮重建 + 固定预算的全局-局部记忆)、输出形式(动作块)、数据来源(专家演示 + DAgger 纠偏 + 合成 RL 任务)与训练顺序(IL→DAgger→RL),Qwen3.5-9B 版仅用单目 RGB 就在 R2R-CE / RxR-CE val-unseen 上拿到 76.7% / 80.1% 成功率,单次决策 293 ms。
研究背景与动机
视觉语言导航(VLN)要求具身智能体在没见过的环境里按自然语言指令行动:把「穿过走廊,在第二个门口左转,走到沙发旁边停下」这样的句子落到第一视角的像素上,并且在几十上百步里保持决策一致。VLN-CE 把这个任务从预定义的离散视点搬到连续环境,动作被切成低层基元(前进 0.25 m、左右转 15°、停止),于是长程决策、误差累积与观测组织一起变成了真问题。
过去几年的进展大多来自任务专用结构。一类是感知与空间推理增强,例如 JanusVLN 挂 3D 几何编码器;一类是图式建模,把环境抽象成拓扑图再在图上决策;一类是分层与双系统,DualVLN、SEDualVLN、AgentVLN、NavFoM 用快慢两套模块分别管反应与规划;StreamVLN 引入流式上下文,还有一批工作给模型加上显式思维链推理。这些设计确实把成绩推了上去,但它们同时把一个问题盖住了:一次评测里的高分,有多少来自骨干 MLLM,有多少来自挂在它身上的那些模块?
作者的判断是:这个归因现在是不可分的。增强型系统的性能同时反映骨干与任务模块,于是「原生 MLLM 自己能走多远」始终没有单独被测过。论文把这句话写成一个明确的问题——在引入任务专用架构之前,我们真的已经榨干原生 MLLM 在 VLN 上的潜力了吗?为了回答它,作者给自己加了一条硬约束:不动架构。不加图编码器,不加记忆模块,不加双系统,不改前向图;能改的只有喂进去什么、让它吐什么、拿什么数据训、用什么目标训。
保留架构不等于什么都不做。要把一个为图文问答预训练的模型变成能连续走路的策略,至少有三件事必须重做,这也正是 SimpleVLN 的三条轴线。表述层解决「一次决策看到什么、说出什么」:单轮重建输入配固定预算的全局-局部记忆,避免上下文随 episode 无界增长;动作块让一次推理吐出多个基元动作。数据层解决「监督从哪来」:专家演示提供动作级监督,基于偏离度的 DAgger 补上策略自己走到的状态,RL 阶段则用自动合成的新任务扩展分布。优化层解决「优化什么」:从模仿动作,到在自己的状态分布上纠偏,最后直接优化任务级成功。
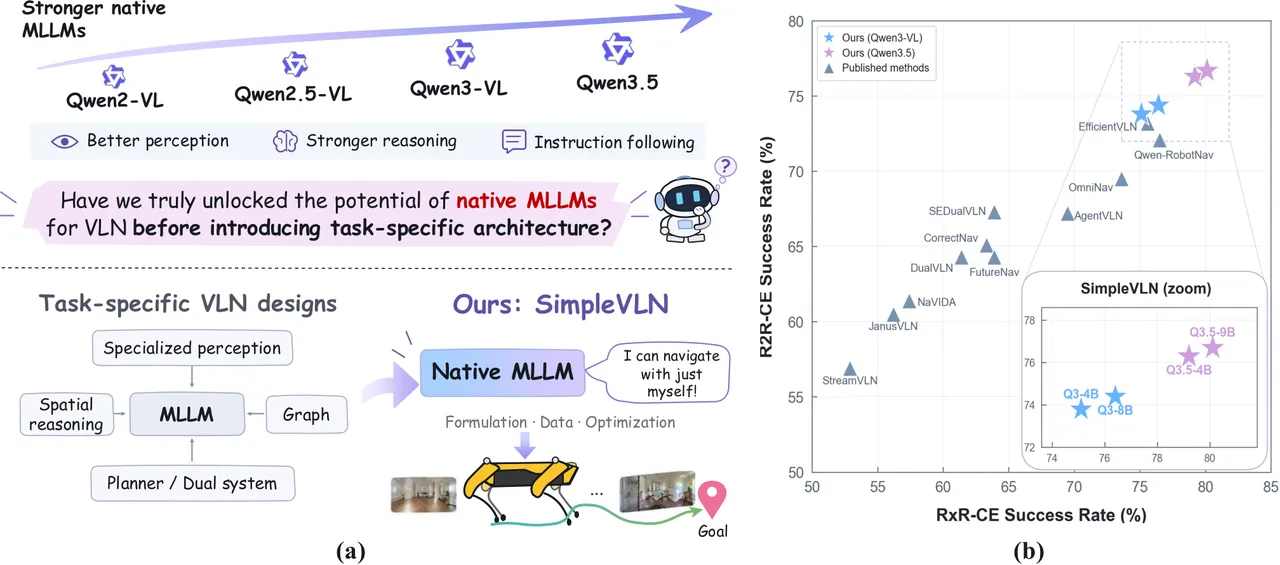
图1:论文 Figure 1。(a) 动机——增强型 MLLM 系统的成绩里混着骨干与任务模块两份贡献,原生 MLLM 的导航能力始终没被单独量过;(b) 在 R2R-CE 与 RxR-CE val-unseen 上与现有方法的成功率对比,SimpleVLN 只用单目 RGB 就把两个基准同时推到最前。
结论先行:这套「只改接口、数据与目标」的做法在两个基准上都超过了带全景、深度或双系统的现有方法,而且换骨干就能白拿增益——同一套流程从 Qwen2.5-VL 3B 的 51.6% 一路推到 Qwen3.5-9B 的 76.7%。这正是保留架构的实际红利:模型升级不需要重新设计导航系统。
预备知识
VLN-CE 的设定与指标。环境是 Matterport3D 的真实室内扫描,跑在 Habitat 上。动作空间被离散成 $\mathcal{A}=\{\text{Forward}(0.25\,\text{m}),\ \text{TurnLeft}(15^{\circ}),\ \text{TurnRight}(15^{\circ}),\ \text{Stop}\}$;执行 Stop 或用完基元动作预算 $S_{\max}$ 时 episode 结束,停在目标 3 m 以内算成功。五个指标各管一件事:NE 是最终位置到目标的直线距离(越小越好),OS 是轨迹上是否曾经进入成功半径,SR 是成功率(本文的主指标),SPL 用「参考路径长度 / 实际路径长度」惩罚绕路,nDTW 衡量与参考路径的形状相似度。SPL 与 SR 的差因此能读出「到了但走得很浪费」。
「保留架构」的严格含义。SimpleVLN 用的是现成 MLLM(Qwen2.5-VL / Qwen3-VL / Qwen3.5),通过 OpenAI 兼容的 chat 接口访问,服务端是 vLLM。一次决策就是一次多图对话请求:系统提示 + 指令文本 + 若干 base64 JPEG 帧,返回一段文本,文本里解析出动作。除权重之外,整个系统只有 prompt 组织、图像采样与文本解析三部分,没有任何新增可学习模块——这也是它能直接吃现有推理栈、并随骨干升级而升级的原因。
三种训练范式的分工。模仿学习从专家轨迹学动作,代价是分布偏移:一旦策略犯错走到专家从未到达的状态,监督就失效了。DAgger 的解法是在策略自己诱导出的状态上补专家标注。RL 直接把任务级结果当信号,不再要求动作与参考序列一致。三者的监督粒度依次变粗、目标依次变真:从「这个动作对不对」,到「在我会走到的地方应该怎么做」,再到「任务到底成没成」。SimpleVLN 把它们串成一条递进流水线,而不是三选一。
方法详解
记号:把「环境步」和「决策步」分开
论文的第一处工程决定是重新定义时间轴。给定自然语言指令 $\mathcal{I}$,在第 $k$ 个基元环境步,agent 观测第一视角 RGB 图像 $x_k$ 并执行动作 $u_k\in\mathcal{A}$。但模型的调用节奏不是 $k$,而是决策步 $t=1,2,\dots$:设 $n_t$ 为决策 $t$ 之前已执行的基元动作数($n_1=0$),则当前观测是 $o_t=x_{n_t}$,一次决策可能对应多个基元步。整个表述层都建立在 $t$ 上,这也是后面动作块与记忆预算能自洽的前提。
单轮决策输入:每步重建,不累积对话
最反直觉的一条是:SimpleVLN 不把新观测和上一轮预测追加到既有对话里。每次决策都从零构造一轮独立输入,内容只有指令 $\mathcal{I}$、当前观测 $o_t$ 和采样出的视觉历史 $H_t$;此前的对话轮次与已执行动作一概不进上下文。作者把这一轮的视觉部分记作 $s_t=(o_t,H_t)$。
理由在消融里给得很直接(表 3(b)):多轮累积只有 35.7% SR,单轮重建是 53.6%,差 17.9 个点。作者的解读是,虽然多轮对话保留了更完整的交互历史,但不断追加观测与动作会造出过长的上下文,而当前的 MLLM 并不能有效地把它用于导航。换句话说,「记得更多」在这类模型上不等于「用得更好」;把上下文压成一个固定形状的决策快照,反而更容易被利用。
全局-局部记忆:固定预算下压缩历史
既然历史不进对话,就必须另有去处。到决策 $t$ 之前,基元步观测序列 $(x_0,\dots,x_{n_t-1})$ 会随交互不断增长:全留则输入爆炸,只留最近几帧则丢掉早先的路线上下文。SimpleVLN 用两个互补的时间尺度表示历史——局部历史保近期连续性,全局历史稀疏覆盖更早的观测:
$$L_{t}=(x_{k})_{k=\max(0,\,n_{t}-N)}^{\,n_{t}-1},\qquad m_{t}=\min\{M,\ \max(0,\,n_{t}-N)\} \tag{1}$$ $$G_{t}=(x_{i_{j}})_{j=1}^{m_{t}},\qquad H_{t}=G_{t}\,\|\,L_{t}$$其中 $\|$ 是序列拼接,$L_t$ 取紧邻 $o_t$ 之前至多 $N$ 帧,$G_t$ 从更早的历史里均匀采样至多 $M$ 帧。当 $m_t>0$ 时,被采样的下标满足 $0\leq i_{1}<\dots<i_{m_{t}}<\max(0,n_{t}-N)$。关键性质是预算固定:无论 episode 走了 40 步还是 400 步,进入模型的帧数上界都是 $M+N+1$,上下文长度不随时间增长。这与流式上下文方案(StreamVLN 那类)解决的是同一个问题,但用的是「重采样」而不是「压缩编码」。
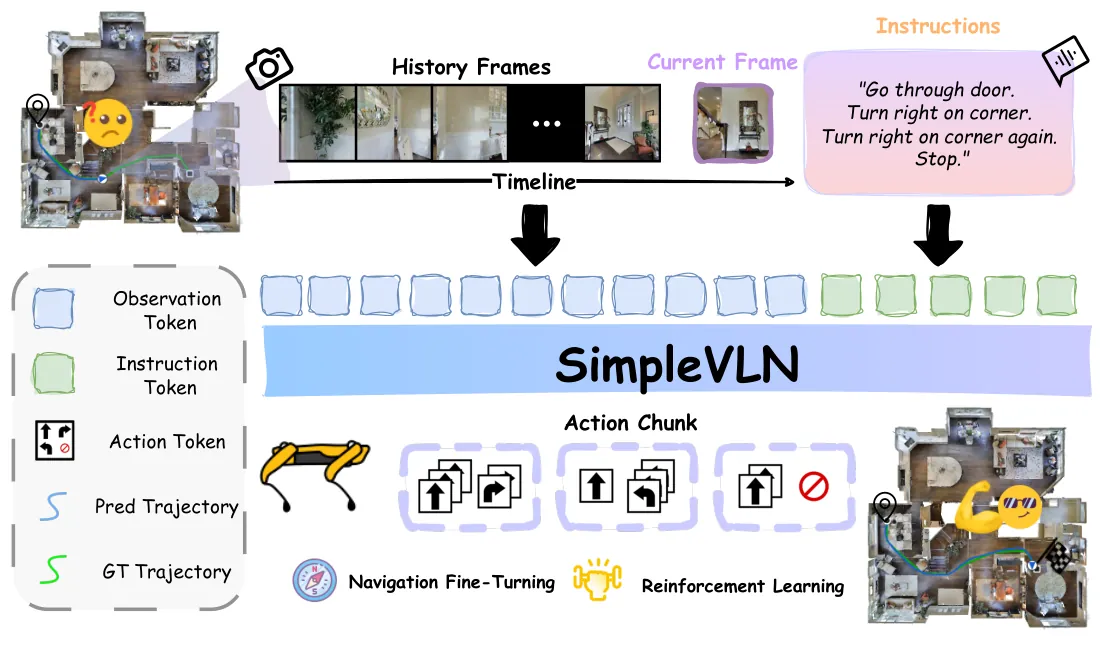
图2:论文 Figure 2,SimpleVLN 总览。每次决策把采样出的历史帧、当前观测与指令组成一轮输入交给 MLLM,模型直接预测一个动作块用于导航——中间没有任何新增模块。
预算取多少不是拍脑袋,是扫出来的(Figure 4)。固定 $N=1$ 扫 $M$:SR 在 $M=8$ 处见顶,之后随全局预算继续增大而下降,说明过多的全局历史引入冗余或不相关的观测,把有用的上下文稀释掉了。固定 $M=8$ 扫 $N$:只留 1 帧局部历史最好,再多邻近帧基本是重复信息。于是默认配置定为 $M=8$、$N=1$——至多 8 帧全局 + 1 帧局部 + 当前观测,共 10 帧。
动作块:一次决策说多个动作
输出侧同样换了表示。SimpleVLN 沿用 NaVIDA 的做法,让一次决策预测一个动作块 $a_t$,即一段有序的基元动作序列。设块内基元动作数为 $K_t$,则 $a_{t}=(u_{n_{t}},\dots,u_{n_{t}+K_{t}-1})$,策略写作
$$a_{t}\sim\pi_{\theta}\big(\cdot\mid\mathcal{I},s_{t}\big)=\pi_{\theta}\big(\cdot\mid\mathcal{I},o_{t},H_{t}\big)$$其中 $\pi_\theta$ 就是那个原生 MLLM。环境按顺序执行块内动作,每步产生一张观测并全部留存,供后续构造历史;块执行完才再次调用模型,除非 Stop 或基元预算 $S_{\max}$ 提前终止 episode。这条设计有两层收益:调用频率下降是显然的,但消融(表 3(a))显示它同时是更好的输出表示——基元动作每次只预测一个,SR 45.6%;换成动作块升到 53.6%,净增 8.0 个点。作者据此明确把它当作表示层的改进,而不只是省算力。
数据构造:演示、纠偏、合成三条来源
专家演示覆盖。把 R2R、RxR 与 ScaleVLN 的轨迹池化以拓宽专家行为覆盖,并且逐条转换成与推理接口一致的决策级样本:输入 $(\mathcal{I},s_t)$,目标是相应的专家动作块 $a_t^{\star}$。训练接口与推理接口同形,这一点决定了后面 DAgger 与 RL 的数据能直接混进来。
策略相关经验(DAgger)。更广的演示并不消除专家轨迹与策略实际访问状态之间的分布差。作者用一个基于偏离度的 DAgger 策略:把当前策略轨迹与真值(GT)轨迹比较,偏离大时取专家轨迹,否则保留策略轨迹;选中的轨迹同样转成决策级样本,与演示数据聚合。这是表 4 里最大的单项增益(R2R-CE +7.5 SR、RxR-CE +8.1 SR),说明「在模型自己会走到的地方给监督」比「再多看一些专家路线」更值钱。
RL 任务合成。到了 RL 阶段,复用监督学习已经用过的那批 episode 既扩展不了任务分布、也给不出真正新的交互经验,所以作者在训练场景里合成新任务:从导航图中采样位于不同房间的起点-终点对,终点绑定带语义标注的物体;再由一个 MLLM 根据参考路径的 waypoint(转弯、房间、显著物体、第一视角视图)生成导航指令。参考路径只用于构造任务,不作为动作目标;val-unseen 场景被排除在外。这条管线让 RL 的数据量不再受人工标注上限约束。
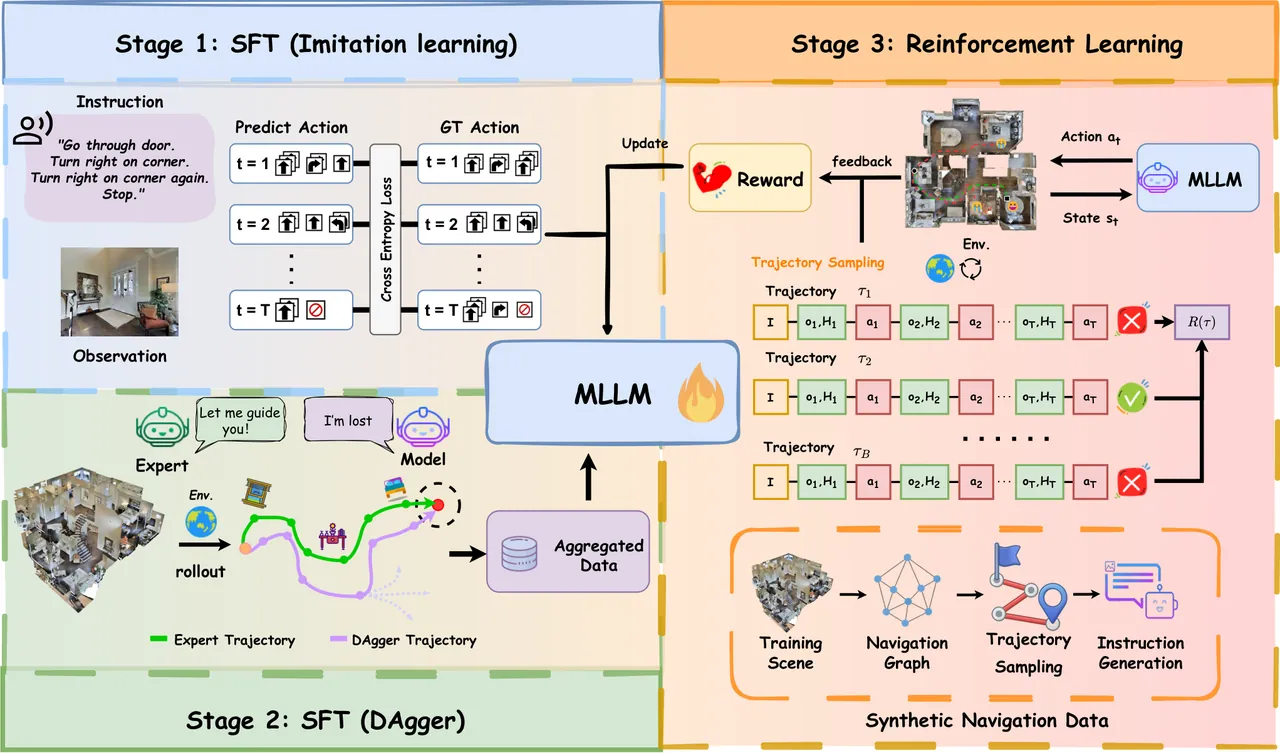
图3:论文 Figure 3,训练数据管线。先从专家演示学,再通过 DAgger 收集并聚合纠偏轨迹;RL 阶段由采样的起点-终点路径与生成的指令合成导航 episode,然后通过环境交互与结果反馈优化策略。
渐进优化:从模仿动作到优化结果
第一段,模仿学习。设监督数据集 $\mathcal{D}$ 由三元组 $(\mathcal{I},s_t,a_t^{\star})$ 构成,目标是最小化整段目标动作块的负对数似然:
$$\mathcal{L}_{\mathrm{SFT}}=-\mathbb{E}_{(\mathcal{I},s_{t},a_{t}^{\star})\sim\mathcal{D}}\Big[\log\pi_{\theta}\big(a_{t}^{\star}\mid\mathcal{I},s_{t}\big)\Big] \tag{2}$$注意这里对整个块取似然,而不是逐基元动作独立加权——这与动作块的输出表示是配套的。第二段,DAgger 适配。目标函数 $\mathcal{L}_{\mathrm{SFT}}$ 一字不改,变的只是 $\mathcal{D}$:加入上一节选出的策略相关轨迹所对应的目标动作块。第三段,强化学习。策略在合成 episode 上与环境交互,逐决策预测动作块,形成轨迹
$$a_{t}\sim\pi_{\theta}\big(\cdot\mid\mathcal{I},s_{t}\big),\qquad \tau=\big((s_{t},a_{t})\big)_{t=1}^{T} \tag{3}$$这里 $T$ 是 episode 终止前实际的模型级决策数,与基元动作预算 $S_{\max}$ 不是一回事。奖励取二值的任务级形式,成功判据沿用第 3.1 节的停止与距离条件:
$$R(\tau)=\mathbb{I}(\mathrm{success})\in\{0,1\},\qquad \max_{\theta}\ \mathcal{J}_{\mathrm{RL}}(\theta)=\mathbb{E}_{\tau\sim p_{\theta}}\big[R(\tau)\big] \tag{4}$$二值奖励的含义值得展开:它不要求轨迹与任何参考动作序列一致,任何走成功的路线都拿满分。对导航这种「同一句指令存在多条合理走法」的任务,这比形状化奖励更少引入人为偏好;论文的实验也支持这一点(表 6:SPL 奖励 68.9 → 二值成功奖励 70.1,R2R-CE SR)。学习信号因此完成了三级跳:专家动作监督 → 策略相关监督适配 → episode 级任务完成反馈。
训练配置。骨干用 Qwen3-VL(4B/8B)与 Qwen3.5(4B/9B)。IL 阶段在 R2R 与 RxR 上 SFT 3 个 epoch,视觉编码器冻结,峰值学习率 $2\times10^{-5}$;随后在收集到的 DAgger 数据上训 1 个 epoch,再在与 ScaleVLN 的混合上训 2 个 epoch。主结果的 RL 用 DAPO 跑 40 步,batch size 256、每个 prompt 16 条 rollout、学习率 $1\times10^{-6}$、KL 系数 0、clip 比例 0.30/0.20。RL 只有 40 步却能带来 7.5 至 10.2 个点的 SR 提升,是这篇论文里性价比最高的一段。
方法↔源码对照
公开仓库只有评测侧,但恰好把表述层的三条设计全部落成了可读代码。对照一:全局记忆的均匀采样。论文式 (1) 里 $G_t$ 的「至多 $M$ 帧均匀采样」,在 eval/vln/eval.py 里就是一个带端点的等距下标函数,调用点把 $M$ 写死成 8,且刻意排除当前帧(rgb_list[:-1]):
# eval/vln/eval.py:168
def uniform_sample_with_ends(self, data, n):
    if len(data) <= n:
        return data
    indices = [round(i * (len(data) - 1) / (n - 1)) for i in range(n)]
    return [data[i] for i in indices]

# eval/vln/eval.py:312,329  单轮重建 + 全局 8 帧 + 当前观测
self.conversations = self.conversations[:1]          # 只留 system 消息
content.extend([{"type": "image_url", ...} for item in
                self.uniform_sample_with_ends(self.rgb_list[:-1], 8)])
content.append({"type": "image_url", ...encode_image_base64(self.rgb_list[-1])})
self.conversations[:1] 这一行就是「单轮决策输入」的全部实现:每步把对话裁回只剩系统提示(SYSTEM_PROMPT = "You are a visual language navigation model."),再重新拼一轮 user 消息。观测缓冲的固定预算由 --max-action-history(默认 10)执行——超出就丢最旧的一帧,正好等于 $M+N+1=8+1+1$。
对照二:动作块的解析与展开。模型输出是逗号分隔的子动作文本,extract_multi_result() 按 ', ' 切分,extract_result() 先剥 <answer>...</answer> 再按关键词判定 stop / forward / left / right,并从文本里正则抓一个数值当作幅度。带量纲的输出(例如「forward 0.75」「left 30」)随后被展开成基元动作,每种最多 3 步:
# eval/vln/eval.py:344-368
select_action_idx = 2
result = result[:select_action_idx]                # 只取块的前两个子动作
for action_index, numeric in result:
    if action_index == 1:                          # forward
        for _ in range(min(3, round(numeric / self.forward_distance))):
            self.pending_action_list.append(1)
    elif action_index == 2:                        # turn left
        for _ in range(min(3, round(numeric / self.turn_angle))):
            self.pending_action_list.append(2)
    if action_index is None or len(self.pending_action_list) == 0:
        action_index = random.randint(1, 3)        # 解析失败时随机兜底
        self.pending_action_list.append(action_index)
待执行动作排在 pending_action_list 里,act() 每步弹出一个;队列非空时不调用模型——这正是论文所说「块执行完才再次查询 MLLM」。对照三:环境常量。eval/config/vln_r2r.yaml 里 forward_step_size: 0.25、turn_angle: 15、success_distance: 3.0、max_episode_steps: 400、RGB 640×480 / hfov 90,逐条对上第 3.1 节的动作空间与成功判据。配置里虽然定义了 depth 传感器,agent 只读 observations["rgb"],与「仅单目 RGB」的说法一致。
flowchart TB
    subgraph LOOP["Decision loop at inference - architecture unchanged"]
        E["Habitat primitive step k
egocentric RGB x_k"] --> B["Observation buffer
drop oldest beyond max_action_history = 10"]
        B --> G["Global memory G_t
8 frames uniform with ends"]
        B --> L["Local memory L_t
N = 1 recent frame"]
        I["Instruction I"] --> C["Rebuild single-turn context
system prompt + I + G_t + L_t + o_t"]
        G --> C
        L --> C
        C --> M["Native MLLM pi_theta via vLLM
no extra encoder, no memory module"]
        M --> A["Action chunk a_t
comma separated sub-actions"]
        A --> P["Parse and expand
first 2 sub-actions, at most 3 primitives each"]
        P --> Q["pending_action_list"]
        Q --> X["Execute Forward 0.25 m / Turn 15 deg / Stop"]
        X --> E
    end
    subgraph TRAIN["Progressive optimization IL - DAgger - RL"]
        D1["Expert demos pooled
R2R + RxR + ScaleVLN"] --> S1["Stage 1 IL
SFT on full chunk likelihood, 3 epochs, frozen vision encoder"]
        S1 --> D2["Deviation-based DAgger
policy trajectory vs GT trajectory"]
        D2 --> S2["Stage 2 DAgger SFT
same loss, 1 epoch then 2 epochs with ScaleVLN"]
        SY["Task synthesis
start-goal pairs in train scenes + MLLM instructions"] --> S3["Stage 3 RL
DAPO 40 steps, batch 256, 16 rollouts"]
        S2 --> S3
        S3 --> RW["Binary reward R = 1 if stopped within 3 m else 0"]
        RW --> S3
    end
    S2 -. IL-DAgger checkpoint .-> M
    S3 -. RL weights .-> M
图4:本文方法的两条回路(依据论文第 3.2–3.4 节与公开评测代码绘制)。上半是推理时的决策回路:缓冲→全局/局部采样→单轮重建→原生 MLLM→动作块解析→顺序执行;下半是训练时的三段递进,IL 与 DAgger 共用式 (2) 的似然目标,RL 换成式 (4) 的二值结果奖励。虚线表示权重交付关系。
实验结果
评测在 Matterport3D + Habitat 上进行,报告 R2R-CE 与 RxR-CE 的 val-unseen 分割,指标为 NE、OS、SR、SPL 与 nDTW,以 SR 为主。表 1 是主对比:SimpleVLN 只用单目 RGB,就在两个基准上同时超过了使用全景、深度或双系统的方法。
| 方法 | 规模 | 观测 | R2R NE↓ | R2R SR↑ | R2R SPL↑ | RxR SR↑ | RxR nDTW↑ |
|---|---|---|---|---|---|---|---|
| NaVid | 7B | 单目 RGB | 5.47 | 37.4 | 35.9 | 23.8 | — |
| Uni-NaVid | 7B | 单目 RGB | 5.58 | 47.0 | 42.7 | 48.7 | — |
| NaVILA | 7B | 单目 RGB | 5.22 | 54.0 | 49.0 | 49.3 | 58.8 |
| StreamVLN | 7B | 单目 RGB | 4.98 | 56.9 | 51.9 | 52.9 | 61.9 |
| JanusVLN | 7B | 单目 RGB | 4.78 | 60.5 | 56.8 | 56.2 | 62.1 |
| NaVIDA | 3B | 单目 RGB | 4.32 | 61.4 | 54.7 | 57.4 | 67.0 |
| DualVLN | 7B | 单目 RGB | 4.05 | 64.3 | 58.5 | 61.4 | 70.0 |
| CorrectNav | 7B | 单目 RGB | 4.24 | 65.1 | 62.3 | 69.3 | 75.2 |
| SEDualVLN | 7B | 单目 RGB | 3.75 | 67.3 | 62.5 | 63.9 | 72.8 |
| AgentVLN | 3B | RGB + 深度 | 3.88 | 67.2 | 64.7 | 69.5 | 74.6 |
| OmniNav | 3B | 全景 | 3.74 | 69.5 | 66.1 | 73.6 | — |
| Qwen-RobotNav | 8B | 全景 | 3.53 | 72.1 | 66.6 | 76.5 | 72.5 |
| Efficient-VLN | 8B | 单目 RGB | 3.29 | 73.2 | 65.0 | 75.6 | — |
| SimpleVLN† Qwen2.5-VL | 3B | 单目 RGB | 5.70 | 51.6 | 44.9 | 50.3 | 57.6 |
| SimpleVLN† Qwen3-VL | 4B | 单目 RGB | 4.26 | 65.4 | 58.8 | 63.4 | 66.5 |
| SimpleVLN* Qwen3-VL | 4B | 单目 RGB | 3.39 | 73.8 | 66.7 | 75.1 | 71.5 |
| SimpleVLN* Qwen3-VL | 8B | 单目 RGB | 2.93 | 74.4 | 69.5 | 76.4 | 77.4 |
| SimpleVLN* Qwen3.5 | 4B | 单目 RGB | 2.79 | 76.3 | 72.3 | 79.2 | 80.3 |
| SimpleVLN* Qwen3.5 | 9B | 单目 RGB | 2.63 | 76.7 | 72.6 | 80.1 | 79.8 |
表1:R2R-CE 与 RxR-CE val-unseen 主对比(据论文 Table 1 精选,† 为 RL 前、* 为 RL 后)。观测列区分单目 RGB / RGB+深度 / 全景——SimpleVLN 全部行都只用单目 RGB,无里程计、无深度。NE 单位为米,其余为百分比。
三点值得从表里读出来。第一,传感器不是差距来源:用全景的 Qwen-RobotNav 8B 拿 72.1,用深度的 AgentVLN 3B 拿 67.2,而 SimpleVLN 的 4B 版(73.8)已经超过 Efficient-VLN 8B(73.2),9B 版把 R2R-CE 推到 76.7、RxR-CE 推到 80.1。第二,RL 在每个骨干上都一致有效:Qwen3-VL 4B 从 65.4 升到 73.8(R2R-CE)、63.4 升到 75.1(RxR-CE);仓库给出的四个 RL 模型统计口径是 R2R-CE 提升 7.5–10.2 点、RxR-CE 提升 11.7–16.1 点。第三,骨干升级直接兑现成导航成绩:同一套流程从 Qwen2.5-VL 3B 的 51.6 走到 Qwen3.5-9B 的 76.7,中间没有任何结构改动——这是「保留架构」最实在的收益。
| 方法 | 规模 | 单次决策延迟 (ms)↓ | R2R-CE SR↑ | RxR-CE SR↑ |
|---|---|---|---|---|
| StreamVLN | 7B | 300 | 56.9 | 52.9 |
| DualVLN | 7B | 683 | 64.3 | 61.4 |
| JanusVLN | 7B | 906 | 60.5 | 56.2 |
| FutureNav | 4B | 1141 | 65.4 | 60.9 |
| SimpleVLN(Qwen3-VL) | 4B | 293 | 73.8 | 75.1 |
表2:推理延迟与性能(论文 Table 2)。同一块 NVIDIA A100 上测,只计一次动作块决策的模型执行时间,不含预处理、环境执行与其它非模型开销。
延迟这一栏的意义在于「便宜不等于将就」。293 ms 与流式基线 StreamVLN 的 300 ms 相当,比双系统的 DualVLN(683 ms)快 2.3 倍、比 FutureNav(1141 ms)快 3.9 倍,同时 SR 高出 8.9 至 16.9 个点。原因不神秘:上下文是固定 10 帧的单轮输入,preill 长度不随 episode 增长;输出是几个词的动作块,decode 很短;而且一次决策能驱动最多 6 个基元步,摊到每步的推理成本更低。
| 消融组 | 变体 | NE↓ | OS↑ | SR↑ |
|---|---|---|---|---|
| 动作格式 | 基元动作(每决策 1 个) | 5.2 | 54.5 | 45.6 |
| 动作块(默认) | 5.5 | 61.2 | 53.6 | |
| 对话格式 | 多轮累积 | 5.9 | 55.2 | 35.7 |
| 单轮重建(默认) | 5.5 | 61.2 | 53.6 | |
| 观测采样 | 只采样块边界 | 6.1 | 55.2 | 46.3 |
| 保留全部基元帧 | 5.8 | 57.5 | 51.9 | |
| 均匀采样 8 帧全局(默认) | 5.5 | 61.2 | 53.6 |
表3:表述层三组消融(论文 Table 3(a)(b)(c)),均为 Qwen3-VL 4B 在 R2R 上微调、在 R2R-CE val-unseen 上评测;加粗为 SimpleVLN 的默认设计。观测采样里的「8 帧」只覆盖全局历史,不含局部帧与当前观测。
表述层的三组消融是全文信息密度最高的部分。单轮重建对多轮累积的 +17.9 SR 是最大的单项差距,说明当前 MLLM 在长对话式导航上下文里的利用效率很差;动作块的 +8.0 SR 则排除了「它只是省调用次数」的解释。观测采样一组尤其有意思:只采样块边界(46.3)不如保留全部基元帧(51.9),而均匀采样 8 帧全局历史(53.6)比「全都留着」还高 1.7 个点——更多的观测在这里是噪声,不是信息。
| R2R | RxR | ScaleVLN | DAgger | R2R NE↓ | R2R OS↑ | R2R SR↑ | R2R SPL↑ | RxR SR↑ | RxR SPL↑ | RxR nDTW↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| ✓ | 5.53 | 61.2 | 53.6 | 48.1 | 50.3 | 42.0 | 57.6 | |||
| ✓ | ✓ | 5.28 | 63.4 | 56.7 | 51.3 | 54.5 | 46.7 | 62.4 | ||
| ✓ | ✓ | ✓ | 4.90 | 68.4 | 57.9 | 50.9 | 55.3 | 48.1 | 63.6 | |
| ✓ | ✓ | ✓ | ✓ | 4.26 | 74.3 | 65.4 | 58.8 | 63.4 | 54.1 | 66.5 |
表4:演示与 DAgger 数据消融(论文 Table 4),Qwen3-VL 4B,R2R-CE 与 RxR-CE val-unseen。
数据侧的账也算得清。加 RxR 让 R2R-CE SR 从 53.6 到 56.7、RxR-CE 从 50.3 到 54.5,是域内增益;再加 ScaleVLN 到 57.9 与 55.3,主要改善对未见环境的泛化;而 DAgger 一步就带来 R2R-CE +7.5、RxR-CE +8.1,是表 4 里最大的一项,同时 NE 从 4.90 降到 4.26、OS 从 68.4 升到 74.3——说明它修的不是「偶尔走对」,而是「少跑偏」。
| RL 配置 | R2R NE↓ | R2R OS↑ | R2R SR↑ | R2R SPL↑ | RxR SR↑ | RxR SPL↑ | RxR nDTW↑ |
|---|---|---|---|---|---|---|---|
| RL 前基线 | 4.26 | 74.3 | 65.4 | 58.8 | 63.4 | 54.1 | 66.5 |
| 合成场景池:仅 R2R | 3.91 | 74.0 | 68.5 | 63.2 | 65.8 | 55.3 | 68.3 |
| 合成场景池:仅 RxR | 3.76 | 71.8 | 67.5 | 59.3 | 68.5 | 59.5 | 68.8 |
| 合成场景池:仅 ScaleVLN | 4.17 | 70.9 | 66.6 | 61.3 | 66.3 | 56.2 | 67.3 |
| 合成场景池:R2R + RxR + ScaleVLN | 3.74 | 73.1 | 70.1 | 65.6 | 71.0 | 62.1 | 68.4 |
| GRPO + SPL(τ) 奖励 | 3.80 | 73.9 | 68.9 | 63.1 | 67.7 | 58.3 | 67.3 |
| GRPO + 二值成功奖励 | 3.74 | 73.1 | 70.1 | 65.6 | 71.0 | 62.1 | 68.4 |
| DAPO + 二值成功奖励 | 3.45 | 76.6 | 71.5 | 65.3 | 73.7 | 64.0 | 69.4 |
表5:RL 数据与配置(合并论文 Table 5 与 Table 6),Qwen3-VL 4B。场景池各行与两行 GRPO 均为 batch 32、每 prompt 8 条 rollout;主结果配置用的是 DAPO、batch 256、每 prompt 16 条 rollout。
RL 部分给出三条可操作结论。其一,合成任务的场景来源要混:三个池单独用分别到 68.5 / 67.5 / 66.6(R2R-CE SR),混合后 70.1、RxR-CE 71.0,都比 RL 前基线高。其二,奖励越简单越好:SPL 形状奖励 68.9,二值成功奖励 70.1(RxR-CE 67.7 → 71.0),支持「只问任务成没成」。其三,优化器有可观影响:奖励固定为二值时,DAPO 到 71.5 / 73.7,GRPO 是 70.1 / 71.0。训练动力学(论文 Figure 5)也一致:rollout 奖励与评测 SR 整体上行,而每条轨迹的平均决策数逐步下降——RL 不只让 agent 更准,还让它更果断,用更少的模型调用走完同样的路。
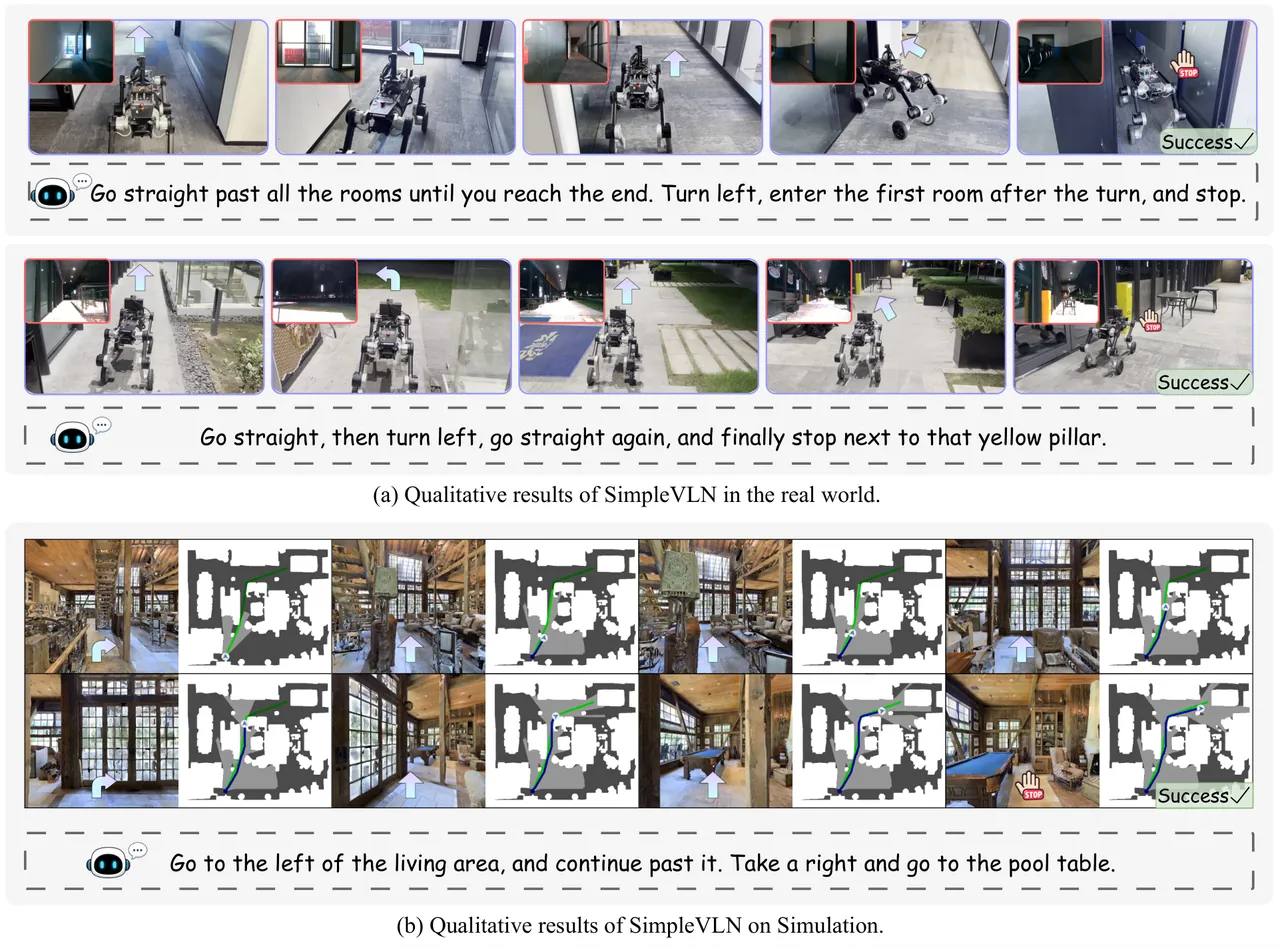
图5:论文 Figure 6,仿真与真实环境中的 SimpleVLN。它跟随多条不同指令抵达指定目标,箭头表示导航方向。
真机部分给出了从仿真到硬件的一条完整链路:模型跑在 Daystar 四足机器人上,算力是机载的 NVIDIA Jetson Thor,感知用 Intel RealSense D450 RGB-D 相机,但只取 RGB 通道作为观测。论文报告它能跟随包含前进、转向、进入房间与按地标停止的多步指令,并在较长轨迹上保持连贯的指令跟随行为。对一个 0.25 m / 15° 的离散动作空间来说,能在机载算力上闭环本身就是一个不小的工程结论——它意味着这套方法不依赖离线大图卡。
局限性
作者自述之一:记忆预算是非单调的,最优点靠扫参得到。Figure 4 显示固定 $N=1$ 时 SR 在 $M=8$ 见顶后随全局预算增大而下降,作者的解释是过量全局历史引入冗余或不相关观测、稀释有效上下文;固定 $M=8$ 时多留局部帧也没有收益。这说明「多看」在这套输入组织下不成立,但论文只给了一个经验最优点,没有给出随场景尺度、指令长度或 episode 长度自适应调整预算的规则——换一个建筑规模分布不同的环境,$M=8$ 是否仍然最优是未知的。
作者自述之二:RL 的增益不能单独归给优化算法。表 6 里 DAPO 对 GRPO 的 +1.4 / +2.7 SR 是在 batch 32、每 prompt 8 rollout 的消融设置下测的,而主结果用的是 batch 256、16 rollout。作者明确写道「我们并不把这一增益单独归因于优化算法」。也就是说,DAPO 更好这个结论与它的具体超参耦合,不能直接搬走。
作者自述之三:真机评测只有定性证据。第 4.6 节只给 Figure 6 的成功案例与方向箭头,没有真机成功率、指令条数、失败模式统计,也没有机载推理时延——表 2 的 293 ms 是 A100 上的数字,Jetson Thor 上一次决策要多久、能否跟上四足步态,论文没有回答。
我的判断之一:缺一条骨干基线,而它正是论文标题里那个问题的答案。全文反复问「原生 MLLM 的潜力是否已被榨干」,但没有报告 Qwen3.5-9B 或 Qwen3-VL-4B 在零样本、少样本或仅提示词条件下的 VLN 成绩。缺了这一行,读者能算出的只有「这套流程把 SFT 起点推到 76.7」,算不出「骨干自己值多少、流程贡献多少」。对一篇以归因为动机的论文来说,这是最明显的实验缺口。
我的判断之二:公开仓库与论文数字之间有明确的复现距离,且 harness 里有论文未描述的行为。训练脚本、RL 任务合成管线、DAgger 的偏离度阈值、ScaleVLN 的混合比例都未公开。评测代码里还有三处论文正文没有提到的处理:动作块被硬截断到前 2 个子动作(select_action_idx = 2),每个子动作最多展开 3 个基元(min(3, round(numeric/forward_distance))),以及解析失败时 random.randint(1, 3) 随机选一个动作兜底。前两条意味着公开 harness 里 $K_t$ 实际上被限制在 6 以内,与论文「块内动作数 $K_t$」的一般化描述不完全一致;第三条会在 SR 里掺入一小部分不可归因的随机成功。仓库未声明 license,也让二次使用有法律上的不确定。
我的判断之三:只用单目 RGB 是卖点,也是没有被消融过的天花板。论文通过与「用全景/深度的方法」横向比较来论证不需要额外传感器,但没有纵向做「SimpleVLN + 深度」或「SimpleVLN + 里程计」的对照(配置里 depth 传感器其实是开着的,只是 agent 不读)。因此严格说,结论是「在现有方法面前,单目 RGB 已经够用」,而不是「额外通道不会带来收益」。在长走廊、重复纹理、光线突变这些单目尺度估计最吃力的场景里,NE 的进一步下降大概率还是要靠几何信息。
总结与展望
SimpleVLN 把 VLN 的瓶颈从「结构」搬到了「接口、数据与目标」三处,并且证明这三处单独就足够。表述层给出的两条工程结论最容易被复用:每步重建一个固定形状的单轮上下文,优于把历史累积成长对话(35.7 → 53.6 SR);均匀采样的少量全局帧优于保留全部帧(51.9 → 53.6 SR,且延迟不随 episode 增长)。数据层的结论是 DAgger 的边际收益超过继续堆演示(+7.5 / +8.1 SR)。优化层的结论是二值成功奖励优于 SPL 形状奖励,而 RL 只需要 40 步就能换来 7.5 至 10.2 个点。
对做机器人导航的团队,这篇论文的可迁移价值不在 76.7 这个数字,而在它给出的一条低成本路径:保留骨干架构意味着可以直接吃 vLLM 这类推理栈、可以直接随模型发布节奏升级(Qwen2.5-VL 3B 的 51.6 到 Qwen3.5-9B 的 76.7 之间没有任何结构改动),也可以把同一套「单轮上下文 + 动作块」接口搬到操作或其它长程任务上。要补的三件事同样清楚:把骨干自身的基线测出来,把训练与任务合成代码放出来,以及把真机评测从「展示成功轨迹」升级为「报告成功率与时延」。