Skip to content
← 标签

#Qwen (10)

图像生成设计与前端梯顶C

Qwen-Image-2.1:一套开放权重同时做生成、局部编辑与透明输出
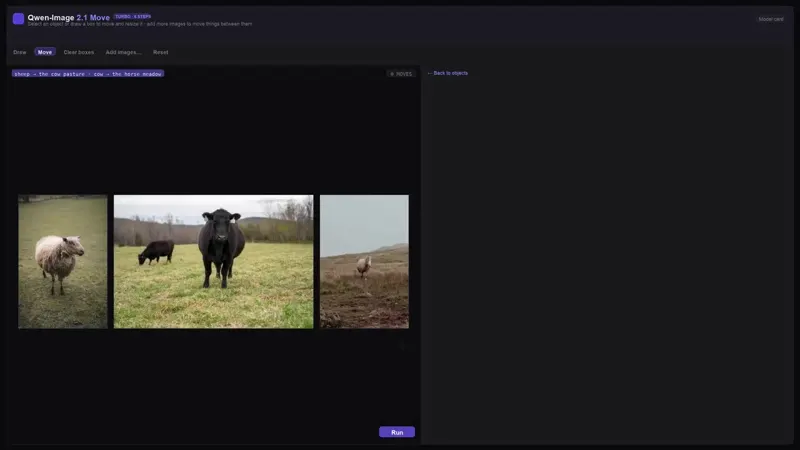
阿里 Qwen 的图像生成与编辑一档,把文生图、局部编辑(圈选/涂抹/独立 mask)、最多 10 张参考图融合与原生 RGBA 透明输出收进同一个 7B 视觉生成组件(32 层 Single-Stream DiT),并用混合粒度注意力与前缀 KV 缓存复用压低批量出图的边际成本;原生 2048px、7 档宽高比。它是当前可下载权重里图像竞技场排位最靠前的一档(文生图第 17 / Elo 1228,图像编辑第 16 / 1367),但许可是 Qwen Research License 而非 Apache-2.0,商用前必须单独读条款,diffusers 还需从 git 主干安装。未做基准复现,置信度记 C(厂商宣称)。

7B视觉生成组件参数厂商宣称 · 2026-09
产品阿里 Qwen (Alibaba)官网Repo
Qwen-Image-2.1:一套开放权重同时做生成、局部编辑与透明输出
SimpleVLN:不改架构释放原生多模态大模型的视觉语言导航能力

SimpleVLN:不改架构释放原生多模态大模型的视觉语言导航能力

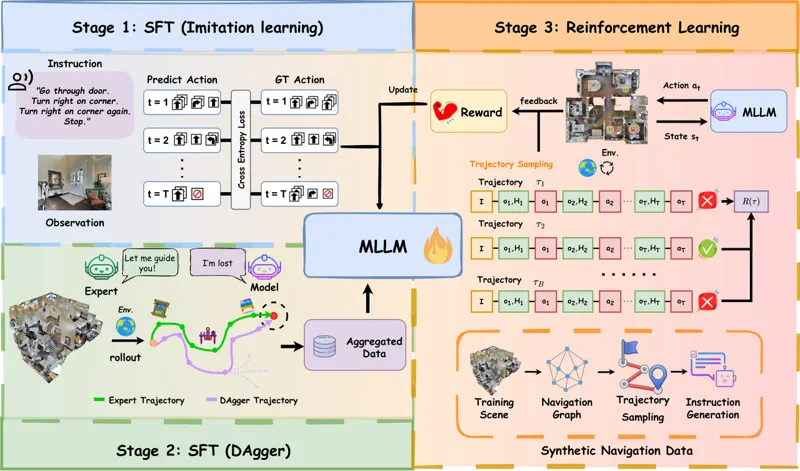
视觉语言导航(VLN)要求具身智能体把自然语言指令落到第一视角观测上并完成长程决策。现有方法大多靠任务专用结构补能力——全景拼接、3D 几何编码器、双系统分层决策——因此很难判断成绩里有多少来自 MLLM 本身。SimpleVLN 把问题反过来问:在引入任何任务专用模块之前,原生 MLLM 的导航潜力是否已经被榨干? 它的回答分三层。表述层:每次决策都重新构造一轮独立输入,即指令 + 当前观测 + 固定预算的全局-局部历史(默认全局 8 帧均匀采样、局部 1 帧),不再累积成越来越长的多轮对话;输出侧用动作块,一次推理给出多个基元动作(前进 0.25 m、左右转 15 度、停止)依次执行。数据层:R2R、RxR、ScaleVLN 的专家演示转成决策级监督样本,基于偏离度的 DAgger 在策略自己走到的状态上收集纠偏轨迹,RL 任务则在训练场景里自动合成新的起点-终点与指令。优化层:IL 到 DAgger 再到 RL 三段递进,RL 只用二值成功奖励(停在目标 3 m 内记 1 分),主结果用 DAPO 训 40 步。 只用单目 RGB、不改一行网络结构,Qwen3.5-9B 版在 R2R-CE 与 RxR-CE 的 val-unseen 上分别拿到 76.7% 与 80.1% 成功率,超过依赖全景、深度或里程计的现有方法;单次动作块决策耗时 293 ms。消融显示单轮输入把成功率从 35.7% 抬到 53.6%,DAgger 再贡献 7.5 与 8.1 个点。评测代码与八个权重已开源,并在 Daystar 四足机器人(Jetson Thor 机载)上完成真实环境验证。

Lingyi Hong, Weiren Cai, Jiayu Chen · 282次阅读 · 2026年10月16日
视觉语言导航具身智能
2026年10月16日
ReST-RL:用统一自训练与价值引导搜索强化大模型推理

ReST-RL:用统一自训练与价值引导搜索强化大模型推理

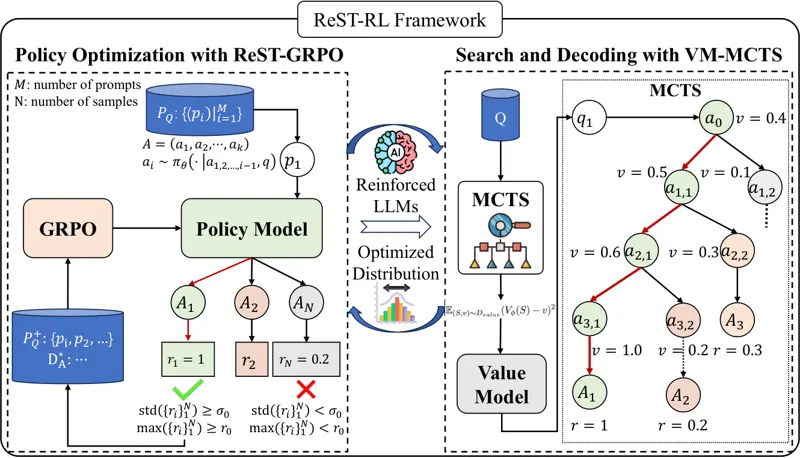
GRPO 是当前提升大模型推理能力的代表性强化学习方法,但它只在整条轨迹末端拿到一个稀疏奖励:一旦同组采样得到的奖励彼此接近,组内相对优势就退化成噪声,策略几乎学不到东西。ReST-RL 把策略优化与价值引导搜索重新接回同一条自训练流水线。第一阶段 ReST-GRPO 先按奖励标准差过滤掉信息量低的提示词,再从每个提示词的最高奖励轨迹中按离散指数分布抽取若干前缀,把它们当作在线 GRPO 的新起点——前缀只作为上下文,后缀一律重新采样并优化,而不是拿来模仿。第二阶段 VM-MCTS 在这个已静态化的策略下用 MCTS 自采价值目标,训练一个预测期望终端奖励的价值模型,推理时同一个模型既用于 UCT 搜索分配,也用于最终 Best-of-N 排序,搜索与验证共享同一套状态价值尺度。在 APPS、BigCodeBench、HumanEval 等代码基准上,Qwen3-8B 的平均分从 0.503 提升到 0.689;在匹配策略与价值模型的对照实验里,ReST-GRPO + VM-MCTS 在 APPS-500 上得到 0.642,而 GRPO + VM-MCTS 只有 0.538,说明第一阶段带来的轨迹分布改善确实穿过了价值学习环节存活下来。端到端算力核算上,ReST-GRPO 用 1752 GPU 小时对 GRPO 的 2080 小时,在 71 小时而非 207 小时达到 9% 的提升。仅用代码轨迹训练出的价值模型,在不做目标域微调的情况下迁移到 MATH、Omni-MATH 与 GPQA-Diamond 同样带来增益。

Sining Zhoubian, Dan Zhang, Jie Tang · 744次阅读 · 2025年8月27日
强化学习GRPO
2025年8月27日

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。