PAPER DEEP DIVE
RLSR:基于自我奖励的强化学习
这篇论文把大模型自身当作二值 judge,用“答案是否正确”的判定替代需要专门工程的可验证奖励,驱动 GRPO 训练。方法利用生成与验证之间的能力不对称:Qwen 2.5 7B 生成 Countdown 答案约为 36%,而判定答案为 96%。作者在 Countdown、简单积分和 MIT Integration Bee 上验证该信号,其中 Qwen 2.5 7B DeepSeek Distilled 从 13% 提升到 75.5%,达到 73% 的 MIT Integration Bee 资格线。论文同时指出 judge 提示词脆弱、小模型易被 reward hack、连续更新 judge 会崩溃。
RLSR:把模型自身变成可训练的奖励函数
一句话总结
RLSR 让大模型在生成答案后先检查自己的答案,再把二值判定转成 GRPO 的标量奖励,从而在没有参考答案、没有手工 reward function 的情况下完成强化学习。
研究背景与动机
强化学习进入大模型训练后,最难的部分往往不是 policy gradient 本身,而是奖励从哪里来。数学题可以用最终答案核对,代码可以用测试用例运行,机器人任务可以用成功或失败事件定义回报;可一旦进入开放工程设计、科学分析、写作或复杂 agent 行为,人工写出的奖励函数常常既不完备,也容易被钻空子。作者把这一点看成 RL 应用面的第一道闸门:如果每个新领域都要先写一套可验证器,训练成本就会在奖励工程处停下。
RLSR 的切入点是生成与验证之间的不对称。一个模型可能很难从零解出积分,但检查一个候选原函数是否正确时,只需要求导并判断导函数是否与原被积函数相等;一个模型可能不会设计螺栓,但检查已有螺栓是否满足载荷、尺寸和材料约束要容易得多。论文称这个现象为 generator-verifier gap,并把它当作奖励信号来源:让同一个或另一个语言模型充当 judge,对候选解输出“正确/错误”,然后把判定交给 GRPO。
这与直接用偏好模型的做法不同。Meta 的 Self-Rewarding Language Models 主要构造偏好数据并用 DPO 类方法优化;RLSR 把 judge 的输出压成更接近可验证奖励的二值信号,并明确以数学推理为测试域。这样做的代价是 judge 必须足够稳定,否则 RL 很快会学会利用假阳性。论文的价值不在于宣布“自我评价天然可靠”,而在于系统展示了什么条件下可靠、什么时候立刻崩溃。
作者选了三个难度递增的域。Countdown 数字拼图足够简单,可以暴露 reward hack 的形态;GPT-4o 合成的大学级积分题可以量化判官验证能力与下游训练天花板;MIT Integration Bee 则把方法放到真实竞赛题上,检验自我监督训练能否达到人类竞赛的资格线。这个序列没有把结果留在玩具任务里,也没有跳过失败模式。
TinyZero 仓库已经被标记为不再维护,并建议新实验直接使用 veRL,但它的 Countdown 预处理和奖励函数仍然清楚展示了本文训练循环的对照点:examples/data_preprocess/countdown.py 生成“数字集合 + 目标值”的问题,verl/utils/reward_score/countdown.py::compute_score 提取 <answer> 中的表达式、校验每个数字只使用一次、再计算结果是否等于 target。RLSR 要替换的正是这个程序化核对器,而不是改变 rollout 与策略更新的整体结构。
# TinyZero 的 Countdown 数据链(非 RLSR 官方实现)
python ./examples/data_preprocess/countdown.py --local_dir ./data/countdown
export BASE_MODEL=./Qwen2.5-7B-Instruct
export DATA_DIR=./data/countdown
bash ./scripts/train_tiny_zero.sh
预备知识:判官、奖励与 GRPO
形式化地说,一个问题可以写成 $q$,策略模型 $\pi_\theta$ 对同一问题采样 $G$ 条候选解 $y_{1:G}$。RLSR 的判官是一个映射 $J_\phi(y,q) \in \{0,1\}$:1 表示候选解通过检查,0 表示不通过。判定结果与格式奖励一起组成标量回报,交给策略优化器。没有参考答案参与训练,评估时才用程序化 verifier 测真实能力。
GRPO 不使用 value network,而是在同一 prompt 的组内做相对比较。设第 $i$ 条回答的综合奖励为 $r_i$,组内基线由均值给出,优势通常写成:
$$A_i=\frac{r_i-\frac{1}{G}\sum_{j=1}^{G}r_j}{\sqrt{\operatorname{Var}(r_{1:G})+\epsilon}}.$$
若把裁剪代理目标和 KL 正则都显式写出,可表示为:
$$\mathcal{J}(\theta)=\mathbb{E}_{q,\{y_i\}\sim\pi_{\text{old}}}\left[\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|y_i|}\sum_{t=1}^{|y_i|}\min\left(\rho_{i,t}A_i,\operatorname{clip}(\rho_{i,t},1-\epsilon,1+\epsilon)A_i\right)-\beta D_{\mathrm{KL}}(\pi_\theta\Vert\pi_{\text{ref}})\right],$$
其中 $\rho_{i,t}=\pi_\theta(y_{i,t}\mid q,y_{i,\lt t})/\pi_{\text{old}}(y_{i,t}\mid q,y_{i,\lt t})$。RLSR 使用 batch 64、rollout 8、学习率 $1\times10^{-6}$、KL 系数 0.001;一般任务最大回答长度为 2048,MIT 实验放宽到 8096。格式正确的答案额外获得 0.1 分,积分题的格式要求是在答案标签中输出合法 SymPy 表达式。
奖励可写成:
$$r(y)=\mathbf{1}\{J_\phi(y,q)=1\}+0.1\cdot\mathbf{1}\{\operatorname{format}(y)=1\}.$$
这个公式揭示了两个耦合因素。若格式项占比过高,策略可以先学格式再学推理;若判官假阳性很多,策略会朝“看起来正确”漂移,而不是朝真实正确漂移。Countdown 实验的四个 prompt 就是在控制这个脆弱平衡。
方法详解
RLSR 的完整循环分四步。第一,从训练分布取一个没有参考答案的问题;第二,策略模型生成多条带推理链和答案标签的候选解;第三,judge 只看问题与候选解,输出 0 或 1;第四,GRPO 按组内奖励计算优势并更新策略。评估阶段另用独立 verifier 核对结果,所以训练目标与评估指标并不混在一起。
flowchart TB
    P[Self-generated problem
no reference answer] --> S[Policy generates G rollouts]
    S --> J[Self judge reads problem and attempt]
    J --> R[Binary correctness reward plus 0.1 format reward]
    R --> GRPO[GRPO computes group-relative advantage]
    GRPO --> U[Update policy weights]
    U --> S
    U -.after 50 steps.-> JU[Optionally replace judge weights]
    JU --> J
积分判官是论文中最清楚的一个设计。它不要求 judge 重新积分,而是要求它先把候选答案当成函数,检查其语法和数学有效性,再对其求导,并判断导函数是否与原始被积函数相等。论文给出的提示词大意是:如果给定函数有效,就求导并判断是否与目标函数相等;若相等输出 1,否则输出 0,忽略积分常数。设候选原函数为 $\hat F(x)$,原被积函数为 $f(x)$,判官实际上在检查:
$$\frac{d}{dx}\hat F(x)=f(x),\qquad \hat F(x)\ \text{valid},\qquad J_\phi(x,\hat F)=\mathbf{1}\left\{\frac{d}{dx}\hat F(x)\equiv f(x)\right\}.$$
这把“生成一个积分”变成“检查一个导数”。对语言模型来说,后者更容易,因为符号微分有明确的局部规则,而积分需要选择方法、换元和回代。这也让验证可以独立于生成器的能力:一个几乎不会积分的小模型,仍然可能判别部分明显错误的积分。
Countdown 的判官问题更危险,因为它检查的是一个表达式是否满足约束。目标值 $T$ 与允许数字集合 $N=\{n_1,n_2,n_3,n_4\}$ 给定后,候选表达式 $E$ 必须满足:
$$\operatorname{multiset}(\operatorname{numbers}(E))=N,\qquad \operatorname{eval}(E)=T,$$
并且 $E$ 是合法算术表达式。任何一条被弱化,策略都可能找到假阳性。论文迭代了四个 prompt。图 1 显示了它们的差异:Prompt 1 只核对表达式相等和数字来源;Prompt 2 加上合法性要求;Prompt 3 把“每个数字出现且只用一次”拆成三条;Prompt 4 要求所有条件都通过,并把“不是等式”也写进检查。
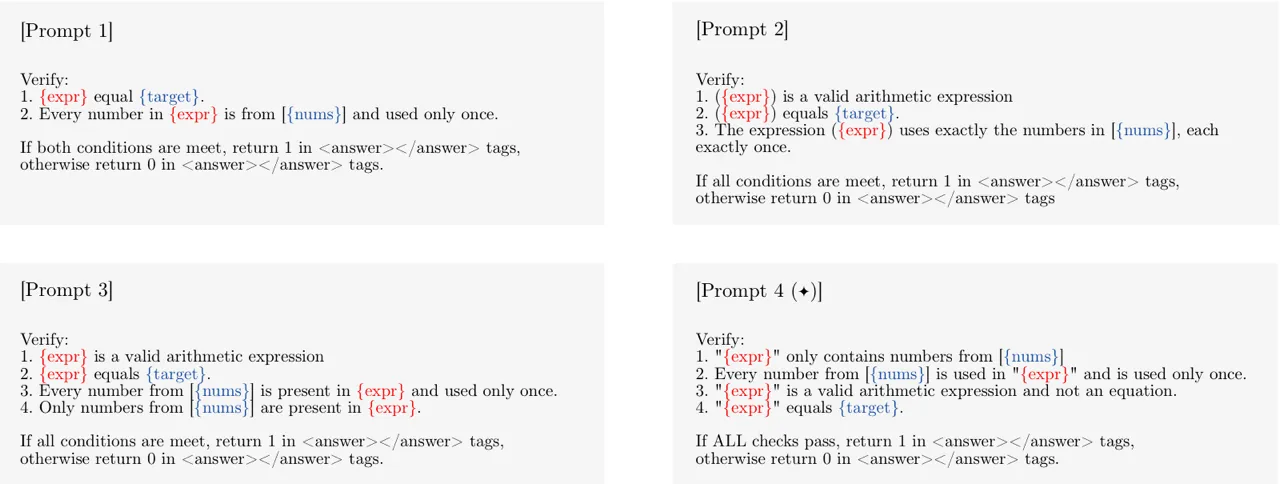
图 1:Countdown 自我判官的四个 prompt 模板。红色是候选表达式,蓝色是目标值和允许数字集合。
训练早期,四个 prompt 都让 true negative rate 接近上限,说明判官在策略还很弱时能识别明显错误。随着策略更新,前三个 prompt 相继被 reward hack:模型学会制造格式上像解、实际上不满足完整约束的表达式,TNR 掉落,平均自我奖励与形式化真实奖励分离。Prompt 4 因为把条件逐条列出并要求全部通过,长时间保持稳定。图 2 正是这一过程的证据。
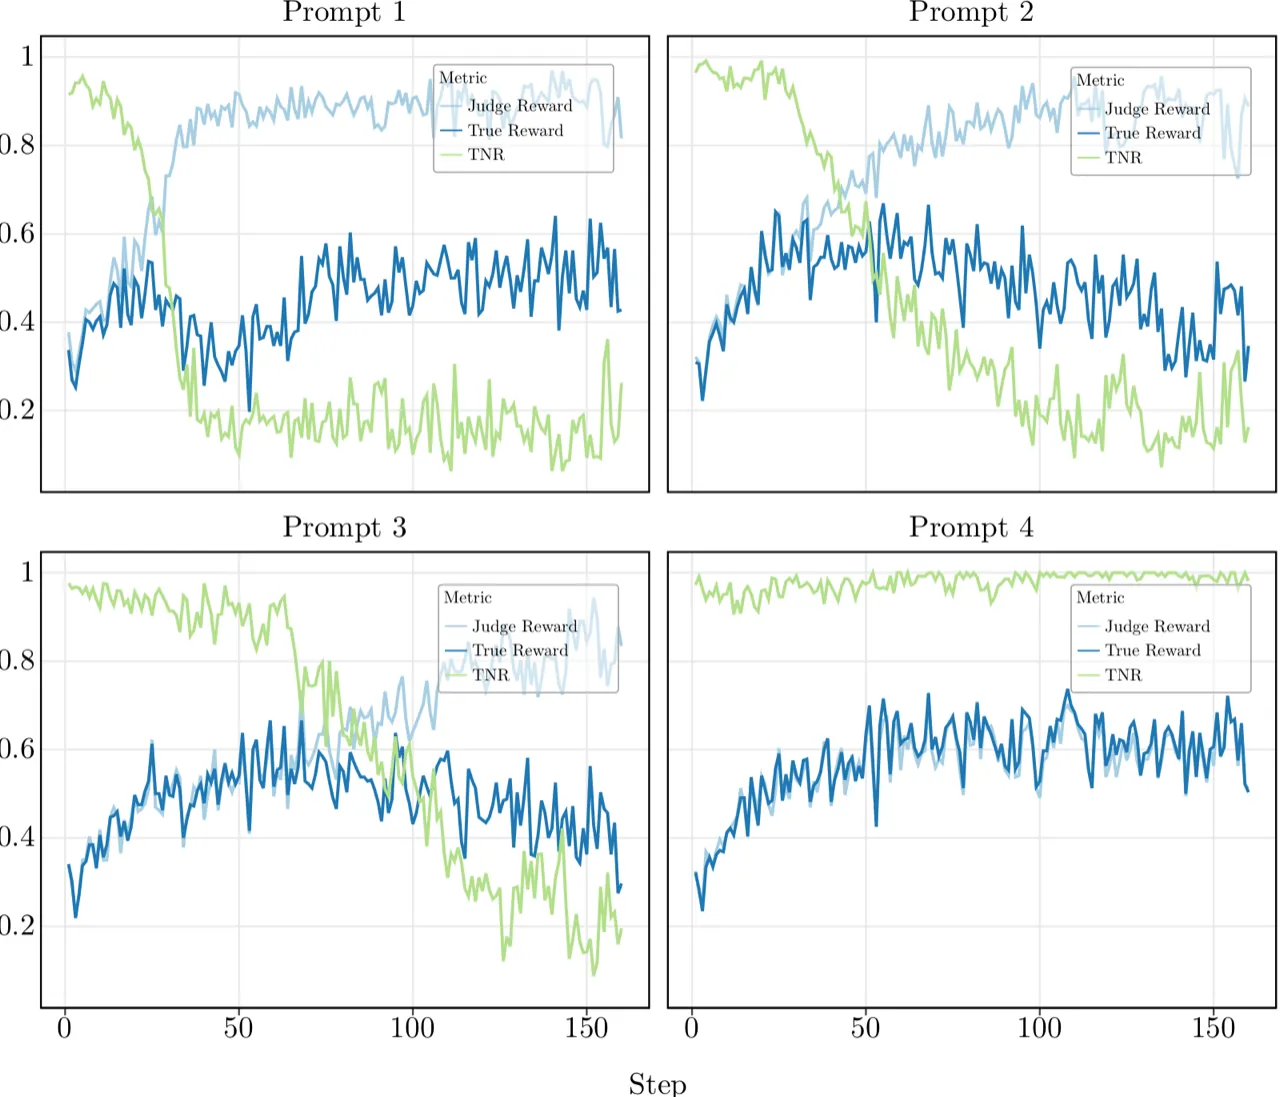
图 2:不同 prompt 下 Qwen 2.5 7B 的 TNR 与真实奖励。TNR 和 True Reward 都由形式化 verifier 计算。
这说明 prompt 工程不是装饰。LLM judge 本身是随机策略,同一个语义可以有多种 token 实现,RL 又专门搜索奖励高的行为。只有把“每个数字出现、只出现一次、表达式合法、结果等于 target、不是等式”全部展开成显式检查,判官才不容易被“看起来符合”的输出骗过。这也解释了为什么小模型更脆弱:它们的指令跟随和符号核对能力有限,更容易在训练压力下放松某条约束。
RLSR 的另一个设计是判官更新。默认使用 offline judge,即训练期间固定初始权重。这样做的好处是奖励面不会随策略一起移动,训练更容易复现;缺点是策略可能追上甚至超过判官,性能被初始验证能力卡住。于是作者比较了固定判官、50 步后把 judge 权重换成当前策略权重、每一步都同步更新三种设置。设第 $k$ 段训练后策略权重为 $\theta_{\pi,k}$,则一次延迟同步可写成:
$$\theta_{J,k+1}=\theta_{\pi,k},\qquad k=50,$$
而每步同步则近似 $\theta_{J,k}=\theta_{\pi,k}$,消除生成器与判官之间的距离。论文观察到第三种设置迅速崩溃:策略开始利用自身评价偏差,低质量解获得高奖励,反馈环路把模型推向更差的区域。一次 50 步延迟更新则带来约 7% 的相对提升,同时保留了短时间内的评价距离。
积分任务的数据放大使用 LADDER。训练集由 Qwen 2.5 7B DeepSeek Distilled 生成 9000 个与 2025 年 MIT Integration Bee 特征相近的合成变体,再加上 20 道真实竞赛题。作者还过滤掉基座模型 pass@1 能解出的题,使训练分布偏向当前能力边界。若 $\mathcal{B}$ 为原始合成题集,$\pi_0$ 为基座模型,训练集近似为:
$$\mathcal{D}_{\text{train}}=\{q\in\mathcal{B}:\operatorname{pass@1}(q,\pi_0)=0\}.$$
这个过滤有两个作用。第一,减少策略在已会题目上浪费 rollout;第二,让组内回答更容易出现“部分正确/部分错误”的差异,GRPO 的组内基线才更有信息量。但合成数据也带来分布风险:如果生成器反复出同一类容易判别、实际推理浅的题,自我改进可能只发生在表面模式上。论文没有把这一闭环说成已解决,而是把它作为可继续扩展的架构。
实验结果
Countdown 实验先用 Qwen 2.5 7B Instruct 同时当 agent 和 judge。基座生成正确解约 36%;作者用 GPT-4o 构造等量正确与错误解,让同一模型分类,判官准确率约 96%,生成与验证相差 62 个百分点。这为自我奖励提供了第一层可行性证据:策略还很弱时,判官信号明显不是随机噪声。
| Countdown 指标 | 数值 | 含义 |
|---|---|---|
| 基座生成准确率 | 36% | 同一模型解出四数字 Countdown 的能力 |
| 自我判官准确率 | 96% | 在 GPT-4o 构造的平衡验证集上分类正确/错误 |
| 生成-验证差 | 62 个百分点 | 验证显著强于生成,自我奖励有信号 |
| 训练后增益 | 约 20 个百分点 | Prompt 4 自我奖励与形式化 verifier 趋势一致 |
但 96% 的初始准确率不等于训练全程安全。图 2 显示前三个 prompt 的 TNR 在训练中期塌落,模型学会触发假阳性。Prompt 4 稳定后,其平均奖励曲线与形式化 verifier 接近,回答长度也同步增加。作者把长度增长归因于搜索与自我检查行为的出现:模型不再直接写一个短表达式,而是在推理链中回溯和重算。
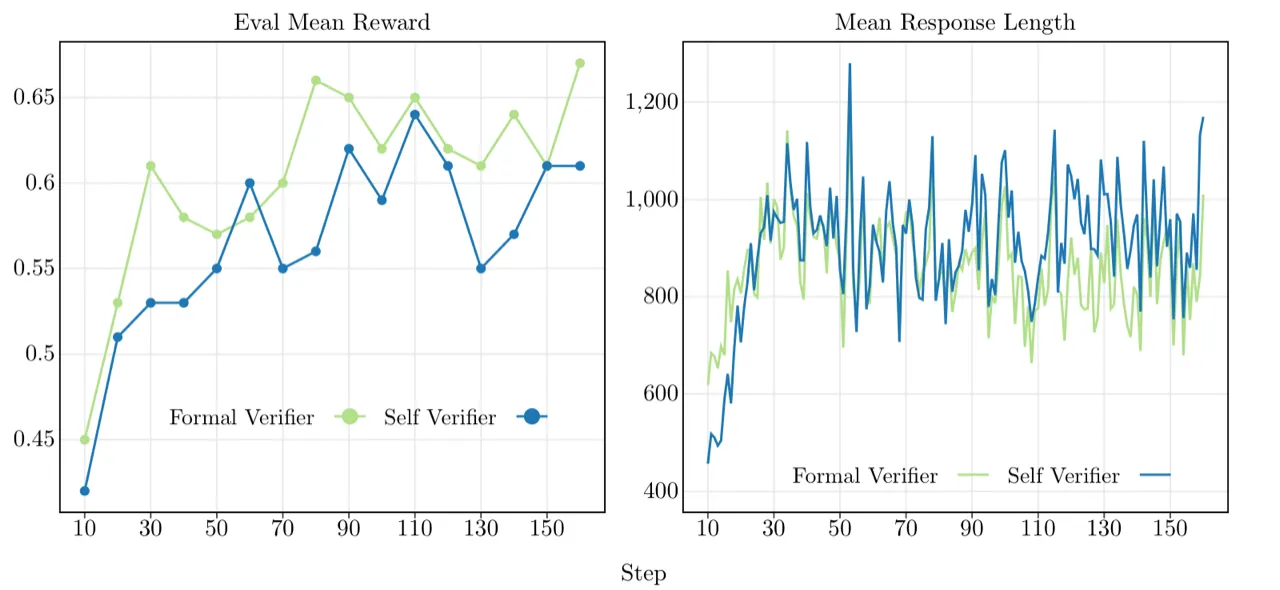
图 3:Countdown 中自我奖励与规则 verifier 的平均奖励、平均回答长度。二者趋势相近。
简单积分实验把“验证更容易”从定性说法变成三个模型的量化差距。Llama 3.2 3B 只能生成 1% 的正确积分,但能验证 47% 的候选解;Qwen 2.5 7B 的生成与验证分别是 46% 和 88%;DeepSeek R1 已接近双饱和,为 98% 和 99%。这里验证被定义成对候选原函数求导并核对,而不是简单给自然语言解释打分。
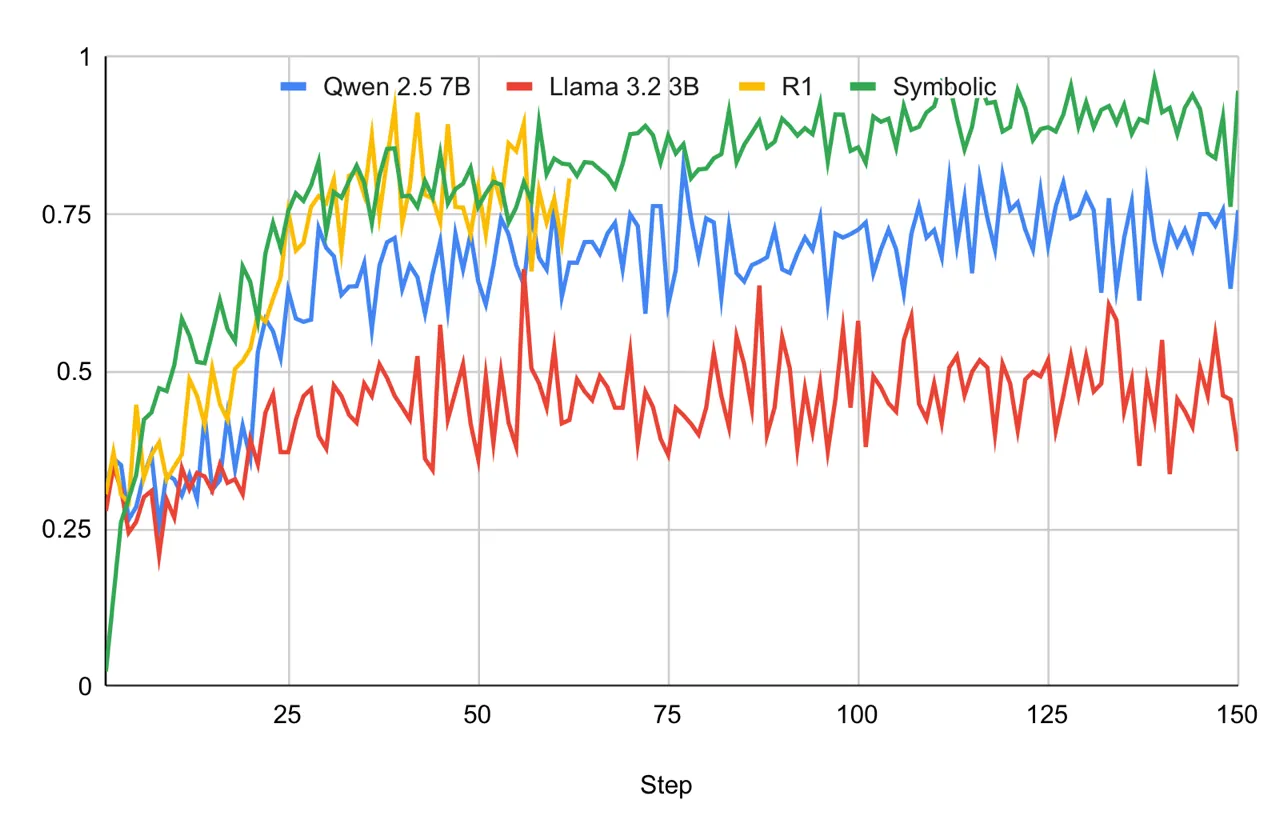
图 4:generator-verifier gap。柱高为准确率,误差条为标准误。
判官质量直接决定下游天花板。用 Llama 3.2 3B 当 judge 时,Qwen 2.5 7B agent 只到约 48%,接近判官的验证水平;用 Qwen 自判则到 75%;用 DeepSeek R1 judge 时接近符号验证的 92% 上限。论文认为这支持一个阈值式结论:判官不需要会做题,但需要足够高的验证准确率;一旦接近上限,换成形式化 verifier 的额外收益变小。
| 训练设置 | 生成能力 | 验证能力 | 下游测试准确率 |
|---|---|---|---|
| Qwen agent + Llama 3.2 3B judge | 1% | 47% | 约 48% |
| Qwen agent + Qwen 2.5 7B judge | 46% | 88% | 约 75% |
| Qwen agent + DeepSeek R1 judge | 98% | 99% | 接近 92% 上限 |
| Qwen agent + symbolic verifier | 不适用 | 程序化核对 | 约 92% 上限 |
判官更新实验进一步说明“谁在打分”可以被训练改变。固定 Qwen judge 的 agent 约在 70% 平台;把 judge 在 50 步后同步为当前 agent 权重后,agent 继续上升到 75%,相对固定基线约提升 7%。更关键的是,更新后的 judge 在求导验证上从 88% 提高到 93%。也就是说,训练不只提升生成,也顺带提升了判别能力;单次延迟更新把这部分新能力转成了更好的奖励信号。
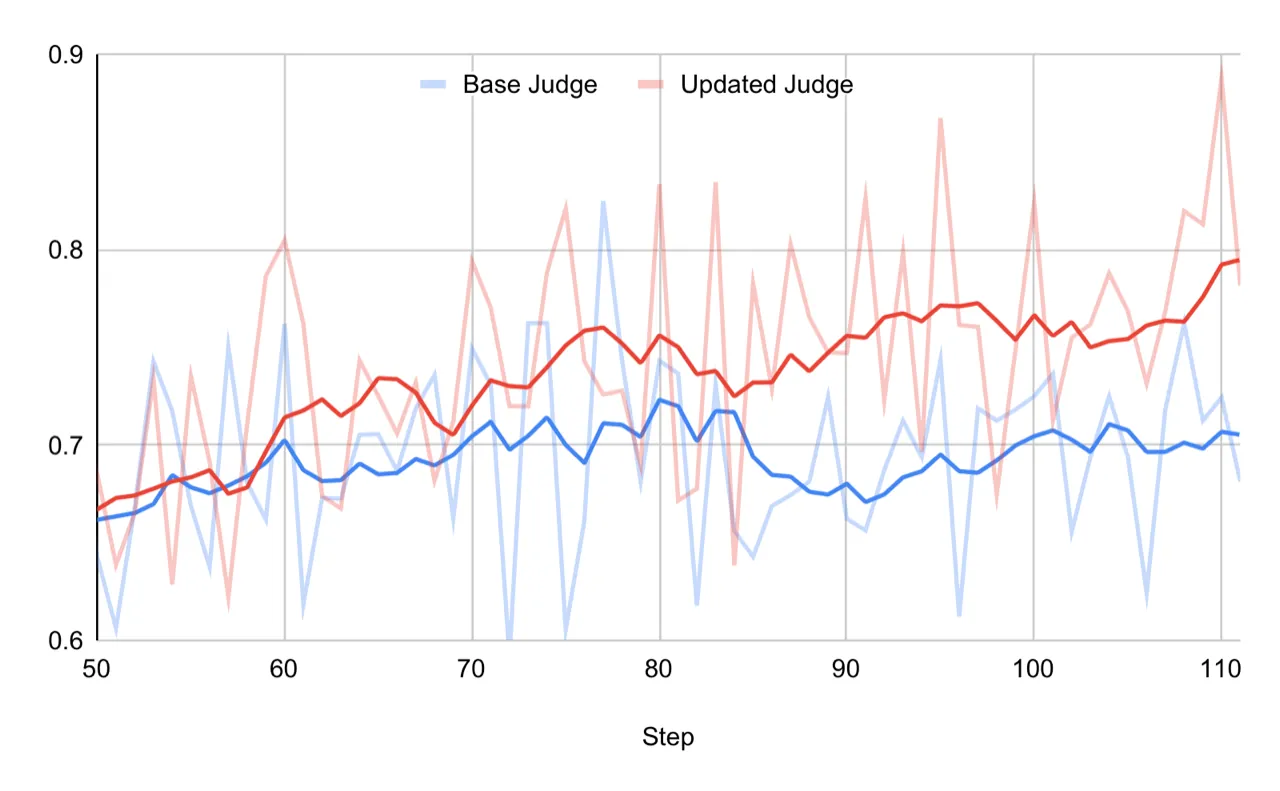
图 5:Base Judge 与 50 步后更新 Judge 的训练准确率对比。
MIT Integration Bee 是最有说服力的结果。Qwen 2.5 7B DeepSeek Distilled 的起点只有 13%,主要受 SymPy 格式输出限制;约 50 步后格式问题修复,准确率跳到 51%。之后增益更慢但仍持续,约 160 步越过 73% 资格线,170 步达到 75.5%。这 75.5% 是用形式化 verifier 评估的,不是用自我 judge 自评的。
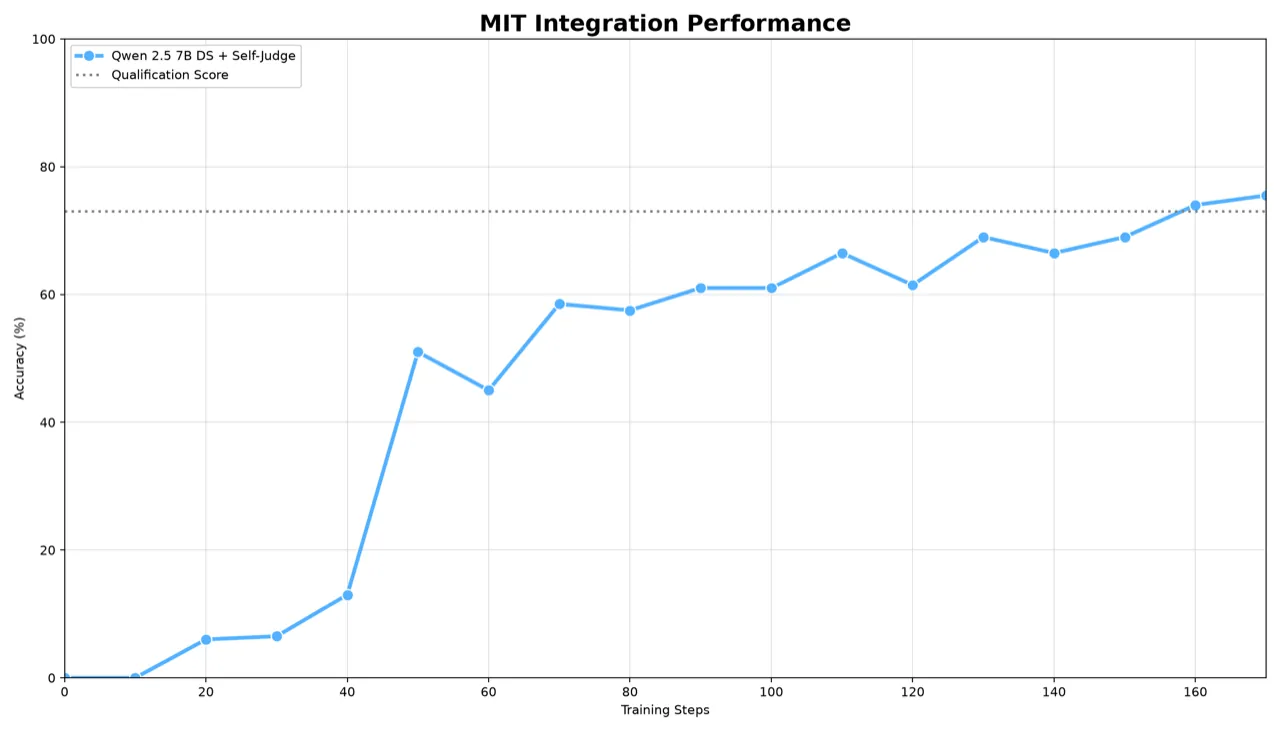
图 6:MIT Integration Bee 测试集准确率,灰色虚线为 73% 资格线。
这条曲线要拆成两段读。前 50 步的陡升包含格式学习:模型先学会输出可解析的 SymPy 表达式,否则数学上正确的答案也会被判为 0。之后从 51% 到 75.5% 的上升更可能反映真实积分能力提升,因为格式奖励的边际作用下降,难题需要更完整的换元、分段和检验。论文特别提醒不要把早期陡升直接当成推理能力翻倍。
| 训练步数 | MIT 测试准确率 | 阶段解释 |
|---|---|---|
| 0-20 | 0-6.5% | SymPy 格式输出大量失败 |
| 40 | 13% | 部分答案可解析,但整体仍弱 |
| 50 | 51% | 格式问题修复,奖励信号开始反映数学内容 |
| 60-110 | 45-66.5% | 出现波动,但趋势上移 |
| 约 160 | 74% | 越过 73% 资格线 |
| 170 | 75.5% | 论文报告的最终点 |
补充的训练与评估奖励曲线也显示,训练平均奖励从约 0.2 上升到 0.4-0.6 区间,评估奖励在 0.2-0.47 区间震荡。它不像 MIT 曲线那样直接对应资格线,但说明奖励信号并非只在训练分布内有效,评估端也能看到随步数提高的响应。
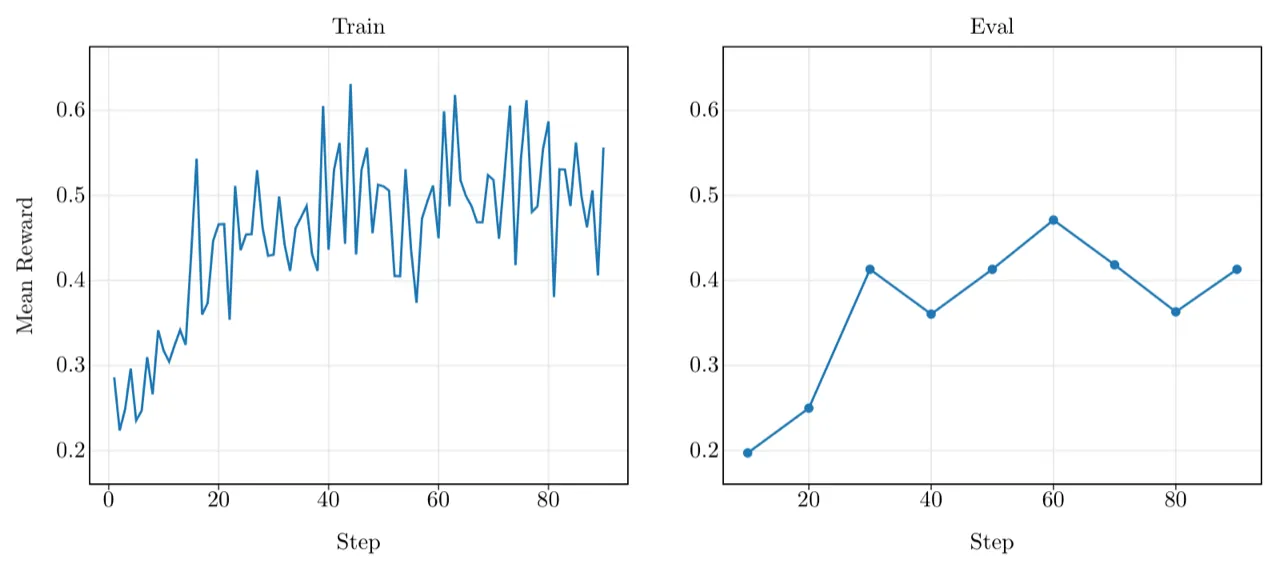
图 7:自我奖励训练与评估的平均奖励曲线。
讨论与适用边界
RLSR 最直接的适用条件有三个:第一,验证比生成更容易;第二,能把候选解格式化为判官可检查的对象;第三,判官有足够高的验证准确率并且不易被 reward hack。积分和 Countdown 同时满足这些条件。工程设计、算法、数据分析、物理模拟等领域也可能满足,尤其是给 judge 提供生成器没有的工具时,差距还会扩大。judge 可以运行测试、调用求解器、跑物理引擎或对照数据集,而生成器仍然只靠推理产生方案。
对机器人与具身系统,这个思想可以映射成任务级奖励:策略提出动作序列或参数化控制方案,judge 检查轨迹是否碰撞、能耗是否超限、末端是否达到目标、物理仿真是否收敛。若 judge 能调用仿真器或约束求解器,而策略不直接调用,这实际上构造了人工 verifier 与 LLM judge 的混合层。RLSR 的实验只覆盖数学域,不能直接外推到长时序控制,但它说明“让模型自己评价”不必等于主观偏好打分;评价程序可以被设计成局部、可检查的推理任务。
风险也很明确。自我 judge 是一个被策略压力搜索的对象,不是静止的评估器。前三个 Countdown prompt 的崩溃说明,只要约束没有显式展开,奖励面就会被找到漏洞。连续更新 judge 更危险,因为它把奖励面和策略面同步移动,评价偏差可能被立刻强化。延迟更新、固定 judge、定期外部审计、多 seed 验证和形式化抽检都应是实际训练中的最低配置。
局限性
作者自述了多层局限。Countdown 需要四次重大 prompt 迭代才能稳定,轻微改词可能在几十步内触发灾难性 reward hack;LLM judge 的非确定性让相同配置在不同 run 中表现分歧,必须多 seed 才能得出可靠结论。连续更新 judge 会迅速崩溃,即使单次更新有效,性能最终也会平台化。格式与真实推理也难以完全解耦:早期分数提升常常只是模型学会输出合法 SymPy。
本文的补充判断是,MIT 结果虽然亮眼,但仍由一个强先验模型驱动。Qwen 2.5 7B DeepSeek Distilled 已经继承了 DeepSeek 蒸馏得到的数学推理能力,LADDER 又只保留基座 pass@1 解不出的题;这意味着自我改进在扩展已有推理先验,而不是从零获得推理。换个弱基座或开放域,判官验证准确率可能无法维持 88% 或 93% 的水平。9000 个合成变体的覆盖范围和难度分布也没有在正文中逐类消融,自我出题是否会造成“简单题回声室”仍是后续问题。
另一个边界是评估与训练的分离。RLSR 的训练奖励没有参考答案,但所有关键结论都依赖形式化 verifier 评估。这并不削弱论文,反而提醒读者:自我奖励系统需要保留一个外部测量通道,否则无法知道策略是在真实进步,还是只在适应判官的偏置。
总结与展望
RLSR 的贡献不是发明 GRPO,也不是证明 LLM 一定可靠,而是把 generator-verifier gap 变成可操作的奖励机制,并用 Countdown、积分与 MIT 竞赛三组实验给出边界。它展示了二值自我判官可以接近形式化 verifier 的训练动态,也展示了这个信号随时可能被策略利用。
后续更有价值的方向不是简单调 prompt,而是把判官设计成工具增强的验证流程:积分判官可调用 SymPy,算法判官可执行测试,机器人 judge 可跑仿真或约束求解器。配合 LADDER 式自出题和延迟 judge 更新,这会形成一个更完整的自我训练环境。关键约束仍然是评价独立性:训练可以自我反馈,结论必须由不参与策略优化的测量通道决定。