PAPER DEEP DIVE
通过自我反馈强化学习对大语言模型进行后训练
大语言模型常给出看似合理但过度自信的答案,校准误差会削弱高风险推理场景的可靠性。本文提出自我反馈强化学习 RLSF:冻结模型生成多条思维链解码轨迹,以最终答案片段的模型置信度排序,自动构造偏好对,再用 PPO 或 DPO 后训练策略,无需人工偏好、标准答案或外部奖励。实验表明,RLSF 能改善算术推理和多选问答上的校准与准确率,并让一次贪心解码接近多路解码的可靠性;但收益依赖初始模型,部分准确率或校准指标仍可能回退。
作者:Carel van Niekerk、Renato Vukovic、Benjamin Ruppik、Hsien-chin Lin、Shutong Feng、Milica Gašić。论文链接:https://arxiv.org/abs/2507.21931。官方代码:https://github.com/carelvniekerk/ConfidentLLM,采用 Apache 2.0 许可证。本文解读依据的是 2026 年 9 月 15 日修订的第二版全文。
一句话总结
这篇论文把模型对最终答案 token 的置信度差距变成一种无需人工偏好标注的训练信号:先让同一个基础模型生成多条思维链,再按答案置信度排出优劣,最后用 PPO 或 DPO 把“更自信的推理路径”学回模型。它的真正价值是改善校准并消除推理时的多路解码成本,不能简单理解为所有基准上的准确率都会上升。
研究背景:答案看起来合理,但概率并不可信
大语言模型在算术题上经常能写出语法完整、步骤看似连贯的解答,却给出错误结果。更麻烦的是,语言模型给出的 token 概率并不自动等于事实正确率。一个模型说自己有九成把握时,读者会期待它在十次中答对九次;现实里,经过人类反馈对齐的模型可能语气更稳妥,内部概率却更加过度自信。论文把这种“置信度与实际正确率脱节”的现象视为可靠部署中的独立问题,而不是准确率的附带指标。
常见的偏好对齐方法主要优化人类喜欢什么回答。它们能改善指令遵循和表达方式,却并未直接约束概率校准。论文引用已有研究发现,这类对齐有时会让模型更会迎合,却更不擅长暴露不确定性。于是出现一个尴尬局面:模型越像一个好助手,用户越难判断它什么时候只是在流畅地猜。
另一条路线是思维链解码。给定一个问题,模型从第一个 token 开始分叉出若干候选,分别继续生成推理过程,再选择最终答案置信度最高的一条。已有工作观察到,蕴含清楚推理步骤的轨迹往往对应更高的答案概率。这个现象说明置信度不只是表面统计量,还可能携带“这条推理路径是否顺畅”的信息。
但思维链解码的成本直接取决于候选数。论文使用十路候选时,一次请求要付出接近十倍的生成代价。对离线评测也许可以接受,对在线系统则很难成为默认方案。作者抓住的矛盾是:既然高置信轨迹在训练阶段如此常见,能否把它们压缩成一次普通前向生成,而不是在每次推理时重复搜索?
预备知识:把文本生成写成序列决策
论文把自回归语言模型看成策略。初始状态是问题,动作是下一个词,状态随着已生成文本增长。若当前上下文为 $s_t$,选中词元 $a_t$,下一个状态可以用拼接表示:
其中 $\odot$ 在这里表示把新 token 接到上下文中,而不是逐元素乘法。该写法让语言生成能够直接嵌入强化学习框架,也解释了为什么 PPO 的轨迹、奖励和优势函数可以用于语言模型。
“思维链解码”的关键不是给提示词加一句“请一步步思考”,而是改变搜索空间。模型先保留首步概率最高的 $K$ 个 token,每个 token 各自成为一条路径的种子,之后按贪心方式继续生成。源码中的生成器先用束搜索返回 $K$ 个首 token,再分别续写,这与论文描述一致。
对一条答案跨度,论文不直接使用生成 token 的原概率,而是计算最高概率与次高概率之差。原因是原始概率会受词表分布影响:0.60 看似很高,但若第二名也有 0.55,模型其实在两个候选之间摇摆。概率差距把这个“只是略胜一筹”的情况暴露出来,更适合作为置信度信号。
方法详解:从候选轨迹构造自我偏好
第一步:从冻结模型生成十路候选
对于问题 $q$,模型在首步取概率最高的 $K$ 个 token,每个 token 引出一条独立的生成路径。令第 $k$ 个首 token 为 $w^k$,则:
随后每条路径用贪心解码补完整条思维链。论文的实验中固定 $K=10$,原因是已有研究显示继续增加候选数后收益趋于平台。此阶段模型参数冻结,不进行梯度更新;它只负责把自身已有的不同推理倾向展示出来。
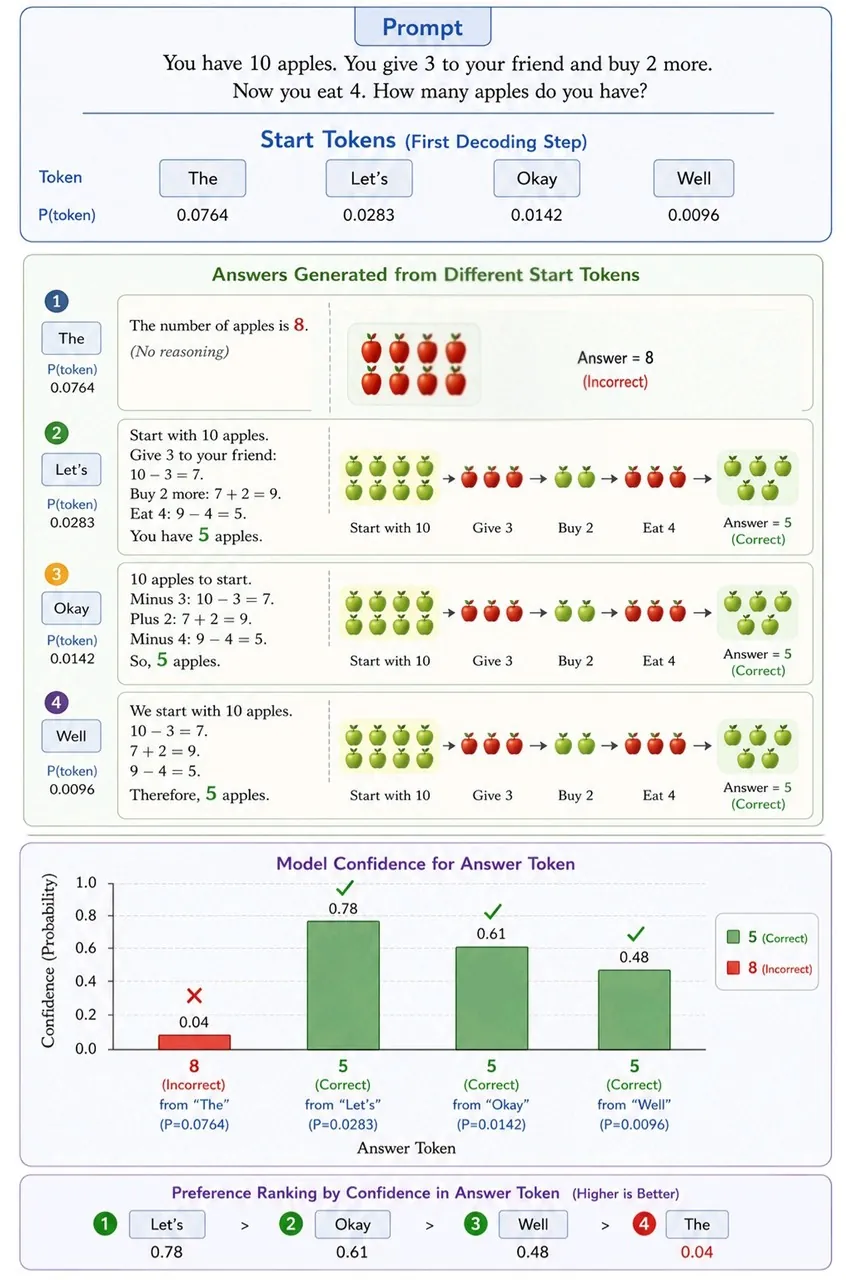
图 1:论文中的 RLSF 总览。同一问题产生多条候选路径,答案 token 的置信度用于排序,再把排序结果转为偏好训练数据。
图 1 也说明了一个容易忽略的设计:候选并不是随机采样出的十个完全不同回答,而是从首 token 分叉后各自贪心延续。这样既保留了起点多样性,又减少每一步随机采样带来的方差。代价是候选之间仍可能共享大量后续表达,多样性受基础模型和首 token 限制。
第二步:先用附加提问定位答案跨度
一条思维链可能以“所以答案是 5”结尾,也可能只写数字,甚至把计算过程与最终值连在一起。为了稳定找到答案 token,作者把固定文本“So the answer is”接到原轨迹后,让模型生成一次答案,再用字符串匹配把生成答案映射回原轨迹中的跨度。
这一做法有工程上的好处:答案提取与完整推理生成分离,后续置信度只统计最终答案 token,不受无意义的停用符或换行干扰。官方实现会移除停用 token,寻找答案序列与生成轨迹的最大重合片段;找不到时把该路径置信度记为 0,而不是给出一个虚假的高分。
第三步:计算答案跨度的置信度差距
设答案跨度从位置 $m$ 开始,共有 $M$ 个 token。对每个位置,取最可能 token 的概率,再减去第二可能 token 的概率,最后在整个答案跨度上取平均:
这里 $s_{m+i}$ 包含原问题与答案之前已经生成的上下文。若最高候选为 0.90、第二候选为 0.05,差距是 0.85;若两者为 0.40 和 0.35,差距只有 0.05。后一种情况下即便排名第一,也不能说明模型有强把握,这就是差距指标比原始最大概率更敏感的地方。
源码把这一思想写得很直接。ProbabilityDisparity 先取得实际生成 token 的概率,再用 torch.topk(k=2) 找到第二高 token 概率,两者相减。文件位置为 confidentllm/confidence_metrics/probability.py:58-81。
next_token_probs = super().__call__(next_token_ids, scores)
second_highest_probs = torch.topk(scores, k=2, dim=-1)
disparity = next_token_probs - second_highest_probs.values[:, :, 1]
这段代码与公式并非只在概念层面相似,张量操作和数学定义一一对应。它也提醒读者:论文所称置信度是“生成答案 token 相对次优 token 的胜出幅度”,不是经过温度缩放或分桶校准后的真实正确概率。
第四步:按置信度构造偏好对
十路候选都有答案和置信度后,作者用置信度高低形成偏好。较高置信路径作为 preferred,较低置信路径作为 rejected。源码会对每一组满足条件的候选两两配对,并额外保存置信度差取指数后的 margin。实现位于 confidentllm/data/datasets/cot_preference_data.py:163-204。
if response_1["confidence"] <= response_2["confidence"]:
    continue
ranked_data["preferred_response"].append(preferred_response)
ranked_data["rejected_response"].append(rejected_response)
ranked_data["margin"].append(exp(confidence_1 - confidence_2))
偏好对完全来自模型自身,不需要正确答案、人工排序或外部裁判。论文因此称其为“自我反馈”。不过,这也把方法的边界写得很清楚:它学习的是模型已有概率结构中的一致性,不是凭空获得外部事实。若基础模型稳定地以高置信度坚持某个错误,构造器只会更偏向那条错误轨迹。
第五步:PPO 路线与 Bradley-Terry 奖励模型
PPO 路线先训练一个标量奖励模型。完整序列结束时,奖励模型的输出成为强化学习回报:
其中 $s_{T-1}$ 是结束 token 前的上下文,$a_{T-1}$ 是结束 token。奖励模型以 Bradley-Terry 偏好假设训练。对问题 $q$、偏好轨迹 $h^1$ 和较差轨迹 $h^2$,损失为:
$\sigma$ 是 sigmoid,$\phi$ 是奖励模型参数。公式要求偏好轨迹的奖励高于被拒轨迹。训练完成后,奖励模型冻结,PPO 用它更新策略;参考模型也保持冻结,并通过 KL 约束限制策略漂移。
PPO 的轨迹目标可以写成带折扣回报的形式:
相应的策略梯度为:
优势 $A$ 衡量某个动作比当前状态的平均预期回报好多少。为了让更新稳定,论文还采用广义优势估计,把多步时序差误差按 $\lambda$ 加权:
PPO 随后用裁剪重要性采样的替代目标更新策略。核心思想是:新策略相对旧策略的变化可以发生,但比率一旦超出 $1-\epsilon$ 到 $1+\epsilon$ 的范围,就不应继续从该样本获得激进梯度。论文附录还加入 KL 惩罚,避免模型为了奖励模型而快速偏航。
第六步:DPO 路线直接优化轨迹偏好
若不想单独训练奖励模型,也可以把同一批自我偏好交给 DPO。它的损失比较策略模型与参考模型对偏好答案的相对概率:
$\beta$ 控制策略偏离参考模型的程度。相比 PPO,DPO 少了在线采样与奖励模型,但论文的结果并没有显示它在所有场景都更优。相反,DPO 在若干组合上出现准确率或校准退步,说明“训练更简单”不等于“目标更匹配”。
第七步:训练结束,推理回到一次贪心解码
flowchart TD
    A["Prompt q"] --> B["Frozen LLM: top K first tokens"]
    B --> C["K greedy continuations"]
    C --> D["Append So the answer is"]
    D --> E["Match and extract answer spans"]
    E --> F["Average top1 minus top2 confidence"]
    F --> G["Rank traces and build preference pairs"]
    G --> H["Bradley-Terry reward model"]
    H --> I["PPO policy update"]
    G --> J["Direct DPO update"]
    I --> K["Greedy inference at 1x cost"]
    J --> K
图中两条训练支路共用同一份自我偏好,但优化对象不同。最终部署时不再保留十路候选,只执行一次常规生成。论文因此把训练阶段的额外成本视为一次性投入,把推理阶段的一倍成本视为主要收益。
官方 PPO 入口在加载策略后,还会同时加载冻结参考模型、奖励模型和价值模型;不同模型必须共享 tokenizer,否则直接拒绝运行。代码位置为 confidentllm/scripts/run_reinforcement_learning.py:72-103。这体现了 RLSF 虽减少了人类标注,却没有消除标准 PPO 的模型内存与在线训练复杂度。
实验分析:改善最明显的是原本校准很差的模型
算术任务使用 MultiArith 与 GSM8K,多项选择使用 CommonsenseQA 与 ARC Easy。基础模型包括经过 DeepSeek R1 蒸馏的 Qwen 2.5 7B、Gemma 2 2B、用于多项选择的 Phi-2,以及表格中出现的 Gemma 9B 配置。评价指标一是精确答案准确率,二是期望校准误差。后者越低,说明模型声称的概率与真实正确率的偏差越小。
先看论文最主要的算术结果。Qwen 2.5 7B 的原始校准相当差,GSM8K 上基础贪心准确率是 53.67%,但 ECE 高达 42.86%。RLSF-PPO 把 GSM8K 准确率提高到 58.62%,ECE 降到 41.92%;在 MultiArith 上准确率从 79.44% 降到 78.06%,ECE 却从 20.75% 明显降到 18.35%。这说明它确实在改善概率质量,但并非每项准确率都保持原水平。
| Qwen 2.5 7B 配置 | MultiArith 准确率 | MultiArith ECE | GSM8K 准确率 | GSM8K ECE |
|---|---|---|---|---|
| 基础贪心 | 79.44 | 20.75 | 53.67 | 42.86 |
| 十路思维链解码 | 77.77 | 22.22 | 58.52 | 41.46 |
| RLSF-DPO | 71.62 | 25.12 | 50.73 | 38.15 |
| RLSF-PPO | 78.06 | 18.35 | 58.62 | 41.92 |
这张表里最值得注意的不是 PPO 的单个最高分,而是不同目标的冲突。RLSF-DPO 在 GSM8K 上把 ECE 降到 38.15%,低于 PPO 的 41.92%,但准确率只剩 50.73%。所以“DPO 更会校准”或“PPO 更准确”都过于简单;更准确的说法是,两种优化路径在这个数据规模上产生了不同的准确率与误差分布权衡。
Gemma 2B 是另一类条件。它在 MultiArith 上已经达到 98.12%,十路思维链解码还能提高到 99.01%,并把 ECE 从 7.43% 降到 4.12%。RLSF-PPO 得到 98.83% 和 7.81% 的 ECE,比基础模型好,但仍落后十路解码。GSM8K 上同样的模式出现:十路解码为 89.18%,RLSF-PPO 为 88.14%。因此 RLSF 对强基线的主要卖点不是“再涨一个点”,而是用普通贪心推理接近多路搜索。
| Gemma 2B 配置 | MultiArith 准确率 | MultiArith ECE | GSM8K 准确率 | GSM8K ECE |
|---|---|---|---|---|
| 基础贪心 | 98.12 | 7.43 | 85.57 | 12.24 |
| 十路思维链解码 | 99.01 | 4.12 | 89.18 | 10.94 |
| RLSF-DPO | 96.13 | 10.52 | 84.74 | 17.43 |
| RLSF-PPO | 98.83 | 7.81 | 88.14 | 12.54 |
多项选择结果给出了相同方向。Phi-2 在 CommonsenseQA 上原本只有 54.46% 准确率和 25.12% 的 ECE,RLSF-PPO 同时提升到 61.13% 和 19.64%。Gemma 2 在 ARC Easy 上已有 96.96%,RLSF-PPO 只得到 97.04%,但 ECE 从 16.12% 降到 5.12%。后者没有超过十路解码的 3.03% ECE,却不需要部署时的十次候选。
| 模型与任务 | 训练与解码 | 准确率 | ECE |
|---|---|---|---|
| Phi-2 / CommonsenseQA | 基础贪心 | 54.46 | 25.12 |
| Phi-2 / CommonsenseQA | RLSF-PPO 后贪心 | 61.13 | 19.64 |
| Gemma 2 / ARC Easy | 基础贪心 | 96.96 | 16.12 |
| Gemma 2 / ARC Easy | 十路思维链解码 | 96.28 | 3.03 |
| Gemma 2 / ARC Easy | RLSF-PPO 后贪心 | 97.04 | 5.12 |
奖励模型与可视化:置信度学到了什么
作者还在 RewardBench 数学子集上检查自我偏好训练出的奖励模型是否真的能区分人类偏好。只使用问题输入的 RLSF 奖励模型,Qwen 版达到 76.13%,Gemma 版达到 81.43%。使用提示、答案与偏好信息的 URM 和 QRM 达到约 97%,AfD 则在 73.12% 到 89.29% 之间。RLSF 比强监督奖励模型低约 16 到 21 个百分点,但它的输入限制也更严格,没有使用人工偏好。
| 奖励模型 | 使用提示 | 使用答案 | 使用偏好 | 准确率 |
|---|---|---|---|---|
| URM LLaMA 3.1 8B | 是 | 否 | 是 | 97.00 |
| QRM LLaMA 3.1 8B | 是 | 否 | 是 | 96.80 |
| Qwen 2.5 7B AfD | 是 | 是 | 否 | 89.29 |
| Gemma 2 2B AfD | 是 | 是 | 否 | 73.12 |
| Qwen 2.5 7B RLSF | 是 | 否 | 否 | 76.13 |
| Gemma 2 2B RLSF | 是 | 否 | 否 | 81.43 |
图 2 把奖励模型展开到 token 级别。正确数字和关键中间计算通常得到较高奖励,冗长解释可能被压低,模型偶尔还会出现先给答案、再补理由的事后合理化。这条观察很重要:奖励模型并非学会了形式化验证,它更像是在识别与高置信训练轨迹相似的表达结构。
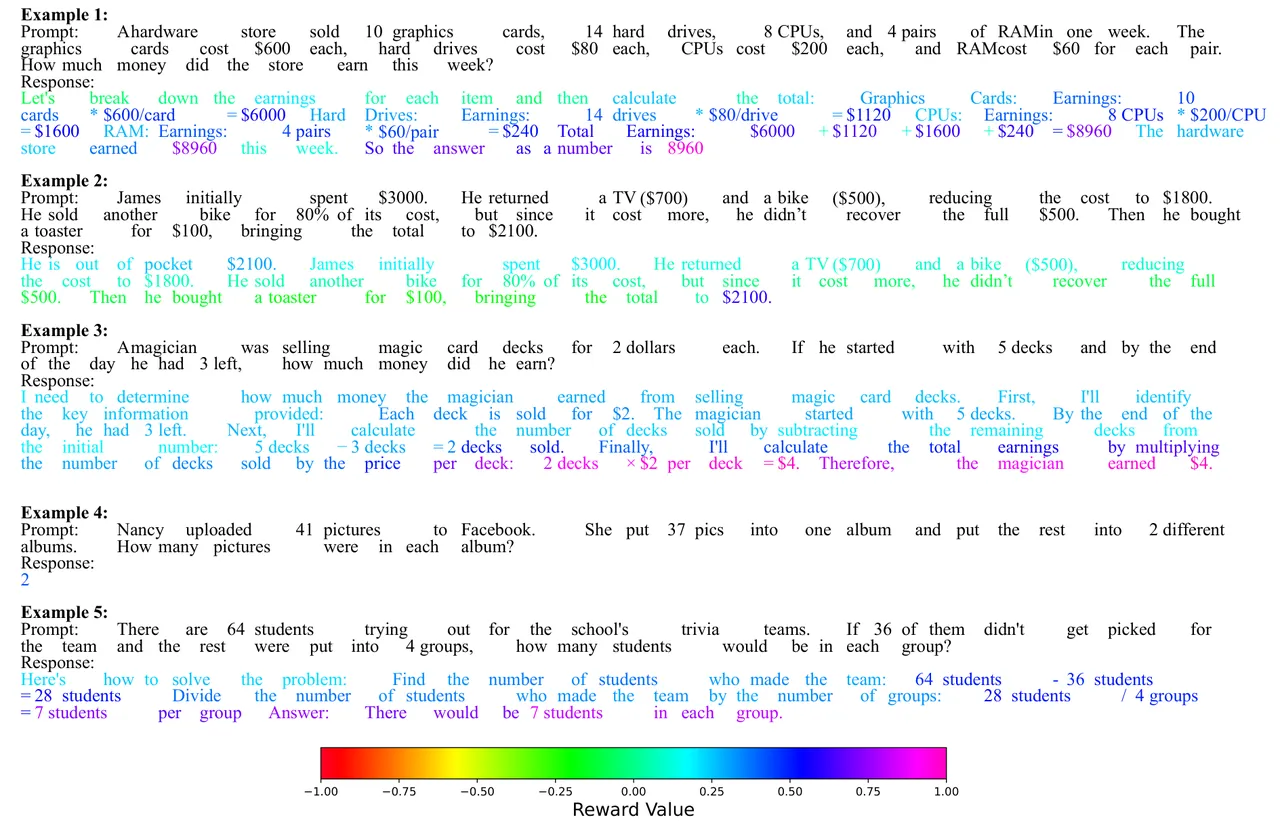
图 2:论文展示的 token 级奖励。颜色反映奖励模型的打分,并不等同于逻辑证明或事实核查。
图 3 展示了校准改善,也展示了仍未解决的问题。训练前后模型都把多项选择题答成 A,而不是正确答案 E。训练前对 A 的概率是 0.993,对 E 只有 0.004;RLSF 后对 A 降到 0.712,对 E 升到 0.138。答案仍然错误,但模型不再以近乎确定的态度坚持错误选项,同时给正确答案留下了更多概率质量。
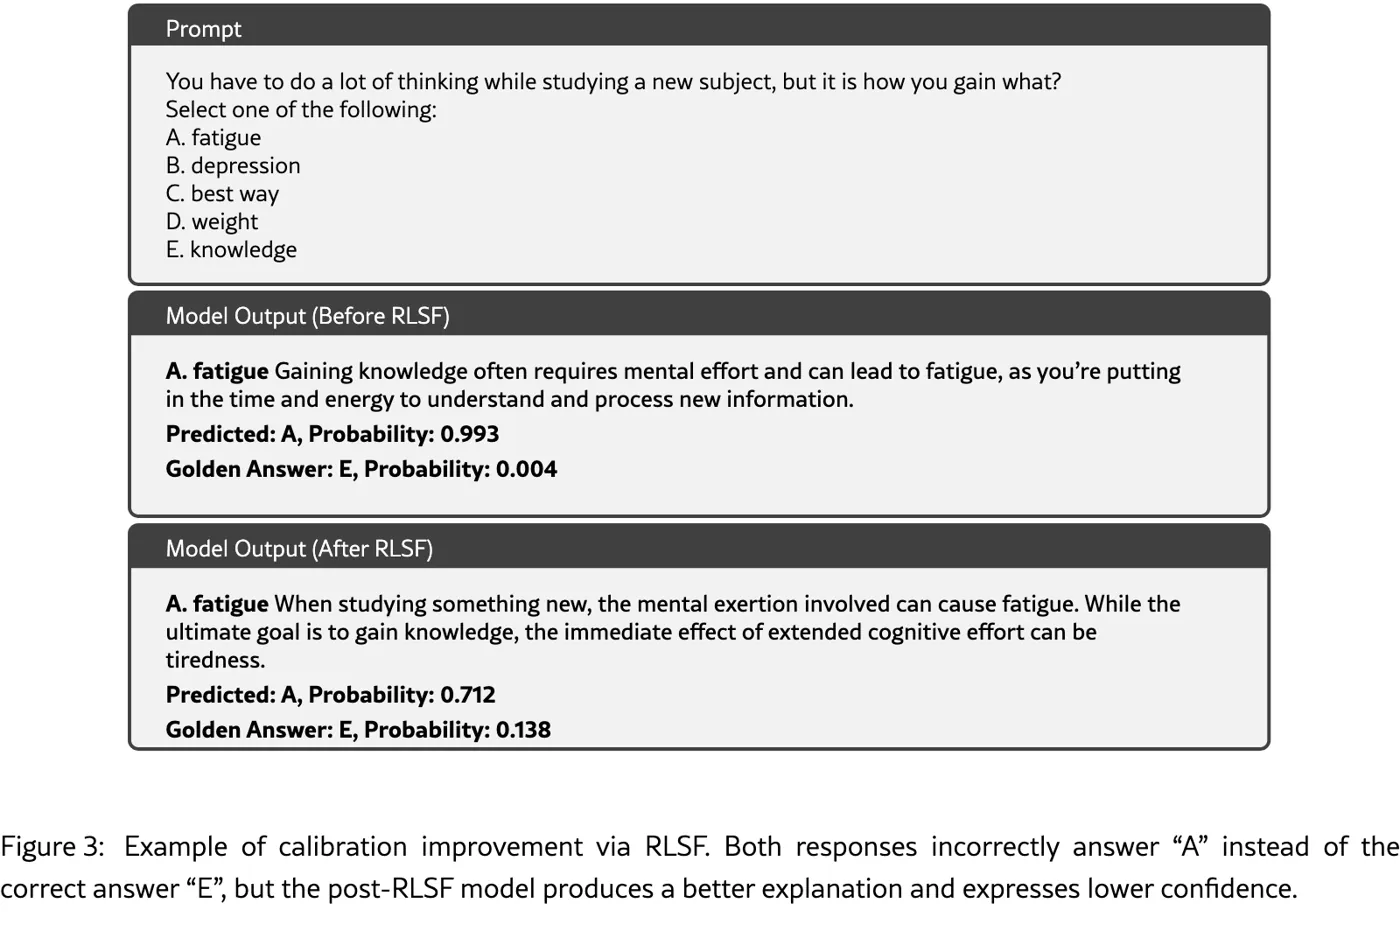
图 3:论文 HTML 中的原始内嵌矢量图渲染。前后两次都答错,但 RLSF 后错误答案置信度从 0.993 降到 0.712,正确答案概率从 0.004 升到 0.138。
局限与风险:自我反馈不是事实来源
作者明确承认,RLSF 主要处理“一次生成完整思维链后给出答案”的单步轨迹,尚未验证多轮交互与长程规划。这个限制并非形式问题。机器人任务常需要在感知、动作和外部反馈之间循环,错误可能在若干步后才暴露;只根据最终答案 token 的置信度排序,无法告诉模型哪一步动作导致失败。
第二个限制是方法依赖基础模型已经具备潜藏的推理能力。如果模型严重欠训练,候选轨迹本身混乱,最高与次高 token 概率的差距可能只是噪声。此时训练会把噪声包装成偏好。论文覆盖的模型最大约 9B,尚未证明方法能按规模平滑迁移到 70B 以上模型或更复杂推理任务。
第三个限制最根本:模型无法通过自我反馈获得外部事实。若预训练知识缺失,模型可能自信地重复错误,RLSF 还会强化这种内部一致性。图 3 恰好说明校准与正确性是两件事:模型可以变得不那么过度自信,却仍然答错。对机器人这种需要物理事实和安全边界的系统,应把 RLSF 当作推理校准层,而不是世界模型或安全验证器。
还有一项独立于论文论述的复现问题。正文模型章节写 Gemma 2 2B,但表 2、部分结果以及官方 README 又出现 Gemma 9B 用于问答和奖励模型的配置。即使作者可能在不同实验中切换模型,正文需要更清楚说明每个表格对应的模型身份。否则读者无法判断校准改进来自方法,还是来自更大的模型容量。
论文结论中的“without harming accuracy”也应谨慎阅读。Qwen 的 MultiArith 从 79.44% 降到 78.06%,Gemma 的 GSM8K 从 85.57% 降为 88.14% 虽较基础上升,却仍低于十路解码的 89.18%。更稳妥的结论是:RLSF 对校准差模型可能同时改善两项指标,对强模型则常以少量准确率或校准损失换取一次推理成本。
结论
RLSF 的核心贡献不是发明另一种奖励模型,而是找到一条从现成置信度生成训练信号的通路。它把十路思维链从部署时的昂贵搜索,转换为训练时的数据构造过程,再通过 PPO 或 DPO 把高置信路径压缩进普通生成策略。对于基础模型校准明显失真的场景,这比只靠提示词要求“表达不确定性”更有明确的作用机制;对于已经很强的模型,它更像降低推理延迟的工具。
这篇工作也留下一个值得继续追问的方向:如何判断“高置信”究竟来自可靠推理,还是来自模型熟悉的错误模板。把置信度与外部工具、物理执行反馈或显式验证器结合,可能比反复优化单一模型的内部概率更接近可靠的具身智能系统。
置信度可以被训练成更好的行为信号,但它不能自动变成关于世界的证据。