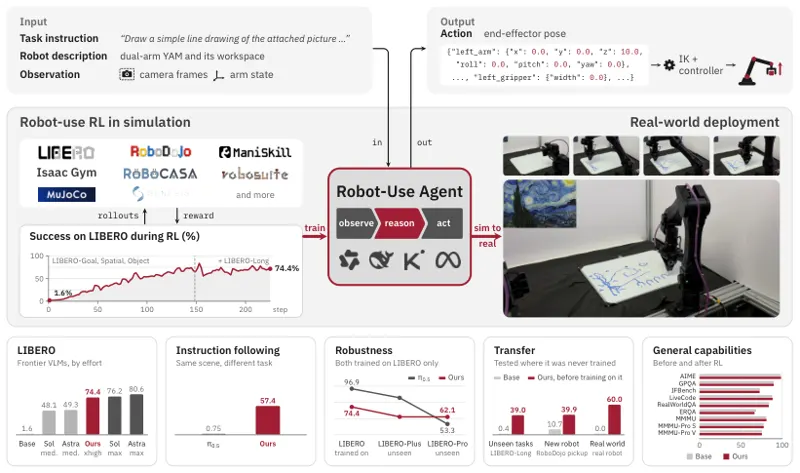
仿真训练推理模型原生使用真实机器人本文仅用仿真强化学习训练 27B 机器人使用推理模型,直接预测末端位姿;LIBERO 成功率由 1.6% 升至 74.4%,真实双臂机器人达 60%。Jiaming Tang, Zhuoyang Zhang, Junxian Guo · 28次阅读 · 2026年11月13日Robot-Use Agents强化学习2026年11月13日
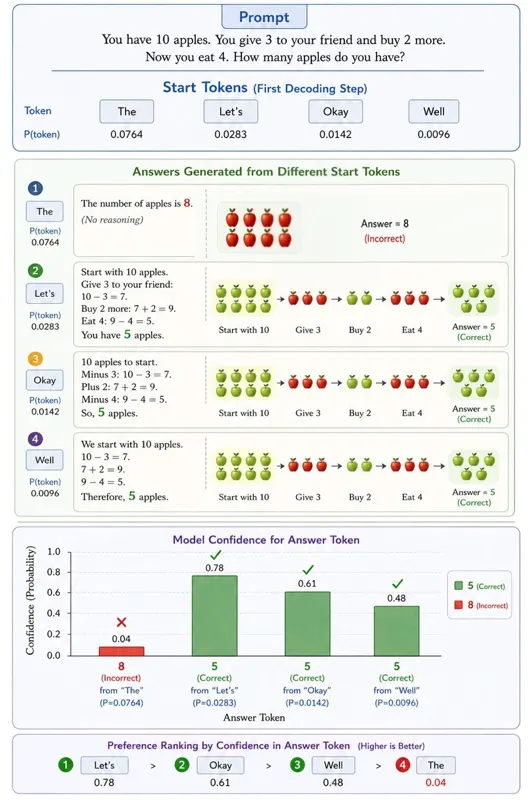
通过自我反馈强化学习对大语言模型进行后训练大语言模型常给出看似合理但过度自信的答案,校准误差会削弱高风险推理场景的可靠性。本文提出自我反馈强化学习 RLSF:冻结模型生成多条思维链解码轨迹,以最终答案片段的模型置信度排序,自动构造偏好对,再用 PPO 或 DPO 后训练策略,无需人工偏好、标准答案或外部奖励。实验表明,RLSF 能改善算术推理和多选问答上的校准与准确率,并让一次贪心解码接近多路解码的可靠性;但收益依赖初始模型,部分准确率或校准指标仍可能回退。Carel van Niekerk, Renato Vukovic, Benjamin Ruppik · 505次阅读 · 2025年7月29日Large Language Models强化学习2025年7月29日
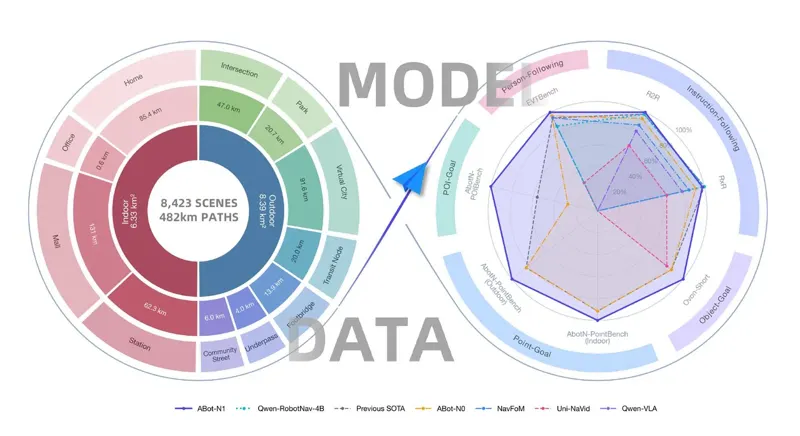
ABot-N1:通用视觉语言导航基础模型高德ABot-N1是一个慢快双系统视觉语言导航基础模型:4B慢系统输出思维链与Target/Affordance双像素目标,2B快系统经QFormer动作查询解码连续SE(2)轨迹点,用统一像素接口覆盖坐标点、物体、POI、指令跟随与人员跟随五类任务。3000万样本预训练+GRPO安全感知后训练,并发布ABotN-PointBench与ABotN-POIBench两个闭环基准。五基准全部SOTA:POI入口到达77.3%(+35.0个百分点),室外/室内坐标点导航92.9%/95.4%,并部署于途途四足机器人Jetson AGX Orin。Ruiyan Gong, Yingnan Guo, Junjun Hu · 949次阅读 · 2026年7月11日VLNNavigation Foundation Model2026年7月11日
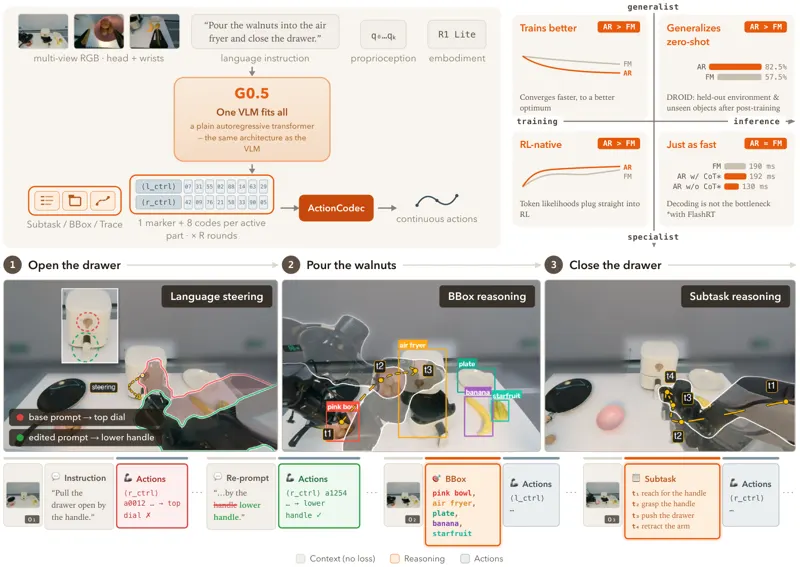
G0.5:单一自回归流统一机器人推理与动作G0.5 用单一 Transformer 解码器在统一目标下同时生成推理与动作 token,配合跨本体动作分词器、原生思维链流与视觉记忆模块,在真机微调、BEHAVIOR、DROID、LIBERO 等 7 项基准上超越 π0.5 与 GR00T-N1.7。Yicheng Liu, Zibin Dong, Baijun Ye · 982次阅读 · 2026年8月12日视觉语言动作模型Galaxea2026年8月12日