PAPER DEEP DIVE
仿真训练推理模型原生使用真实机器人
本文仅用仿真强化学习训练 27B 机器人使用推理模型,直接预测末端位姿;LIBERO 成功率由 1.6% 升至 74.4%,真实双臂机器人达 60%。
论文元信息
标题:仿真训练推理模型原生使用真实机器人
英文标题:Training Reasoning Models in Simulation to Natively Use Real Robots
作者:Jiaming Tang、Zhuoyang Zhang、Junxian Guo、Fangzhou Zhao、Yilong Zhao、Zekai Li、Xingyang Li、Yuyang Zhao、Song Bian、Zhijian Liu、Song Han。
论文:arXiv 2611.18562;代码:mit-han-lab/pear。本文精读对应代码提交 d604856a1b16fdccd47e22a27d4dd935e3a62014。
研究对象:一个 27B 视觉语言推理模型,只通过仿真环境中的强化学习学习“机器人使用”,不依赖专家演示、监督微调或真实机器人训练数据。模型输出具名部件与数值量组成的严格 JSON,动作最终是相对下一末端执行器位姿;逆运动学和底层控制器位于模型外部。
一句话总结
PEAR 把机器人操作重新表述成一项可验证的“工具使用”任务:27B 推理模型在长上下文中读取图像、调用观察与动作接口、解析执行反馈,并由仿真成功信号通过 GRPO 训练。它只用仿真强化学习,把 LIBERO 成功率从 1.6% 提升到 74.4%,并在从未训练过的真实双臂 YAM 平台上完成 18/30 次任务。
研究问题:机器人策略缺的是动作,还是会使用机器人
主流视觉语言动作模型通常把任务压缩成观测到动作序列的映射。它们依赖示范数据,输出连续控制量或动作块,并在训练分布附近表现良好。这样的设计把感知、语言理解和控制耦合在一个策略里,却很少直接训练模型回答几个部署时真正关键的问题:现在应该观察哪里,应该调用哪个机器人接口,参数是否合理,上一次动作产生了什么变化,失败后要不要重新规划。
PEAR 的出发点是把这些问题显式保留在推理链中。模型不是直接输出关节扭矩,也不是一次性吐出整段轨迹,而是在每一轮根据当前图像、任务说明和历史反馈,选择一个工具并填写严格参数。执行结果返回后,模型再决定下一步。作者把这种能力称为“原生机器人使用”:模型知道机器人有哪些能力,知道怎样以正确格式调用它们,也知道如何利用执行结果继续任务。
这一路线有两项吸引力。第一,接口层把高层语义推理与低层控制解耦,模型可以调用已经可靠的 IK、运动规划和控制模块,避免让语言模型重新学习电机动力学。第二,训练信号可以来自仿真任务是否成功,而不需要人工标注每一步的“正确想法”。只要环境能够判断目标是否完成,就能把成功或失败传播到长程工具调用序列。
难点同样明显。一个成功回合可能横跨几十次图像观察和工具调用,奖励却只在结尾给出一个二值信号。模型还必须学会严格语法、空间关系、动作尺度和停止条件。任何一次 JSON 格式错误、越界位姿或错误抓取,都可能让长回合永久偏离。论文真正要证明的是,这些能力能否仅凭仿真 RL 获得,以及由此形成的接口习惯能否跨越仿真器与真实硬件之间的差异。
任务形式化:一条由工具调用组成的长轨迹
一个回合可以写成图像观测与模型响应交替的序列:
$$\tau=(o_1,y_1,\ldots,o_T,y_T).\tag{1}$$其中,$o_t$ 是第 $t$ 轮由环境返回的观察,$y_t$ 是模型生成的推理文本和工具调用。论文在策略条件中保留从任务开始到当前轮的全部交互:
$$h_t=(p,o_1,y_1,\ldots,o_t),\qquad y_t\sim\pi_\theta(\cdot\mid h_t).\tag{2}$$这里 $p$ 是任务提示,$\theta$ 是 27B 模型参数。回合结束时,环境给出二值奖励:
$$R(\tau)\in\{0,1\}.\tag{3}$$该形式化与传统“观测到动作”的 MDP 有一个关键区别:$y_t$ 不只是动作,它同时包含语言判断、工具名与参数。动作空间因此既受自然语言语义约束,又受 JSON schema 约束。模型的推理和接口调用写在同一条自回归序列中,训练也必须让格式错误、错误参数和空间误判都获得低奖励。
长上下文不是工程装饰,而是算法的一部分。论文报告 LIBERO 使用 256k token 上下文,RoboDojo 使用 160k token;一个平均回合约 94k token,包含 19.7 轮交互和 39 至 59 张图像。模型必须在这个窗口中保留任务目标、已经移动的物体、先前失败原因和当前位姿,而不是每轮从一张新图片重新开始。
PEAR 的系统结构
PEAR 由五个相互约束的部分组成。第一个是代理循环,它维护消息历史、调用模型、解析工具请求并把执行结果追加回上下文。第二个是严格 JSON 协议,它把观察、动作和最终回答区分成不同类型。第三个是仿真工具层,它把模型给出的具名参数转换成机器人动作并生成新图像。第四个是异步回放缓冲,它把长度差异极大的回合组织成可训练组。第五个是分布式训练器,它用组相对优势和定制的 REINFORCE 目标更新模型。
flowchart TD
    P["Task prompt and robot capability contract"] --> L["PEAR agent loop: Qwen3.8-27B"]
    O["Multimodal observation"] --> L
    H["Full interaction history"] --> L
    L --> J{"Strict JSON response"}
    J -->|Observe| S["Simulator returns image and state"]
    J -->|Act| K["Named robot tool with quantities"]
    K --> I["External IK and controller"]
    I --> S
    S --> H
    H --> L
    J -->|Finish| R["Episode result"]
    R --> B["Async replay buffer: groups of eight"]
    B --> A["GRPO advantage, DAPO filtering, score centering"]
    A --> T["Token-mean REINFORCE update"]
    T --> L
图 1:依据论文方法与公开代码绘制的 PEAR 训练和执行闭环。
这个结构刻意没有让模型直接控制关节。工具层知道机器人本体、相机外参和场景对象;模型只需要选择部件、方向和相对位移等语义量。例如,模型可以指定移动某只手臂并给出相对位姿,而 IK 和控制器负责求逆、限位与执行。这样既保留了推理模型擅长的符号组合,又避免要求它从少量成功回合中重新发现底层动力学。
协议设计:让“想法”变成可执行请求
论文最容易被忽略、但对成败最关键的贡献是协议。开放文本中的“抓取红色积木”无法直接执行,系统需要一个不依赖自由文本解析的动作契约。pear/agent_loop/protocol.py 定义了观察、工具调用和最终答案的结构。每条消息都有类型、工具名与参数,解析器只接受 schema 允许的字段。这样,模型可以自由推理,但真正送入机器人的部分必须可验证。
代码中的解析规则进一步收紧了接口。pear/agent_loop/tool_parser.py 只从响应的最后一个 fenced JSON 块提取工具调用:
JSON_BLOCK_PATTERN = re.compile(
    r"```json\s*(\{.*?\})\s*```",
    re.DOTALL,
)
截取范围 19 至 47 行还负责拒绝缺失 JSON、结构不合法和多余工具请求。只取最后一个块的设计允许模型先写分析,再以明确边界提交动作;解析器不必猜测自然语言中的意图。它把“思考”和“执行”分开,但同时保留在同一个模型回合里。对于长上下文代理,这是一个务实折中:模型仍可进行连续推理,运行时只解析最终承诺。
pear/envs/system_prompt.md 第 3 至 33 行则把观察、动作和响应契约写进系统提示。提示告诉模型机器人有哪些具名部件、怎样描述相对运动、何时调用观察、怎样结束回合。把这些约束放在系统提示而不是散落在每个任务里,使所有仿真任务共享同一套“机器人使用手册”。它也是仿真技能迁移到真实 YAM 的接口基础:只要真实系统兑现同一组工具语义,模型不必知道背后是 MuJoCo、RoboDojo 还是实体控制器。
严格协议带来的代价是脆弱性。模型可能在推理上正确,却因为键名、嵌套层级或单位格式错误而失去整个动作。奖励只看最终任务是否完成,不直接奖励合法 JSON,因此训练初期会出现大量零奖励回合。PEAR 通过长上下文和组内比较逐步筛出既能完成任务、又能满足格式约束的行为,但这也解释了为什么它需要异常大的 rollout 规模和计算预算。
回合执行:每一步都重新读取世界
pear/agent_loop/agent_loop.py 第 98 至 172 行实现回合主循环。它先把任务提示、当前图像和历史构造为模型输入,然后等待响应;若响应包含工具调用,就交给环境执行,把返回图像与状态加入历史,再进入下一轮。若响应声明完成,循环结束。每一步都重新观察,避免把一次预测的局部轨迹盲目执行到底。
pear/envs/tool.py 第 63 至 125 行完成真正的仿真执行。它校验工具名和参数,映射到机器人控制接口,推进仿真器,返回新的相机图像和可读反馈。这里的反馈并不是让模型看到隐藏状态,而是把可部署时也能获得的视觉与状态信息回传。模型学到的因此是闭环纠错,而不是对仿真器内部变量的特权访问。
第 198 至 229 行还处理上下文续写和评分中心化占位。长回合可能超过一次生成窗口,系统需要压缩或续接历史;累积奖励也需要在组内归一化,避免长回合因 token 数更多而获得不成比例的梯度。公开实现把这两件事放在代理循环与训练器边界上,说明 PEAR 不是“把聊天记录无限拼接”那么简单,而是在回合级工程中维持可训练性。
从机器人角度看,平均 19.7 轮交互意味着模型不断进行“观察、判断、动作、再观察”。这比一次性动作块更适合物体被碰动、抓取失败或相机视角变化的任务。它也把误差暴露出来:如果模型忘记已经夹住物体,下一轮可能重复抓取;如果错误估计位移,后续图像会显示异常,模型必须利用反馈修正。论文的真实机器人失败分析正是围绕这些闭环问题展开。
训练算法:二值奖励如何变成 token 级梯度
PEAR 使用 GRPO 风格的组相对优势。对同一任务采样多个回合后,先按组计算奖励均值与标准差:
$$\hat A_i=\frac{R(\tau_i)-\operatorname{mean}_j R(\tau_j)} {\operatorname{std}_j R(\tau_j)+\epsilon}.\tag{4}$$若一组 8 条 rollout 全部成功或全部失败,组内没有可用比较信号。论文实现采用 DAPO 风格的组过滤,只保留奖励存在差异的组。这可以避免大量零方差样本贡献噪声,也解释了训练吞吐与有效样本率之间的张力。对于长程机器人任务,成功稀少且格式错误常见,过滤器不是小优化,而是让梯度聚焦在“同任务内哪种行为更好”的必要机制。
序列被拆成 token 后,第 $i$ 条 rollout 第 $t$ 轮、第 $k$ 个 token 的上下文是:
$$c_{i,t}^k=(h_{i,t},y_{i,t}^{<k}).\tag{5}$$损失不把整段对话当作同等重要的 token,而是对生成 token 求平均。设 $\mathcal G$ 为保留的组,$N$ 为其中轨迹数,基础 REINFORCE 梯度可以写成:
$$g=\frac1N\sum_i\hat A_i\sum_{t,k} \nabla_\theta\log\pi_\theta(y_{i,t}^k\mid c_{i,t}^k).\tag{6}$$论文配置启用了 REINFORCE bypass,而不使用 PPO 的裁剪比率;同时没有 KL 惩罚、没有熵奖励。这使目标更接近带基线优势的策略梯度,减少额外超参数,并把行为变化直接归因于组内奖励差。需要强调的是,这不等于没有稳定性控制:组过滤、优势归一化、评分中心化和固定学习率共同承担稳定性。
评分中心化进一步处理多轮工具调用的贡献。其核心思想是让相对于组均值的得分成为 token 权重,而不是把原始二值奖励无条件广播到整条超长序列。由此,同一组内较成功的轨迹在全部生成 token 上获得正优势,较失败的轨迹获得负优势。模型不需要外部价值网络,也不需要为每个中间动作提供过程奖励。
优化器使用 AdamW,学习率 $1\times10^{-6}$,损失按生成 token 数取均值。每一步包含 128 个组,每组 8 条 rollout,即每步 1024 个长回合。这样的大批量不是为了追求常规语言模型的吞吐,而是因为单条机器人轨迹高度随机、奖励稀疏,只有把相同任务的多条尝试放在一起,组内相对优势才有意义。
filter_groups:
  enable: true
  metric: reward

rollout_correction:
  bypass_mode: true
  loss_type: reinforce
  score_centering: true
上面的配置摘自 pear/configs/training.yaml 第 13 至 79 行的关键字段。它揭示了 PEAR 与标准 PPO 的差别:工具调用回合很长,奖励又是二值,如果直接套用 PPO 的逐 token 比率裁剪,模型很容易在少数成功轨迹上快速过拟合。pear/configs/base.yaml 第 18 至 38 行还设置了异步训练与最多 5 个版本的最大陈旧度,使 rollout 生成和参数更新可以流水化。
异步训练与回放:把长度不一的长回合变成稳定批次
pear/trainer/replay_buffer.py 第 39 至 112 行负责收集轨迹、组织任务组并计算组成功率。机器人回合长度差异巨大:简单拾取可能几轮完成,复杂积木任务可能耗尽数十万 token。同步等待会浪费大量 GPU 时间,因此 PEAR 允许 rollout worker 在旧参数上继续生成,再把样本送入回放缓冲。
异步带来陈旧样本问题。若更新后的模型与生成轨迹时的模型差异过大,优势估计和梯度就来自不一致的策略。配置把最大陈旧度限制为 5,并提供重要性权重与截断机制。它不是免费午餐:吞吐提升的代价是训练目标更复杂、有效批大小更难解释,也让复现实验必须精确控制 worker 数量、调度延迟和缓存命中。
pear/rollout/lmcache.py 第 21 至 263 行实现前缀 KV cache。每条新回合都共享很长的系统提示和任务前缀,若每轮重新编码全部图像与历史,显存和计算都不可承受。LMCache 保留可复用前缀的键值状态,并在任务或参数版本变化时清理陈旧缓存。由于图像与动作交替,缓存键还必须区分同一文本前缀后的不同视觉状态,不能简单按 token 字符串复用。
回放缓冲的另一项职责是计算每组的通过率。并行的 8 条 rollout 并非简单拼接;训练器需要知道它们是否来自同一任务、使用哪个策略版本、是否满足过滤条件。对长上下文代理来说,数据组织本身就是算法的一部分:一条成功轨迹的价值取决于同组失败轨迹,而不是孤立样本中的 token 概率。
课程学习:先在短任务站稳,再扩大动作空间
论文使用三阶段课程。第 1 至 148 步只在 LIBERO 的 Goal、Spatial 和 Object 三类任务上训练,先学习把末端移动到目标、理解空间关系和抓放物体。第 149 至 225 步加入 Long,使四个 LIBERO 套件共同参与。第 226 至 340 步引入 RoboDojo 的 general_pickup 与 align_blocks,让模型接触不同仿真器、相机和双臂动作。
课程顺序符合能力依赖。Goal 和 Spatial 提供较清晰的目标信号;Object 引入物体交互;Long 要求多个子目标串联;RoboDojo 则把相同工具协议迁移到不同机器人本体和环境。若一开始就直接训练最难的长程双臂任务,成功样本可能稀少到无法形成有效组内差异,模型只学会格式却学不到任务结构。
但课程也留下解释上的空缺。论文没有给出每一阶段贡献的完整消融,因此无法精确判断 LIBERO 前三类任务、Long 任务和 RoboDojo 各自对最终真实迁移贡献多少。特别是真实 YAM 采用双臂,而 LIBERO 主要是单臂操作,RoboDojo 的引入显然重要;但当前结果仍不能证明只要增加任何第二仿真器就会产生同样的 sim-to-real 收益。
| 训练阶段 | 步数 | 任务分布 | 主要目的 |
|---|---|---|---|
| 阶段一 | 1–148 | LIBERO Goal、Spatial、Object | 建立观察、空间与基本操作闭环 |
| 阶段二 | 149–225 | 四个 LIBERO 套件,加入 Long | 学习多子目标与长程状态维护 |
| 阶段三 | 226–340 | RoboDojo general_pickup、align_blocks | 迁移工具协议到第二仿真域与双臂任务 |
表 1:论文附录中的课程训练安排。
仿真训练结果:从几乎不会到可执行
基座 Qwen3.8-27B 在 LIBERO 上只有 1.6% 成功率。它可能理解任务语言,却不会稳定地调用工具、组合动作或跨轮纠错。PEAR 最终达到 74.4%,说明仿真 RL 不只是改善格式,而是显著提高了任务完成能力。四个套件的结果分别为 Spatial 85.8%、Object 97.0%、Goal 61.4%、Long 53.2%。
难度分层很清楚。Object 接近饱和,说明抓取和放置类技能可以通过仿真反馈稳定学会;Spatial 也表现良好,说明模型能把图像关系转换为工具参数。Goal 和 Long 明显较低,它们要求更长状态链和更精确的结果验证。平均 74.4% 掩盖了 Long 仍有一半左右失败的事实,不能把它解读为已解决通用长程操作。
推理努力程度是另一个关键变量。低努力设置只得到 21.9%,而 xhigh 达到 74.4%。这不是普通文本任务中“多想一会儿略有帮助”,而是同一模型必须保留更多历史、执行更多轮观察并避免过早结束。推理预算与机器人任务成功率强耦合,部署时必须把延迟、费用和成功率一起考虑。
LIBERO-Pro 上,PEAR 达到 62.1%,论文报告 π0.5 为 53.3%。在“新任务、熟悉场景”条件中,PEAR 为 57.4%,π0.5 仅 0.75%;在交换物体位置后,PEAR 为 57.5%,π0.5 为 20.8%。这些差异说明接口式推理可能更擅长重新读取场景和重规划,而不是依赖固定动作记忆。不过比较对象的训练数据、动作接口和评测预算并不完全相同,不能把差值全部归因于 PEAR 的训练目标。
RoboLab-120 上,PEAR 达到 37.3%,基座为 5.4%。Cosmos3-Nano 为 36.8%,π0.5 为 28.0%,DreamZero 为 25.7%,GR00T N1.6 为 7.2%。PEAR 与 Cosmos3-Nano 几乎持平,但明显高于其他策略。该结果的重要性在于跨环境,而不只是单一套件刷分;它也提醒我们,37.3% 仍意味着近三分之二任务失败,真实开放环境的表现不能由此直接推断。
| 评测 | PEAR | 对照 | 基座或其他参考 | 结论 |
|---|---|---|---|---|
| LIBERO 总体 | 74.4% | — | 1.6% | 仿真 RL 带来 72.8 个百分点提升 |
| LIBERO Spatial | 85.8% | — | — | 空间参数调用较稳定 |
| LIBERO Object | 97.0% | — | — | 物体抓放接近饱和 |
| LIBERO Goal | 61.4% | — | — | 目标完成仍受长程误差影响 |
| LIBERO Long | 53.2% | — | — | 多阶段任务仍是主要短板 |
| LIBERO-Pro | 62.1% | π0.5 53.3% | — | 分布外任务有一定优势 |
| 新任务、熟悉场景 | 57.4% | π0.5 0.75% | — | 重读取与重规划差异显著 |
| 交换物体位置 | 57.5% | π0.5 20.8% | — | 对布局变化更稳健 |
| RoboLab-120 | 37.3% | Cosmos3-Nano 36.8% | 基座 5.4% | 跨环境有效,但绝对成功仍低 |
表 2:论文主要仿真评测结果汇总。
真实机器人:零真实训练数据的 18/30
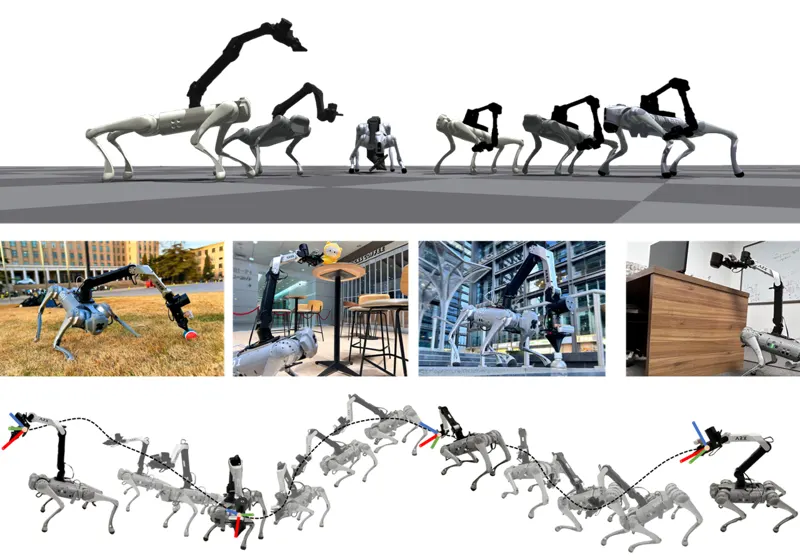
真实实验使用双机械臂 YAM 平台,任务涉及抓取、对齐和放置积木。最终模型完成 18/30 次试验,成功率为 60%;仅在 LIBERO 上训练的版本为 7/30,即 23.3%;基座模型为 0/30。三个数字形成清晰梯度:基座没有可用接口习惯,LIBERO 训练提供部分操作能力,加入 RoboDojo 后才形成可迁移的双臂执行策略。
更重要的是,真实机器人没有参与训练或微调。PEAR 的输入是真实相机图像,执行器是真实 IK 与控制器,模型仍输出同一类 JSON 位姿指令。这证明工具的语义契约可以在仿真与真实系统之间共享。它并不证明仿真与现实没有差异;60% 的成功率说明差异仍足以让四成试验失败,只是这些失败没有阻止基本任务执行。
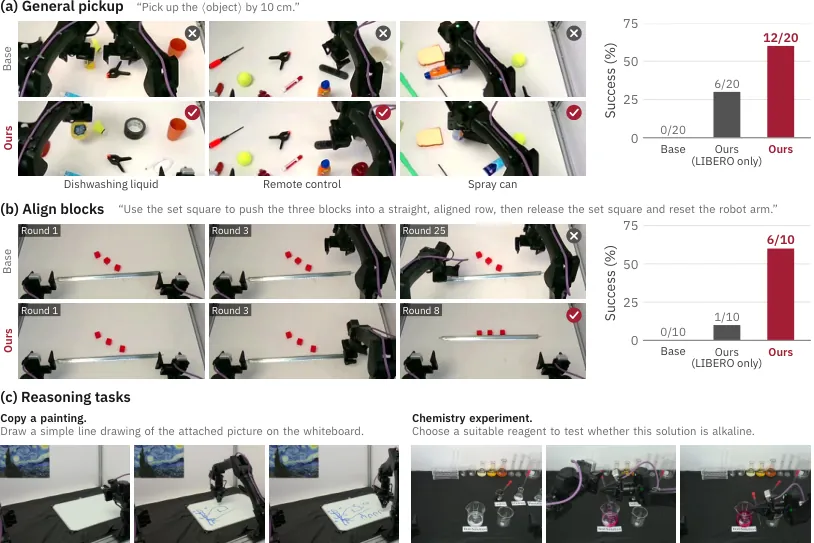
图 2:论文图 7,真实双臂 YAM 上的对齐与放置实验。图像来自论文。
最终模型的 12 次失败分为四类:6 次在回合数上限前仍未完成,3 次积木没有对齐,2 次碰倒物体,1 次球滚离目标区域。失败结构比单一成功率更有信息量。回合上限说明模型进入低效循环或持续验证;未对齐和碰倒说明末端位姿与接触控制存在误差;球滚离目标说明模型对可移动物体的动力学预测不足。
这些失败与“模型只会输出路径点”的架构一致。模型可以判断大致方向和部件,却无法通过接触力感知判断夹爪是否真正夹紧,也无法直接补偿柔性物体或滚动接触。外部控制器保证执行安全与运动学可行,但不会替模型解决任务级误差累积。PEAR 的真实迁移是有效的,但距离稳定部署仍有明显距离。
实验规模也限制了外推。30 次试验足以展示从 0 到 60% 的跃迁,却不足以给出窄置信区间或覆盖多种机器人、光照、物体材质与相机安装。论文没有把真实成功率拆成按物体、初始姿态或操作者划分的细分表,因此无法判断 60% 是否由少数简单配置拉高。真实结果应视为可行性证据,而不是可靠性认证。
| 真实 YAM 条件 | 成功次数 | 成功率 | 解释 |
|---|---|---|---|
| 最终 PEAR | 18/30 | 60.0% | 加入 RoboDojo 后形成可迁移闭环 |
| 仅 LIBERO 训练 | 7/30 | 23.3% | 单臂短任务不足以覆盖真实双臂差异 |
| 基座模型 | 0/30 | 0% | 缺少工具调用与任务执行训练 |
| 最终模型失败:回合上限 | 6 | — | 低效循环或无法确认完成 |
| 最终模型失败:未对齐 | 3 | — | 位姿精度与视觉判断不足 |
| 最终模型失败:碰倒物体 | 2 | — | 接触与碰撞控制不足 |
| 最终模型失败:球滚走 | 1 | — | 可移动物体动力学难以预测 |
表 3:真实机器人成功率与论文报告的失败类型。
完整 RoboDojo:能力有了,上下文预算成了瓶颈
在完整 RoboDojo 的 540 个任务中,最终模型只成功 21 个,同时有 370 个回合以耗尽 256k 上下文结束,占 68.5%。这组数字极其重要,因为它改变了“模型不会做”的简单解释。至少在相当一部分回合里,模型仍在持续观察和调用工具,但历史长度超过训练与推理预算,最终没有机会给出完成动作。
长上下文代理的容量不是免费的。每一张图像都消耗视觉 token,每轮工具返回和执行反馈继续累积;20 轮之后,历史可能已经接近一个短文本模型整个训练窗口的数倍。若不进行检索、摘要或状态压缩,模型即使方向正确也会被记录拖死。论文的上下文长度已经很大,却在 540 个更广泛任务上暴露出上限。
这也解释了为什么 RoboLab-120 的 37.3% 与完整 RoboDojo 的 3.9% 差异巨大。任务集合、成功判定和允许回合数可能不同,但上下文耗尽显然是实际限制。部署时单纯增加窗口会提高显存、延迟和缓存压力;更可持续的方向是学习压缩状态、丢弃无关图像、把已完成子目标转成结构化摘要,或为工具结果建立可检索记忆。
该结果还暴露成功率指标的单轴性。一个模型可能连续执行 100 轮、逐步接近目标,但因没有在预算内完成而被计为失败;另一个模型可能很快输出错误动作并被判失败。只看最终奖励无法区分“不会做”“知道该做但太慢”“格式错误”和“上下文溢出”。论文后续若要推动真实部署,应报告终止原因分布,而不只是二值成功率。
是否损害通用推理:九个基准给出的答案
机器人 RL 最自然的担忧是灾难性遗忘。PEAR 在九个通用能力基准上比较基座与最终模型,基座平均为 81.64,最终为 81.49,差距只有 0.15 分;每一个配对基准的 95% 置信区间都包含零。作者据此认为,仿真机器人训练没有造成可检测的通用推理退化。
这个结果缓解了“强化学习会把语言模型变笨”的直觉担忧,但不能证明内部能力完全不变。九个基准的平均值可能掩盖特定技能的小幅升降;置信区间包含零只说明当前样本无法拒绝无差异,并不等于等价。论文没有展示全部逐项变化和失败样本,因此最稳妥的结论是“在所选基准与样本量下未观察到显著退化”。
从工程角度看,这仍然是重要正面证据。PEAR 用同一个 27B 模型承担语言理解、空间判断和工具调用,而不是另外接一个不可训练的高层智能体。若机器人训练会显著破坏通用语义能力,长上下文任务中的自然语言规则与错误恢复也会受损。当前结果说明该接口可以在不牺牲已有通用能力的前提下获得。
为什么相对末端位姿是合理接口
PEAR 输出相对下一末端执行器位姿,而不是关节角度或未来动作块。这一选择把视觉语言模型最擅长的部分保留在模型内:识别目标、判断方向、决定先移动哪只手、根据反馈修正。它也把最不适合语言模型学习的部分移出去:逆运动学、关节限位、速度约束与实时控制。
相对位姿还降低了 sim-to-real 的接口差异。仿真器与真实机器人可以使用不同关节数量、相机位置和控制频率,只要都把“沿某个方向移动某个具名末端”解释成相对变换。模型不必背住每台机器人的绝对坐标,也不必知道仿真器内部的刚体编号。这种语义稳定性正是同一 JSON 协议能够连接 LIBERO、RoboDojo 与 YAM 的原因。
接口的抽象层次也有限。相对位姿无法表达力控、柔顺装配、灵巧手内操作或高动态接触。若任务需要判断“夹爪是否夹紧”或控制接触力,仅凭图像和位姿很难闭环。PEAR 的积木对齐失败与球滚走失败正好展示了这一边界。更丰富的工具接口可以加入力矩、夹爪宽度和触觉反馈,但那会扩大动作空间并增加训练难度。
计算成本:50,000 H100 小时意味着什么
论文报告训练约消耗 50,000 个 H100 等效 GPU 小时。这是一个必须正面讨论的数字。它说明“仅用仿真 RL”不等于低成本:没有人工演示,代价转移到了海量 rollout、长上下文推理、异步调度和重复图像编码。若按云 GPU 价格粗略折算,单次完整训练就是六位数美元量级,远非普通实验室可以随手复现。
长上下文是成本放大器。每个回合平均 94k token,每次策略更新又要多组多 rollout 比较。相比标准语言模型 RLHF,PEAR 的样本不是短对话,而是包含几十张图像和几十次工具调用的完整执行记录。LMCache、异步回放和组过滤因此不是锦上添花,而是让训练在预算内可执行的基础设施。
成本还意味着研究结论的生态影响。只有少数团队能重复 27B、340 步、1024 条组批次的完整实验。公开代码提高了透明度,但如果没有权重、数据缓存和更小规模配方,社区难以验证每个设计选择。未来更值得追求的不一定是更大模型,而是能显著降低 rollout 成本的课程、缓存与状态压缩方法。
与模仿学习和端到端 VLA 的关系
PEAR 不是要否认模仿学习。示范数据在真实机器人上仍然高效,尤其适合接触丰富、难以用奖励描述的任务。PEAR 提供的是一种不同的问题设定:当任务可以由仿真器稳定判定、机器人具备可靠低层接口、且环境可以大规模并行时,能否绕过人工示范,直接优化任务成功。
与端到端 VLA 相比,PEAR 把“策略”拆成推理模型和工具接口。优势是动作语义清楚、可调用 IK、可逐轮纠错、任务规则写在提示中;劣势是推理延迟高、依赖视觉与状态反馈、长历史昂贵,而且必须保证解析器和控制器稳定。它不是端到端策略的全面替代,更像是一种高层机器人使用代理。
与 π0.5 等模型的结果差异也需要谨慎解读。PEAR 在 LIBERO-Pro 和布局变化上更高,可能因为它在每一步重新读取环境并显式规划;但如果任务要求快速连续接触控制,动作块策略可能更有优势。论文没有在同一个真实平台上比较端到端 VLA 与 PEAR 的真实成功率,因此两种范式的优劣仍取决于任务与接口。
作者自述局限
仿真到现实仍有差距。作者承认真实实验规模有限,且零样本迁移没有达到仿真中的稳定性。最终模型 60% 的真实成功率以及 12 次具体失败,直接证明了视觉、接触和动力学差异仍然存在。
长上下文限制明显。完整 RoboDojo 中 370/540 个回合耗尽 256k 上下文,是最强的作者可见限制。模型即使能持续调用工具,也可能因历史过长而无法完成。论文没有给出压缩策略在完整集合上的恢复效果。
动作接口受到约束。PEAR 只输出相对末端位姿,底层 IK 和控制由外部负责。它无法直接处理需要精细力控、触觉反馈或灵巧手内操作的任务。真实失败中的未对齐、碰倒和滚动都落在这个边界附近。
评测覆盖有限。真实机器人只在一个双臂平台和有限积木任务上测试,30 次试验不足以建立可靠泛化结论。LIBERO、RoboDojo 与 YAM 的差异也无法通过一个总体成功率完全拆开。
计算门槛高。50,000 H100 等效小时使完整训练难以广泛复现。代码公开有助于审计,但模型权重、训练缓存和完整运行配置是否足以让第三方重跑论文数字,仍需独立验证。
独立局限与风险判断
奖励只给终点的归因问题。二值成功奖励无法告诉模型哪一轮出错。GRPO 只能比较同组轨迹整体优劣,成功的轨迹可能包含偶然正确但不可复现的步骤,失败的轨迹也可能包含大量正确动作。过程验证器、关键帧奖励或失败分类可以显著改善学习效率,但论文没有系统评估这些替代方案。
比较公平性仍需审计。PEAR 使用更强基座、更长推理预算和显式工具接口,而部分基线可能是动作块策略或少样本代理。即使任务与仿真器相同,信息接口、推理时延和工具可靠性也可能不同。论文报告的数字有参考价值,但不能直接推出“RL 优于模仿学习”这一过宽结论。
真实安全性没有建立。外部 IK 和控制器可以限制关节范围与速度,但模型仍可能选择错误物体、碰撞相邻物或反复执行无效动作。真实实验看起来处于受控环境且有监督;开放环境部署还需要碰撞检测、力矩上限、工作空间监控、急停和人工接管。
协议脆弱性会放大到硬件。严格 JSON 在训练中可由解析器拒绝,但真实工具层若对数值范围、单位或坐标系处理不一致,仿真中合法的请求也可能产生危险运动。实现必须在工具边界做独立校验,不能因为模型经过 RL 就信任其输出。
上下文压缩可能改变能力。若为降低推理成本而摘要历史,模型可能丢失早期物体状态或失败原因;若保留全部图像,成本又会迅速上升。论文尚未回答“哪些历史真正必要”。这将是长上下文机器人代理从展示走向产品的主要系统问题之一。
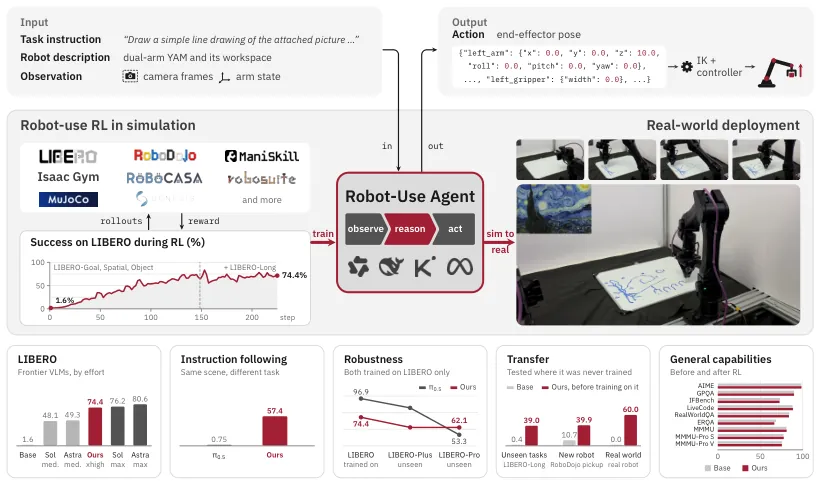
图 3:论文图 1,PEAR 如何把仿真强化学习、工具协议、长上下文推理与真实机器人连接起来。
工程复现要点
若要基于公开代码复现实验,第一步应固定论文提交与依赖,验证协议解析器的单元行为,确认错误 JSON 会被拒绝而不会被宽松修补。第二步应先用少量任务跑通观察、动作、IK、图像回传和结束信号,再检查每个工具的真实语义是否与仿真训练一致。模型输出合法并不代表工具执行正确,接口契约必须逐项测试。
第三步应记录每条 rollout 的终止原因、上下文长度、工具调用次数和组成功率。只记录最终奖励会让上下文耗尽、格式失败和错误动作混在一起。PEAR 的完整 RoboDojo 结果已经说明,终止原因分布可能比成功率更有诊断价值。还可以对同一条成功轨迹重放,验证视觉输入与动作日志是否可独立复现。
第四步应做最小化消融:固定模型与数据,分别去掉组过滤、评分中心化、LMCache、RoboDojo 阶段和异步训练,观察成功率、有效样本率、吞吐和上下文耗尽率。论文提供了训练配方,但公开摘要不足以证明每个组件都是必要且充分的。复现工作最有价值的贡献,可能是找到更便宜的长上下文训练组合。
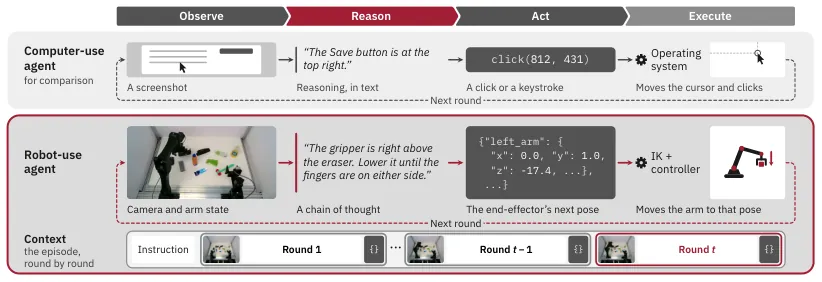
图 4:论文图 2,一个机器人使用回合中的观察、推理、工具调用与反馈。
研究意义
PEAR 最重要的意义是把机器人学习从“让模型背动作”推进到“让模型学会使用一套机器人能力”。在仿真中,模型通过反复失败学会何时观察、怎样表述相对位姿、何时停止;在真实系统中,只要工具接口保持一致,这些行为就可以直接运行。这与传统端到端策略的知识形态不同,也为机器人基础模型提供了另一条抽象层。
第二个意义是把长上下文推理模型真正放进闭环,而不是只让它在任务开始前写计划。每一步的结果都会改变下一步输入,模型必须维护世界状态、识别失败并重新调用工具。LIBERO 从 1.6% 到 74.4% 的跃迁说明,预训练语言能力本身不足以产生稳定机器人使用;可验证奖励和接口约束才是把通用模型变成操作代理的关键。
第三个意义是公开代码让系统细节可以被审计。论文之外,解析器、提示、工具调用、回放缓冲、配置和缓存实现都能阅读。这让读者可以区分“论文宣称的算法”和“实际运行的算法”,也能发现长上下文代理的工程成本。即使结果尚未完全复现,公开代码本身已经提高了研究的可讨论性。
总结与展望
PEAR 用一个明确但代价高昂的实验回答了问题:27B 推理模型只靠仿真 RL 就能学会机器人工具使用,并把部分能力零样本迁移到真实机器人。仿真成功率从 1.6% 到 74.4%,真实双臂成功 18/30,跨场景任务也有明显增益;与此同时,Long 任务仅 53.2%,完整 RoboDojo 大量上下文耗尽,真实失败集中在对齐、碰撞和动力学,说明系统仍处于能力验证阶段。
后续研究应优先解决三件事。第一,压缩长历史并显式表示物体状态、已完成子目标和失败原因,让上下文预算不再成为主要失败源。第二,引入更丰富的工具反馈,如夹爪宽度、力矩、触觉和碰撞事件,使模型能判断“看起来对齐”与“实际接触成功”的差别。第三,扩大真实机器人评测并公开失败日志,按任务、物体、初始状态和终止原因拆分结果。
从更长的技术路线看,PEAR 提供了“推理模型作为机器人使用层”的原型。它不替代低层控制,也不要求所有能力都来自同一个网络,而是学习一套可验证的调用协议。若未来能把成本、上下文和接触反馈补齐,这种方法可能比端到端动作模型更适合那些工具丰富、任务可分解、需要频繁重规划的真实机器人系统。