PAPER DEEP DIVE
RoboDuet:面向四足机器人全身移动操作的双策略协同学习
RoboDuet 让腿部与机械臂两套策略互相传递姿态引导信号,在真实四足机器人上实现大范围六自由度末端跟踪与跨平台零样本迁移。
论文元信息
论文:RoboDuet: Learning a Cooperative Policy for Whole-body Legged Loco-Manipulation
作者:Guoping Pan、Qingwei Ben、Zhecheng Yuan、Guangqi Jiang、Yandong Ji、Shoujie Li、Jiangmiao Pang、Houde Liu、Huazhe Xu。
论文链接:https://arxiv.org/abs/2403.17367。本文解读依据 arXiv v5 全文、论文 LaTeX 源文件与项目公开代码。
代码与项目页:代码已开源,仓库为 locomanip-duet/RoboDuet,项目演示页为 locomanip-duet.github.io。
一句话总结:RoboDuet 让腿部与机械臂两套策略互相传递姿态引导信号,在真实四足机器人上实现大范围六自由度末端跟踪与跨平台零样本迁移。
研究背景与问题
轮式移动底盘已经在仓储、服务与家庭场景中大量部署,但底盘高度固定、接触方式单一,遇到台阶、坡面、碎石或需要改变机身姿态的空间时,机械臂的可达范围会迅速受限。四足机器人能通过改变机身高度和俯仰、横滚角来扩展操作空间,因此“腿负责移动、机械臂负责操作”的简单分工并不足够,控制真正困难的部分在于两者必须在同一时刻协调。
如果直接把四足机器人的十二个腿部关节和机械臂的六个关节交给一个大网络,策略需要同时学习步态、平衡、逆运动学、接触稳定和六维末端跟踪。论文将这类做法称为统一策略。统一策略的输出空间大,不同任务的奖励尺度也不一致;腿部奖励关注速度、足端落点和机身稳定,机械臂奖励关注末端位置与姿态,训练早期很容易出现一方主导优化的现象。
另一条常见路线是把机械臂固定在四足机器人背上,把底盘当作可移动平台,再调用逆运动学求解器控制机械臂。论文中的浮动基座加逆运动学基线就是这种思路。它在机械臂可达且无碰撞时工作良好,但不会主动压低、倾斜或转动机身,也无法在末端目标靠近腿部时调整足端位置,所以“能移动”与“能操作”仍然是两个松散拼接的模块。
RoboDuet 关注的不是高层任务规划,而是低层全身控制器。输入包含基础速度命令、目标末端六维位姿和机器人状态,输出是十二个腿部目标偏移、六个机械臂目标偏移,以及两个控制机身俯仰和横滚的引导量。它要解决的核心问题是:在不让两个子系统互相破坏的前提下,让机械臂的动作要求反过来改变四足机器人的机身姿态与落脚方式。
论文的切入点是把“协同”压缩成一条低带宽通道。机械臂策略并不把完整内部特征广播给腿部策略,而是额外输出两个机身姿态引导值,用它们替换原有的俯仰、横滚命令。腿部策略继续沿用第一阶段获得的稳定运动先验,机械臂策略则学习六自由度跟踪。这样既保留模块分工,又允许机械臂主动请求机身改变姿态。
机器人系统与任务定义
实验平台由十二自由度 Unitree Go1 Edu、六自由度 ARX5 机械臂和安装在夹爪上方的 RealSense D435i 相机构成。Go1 重十二千克,ARX5 重三点三五千克,额定负载一点五千克,最大伸展约六百二十毫米。训练与部署控制频率都是五十赫兹,这对策略的输入历史和动作平滑性提出了实际要求。
腿部策略跟踪的指令写作 $\mathbf{c}_t=(v_x^{cmd},v_y^{cmd},\omega_{yaw}^{cmd},\phi_{pitch}^{cmd},\phi_{roll}^{cmd})$。前三个量规定机身坐标系下的线速度与偏航角速度,后两个量规定机身俯仰与横滚。与传统 locomotion 只控制速度不同,这里把机身姿态也作为可命令量,因为它决定了机械臂基座在空间中的朝向。
机械臂策略跟踪的是九维末端目标表示 $\chi_t$,其中位置用半径、纬度和经度描述,姿态用六维旋转表示。输出被刻意拆成两部分:前六个动作是机械臂关节目标偏移,后两个动作是机身姿态引导。执行时先让机械臂策略产生引导,再由腿部策略据此生成十二维腿部动作,最后把腿动作与机械臂前六个动作拼成十八维控制向量。
方法:两个策略如何形成一支二重奏
第一阶段先训练 locomotion 策略。机械臂在全部训练中固定在默认关节位置 $[0,0.8,0.8,0,0,0]$,这样腿网络从最开始就感受到机械臂质量、惯量和重心偏移。若先训练空载四足再突然加载机械臂,腿部策略会面对明显的动力学分布变化。固定机械臂也不是为了让问题变简单,而是把“先获得可靠移动能力”与“再学习协同操作”分开。
步态由行为参数向量描述,论文给出:
$$ \mathbf{b}_t=[\theta_1^{cmd},\theta_2^{cmd},\theta_3^{cmd},f^{cmd},h_z^{cmd},\phi^{cmd},s^{cmd},h_z^{f,cmd}] $$
其中 $\theta_i^{cmd}$ 是四足之间的相位偏移,$f^{cmd}$ 是步频,$\phi^{cmd}$ 是机身姿态命令,$s^{cmd}$ 是足端 clearance,$h_z^{f,cmd}$ 是抬脚高度。论文为加快收敛把部分参数固定:相位为 $[0.5,0,0]$,形成稳定 trot,步频三赫兹,抬脚高度零点零六米。
为了显式告诉策略当前处于步态周期中的哪个位置,输入加入四足时钟:
$$ \mathbf{t}_t=[\sin(2\pi t^{FR}),\sin(2\pi t^{FL}),\sin(2\pi t^{RR}),\sin(2\pi t^{RL})] $$
四只脚的相位由偏移量共同决定:
$$ [t^{FR},t^{FL},t^{RR},t^{RL}] = [t+\theta_2^{cmd}+\theta_3^{cmd}, t+\theta_1^{cmd}+\theta_3^{cmd}, t+\theta_1^{cmd}, t+\theta_2^{cmd}] $$
当基础速度指令为零时,策略把四个时钟量设为 $[1,1,1,1]$,强制四足停止原地踏步。这个细节直接影响操作精度:机器人静止抓取物体时,持续踏步会把微小机身抖动传给机械臂,使末端难以稳定在毫米级目标附近。
腿部奖励沿用 blind locomotion 的主体设计,但去掉了机身高度跟踪项,使机身高度能根据任务自动调整。另一个关键改动是加入能耗惩罚,因为背部机械臂增加了腿部电机负载,长时间工作会带来发热风险。论文使用的能耗项为:
$$ r_{energy}^{loco}=-0.00004\sum_i|\tau_i\dot q_i|^2 $$
这里 $\tau_i$ 和 $\dot q_i$ 分别是第 $i$ 个腿部关节的力矩与角速度。平方和会同时惩罚大扭矩与快速运动,抑制机械臂负载下的高功率动作,而不只是追求速度跟踪。
第二阶段同时激活两个策略,但保持输入输出维度不变。机械臂策略的观测包括机械臂关节状态、目标末端位姿、机身姿态和上一时刻动作。它的前六个输出进入机械臂 PD 控制器,后两个输出经过 $\tanh$ 限制在 $[-1,1]$,经环境中的零点四倍缩放后,分别替换腿策略的 pitch 与 roll 命令。腿策略不必理解完整机械臂轨迹,只需响应这两个姿态请求。
这个设计的信息通道很窄,却恰好对应全身控制的物理需求。机械臂要实现更高的抓取点,需要机身抬头或抬升;要抓取低位目标,需要机身低头或降低;要绕开腿部,则需要横滚或改变足端位置。两个引导值可以看作机械臂向腿部发出的“姿态意图”,腿部策略仍保留对平衡、落脚和速度的控制权。
末端的姿态采样先由 Z-Y-X 欧拉角构造旋转矩阵,再转换为各坐标轴夹角,以减少机身旋转对目标表示的影响:
$$ R=R_{yaw}R_{pitch}R_{roll} = \begin{bmatrix} r_{11}&r_{12}&r_{13}\\ r_{21}&r_{22}&r_{23}\\ r_{31}&r_{32}&r_{33} \end{bmatrix} $$
$$ [\alpha,\beta,\gamma] = [\tan^{-1}(r_{21}/r_{11}), \tan^{-1}(r_{32}/r_{22}), \tan^{-1}(r_{13}/r_{33})] $$
目标跟踪奖励把位置误差和姿态误差分别映射到指数函数,避免某一项在高误差时完全压住另一项:
$$ r_{\chi_t}=e^{-w\Delta(l,p,y)}e^{-\Delta(\alpha,\beta,\gamma)} $$
$$ \Delta(l,p,y)=\sum_{u\in\{l,p,y\}}k_u|u_t-u^{cmd}| $$
$$ \Delta(\alpha,\beta,\gamma)=\sum_{u\in\{\alpha,\beta,\gamma\}}k_u|u_t-u^{cmd}| $$
式中 $k_u$ 取对应采样范围的倒数,把不同量纲的误差统一到相近尺度;$w$ 调节位置和姿态的相对优先级。第二阶段还把速度跟踪奖励减半,并用髋关节约束奖励替换第一阶段中较严格的 Raibert 足端落点跟踪项,从而允许足端为全身姿态调整让出空间。
flowchart LR
  A[目标末端六维位姿] --> B[机械臂策略]
  S1[机械臂关节状态] --> B
  S2[机身姿态] --> B
  B --> C[六维关节目标偏移]
  B --> D[俯仰与横滚引导]
  D --> E[替换腿部姿态命令]
  E --> F[第一阶段腿部策略]
  F --> G[十二维腿部动作]
  C --> H[拼接为十八维动作]
  G --> H
  H --> I[腿力矩与机械臂关节目标]
  I --> S1
  I --> S2
图 1:RoboDuet 实际训练与执行关系。机械臂策略的末两维不直接驱动电机,而是替换腿部策略的机身姿态命令。
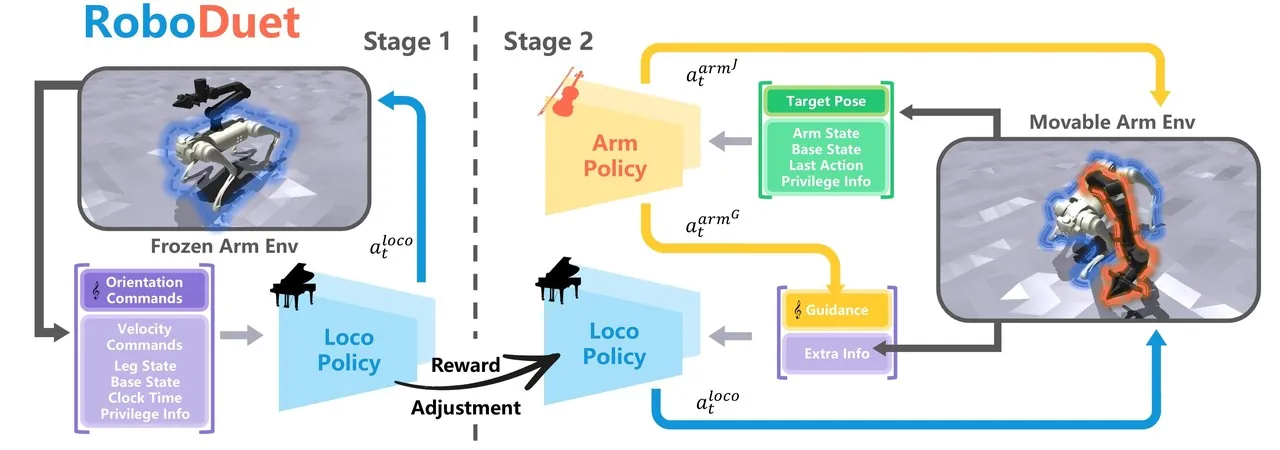
图 2:论文中的 RoboDuet 架构。第一阶段固定机械臂训练腿部策略,第二阶段同时训练两套策略并引入奖励调整。
训练配置
所有方法使用 IsaacGym 并行训练四千零九十六个智能体,算法为 PPO,总计五万次迭代,并在三个随机种子上重复。两阶段方法把一万次迭代分配给第一阶段,剩余四万次用于第二阶段。网络使用带 ELU 激活的多层感知机,双策略网络隐藏层规模依次为 512、256、128;统一策略把特征提取器合并,因此隐藏层宽度加倍。
训练和评估的目标范围不同。训练时末端半径为零点三到零点七米,评估扩展到零点二到零点八米;俯仰、经度、横滚和偏航等角度也扩大抽样范围。评估从扩展空间中均匀采样二十万个目标,成功率要求位置误差不超过零点零三米、姿态夹角不超过 $\pi/36$;允许四秒到达目标,再计算随后两秒的平均误差。
生存率测试会对机身施加十到二十牛顿的外部力,持续两秒,并检查机身高度是否高于零点二六米。可解率定义为全程无自碰撞且最终达到阈值的目标比例;工作空间则统计满足误差与碰撞条件的目标凸包体积。因此,论文不是只报告一个“抓取成功率”,而是把精度、稳定性、可解空间和抗扰动拆开评估。
| 部件 | 参数 |
|---|---|
| Unitree Go1 Edu | 12 自由度,整机 12 kg |
| ARX5 机械臂 | 6 自由度,3.35 kg,额定负载 1.5 kg,最大伸展 620 mm |
| 相机 | RealSense D435i,固定安装在夹爪上方 |
| 控制频率 | 训练与部署均为 50 Hz |
| Go1 加 ARX5 系统质量 | 论文实机迁移段给出 18.35 kg |
| Go2 加 ARX5 系统质量 | 论文实机迁移段给出 21.05 kg,比 Go1 系统重 14.7% |
仿真结果:协同策略与两阶段训练分别贡献什么
消融实验把 RoboDuet 拆成四种组合:直接从第二阶段训练的统一策略、采用两阶段训练的统一策略、直接训练的双策略协同模型,以及同时采用双策略和两阶段训练的 RoboDuet。这样可以把“策略是否解耦”和“是否利用运动先验”分开观察,而不是只比较最终总分。
两阶段训练最明显的作用是抗扰动。静止模式下,两阶段统一策略的生存率从统一策略的 87.35% 升到 95.66%,提高 8.31 个百分点;移动模式下也从 93.03% 升到 99.09%。这说明第一阶段形成的稳定步态并没有因为第二阶段引入机械臂目标而消失,反而给后续联合训练提供了可靠起点。
协同机制主要扩展工作空间与改善姿态跟踪。直接训练的 Cooperated 模型在静止位置误差上最好,但生存率低于 RoboDuet,说明它在缺乏步态先验时更激进地追求跟踪奖励。RoboDuet 没有在每一项误差上夺冠,却把 98.20% 的静止生存率、99.96% 的移动生存率与较大的移动工作空间放在同一套控制器里,这种综合平衡更接近实机需求。
| 方法 | 静止生存率 | 静止工作空间 | 移动生存率 | 移动工作空间 |
|---|---|---|---|---|
| Unified | 87.35% | 0.5136 | 93.03% | 0.7896 |
| Two-Stage | 95.66% | 0.6010 | 99.09% | 0.8130 |
| Cooperated | 94.49% | 0.8408 | 98.56% | 0.8671 |
| RoboDuet | 98.20% | 0.8579 | 99.96% | 0.8705 |
与浮动基座加逆运动学的比较更能说明全身控制的来源。两者放在相同误差阈值下评估,RoboDuet 的可解率提高 14.83%。机械臂本身的尺寸没有改变,但机器人可以通过改变机身姿态和足端位置,把原本落在逆运动学可达边界之外的目标纳入可解范围。
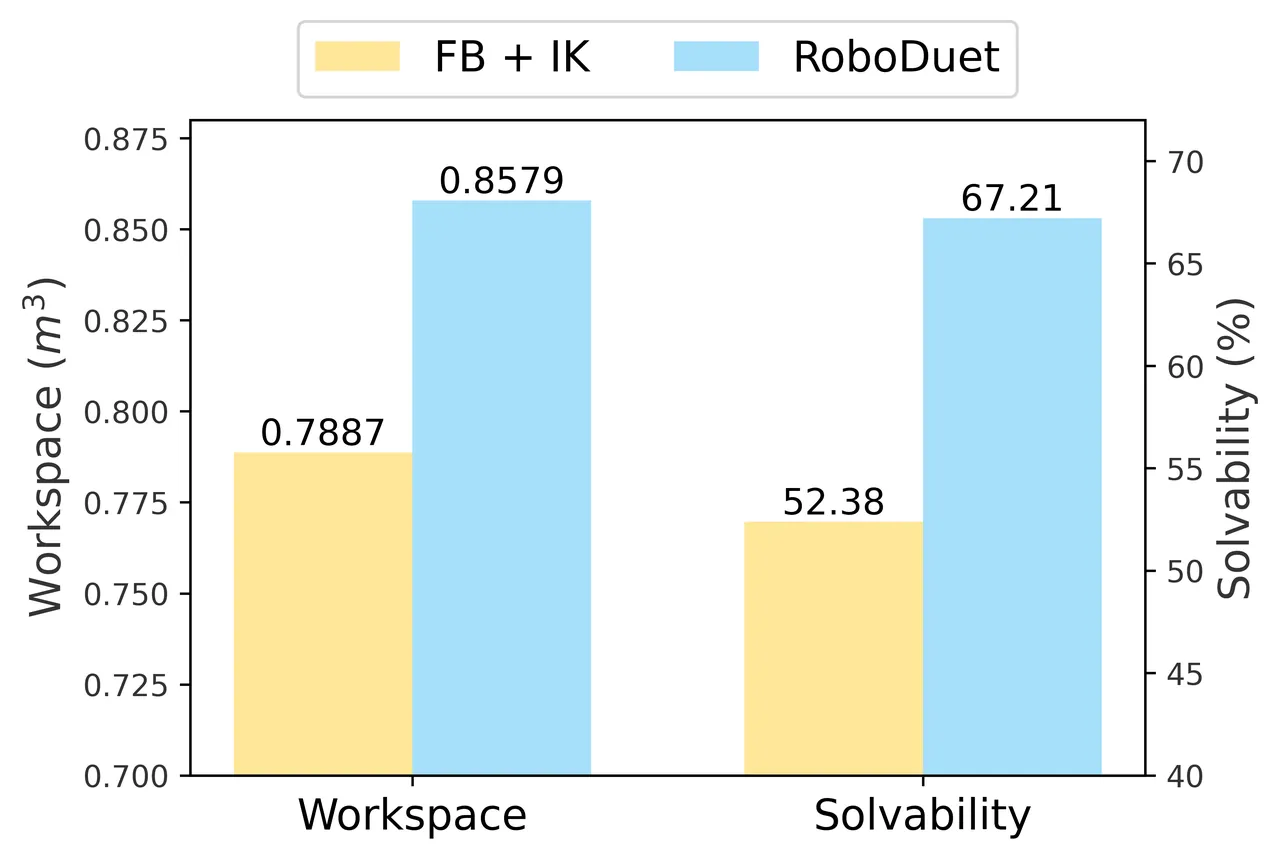
图 3:相同误差阈值下,RoboDuet 在可解率与工作空间上优于浮动基座加逆运动学。
零样本迁移实验把 Go1 加 ARX5 训练出的策略直接部署到 Go2 加 ARX5 与 A1 加 ARX5。静止条件下,新平台仍保持约 0.84 到 0.86 的工作空间和 96% 以上的生存率;移动条件下,Go2 与 A1 的工作空间降到约 0.81 到 0.82,但受扰动后的生存率仍分别有 93.21% 和 94.34%。迁移不是完全没有代价,论文也明确指出只有 Go1 使用为自身定制的协同策略。
| 平台 | 静止工作空间 | 移动工作空间 | 静止生存率 | 移动生存率 |
|---|---|---|---|---|
| Go1 | 0.8579 | 0.8705 | 98.20% | 99.96% |
| Go2 | 0.8552 | 0.8216 | 96.32% | 93.21% |
| A1 | 0.8416 | 0.8121 | 97.07% | 94.34% |
实机结果:极限位姿与跨高度搬运
极限六维位姿实验包含五个目标,其中两个贴近地面并与腿部空间相交,两个显著高于训练采样范围,第五个位于机械臂最大伸展附近且朝向机器人头部。每个目标重复八次。浮动基座加逆运动学在三个目标上求解失败,整体逆运动学失败率为 60%;由于不会调整机身或腿脚,它的自碰撞率为 50%。RoboDuet 没有求解器失败这一项,自碰撞率降到 5%。
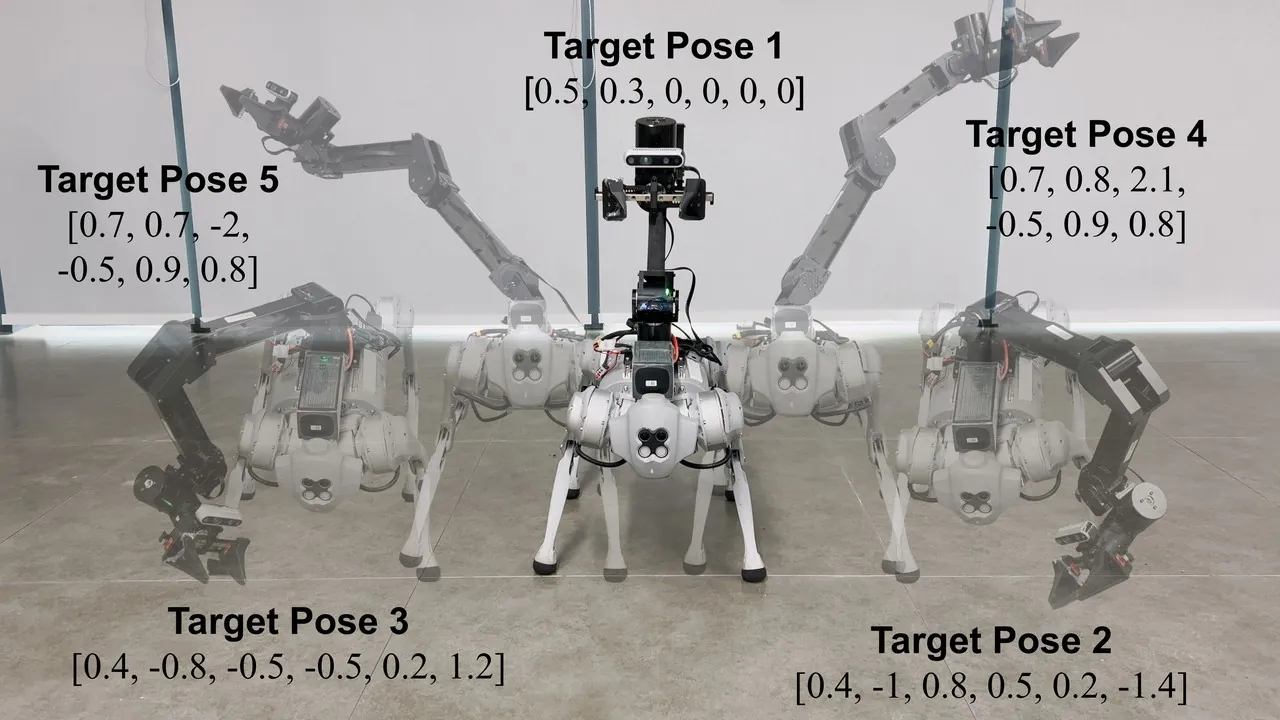
图 4:五个极限六维目标。对于部分物理上不可达的目标,策略给出稳定近似解,而不是让机器人失稳。
跨高度搬运任务要求机器人把玩偶依次从地面搬到二十厘米、六十厘米和一百厘米的平台,再取回。每个高度由三名操作者各重复五次,因此每个区间共十五次。成功条件是全程不掉落并完成放置或取回。操作者通过 VR 手柄控制速度与末端目标,这部分仍然是遥操作,不是自主抓取。
| 方法 | 0 到 20 cm | 20 到 60 cm | 60 到 100 cm | 100 到 0 cm | 总计 |
|---|---|---|---|---|---|
| FB+IK | 3/15 | 7/15 | 0/15 | 0/15 | 10/60 |
| AFB+ID | 9/15 | 13/15 | 6/15 | 4/15 | 32/60 |
| RoboDuet | 10/15 | 12/15 | 8/15 | 9/15 | 39/60 |
按总成功次数计算,RoboDuet 为 65.0%,AFB+ID 为 53.3%,相差约 11.7 个百分点。论文摘要与引言中“至少 23% 提升”的口径,是更困难搬运任务上的相对提升,不能被误读成所有任务都提高了二十三个百分点。原创解读必须保留这个统计口径差异,否则会把论文结果说得比实验更夸张。
高位平台任务最能体现机身倾斜的价值。机械臂要在接近最大伸展处维持水平或俯视姿态,逆运动学经常找不到可行解。RoboDuet 通过压低或倾斜机身缩短基座与桌面的垂直距离,最终在 100 厘米到 0 厘米的取回区间完成 9/15 次,而 AFB+ID 完成 4/15 次。低位抓取则更能体现避免自碰撞的能力。
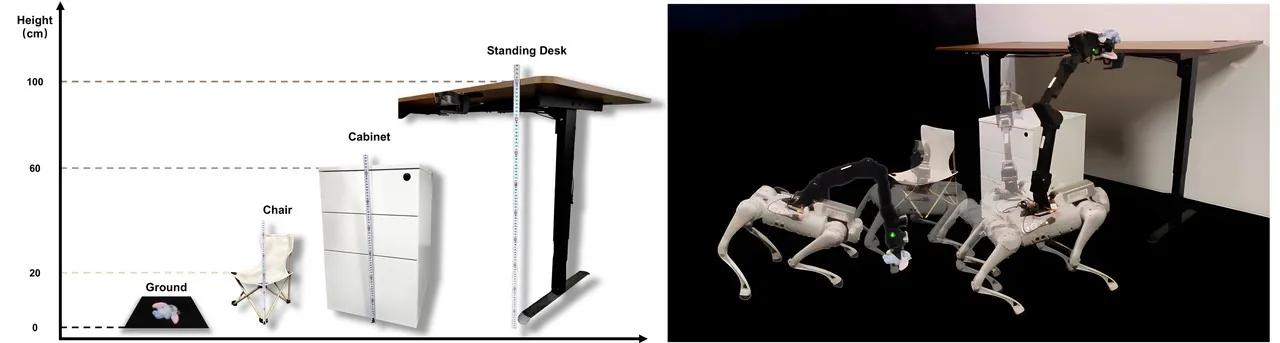
图 5:跨高度搬运需要机械臂与腿部共同改变机身位置、姿态和足端支撑。
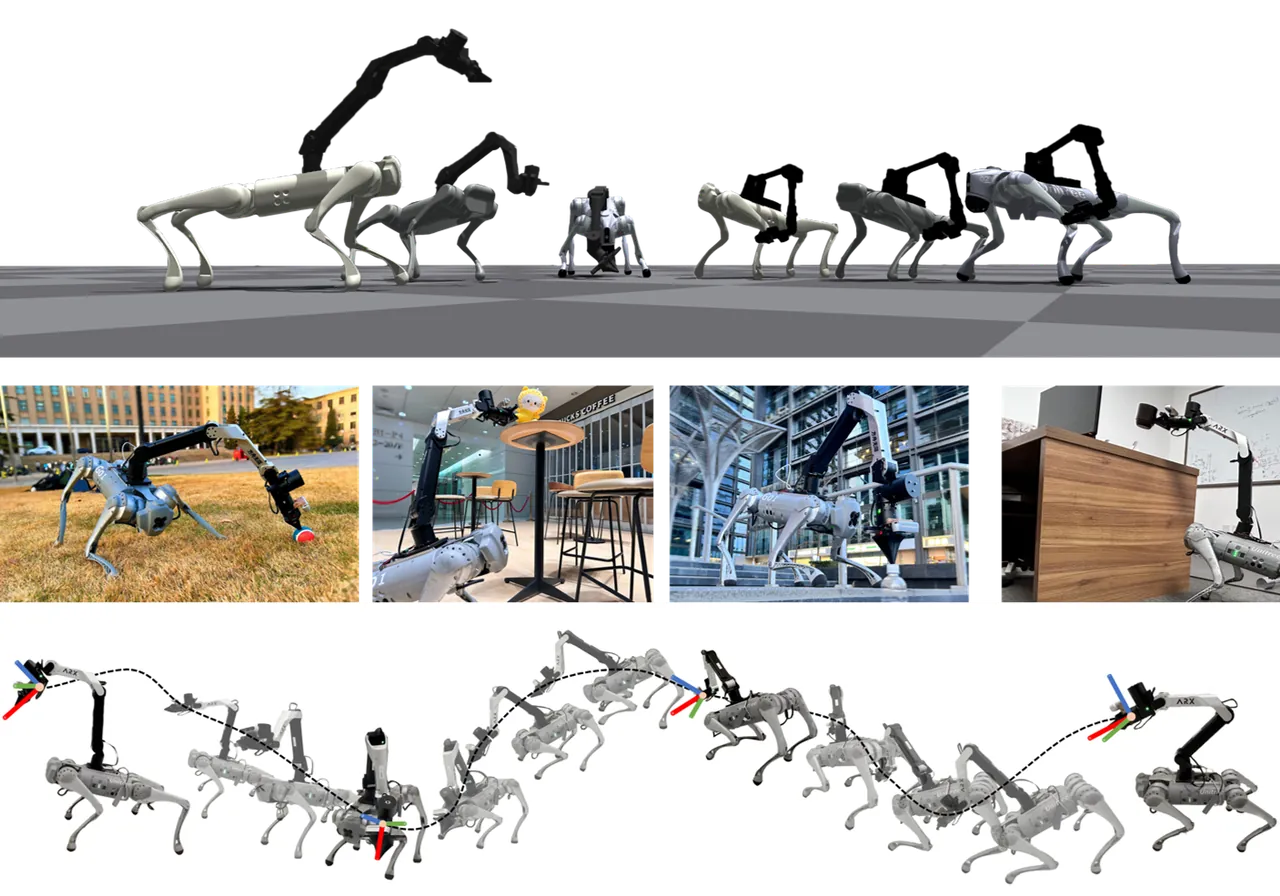
图 6:RoboDuet 覆盖多平台迁移、真实移动操作与全身姿态调整三类能力。
实机零样本迁移从 Go1 加 ARX5 直接部署到 Go2 加 ARX5。系统质量从 18.35 千克增加到 21.05 千克,增重 14.7%,但没有重新训练第二阶段策略。论文用同一轨迹展示两端末端的四维跟踪与协调姿态,说明该方法的模块边界可在相似形态和尺寸范围内复用。
代码对应:论文方法如何落到实现
代码中最能确认双策略接口的位置是训练循环。机械臂策略先执行,随后把最后两个动作送入环境的 plan,再执行腿部策略,最后把腿部动作与前六个机械臂动作拼接。这与论文的文字描述完全一致,而不是事后根据摘要推测。
actions_arm = self.alg_arm.act(...)
self.env.plan(actions_arm[..., -self.env.num_plan_actions:])
actions_dog = self.alg_dog.act(...)
ret = self.env.step(actions_dog,
                    actions_arm[..., :-self.env.num_plan_actions])
文件 go1_gym_learn/ppo_cse_automatic/__init__.py 的这段实现表明,后两个值只在环境规划中被消费,不直接进入机械臂关节目标。部署脚本也明确把最后两维拆分出来送给 env.plan。
actions_arm = arm_policy(obs)
env.plan(actions_arm[..., -2:])
actions_dog = dog_policy(dog_obs)
env.step(actions_dog, actions_arm[..., :-2])
配置层定义机械臂执行动作数为六、策略输出维度为八,并在 legged_robot_config.py 中把整机动作数设为十八。混合控制器对十二个腿部关节返回 PD 力矩,对机械臂关节返回位置目标,这解释了为什么拼接后的十八维动作在仿真与实机都成立。
num_actions_arm = 6
num_actions_arm_cd = 8
num_actions = 18
训练脚本用 pretrained_to_hybrid_start = 10000 标出第二阶段起点,并在前一万次迭代保持机械臂固定。第二阶段环境把机械臂引导经 rescaled_obs = obs * 0.4 缩放,再把第一、第二维写入腿策略的 pitch 与 roll 命令。代码层面的这些限制,使正文中的公式和数据都能回溯到具体实现。
局限与风险评估
作者明确说明,RoboDuet 只负责低层全身控制。要实现完全自主的任务执行,还需要上层规划器和更强的碰撞检测。论文实机实验使用 VR 手柄控制速度与末端目标,因此“机器人能够完成搬运”不等于“机器人能够自主发现、定位并抓取物体”。
地形能力也有限。方法能够在坡面和碎石上维持固定末端目标,但尚未展示楼梯上的移动操作。由于楼梯同时要求抬腿、落脚、机身俯仰和末端稳定,策略必须处理更高频的接触变化,这与平面或缓坡上的协同控制并不相同。
零样本迁移的边界是形态和尺寸相近的四足平台。作者称其为 zero-shot transfer,但实验只覆盖 Go1、Go2、A1 三个相近平台,且只有 Go1 使用为其定制的第二阶段策略。迁移后移动工作空间与生存率都有下降,因此不能把结果推广到任意机器人或任意机械臂组合。
实机样本量也需要谨慎解释。极限位姿为五个目标各八次,跨高度任务为每段十五次,均由三名操作者完成。这样的规模足以证明系统在这些特定任务上可行,但还不足以估计不同光照、地面摩擦、物体形状和操作者习惯下的稳健性。论文没有展示感知到动作的闭环自主性,相机在系统中更多承担平台配置与后续扩展角色。
结论与展望
RoboDuet 的核心并不是简单增加网络容量,而是把全身控制拆成两个可以互相请求、但不能互相覆盖的策略。腿部策略保留移动与平衡的主动权,机械臂策略保留六维跟踪的主动权,两者通过两个姿态引导值形成低带宽协同。第一阶段提供稳定步态先验,第二阶段再学习如何让机身为机械臂让位。
实验结果支持这一设计:双策略比统一策略获得更大的工作空间,两阶段训练显著提高抗扰动能力,极限位姿自碰撞率从 50% 降到 5%,跨高度搬运总成功次数达到 39/60。更重要的是,训练出的控制器能够直接迁移到质量增加 14.7% 的 Go2 平台,说明模块化协同不只改善单一平台指标,也降低了更换相似硬件的成本。
下一步最有价值的方向是把低层控制器接入真正的视觉定位、任务规划与自主碰撞检测。另一个方向是扩展到楼梯、不规则接触和动态障碍,让两个引导维度之外再形成足端落脚与机身姿态的联合规划。只有当感知、规划和低层控制形成闭环,RoboDuet 这类全身控制框架才会从高质量遥操作工具走向自主移动操作机器人。
RoboDuet 的关键不是让机械臂“长在”四足机器人上,而是让机械臂的动作能够请求腿部改变整个身体;协同发生在姿态指令层,而不是把所有关节塞进同一个网络。