PAPER DEEP DIVE
基于注意力神经地图编码的敏捷泛化足式运动
本文提出一个统一的强化学习框架,用于兼顾敏捷与泛化的足式运动。核心是一个注意力地图编码器(AME-2):在提取局部地图特征的同时计算全局地形上下文,并用全局上下文调制局部特征,生成可解释、可泛化的策略嵌入。感知侧提出一套轻量神经建图管线,把深度观测转成带不确定性的局部高程估计并与里程计融合,显式建模噪声与遮挡,且能在并行仿真中以同一份代码运行,便于 sim-to-real 迁移。在四足 ANYmal-D 与双足 TRON1 上验证:控制器零样本穿越未见地形,兼具敏捷性与泛化能力。
论文元信息
标题:Agile and Generalized Legged Locomotion via Attention-Based Neural Map Encoding(基于注意力神经地图编码的敏捷且泛化足式运动)
作者:Chong Zhang、Victor Klemm、Fan Yang、Marco Hutter(ETH Zurich 机器人与系统实验室 Robotic Systems Lab;通讯作者 chong.zhang@ai.ethz.ch;作者亦隶属 Secure, Reliable, and Intelligent Systems Lab 与 ETH AI Center)
链接:arXiv:2601.08485v3 [cs.RO],2026-09-07 更新;全文 https://arxiv.org/abs/2601.08485;项目主页 https://sites.google.com/leggedrobotics.com/ame-2 ;结果视频 https://www.youtube.com/watch?v=FNA1crvtBLs
代码状态:已发布最小复现仓库 github.com/leggedrobotics/ame2_minimal(约 78 star / 3 fork,GPL-3.0,2026-10-05 建仓)。它是一个 Isaac Lab 扩展,主打 Unitree G1 的教师策略训练,并附带 AME-1 与 MoE 两个对照实现、可选 TAGA 式主动视野变体,以及一个 G1 教师 checkpoint(modelzoo/g1_gaze_64000env_10h)。作者在 README 里明确写着「half-archived as a reference to a finished work」「No feature contribution」;论文 ANYmal-D / TRON1 那条链路的三块——Mid-360 激光神经建图入环、G1 学生训练、建图模型权重——被划线标注「unavailable until the next paper release」。因此策略侧与奖励/终止逻辑、概率胜者全取的融合代码可以逐行读,学习型建图网络的权重尚未放出。
一句话总结
AME-2 在注意力地图编码器上多接了一路「全局地形上下文」,用它去调制「局部接触特征」,再配上一套能同时跑仿真与真机、显式建模遮挡与噪声的不确定性神经高程建图;同一套奖励与训练配方不加改动地套在四足 ANYmal-D 与双足 TRON1 上,让控制器零样本爬上 1 米高台、以 2 m/s 跑酷、走过 19 cm 平衡木,并把「什么时候该用膝盖、什么时候该收腿缓冲」这类全身接触行为自动学了出来。
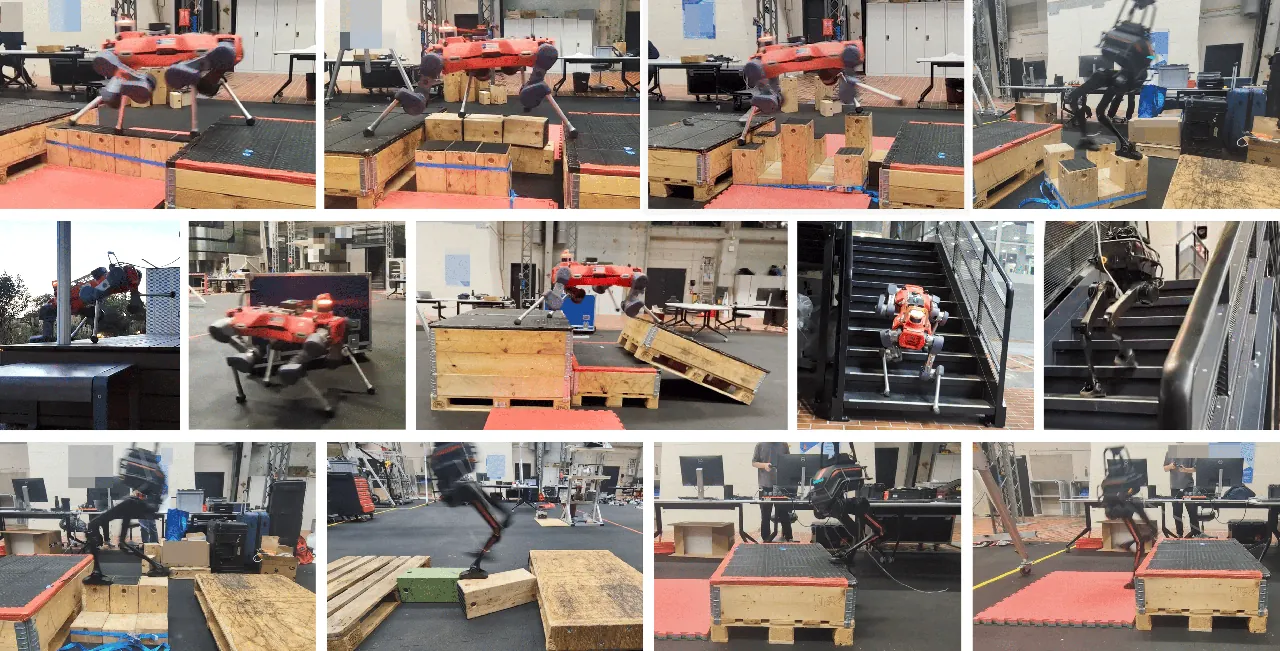
论文主图(Fig. 1):同一套方法在四足 ANYmal-D 与双足 TRON1 上,仅靠机载感知与计算,穿越台阶、箱体、斜坡、废墟与稀疏地形等多样地形。
研究背景与动机
足式机器人要在真实世界里可靠工作,敏捷与泛化缺一不可:既要能爬高台、跳裂缝、踩稀疏落脚点,又要在没见过的地形上不崩。难点在于感知与控制必须紧耦合,而且遮挡、稀疏落脚点、传感器噪声都是常态。
一条成熟的路线是经典模型预测控制:维护状态估计器,用激光或深度相机建显式高程图,再基于地图做规划与控制。这类方法在结构化地形上很稳,但建图常依赖手工调参的滤波与概率融合,速度慢、要针对地形调参,一旦遮挡导致高程图出现空洞就束手无策——太慢,撑不起敏捷运动。
另一条路线是端到端:用一个神经网络把原始传感器流和本体感知直接映射到关节指令。这类方法在跑酷赛道上做到了敏捷,但泛化受限、可解释性差:模型把「感知—行动」揉进一张黑箱,换到没见过的地形分布就容易失效。
本文的前作 AME-1(Science Robotics 2025,参考文献 [15])走的是中间道路:保留显式高程图的模块化结构,但用一个注意力地图编码器把地图特征压成策略嵌入,取得了很好的泛化,代价是敏捷性受限——它编码局部落脚点的方式,本质上像「模型式落脚点评分」,只看局部地形特征与机器人状态,无法表达「整块地形是什么类型、我该用哪种接触模式」。
本文要同时拿到敏捷与泛化,核心主张是两条:其一,地图编码器必须同时具备局部精细接触特征与全局地形上下文,并用全局上下文去调制局部特征;其二,感知侧要有一套快、轻、可微、显式带不确定性的神经建图管线,且在仿真里能并行跑上千环境、到真机上跑同一份代码,从而把 sim-to-real 的感知落差抹平。
预备知识
POMDP 与 PPO。控制问题被写成部分可观测马尔可夫决策过程,用 PPO 在并行仿真(Isaac Gym)里优化。策略 50 Hz 输出关节 PD 目标,硬件上以 400 Hz 跟踪。
特权教师—学生蒸馏。先用「真值地图 + 无噪声本体感知」训练一个特权教师;再让学生策略在神经建图的输入下,同时接受 PPO 的 RL 损失、对教师的动作蒸馏损失、以及两者地图嵌入之间的表征对齐损失。
高程图与注意力地图编码(AME-1)。自我中心高程图把每个地图点写成三维坐标 $(x,y,z)$;AME-1 用 CNN 提局部特征、用本体感知生成查询向量、对局部特征做多头注意力,得到地图嵌入。本文的 AME-2 在此之上加了全局特征。
方法详解
3.1 系统总览
整套系统分教师与学生两级:教师用真值建图在仿真里由 RL 训出来;学生把真值地图换成在线神经建图,在教师的动作蒸馏与表征对齐监督下训练,最终部署到真机。控制器只负责到达位置与朝向目标(goal-reaching),不跟踪速度,这让策略有更大自由度去涌现敏捷动作。
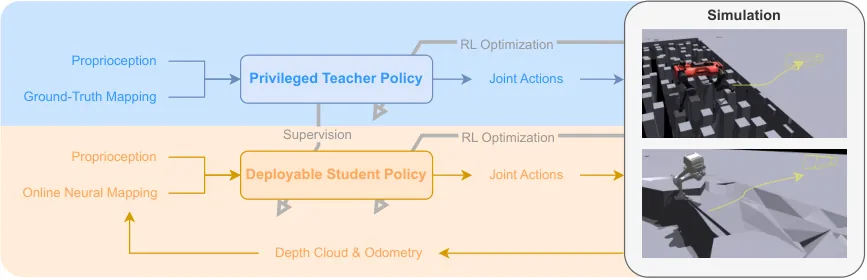
图 1:系统总览(论文 Fig. 2)。上半区:特权教师在仿真里用真值建图训练;下半区:可部署学生用在线神经建图,接受教师监督,输出的关节动作驱动机器人到达位置与朝向目标。
3.2 控制器输入输出与地图表示
本体感知包含基座线速度 $v_b$(仅教师可见)、基座角速度 $\omega_b$、投影重力 $g_b$、关节位置 $q$、关节速度 $\dot{q}$、上一步动作与目标指令 $c$。真值地图把每个自我中心栅格点写成 $(x,y,z)$;神经建图再补一个不确定性通道 $u$,得到四维表示 $(x,y,z,u)$——这正是学生比教师多出来的那一路信息。
3.3 AME-2 编码器:让全局地形上下文去加权局部接触特征
AME-2 是全文的核心。它有两条并行分支再汇聚:
其一,逐点局部特征。地图先经一个 MLP 得到位置嵌入(论文图示维度 16),同时把非坐标通道送入两层 CNN 得到局部嵌入(48 维),两者拼接后再过一个 MLP 融合成 96 维的逐点局部特征 $(\text{点}\times 96)$。
其二,全局地形上下文。逐点局部特征再过一层 MLP 并沿点维做 max pooling,压成 1×64 的全局特征,捕捉整块地形的「类型」。
接着是关键的一步:把全局特征与本体感知嵌入拼接,经 MLP 生成一个 96 维查询向量;以逐点局部特征为键与值做多头注意力(32 头、维度 96),得到「按当前本体状态与全局上下文加权过」的局部特征。最后把全局特征与加权局部特征拼接成地图嵌入,送入动作解码 MLP。
与 AME-1 的差别正在这里:AME-1 的查询只来自本体感知,注意力只在局部落脚点上分配;AME-2 先把「这块地形是稀疏、是爬升还是障碍」的全局判断塞进查询,再让注意力去挑接触区域。作者的解释是:高障碍攀爬可能需要全身接触,障碍避让需要避开某些接触,这些都不是「挑一个最佳落脚点」能表达的,策略必须同时判断「该往哪踩」与「该不该踩、该用哪个部位碰」。
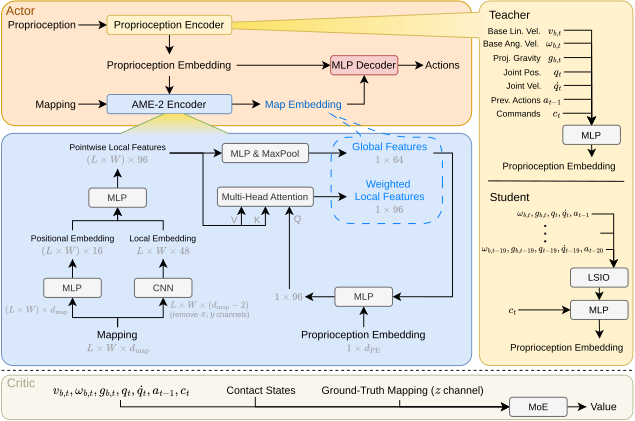
图 2:策略与 AME-2 编码器结构(论文 Fig. 3)。左上为 Actor 总览,中部蓝色框为 AME-2 编码器:位置嵌入 + CNN 局部嵌入 → 逐点局部特征;MLP + max pool → 全局特征;查询由「本体嵌入 ⊕ 全局特征」生成,经 MHA 得到加权局部特征;右侧本体编码器:教师用 MLP,学生用 LSIO 堆叠过去 20 步;底部 Critic 为 MoE。
本体编码器在教师与学生上不同:教师用朴素 MLP 处理无噪声本体感知;学生则把过去 20 步的类型观测量堆叠,用 LSIO(Long-Short I/O)得到时序嵌入,再与指令一起过 MLP。原因是真机上环境不确定、且历史信息对判断机器人状态与环境动力学更关键。
3.4 非对称 Actor-Critic 与教师-学生 RL
Critic 不采用与 Actor 相同的注意力结构——因为 critic 不需要部署,也不必泛化到训练地形之外,而对 $L\times W$ 个局部特征做 MHA 又很贵。于是 critic 用混合专家(MoE)设计,拟合能力强、优化更省算力。注意一个反直觉的对照结论:用「AME-2 策略架构 + MoE critic」能训出泛化的教师,但换成 MoE Actor 却得不到泛化教师(见消融)。
教师训练时 Actor 拿无噪声本体感知与真值地图,Critic 额外拿到各连杆接触状态;接触状态不给 Actor,是为了保持适当的信息落差、避免学生训练受损。左右对称增广只加在 Critic 上。
学生的训练目标是三部分线性组合:PPO 的 RL 损失、对教师的动作蒸馏损失、以及教师与学生地图嵌入之间的表征损失(均方误差)。前几千次迭代会先关掉 PPO 代理损失并配大学习率,让蒸馏先稳住,再引入 RL。
3.5 奖励设计:不奖励落脚点,让全身接触自己涌现
奖励分三类:任务奖励(到达目标)、正则与惩罚项、仿真保真项(惩罚接近极限的关节状态),四足与双足共用同一套。位置跟踪奖励沿用前作形式:
$$r_{\rm position\_tracking}=\frac{1}{1+0.25\,d_{xy}^{2}}\cdot t_{\rm mask}(4)\tag{1}$$
其中 $d_{xy}$ 是机器人到目标点的水平距离,$t_{\rm mask}$ 是随时间收敛的掩码:
$$t_{\rm mask}(T)=\frac{1}{T}\cdot\mathbf{1}(t_{\rm left}<T)\tag{2}$$
朝向跟踪奖励同理,但在接近目标时才生效:
$$r_{\rm heading\_tracking}=\frac{1}{1+d_{\rm yaw}^{2}}\cdot t_{\rm mask}(2)\cdot\mathbf{1}(d_{xy}<0.5)\tag{3}$$
到达后要维持稳定站姿,故有站立奖励,把「未着地脚比例 $d_{\rm foot}$、基座倾斜 $d_{\rm g}$、关节偏离站姿参考的程度 $d_{\rm q}$」与距离一起指数衰减:
$$r_{\rm stand}=\mathbf{1}(d_{xy}<0.5\;\land\;d_{\rm yaw}<0.5)\cdot\exp\left(-\frac{d_{\rm foot}+d_{\rm g}+d_{\rm q}+d_{xy}}{4}\right)\tag{5}$$
正则项里有个关键取舍:本文不像前人那样显式奖励或惩罚足端落脚位置,而是为所有连杆定义惩罚项,从而让全身接触涌现。作为对照,落脚点奖励难以做到地形无关——四足攀爬受益于主动的膝盖接触和贴边落脚,而在稀疏地形上贴边落脚恰恰是要避免的。惩罚事件包括:偏航角速度过快(>2.0 rad/s)、平地起跳、非足接触与其接触切换、横向接触力大于竖向的绊倒、接触中移动的打滑、以及自碰撞。所有权重取整十次幂,且比任务奖励小一到两个数量级,无需大量调参即可训练成功。
3.6 终止条件:用生物力学阈值诱发缓冲行为
早期终止条件包括:姿态崩塌(投影重力分量越界)、基座碰撞力超过整机重量、大腿加速度超阈值、以及 5 秒内移动过少。最有意思的一条是大腿加速度阈值:作者直接取生物力学文献里狗($60\ \mathrm{m/s^2}$)与人($100\ \mathrm{m/s^2}$)的数据作为阈值,用来在跳跃落地时抑制冲击。这个看似「工程取巧」的终止条件,直接诱发了第 6 节的真机缓冲行为——ANYmal-D 下高台时用膝盖轻轻触地,TRON1 落地前先收腿再换支撑腿。
3.7 地形与课程
训练地形分三类:密集地形(粗糙地面、上下台阶、箱体、障碍)、攀爬地形(爬出深坑、爬下平台、连续攀爬)、稀疏地形(跳缝、栈板、梅花桩、独木桥)。稀疏地形里一半加真实地板、一半加「虚拟地板」——在感知图里可见但不产生碰撞,用来阻止机器人偷懒走地板。课程方面,粗糙噪声从 ±0 m 增到 ±0.2 m(ANYmal-D),箱体高度从 0.05 m 增到 0.4 m,障碍密度从 0 增到 0.5 个/平方米,坡度从 5° 增到 45°。
泛化靠四个训练时完全没见过的测试地形来检验:测试 1 是随机重叠的梅花桩(检验稀疏泛化);测试 2 把梅花桩、旋转栈板与高台攀爬拼在一起(组合泛化);测试 3 要求先绕开一个大障碍、再攀爬、跳缝、避障、爬下(避障 + 敏捷攀爬 + 跳跃的组合泛化);测试 4 是真实废墟网格,需翻越碎石并避免脚被卡住(真实攀爬泛化)。
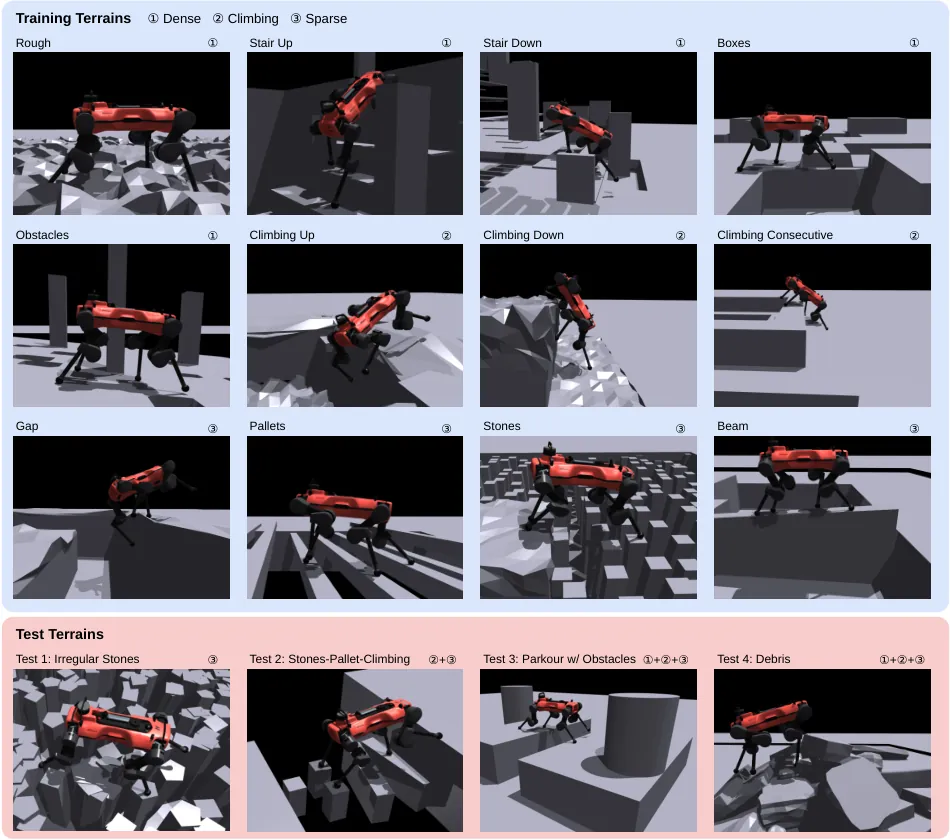
图 3:训练与测试地形(论文 Fig. 4)。上:三类原始训练地形;下:四个测试地形,均为训练中未见或为未见组合。
3.8 神经建图管线:从深度点云到带不确定性的高程图
建图管线是全文的第二大贡献。每一帧,深度点云先投影到局部二维高程栅格;若多个点落在同一格,取最大的 $z$ 值(对运动最有意义的一维),空格则赋固定最小值。这样得到的局部高程往往噪声大、遮挡处不完整,于是用一个轻量 CNN 联合预测基座相对高程与不确定性(以 log 方差形式)。这个不确定性同时刻画测量噪声与遮挡,而高程预测本身也能抑制噪声。
随后用里程计把局部预测融合到全局栅格地图 $\mathcal{M}$,它有两层:高程层与不确定性(方差)层。全局地图初始化为机器人站立高度的平地、配一个大不确定性。融合时不用标准贝叶斯融合,因为「对同一遮挡区域的重复观测不应仅因为预测一致就降低不确定性」。作者改用概率胜者全取(Probabilistic Winner-Take-All):
先算一个有效测量方差,用先验给它下限,防止过度自信:
$$\hat{\sigma}^{2}_{t}=\max\left(\sigma^{2}_{t},\,0.5\cdot\sigma^{2}_{\rm prior}\right)\tag{6}$$
只有有效方差没有显著大于先验时,这次更新才算有效;对有效更新,按相对精度确定覆写概率:
$$p_{\rm win}=\frac{(\hat{\sigma}^{2}_{t})^{-1}}{(\hat{\sigma}^{2}_{t})^{-1}+(\sigma^{2}_{\rm prior})^{-1}}\tag{7}$$
最后随机覆写:采样 $\xi\sim\mathcal{U}[0,1]$,落在阈值内就让新预测接管该格:
$$(h_{\rm new},\sigma^{2}_{\rm new})\leftarrow\begin{cases}(h_{t},\hat{\sigma}^{2}_{t})&\text{if }\xi<p_{\rm win}\\ (h_{\rm prior},\sigma^{2}_{\rm prior})&\text{otherwise}\end{cases}\tag{8}$$
这套策略的好处有四:同一遮挡点的不确定性不会因一致预测而降低;过度自信但与先验不一致的预测无法接管;动态地形出现高置信测量时地图能快速更新;且它容易接进并行仿真、又快到能在硬件上运行。
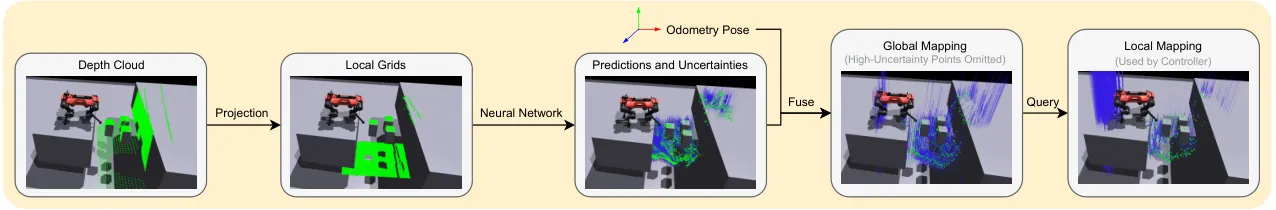
图 4:神经建图管线(论文 Fig. 5)。深度点云投影到局部栅格,经神经网络得到带不确定性的高程估计,再由里程计融合进全局地图,最后按机器人位姿查询出局部地图作为控制器输入。绿点为高程估计,蓝线为不确定性。
3.9 建图模型训练与网络结构
建图模型用程序化生成的地形 + 随机位姿做光追采样训练,不靠物理仿真。用 Warp 光追在单张 RTX 4090 上可跑到每秒数十万帧的采样速度。训练时施加多种增广:每格随机均匀噪声、从四边随机裁剪、用随机传感器位姿与视场模拟遮挡、随机截断高程范围、随机丢点与离群点——从而合成出「有噪、部分可观测」的输入,标签是原始真值高程。
损失用 $\beta$-NLL($\beta=0.5$):
$$L_{0.5}=\mathbb{E}_{X,Y}\left[\mathrm{sg}\!\left[\hat{\sigma}(X)\right]\left(\frac{\log\hat{\sigma}^{2}(X)}{2}+\frac{(Y-\hat{\mu}(X))^{2}}{2\hat{\sigma}^{2}(X)}\right)\right]\tag{9}$$
其中 $\mathrm{sg}[\cdot]$ 为停止梯度算子。相比经典贝叶斯学习的标准 NLL,这个形式抑制了「在难样本上抬高不确定性来偷懒降损失」的倾向,让模型在无法准确预测时输出高不确定性、在能准确预测时输出低不确定性与准确估计。
批次内不同样本的粗糙度差异很大,平地样本会主导损失。于是按全变分(TV)对样本重加权:
$$\mathrm{TV}(Y_{b})=\frac{1}{HW}\left(\|\nabla_{x}Y_{b}\|_{1}+\|\nabla_{y}Y_{b}\|_{1}\right),\qquad w_{b}=\frac{\mathrm{TV}(Y_{b})}{\sum_{b^{\prime}=1}^{B}\mathrm{TV}(Y_{b^{\prime}})+\varepsilon}\tag{10}$$
网络是一个浅层 U-Net,采用门控残差设计:CNN 输出不确定性、原始估计 $h'$ 与门控图 $G$,最终估计为原始输入与网络估计的门控组合 $h=G\odot h'+(1-G)\odot h_{\rm in}$,从而在清晰观测区保住精度、只在有噪或被遮挡处选择性覆写。每个机器人用 5400 万帧训练,每个模型一小时内收敛。ANYmal-D 的局部栅格为 51×31、4 cm 分辨率;TRON1 为 31×31、4 cm 分辨率。
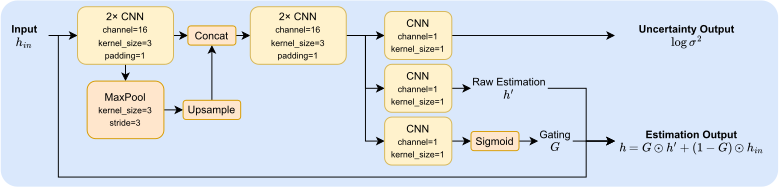
图 5:建图模型结构(论文 Fig. 7)。门控残差 U-Net:输入 $h_{\rm in}$ 经两层 CNN 与池化—上采样跳连,分出不确定性头 log σ²、原始估计头 h′ 与门控头 G,最终 $h=G\odot h'+(1-G)\odot h_{\rm in}$。
3.10 仿真集成与真机部署
在 1000 个并行 ANYmal-D 环境里,建图模型推理低于 0.3 ms、显存约 3 GB(TRON1 约为 60%);存 1000 张 8 m×8 m 全局地图约 0.3 GB,且地图可随机器人接近边界自动重定中心。深度点云等中间开销每 1000 环境再加约 1.2 GB。真机上,整条建图管线每帧约 5 ms,其中约 2.5 ms 花在 ONNX Runtime 的模型推理,足以跟上深度相机帧率。ANYmal-D 合并两个前视相机的点云,TRON1 只用单个前视相机;里程计在 ANYmal-D 上用 CompSLAM + Graph-MSF,在更轻、加速度更大的 TRON1 上用 DLIO。由于里程计速度估计噪声大且有延迟(20 ms 内 1 cm 漂移即可造成 0.5 m/s 的速度误差),作者直接去掉学生的线速度观测。
3.11 方法流程总览
flowchart TD
  subgraph MAP["神经建图管线 50Hz 仿真与真机同一份代码"]
    DC["深度点云 双前视相机合并"] --> LG["局部高程栅格 51x31 4cm 取每格最大 z"]
    LG --> UN["轻量门控残差 U-Net 预测 高程 与 log 方差"]
    UN --> PW["概率胜者全取融合 方差下限 与 覆写概率"]
    ODO["里程计 CompSLAM+Graph-MSF 或 DLIO"] --> PW
    PW --> GM["全局地图 8m x 8m 高程层 加 方差层"]
    GM --> Q["查询自我中心局部地图 4 通道 x y z u"]
  end
  Q --> AME["AME-2 编码器"]
  P["本体感知 过去20步堆叠"] --> LSIO["LSIO 时序编码器"] --> PE["本体感知嵌入"]
  PE --> AME
  AME --> ME["地图嵌入 全局特征 拼接 加权局部特征"]
  ME --> DEC["动作解码 MLP"]
  DEC --> A["关节 PD 目标 50Hz 由 400Hz 跟踪"]
  PE --> QRY["查询向量 由 本体嵌入 拼接 全局特征 生成"]
  AME --> QRY
图 6:AME-2 训练与部署流程。左侧为神经建图管线(深度点云 → 局部栅格 → U-Net 高程与不确定性 → 概率胜者全取融合 → 全局地图 → 查询局部地图);右侧为策略侧,本体嵌入与地图嵌入经动作解码器输出关节目标。
3.12 与开源代码的对应
开源仓库虽然以 G1 教师训练为目标,但其 AME-2 编码器与概率胜者全取融合的实现和论文逐行对应。编码器在 rsl_rl/rsl_rl/models/AME2_models.py 的 AME2Model.get_latent() 中,局部特征、全局特征与注意力查询的构造与式(6)—(8)所在的编码器设计完全一致:
# AME2_models.py :: AME2Model.get_latent()
fc_out  = self.fc_part(map_4d)                       # 位置嵌入 (B, L, W, 16)
cnn_out = self.cnn_part(map_4d[..., 2:].permute(0,3,1,2))  # 局部嵌入 (B, 48, L, W)
local_feat = self.local_proj(torch.cat([fc_out, cnn_out], -1)).view(B, L*W, 96)
global_pre_pool = self.global_pool_mlp(local_feat)   # (B, L*W, 64)
global_feat, _  = torch.max(global_pre_pool, dim=1)   # max pool -> (B, 64)
query = self.query_mlp(torch.cat([prop_embedded, global_feat], -1)).unsqueeze(1)
attn_out, _ = mha_math(self.mha, query, local_feat, local_feat)  # K=V=local_feat
这里 fc_part 是 Linear(dmap, 16)、cnn_part 以 Conv2d(dmap-2, ...) 只处理非坐标通道、local_proj 把 16+48 维投到 96 维——与论文 Fig. 3 中「位置嵌入 16 / 局部嵌入 48 / 逐点局部特征 96」的维度一一对应。注意力模块 mha_math(同仓库 rsl_rl/rsl_rl/modules/ame2_modules.py)把 SDPA 固定到 math 内核,注释解释了这是为规避 Blackwell 上 fused kernel 在 head_dim=3、批×头数超 ~1e5 时的反向崩溃——即论文里 96 维、32 头的注意力。
概率胜者全取融合在 ame2/ame2/sensors/neural_mapping_utils.py 的 BatchedGlobalProbWinnerPipeline.step() 里,是式(6)—(8)的逐行实现:
# neural_mapping_utils.py :: BatchedGlobalProbWinnerPipeline.step()
R_eff = torch.maximum(R_meas, self.tau_min * P_prior)            # 式(6) 方差下限
better = (R_eff < P_prior * (1+self.tau_min)) | (R_eff < 0.04)     # 有效性门
prec_eff, prec_prior = 1.0/(R_eff+eps), 1.0/(P_prior+eps)
p_meas = prec_eff / (prec_eff + prec_prior + eps)                # 式(7) 覆写概率
take = torch.rand_like(p_meas) < p_meas                          # 式(8) 随机覆写
M_new = torch.where(take, m_meas, M_prior)
P_new = torch.where(take, R_eff,  P_prior)
tau_min=0.5 正是式(6)里的系数 0.5;有效性门对应论文「有效方差没有显著大于先验才更新」的判据;并且仓库同时给出 LivoxGlobalProbWinnerPipeline——README 里被划掉的「Mid-360 激光建图入环」在代码层面其实已经落地,缺的只是学习型建图网络的权重。
实验结果
4.1 与前作对比
论文把结果与三类前作对比:泛化最强的前作 AME-1 [15]、四足通用敏捷前作(端到端视觉循环策略)[48]、以及双足敏捷前作 [17]。可比指标是上下高台的极限高度。
| 方法 | 四足爬升上/下 | 双足爬升上 | 双足爬升下 | 稀疏地形 | 泛化 |
|---|---|---|---|---|---|
| AME-1 [15](泛化 SOTA) | ~0.5 m | ~0.3 m | ~0.3 m | 是 | 无 |
| 四足通用敏捷 SOTA [48] | 1 m | — | — | 是 | 少样本微调 |
| 双足敏捷 SOTA [17] | — | 0.5 m(H1) | ≥0.5 m(H1) | 否 | 无 |
| 本文 | 1 m | 0.48 m(TRON1)/ 0.65 m(H1) | 0.88 m(TRON1)/ 1 m(H1) | 是 | 零样本 |
范式层面的差别同样关键:本文用统一奖励跨四足与双足、用神经建图替换特权地图与经典建图、且训练与部署用同一份建图管线(多数前作是 $\neq$ 的),并且只需 2 段/个策略而非十几个。[48] 的通用学生泛化到未见环境是「少样本微调」,而本文是零样本。由于拿 TRON1 对比体量更大的 H1 可能不公,作者还把方法套到 H1 上补充仿真结果。
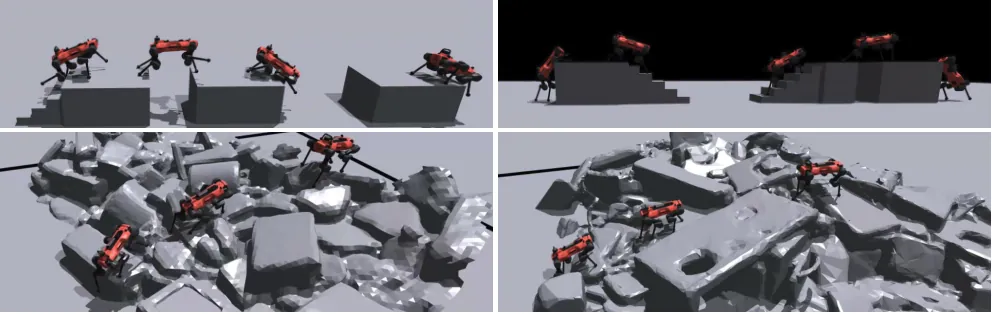
图 7:ANYmal-D 控制器零样本通过前作 [32,48] 报告过的最难跑酷与废墟地形(论文 Fig. 8)。论文只在原始地形上训练,却能直接跨越前作需要微调才能下的地形。
4.2 真机跑酷与稀疏地形
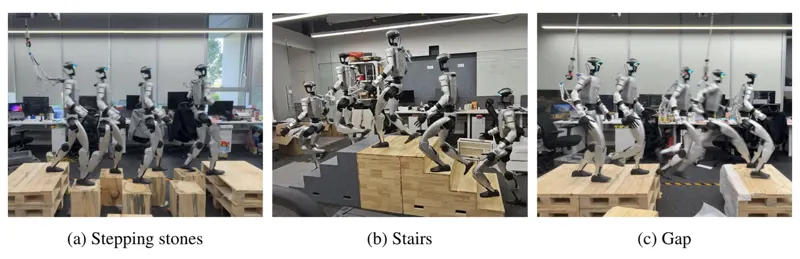
在一个既不在控制器训练地形、也不在建图模型训练地形里的跑酷赛道上,ANYmal-D 能以最高 2 m/s 稳定穿越,组合出攀爬与跳跃动作。稀疏地形上,两代机器人各显其能:ANYmal-D 走过 19 cm 宽平衡木、跨两段不固定带缝横梁、走 20 cm 高差的两排踏步石;TRON1 走两块不固定的 19 cm 悬浮方块、横梁接裂缝、以及菱形踏步石——其中多条地形在训练中未见。
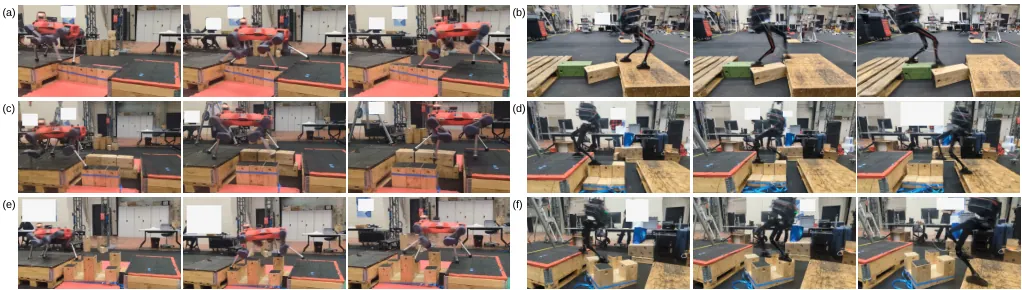
图 8:ANYmal-D 与 TRON1 穿越多种稀疏地形(论文 Fig. 10)。含平衡木、悬浮方块、带缝横梁、踏步石等,其中多条为训练中未见。
4.3 双足机动与鲁棒性
为展示全向感知运动,作者命令 TRON1 依次通过 38 cm 高台、一道裂缝、一段楼梯与粗糙地形,各方向动作平滑。鲁棒性方面,机器人能爬上并平衡在一辆没上锁的可倾斜平台小车上;ANYmal-D 还能从不固定的倾斜踏步石上靠膝盖恢复。
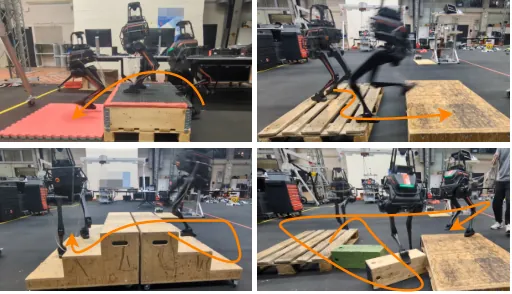
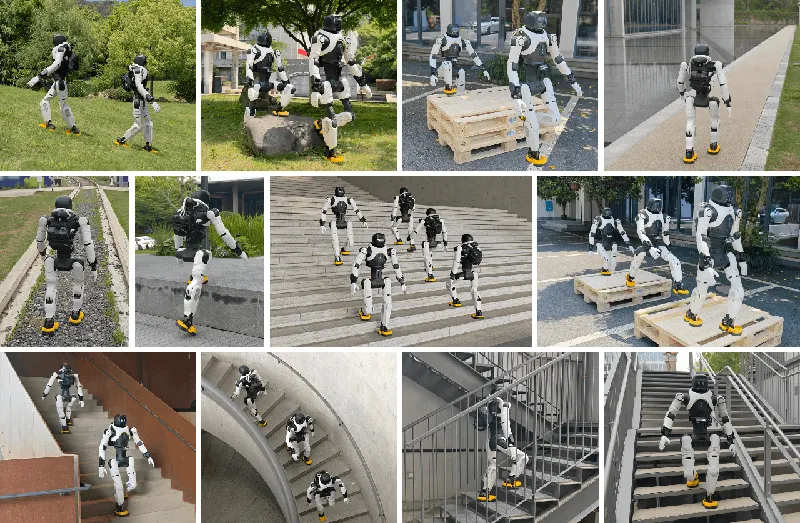
图 9:TRON1 通过 38 cm 高台、裂缝、楼梯与粗糙地形(论文 Fig. 11),橙色箭头为大致轨迹,展示全向感知运动能力。
4.4 建图质量
在训练中未见的复杂地形上走过之后,估计出的高程网格能忠实还原台阶、箱体与倾斜面,且把从未被相机覆盖的区域与遮挡区域用高不确定性标出。可视化中网格表示估计高程、细线表示不确定性,红蓝配色只用于增强高度对比。
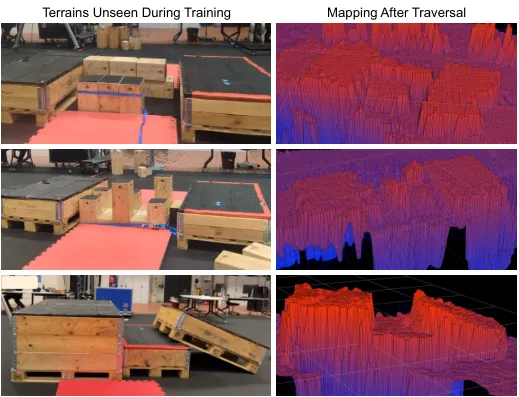
图 10:ANYmal-D 穿越训练未见地形后得到的建图(论文 Fig. 13)。左列为真实地形,右列为估计高程网格,未覆盖区域被排除着色。
4.5 涌现行为与可解释注意力
由于不再显式奖励落脚点,且用生物力学阈值做终止,控制器自发学到两类全身行为:其一是全身接触——ANYmal-D 主动用膝盖接触来稳定自身、翻越难地形;其二是冲击缓冲——下高台时用膝盖轻轻触地,或落地前收腿吸收冲击。作者认为全身接触对复杂环境下的全身灵巧性会越来越重要,但也提醒现有机器人多为足端接触设计,这类动作会给硬件施压。
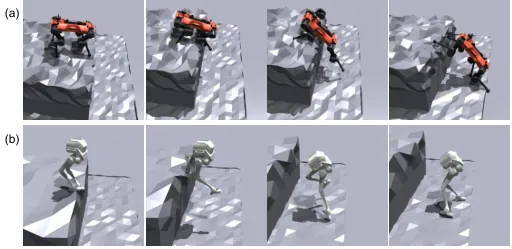
图 11:涌现的冲击缓冲行为(论文 Fig. 14)。(a) ANYmal-D 下高台时用膝盖支撑并轻触地面;(b) TRON1 跳下时先伸腿、落地时收腿再换支撑腿。
注意力可视化给了本文「泛化从何而来」的直接线索:局部注意力倾向聚焦在未来接触区,而全局上下文聚焦在一小撮能刻画地形类型的特征点上。这个模式在训练与测试地形上都出现,说明表征可迁移。在训练地形上,注意力随地形类型变化:下楼时局部注意力盯可踩区域、全局关注下一级台阶;避障时局部盯未来落脚、全局高亮障碍与自由空间;攀爬时局部覆盖前脚落点与后膝支撑、全局指示即将攀爬。在测试地形上,这些模式被复用与重组:测试 2 上全局点移向平台顶部、局部注意力从未来落脚转向膝盖支撑。作者也坦承,局部注意力在近平面接触区会变得平滑,因为特征没有用接触标签监督。
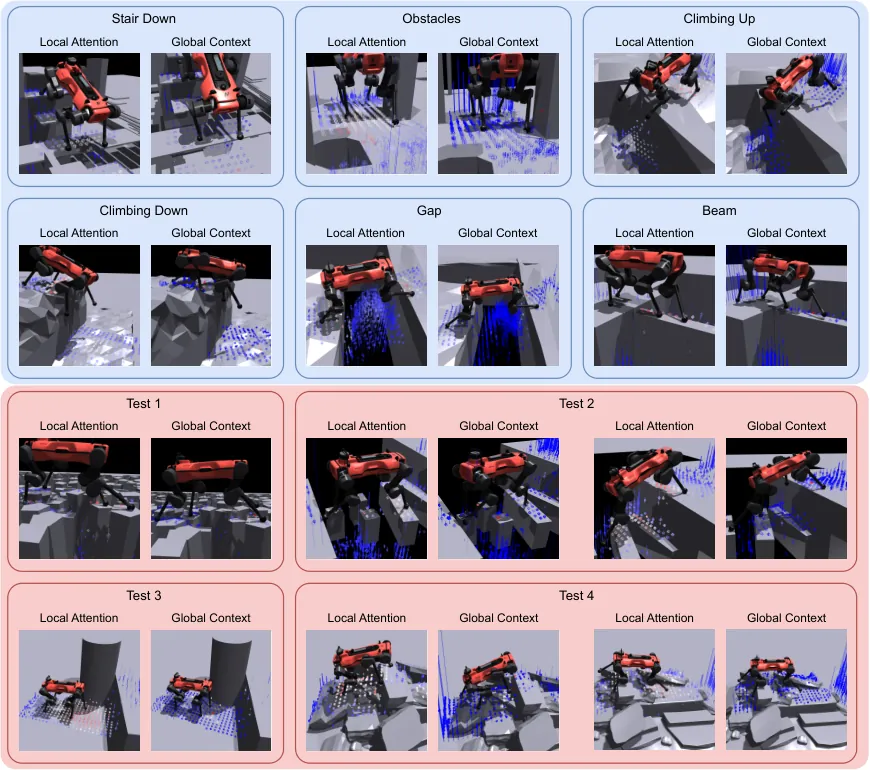
图 12:ANYmal-D 控制器的特征模式(论文 Fig. 15)。每格对比局部注意力与全局上下文;红色越亮权重越高。局部注意力给出精细的运动控制模式,全局上下文主要盯住刻画地形类型的稀疏特征点。
4.6 消融与基准
消融全部在 ANYmal-D 仿真里做。教师架构对比:AME-1 与 MoE 两种基线;学生设计对比 7 种。结论是:所有架构在训练地形上都收敛良好;但 MoE 泛化极差,AME-1 在纯稀疏地形(测试 1)尚可、在混合地形(测试 2–4)就吃力,作者归因于 AME-1 的注意力查询只看本体感知、缺全局上下文,而本文教师在所有测试地形上都稳定泛化。
学生侧的关键发现:直接教师监督(动作蒸馏 + 表征对齐)在训练地形已能达标,但没有强泛化;引入 RL 对测试地形很重要,表征损失再带来额外提升;仅用 RL 无教师监督则很难探索出技能。对照「端到端视觉循环学生 [48]」:后者在测试 3(纯障碍跑酷)略好,但在所有含稀疏区域的测试地形上都不如本文——测试 3 上本文的多数失败是把障碍误当成高台去攀爬。此外,去掉不确定性输入的学生表现更差,说明建图不确定性对运动确有用。
| 建图方法 | Dense | Climbing | Sparse | Test1 | Test2 | Test3 | Test4 | 测试均值 |
|---|---|---|---|---|---|---|---|---|
| 本文 | -0.006 | -0.108 | 0.020 | 0.033 | 0.227 | 0.036 | -0.111 | 0.046 |
| 本文(仅运动地形训练) | 0.020 | -0.090 | 0.081 | 0.104 | 0.234 | 0.087 | -0.075 | 0.088 |
| 时序循环模型 | -0.162 | -0.114 | -0.101 | 0.316 | 0.135 | 0.066 | -0.176 | 0.085 |
表:不同神经建图方法在训练/测试地形上的 $L_{0.5}$ 损失(论文 Table III),越低越好。本文在测试均值上最优(0.046)。
建图侧还做了两组对照:其一,只用运动训练地形训练建图模型——测试误差明显变大,说明额外的可通行与不可通行多样化地形对泛化有用;其二,时序循环建图模型——它需要用策略在环训练、收敛慢约 5 倍,且在测试 1 上损失高达 0.316,作者观察到它「过拟合训练地形、生成意义不明的不确定性图、丢失细节」。
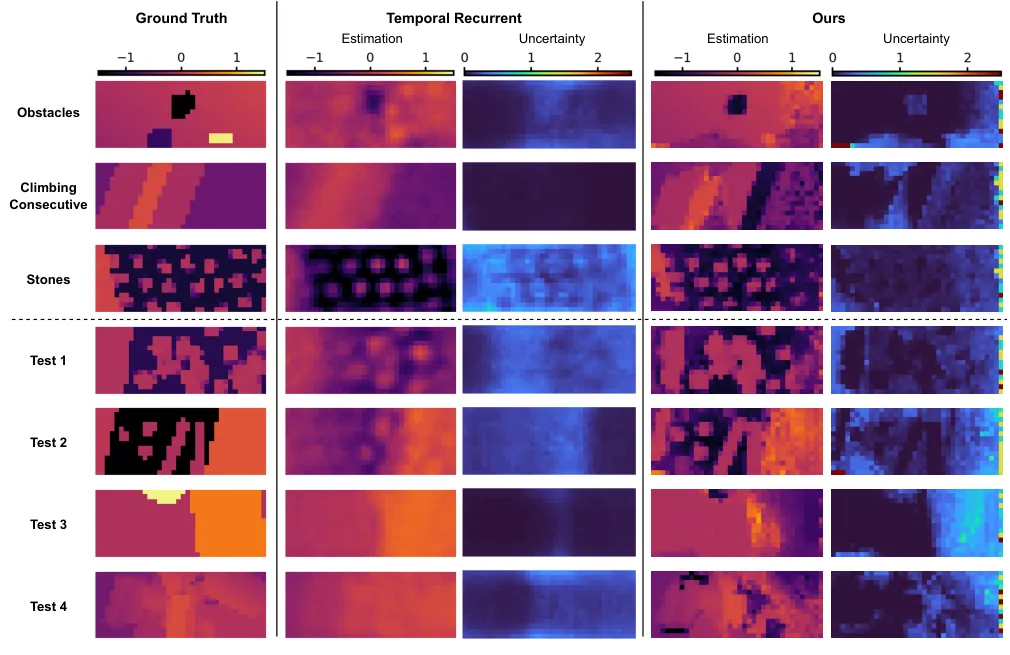
图 13:时序循环模型与本文建图管的定性对比(论文 Fig. 17)。本文在置信处估计准确、在遮挡处赋高不确定性;循环模型的不确定性图意义较弱、细节丢失、在未见地形上更差。
鲁棒性实验进一步显示:在训练随机化范围之外的丢点与伪影下,策略成功率不降反偶有上升(点更少 → 更不确定 → 行为更保守);关掉前上相机后多数地形仍表现良好,但对需要交互感知的高障碍(测试 2、3)会明显吃力,说明这些行为仍对相机视角敏感。
4.7 关键数字汇总
| 项目 | 数值 |
|---|---|
| 控制频率 / 关节跟踪 | 策略 50 Hz;关节 PD 400 Hz |
| 训练迭代 / 并行环境 | 教师 8 万次、学生 4 万次;4800 环境 |
| 训练成本 | ANYmal-D ~60 RTX-4090 天(8 卡);TRON1 ~30 RTX-4090 天(4 卡) |
| 建图模型训练帧数 / 收敛 | 每机器人 5400 万帧;<1 小时收敛 |
| 建图推理 | 仿真 1000 环境 <0.3 ms、~3 GB;真机整管线 ~5 ms、模型 ~2.5 ms |
| 策略推理(真机) | Intel Core i7-8850H 上约 2 ms |
| 局部栅格 | ANYmal-D 51×31、TRON1 31×31,均 4 cm 分辨率 |
| 真机极限 | 跑酷 2 m/s;ANYmal-D 爬 1 m;TRON1 爬 0.88 m、跨 38 cm 高台 |
局限性
作者自述三条:其一,用的是 2.5-D 高程图,解决不了完整的三维运动,未来可接多层高程图或注意力体素表示;其二,控制器不为严重退化的感知(高草、雪地)设计,可把鲁棒控制器与敏捷通用控制器合成一个场景感知策略;其三,建图模块在高度动态、遮挡严重的环境里会失效,需要显式推理移动物体。
我们的判断:其一,训练成本高(四足 ~60 卡天),而作者也承认注意力在全图上的开销是主要瓶颈,稀疏注意力或许能降几倍算力——但论文只提了方向、没给实测。其二,消融显示端到端视觉策略在纯障碍跑酷(测试 3)上仍略优,且本文学生多数失败发生在「技能切换」处(如先在稀疏区减速再攀爬),零样本泛化的上限并未触及。其三,全身接触虽被证实对敏捷/鲁棒有利,但现有机器人主要按足端接触设计,膝盖与躯干着地会给硬件带来额外应力,论文只点出方向、未给长期耐久数据。其四,泛化靠的是「训练地形覆盖 + 大量随机化」,四个测试地形仍是由同类原始地形组合而成,能否应对分布外完全不同的地形(如柔软可变形地面)尚无证据。
总结与展望
本文给出一条同时兼顾敏捷与泛化的清晰路径:不把感知直接塞进黑箱策略,而是保留一块可解释、可复用、可并行的高程建图;在策略侧让地图编码器同时具备局部接触细节与全局地形上下文,并用后者调制前者;再用一套统一奖励与教师-学生配方,把同一套方法不加改动地用到四足与双足上。它带来的结果是零样本爬 1 m 高台、跑酷 2 m/s,以及自动涌现的膝盖支撑与落地缓冲。工程上最有价值的两个「反直觉细节」值得记住:不给落脚点奖励、只给所有连杆惩罚,反而催生了全身接触;用狗与人的大腿加速度阈值做终止,反而把缓冲行为逼了出来。展望上,作者指向多层高程图与注意力体素、与鲁棒控制器的结合、以及对动态遮挡元素的显式推理。
金句
「策略不仅要判断往哪里踩,还要判断该做哪些接触、该避开哪些接触。」
「对同一遮挡区域的重复观测,不应仅仅因为预测一致就降低它的不确定性。」
「遮挡区域不是用学习到的先验去补全,而是被保留为不确定——一旦可见,新的几何就能依据预测的不确定性被融合进地图。」