PAPER DEEP DIVE
功夫机器人:基于物理的人形机器人全身控制学习高动态技能
提出面向高动态技能的物理式人形全身控制框架,用接触感知运动过滤、可微IK重定向与自适应强化学习,让Unitree G1复现跳跃和旋转等动作。
论文:KungfuBot: Physics-Based Humanoid Whole-Body Control for Learning Highly-Dynamic Skills
作者:Weiji Xie、Jinrui Han、Jiakun Zheng、Huanyu Li、Xinzhe Liu、Jiyuan Shi、Weinan Zhang、Chenjia Bai、Xuelong Li
论文与项目:arXiv:2506.12851 · 项目页
代码状态:官方代码已公开于 TeleHuman/PBHC。本次精读核对的提交为 ffac5cded61fe78b39b051f09ac2ed0f6a1ccea0,公开仓库采用 CC BY-NC 4.0 许可证,明确限制商业使用。
一句话总结
功夫机器人把“从视频里找到像人的动作”和“让真实人形机器人承受动力学约束完成动作”拆成前后相接的两段工程:先用质心、足底压力与接触掩码清洗人体动作,再用随训练误差自动收紧的跟踪容差训练强化学习策略,使宇树 G1 能完成拳击、跳跃踢腿、旋转、深蹲、舞蹈和太极等高动态全身动作。
研究背景与问题
人形机器人最有价值的能力之一,是直接继承人类已经会做的动作。相比为每个技能手工设计有限状态机,动作模仿有机会把格斗、舞蹈、体育和表演中的姿态、节奏与全身协调关系迁移给机器人。难点在于,人类视频描述的是视觉上合理的肢体轨迹,机器人执行时却必须满足质量分布、关节力矩、摩擦、碰撞、驱动延迟和接触约束。一个在视频中自然的前踢,到了人形机器人身上可能因为支撑脚打滑、质心越界或膝关节力矩不足而完全不可执行。
论文指出,现有动作跟踪方法通常只处理平滑、低速的人体运动。它们依赖设计精细的奖励函数和课程学习,能够完成行走、转身、缓慢挥手等动作,却很难跨过高动态技能的门槛。高动态动作有两个叠加困难。第一,参考动作本身未必物理一致,单目人体恢复模型会估计出脚底漂浮、地面穿透或不符合支撑关系的轨迹。第二,即使参考动作经过了简单清理,强化学习中的固定跟踪容差也无法同时适配慢速太极和瞬间踢腿:容差过大时策略学得稳,却忽略动作细节;容差过小时训练早期几乎没有有效奖励,策略容易崩溃。
作者的判断不是“换一个更大的网络”就能解决,而是把误差来源分成运动数据质量和训练课程尺度。前者需要建立从视频人体到机器人轨迹的物理清洗链路,后者需要让奖励的敏感区间随策略能力变化。这个分解对应论文的两项核心贡献:多步动作处理管线与自适应动作跟踪机制。图 1 把视频恢复、物理筛选、接触修正、逆运动学重定向、强化学习训练和真机部署放在同一条流程里。
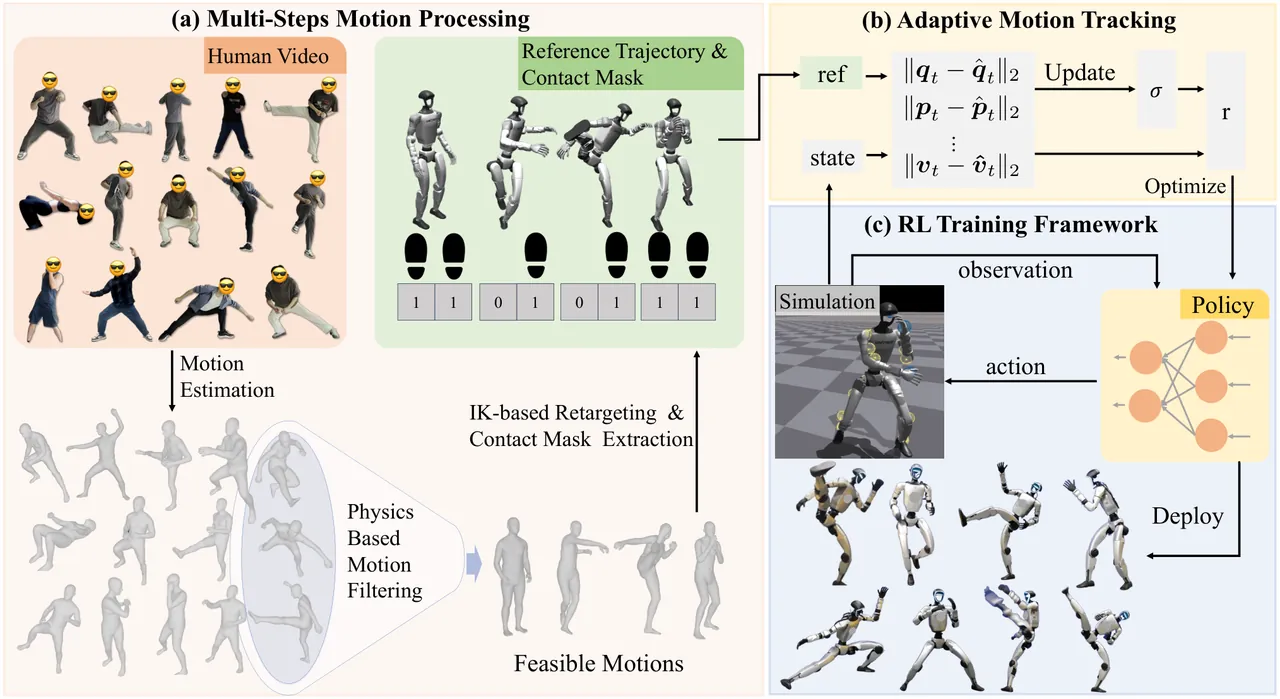
论文将机器人控制过程写成一个带参考状态的马尔可夫决策模型:
$$\mathcal{M}=(\mathcal{S},\mathcal{A},\mathcal{S}^{\rm ref},\gamma,r,P)$$其中,$\mathcal{S}$ 是机器人状态空间,$\mathcal{A}$ 是关节动作空间,$\mathcal{S}^{\rm ref}$ 是参考动作状态,$\gamma$ 是折扣因子,$r$ 是奖励函数,$P$ 是转移动力学。策略看到当前机器人状态和未来参考动作后输出关节目标,环境则按照仿真动力学推进。与普通运动控制相比,这里的参考状态不仅包含关节角,还包含根节点运动、身体位置、速度和加速度,因此高动态动作的时序误差会直接进入优化目标。
从视频到机器人:四步动作处理
1. 单目视频恢复人体动作
流程从普通 RGB 视频开始。论文使用 GVHMR 一类人体运动恢复方法,把每帧图像估计成 SMPL 参数。SMPL 人体网格由体型参数、姿态参数和全局平移共同决定,可写成:
$$\mathcal{V}=M(\bm{\beta},\bm{\theta},\bm{\psi})\in\mathbb{R}^{6890\times3}$$这里 $\bm{\beta}$ 控制高矮胖瘦,$\bm{\theta}$ 控制关节点旋转,$\bm{\psi}$ 控制整个人体在空间中的平移。SMPL 能提供比二维关键点更完整的表面和体积信息,因此后续可以计算网格质心、足部接触和地面高度。不过,单目估计并不意味着轨迹天然物理可信。相机尺度、遮挡、快速运动和地面先验都可能造成脚底抬高、脚踝抖动或整个人体下沉。论文因此没有把恢复结果直接送入强化学习,而是安排了一轮明确的物理验收入口。
2. 用质心与足底压力中心筛掉不可执行动作
物理过滤的核心是判断当前姿态能否在支撑条件下保持稳定。代码在 SMPL 网格上先按部位体积估计人体质心,再为接近地面的顶点赋予更高权重,得到足底压力中心。两者在水平面上的距离被用作稳定性判据:
$$\Delta d_t=\|\bar{\bm p}_t^{\rm CoM}-\bar{\bm p}_t^{\rm CoP}\|_2<\epsilon_{\rm stab}$$$\epsilon_{\rm stab}$ 在实验中取 $0.1$。如果某帧的质心投影距离压力中心过远,该帧就被视为不稳定。论文还要求动作首尾至少落在稳定集合中,并限制连续不稳定帧的最大长度不能超过 $\epsilon_N=100$。这种设计承认腾空、踢腿和跳跃本来就允许短时失去静态支撑,但它拒绝那些长时间、无法解释的失控区间。
官方实现提供了更具体的工程细节。motion_filter.py 在约两万个表面顶点上按部位体积计算质心,并根据顶点相对地面的高度生成压力权重,再求足底压力中心。过滤不是只看一帧姿态是否“像在站立”,而是检查整段视频的稳定性序列。对高动态动作而言,这项筛选尤其重要:踢腿时质心可以短暂离开双足支撑区域,但如果轨迹从未重新建立接触,机器人学到的就会是一段不可能持续的状态。
3. 用踝关节速度与高度估计接触掩码
第二层处理寻找脚与地面的接触。对左踝关节位置 $\bm p_t^{\rm l-ankle}$,论文将“相邻帧移动足够小”和“高度足够低”同时作为接触条件:
$$c_t^{\rm left}=\mathbb I\left[\|p_{t+1}^{\rm l-ankle}-p_t^{\rm l-ankle}\|_2^2<\epsilon_{\rm vel}\right]\mathbb I\left[p_{t,z}^{\rm l-ankle}<\epsilon_{\rm height}\right]$$右脚的判定方式对称,$\epsilon_{\rm vel}=0.002$,$\epsilon_{\rm height}=0.2$。只要任一只脚被判定接触,该帧就视为有地面支撑。论文在 10 个手工标注样本上测试了接触估计,准确率为 91.4%。这个数字比“看起来脚贴地”更有意义,因为它直接影响下一阶段的全局高度修正。
接触掩码把动作从纯几何问题变成了带有支撑假设的时序问题。只用高度阈值会误判快速经过地面的摆动腿,只用速度阈值又会把悬空但短暂静止的脚当作接触脚。两者结合后,系统更可能找到真正承担身体重量的支撑相。尽管如此,91.4% 的测试只覆盖 10 个样本,阈值对鞋型、镜头角度和恢复误差的敏感性仍需要更大规模验证。
4. 地面修正、平滑与微分逆运动学重定向
检测到接触后,系统计算脚底最低点相对地面的高度偏差 $\Delta h_t$,并把整个 SMPL 全局平移向下修正:
$$\psi_{t,z}^{\rm corr}=\psi_{t,z}-\Delta h_t$$对没有接触的帧,则沿用上一个接触帧的高度偏移,避免每一帧独立抖动。修正后的竖直平移还会通过指数移动平均平滑。公开代码中的系数为 $\alpha=0.3$:
$$\hat x\leftarrow(1-\alpha)\hat x+\alpha x$$这个处理不改变关节旋转,只对全局高度做连续修正,因此能保留动作主体,同时消除“人体整体悬空”这一类最容易从视频恢复中出现的伪影。完成清洗后,系统用可微分逆运动学把 SMPL 动作重定向到宇树 G1。重定向目标同时考虑机器人末端位置、姿态和关节约束,输出 G1 的 23 个受控自由度。
官方代码 convert_fit_motion.py 使用 dof[:, :19] 与 dof[:, 22:26] 拼出 23 维关节向量。也就是说,每条腿的髋、膝、踝与腰部等主要自由度被保留,而每只手腕的三个手部自由度被排除。这个选择符合全身动作控制的实验范围:论文展示的是拳击、踢腿和舞蹈的肢体动力学,而不是手指精细操作。
flowchart LR
    Video[单目人体视频] --> HMR[恢复 SMPL 动作]
    HMR --> Stability[质心与压力中心稳定性筛选]
    Stability -->|接受| Contact[踝速度与高度接触估计]
    Stability -->|拒绝| Drop[不进入训练集]
    Contact --> Ground[接地高度修正]
    Ground --> Smooth[全局位置指数平滑]
    Smooth --> Retarget[微分逆运动学重定向]
    Retarget --> G1[G1 的 23 维参考轨迹]
    G1 --> Adapt[自适应容差更新]
    Adapt --> PPO[非对称 Actor-Critic]
    PPO --> MuJoCo[MuJoCo 迁移检查]
    MuJoCo --> Real[G1 真机部署]
自适应动作跟踪:让容差跟着能力走
指数奖励为何对尺度敏感
动作跟踪奖励常把误差压进指数函数:
$$r(x)=\exp(-x/\sigma)$$$x$ 可以是身体位置、关节位置、速度或加速度误差,$\sigma$ 决定奖励对误差变化的敏感区间。论文的观察是:当 $\sigma$ 远大于典型误差时,不同动作质量都得到接近 1 的奖励,策略缺少继续变精细的动力;当 $\sigma$ 过小时,训练初期的误差会让奖励迅速接近 0,梯度信号同样变弱。固定的经验容差只能在某一段难度上有效,难以同时覆盖缓慢太极和高速回旋踢。
图 2 用“马步冲拳”中右手竖直位置的跟踪结果说明这一点。自适应容差会随着训练过程逐步收紧,手部轨迹从较宽的误差带逐渐贴近参考运动,而不是一开始就要求策略完成精确的高速路径。
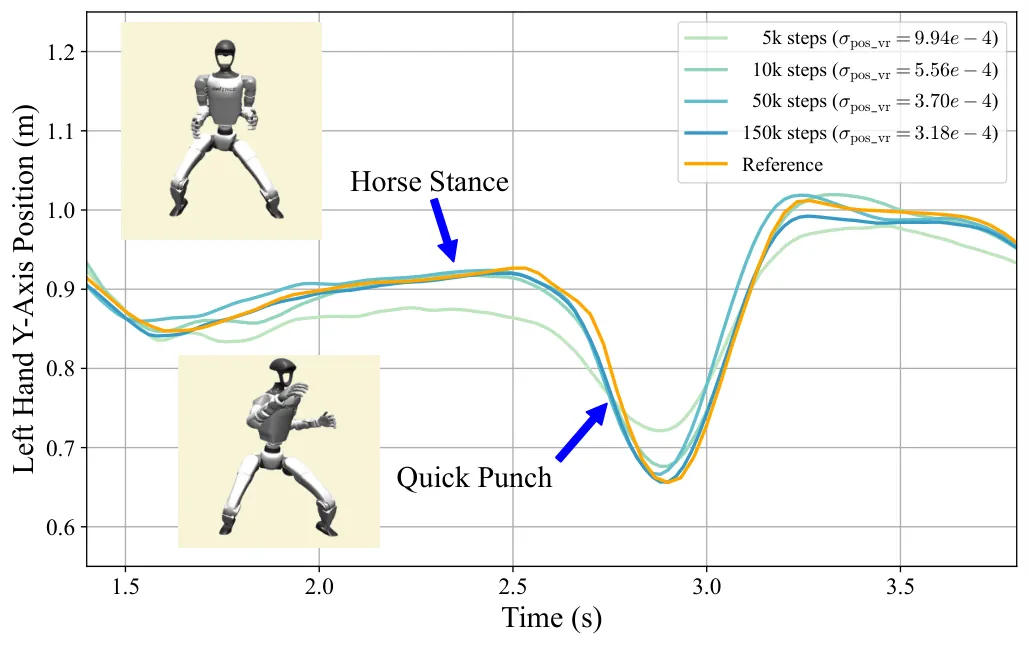
双层优化给出容差调整目标
作者没有把 $\sigma$ 的变化完全交给启发式规则,而是把它写成双层优化。内层在给定 $\sigma$ 下训练策略,外层希望策略收敛后具有更好的精确跟踪表现:
$$\max_{\sigma\in\mathbb R_+}J^{\rm ex}(x^*)\quad \text{s.t. }x^*\in\arg\max_x J^{\rm in}(x,\sigma)+R(x)$$$J^{\rm in}$ 是当前容差下的训练目标,$R(x)$ 是正则项,$J^{\rm ex}$ 衡量收敛策略的精确性。对这个简化问题求导后,作者得到合适容差的直观形式:它应当接近当前收敛误差的平均尺度。
$$\sigma^*=\frac{1}{N}\sum_{i=1}^N x_i^*$$实际训练无法等策略完全收敛后再求解一次外层问题,因此系统在线估计误差均值,并持续更新容差。公开代码对每个奖励项维护误差指数移动平均 $\hat x$,再执行:
$$\hat x\leftarrow(1-\alpha)\hat x+\alpha x$$ $$\sigma\leftarrow\min(\sigma,\hat x)$$第二条更新是这项工作稳定性的关键。$\sigma$ 只能不增,不能因为一次偶然误差上升而放宽。训练开始时使用较大的初始容差,让策略先获得足够密集的奖励;随着误差均值下降,容差只向更严格的方向移动。这样就把课程学习写进了奖励本身,而不必手工安排多个训练阶段。
图 3 展示了这一闭环在训练中的变化。随着跟踪因子逐步收紧,策略先获得可学习的宽奖励区间,再被推向更精确的轨迹。容差不是按预设步数突然切换,而是由当前误差估计连续驱动。训练过程因此更像一个反馈控制回路:策略改善会收紧目标,收紧后的目标继续要求策略改善。
与固定容差方法的关键差别
固定容差的方法并不是没有课程,只是课程通常写在任务采样、终止条件或动作裁剪中。功夫机器人把课程放在误差函数尺度上,且每个奖励项分别更新。身体位置误差、关节误差和速度误差可以拥有不同的敏感区间,系统根据训练时实际达到的误差收紧各自容差。对于包含快速换向和瞬时接触的动作,这比一个全局超参数更贴近问题结构。
但这条推导也依赖若干理想化假设:策略优化被视为可求最优的内层问题,误差分布被压缩为均值,在线更新使用的是采样误差的指数平均。它解释并指导了算法,却不能证明任意高动态动作都能在真实机器人上稳定收敛。后文的结果更准确地说,是在有限动作集和 G1 平台上验证了这种课程设计有效。
非对称 Actor-Critic 与训练稳定性
策略训练采用非对称 Actor-Critic。Actor 只使用真机可获得或可估计的观测,Critic 额外接收参考身体位置、当前与参考位置之差、基座线速度以及域随机化后的物理参数。Critic 的特权信息只在训练时使用,部署时不需要。这个结构减少了执行器对不可观测状态的依赖,同时让价值网络更容易判断动作偏离来自控制误差还是环境参数变化。
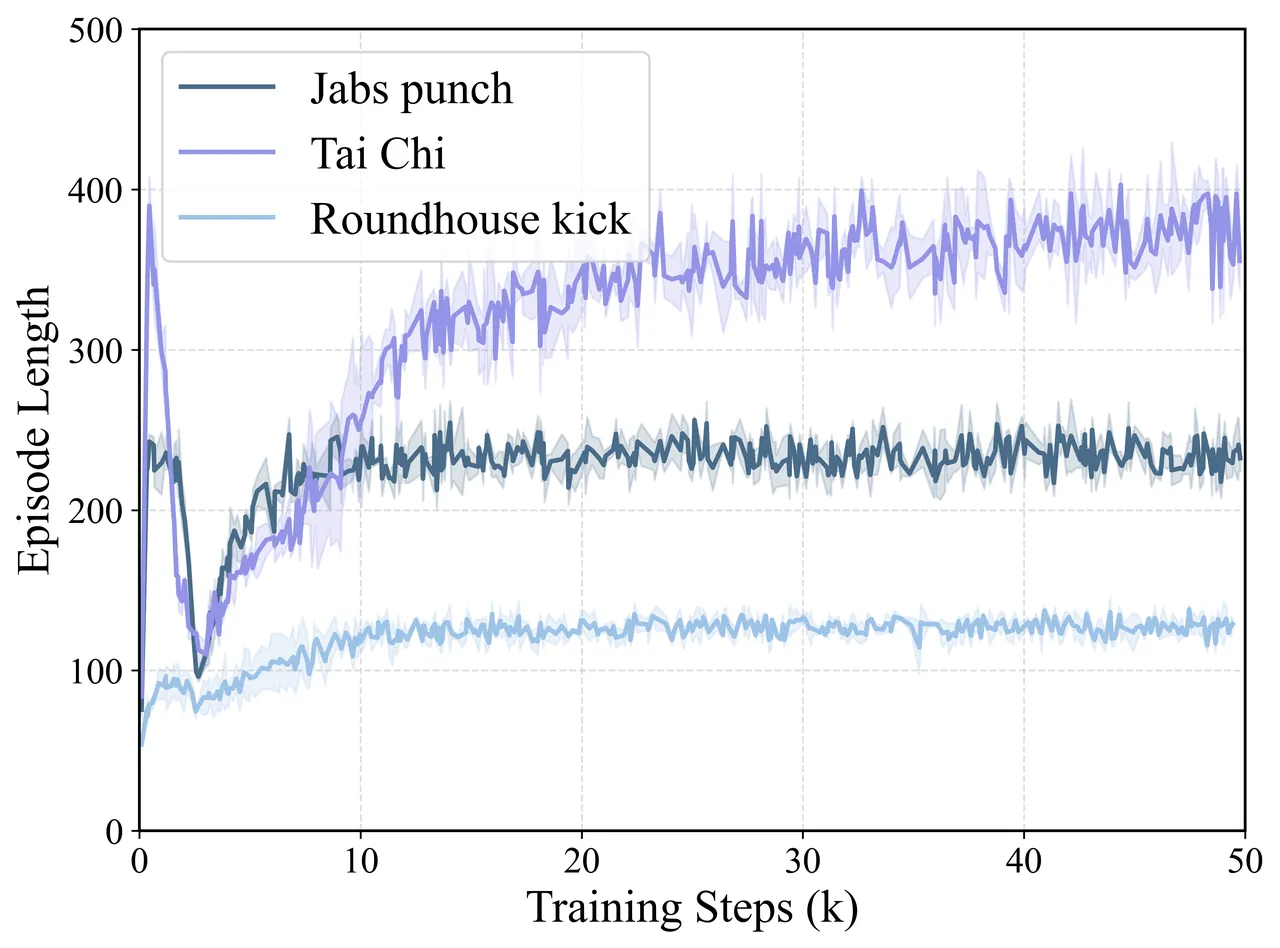
训练还使用参考状态初始化、奖励向量化、域随机化和动作平滑约束。参考状态初始化让回合不必每次都从站姿慢慢进入动作;奖励向量化把多个身体与关节指标保留为不同通道,便于分别调整容差;域随机化覆盖摩擦、PD 增益、连杆质量、踝关节惯量、基座质心偏移、执行器延迟和外部推力。论文报告训练在约两万步后趋于稳定,每套策略在一台 RTX 4090 上训练约 27 小时。
数据集与实验设置
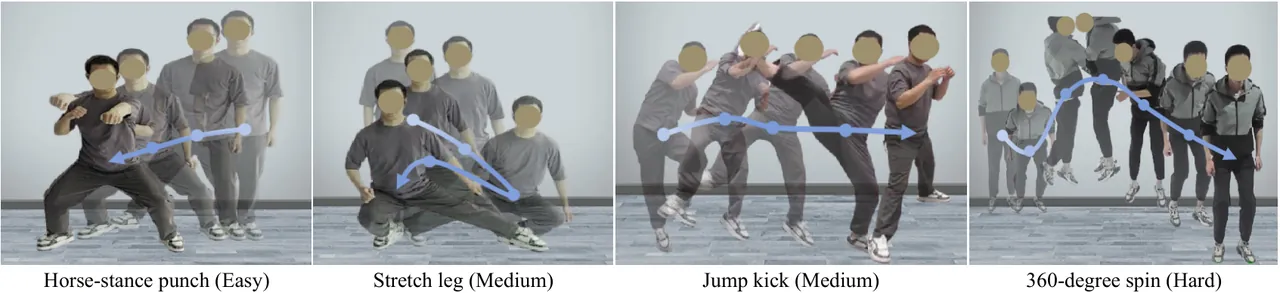
论文构建了 13 个高动态动作,按敏捷性分为简单、中等和困难三级。数据来源包括单目视频、AMASS 和 LAFAN。视频动作经过前述恢复与清洗流程,公开数据动作则经过筛选、接触修正和重定向,使所有序列进入统一的 G1 参考轨迹格式。为降低起始和结束瞬间的跳变,论文在每段动作前后用线性插值连接默认姿态。
图 4 展示了十个代表性动作,包括拳击、踢腿、跳跃、旋转、拉伸、舞蹈和太极。图中颜色表示轨迹随时间的变化,动作难度并不只由关节角范围决定。快速踢腿要求短时单脚支撑与高加速度,旋转要求角动量连续,深蹲要求膝关节力矩和重心控制,太极则要求慢速过程中的持续平衡。它们共同构成一个比常规行走更宽的动力学分布。
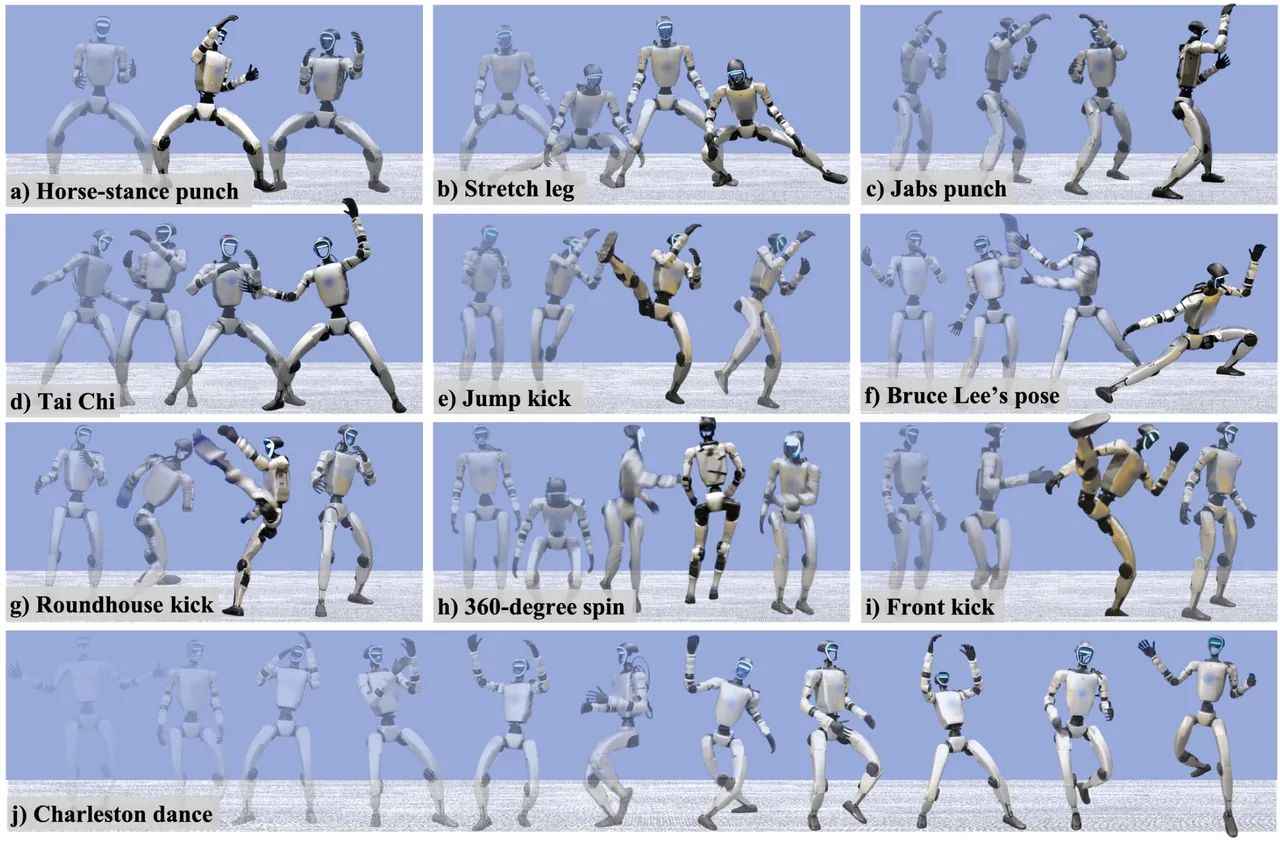
仿真实验在 IsaacGym 中完成,每个设置使用三个随机种子,并在 1000 次回合 rollout 上统计。主表报告非 oracle 版本 PBHC,与 OmniH2O、ExBody2 以及不可直接部署的 MaskedMimic、oracle PBHC 比较。这里的 oracle 允许使用更完整的未来参考和状态信息,用来观察部署约束带来的性能上界,而非公平的真机基线。
动作筛选实验单独使用 10 段动作检验物理指标:6 段被接受,4 段被拒绝。被拒绝动作的回合长度比 ELR 最高只有 54%,而接受动作通常能够维持更长回合。图 5 给出接受与拒绝动作的 ELR 分布。ELR 不是动作“好看程度”的分数,而是策略在仿真中维持有效跟踪的持续时间;分布分离说明物理筛选确实在预测可学习性,而不只是删除视觉上奇怪的片段。
主要结果
表 1 汇总 PBHC 在三个难度级别的非 oracle 跟踪误差。六列依次是全局身体位置、根节点相对身体位置、关节位置、身体速度、身体加速度和关节速度误差,数值越低越好。困难动作的身体位置误差约为简单动作的五倍,说明难度划分与策略实际承受的误差一致。
| 难度 | 全局身体位置 | 根相对身体位置 | 关节位置 | 身体速度 | 身体加速度 | 关节速度 |
|---|---|---|---|---|---|---|
| 简单 | 53.25±17.60 | 28.16±6.127 | 725.62±16.20 | 4.41±0.312 | 4.65±0.140 | 81.28±2.052 |
| 中等 | 126.48±27.01 | 48.87±7.550 | 1043.30±104.4 | 6.62±0.412 | 7.19±0.254 | 105.30±5.941 |
| 困难 | 290.36±139.1 | 124.61±53.54 | 1326.60±378.9 | 11.93±2.622 | 12.36±2.401 | 135.05±16.43 |
表中的单位并不是同一尺度,因此不能把六列简单相加。全局身体位置、根相对位置和关节位置反映空间误差,速度与加速度反映时间导数上的偏差。困难组的标准差明显增大,尤其是全局身体位置从简单组的 17.60 增至 139.1,说明模型在个别快速动作上存在较大的跨种子波动。论文仍报告 PBHC 在所有指标上优于可部署基线,但这个结果不应被解读为每个困难动作都同样稳定。
消融实验进一步展示自适应机制的价值。以“直拳”为例,PBHC 的全局身体位置误差为 44.38±7.118,固定 Coarse 容差为 63.95±6.680;回旋踢分别为 52.53±2.106 与 76.81±2.863。舞蹈动作“查尔斯顿”上,PBHC 为 94.81±14.18,而 LowerBound 达到 358.82±10.35。快速动作与慢速动作需要的容差方向不同,单个固定尺度难以同时覆盖。
接触掩码消融也很直接。查尔斯顿舞蹈中,完整方法的平均接触误差为 217.82±47.97,不使用接触掩码时为 633.91±49.74;跳跃踢腿的身体位置误差从完整方法的 42.58±8.126 增至无接触掩码的 170.28±97.29。对于腾空和落地频繁的动作,错误的地面高度会让整条参考轨迹上下漂移,策略即使关节动作接近,也会因为全局位置不一致而得到较差奖励。
| 动作 | 指标 | 完整 PBHC | 消融版本 |
|---|---|---|---|
| 查尔斯顿舞 | 平均接触误差 | 217.82±47.97 | 633.91±49.74 |
| 跳跃踢腿 | 全局身体位置误差 | 42.58±8.126 | 170.28±97.29 |
真机部署与迁移表现
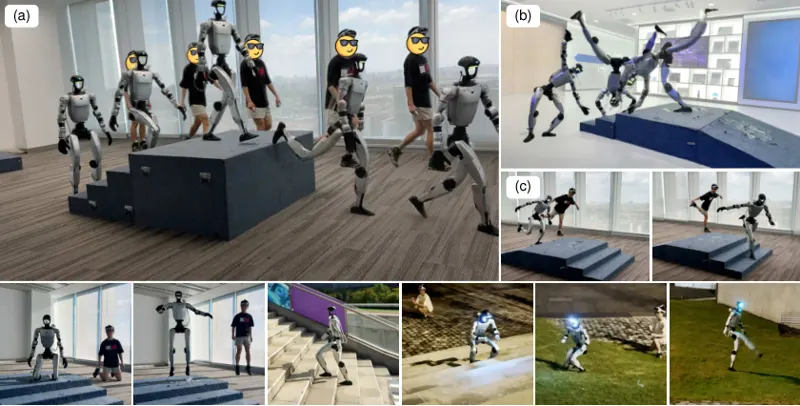
论文在宇树 G1 上演示了直拳、勾拳、马步冲拳、前踢、跳踢、侧踢、后踢、旋转回旋踢、360 度旋转、深蹲、拉伸、舞蹈和太极。真机视频中动作的完整性和速度表现说明,策略输出的关节目标、参考轨迹和域随机化已经足以跨越从仿真到真实硬件的常见差距。尤其是跳跃和旋转动作,需要控制器在短时间失稳后重新落地并恢复平衡,比静态姿势跟踪更能检验迁移质量。
定量真机实验只覆盖太极,共进行 10 次试验。表 2 比较 MuJoCo 与真机的跟随误差。五列分别为局部身体位置、关节位置、身体速度、身体加速度和关节速度误差。真机的局部身体位置为 36.64±2.592,略高于 MuJoCo 的 33.18±2.720;关节位置为 1130.05±9.478,也略高于仿真的 1061.24±83.27。差距存在,但量级接近。
| 平台 | 局部身体位置 | 关节位置 | 身体速度 | 身体加速度 | 关节速度 |
|---|---|---|---|---|---|
| MuJoCo | 33.18±2.720 | 1061.24±83.27 | 2.96±0.342 | 2.90±0.498 | 67.71±6.747 |
| 真机 G1 | 36.64±2.592 | 1130.05±9.478 | 3.01±0.126 | 3.12±0.056 | 65.68±1.972 |
这组数据支持“真机表现接近仿真”,但也必须看到边界。首先,真机量化只测了一个较慢的太极动作,而论文演示中最困难的跳跃踢腿和回旋踢主要依靠视频展示,没有给出多动作、多试次的误差表。其次,真机根节点固定为原点,因为外部动作捕捉或定位不可用,所以全局位移误差没有进入真机表。再次,10 次试验的样本量足以发现明显迁移失败,却不足以估计长期运行、地面材质变化或电池状态变化下的尾部风险。
因此,最稳妥的结论是:论文已经证明该策略在 G1 上完成多种高动态动作,并在太极这一动作上取得与 MuJoCo 接近的定量表现;它尚未证明所有展示动作都能在多次、多场景真机试验中达到同样统计稳定性。
方法边界与风险
作者明确承认两项限制。第一,系统没有地形感知和障碍规避能力。所有动作都假定机器人在平坦、可预测的地面上执行,策略没有接收深度图、接触材质或障碍物几何,因此不能把论文结果外推为复杂环境中的自主运动。第二,每个动作训练一套独立策略,系统不是可以在一个策略中自由切换技能的通用动作库。对十几种展示技能逐个训练意味着训练成本会随动作数量线性增长,也缺少动作之间的在线衔接机制。
从精读角度看,还有三项需要后续验证的风险。物理过滤依赖手工设定的稳定性、速度、高度和最长不稳定帧阈值,论文给出的 10 段筛选测试规模较小;接触掩码虽然有 91.4% 的准确率,但同样只在 10 个标注样本上验证。不同体型、服装、镜头和地面条件是否保持相同准确率,仍需更大规模基准。真机层面目前只有太极的 10 次定量试验,高动态踢腿和跳跃的重复成功率、冲击负载、关节温升与安全恢复没有公开统计。
此外,双层优化提供了清晰的理论动机,但实际实现用指数移动平均在线更新,且把每个误差项压缩成一个均值。它不建模误差的时间相关性,也不会识别某一类动作片段的局部难点。若一个动作大部分时间容易、只有少数高速切换很难,均值可能仍偏大,导致难片段训练不足。未来可以把误差分布、分位数或按动作阶段变化的容差纳入课程,而不是只跟踪全局平均。
可复现性与开源代码
论文公开了项目页和官方代码。代码目录把问题拆成运动源处理、SMPL 重定向、动作过滤、HumanoidVerse 仿真环境与 G1 描述等模块,能够对应论文中的主要技术步骤。本次核对确认,convert_fit_motion.py 的 23 自由度拼接与 G1 控制范围一致,motion_filter.py 的体积加权质心和压力加权足底中心与物理筛选公式一致,motion_tracking.py 的指数移动平均与非增容差更新也对应该文的自适应机制。
复现时需要注意许可证。仓库采用 CC BY-NC 4.0,而不是常见的宽松软件许可证。它可以用于研究和非商业用途,但商业部署、产品集成或再分发必须另行确认授权。代码公开也不等于训练数据、动作视频和全部实验配置都具有同样许可。论文复现应分别核对动作来源、SMPL 相关依赖、仿真器许可证和机器人厂商软件的使用条件。
从工程迁移角度看,最值得复用的不是某一个固定超参数,而是三个接口。第一是“人体动作必须经过显式物理验收”,在数据进入策略前先拒绝不可能支撑的轨迹。第二是“接触假设要贯穿数据清洗、参考轨迹和奖励设计”,而不是只在训练中加入脚下接触惩罚。第三是“课程尺度可以从策略当前误差估计”,让高动态动作在不同学习阶段获得合适的奖励敏感度。这些接口比单个网络结构更独立于具体人形平台。
结论
功夫机器人提出了一种面向高动态人形全身控制的完整方案:用物理筛选和接触修正提高人体动作的可执行性,用微分逆运动学保持机器人约束,用自适应指数奖励把课程学习嵌入跟踪目标,再通过非对称 Actor-Critic 和域随机化完成零样本迁移。13 个动作、三个难度级别和 G1 真机演示共同说明,高质量参考轨迹与自适应奖励尺度可以显著降低高动态技能的学习门槛。
这篇论文最重要的启示是把“动作像不像”扩展为“动作在机器人上能不能持续”。视觉恢复只负责提出候选运动,物理过滤负责拒绝不可执行候选,接触修正负责把候选放回地面,强化学习负责在动力学约束下兑现它。这个顺序比单纯扩大策略网络更接近真实机器人技能工程的因果链。
金句:高动态动作学习不是把人的轨迹复制给机器人,而是先把人的意图变成一条物理上站得住的轨迹,再让策略学会在每一次失衡和支撑之间把它兑现。