PAPER DEEP DIVE
Social Humanoid:具有社会响应性的人–人形机器人交互
面向29自由度Unitree G1的人–人形机器人全身交互系统,通过共享码本VQ-VAE、Diffusion Forcing与两阶段自适应重定向,从人的动作生成并执行协同响应。
一句话总结
本文把人–人交互动作重定向到 29 自由度 Unitree G1,并用共享运动词表与 Diffusion Forcing Transformer 预测人的后续动作和人形机器人的协同反应,再交给 SONIC 以 50 Hz 执行,形成从 RGB-D 感知到真实机器人全身互动的闭环。
研究背景与问题设定
人形机器人要进入握手、拥抱、击掌、让路和协同搬运等场景,仅有稳定的行走或单臂抓取还不够。机器人必须从对方当前和过去的动作中推断其意图,并在几十帧内产生与自己身高、关节结构、平衡能力和接触方式相匹配的全身动作。与单人动作生成相比,这个问题的困难在于两名行为者共同决定动作是否合理:机器人的反应会改变人的运动,人的下一动作又反过来约束机器人。
现有人–人动作生成方法大多离线工作。它们可以生成视觉上合理的双人骨架序列,却通常不要求结果能在实体机器人上稳定跟踪。另一边,人形机器人运动重定向和全身控制已经能从单段人体动作得到可执行轨迹,但输入通常不包含持续的人际互动,也不会把伙伴未来动作当作生成条件。Social Humanoid 把这两个分支接在一起,目标不是生成一段看似社交的动画,而是输出可由真实 G1 执行、且能随伙伴变化而更新的动作流。
直接使用人–人数据还会遇到形态差异。原始数据里两个人身高接近、手臂长度相似;G1 更矮,关节数量、可达空间和脊柱结构与 SMPL 人体不同。若把两人分别重定向,手与手、手与肩膀的接触点可能错开,甚至悬空数十厘米。若把整对人按同一比例缩小,伙伴又会变成不真实的“小人”,训练分布与部署时面对的正常成年人不再一致。论文的出发点是把“机器人适应人体”和“伙伴适应机器人”改成一个联合但分阶段的几何问题。
系统还受实时性约束。相机、人体姿态估计、网络传输、生成模型和低层控制器共同构成一条延迟链。生成器每次输出未来运动块,控制器则持续追踪已经收到的块;如果生成延迟过大,机器人看到的将是被延迟的人际状态,反应会落在伙伴动作之后。论文因此同时报告交互质量、动作位置误差和端到端时延,而不是只比较离线轨迹的视觉质量。
论文的核心判断可以概括为:如果在人类与人形机器人之间建立共享的离散运动词表,并让扩散序列模型在该词表上同时预测双方未来,那么异构动作空间就能被统一处理;而要在真实机器人上成立,还需要一套保留接触关系的双人重定向流程和能够跟踪全身参考的控制器。这个判断贯穿数据构建、表示学习、序列生成和部署四个层面。
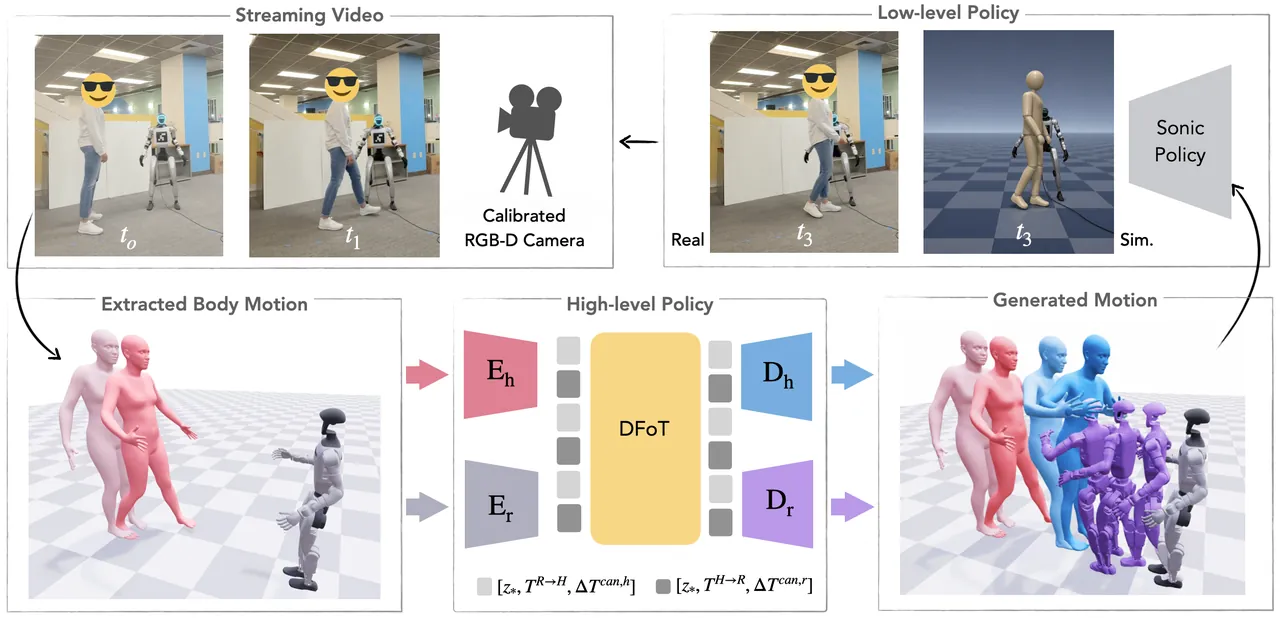
图 1(论文 Figure 2):RGB-D 观测、共享码本 VQ-VAE、DFoT 高层策略与 SONIC 低层控制组成闭环系统。
数据与方法概览
作者从 CHI3D、Hi4D、Harmony4D、Inter-X 和 Embody3D 五个真实人–人交互数据源构建 HHI 基准,并统一重定向到 Unitree G1、重采样到 30 FPS。补充材料给出的总规模约为 260 小时:CHI3D 245 段、0.24 小时;Hi4D 200 段、0.22 小时;Harmony4D 416 段、1.42 小时;Inter-X 22776 段、37.50 小时;Embody3D 14692 段、220.97 小时。数据按 80/10/10 划分训练、验证和测试。
每条双人片段会交换主动方与伙伴角色再重定向一次,使同一段交互中的两种角色都进入数据集。这个处理对反应生成很重要:如果只保留“人主动、机器人跟随”的方向,模型会偏向固定角色,难以在机器人先伸手、伙伴后回应时切换行为。交换角色后,机器人既见过伙伴发起动作,也见过机器人主动发起动作,训练样本的因果方向更平衡。
论文不采用世界坐标系中的绝对轨迹作为网络输入,而以规范坐标表示相对运动。人体的 21 个 SMPL 关节使用 6D 旋转表示;G1 的 29 个驱动关节使用关节角。根节点相邻帧之间的运动写成规范坐标下的六维旋转与三维平移,同时保留规范坐标到根节点的变换,以及两个智能体之间的相对变换。
单个智能体的完整运动可写为:
$$ \mathbf m^{a}=\left[\Delta\mathbf T^{\mathrm{can},a};\mathbf T^{\mathrm{can}\to\mathrm{root},a};\Theta^{a};\mathbf T^{a\to b}\right] $$
其中 $a$ 表示人形机器人或人,$b$ 表示另一方。第一项描述帧间根运动,第二项把规范姿态放到当前根节点,第三项保存本体关节,最后一项把智能体放到伙伴的规范坐标系中。把跨智能体变换直接写进每个 token,网络在预测未来动作时就能同时知道对方相对自己的方向和距离,而不必从绝对坐标中重新猜测。
这个表示也解释了本文为什么能够把“姿态生成”和“空间交互”放在一个序列模型里。若只编码关节角,网络知道机器人手臂抬高多少,却不知道伙伴站得多远;若只编码绝对位置,同一动作换一个房间或初始朝向就会变成不同样本。相对规范表示把与场景绑定的平移剥离,同时保留两人之间的可交互几何。
共享码本 VQ-VAE:把人和机器人放进同一套动作词
人体与 G1 的特征维度不同,直接共享一个连续隐空间会让编码器互相干扰。论文为两个本体分别设置一维卷积编码器和解码器,编码器将序列下采样四倍,并通过膨胀残差块获得较长时域感受野;两路编码结果只共享一个 EMA 向量量化码本。连续特征进入码本时选择距离最近的离散码字:
$$ \mathbf z_t^{a}=\arg\min_{\mathbf c_k\in\mathcal C}\left\|\mathbf v_t^{a}-\mathbf c_k\right\|_2 $$
这使人的动作和机器人的动作都变成一串来自同一词表的 token。由于解码器仍然分属两个本体,同一个语义 code 可以让人解码出人体姿态、让机器人解码出符合自身比例的 G1 姿态。共享的只是“动作概念”的离散索引,不是关节角本身,因此并未假设人的每个自由度都能在一一对应的机器人关节上找到映射。
仅共享码本并不能保证对应帧使用同一个 code。两个编码器完全可能把人的“左手前伸”和机器人的“左手前伸”分配到不同区域。论文因此增加连续对齐损失,让配对帧的编码特征接近:
$$ \mathcal L_{\mathrm{align}}=\left\|\mathbf v^{\mathrm h}-\mathbf v^{\mathrm r}\right\|_2^2 $$
同时把每个编码特征到所有码字的距离视为分类 logits,用对称交叉熵要求人的编码器预测机器人 code、机器人的编码器预测人的 code:
$$ \mathcal L_{\mathrm{agree}}=\frac{1}{2}\left[\mathrm{CE}\left(\ell^{\mathrm h},c^{\mathrm r}\right)+\mathrm{CE}\left(\ell^{\mathrm r},c^{\mathrm h}\right)\right] $$
完整训练目标由双本体重建、VQ commitment 和上述两项对齐构成:
$$ \mathcal L=\mathcal L_{\mathrm{rec}}+\beta\mathcal L_{\mathrm{commit}}+\lambda_{\mathrm{align}}\mathcal L_{\mathrm{align}}+\lambda_{\mathrm{agree}}\mathcal L_{\mathrm{agree}} $$
消融结果说明“共享词表”本身不是充分条件。没有对齐时,人自行重建误差为 3.665 cm、机器人自重建误差为 2.809 cm,看起来都不错;但人动作直接解码为机器人动作时误差达到 12.520 cm,配对帧 code 一致率为 0。连续与离散对齐同时启用后,人→机器人误差降到 2.793 cm,code 一致率升到 0.780,跨本体 Fréchet Distance 从 0.2062 降到 0.0028。
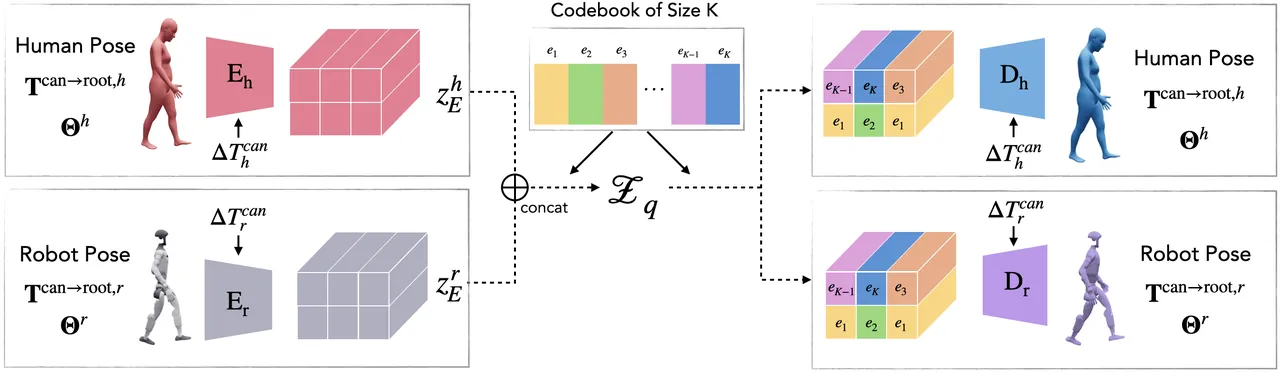
图 2(论文 Figure 3):两个本体使用独立编码器与解码器,只共享向量量化码本;对齐损失负责把对应动作压到相同 code。
Diffusion Forcing Transformer:在双方时间轴上做条件生成
高层策略接收观察窗口内的人与机器人 latent,预测未来一段时间双方的 latent。论文采用 Diffusion Forcing Transformer,因为它允许每个智能体、每个未来帧拥有独立的噪声水平。训练时,上下文帧保持干净,未来帧分别加噪;人的 token 和机器人的 token 不被绑定到同一个扩散时刻。这样网络不能依赖“看到机器人噪声程度就知道人的同一帧噪声程度”这种捷径,必须真正学习跨智能体条件关系。
对智能体 $a$ 的第 $i$ 个未来 token,加噪过程是:
$$ \mathbf z_i^{a}\left(t_i^{a}\right)=\sqrt{\bar\alpha_{t_i^{a}}}\mathbf z_i^{a}+\sqrt{1-\bar\alpha_{t_i^{a}}}\epsilon_i^{a} $$
其中 $\bar\alpha$ 是扩散噪声调度,$\epsilon_i^a$ 是标准高斯噪声。每个 token 的 $t_i^a$ 可以不同,因而模型可以同时处理完全干净的历史、部分损坏的当前帧和高度嘈杂的未来帧。Transformer 使用时间位置编码、噪声水平嵌入和智能体嵌入区分 token 来自哪一方。
生成阶段使用 30 步 DDIM。采样策略矩阵指定不同 token 在每一步保留多少噪声,因此同一个模型可以执行联合未来生成、伙伴动作预测或伙伴 inpainting:若要预测机器人反应,就保留已知人的 token 并生成机器人 token;若要让机器人响应一个给定的未来伙伴动作,也可以把人的未来片段作为条件固定住。论文强调,这些任务通过采样调度切换,不需要为每种任务重新训练模型。
训练损失同时约束 latent、运动空间和自编码重建:
$$ \mathcal L_{\mathrm{total}}=w_{\mathrm{latent}}\mathcal L_{\mathrm{latent}}+w_{\mathrm{motion}}\mathcal L_{\mathrm{motion}}+w_{\mathrm{recon}}\mathcal L_{\mathrm{recon}} $$
论文使用 $w_{\mathrm{latent}}=1$、$w_{\mathrm{motion}}=0.5$、$w_{\mathrm{recon}}=0.5$。latent 损失保证去噪方向正确,motion 损失把预测 token 解码后与真实轨迹比较,防止“latent 距离小但物理解码偏”的情况;recon 损失则绕过扩散,直接把真实动作送进 VQ-VAE 再解码,维持瓶颈的表征能力。三者分别约束生成、物理姿态和表示,而不是把所有压力压在一个损失上。
从交互建模角度看,这种安排让“预测伙伴”与“生成自己”共享一个序列模型。机器人对人类未来的估计不是后处理模块,而是与自身动作在同一扩散网格中联合推断。代价是模型必须区分两个本体的动力学与角色,但共享码本已经把最难的异构输出空间统一。
flowchart LR
    RGBD["RGB-D
15 Hz"] --> TRACK["Human pose
and tracking"]
    TRACK --> CANON["Canonical dyad
representation"]
    CANON --> EH["Human encoder"]
    CANON --> ER["Robot encoder"]
    EH --> CODE["Shared codebook"]
    ER --> CODE
    CODE --> HIST["Observed latent
history"]
    HIST --> DFOT["Diffusion Forcing
Transformer"]
    DFOT --> FH["Future human
latent"]
    DFOT --> FR["Future robot
latent"]
    FH --> DH["Human decoder"]
    FR --> DR["Robot decoder"]
    DR --> RETARGET["Adaptive-HHI
training data"]
    DR --> SONIC["SONIC tracking
50 Hz"]
    SONIC --> G1["Unitree G1"]
    G1 --> CANON
Adaptive-HHI:不让机器人独自吸收形态差
重定向分为两遍。第一遍保留伙伴不动,把主动方人体重定向到 G1。优化目标沿用 OmniRetarget 的 SQP 与交互网格思想,在每一帧求一个包含 29 个驱动关节和 7 维根位姿的 $36$ 维配置。目标是让人形机器人关键点的 Laplacian 坐标接近按身高缩放后的源人体坐标,同时保持机器人手腕、肘部到伙伴关节的距离。
Pass I 的目标可写成:
$$ \min_{\mathbf q_t}\sum_v w_v\left\|\mathcal L\left(\mathbf x_t\left(\mathbf q_t\right)\right)_v-s\mathcal L\left(\mathbf x_t^{\mathrm{src}}\right)_v\right\|^2+\sum_{j\in\mathcal P}\lambda_j\left(r_{j,t}\left(\mathbf q_t\right)-d_{j,t}\right)^2+\lambda_s\left\|\mathbf q_t-\mathbf q_{t-1}\right\|^2+\mathbf q_t^{\top}\mathbf Q\mathbf q_t $$
第一项约束体形局部关系,第二项约束手腕和肘部与伙伴的距离,第三项要求时间平滑,最后一项是姿态正则。优化还受关节限位、信赖域和脚部粘滞约束。手腕与脚部权重并不对称:手腕被放大以保住接触,脚部权重降低以减少人在接触时脚部姿势对机器人站立的影响。
只做 Pass I 时,伙伴仍是原始身高和姿势。G1 较矮,拥抱时伙伴的手可能落在机器人肩膀上方,击掌和握手也会出现够不到或穿过身体的情况。Pass II 因此对伙伴的肩、肘、腕做手臂链 IK,在有人形机器人手臂接触的帧中调整伙伴上肢,使源双人相对位移在机器人尺度下重新成立;在接触程度高的片段,还对腕、胸、颈附近的关键顶点做身体 QP,允许伙伴调整髋、脊柱和膝。
“共变形”并不等于把伙伴整体缩小。论文调整的是姿势和局部关节,保留成年人比例和身高,因此训练数据的伙伴尺度与真实部署对象接近。它也不让机器人承担全部误差:机器人先按自身结构重定向,伙伴再为接触可达性调整。这个顺序比独立重定向或整对缩放更符合真实人际互动的双向适应。
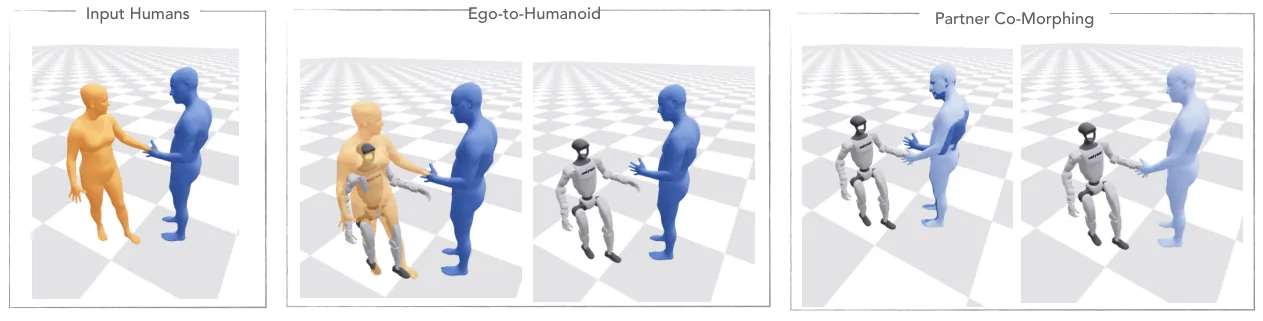
图 3(论文 Figure 4):Pass I 把主动人重定向到 G1;Pass II 在接触约束下共变形伙伴姿势,同时保持其人体比例。
补充材料中的重定向消融显示,Pass I 只加入接触自适应权重时,CHI3D 手腕误差从 OmniRetarget 的 1.379 cm 降到 0.976 cm,但脚滑从 0.009 升到 0.014;再加入接触与可达距离约束后,误差降到 0.501 cm,接触保持率升到 0.936,脚滑降到 0.0034。平均误差约下降 64%,主要收益来自对腕部和可达关系更直接的约束。
真实部署:从相机到 50 Hz 控制
系统使用三脚架上的 ZED 2i 以 1280×720、15 Hz 获取 RGB-D。YOLOv11 检测人,Fast Sam 3D Body 估计 SMPL 姿态,深度用于恢复米制根位置,RANSAC 平面拟合得到重力方向和地面高度,卡尔曼滤波平滑轨迹并保持身份。机器人正面与背面贴有 AprilTag;初始化时用标签把机器人放到同一重力对齐坐标,之后组合 Unitree 板载里程计得到持续位姿。
笔记本负责相机与机器人状态同步,并通过 WiFi 把压缩后的 RGB 和深度传到服务器。人体估计使用两张 RTX 4090 并行运行两个 FS3DB 实例,高层策略占一张 RTX 4090,G1 附近的低层策略运行在 RTX 4060 Mobile 上。输入从 15 Hz 插值到 30 Hz,DFoT 每 7.5 Hz 发出一个 30 Hz 动作块,SONIC 再用 50 Hz 追踪。
论文报告的端到端时延中位数为 308.1 ms,p95 为 376.2 ms。若启用动作块延迟一拍与 100 ms 线缓冲两项可选措施,中位数变为 541.1 ms,p95 为 609.2 ms。感知约占 104.4 ms,人类姿态与全局估计约占 79.4 ms,高层策略约占 103.2 ms,低层约占 21.1 ms。缓冲能提高连续性与网络抖动容忍度,但进一步增加人机反应间隔,这反映了实时互动中稳定性与即时性的直接取舍。
安全验证按仿真、龙门架支持、无龙门架三个阶段推进。SONIC 在操作员启动前保持站立;理想偏航角速度被限制为每秒 45 度;若连续高层预测差异超过 0.7 rad,系统平滑回到站立。五段 60 秒试运行没有观察到不安全生成行为,但作者明确指出低层策略不是力自适应或柔顺控制,物理接触强度并未被主动调节。
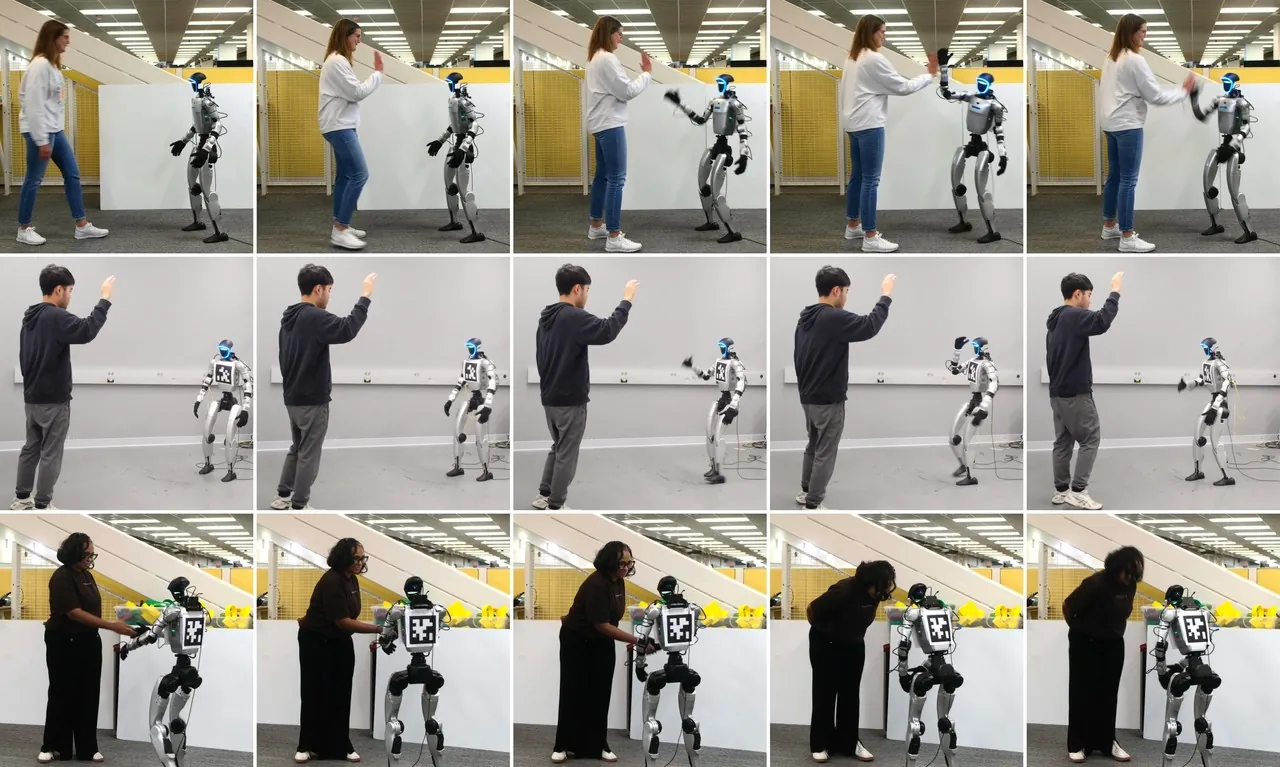
图 4(论文 Figure 6):击掌、挥手,以及从握手直接转入弯腰的连续真实 G1 试验。
实验结果:交互相关性比轨迹拟合更能区分方法
高层策略在完整 HHI 数据上与最近邻检索、随机采样和 Ready-to-React 比较。Social Humanoid 的世界坐标 MPJPE 为 0.128,显著低于 R2R 的 0.545 以及 NN、RS 的约 1.10;速度误差为 0.007,也优于全部基线。交互相关性误差 MI 从 0.056 或 0.088 降到 0.002,说明生成的人与机器人关节关系不仅位置接近,更接近真实双人协同模式。
| 方法 | FD ↓ | FS ↓ | IP ↓ | MI ↓ | MPJVE ↓ | W-MPJPE ↓ |
|---|---|---|---|---|---|---|
| NN | 0.053 | 0.138 | 0.057 | 0.056 | 0.014 | 1.099 |
| RS | 0.180 | 0.134 | 0.058 | 0.056 | 0.015 | 1.100 |
| R2R | 0.504 | 0.921 | 0.088 | 0.088 | 0.019 | 0.545 |
| 本文 | 0.118 | 0.876 | 0.051 | 0.002 | 0.007 | 0.128 |
表中最能说明方法性质的是 MI 与 MPJPE 同时改善。只用 NN 检索训练窗口时,样本本身物理合理,脚滑较低,FD 也最好,但它不一定选到与当前伙伴意图匹配的反应,因此位置误差和交互误差都很大。R2R 生成更灵活,却出现更严重的脚滑和穿插。本文没有在 FD 和 FS 上全面领先,但在跨本体位置、速度、穿插和交互一致性上占优。作者没有掩盖 NN 的 FD 优势,这一点比“所有指标全胜”的叙述更可信。
VQ-VAE 消融进一步区分了离散 token 与共享码本的作用。去掉 VQ 后,FD 为 0.253、IP 为 0.027;分别使用两套码本时,IP 增至 0.088,MI 恶化到 0.212。共享 codebook 版本同时取得最低 FD 0.072、IP 0.026、MPJVE 0.005 和 MPJPE 0.057。关键不在“码本”这个形式,而在两个本体是否真的使用相同的动作单元;独立码本虽然各自压缩良好,却破坏了跨伙伴条件的可迁移性。
重定向与真实执行结果
重定向实验覆盖 CHI3D、Hi4D 和 Harmony4D。本文在三个数据集的姿态误差、接触保持、脚滑和手腕误差上都优于 OmniRetarget。CHI3D 的手腕误差从 1.379 cm 降到 0.501 cm,Hi4D 从 1.729 cm 降到 0.804 cm,Harmony4D 从 2.981 cm 降到 1.909 cm。PHC 在三套数据上的手腕误差分别为 22.382、21.088 和 23.365 cm,说明仅仅生成可追踪的单人动作并不能保住互动点。
| 数据集 | 方法 | MPJPE [cm] ↓ | 接触保持 ↑ | 脚滑 ↓ | 手腕误差 [cm] ↓ | 下游成功率 ↑ |
|---|---|---|---|---|---|---|
| CHI3D | PHC | 6.179 | 0.478 | 0.107 | 22.382 | 68% |
| CHI3D | OmniRetarget | 4.184 | 0.915 | 0.009 | 1.379 | 100% |
| CHI3D | 本文 | 3.893 | 0.936 | 0.003 | 0.501 | 100% |
| Hi4D | PHC | 6.892 | 0.089 | 0.087 | 21.088 | 79% |
| Hi4D | OmniRetarget | 4.704 | 0.827 | 0.006 | 1.729 | 100% |
| Hi4D | 本文 | 4.371 | 0.881 | 0.005 | 0.804 | 100% |
| Harmony4D | PHC | 7.656 | 0.215 | 0.291 | 23.365 | 62% |
| Harmony4D | OmniRetarget | 5.220 | 0.676 | 0.033 | 2.981 | 81% |
| Harmony4D | 本文 | 4.638 | 0.775 | 0.020 | 1.909 | 97% |
Harmony4D 的下游成功率最能体现几何保真度的价值:本文 97%,OmniRetarget 81%,PHC 62%。重定向误差不是孤立的视觉指标,手腕偏移会变成控制器无法完成接触的参考动作。Hi4D 上本文与 OmniRetarget 都是 100%,说明当原始互动较接近机器人尺度时,接触约束的边际收益会缩小;Harmony4D 包含更多野外多人场景和更大形态差,方法差异因此放大。
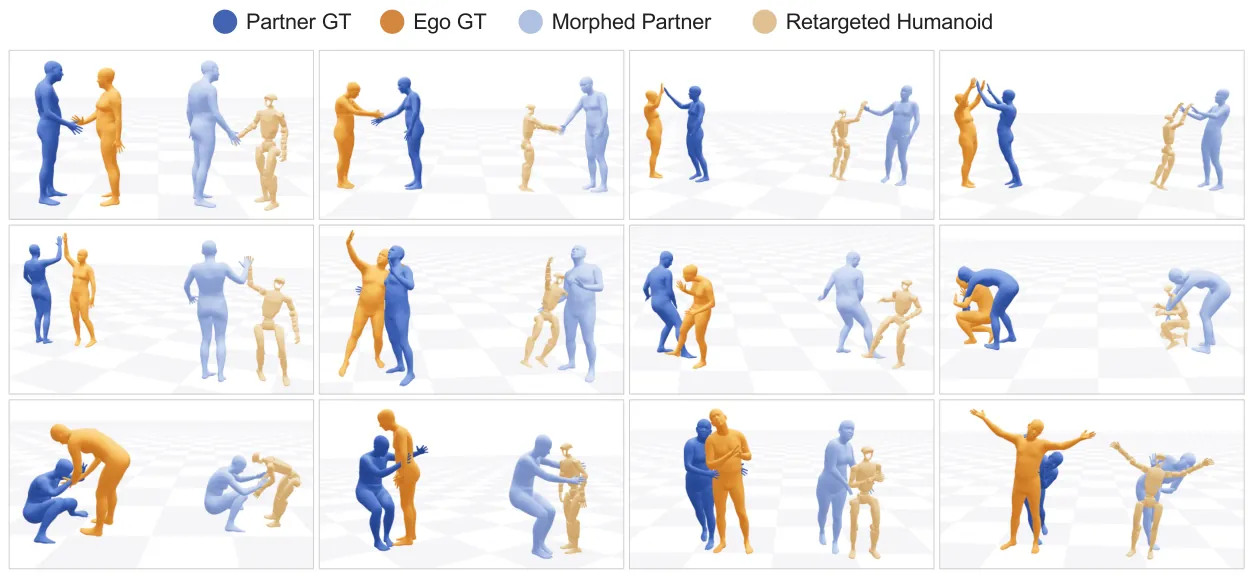
图 5(论文 Figure 5):橙色与深蓝为原始双人,浅褐与浅蓝为重定向后的机器人与共变形伙伴,接触和相对位置得到保留。
真实机器人与仿真各测试六类场景,每类 30 次。仿真成功定义为低层策略完成跟踪且不摔倒或出现不安全行为;真实试验成功定义为 G1 做出正确反应、完成互动且无需操作员干预。四名参与者参加了真实试验。握手、挥手、拥抱、弯腰和挽臂在仿真与真实机器人上都是 100%,击掌两项均为 90%。真实成功率与仿真完全一致,说明主要失败来自高层生成的动作块,而不是 sim-to-real 跟踪突然失效。
| 互动场景 | 仿真成功率 | 真实 G1 成功率 | 试验次数 |
|---|---|---|---|
| 握手 | 100% | 100% | 30 |
| 挥手 | 100% | 100% | 30 |
| 击掌 | 90% | 90% | 30 |
| 拥抱 | 100% | 100% | 30 |
| 弯腰 | 100% | 100% | 30 |
| 挽臂 | 100% | 100% | 30 |
这些数字不能直接等同于“社交能力”。成功判据关心动作是否完成、机器人是否摔倒以及是否有人工接管,并没有测量参与者是否感到自然、舒适或被理解。击掌的 10% 失败也提醒我们,快速接近、接触时机和手掌空间关系比静态姿势更难。论文将真实试验作为执行可行性证据,而不是社会交互质量量表,这个边界应当保留。
影子遥操作与共享词表的额外价值
共享码本还允许单次前馈式跨本体翻译:人的动作经过人体编码器、共享码本和机器人解码器直接变成 G1 动作,不使用机器人历史,也不运行优化式重定向。作者用这个路径做影子遥操作,演示操作员抬臂和坐到沙发时 G1 跟随全身姿态。机器人不是逐关节复制人体,而是通过自己的运动学重建动作。
这一能力与主任务共享同一表示。若码本只是为每个本体各自压缩,跨本体解码会得到语义错位的动作;对齐损失把配对帧的 code 拉到一起后,人的姿势才能在机器人本体上被合理解释。影子遥操作因此是表示对齐的直观检验,也为缺少配对机器人数据时利用人体动作提供了路径。
局限与边界
作者明确列出若干限制。系统不建模手指关节、面部表情和物体姿态,因此能完成全身拥抱或握手轮廓,却无法表现握手的力度、手指包覆、眼神接触和共同操作物体的精细状态。人际互动中的大量社会线索恰好存在于这些细节里,缺少它们会让同样的身体动作产生不同解释。
感知依赖现成的 Fast Sam 3D Body、深度估计和身份跟踪,低层执行依赖 NVIDIA SONIC。Social Humanoid 的贡献主要位于数据重定向、共享表示和高层生成,不包含一个新的鲁棒姿态估计器或接触力控制器。相机遮挡、快速交叉、多人身份切换或深度失效都可能沿感知链传递到生成端,论文没有分别量化这些误差对最终互动成功率的影响。
系统的重定向和生成都是运动学层面。虽然低层控制器能让动作在物理世界中稳定执行,高层没有显式建模接触力、人体舒适度、疼痛阈值或安全距离。论文的安全机制包含操作员监督、速度限制和异常动作回退,但作者也说明低层策略不是力柔顺的。对于拥抱、搀扶和人群穿行等场景,仅保证不摔倒是必要条件,不是安全交互的充分条件。
真实试验规模和社会评价仍有边界。四名参与者、每类 30 次、六个预定义场景能够证明 G1 可执行这些动作,却不足以分析年龄、身高、文化习惯或陌生人对机器人接近速度的接受程度。论文只覆盖双人互动;多人同时交谈、围绕机器人移动或需要轮流等待的场景,需要新的伙伴选择、社会注意力和多智能体序列模型。
从方法内部看,共享码本是离散瓶颈,可能损失细微、连续的人体动作差异。论文的码本大小与重建误差在补充材料中有配置,但没有系统分析极端慢动作、快速击掌或局部遮挡下的 code 稳定性。DFoT 的 308 ms 中位时延对慢速拥抱可以接受,对高速让路或突发避让仍可能过慢。作者用缓冲提高稳定性,却进一步增加延迟,说明系统尚未解决“高动态、低延迟、强接触”三者同时要求的场景。
讨论:这项工作真正改变了什么
第一项改变是把 HHI 数据构建从“单人重定向后拼接”变成双人接触约束问题。Adaptive-HHI 让人和机器人共同调整,但不改变伙伴尺度,保住了训练分布和部署对象之间的一致性。消融中手腕误差与 Harmony4D 下游成功率同时改善,说明几何接触保真度会直接影响控制可执行性。
第二项改变是把跨本体生成从后处理翻译变成共享的序列建模问题。人形机器人不需要先生成人体动作再求解 IK,而是在统一 token 空间中与伙伴一起预测。共享码本负责找语义对应,DFoT 负责时间与因果条件。这个方法可以扩展到其他异构双人组合,例如机械臂与工人、四足机器人与行人,但需要重新定义接触点和本体编码器。
第三项改变是给出了完整的系统证据链,而不是只展示离线视频。论文报告重定向误差、生成指标、仿真成功率、真实 G1 成功率和分阶段时延,读者可以看到每个环节如何约束下一步。它仍不是社会智能的终点,但把“会生成社交动作”推进到“能在真实人形机器人上按时执行一段协同全身动作”。
总结与展望
Social Humanoid 的技术路线由四个互相依赖的部分组成:用 Adaptive-HHI 把真实人–人动作变成保留接触的 G1 数据;用带连续与离散对齐的共享码本把人体与机器人动作压到同一离散词表;用 Diffusion Forcing Transformer 在双人时间轴上条件生成;用 SONIC 把生成轨迹落实到 50 Hz 的真实机器人控制。论文的主要说服力来自重定向、生成和真实执行三层结果能够相互解释。
下一步最值得补的不是再增加一个视觉展示场景,而是把手部、面部、物体和接触力纳入同一闭环,并在更多参与者与更复杂多人环境中测量舒适度、可预测性和失败恢复。代码与数据尚未公开,也意味着复现仍需等待作者释放实现。即便存在这些边界,本文已经清楚展示了异构具身交互中一个关键原则:共享表示只有与接触几何和可执行控制一起设计,才会从动画能力变成机器人能力。
金句:社交人形机器人真正要共享的不是人的关节角,而是人与机器人对“此刻正在发生什么、下一步该如何回应”的共同动作词表。