PAPER DEEP DIVE
反思、重试、奖励:强化学习驱动的自改进 LLM
论文提出 Reflect-Retry-Reward 框架:模型首次答错后生成自反思,再带着反思重试;若重试成功,就用 GRPO 只奖励反思 token。方法仅依赖二元反馈,使 1.5B-7B 模型在函数调用和数学方程生成上显著提升,小模型可超过同族约 10 倍规模的模型。
论文元信息
标题:Reflect, Retry, Reward: Self-Improving LLMs via Reinforcement Learning
作者:Shelly Bensal、Umar Jamil、Christopher Bryant、Melisa Russak、Kiran Kamble、Dmytro Mozolevskyi、Muayad Ali、Waseem AlShikh,全部来自 Writer, Inc.
版本:arXiv 2505.24726v1,2025 年 5 月 30 日提交,领域 cs.CL。
链接:https://arxiv.org/abs/2505.24726
代码状态:论文正文与参考文献未提供公开代码仓库。按标题、论文句式和作者检索 GitHub 后,也未找到官方实现;实现描述集中在 TRL 的 GRPOTrainer 扩展、vLLM 拒绝采样与任务验证器。
一句话总结
这篇论文把失败后的自反思当作可训练对象:第一次回答错误时让模型反思,第二次回答成功后,GRPO 只给反思 token 发奖励,从而在仅依赖二元验证器的条件下提高函数调用与算式构造能力。
研究背景与动机
大语言模型在数学、代码、推理和工具调用上的能力已经很强,但模型仍有可复现的盲区。一个任务成功了,并不保证同类任务也成功;一个模型在某个基准上很强,也不保证它能在新的可验证任务上稳定输出。最常见的解法是收集失败样例并继续微调,但这要求失败分布已经被系统性收集,并且往往需要人工标注或教师模型生成答案。
合成数据是另一条路线:让更强的模型生成示范,再把这些示范交给较小模型学习。可如果任务本身连最大模型也常常失败,教师模型就无法稳定提供正确答案;如果任务受许可、隐私或工具环境限制,收集大规模示范也会变得昂贵。论文正是在这个约束下提问:当可用的监督只剩“对/错”时,模型能否自我改进?
提示词层面的自反思早已存在。模型先生成答案,再生成自我批评,然后根据批评修订答案。这类方法不需要训练数据,但效果高度依赖提示词写法,而且模型并不总是可靠地识别自己的错误;对已经很强的模型或简单提示,反思有时还会引入噪声。
训练层面的自纠正方法则试图把这种能力写入参数。已有工作会微调自纠正轨迹,或把它建模成多轮强化学习。但许多方案仍依赖更大的教师模型来产生数据或监督。本文选择更严格的设定:不引入外部教师,不把正确答案直接当作奖励,只用一个二元验证器判断第一次尝试是否失败、第二次尝试是否成功。
作者把学习目标从“学会解决某个任务”移到“学会在失败后产生有效反思”。这个移位很关键。任务专属训练会优化最终答案,训练分布之外的收益往往有限;而失败后的反思是跨任务的结构性行为。只要任务可以验证成败,同一套机制理论上就能接管反馈,不需要把每个任务的正确解答都转成训练信号。
预备知识:GRPO 为什么适合这里
GRPO,即 Group Relative Policy Optimization,由 DeepSeekMath 提出。与 PPO 不同,它不维护一个单独的价值网络,而是在同一查询下采样一组补全,用组内奖励的相对位置估计优势。对于只在序列结束时给一次反馈的场景,例如“算式是否等于目标”“代码是否能执行”“函数调用是否正确”,这个设计避免了训练额外 critic 的成本。
给定查询 $q$,GRPO 为每个旧策略参数 $\theta_{\text{old}}$ 采样 $G$ 条补全 $y_i$。若验证器把第 $i$ 条补全的成功与否记作 $v(q,y_i) \in \{0,1\}$,组内优势可写成:
$$\hat A_i=\frac{v(q,y_i)-\operatorname{mean}_{j\in[1,G]} v(q,y_j)}{\operatorname{std}_{j\in[1,G]} v(q,y_j)+\epsilon}$$
这里 $\epsilon$ 是数值稳定项。这个式子的作用是把稀疏的二元结果转换成组内比较信号:同一批样本里,成功者得到正优势,失败者得到负优势。策略更新随后会提高有正优势补全的概率,降低有负优势补全的概率。
本文的难点在于:模型实际做了两段生成。第一段是原始回答;失败后有一段自反思;然后基于反思重试。如果直接把第二次尝试的成功记给整条序列,更新会同时奖励反思 token 和第二次答案 token。作者只希望模型学会反思,而不是重新学习某个任务的答案,因此需要一个能把奖励限制在反思片段上的机制。
方法详解
1. 先定义可验证性,再定义训练流程
整个方法的前提是一个二元验证器:
$$v(q,y)=\mathbb{1}\{y \text{ satisfies } C(q)\}$$
其中 $q$ 是查询,$y$ 是模型输出,$C(q)$ 是任务约束。函数调用要求选对工具、参数名、参数值和格式;算式构造要求只使用给定数字、每个数字恰好一次,并且结果等于目标值;代码任务可以检查是否能执行。这个验证器不必输出分数,只需要输出 0 或 1。
对每个查询,模型的第一次生成记作 $y_0 \sim \pi_\theta(\cdot \mid q)$。若 $v(q,y_0)=1$,流程终止,因为现有能力已经足够。若 $v(q,y_0)=0$,则把失败信息加入上下文,生成自反思 $r$:
$$r \sim \pi_\theta(\cdot \mid q,y_0,c_{\text{fail}})$$
随后把原始任务和反思一起放回上下文,得到第二次尝试 $y_1$:
$$y_1 \sim \pi_\theta(\cdot \mid q,y_0,r)$$
这三条生成不是三种不同任务,而是同一个状态机里的连续动作。失败触发反思,反思触发重试,重试结果决定反思是否被记功。
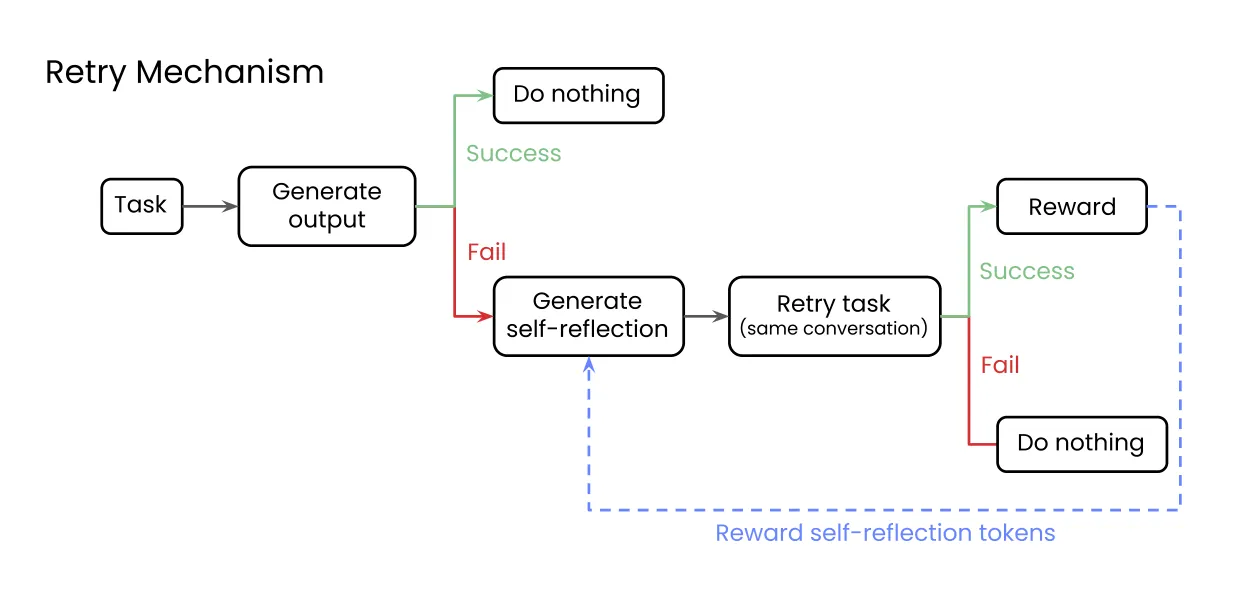
图 1:论文的 Reflect, Retry, Reward 机制。第一次失败后生成反思;带反思重试成功时,只有反思 token 被强化。
2. 奖励只落在反思 token 上
设第二次尝试的成功标志为 $s=v(q,y_1)$。只有 $s=1$ 时才产生正学习信号。关键奖励结构可以写成:
$$\hat A_i^{(t)} = \hat A_i \cdot \mathbb{1}\{t \in R_i\}, \quad R_i=\{t:\text{token }t\text{ belongs to reflection }r_i\}$$
这里 $\hat A_i^{(t)}$ 是第 $i$ 条轨迹中第 $t$ 个 token 的优势,$R_i$ 是自反思片段的 token 索引集合。若二次尝试失败,自反思没有得到正向强化;若二次尝试成功,即使最终答案本身也来自第二次生成,策略梯度也不直接强化那段答案。第一答、重试答和所有非反思 token 的优势都置为 0。
这个设计的含义比“只奖励反思”更极端:模型不是因为“写对了函数调用”而更新,而是因为“写出了能把错误转化成成功的那段话”而更新。作者明确把最终答案排除在学习信号之外,是为了防止模型记住 Countdown 的某个算式或 APIGen 某个工具的参数组合,也希望反思行为更接近任务无关的策略。
若把 token 级策略梯度展开,可以被理解为:
$$\nabla_\theta J(\theta)=\mathbb{E}\left[\sum_{t\in R}\hat A \, \nabla_\theta \log \pi_\theta(r_t\mid q,y_0,r_{{<t}})\right]$$
式中 $r_{{<t}}$ 表示当前反思 token 之前已经生成的反思前缀。只有这些反思条件概率会收到梯度;原始回答和二次回答的 token 不进入求和。GRPO 的比例项和裁剪仍可在 TRL 中照常处理,但梯度被这个掩码压缩到反思段。
再考虑 GRPO 常用的参考策略 KL 约束:
$$J_{\text{KL}}(\theta)=\mathbb{E}\left[\sum_{t\in R}\hat A \, \nabla_\theta \log \pi_\theta(r_t\mid \cdot)\right]-\beta\,D_{\mathrm{KL}}\!\left[\pi_\theta\|\pi_{\text{ref}}\right]$$
作者把 KL 系数设为 0.001。这个数值很小,目的是保留探索空间,同时避免反思训练把语言模型拉得过远。强化信号来自二元成功,KL 正则提供稳定性,两者共同约束反思分布的漂移。
3. 只用失败查询构造训练集
训练没有遍历完整任务集,而是先构造一个失败数据集。作者对每个查询最多采样 64 次,只保留所有采样都被验证器判为失败的查询。模型越大,初始成功率越高,需要的采样次数通常越多;因此作者对较大模型采样更多响应,用 vLLM 的前缀缓存加速拒绝采样。
这种做法有三重作用。第一,已经总能答对的查询对训练自反思没有价值,跳过它们节省算力。第二,随机采样让“偶尔失败”的查询也有机会进入训练集;如果某查询 80% 概率正确,20% 的失败仍然承载可学习的不确定性。第三,只保留失败查询后,作者能更直接观察模型在真正困难样本上收敛到有效反思需要多少数据。
作者强调这只是效率与分析上的选择,功能上等价于在线收集到的成功与失败混合流。关键区别不是训练分布被人为排除了成功案例,而是验证器先把确定不可学的部分滤掉,让强化学习集中在失败边界附近。
4. 把单步 GRPO 改成多步
TRL 的 GRPOTrainer 通常处理一次生成到一次奖励。本文扩展了它的 _prepare_inputs,加入 second_step。第一次补全生成后,trainer 不立刻更新,而是保留已经计算好的注意力掩码,再做第二段补全生成。由于训练输入来自失败数据集,第一段补全对应自反思,掩码正好圈住反思 token。
这个实现使下游奖励函数能同时看到初始补全和后续步骤的状态。作者指出,这种多步结构可以接入任意复杂奖励机制;但论文实验只使用最简单的二元成功信号。也就是说,架构扩展保留了更大自由度,实际奖励仍然极其克制。
训练上限为 1,750 步,有效批大小是 256 个失败查询;多数模型明显提前收敛,作者在收敛点取评估结果。优化器使用 5e-7 学习率、0.03 warmup 比例和余弦退火;KL 系数 0.001;每个模型使用 4 到 8 张 H100。作者将范围限制在 1.5B 到 8B,因为 GRPO 在更大模型上的计算与可扩展性仍是已知瓶颈。
实验设置与结果
APIGen 函数调用
APIGen 包含 60,000 条函数调用样本,测试集为 12,000 条。每条样本包括用户查询、候选工具及其 JSON 参数、正确函数调用。数据集共 4,211 个工具,工具平均 2.3 个参数,每个查询平均有 2.8 个候选工具,最少 1 个,最多 8 个。只有工具名、参数和参数值都正确才判为成功。
为避免数据污染,作者只评估 APIGen 发布前就存在的模型:Qwen2 1.5B/7B Instruct、Llama3.1 8B Instruct、Phi3.5-mini Instruct,同时报告 Qwen2 72B、Llama3.1 70B、Palmyra-X4 73B 的未训练基线。不同模型家族使用不同工具调用模板,作者测试后选择能带来最强基线的模板,而不是挑一个让基线弱的格式。
结果中,原生模型加一次反思平均带来 4.5 个百分点的提升;训练后,许多模型的一次尝试已经超过原生两次尝试。反思重试再平均增加 4.7 个百分点。最突出的对比是:Qwen2 7B 训练后二次尝试达到 77.3%,超过 Qwen2 72B 原生二次尝试的 76.6%。
| APIGen | 原生一次 | 原生二次 | 训练后一次 | 训练后二次 |
|---|---|---|---|---|
| Qwen2 1.5B Instruct | 32.6% | 34.8% | 48.6% | 52.9% |
| Qwen2 7B Instruct | 66.4% | 69.4% | 72.2% | 77.3% |
| Llama3.1 8B Instruct | 64.9% | 70.9% | 68.7% | 74.9% |
| Phi3.5-mini Instruct | 47.5% | 50.2% | 52.9% | 56.0% |
| Qwen2 72B Instruct | 73.7% | 76.6% | — | — |
| Llama3.1 70B Instruct | 66.8% | 76.9% | — | — |
| Palmyra-X4 73B | 79.9% | 83.5% | — | — |
表 1:APIGen 12,000 样本测试集上的准确率。训练只奖励反思 token,但一次尝试也普遍提高。
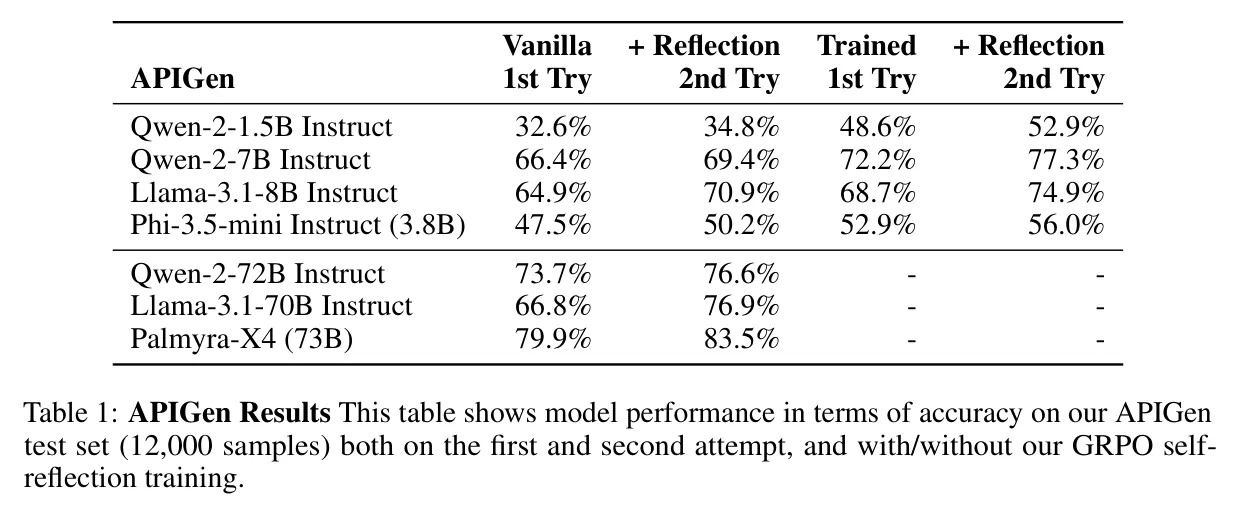
图 3:论文 Table 1 的原始结果版式,便于核对训练前后与一次、二次尝试的对照关系。
Countdown 算式构造
Countdown 来自 TinyZero 项目,训练侧有 450,000 个题目,测试集 15,000 条。给定 3 到 4 个数字和一个目标,模型必须用基本算术符号构造等式;所有给定数字都要用,而且每个数字只能用一次。验证器不需要标准答案:它检查表达式是否合法、数字是否约束满足、求值是否命中目标。
形式化看,若输入数字向量是 $\mathbf{x}$,生成的运算符序列是 $\mathbf{o}$,目标值是 $T$,验证条件可写成:
$$v(\mathbf{x},\mathbf{o},T)=\mathbb{1}\left\{\operatorname{eval}(e(\mathbf{x},\mathbf{o}))=T \wedge \operatorname{operands}(e(\mathbf{x},\mathbf{o}))=\operatorname{multiset}(\mathbf{x})\right\}$$
这里的第二个乘项表示表达式实际使用的操作数多重集合必须与输入数字多重集合一致。这个条件让模型不能靠引入额外数字或丢弃数字来“碰中”目标,也不能重复使用某个方便的数。
这个任务的提升幅度更大。原生反思平均提高 5.3 个百分点,训练后反思重试的平均增益达到 8.6 个百分点;论文结论给出 Countdown 平均提升 16.0%。Llama 系列起点极低,Llama3.1 8B 只有 2.2%,训练后二次尝试到 17.8%;Qwen2.5 1.5B 从 6.0% 到 45.0%。Qwen2.5 7B 训练后二次尝试达到 50.3%,超过 Qwen2.5 72B 原生二次尝试的 49.9%。
| Countdown | 原生一次 | 原生二次 | 训练后一次 | 训练后二次 |
|---|---|---|---|---|
| Qwen2.5 1.5B Instruct | 6.0% | 10.2% | 34.9% | 45.0% |
| Qwen2.5 3B Instruct | 18.8% | 29.0% | 33.9% | 47.3% |
| Qwen2.5 7B Instruct | 31.7% | 38.0% | 41.6% | 50.3% |
| Llama3.1 8B Instruct | 2.2% | 4.6% | 8.8% | 17.8% |
| Llama3.2 3B Instruct | 2.1% | 3.0% | 8.8% | 13.8% |
| Palmyra 1.7B | 26.8% | 31.8% | 33.3% | 38.6% |
| Qwen2.5 32B Instruct | 38.6% | 45.1% | — | — |
| Qwen2.5 72B Instruct | 45.2% | 49.9% | — | — |
| Llama3.1 70B Instruct | 17.3% | 25.5% | — | — |
| Palmyra-X4 73B | 46.8% | 51.6% | — | — |
表 2:Countdown 15,000 样本测试集上的准确率。低基线模型的提升空间更明显。
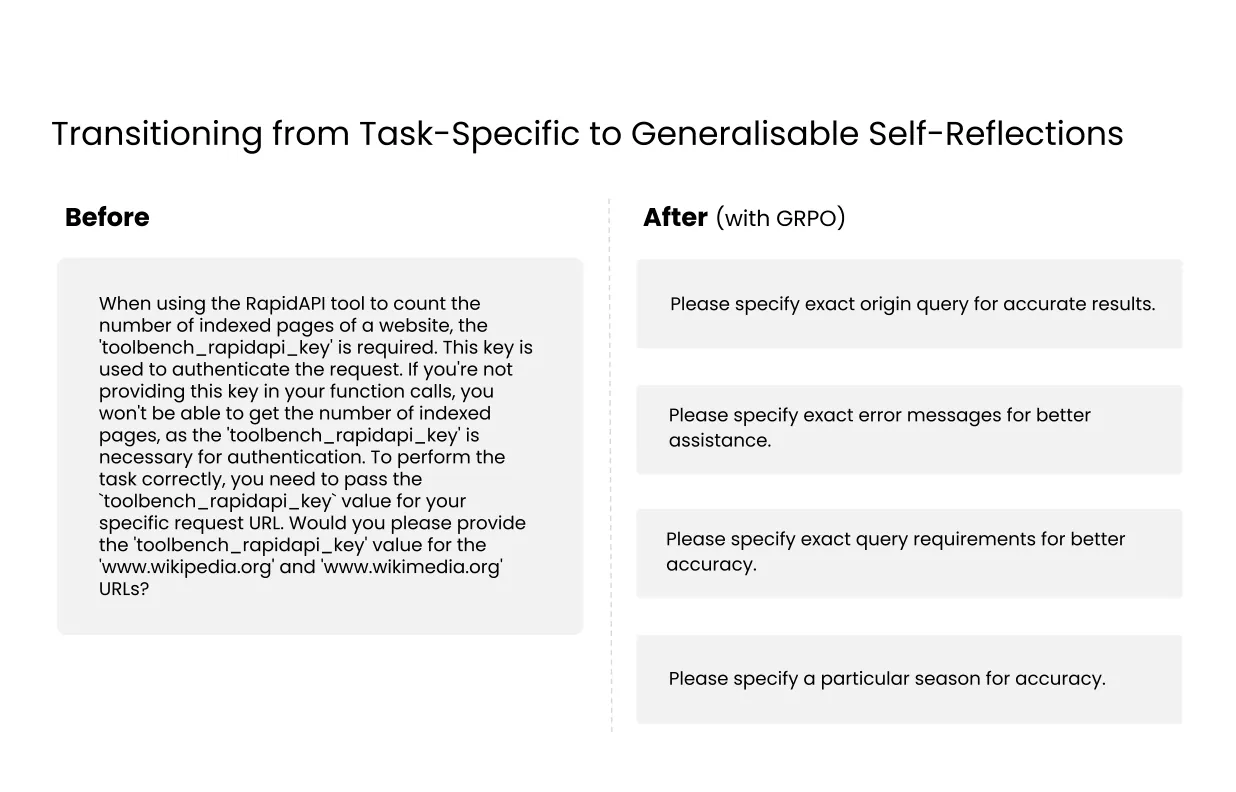
图 2:同一模型训练前后的自反思示例。训练后的反思更短、更清晰、更少重复。
反思变短,而不是变长
图 2 是这篇论文最有意思的定性观察:原生模型的自反思通常冗长、含混、反复重述;GRPO 训练后的自反思更短、更直接。这与“长链思维带来更好推理”的常见直觉相反。作者没有据此宣称短反思永远更好,而是把何时应该简洁、何时应该冗长留作开放问题。
从强化学习角度看,这个现象很合理。奖励不是给思考长度,而是给“能让第二次尝试越过验证器的反思”。冗长解释如果提高了下次生成的噪声,就不会被强化;紧凑的错误定位如果可靠地改变后续上下文,就会反复被选中。模型学到的是奖励相关的前缀,不是人类的修辞偏好。
错误类型分析
论文附录把错误分成类型。APIGen 上分为工具选择错误、参数错误和格式错误。Qwen2 1.5B 的工具选择错误从 33.9% 降到 21.3%,格式错误从 8.2% 降到 4.8%,但参数错误保持 25.3%。Qwen2 7B 的工具选择错误从 5.2% 降到 3.5%,参数错误从 27.2% 降到 22.7%。这说明小模型主要补工具选择,7B 到 8B 模型主要补参数选择。
| APIGen 错误分析 | 工具选择错误 | 参数错误 | 格式错误 |
|---|---|---|---|
| Qwen2 1.5B:原生 → 训练 | 33.9% → 21.3% | 25.3% → 25.3% | 8.2% → 4.8% |
| Qwen2 7B:原生 → 训练 | 5.2% → 3.5% | 27.2% → 22.7% | 1.2% → 1.6% |
| Llama3.1 8B:原生 → 训练 | 4.6% → 3.7% | 28.5% → 25.6% | 2.0% → 2.0% |
| Phi3.5-mini:原生 → 训练 | 18.8% → 17.6% | 24.8% → 23.9% | 8.9% → 5.7% |
表 3:APIGen 首次尝试错误分类。训练没有消除全部参数错误,但把最大的瓶颈向前推了一步。
灾难性遗忘很小
由于目标是反思而不是任务专属答案,作者评估了 MMLU-Pro、GSM8K、HellaSwag 和 MATH。结果如表 4:大多数指标变化小于 1%,有些甚至略升。Qwen2.5 1.5B 的 MMLU-Pro 从 30.9% 到 31.5%,MATH 从 25.5% 到 26.3%。这说明小系数 KL 与掩码奖励没有把模型强行推向单一任务分布。
| 通用基准 | MMLU-Pro | GSM8K | HellaSwag | MATH |
|---|---|---|---|---|
| Qwen2 1.5B:原生 → 训练 | 22.1% → 21.9% | 59.6% → 59.5% | 66.0% → 66.1% | 21.2% → 20.9% |
| Qwen2 7B:原生 → 训练 | 43.4% → 42.8% | 77.6% → 77.0% | 80.7% → 80.5% | 34.0% → 33.7% |
| Qwen2.5 1.5B:原生 → 训练 | 30.9% → 31.5% | 59.4% → 58.0% | 68.3% → 68.3% | 25.5% → 26.3% |
| Qwen2.5 7B:原生 → 训练 | 44.8% → 44.2% | 84.2% → 82.1% | 80.5% → 80.5% | 42.3% → 40.3% |
| Llama3.1 8B:原生 → 训练 | 41.0% → 40.9% | 78.0% → 77.7% | 79.3% → 79.3% | 31.1% → 31.5% |
表 4:通用能力检查。绝大多数退化低于 1 个百分点。
这张图为什么不是通用流程图
下面的流程图对应本文的两个关键分支:只有在第一次失败后才进入反思,只有在重试成功后反思才获得正优势。第一次成功、第二次失败都不更新反思分布;重试答案本身也不被强化。
flowchart TB
    Q[Query q] --> Y0[First answer y0]
    Y0 --> V0{Validator v q y0}
    V0 -->|Success 1| Stop[No policy update]
    V0 -->|Failure 0| Fail[Add failure context]
    Fail --> R[Generate reflection r]
    R --> Y1[Retry answer y1]
    Y1 --> V1{Validator v q y1}
    V1 -->|Success 1| Mask[Set advantage mask to R]
    Mask --> GRPO[GRPO updates reflection tokens only]
    V1 -->|Failure 0| NoReward[No positive reward for r]
    GRPO --> Next[Improved reflection policy]
局限性
第一,作者自述:不是每个任务都能方便地定义二元验证器。生成式写作、开放式规划、安全判断或主观评价很难压缩成 0/1。有标注时可以用标准答案,也可以让更大模型当裁判,但这又引入了新的可靠性问题。裁判误差会被强化学习利用,反而学到迎合裁判的模式。
第二,作者也承认方法并非对所有模型和任务有效。模型必须先具备基本的执行、反思和学习能力。Llama3.2 3B Instruct 在函数调用上就无法学会自纠正。作者尝试过更小的 0.5B 和 1B 模型,发现它们既难以准确作答,也难以反思,因此没有报告结果。
第三,从实验设计看,函数调用验证器依赖 APIGen 的精确标准答案,而不是只检查真实 API 调用是否成功。这保证了评测可控,但也可能低估语义等价但字面不同的调用。真实工具环境中的副作用、鉴权和状态变化会带来另一层约束。
第四,两次尝试仍然是有限步。论文没有测试反思超过一次后的收益、反思链是否稳定,也没有证明在更难任务或更大模型上,只奖励反思段仍足够。GRPO 的计算瓶颈也使 8B 以上模型未被训练验证。
总结与展望
这篇论文的价值不在提出一个新 RL 算法,而在重新切开奖励面。传统任务 RL 把成功归因于整个输出;这里把成功归因到失败之后、重试之前的那段自反思。二元验证器只需要判断边界是否被跨过,反思文本本身告诉模型怎么跨过边界。作者用这个简单接口把函数调用准确率平均提高 9.0%,把 Countdown 提高平均 16.0%,而且 7B 训练模型在两个任务上都超过了同族 72B 未训练模型的二次尝试表现。
对工程实践而言,这给出一条务实路线:如果系统已经能自动判定成功,就可以从真实失败流里采样,给模型一次反思机会,再用组相对优势更新反思 token。它不需要大规模教师标注,也不需要把每个任务的最终答案变成训练目标。后续工作需要回答三个问题:反思训练能否跨任务迁移;更复杂的任务图能否拆成多个可验证边界;以及当反思与最终答案的因果贡献更难分离时,掩码奖励是否仍足够。
当监督只剩一个 0 或 1,模型仍然可以进步:只要错误后多了一次成功,就把功劳记给那段让它跨过边界的反思。