
通过自我反馈强化学习对大语言模型进行后训练
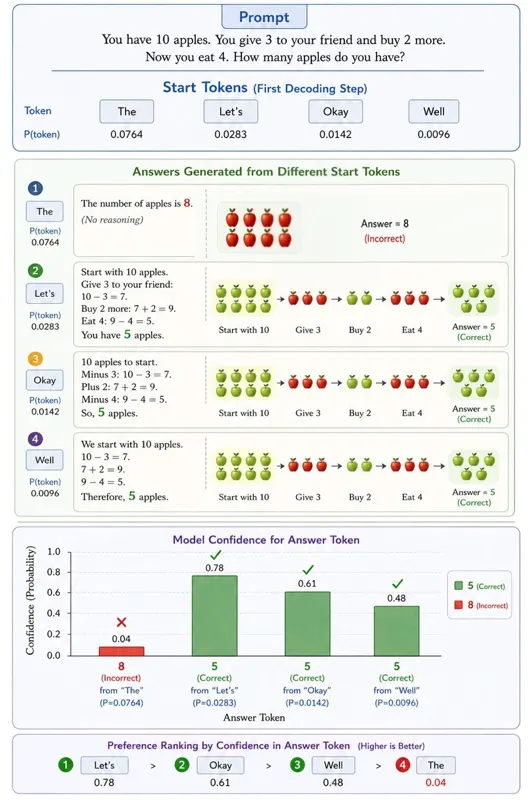
大语言模型常给出看似合理但过度自信的答案,校准误差会削弱高风险推理场景的可靠性。本文提出自我反馈强化学习 RLSF:冻结模型生成多条思维链解码轨迹,以最终答案片段的模型置信度排序,自动构造偏好对,再用 PPO 或 DPO 后训练策略,无需人工偏好、标准答案或外部奖励。实验表明,RLSF 能改善算术推理和多选问答上的校准与准确率,并让一次贪心解码接近多路解码的可靠性;但收益依赖初始模型,部分准确率或校准指标仍可能回退。
Carel van Niekerk, Renato Vukovic, Benjamin Ruppik · 46次阅读 · 2025年7月29日
Large Language Models强化学习
2025年7月29日