RLSR:基于自我奖励的强化学习
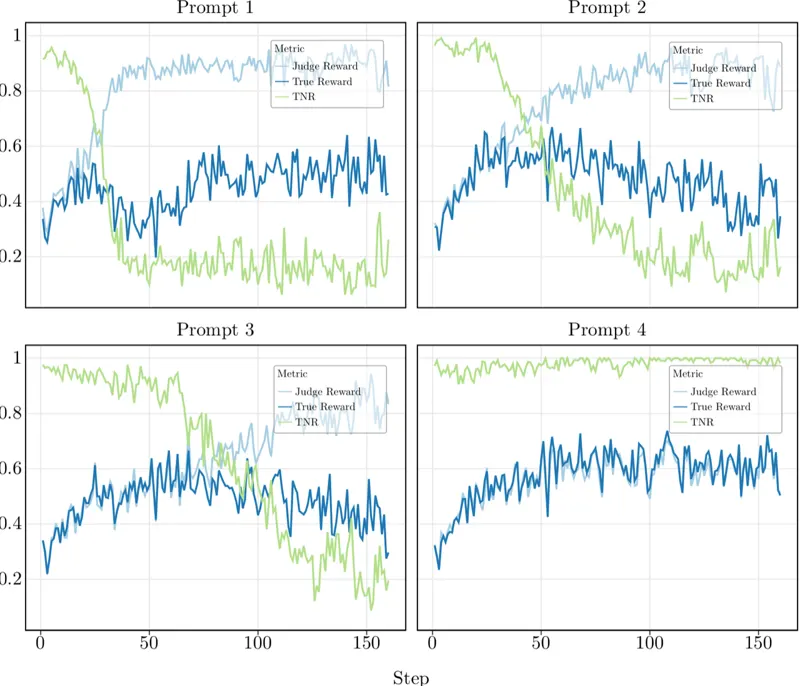
这篇论文把大模型自身当作二值 judge,用“答案是否正确”的判定替代需要专门工程的可验证奖励,驱动 GRPO 训练。方法利用生成与验证之间的能力不对称:Qwen 2.5 7B 生成 Countdown 答案约为 36%,而判定答案为 96%。作者在 Countdown、简单积分和 MIT Integration Bee 上验证该信号,其中 Qwen 2.5 7B DeepSeek Distilled 从 13% 提升到 75.5%,达到 73% 的 MIT Integration Bee 资格线。论文同时指出 judge 提示词脆弱、小模型易被 reward hack、连续更新 judge 会崩溃。
Toby Simonds, Kevin Lopez, Akira Yoshiyama · 176次阅读 · 2025年5月12日
强化学习Large Language Models
2025年5月12日