Skip to content
←返回能力前沿雷达

SOTA · 语言与推理

多模态理解

图文理解、图表与文档问答、视觉推理

多模态理解是 agent 能不能进入真实世界的门槛能力:文本描述不了的东西(一张截图、一份图表、一段视频帧、一个界面状态)只能靠视觉通路进来。它与 AGI 的关系有两点。一是它与生成共享表征:能看懂空间关系与语义,才能按指令重建它们,所以理解侧的 `multimodal` 与生成侧的 `image` 分成两个域却共用一套判断逻辑——理解的尺子是 MMMU、MathVista、ChartQA、DocVQA,生成的尺子是竞技场偏好。二是它决定了 agent 的行动面:计算机使用、机器人视觉、文档处理、视频理解,全部要先能看懂,再看懂之后的规划才有意义。梯顶按「第三方读数 + 真实用途」排:已同步的 Arena Agent 榜(2026-09-22)量的是把真实任务推进了多少,榜首 Claude Fable 5.1 净改进 13.71、GPT-6 Astra 11.54,这两条比任何单点视觉分更接近「多模态理解在生产里管不管用」。资产侧则收跨模态产品与生成模型的视觉通路:GPT-Image 2.5 与 Qwen-Image 2.1 是图像侧的读数,Gamma 是文档侧的落地形态,而 Gemini Omni 是这个域里唯一同时满足「第三方竞技场读数(文生视频 Elo 1516/1784 票)」与「置信度已确认」的一条,它把看懂视频与改视频放进同一个对话回合,说明多模态理解正在从静态图走向时序内容。

尺子MMMU、MathVista、ChartQA、DocVQA

SOTA 阶梯

6
多模态理解文档与演示梯顶C

Gamma:把「一份长材料」直接变成「一份能讲的演示」的编排型工具

Gamma 做的不是「写提示词出一页幻灯片」,而是把一份既有材料重新组织成一份可讲的演示:吃进长文档、PDF、粘贴的文本或一个网址,输出带大纲、分页、配图与版式的整套 deck,并且以「卡片式」结构让每一页都能单独重排、重写、换图。它代表文档与演示领域真正有用的那一类 AI——价值在编排与信息取舍,不在生成质量。它的天花板也同样清楚:输出是它自己的排版系统,导出到 pptx 之后样式还原度会掉一层,而这恰好是多数组织的硬性要求。

网页 / pptx / pdf输出形态厂商宣称 · 2025-01
产品Gamma Tech官网
Gamma:把「一份长材料」直接变成「一份能讲的演示」的编排型工具
视频生成影音创作梯顶A

Gemini Omni:视频交付单位从「一次抽卡」变成「一段可对话的编辑过程」

Google DeepMind 的视频与多模态生成模型,官方定位 create anything from any input, starting with video:逐步对话编辑视频,每次编辑建立在上一次之上并维持连贯场景,交付单位从一个镜头提到可改素材;另两条:真实世界知识、任意参考合成单一输出。水位连票数读:Artificial Analysis 竞技场(2026-09-22)文生视频榜 gemini-omni-1.1-flash 以 Elo 1516 第 1,但只有 1,784 票、CI ±15;第 2 同门 1513、26,576 票、±9,3 分差远小于各自 CI,统计不可区分,即 Omni 系列并列榜首。图生视频榜第 1 是 minimax-h3(1495、57,112 票),Omni 以 1488、3,734 票第 2。定价:输入 $1.50/1M tokens,输出文本 $9.00/1M、视频 $17.50/1M,720p 约 $0.10/秒、30 秒约 $3。付费层 GA、免费层无。闭源不可自托管、不能微调。置信度 A(已确认),视频域首条 A 档;A 指读数可信可核,不等于无争议第一。

1516Arena T2V Elo(1784 票)已确认 · 2026-09
产品Google DeepMind官网
Gemini Omni:视频交付单位从「一次抽卡」变成「一段可对话的编辑过程」
图像生成设计与前端梯顶C

GPT Image 2.5:把「多轮改图不走样」写成 API 契约的图像旗舰

OpenAI 2026-09-08 发布的图像生成与编辑模型,分 Flare(默认档:画质高于 GPT Image 2、延迟低 50%)与 Sunburst(精度档:用更长生成时间换复杂细节保真)两个变体,共 4 个端点(各一个文生图 + 一个编辑),API 面与价格完全一致。能力面:长边 3840px、6 档质量(auto/low/medium/high/xhigh/max,比上代多两档天花板)、单次最多 16 张参考图编辑、可选 mask、PNG/WebP 真 alpha 透明输出。发布重点是「多次编辑之间细节保持一致」与「基于批注只改一处」,即多轮改图不漂移。第三方水位:Artificial Analysis 竞技场(2026-09-22)上,sunburst 同时是文生图第 1(Elo 1423)与图像编辑第 1(1526),flare 双榜第 2(1401/1482),是唯一双榜登顶的系列;但两行都还标 preliminary、票数(8791/8014)远少于被超越的 gpt-image-2(82862)。闭源、只走 ChatGPT 与 API,不能自托管或微调。未做基准复现,置信度记 C(厂商宣称)。

1423/1526Arena 文生图 / 图像编辑 Elo 双榜第 1厂商宣称 · 2026-09
产品OpenAI官网
GPT Image 2.5:把「多轮改图不走样」写成 API 契约的图像旗舰
图像生成设计与前端梯顶C

Qwen-Image-2.1:一套开放权重同时做生成、局部编辑与透明输出

阿里 Qwen 的图像生成与编辑一档,把文生图、局部编辑(圈选/涂抹/独立 mask)、最多 10 张参考图融合与原生 RGBA 透明输出收进同一个 7B 视觉生成组件(32 层 Single-Stream DiT),并用混合粒度注意力与前缀 KV 缓存复用压低批量出图的边际成本;原生 2048px、7 档宽高比。它是当前可下载权重里图像竞技场排位最靠前的一档(文生图第 17 / Elo 1228,图像编辑第 16 / 1367),但许可是 Qwen Research License 而非 Apache-2.0,商用前必须单独读条款,diffusers 还需从 git 主干安装。未做基准复现,置信度记 C(厂商宣称)。

7B视觉生成组件参数厂商宣称 · 2026-09
产品阿里 Qwen (Alibaba)官网Repo
Qwen-Image-2.1:一套开放权重同时做生成、局部编辑与透明输出
图像生成设计与前端梯顶D

Nano Banana Pro:把「聊天式改图」做成产品形态的图像编辑模型

Gemini 的原生图像生成与编辑一档,社区叫它 Nano Banana。它的关键不是画质峰值,而是交互形态:多轮对话里持续改同一张图、能读图里的文字再改、能把多张参考图合成一张。这让图像生成第一次像「和设计师对话」而不是「抽卡」。它的排名多来自偏好竞技场,那是投票不是测量,记为待复现。

产品Google DeepMind (Gemini image)官网
Nano Banana Pro:把「聊天式改图」做成产品形态的图像编辑模型
Agent文档与演示C

Muse:Meta 的长时任务个人 agent
Meta 2026-09-08 在美区发布的个人 AI agent:iOS/Android/Web,跑在云端 VM 上,用 chat 下目标、能看着它操作浏览器,Sentinel 权限把读写分开。

美区 · iOS / Android / Web首发平台(Meta 官方)厂商宣称 · 2026-09
产品Meta官网
Muse:Meta 的长时任务个人 agent
最新演示

57

论文与深读

41
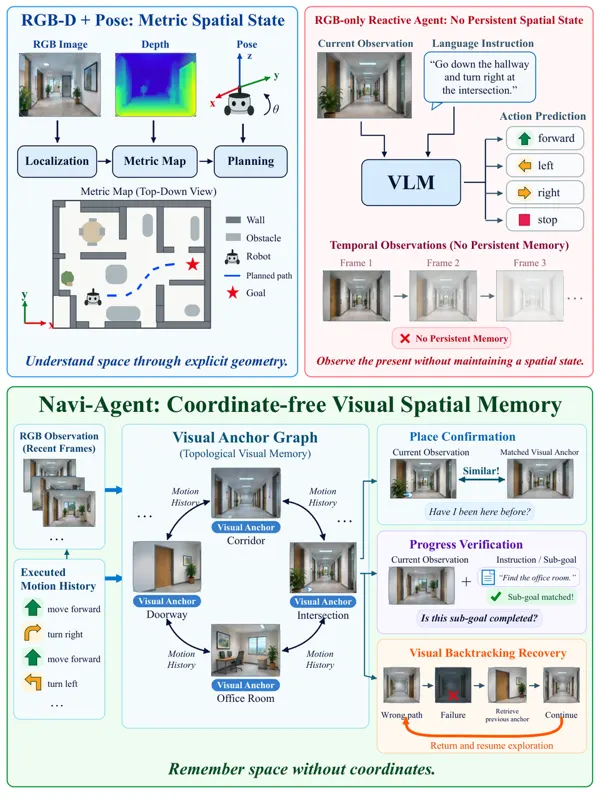
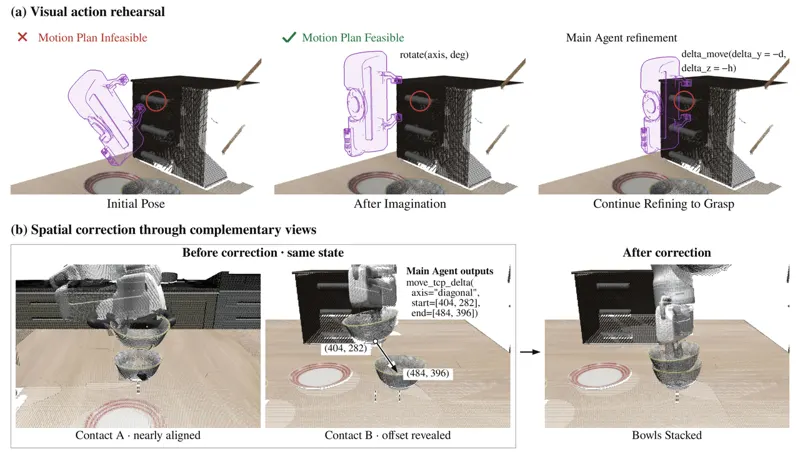
World Action Agent:让 VLM 在视觉动作工作区里驾驶机器人2026-09-24World Action Agent:让 VLM 在视觉动作工作区里驾驶机器人香港科技大学(广州)、香港中文大学与 Knowin AI 提出 World Action Agent(WAA),一个多智能体 harness——它不改 VLM,而是改 VLM 看到什么、以及它的决策如何生效,让通用 VLM 只用点选、拖拽、预览、执行等基础工具就能驾驶机器人,所有决策都在同一个「视觉动作工作区」内完成。工作区有三个性质:其一是 Contact views,根据交互区域、遮挡、取景紧凑度、视点冗余与稳定性主动求解相机参数,且约束两个视图的水平投影正交,使任何对齐误差都能沿两个独立方向被读出,且只需基坐标系点云,因此对 RGB-D 融合、仿真渲染或 VGGT 重建等感知来源完全无关;其二是动作试演,把每个动作表示为可编辑提案,由 cuRobo 规划后以半透明机器人叠加到各视图并报告可行性,Imagination Agent 在物理场景不变的独立上下文中反复修订,只有具备可执行规划的提案才能变成物理运动;其三是视图内修正,智能体在观察到误差的 Contact view 中从参考点拖到期望位置,参考点可以是所持物体上的可见点,因此无需先把关系换算成绝对位姿。技能侧由 Learner、Editor、Reviewer 三个角色在证据与独立审核约束下从专家视频与人类 Canvas-GUI 教学中进化出关系型多模态技能库。LIBERO-Pro 上以 Gemini 3.7 Flash 为骨干、仅用 LIBERO-90 进化并冻结的技能取得 75.6% 平均成功率的 SOTA,超过 ASPIRE(72.0%)、端到端 VLA 与同骨干的 Show-Harness(6.7%),Spatial 两个切分达 80.0 / 73.3;每回合仅 31 次模型调用、150 秒、0.1996 美元,远低于 Show-Harness 的 120 次、874 秒、0.5021 美元。同一套冻结技能迁移到 robosuite 达 100.0%;用 112 条轨迹(1,774 决策步)LoRA 微调 Qwen3.5-9B 只替换主智能体,域外成功率从 1.7% 提升至 43.3%。
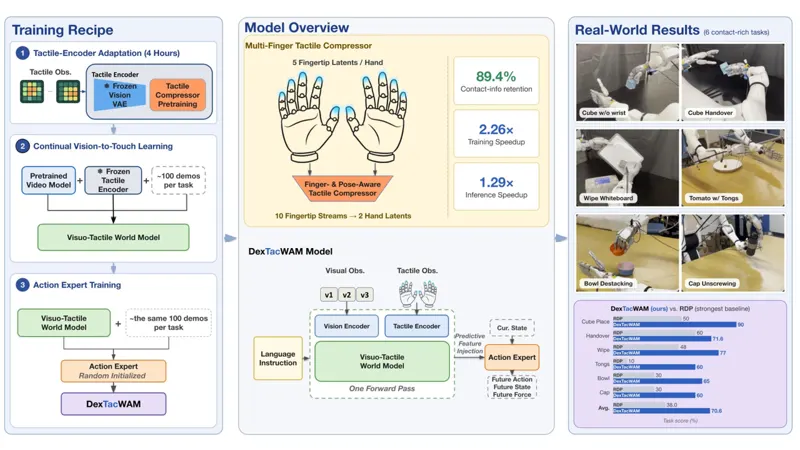
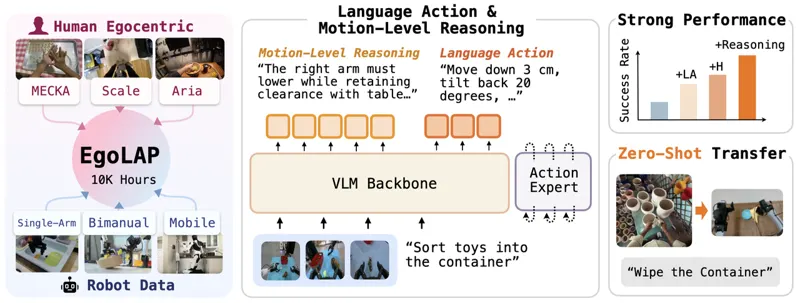
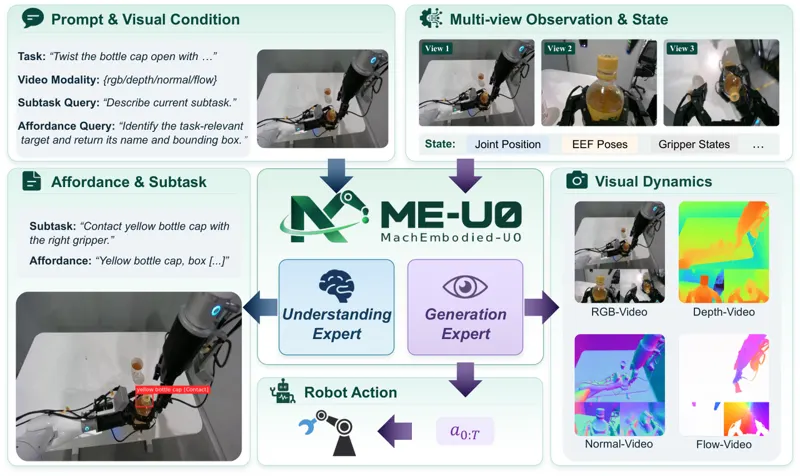
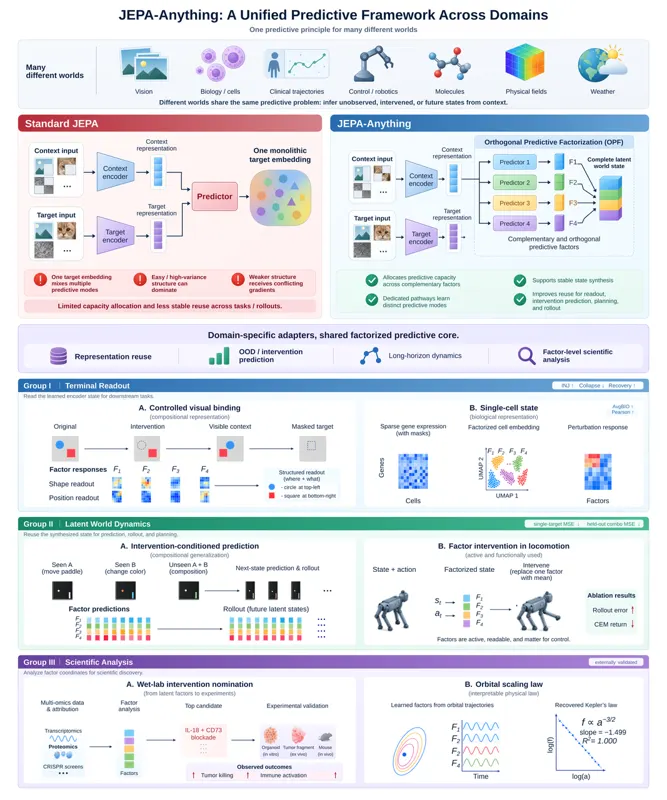
MachEmbodied-U0:理想汽车的统一理解-生成具身基础模型2026-09-22MachEmbodied-U0:理想汽车的统一理解-生成具身基础模型理想汽车 Foundation Model 团队提出 MachEmbodied-U0(ME-U0),一个把理解与生成专家统一进 Mixture-of-Transformers 架构的具身基础模型。理解专家以自回归文本生成输出子任务描述与可供性定位(含边界框、交互方式与交互点);生成专家用 flow matching 联合去噪未来视觉动力学(RGB、深度、表面法线、光流)与连续机器人动作,四种视觉模态共享同一个视频 VAE 隐空间与生成骨干,无需分模态预测头。Multi-rate Rotary Position Encoding(MRPE)解决动作比视频密三倍带来的时间对齐问题:保留视频隐帧的共享时间位置,给块内每个动作按次序分配不同的高度轴索引,配合 H_a = 3(H_v - 1) 的采样规则,形成每视频隐步对应 12 个动作步的一致跨模态时间结构。数据侧从约 5,700 小时机器人示范加 3,920 小时第一人称示范中精选出约 4,200 小时,覆盖四个开源数据集与六种本体(AgiBot G1 占 52.8%);三阶段清洗依次做突变检测、状态-动作一致性检查与物理边界检查;Ego2Robot 合成流水线用 Depth Anything 3、SAM3、ProPainter、SAM3D、两阶段 PPO 与 MuJoCo/Mink 逆运动学把人类示范转为机器人对齐的观测与轨迹标注。实验在下游不补任何子任务、可供性、几何与运动标注的前提下取得 RoboDojo 17.66 分(WAM 组最强,精度 23.95、长程 36.98 领先最明显)、LIBERO 99.0%、LIBERO-Plus 82.5%,并保留零样本的子任务预测、可供性接地与视觉动力学能力。作者诚实指出记忆类任务最弱(Score 8.42),因模型不显式保留观测历史。
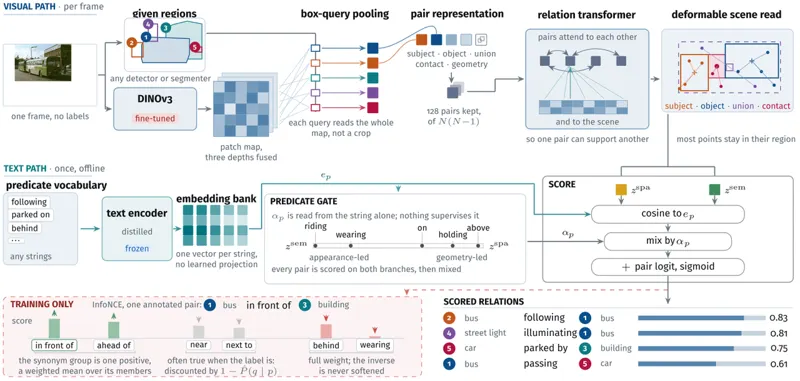
RelateAnything:任意区域输入下的实时开放词汇关系预测2026-09-11RelateAnything:任意区域输入下的实时开放词汇关系预测开放词汇检测允许在推理时接受任意类别列表,可提示分割能在没有类别名的情况下返回区域:分类体系已经离开模型、成为输入,而关系预测尚未如此。场景图模型仍在一个标注风格的 50 或 56 个谓词上训练与评测,关系头以物体标签为条件,因而与单一检测器绑定。本文指出三个障碍:不存在既自由文本又经过验证的关系语料;以标签为条件的架构无法接受训练时没见过的词汇;标准指标奖励与训练语料的一致性,使更大的词汇量反而表现为退步。RelateAnything 是一个 5300 万参数模型,输入图像与任意来源的区域,输出在推理时以字符串形式给出的谓词词汇上的打分关系;物体标签从不作为输入,词汇是文本嵌入库而非学习出的分类器,推理速度为每帧 20 毫秒。为支撑 19103 个谓词的训练,论文提出正-未标注监督与能够区分反义词的文本编码器(对比式编码器把反义词嵌入到余弦 0.95),并构建 RA-4M:47.4 万张图像、430 万条关系、10102 个自由文本谓词,对着编号框标记生成并经几何门验证;评测上构建 OV-SGG-Bench 六轴跨数据集协议。在三个跨数据集基准与一个零样本基准上,平均召回达到同规模最强开放词汇方法的 2.3 至 3.5 倍,并以不足其 2% 的参数量超过 3B 视觉语言场景图模型;域内评测会把迁移收益高估约 5 倍。模型、语料与基准均已公开。

开源项目

1

现在就能用的资产

这个域还没有挂上可直接装用的 skill。

边界与失败模式

这个域的失效方式最安静,也最贵。一是细节读取不可靠:图内小字、表格里的数值、密集界面里的状态,模型会给出语法通顺但数字错误的答案,且不表达犹豫;文档与图表问答在评测集上分数很高,在生产里对关键数字仍必须复核——任何「读图得出数值」的结论都默认降一档。二是分辨率与切片策略是隐藏变量:同一张图走不同预处理(整图 vs 切块 vs 降采样)结果差别很大,而厂商通常不披露,这使跨模型比较失去意义。三是长视频与多图的时间对齐仍然弱:能描述单帧,说不清「先发生什么」,视频理解在几十秒之后开始遗忘。四是幻觉与视觉接地脱钩:模型会用训练先验补上图像里不存在的物体,尤其在图模糊或问法带暗示时,这是安全域与这个域的共同上游问题。五是评测本身偏窄:MMMU、ChartQA 这类题目是干净截图与规范图表,真实世界是倾斜的手机拍照、被压缩的扫描件、混排的 PDF,分布外表现普遍显著低于榜面。成本与延迟:视觉输入的 token 计费远高于文本(一张高分辨率图常抵几百到上千 token),多轮图像对话的成本增长比纯文本快一个量级;延迟上,首 token 时间受图像编码支配,大图预处理经常比生成还慢。

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。