PAPER DEEP DIVE
EgoLAP:通过语言-动作推理从第一视角人类数据中学习
第一视角人类视频规模大、行为多样,但人手与机械臂之间的具身差异使原始人类轨迹难以直接作为机器人控制的监督信号。EgoLAP 的核心主张是:低层动作是具身特定的,但其背后的运动意图可以跨人类与机器人迁移。框架把运动意图写成两种共享的文本目标——用结构化、时间抽象的自然语言动作(language action)概括一秒内位姿与夹爪的变化,用运动级推理(motion-level reasoning)给出接触、几何与物体 affordance 层面的物理依据,二者串成一条人-机共享的语言动作思维链。模型以 PaliGemma-2B 为 VLM 主干,配一个 3 亿参数、从零初始化的动作专家,经流匹配预测连续动作块;文本目标只监督主干(知识隔离),推理期仅 rollout 动作专家、不生成任何文本,因而不牺牲实时控制。在约 1 万小时人-机混合数据(ABC、EgoVerse、OXE 等)上预训练后,EgoLAP 在定制双臂真机上取得 80.1% 的平均任务进度,比 FAST、OAT 等动作表示高 2.3 倍;在零样本双臂仿真上达 38.3%,比直接用同域真机数据训练的 ABC-VLA 高 1.8 倍。运动级推理与语言动作强协同(真机 +35.6 点),而对非语言 token 几乎无益;跨 embodiment 技能检索最多提升 25 点,表明共享文本目标重塑了表征几何。
论文元信息
标题:EgoLAP: Learning from Egocentric Human Data through Language-Action Reasoning(EgoLAP:通过语言-动作推理从第一视角人类数据中学习)
作者:Lihan Zha、Shresth Grover、Tenny Yin、Samuel M. Bateman、Hengkai Pan、Mengchao Zhang、Aykut Onol、Allen Z. Ren、Dhruv Shah、Anirudha Majumdar(Princeton University、Toyota Research Institute、Physical Intelligence)
链接:arXiv:2610.08726v1 [cs.RO],2026-10-06;项目主页 https://ego-lap.github.io/
代码状态:本文未公开 EgoLAP 训练代码,仅发布项目主页。其直接前作 LAP(Language-Action Pre-training)的开源实现位于 github.com/lihzha/lap,其中语言动作的序列化与反序列化代码与本文方法逐行对应,可作为方法复现的参照。
一句话总结
EgoLAP 把人手与机械臂的运动统一写成"自然语言动作 + 运动级物理推理"这条共享的语言思维链,让第一视角人类视频与机器人轨迹在同一语义空间里互相监督,从而在双臂真机上取得 80.1% 的平均任务进度,比其它动作表示高 2.3 倍。
研究背景与动机
机器人基础模型的进步长期依赖机器人示教数据的规模扩张,但示教采集昂贵、场景狭窄,远远覆盖不了人类日常活动的广度。第一视角人类视频则天然具备规模与行为多样性:它记录长程操作、发生在真实家庭环境、且不依赖任何机器人平台而独立增长。如何把这份"人类经验"变成机器人控制的监督信号,是具身智能的核心问题之一。
已有工作大多通过手工设计的中间表示来桥接两种 embodiment:交互热点与 affordance、手部姿态或图像空间轨迹、隐式规划、或者对视频做"换体"编辑。这些表示各自捕捉了人类行为的某个侧面,但它们继承了提取管线本身的归纳偏置与失败模式——手姿估计会错、点跟踪会漂、换体会失真——因而难以规模化。更根本的困难是 embodiment gap:人手与机械臂在形态、运动学与控制频率上差异巨大,直接把人类低层动作当作控制监督是无效的。
本文的关键洞察是:人手与机器人不必共享低层动作,它们需要共享的是运动意图(motion intent)——即"应当产生什么运动"以及"在当前物理状态下为什么这个运动是合适的"。前者用语言动作(language action)表达:对一秒内位姿与夹爪变化的结构化、时间抽象的自然语言描述,例如"前进 3 厘米、顺时针旋转 14 度、闭合夹爪"。后者用运动级推理(motion-level reasoning)表达:把接触、几何与物体 affordance 与下一次运动的预期效果联系起来的局部物理依据。
语言动作之所以有效,是因为它复用了视觉-语言模型(VLM)已有的词表与组合结构,把控制相关的监督放进主干网络预训练时就理解的语义空间里;而非语言的动作 token(如 FAST、OAT)则与预训练分布脱节,阻碍跨 embodiment 迁移。但仅有"做什么"还不够:同一任务在不同 embodiment 上需要的具体运动不同,因此必须补上"为什么"。运动级推理正是填补这一空缺的监督形式——它比子任务规划或视觉轨迹更底层,直接连接到低层动作,却又能在 embodiment 之间迁移。
把两者结合,就得到一条物理落地的"动作思维链"(action chain-of-thought):先推理"为什么这个运动合适",再给出"具体执行什么运动"。EgoLAP 正是围绕这条思维链构建的 VLA 预训练框架,它在训练期用文本目标对齐人类与机器人的运动语义,在推理期却只 rollout 连续动作专家,不生成任何文本,从而保留实时控制能力。
预备知识
VLA 与动作表示。视觉-语言-动作模型通常用离散动作 token 监督 VLM,有时再配一个连续动作专家负责实时控制。离散目标的选择尤为关键,尤其当动作专家的梯度不回传到 VLM 主干时。FAST、OAT 等学习型 tokenizer 优化动作压缩或 token 结构,而 LAP 一族则直接用自然语言描述运动,以兼容 VLM 的预训练语义空间。
流匹配(flow matching)。连续动作块 $a_{t:t+K}$ 由一个速度场网络 $v_{\phi}$ 通过插值与去噪学习:训练时把真实动作与高斯噪声按时间 $\tau$ 混合,让网络预测从噪声指向真实动作的速度;推理时从纯噪声出发沿学习到的速度场积分回动作。它比扩散模型采样更快,适合机器人控制。
知识隔离(knowledge insulation)。为防止随机初始化的连续动作专家的梯度侵蚀 VLM 预训练好的语言表征,在主干与专家的边界处停止梯度回传。主干只由文本目标优化,专家则学习消费主干的表征。
方法详解
3.1 问题形式化与共享离散目标
设机器人数据集 $\mathcal{D}_{R}$ 含样本 $(o_{t},\ell,s_{t},a_{t:t+K})$,其中 $o_{t}$ 为一路或多路 RGB 观测,$\ell$ 为任务指令,$s_{t}$ 为本体感知状态,$a_{t:t+K}$ 为 horizon 为 $K$ 的动作块。人类数据集 $\mathcal{D}_{H}$ 含第一视角样本 $(o_{t},\ell,q_{t:t+K})$,$q$ 为头相机坐标系下一路或两路手部姿态;当前姿态 $q_{t}$ 充当状态输入 $s_{t}$,相邻姿态之间的相对运动定义连续动作块 $a_{t:t+K}$。
每个样本最多提供三路训练信号。第一路是一个确定性的规范化器 $G_{e}$,它只依赖 embodiment 元数据 $e$(单臂机器人、双臂机器人、人类数据),产出共享的离散动作 token 目标 $m_{t}$:
$$m_{t}=G_{e}\!\left(q_{t:t+K}\right)\quad\text{或}\quad m_{t}=G_{e}\!\left(a_{t:t+K},s_{t}\right)\tag{1}$$
在 EgoLAP 中 $m_{t}$ 就是一句语言动作,概括自我中心坐标系下一秒的手部或末端执行器运动。受控基线则把这一离散目标换成 FAST 或 OAT token,其余训练配方保持不变。第二路信号是运动理由 $r_{t}$,它把 $m_{t}$ 落到可见的空间关系、接触证据、物体 affordance 与运动的预期物理效果上。第三路信号是连续动作块 $a_{t:t+K}$ 本身,直接监督实时控制。
3.2 模型架构:注意力与梯度的结构化
EgoLAP 采用 Mixture-of-Transformers(MoT)架构,把一个 PaliGemma-2B 视觉-语言主干与一个从零初始化的 3 亿参数动作专家配对。VLM 接收最多三路 RGB 图像(一路基相机 + 两路腕相机)、任务指令与本体感知状态;缺失的相机视角以零填充。状态被归一化后离散为 256 个均匀 bin,作为文本拼进 prompt。
注意力掩码是这套设计的核心。图像、指令与状态 token 构成双向前缀;推理 token 与语言动作 token 注视该前缀并在自身内部保持因果;而动作专家只注视自己的 token 与观测-指令-状态前缀,绝不注视推理或语言动作 token。因此推理期无需任何文本生成。同时,知识隔离在 VLM 边界处截断来自动作专家的梯度,主干只被文本目标优化。
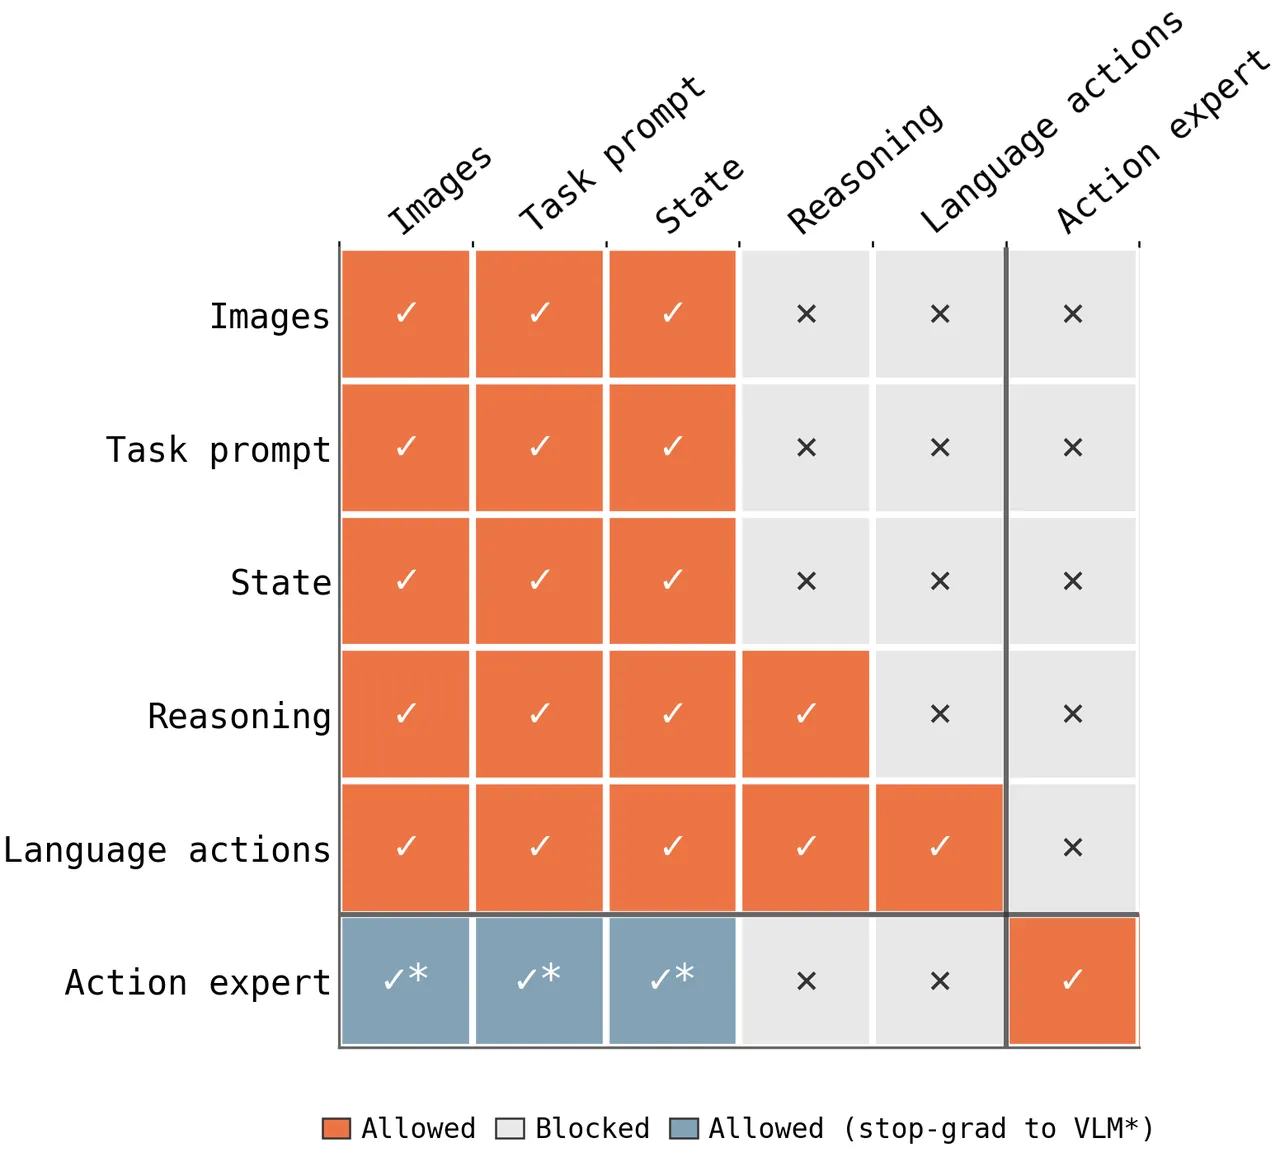
图 1:注意力与梯度结构。橙色为允许的注意力,灰色为被阻断,蓝色为在 VLM 边界处停止梯度的注意力。动作专家 token 从不注视文本目标,因此控制无需文本生成。
训练目标上,设 $D$ 为动作维度,动作专家以流匹配预测 $a_{t:t+K}\in\mathbb{R}^{K\times D}$(delta 末端位姿空间),损失为 $\mathcal{L}_{\mathrm{FM}}$;$\mathcal{L}_{\mathrm{text}}$ 为语言动作与运动级推理的期望掩码 token 级目标;$\lambda_{\mathrm{text}}$ 权衡两者。完整损失为:
$$\mathcal{L}=\mathbb{E}_{(x_{t},a_{t:t+K},m_{t},r_{t})\sim p_{\mathrm{mix}}}\left[\lambda_{\mathrm{text}}\mathcal{L}_{\mathrm{text}}+\mathcal{L}_{\mathrm{FM}}\right]\tag{2}$$
其中 $p_{\mathrm{mix}}$ 为固定的人-机采样分布。本文取 $K{=}30$、$\lambda_{\mathrm{text}}{=}0.8$,略微下调自回归 VLM 目标以对齐两者的收敛速度。推理时动作专家从 $\tau{=}1$ 的高斯噪声出发,积分学习到的速度场到 $\tau{=}0$,仅以当前观测、指令与状态为条件。
3.3 语言动作:自我中心规范化与确定性文法
原始轨迹无法共享表示,除非坐标约定对齐。对每个样本,在预测窗口起点定义自我中心动作坐标系 $F_{t}=(R_{t}^{F},p_{t}^{F})$:带腕相机的单臂机器人用末端执行器坐标系,双臂机器人与无腕相机的单臂机器人用基坐标系,第一视角人类数据用头戴相机坐标系。这些以相机为中心的坐标系遵循大致相似的观察约定,因此运动方向在 embodiment 之间比在各自世界坐标系中更一致。
对末端或手部位姿 $(R_{\tau},p_{\tau})$,在该坐标系下表示为:
$$\bar{p}_{\tau}=(R_{t}^{F})^{\top}(p_{\tau}-p_{t}^{F}),\qquad\bar{R}_{\tau}=(R_{t}^{F})^{\top}R_{\tau}\tag{3}$$
在一秒窗口上计算净平移 $\Delta p=\bar{p}_{t+1\mathrm{s}}-\bar{p}_{t}$ 与相对旋转 $\Delta R=\bar{R}_{t}^{\top}\bar{R}_{t+1\mathrm{s}}$;双臂样本对左右轨迹独立执行同一流程并保留手臂身份;旋转转为外旋 XYZ 欧拉角后序列化。随后用 LAP 的结构化文法把 $(\Delta p,\Delta R,\Delta c)$ 序列化:
$$m_{t}^{\mathrm{lang}}=\text{``}\langle\text{verb}\rangle\;\langle\text{direction}\rangle\;\langle\text{magnitude}\rangle\;\langle\text{unit}\rangle\text{''}\tag{4}$$
其中 move 表示平移、tilt 表示滚转或俯仰、rotate 表示偏航;平移幅度四舍五入到整数厘米,旋转幅度取 5 度的整数倍;四舍五入为零的分量被省略;末尾追加 open / close / maintain 夹爪短语,双臂运动使用显式的左臂与右臂子句。例如:"Left arm: move forward 5 cm, move left 2 cm, tilt left 10 degrees, rotate clockwise 10 degrees, close gripper. Right arm: move down 10 cm, tilt forward 15 degrees, open gripper."
由于 $G_{e}$ 是确定性的、文法是机器可解析的,语言动作是一个可验证的目标:任何采样补全都能被解析并与示教运动比对打分,无需学习型奖励模型。本文据此用 GRPO 对 EgoLAP 做后训练,只更新语言主干,视觉编码器与动作专家保持冻结。
3.4 运动级推理:物理落地的"为什么"
语言动作说明"发生了什么运动",却不说明"为什么在当前物理状态下这个运动是合适的"。因此作者对人类与机器人轨迹的子集标注运动理由 $r_{t}$:给定任务指令、有序轨迹帧、近期动作历史与当前帧的真值语言动作,产出一条理由,指出具体的末端-物体关系、相关接触或 affordance 证据、以及被标注运动的直接物理效果。例如揉面团的理由可以是:"面团位于金属碗底部,双掌直接接触面团顶部与侧面;揉面需要把面团压向碗面变形;双手主导向后平移同时腕部上抬、手指张开,在下次按压前把 compliant 的面团拉向身体。"
运动级推理刻意保持局部与物理聚焦。它不同于以往研究的高层任务或子任务推理:它处在更低的层级,直接连接低层动作,描述 embodiment 之间共享的底层运动意图。训练时还施加推理 dropout 与推理损失 dropout(见下),避免 VLM 过拟合到推理。
3.5 流匹配目标与随机监督
对连续动作块 $a_{t:t+K}$、高斯噪声 $\epsilon\sim\mathcal{N}(0,I)$、插值时间 $\tau=0.001+0.999z$($z\sim\operatorname{Beta}(1.5,1)$),定义插值状态与目标速度:
$$a_{t:t+K}^{\tau}=(1-\tau)a_{t:t+K}+\tau\epsilon,\qquad u_{t}=\epsilon-a_{t:t+K}\tag{5}$$
动作专家 $v_{\phi}$ 被训练去恢复该速度:
$$\mathcal{L}_{\mathrm{FM}}=\mathbb{E}_{\tau,\epsilon}\left[\frac{1}{KD}\left\|v_{\phi}\!\left(a_{t:t+K}^{\tau},\tau,\operatorname{sg}[h_{\theta}(x_{t})]\right)-u_{t}\right\|_{F}^{2}\right]\tag{6}$$
其中 $x_{t}=(o_{t},\ell,s_{t})$ 为多模态前缀,$h_{\theta}$ 为主干前缀表征,$\operatorname{sg}$ 为停止梯度,实现知识隔离边界。推理时用固定步长 ODE 求解器从 $\tau{=}1$ 积分到 $\tau{=}0$。
为避免 VLM 过拟合到推理,作者随机改变推理是否出现在目标中、以及是否接受损失。对理由 token $r_{t}$ 与离散动作 token $m_{t}$,抽取两个独立变量:
$$B\sim\operatorname{Bernoulli}(p_{\mathrm{ctx}}),\qquad C\sim\operatorname{Bernoulli}(p_{\mathrm{sup}})\tag{7}$$
若 $B{=}1$,理由作为 teacher-forced 因果前缀插入 $m_{t}$ 之前;否则 VLM 直接预测 $m_{t}$。在理由存在的前提下,$C$ 决定其 token 是否接受语言建模损失。掩码后的单样本目标为 $\ell_{\mathrm{text}}(B,C)$,文本项即 $\mathcal{L}_{\mathrm{text}}=\mathbb{E}_{B,C}[\ell_{\mathrm{text}}(B,C)]$。本文取 $p_{\mathrm{ctx}}=p_{\mathrm{sup}}=0.5$;无理由的样本置 $B=C=0$。于是在有标注的样本中,一半训练直接的语言动作预测,四分之一仅把推理当因果上下文,四分之一既以推理为条件又监督理由。离散动作 token 在所有情况下都接受监督。
3.6 方法流程总览
flowchart TD
  subgraph SRC["数据源 约10k小时"]
    H1["MECKA 第一视角人手"]
    H2["Scale / Aria 第一视角"]
    R1["ABC YAM 双臂 30%"]
    R2["AgiBot / Galaxea / MolmoAct2 25%"]
    R3["OXE 单臂 含 DROID 20%"]
  end
  H1 --> CANON
  H2 --> CANON
  R1 --> CANON
  R2 --> CANON
  R3 --> CANON
  CANON["自我中心规范化 G_e 统一动作坐标系"]
  CANON --> LA["语言动作 m_t 结构化自然语言"]
  GEM["Gemini 离线标注 仅 MECKA + DROID 占32%"] --> MR["运动级推理 r_t 接触 几何 affordance 意图效果"]
  OBS["图像 + 指令 + 状态 前缀"] --> VLM
  OBS --> EXP
  LA --> VLM
  MR --> VLM
  VLM["VLM 主干 PaliGemma-2B 文本损失 L_text"]
  VLM -- "stop-grad 边界" --> EXP
  EXP["动作专家 300M 流匹配 L_FM 预测30步动作块"]
  EXP --> ACT["推理期仅 rollout 动作专家 10步欧拉积分 无文本生成"]
图 2:EgoLAP 训练与推理流程。人类与机器人轨迹经自我中心规范化得到共享语言动作;Gemini 离线标注的运动级推理仅覆盖 MECKA 与 DROID;文本目标只监督 VLM 主干,连续动作专家经流匹配学习并在推理期独立 rollout。
3.7 与开源代码的对应
本文未发布 EgoLAP 代码,但前作 LAP 的开源仓库(github.com/lihzha/lap,第一作者同为 Lihan Zha)实现了本文复用的语言动作管线,可逐行对应。其 src/lap/policies/transforms/action_text.py 中的 summarize_numeric_actions() 正是式 (4) 的确定性序列化:平移以 round(abs(dx_m * 100.0), decimals) 转成厘米、旋转以 _round_to_nearest_n(..., rotation_precision) 取 5 度整数倍、分量按"前后—上下—左右—滚转—俯仰—偏航—夹爪"的固定顺序拼接、四舍五入为零者省略,与本文表 3 的词汇表完全一致。
同文件中的 summarize_bimanual_numeric_actions() 返回 f"Left arm: {left_summary}. Right arm: {right_summary}",即本文附录 A.2 的双臂模板;人类手部轨迹复用同一条双臂模板而非单独词汇,使人类与机器人运动监督同一批 VLM token。反向映射则由 src/lap/policies/lang_action_formats.py 的 parse_language_to_deltas() 提供:用正则把 "move / tilt / rotate / open gripper" 解析回平移、旋转与夹爪增量——这正是式 (9) 的 GRPO 奖励能够"无需学习型奖励模型即可验证"的工程基础。
实验结果
4.1 实验设计
真机评测在一台定制双臂 YAM 机器人上进行,其手臂间距与相机配置与所有训练 embodiment 都不同;测试五个行为,覆盖刚性、铰接与可形变操作:Pick Place (Simple)、Fold Pants、Handover & Place、Wipe Object、Pick Place (Complex),每任务 10 次试验(Complex 为 12 次),报告平均任务进度。仿真评测基于 ABC 构建双臂基准,含 14 个任务(3 拾取、8 放置、2 颜色选择、1 叠布),每模型每任务 100 回合、共 1400 回合;由于没有模型在仿真数据上训练,这是零样本仿真评测。基线为三个仅动作表示不同的策略族:EgoLAP(语言动作 + 运动级推理)、EgoFAST(FAST token + 推理)、EgoOAT(OAT token + 推理),另与不含推理且不含人类数据的 LAP、以及在 ABC 真机数据上训练的 ABC-VLA 对比。
4.2 语言动作最有效地迁移人类经验
固定表示、只改变是否加入人类数据:加入第一视角人类数据把仿真成功率从 7.2% 提到 16.4%,即 2.3 倍。仿真套件是迁移更难的检验(两个策略都从未见过模拟器),而人类数据恰恰在此回报最大。只改变动作表示、不加推理时,EgoLAP 在仿真达 16.4%、真机达 44.5%,而 EgoFAST 为 1.6% / 35.2%、EgoOAT 为 2.7% / 18.0%。差距在域差最大的未见模拟器上最悬殊:语言动作比 FAST 与 OAT 高一个数量级。完整的 EgoLAP 还比直接在同源仿真数据上训练的 ABC-VLA 高 16.9 个点(仿真)与 54.5 个点(真机),说明它克服了域内数据优势。
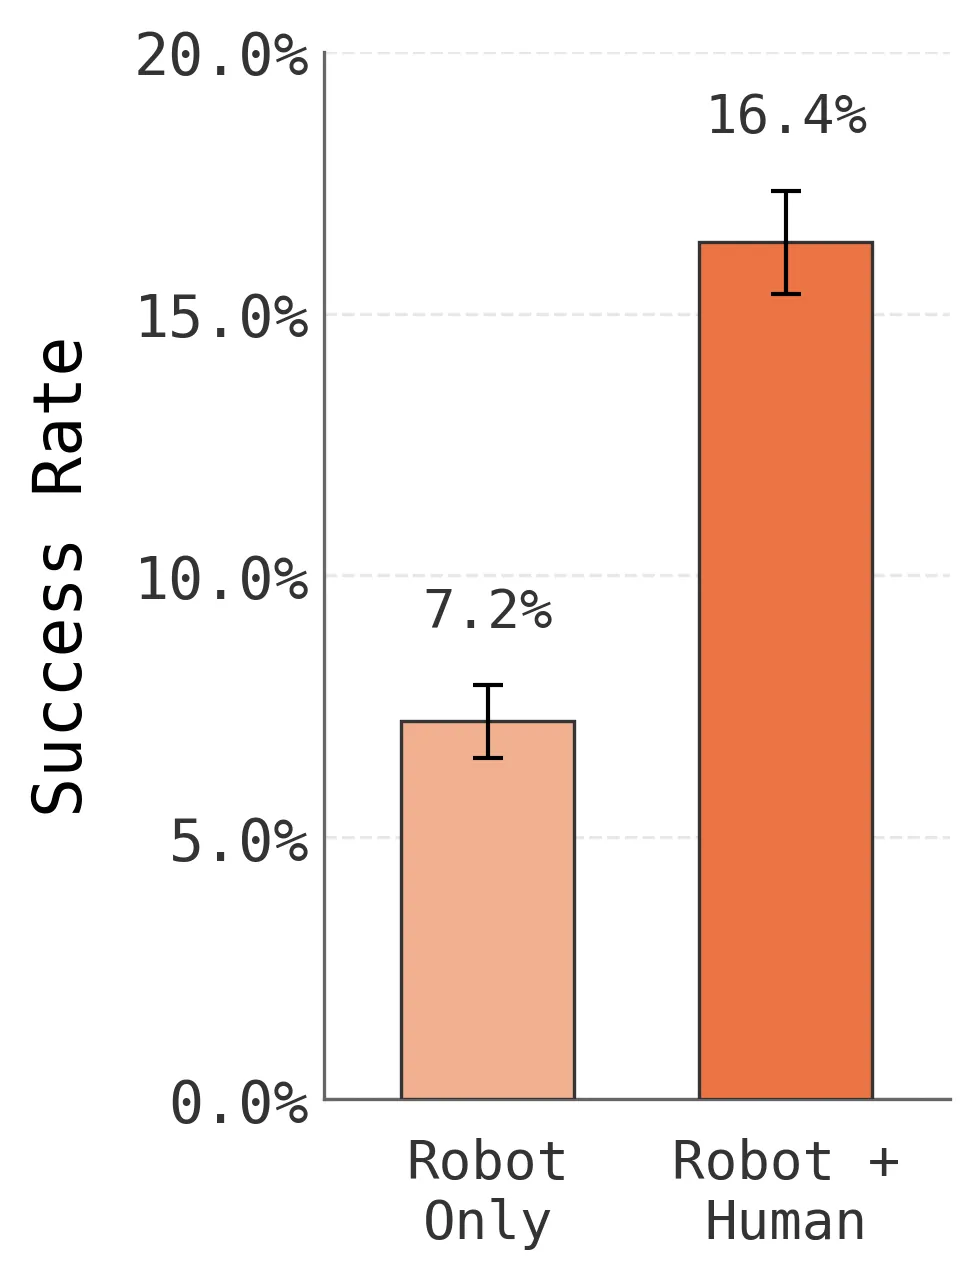
图 3:人类数据对 EgoLAP 的帮助。在语言动作策略不变的前提下,加入第一视角人类数据使仿真成功率翻倍以上。
4.3 运动级推理与语言动作相互增强
把每个 EgoX(无推理)策略与其加推理的版本对比:运动级推理把 EgoLAP 的真机平均进度从 44.5% 提到 80.1%(+35.6 个点,五个任务全部成立),仿真从 16.4% 提到 38.3%(+21.9 个点,各任务族全部成立)。同样的监督对 EgoFAST 在仿真只加 7.1 个点、在真机反而从 35.2% 掉到 26.1%;对 EgoOAT 则只加 0.7(仿真)与 7.6(真机)个点。这一不对称强烈暗示语言动作与运动级推理之间存在协同:两者构成同一条文本"动作思维链",从"为什么合适"的物理推理走向"具体执行什么";而非语言 token 缺乏这种语义对应,主干只能靠共现去推断相关性,无法调用 VLM 已有的知识。
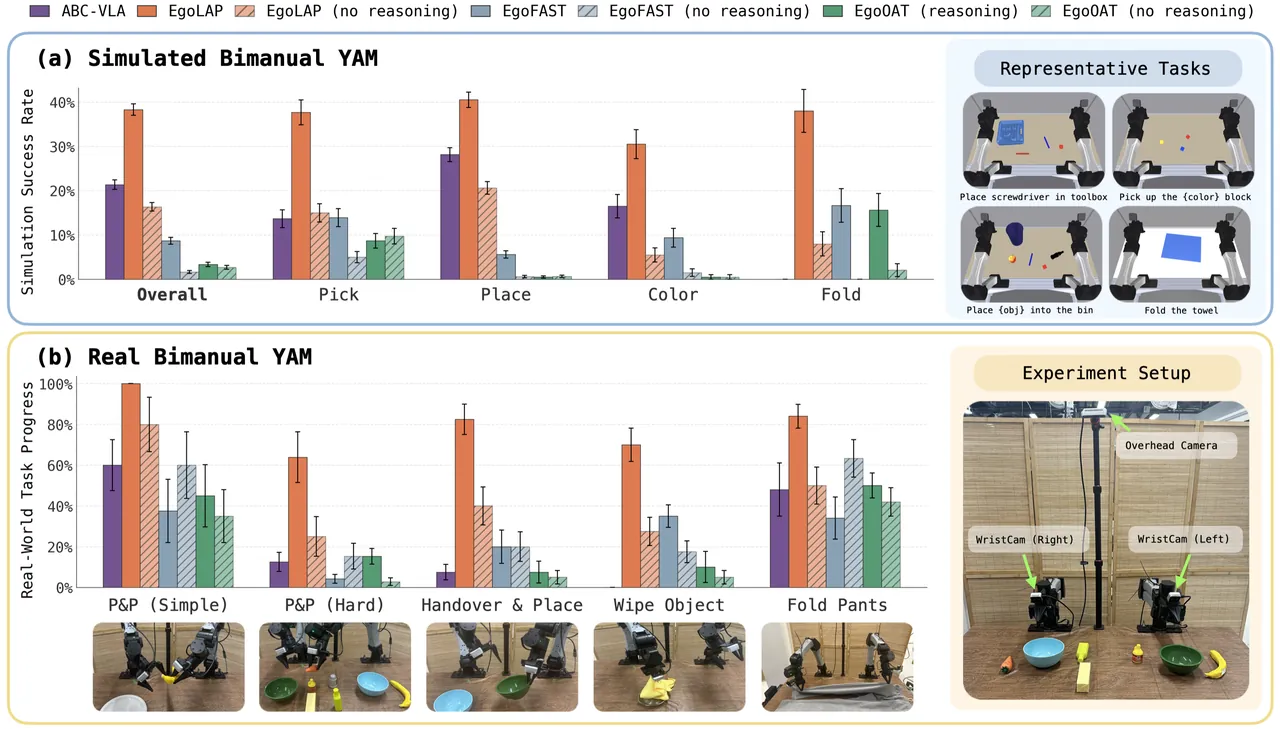
图 4:双臂 YAM 零样本评测。EgoLAP 真机平均进度 80.1%(比其它动作表示高 2.3 倍)、仿真成功率 38.3%(比 ABC-VLA 高 1.8 倍);与语言动作配对时运动级推理带来 35.6 个点的提升,远超其它动作表示。
4.4 人类数据强化推理;运动级推理胜过既有推理格式
为检验增益是否仅来自机器人侧的理由监督,作者在 14 任务仿真上比较有/无人类数据的语言动作策略:推理把仅机器人数据的成功率从 7.2% 提到 18.4%(+11.2),而有人类数据时从 16.4% 提到 38.3%(+21.9)。加入人类数据在无推理时贡献 9.2 个点、有推理时贡献 19.9 个点——机器人侧理由监督本身无法解释全部增益。
进一步与 ECoT 风格的复合目标对比(先预测当前子任务、可见物体框、视觉轨迹,再给语言动作):运动级推理对它尝试的每个目标都有帮助(对 FAST +7.1、对 ECoT 复合 +9.1、对纯语言动作 +21.9),但复合目标本身无益——单独只有 5.3%,远低于无推理语言动作的 16.4%;把它叠在运动级推理之前更把策略压到 14.4%,不足运动级推理单独 38.3% 的一半。由于所有变体都在相同轨迹、相同动作条件理由下训练,ECoT 对照也保留同一语言动作目标,因此 EgoLAP 的更大增益不能归因于特权动作信息或单纯的额外辅助监督。
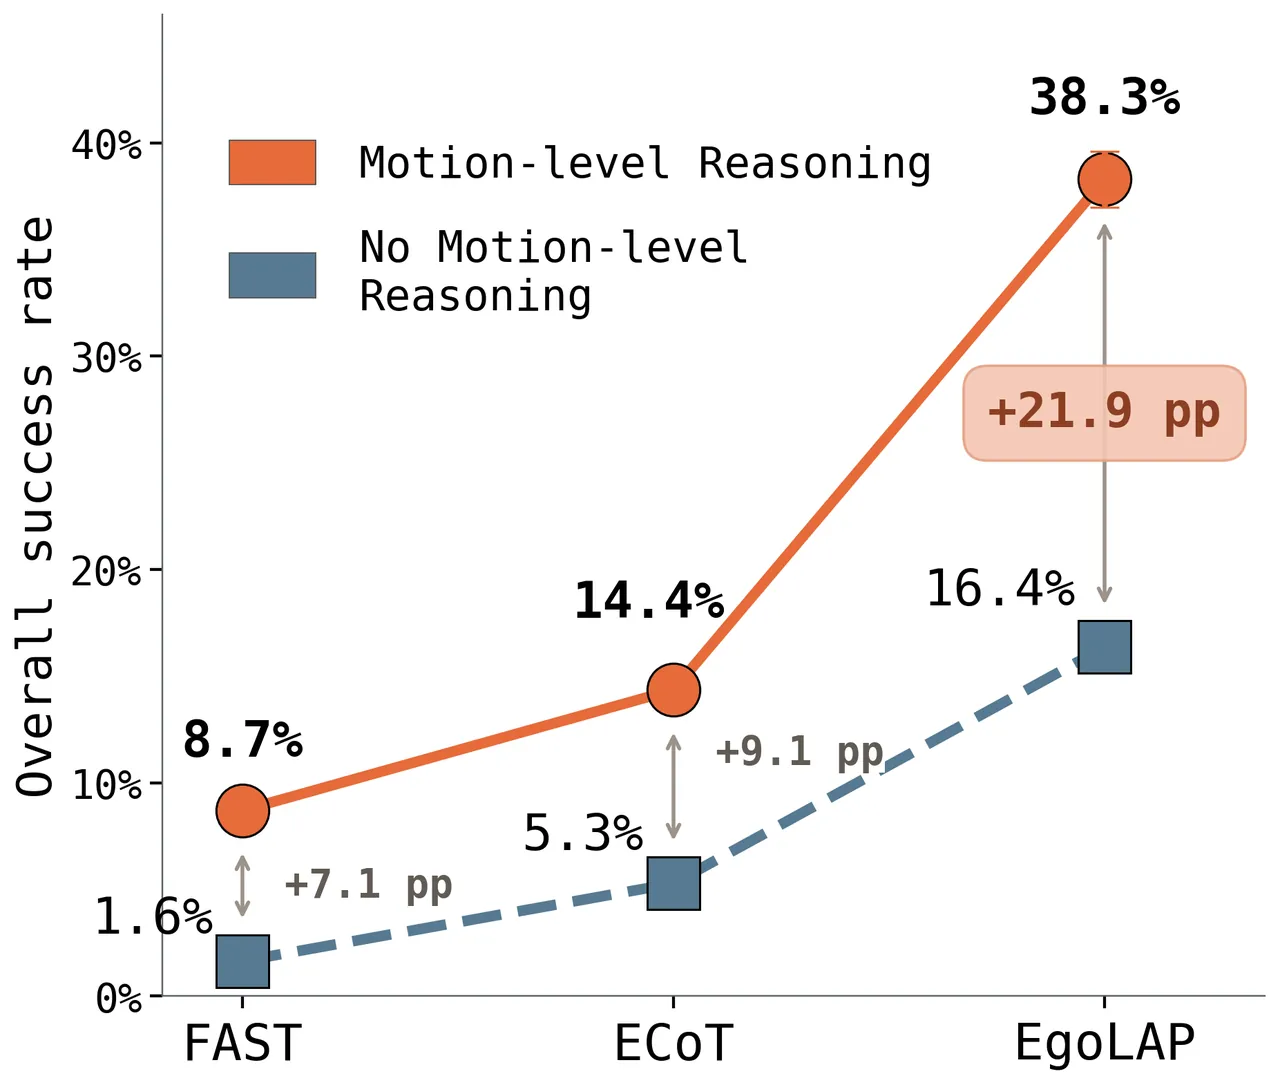
图 5:运动级推理承载增益。它胜过 ECoT 风格推理,并以很大 margin 增强后者。
4.5 下游适配与跨 embodiment 技能对齐
用 GRPO 在语言动作上后训练(视觉与动作专家冻结),即便专家冻结,RL 在三个分支上都提升仿真成功率;其中"推理预训练但采样时只生成语言动作"比"采样时也生成推理"更好(+19.4% 对 +12.7%),因为 ABC 的理由在训练中从未出现,采样出的理由分布外,反而拖累后续语言动作。
跨 embodiment 技能检索上,对仅推理监督不同的配对 checkpoint,mean-pool 最后一层特征、减去各 embodiment 均值后做余弦检索:机器人→人类的 R@1 从 51% 升到 76%(+25),人类→机器人从 42% 升到 63%(+21)。由于两种 embodiment 仍线性可分,推理保留了域身份,但赋予两域相同的内部组织——折叠靠近折叠、放置靠近放置。
4.6 关键数字汇总
| 动作表示 / 配置 | 仿真 14 任务成功率(无推理) | 仿真(有运动级推理) | 增益 |
|---|---|---|---|
| 语言动作(EgoLAP) | 16.4% | 38.3% | +21.9 |
| FAST(EgoFAST) | 1.6% | 8.7% | +7.1 |
| OAT(EgoOAT) | 2.7% | 3.3% | +0.7 |
| ECoT 复合(子任务+框+轨迹) | 5.3% | 14.4%(叠加于运动级推理前) | +9.1 |
| 语言动作 · 仅机器人数据 | 7.2% | 18.4% | +11.2 |
| 方法 | 真机平均任务进度(无推理) | 真机(有推理) |
|---|---|---|
| EgoLAP(语言动作) | 44.5% | 80.1% |
| EgoFAST | 35.2% | 26.1% |
| EgoOAT | 18.0% | 25.6% |
| 跨 embodiment 检索 | 无推理 | EgoLAP | Δ |
|---|---|---|---|
| R→H · 3 技能 R@1 | 51 | 76 | +25 |
| H→R · 3 技能 R@1 | 42 | 63 | +21 |
| R→H · 2 技能 R@1 | 69 | 92 | +23 |
| R→H · 3 技能 MRR | 61 | 80 | +19 |
| 训练混合(每 batch 占比) | 是否带运动级推理标注 |
|---|---|
| ABC 机器人数据 30% | 否 |
| EgoVerse 人类(MECKA / Scale / Aria)25% | 仅 MECKA(20%) |
| 其它双臂机器人(AgiBot / Galaxea R1 Lite / MolmoAct2)25% | 否 |
| 单臂 OXE(DROID 占 12%)20% | 仅 DROID(12%) |
局限性
作者自述:语言动作目前以固定一秒窗口、量化后的平移与旋转做概括,可能丢失快速、接触密集操作所需的动态与精度;评测仍集中于双臂桌面任务;强化学习研究局限于仿真,且优化的是运动匹配代理而非任务奖励。
我们的判断:其一,运动级推理标签由 Gemini 离线生成(DROID 用 gemini-3.5-flash、MECKA 用 gemini-3.7-flash),标签质量受生成模型上限约束,且只覆盖 32% 的 batch,推理监督的边际收益与标注覆盖率耦合;其二,真机评测只有 5 个任务、每任务 10–12 次试验,SEM 误差棒较宽,80.1% 与基线的差距虽大但绝对样本量有限;其三,"零样本仿真"的 ABC 基准与训练混合中占 30% 的 ABC 真机数据同源,虽未用仿真轨迹训练,但平台与物体分布的重叠可能部分放大迁移数字。
总结与展望
EgoLAP 用一个简洁而有力的主张把人类视频变成机器人控制的监督:低层动作是 embodiment 特定的,但运动意图可以跨 embodiment 迁移;把"做什么"写成语言动作、把"为什么"写成运动级推理,就得到一条两种数据源共享的语言思维链。实验表明这条思维链不仅提升策略性能(真机 80.1%、仿真 38.3%),还重塑了表征几何——跨 embodiment 技能检索最多提升 25 个点,且推理的增益与语言动作强协同、与非语言 token 几乎不协同。由于文本目标只在训练期存在、推理期只 rollout 连续动作专家,这套方法不牺牲实时控制。展望未来,作者提出语言动作可支持自适应精度(粗粒度长程描述 + 细粒度高频修正),并容忍来自姿态跟踪、UMI 或互联网视频的近似标签;RL 侧则应联合后训练运动级推理与动作专家、以任务级反馈为目标。
金句
"人手与机器人不必共享低层动作;它们需要共享的是运动意图——应当产生什么运动,以及在当前物理状态下为什么这个运动是合适的。"
"语言动作与运动级推理构成同一条文本动作思维链:从'为什么这个运动合适'的物理推理,走向'具体执行什么运动'。"