EgoLAP:通过语言-动作推理从第一视角人类数据中学习
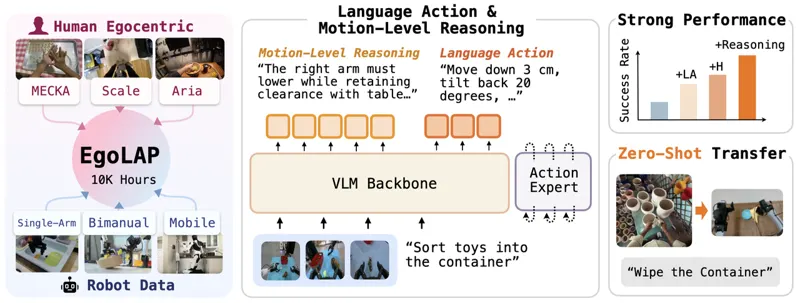
第一视角人类视频规模大、行为多样,但人手与机械臂之间的具身差异使原始人类轨迹难以直接作为机器人控制的监督信号。EgoLAP 的核心主张是:低层动作是具身特定的,但其背后的运动意图可以跨人类与机器人迁移。框架把运动意图写成两种共享的文本目标——用结构化、时间抽象的自然语言动作(language action)概括一秒内位姿与夹爪的变化,用运动级推理(motion-level reasoning)给出接触、几何与物体 affordance 层面的物理依据,二者串成一条人-机共享的语言动作思维链。模型以 PaliGemma-2B 为 VLM 主干,配一个 3 亿参数、从零初始化的动作专家,经流匹配预测连续动作块;文本目标只监督主干(知识隔离),推理期仅 rollout 动作专家、不生成任何文本,因而不牺牲实时控制。在约 1 万小时人-机混合数据(ABC、EgoVerse、OXE 等)上预训练后,EgoLAP 在定制双臂真机上取得 80.1% 的平均任务进度,比 FAST、OAT 等动作表示高 2.3 倍;在零样本双臂仿真上达 38.3%,比直接用同域真机数据训练的 ABC-VLA 高 1.8 倍。运动级推理与语言动作强协同(真机 +35.6 点),而对非语言 token 几乎无益;跨 embodiment 技能检索最多提升 25 点,表明共享文本目标重塑了表征几何。
Lihan Zha, Shresth Grover, Tenny Yin2026年10月6日
视觉语言动作模型操作Egocentric Vision2026年10月6日