PAPER DEEP DIVE
StageVLN:面向高效视觉语言导航的空间轨迹引导
StageVLN在训练阶段以冻结几何模型提供多层空间引导,并用相对朝向与专家路线进度约束导航状态;部署时辅助分支全部移除。它在R2R-CE未见验证集取得56.3%成功率与51.4% SPL,在RxR-CE取得54.3%成功率。
论文信息:Anh Dao、Quan-Dung Pham、Le Danh Vinh 等作者,arXiv:2610.05664v1,2026 年 10 月 5 日提交,主要归类为计算机视觉与机器人学。论文链接:https://arxiv.org/abs/2610.05664。
代码状态:论文正文没有给出代码仓库;截至 2026 年 10 月 26 日,按精确标题和方法名检索 GitHub,也未发现作者公开的 StageVLN 实现。因此本文只能依据论文正文、公式、表格与图像分析其设计,不声称存在可验证的开源代码。
一句话总结
StageVLN 不让机器人在推理时额外携带深度估计器、地图模型或几何编码器,而是在训练阶段用冻结的 VGGT-Ω 教师、相对朝向目标和专家路线进度目标塑造一个 4B 参数视觉语言导航策略,使模型部署时仍只接收 RGB 与语言。
一、研究问题:语义理解不等于导航状态
连续环境中的视觉语言导航要求智能体一边理解“穿过门、绕过沙发、在蓝色目标附近停止”等指令,一边把每一帧 RGB 观测与可通行空间、身体朝向和整段路线联系起来。只预测下一步动作可以训练出一个可运行的系统,但它没有直接规定中间隐藏状态必须保留哪些空间关系。
大型视觉语言模型提供了很强的物体识别、场景语义和指令跟随先验,但这些先验主要服务于图像问答或文本生成。一个模型能认出厨房、床和门,并不等于它能在连续转向后稳定知道自己相对起点转了多少度,也不能保证它知道整条专家路线已经完成了多少比例。
作者把现有解决路径分成两类。第一类是显式三维输入,例如深度、地图、点云或预先重建的环境结构;第二类是运行时几何融合,把几何基础模型提取的特征直接接入导航策略。两类方法都可能改善空间理解,却会增加传感器要求、显存开销、推理延迟和系统耦合。
StageVLN 的核心提问因此不是“如何再增加一个更强的三维模块”,而是“几何和轨迹知识能否只在训练时作为教师,最后沉淀到原始 RGB 导航通路中”。这属于特权信息监督与中间表示蒸馏在具身导航上的组合,而不是新的外部感知接口。
这个问题对真实机器人很重要。论文的真机系统使用 Unitree G1、ZED X Mini 相机和 Jetson AGX Orin,但策略推理仍放在远端 RTX 5090 工作站。若部署端还要同时运行大型几何模型,通信、显存和能耗压力都会上升。训练期辅助监督至少在系统层面避免了这类额外常驻成本。
二、预备知识:教师特征、相对朝向与路线进度
导航策略记为 $\pi_\theta$,输入为语言 $l$ 和截至时刻 $t$ 的 RGB 观测历史 $O_t=(o_0,\ldots,o_t)$,输出集合包含前进、左转、右转和停止四类动作。基础行为克隆直接最大化专家动作的对数似然:
$$\mathcal{L}_{\mathrm{nav}}=-\mathbb{E}_{\mathcal{D}}\left[\log\pi_{\theta}\left(a_{t}^{\star}\mid l,O_{t}\right)\right].$$
这个目标只约束最终动作标签。对大型自回归模型而言,动作 token 之前的隐藏状态仍可能以多种方式编码场景;训练数据也没有显式告诉模型哪些内部特征应对应局部几何,哪些应对应跨帧旋转或路线进度。
StageVLN 保持这一动作监督,同时加入三类辅助信号。空间蒸馏负责“当前画面里的几何结构”,相对朝向负责“历史帧到当前帧的旋转关系”,路线进度负责“整段专家轨迹中已经走了多远”。三者分别覆盖局部、帧间和全局三个尺度。
三、方法总览:三个尺度、一次联合训练
论文图 1 给出了最关键的部署差异。显式三维输入方案在推理时继续依赖额外传感器或地图;运行时几何融合方案在推理时保留几何模型;StageVLN 则把空间和轨迹引导框在“仅训练”区域,部署端只留下导航策略本身。
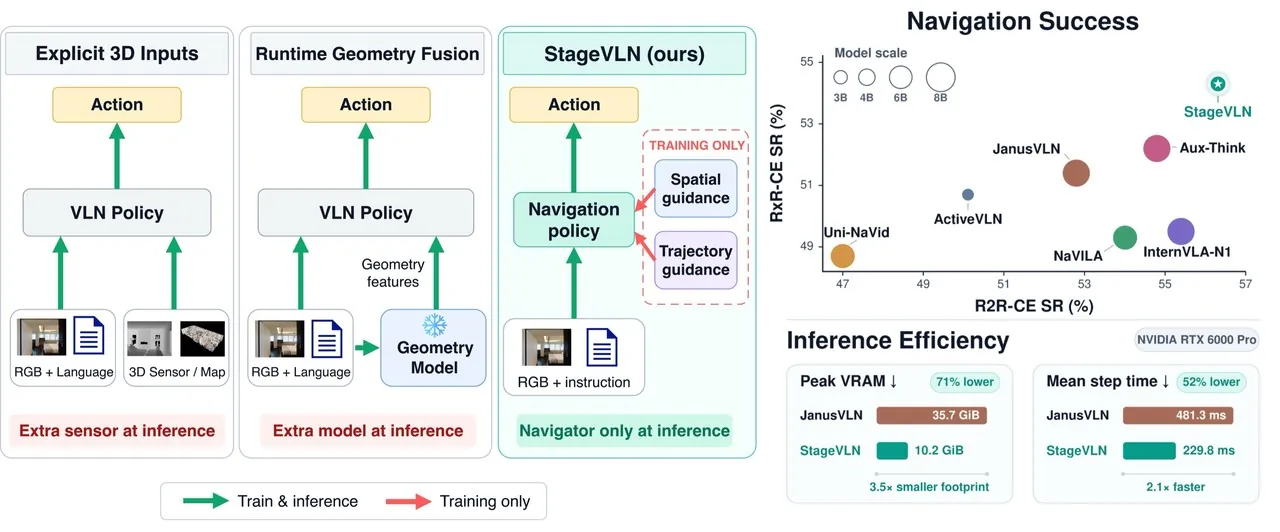
图1:左侧比较三种推理架构,右侧给出成功率与推理效率。StageVLN 的额外几何和轨迹分支只在训练阶段出现。
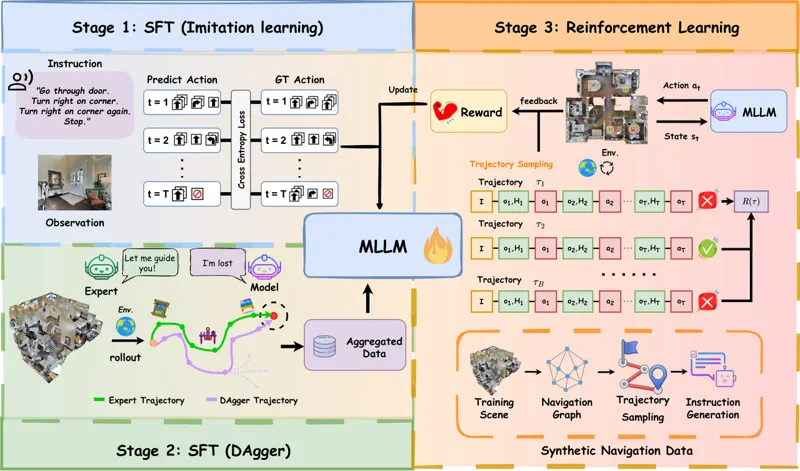
图 2 进一步展开训练流程。当前 RGB 图像交给冻结几何教师,导航策略接收最多八帧历史观测、当前帧和语言指令。教师只处理当前帧,而导航策略要在时间序列中处理历史视觉 token。多个策略层通过独立投影器对齐到教师不同层的特征。
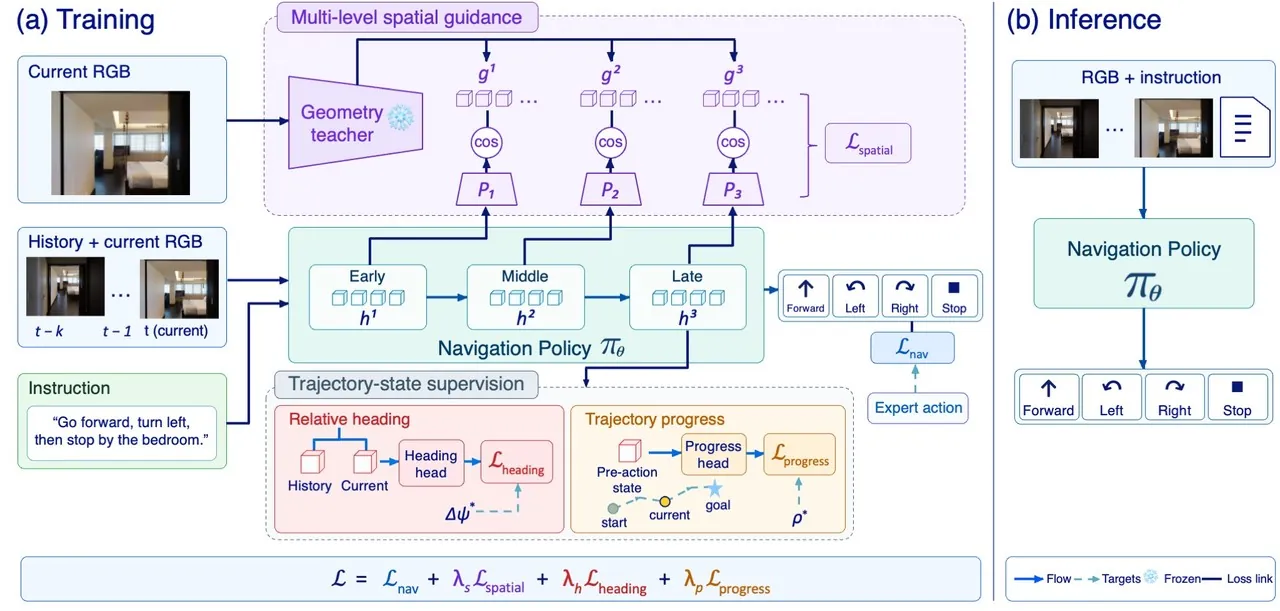
图2:训练期同时计算空间蒸馏、相对朝向、路线进度和动作损失;推理期删除教师、投影器与辅助头。
flowchart TB
    subgraph TRAIN["训练期"]
        RGB["当前 RGB"] --> TEACHER["冻结几何教师 VGGT-Ω"]
        TEACHER --> FEAT["多层几何特征"]
        HIST["历史帧与当前帧"] --> POLICY["Qwen3.5-4B 导航策略"]
        INSTR["语言指令"] --> POLICY
        POLICY --> HIDDEN["第 8 16 24 层视觉 token"]
        FEAT --> DISTILL["多层余弦蒸馏"]
        HIDDEN --> DISTILL
        HIDDEN --> HEAD["相对朝向头"]
        HIDDEN --> PROG["路线进度头"]
        POLICY --> NAVLOSS["动作损失"]
        DISTILL --> TOTAL["联合目标"]
        HEAD --> TOTAL
        PROG --> TOTAL
        NAVLOSS --> TOTAL
    end
    TOTAL --> UPDATE["更新导航策略与训练辅助模块"]
    subgraph DEPLOY["部署期"]
        DRGB["RGB 与指令"] --> DPOLICY["仅导航策略"]
        DPOLICY --> ACTION["前进 左转 右转 停止"]
    end
    UPDATE --> DPOLICY
四、多层级几何表示蒸馏
作者把冻结几何教师记为 $g_\phi$。对当前观测 $o_t$,教师在 $M$ 个选定层输出空间特征:
$$\left\{G_{t}^{(r_m)}\right\}_{m=1}^{M}=g_{\phi}(o_t).$$
这里 $r_m$ 是第 $m$ 个教师层索引。论文没有只取最后一层,而是选择三个层级形成“早期、中期、晚期”的监督。实现中导航器第 8、16、24 层的视觉 token 分别对齐 VGGT-Ω 聚合器中从零开始计数的第 11、17、23 层。
教师的 patch 特征先加入位置编码,再被重排成二维网格并缩放到导航器当前图像的 token 网格。论文用 $R_t$ 表示这一空间重整过程。停梯度后的目标写成:
$$Z_{t}^{(m)}=\operatorname{sg}\left[R_{t}\left(G_{t}^{(r_m)}+E_{t}^{(r_m)}\right)\right].$$
其中 $E_t^{(r_m)}$ 是位置编码,$\operatorname{sg}$ 表示停止梯度。教师不更新,且非 patch token 被排除。这样目标只表达当前图像的几何 patch,不会把教师中与语言或动作无关的 token 强行压到学生特征上。
学生侧只抽取导航器当前图像的视觉 token,记第 $\ell_m$ 层的第 $n$ 个 token 为 $V_{t,n}^{(\ell_m)}$。独立投影器 $P_m$ 把学生特征映射到教师维度,然后最小化平均余弦距离:
$$\mathcal{L}_{\mathrm{spatial},t}^{(m)}=\frac{1}{N_{t}}\sum_{n=1}^{N_{t}}\left[1-\cos\left(P_{m}\left(V_{t,n}^{(\ell_m)}\right),Z_{t,n}^{(m)}\right)\right].$$
$N_t$ 是对齐的当前图像 token 数。余弦距离关注意义方向和结构关系,不要求两个模型的绝对数值尺度一致;对跨架构蒸馏而言,这比直接回归特征值更容易形成稳定约束。所有层级等权平均后得到:
$$\mathcal{L}_{\mathrm{spatial}}=\mathbb{E}_{\mathcal{D}}\left[\frac{1}{M}\sum_{m=1}^{M}\mathcal{L}_{\mathrm{spatial},t}^{(m)}\right].$$
实现中每个投影器由 LayerNorm、两层 MLP 和 GELU 组成,维度为 $2560\rightarrow4096\rightarrow2048$。梯度更新投影器和策略参数,教师目标保持冻结。论文把空间损失权重设为 0.3,三个层级等权。
这一设计的限制也很明确:蒸馏传递的是教师中间空间表示经过投影后的对齐关系,不等于学生显式获得深度图、相机位姿或可读地图。导航器仍只接收 RGB,因此它学到的是隐式空间先验;如果新场景的分布远离教师训练分布,这种隐式先验可能失效。
五、相对朝向:约束跨帧旋转关系
当前帧几何蒸馏无法告诉模型“与三帧前相比,身体已经左转了 30 度”。为此,作者从选定的历史帧和当前帧视觉 token 构造成对监督。对时刻 $\tau$ 的观测,先对第 $\ell_h$ 层视觉 token 做均值池化,再通过共享帧投影器 $F$:
$$e_{\tau}=F\left(\frac{1}{N_{\tau}}\sum_{n=1}^{N_{\tau}}V_{\tau,n}^{(\ell_h)}\right).$$
历史特征 $e_{\tau_i}$ 与当前特征 $e_t$ 通过共享关系头 $R$ 组合。输入同时包含两者、差值与逐元素乘积,输出二维相对朝向向量:
$$u_{i,t}=R\left([e_{\tau_i};e_t;e_t-e_{\tau_i};e_{\tau_i}\odot e_t]\right)\in\mathbb{R}^{2}.$$
监督目标来自专家动作序列。左右转分别对应正负 15 度名义增量,前进和停止对应零;从历史时刻到当前时刻累加后,再用区间包装消除角度跨越:
$$\Delta\psi_{i,t}=\operatorname{wrap}_{[-\pi,\pi)}\left(\sum_{s=\tau_i}^{t-1}\delta(a_s^{\star})\right).$$
角度最终编码成正弦和余弦,而不是回归单个标量:
$$r_{i,t}=[\sin\Delta\psi_{i,t},\ \cos\Delta\psi_{i,t}]^{\top}.$$
预测与目标都用余弦距离比较:
$$\mathcal{L}_{\mathrm{heading}}=\mathbb{E}_{\mathcal{D}}\left[\frac{1}{|\mathcal{H}_{t}|}\sum_{i\in\mathcal{H}_{t}}\left(1-\cos(u_{i,t},r_{i,t})\right)\right].$$
这里特别强调“相对”而不是“下一步动作朝向”。模型看到历史和当前观测后预测累计旋转差,而当前时刻的真实动作 $a_t^\star$ 被排除在目标累加之外。这样可以避免进度或朝向辅助头通过教师强制直接读取动作 token。
但相对朝向监督依赖动作标签中的 15 度离散转角。连续环境中实际转弯可能由多次控制或仿真器插值完成,名义转角与真实身体旋转未必一一相等。论文没有给出利用连续位姿真值进行监督的结果,因此该目标的精度受动作标注口径限制。
六、专家路线进度:全局轨迹状态
朝向只描述帧间旋转,仍缺少整段路线的位置感。作者把进度定义为在时刻 $t$ 之前已经执行了多少比例的专家前进动作:
$$p_t=\frac{\sum_{s=0}^{t-1}\mathbf{1}[a_s^{\star}=\texttt{MOVE\_FORWARD}]}{\sum_{s=0}^{T-1}\mathbf{1}[a_s^{\star}=\texttt{MOVE\_FORWARD}]}.$$
分母是整条专家轨迹中的前进动作总数,左右转和停止不计入。这个定义把“沿专家路线走了多远”变成一个位于零到一之间的软目标,同时避开了以绝对米数作为标签时对环境尺度和路径长度的依赖。
进度头 $Q$ 不读取第一个受监督动作 token,而是读取它之前的隐藏状态。若 $j_t$ 是第一个动作 token 的位置,则:
$$z_t=Q\left(H_{t,j_t-1}^{(\ell_p)}\right).$$
对样本集合 $\mathcal{B}_P$ 使用带软目标的二元交叉熵,写成数值稳定的 softplus 形式:
$$\mathcal{L}_{\mathrm{progress}}=\frac{1}{|\mathcal{B}_P|}\sum_{t\in\mathcal{B}_P}\left[\operatorname{softplus}(z_t)-p_tz_t\right].$$
使用动作 token 之前的隐藏状态,是为了防止进度头在训练时偷看当前专家动作。若允许读取动作 token,进度分类会变得过于容易,却无法迫使策略在生成动作之前形成路线状态。
这个目标也不等于成功概率。它估计的是专家路线完成度,部署时进度头被删除,模型不会根据进度自动触发停止。论文明确说明进度头不提供停止规则,所以最终停止仍由原导航策略产生。
七、联合目标与实现配置
最终训练目标将动作、空间、朝向和进度四项相加:
$$\mathcal{L}=\mathcal{L}_{\mathrm{nav}}+\lambda_s\mathcal{L}_{\mathrm{spatial}}+\lambda_h\mathcal{L}_{\mathrm{heading}}+\lambda_p\mathcal{L}_{\mathrm{progress}}.$$
作者设置 $\lambda_s=0.3$,$\lambda_h=\lambda_p=0.1$。主导项仍是专家动作负对数似然,辅助项改变中间表示,但不替代动作生成目标。这一权重也解释了为什么“加更多监督”不必然在所有指标上单调改善,辅助梯度之间仍可能竞争。
导航器采用 Qwen3.5-4B,几何教师为冻结的 VGGT-Ω。视觉编码器与教师都保持冻结,语言模型和输出头学习率为 $10^{-6}$,视觉合并器、对齐投影器和轨迹头为 $10^{-5}$。训练只进行一个 epoch,全局批大小 64,使用四张 H100。
训练数据仅包含 R2R-CE 的 10,819 个专家回合与 RxR-CE 的 19,990 个回合。评测使用两个数据集的 validation-unseen 划分,分别为 1,839 和 3,669 条轨迹。表中“外部训练数据为 0K”不否认 Qwen 与 VGGT-Ω 的预训练数据,只是不计入额外导航训练集。
八、主实验结果
R2R-CE 未见验证集上,StageVLN 取得 56.3% 成功率、51.4% SPL 和 64.7% 预言成功率,导航误差为 5.17 米。RxR-CE 上成功率为 54.3%,导航误差为 5.65 米,SPL 为 42.8%。这两个结果来自 4B 导航器,并且推理时没有额外几何编码器。
| 方法 | 参数量 | R2R NE↓ | R2R OS↑ | R2R SR↑ | R2R SPL↑ | RxR NE↓ | RxR SR↑ | RxR SPL↑ |
|---|---|---|---|---|---|---|---|---|
| ActiveVLN | 3B | 5.31 | 58.3 | 50.1 | 43.7 | 5.84 | 50.7 | 41.2 |
| StreamVLN* | 7B | 6.05 | 53.8 | 45.5 | 41.6 | - | - | - |
| NaVILA* | 7B | 5.22 | 62.5 | 54.0 | 49.0 | 6.77 | 49.3 | 44.0 |
| InternVLA-N1 | 8B | 4.89 | 60.6 | 55.4 | 52.1 | 6.41 | 49.5 | 41.8 |
| JanusVLN | 7B + 1B | 5.17 | 58.0 | 52.8 | 49.2 | 6.46 | 51.4 | 44.3 |
| StageVLN | 4B | 5.17 | 64.7 | 56.3 | 51.4 | 5.65 | 54.3 | 42.8 |
表 1 中最值得注意的不是“4B 超过 7B”这一句单独结论,而是不同指标的取舍。StageVLN 的 R2R 成功率和预言成功率都高于 InternVLA-N1,但导航误差 5.17 大于对方的 4.89;RxR 的 SPL 也低于 NaVILA、JanusVLN 和 ActiveVLN。这说明它更容易到达目标,但部分成功轨迹不是最短或最高效路径。
与同样使用几何表示的 JanusVLN 比较,StageVLN 在 R2R-CE 提升 3.5 个百分点成功率与 2.2 个百分点 SPL,在 RxR-CE 提升 2.9 个百分点成功率,但 RxR SPL 低 1.5 个百分点。作者据此认为训练期几何监督可以替代推理期额外几何编码器;更严谨的表述应是:在当前实现与评测配置下,这种替代改善了成功率,但没有全面支配所有效率指标。
StageVLN 的优势还依赖更大的基础模型语义能力。表 1 中的较小 ActiveVLN 也达到 50.1% R2R 成功率,说明参数规模不是唯一解释项;而 4B StageVLN 的高 OS 与 SR 又显示,训练目标和模型先验之间存在互补。论文没有拆分“Qwen3.5-4B 预训练收益”和“辅助监督收益”的完整交叉实验,这限制了对外部有效性的判断。
九、推理效率与真机部署
效率测试在单张 RTX 5090 和 RTX 6000 Pro 上进行。StageVLN 的峰值分配显存为 10.24 GiB,单步平均时间为 304.5 毫秒或 229.8 毫秒。表 2 显示,它的显存明显低于 NaVILA 与 JanusVLN,但推理速度并非所有平台最快。
| 硬件 | 方法 | 峰值分配显存 GiB↓ | 平均单步时间 ms↓ |
|---|---|---|---|
| RTX 5090 | JanusVLN | OOM | - |
| RTX 5090 | NaVILA | 17.47 | 365.2 |
| RTX 5090 | StreamVLN | 17.48 | 233.4 |
| RTX 5090 | StageVLN | 10.24 | 304.5 |
| RTX 6000 Pro | JanusVLN | 35.73 | 481.3 |
| RTX 6000 Pro | NaVILA | 17.47 | 383.1 |
| RTX 6000 Pro | StreamVLN | 17.48 | 209.8 |
| RTX 6000 Pro | StageVLN | 10.24 | 229.8 |
相对 NaVILA,StageVLN 的显存降低 41.4%,RTX 5090 单步时间减少 16.6%,RTX 6000 Pro 减少 40.0%。相对表中最重的 JanusVLN,6000 Pro 上显存和延迟收益更明显。不过 StreamVLN 在同一显存约 17.48 GiB 的配置下分别达到 233.4 和 209.8 毫秒,说明 StageVLN 的“轻量”主要体现在去掉了额外几何编码器,而不是拥有最低的绝对延迟。
真机部分使用 Unitree G1,前置 ZED X Mini 相机,Jetson AGX Orin 只负责图像预处理和通信,策略推理运行在远端 RTX 5090。图 3 展示两条办公环境路线,包括走廊行进、穿门、绕植物、转向房间和在蓝色沙发或电视前停止。作者报告两条路线都成功,且没有额外真机导航数据微调。
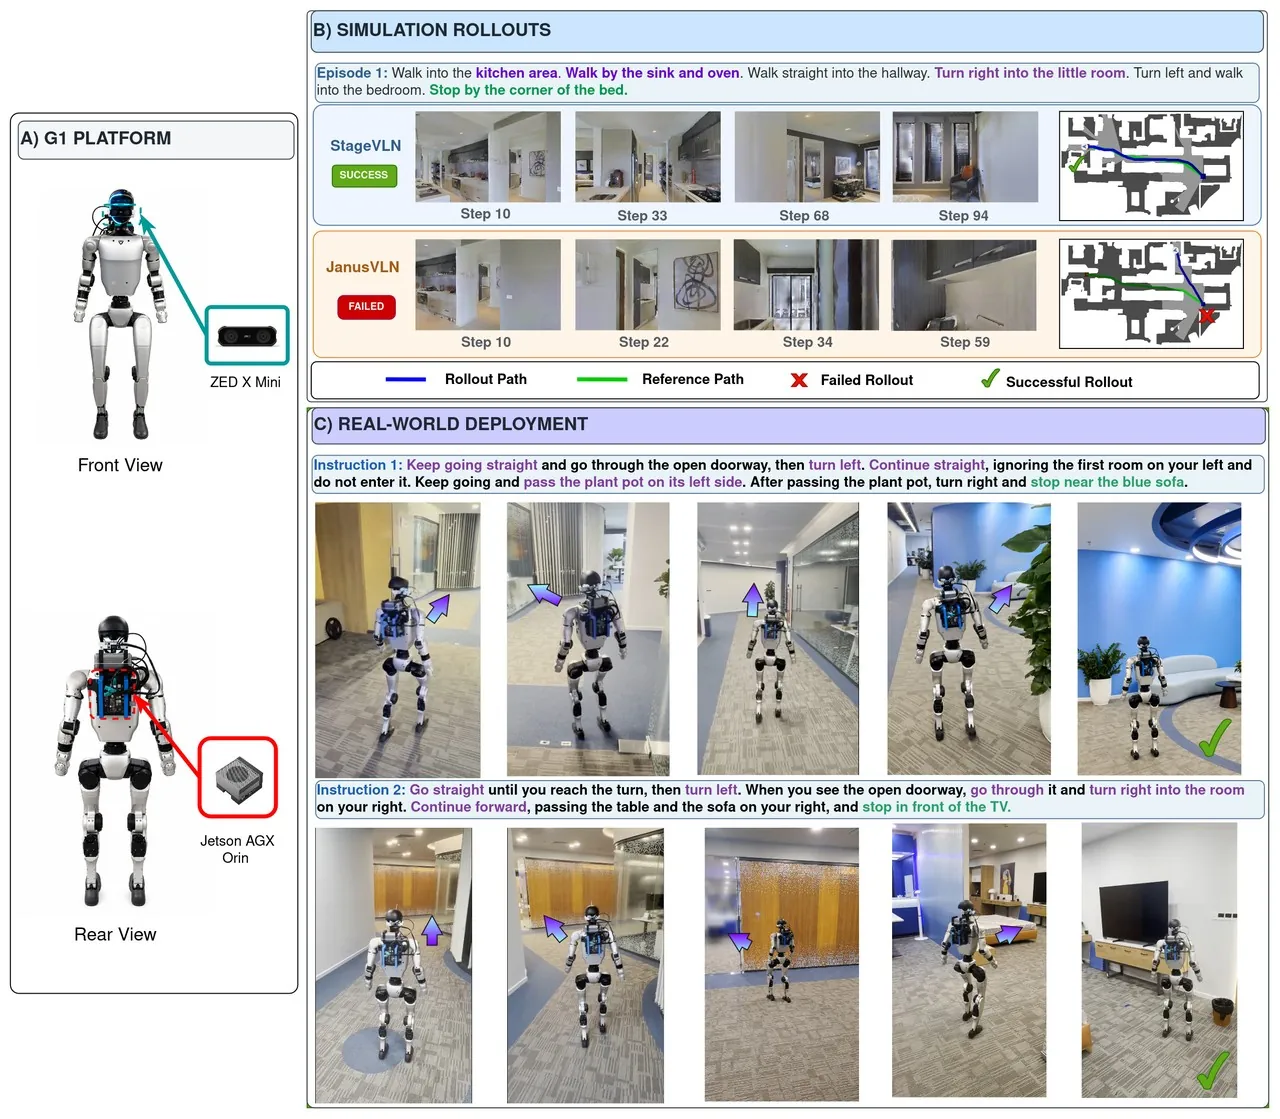
图3:左侧为 G1、ZED X Mini 与 Jetson 配置;右上比较仿真中与 JanusVLN 的轨迹;右下展示两条真机路线。
这部分证明了从仿真训练策略直接迁移到人形机器人平台的可行性,但不能证明大规模真机鲁棒性。只有两条定性路线,没有成功率、碰撞率、定位漂移、光照变化或动态障碍物的统计结果。论文也没有给出远端网络延迟,而 Jetson 仅做预处理意味着系统仍依赖外部计算资源。
十、消融实验揭示了什么
组件消融统一使用 VGGT 教师,而主表使用更强的 VGGT-Ω。监督微调基线为 46.49% SR 与 42.32% SPL;只在最后一个层级做几何对齐时为 48.50/41.86;三层多级对齐提升到 52.26/46.72。多级监督显然比单层更有效,单层甚至没有改善 SPL。
| 动作监督 | 几何蒸馏 | 相对朝向 | 路线进度 | NE↓ | OS↑ | SR↑ | SPL↑ |
|---|---|---|---|---|---|---|---|
| 是 | 否 | 否 | 否 | 5.19 | 56.01 | 46.49 | 42.32 |
| 是 | 单层 | 否 | 否 | 6.33 | 61.83 | 48.50 | 41.86 |
| 是 | 多层 | 否 | 否 | 6.12 | 61.01 | 52.26 | 46.72 |
| 是 | 多层 | 是 | 否 | 6.17 | 63.30 | 49.97 | 43.80 |
| 是 | 多层 | 否 | 是 | 5.66 | 63.89 | 53.18 | 48.67 |
| 是 | 否 | 是 | 是 | 5.86 | 64.06 | 54.43 | 48.58 |
| 是 | 多层 | 是 | 是 | 5.58 | 67.37 | 55.36 | 48.44 |
消融最重要的信息是辅助目标并非独立可加。多层几何对齐本身达到 52.26/46.72,加上朝向监督后反而降到 49.97/43.80;多层几何加进度提升到 53.18/48.67;同时加入朝向和进度后 SR/OS 更高,但 SPL 略降。朝向目标似乎主要在与进度目标共同存在时才提供成功率收益。
最终完整的 VGGT 版本相比监督微调提升 8.87 个百分点 SR 和 6.12 个百分点 SPL,但导航误差为 5.58,仍高于监督微调的 5.19。也就是说,模型更容易成功,不代表每个成功回合都更贴近最短路径或专家轨迹。作者也明确承认“辅助目标没有在所有指标上均匀改善”。
教师替换实验显示 VGGT-Ω 将完整模型的 NE 从 5.58 降到 5.17,SR 从 55.36 升到 56.28,SPL 从 48.44 升到 51.37,但 OS 从 67.37 降到 64.71。更强的几何教师改善了实际成功与路径效率,却让“预言成功率”略低。论文没有解释这一现象的机制,只把它归因于教师表示质量影响下游导航。
十一、局限性分析
第一项由论文自己呈现的限制是真机证据规模很小。作者强调没有额外真机数据微调,并展示了两次成功部署,但这些只说明可行性,不能支撑对成功率、环境泛化或长期稳定性的统计结论。Jetson 本地只预处理,实际策略仍在远端 RTX 5090 上运行,因此“4B 模型轻量”不等于可以完全在机器人本体实时运行。
第二项是几何监督的隐式性。StageVLN 删除了推理期几何编码器,这带来效率收益,也意味着模型无法在部署时显式检查深度、尺度或可通行空间。如果教师特征在某个新场景中不可靠,策略没有可观测的几何质量信号;论文没有评估光照变化、反光表面、透明玻璃、动态人群或相机标定漂移。
第三项是监督标签与真值位姿之间的差距。相对朝向由左右转动作累加得到,每步使用固定的正负 15 度,而真实连续运动可能包含更细的旋转。进度只统计专家前进动作比例,不表示物理距离或任务语义完成度。两者对同一条路线的刻画都比连续位姿和真实剩余距离更粗。
第四项是实验公平性仍需更细的证据。主表标注了是否有额外几何编码器和外部导航数据,这是有价值的控制;但不同方法的预训练语料、视觉输入帧数、推理硬件适配和提示工程没有完全统一。论文报告 StageVLN 使用无额外导航训练数据,却没有提供仅换更强普通监督基线或增加训练时长的完整对照。
十二、结论与展望
StageVLN 给出的工程结论很清楚:若目标是让 RGB 语言导航策略获得几何与路线先验,又不希望在每次推理时携带额外几何模型,可以把教师和辅助头视为训练期的临时脚手架。多层特征对齐、帧间相对朝向和路线进度分别约束三个尺度的中间状态,部署时移除这些模块,保留原始动作生成路径。
结果支持这一方向,但边界同样清楚。它在两个连续导航基准上提高了成功率,并显著低于常见几何融合方案的显存占用;RxR SPL 的下降、朝向消融的非单调变化、单次仿真训练以及小规模真机演示说明,这还不是一个已经解决全部泛化与效率问题的导航基础模型。
后续工作最值得补齐的不是再增加一个辅助损失,而是给出更强的因果证据:与相同教师做显式输出蒸馏相比如何,与相同参数量的普通多任务监督相比如何,策略在真机上能否达到可统计的成功率,以及能否在相机、光照和动态障碍变化下保持隐式几何表征。只有这些对照齐全,训练期空间引导才能真正成为可复用的部署范式。
金句:真正适合部署的几何智能,不一定是在机器人身边再放一个几何模型,而是让导航策略在训练后把空间结构内化,并在推理时轻装上路。