PAPER DEEP DIVE
PredActor:预测未来状态的机载人形扩散控制策略
扩散模型能生成多样动作,却很难直接变成人形机器人的闭环控制:生成器—跟踪器分层方案靠参考轨迹操舵,参考可能超出跟踪器能力,物理可行性与抗扰动只能交给另一个控制模块;纯动作扩散直接输出可执行动作,却没有可供测试时引导的未来状态。PredActor 把两条路合成一个直接执行的策略:只用 96 维本体感受历史与可选文本条件,让交错的状态—动作 Transformer 同时去噪 20 步未来状态与动作;未来状态留在策略内部充当可微操舵接口,CFG 放大文本条件动作,CG 把预测状态推向目的地或摇杆速度等测试时目标,下发给 29 个关节的只有动作,既不需要参考跟踪器也不需要特权全身状态。配合滚动去噪与保精度运行时优化(两步 NS-DDIM、堆叠轴全身引导、调度预计算、all-QKV 打包、条件缓存、LibTorch 推理模式),Jetson Orin NX 上完整回调中位 16.790 ms、p95 19.383 ms,593/600 次落在 20 ms 控制周期内。仿真中 45 个目的地到达 44 个,MotionCLIP 文本检索 0.539 对纯动作扩散的 0.424;真机 Unitree G1 六组设置各五次试验,站立到行走、行走到慢跑、站立到下蹲全部成功。
PredActor: Predictive Action Diffusion for Steerable Onboard Humanoid Control
Lei Ye、Haibo Gao、Yitang Li、Peng Xu、Zetong Jing、Junhan Sun、Fanrong Dong、Ziqi Han、Xue Wang、Jianhua Sun、Cewu Lu、Hao Zhao、Liang Ding(哈尔滨工业大学 / 上海创智学院 / RoboParty Lab / 清华大学 / 上海交通大学;通讯作者 Haibo Gao、Peng Xu、Jianhua Sun、Liang Ding)
arXiv:2609.24840 [cs.RO](cs.RO 主分类,交叉 cs.LG),2026-09-21 提交 v1,2026-10-05 修订至 v3 · arXiv:2609.24840 · 项目页 · GitHub: MasterYip/PredActor
代码状态:评测代码已开源(MIT 许可)。仓库当前提供浏览器内 MuJoCo 评测、G1 资产与已发布的 PDP051 检查点(权重托管在 HuggingFace MasterYip/PredActor_Artifacts,用 uv sync --locked + predactor-eval 起本地服务,不需要 Isaac Sim 与训练仓库)。README 的发布清单里,数据采集与标注、BC 训练、DAgger 交互式聚合、机载部署四项仍标记为未完成([ ]),也就是说训练侧与真机侧目前都还无法第三方复现。
一句话总结
PredActor 把「预测未来状态」和「直接输出动作」压进同一个只用本体感受的扩散策略:一个交错的状态—动作 Transformer 一次去噪同时给出 20 步未来状态与动作,未来状态不出策略,只当作可微的操舵接口(分类器引导 CG 把它推向测试时目标,无分类器引导 CFG 放大文本条件),真正下发给 29 个关节的只有动作,因此既不需要参考轨迹跟踪器、也不需要特权全身状态估计。配合滚动去噪与「不改变计算结果」的运行时优化,完整控制回调在 Jetson Orin NX 上中位 16.790 ms、p95 19.383 ms,593/600 次落在 20 ms 控制周期内;作者称这是第一个整机载部署、跑 50 Hz 的联合状态—动作扩散策略(Unitree G1)。
一、问题:三种扩散控制范式各缺一块
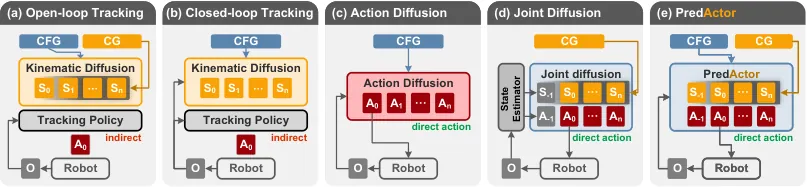
图1(论文 Figure 2):基于扩散的人形控制范式谱系。(a,b) 生成器—跟踪器方法把生成出来的动作交给一个独立跟踪器执行;(c) 纯动作扩散直接预测动作,但没有可供引导的未来状态;(d) 联合扩散同时预测状态与动作,却需要额外的状态估计;(e) PredActor 直接执行动作,同时用内部的未来状态预测承接 CG 与 CFG 两种操舵。O 为观测。
扩散模型在动作生成上的吸引力在于它天然多峰:同一段观测可以对应多种合理动作,采样过程把「选哪一种」交给条件与引导来决定。但把这种灵活性变成人形机器人的闭环控制,卡点不在生成质量,而在生成结果如何被执行、以及执行时谁来保证物理可行。论文把已有路线按这条线索分成三类,并指出每一类都缺一块。
第一类是分层生成器—跟踪器。运动学生成器(扩散或 flow matching)产出一段参考动作,交给一个物理训练出来的跟踪器执行;开环变体不回传机器人反馈,闭环变体(CLoSD、ReactiveBFM)把执行过的状态送回后续规划窗口。这条路的两个结构性问题很直接:参考轨迹可能落在跟踪器的支撑集之外,也就是生成器根本不知道跟踪器做得到做不到;而环境扰动到来时,系统的响应主要是跟踪器把状态拉回参考轨迹,不是行为层面的适应。此外规划与控制两套时钟各自运行,同步与重规划会变复杂。
第二类是纯动作扩散(Diffusion Policy、DiffuseLoco 一脉),直接从观测与任务条件映射到动作,省掉了参考跟踪这一层,闭环性质因此更好。代价是它的预测里没有显式的未来状态轨迹,于是测试时想「把机器人送去那个点」这类目标没有可微的落点——分类器引导需要一个状态量才能求梯度。
第三类是联合状态—动作扩散(Diffuser 的思想,Diffuse-CLoC、BeyondMimic、SCDP、SCRIPT 等实现),它把预测表示补了回来,可以在状态上做整形再影响动作。但论文指出两个不均衡:代表性控制器往往条件在特权全身状态上,于是 sim-to-real 必须额外挂一个可部署的状态估计器;同时两种引导接口的支持不齐——CFG 用来强化学到的行为条件,CG 用来把预测运动推向测试时目标,而在这些代表性联合控制器里 CFG 很少见。
于是论文把开放问题写成一个功能性的问句,而不是一个性能指标:一个直接执行的策略,能不能只用可部署的观测,同时具备「学出来的行为选择」与「测试时的运动操舵」,还不丢掉闭环抗扰?PredActor 的回答是:让状态预测留在策略内部当接口,动作照常直接下发。
论文用一张能力矩阵把 14 个系统按上面三类范式排开(Table 1)。它的说服力不在某一行,而在最后一行是整张表里唯一一个五列全勾的:
| 方法 | 范式(Fig.2) | 仅本体感受 | CFG | CG | 文本 | 真机 | 推理算力 | 控制频率 |
|---|---|---|---|---|---|---|---|---|
| MotionBricks + SONIC | 生成器 + 跟踪器 (a) | ◐ | – | – | – | ✓ | Orin(机载) | 50 Hz 跟踪器 |
| ARDY + SONIC | 开环跟踪 (a) | ◐ | ◐ | – | ◐ | – | RTX 4090 | – |
| TextOp | 开环跟踪 (a) | ◐ | ✓ | – | ✓ | ✓ | RTX 4090(离机) | 50 Hz 跟踪器 |
| RoboGhost | 隐空间生成 + 跟踪器 (a) | ✓ | – | – | ✓ | ✓ | Orin NX(部分) | 50 Hz 跟踪器 |
| ReactiveBFM | 闭环跟踪 (b) | ◐ | – | – | ✓ | ✓ | RTX 4090(离机) | 50 Hz |
| CLoSD | 闭环跟踪 (b) | – | ✓ | – | ✓ | – | – | N/A |
| DiffuseLoco | 动作扩散 (c) | ✓ | – | – | – | ✓ | RTX 4060M(机载) | 30 Hz 目标 |
| SENTINEL | 动作 flow + 残差 (c) | ✓ | ✓ | – | ✓ | ✓ | RTX 4090(离机) | 50 Hz |
| Diffuse-CLoC | 联合扩散 (d) | – | – | ✓ | – | – | RTX 4060(仿真) | N/A |
| BeyondMimic | 隐空间联合扩散 + 解码 (d) | ◐ | – | ✓ | – | ✓ | RTX 4060M(机载) | 25 Hz |
| SCDP | 联合扩散 (d) | ✓ | – | – | – | ✓ | RTX 5090(离机) | 50 Hz |
| SCRIPT | 联合扩散 (d) | – | ✓ | – | ✓ | – | – | N/A |
| UniPhys | 隐空间联合扩散 + 解码 (d) | – | ✓ | ✓ | ✓ | – | A100(仿真) | N/A |
| PredActor | 联合扩散 (e) | ✓ | ✓ | ✓ | ✓ | ✓ | Orin NX(机载) | 50 Hz |
表1:据论文 Table 1 整理。✓ 为该系统明确支持,– 为不支持,◐ 为部分或间接支持(例如观测里仍含估计量、CFG 只覆盖部分条件)。「推理算力」标注了算力所在位置:机载 / 离机 / 仅仿真。
二、预备知识:噪声水平、DDIM 与两种引导
读这篇论文需要三件预备知识。第一是扩散去噪的逐位置噪声水平。标准做法给整条轨迹一个标量噪声水平 $t$,一步步降到 0;PredActor 给horizon 里每个位置各配一个水平,记作向量 $\mathbf{k}_{s},\mathbf{k}_{a}\in\{0,\ldots,T\}^{h}$,上标 $0$ 表示干净样本。这不是花哨写法,而是滚动推理的前提:一条被反复平移复用的轨迹,头部位置已经去噪得很干净、尾部位置刚被新暴露出来还全是噪声,两者的噪声坐标天然不同。
第二是 DDIM 采样与它的确定性特例。DDIM 把一次「预测干净样本 → 跳回某个噪声水平」写成闭式更新,参数 $\eta$ 控制随机性;本文评测的部署档位取 $\eta=0$,此时更新完全确定,中间样本因此可以跨控制周期携带而不必每拍从头重采。这一点是后面所有延迟优化的地基。
第三是两种引导的分工,来自 Ho 与 Salimans 的 CFG 与更早的分类器引导。CFG 在训练时随机丢掉条件(conditional / null / partial-condition 三种预测都要学),推理时把条件预测与无条件预测外推混合,效果是放大「学到的行为条件」,本文用它强化文本命令。CG 在推理时对一个可微目标 $\mathcal{J}$ 求梯度并注入去噪过程,效果是把预测推向测试时才给出的目标,本文用它做目的地跟随与摇杆速度操舵。前者用的是训练里已有的语义,后者用的是训练时根本不知道的目标——这正是论文说的「两种互补的可操舵性」。
三、方法:一个策略,两条操舵通道
3.1 形式化:只用可部署观测的联合去噪
控制时刻 $t$,机器人上可得的本体感受观测记为 $\mathbf{o}_{t}\in\mathbb{R}^{d_{o}}$,全身运动状态记为 $\mathbf{s}(t)\in\mathbb{R}^{d_{s}^{\mathrm{phys}}}$,下发给关节控制器的动作记为 $\mathbf{a}(t)\in\mathbb{R}^{d_{a}}$。给定长度 $\ell$ 的观测历史 $\mathbf{o}_{t-\ell+1:t}$ 与可选任务上下文 $\mathbf{z}=[z_{1},\ldots,z_{n}]$,PredActor 在 $h$ 个 horizon 位置上预测干净的状态与动作轨迹 $\mathbf{s}^{0}\in\mathbb{R}^{h\times d_{s}}$、$\mathbf{a}^{0}\in\mathbb{R}^{h\times d_{a}}$。去噪器 $F_{\theta}$ 定义为
$$(\hat{\mathbf{s}}^{0},\hat{\mathbf{a}}^{0})=F_{\theta}(\mathbf{s}^{\mathbf{k}_{s}},\mathbf{a}^{\mathbf{k}_{a}},\mathbf{k}_{s},\mathbf{k}_{a};\mathbf{o}_{t-\ell+1:t},\mathbf{z}) \tag{1}$$
式 (1) 里最值得盯住的是分号右边只有什么:观测历史与任务上下文。全身状态 $\mathbf{s}$ 只作为训练目标出现,部署时策略不吃它,也不需要外部估计器把它补出来。预测出来的状态是内部引导变量,只有被选中的那一步动作会送进关节控制器,中间没有独立的参考跟踪器。
被评测的 G1 档位把这条式子里的维度填成了具体数字(论文 Table 6 与 Appendix B.1.1)。可部署观测是 96 维:29 维关节位置、29 维关节速度、3 维基座坐标系下的投影重力、3 维 IMU 角速度、29 维上一步动作,再加 3 维基座线速度。物理状态是 192 维,经一个固定的「强调投影」映射成 384 维模型表示——投影 $E$ 与其伪逆 $E^{\dagger}$ 在训练前就指定好,不由梯度学习,实现上是「加权对称随机投影拼接一个恒等分量」,它改变表示维度而不改变底层物理量。动作是 29 个关节控制器指令,由运行时转成 PD 目标。文本条件走一个 512 维语义嵌入。归一化统计只在训练划分上拟合、测试时冻结。
192 维物理状态的构成在开源仓库里写得更直白。标准 G1 的前向运动学布局是:30 个刚体的局部位置占 $[0:90]$、30 个刚体的局部线速度占 $[90:180]$、根位置 $[180:183]$、根姿态(roll/pitch/yaw)$[183:186]$、根线速度 $[186:189]$、根角速度 $[189:192]$(见 PredActor/diffusion_policy/task_provider/whole_body_guidance/guidance_types/axes_vel.py 顶部注释)。这份布局也解释了后面的引导为什么能按轴、按身体分组去施加。
3.2 交错的状态—动作 Transformer 与非对称注意力
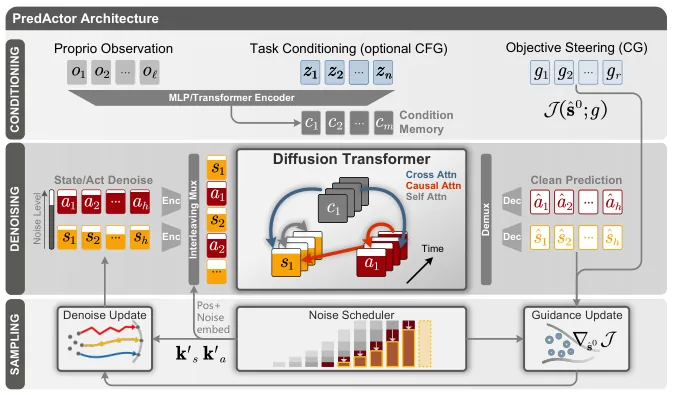
图2(论文 Figure 3):PredActor 的联合预测架构。观测历史与任务命令条件化一个 Transformer,它同时去噪交错排列的未来状态 token 与动作 token。操舵改变的是状态更新,不是当前这一步的动作预测;被改过的状态可以在下一个去噪步影响动作。执行的只有动作。
编码器把观测历史 token $o_{1},\ldots,o_{\ell}$ 与任务 token $z_{1},\ldots,z_{n}$ 映射成条件记忆 $\mathbf{C}=[c_{1},\ldots,c_{m}]$。噪声状态与动作 token 各自过独立投影,拼上噪声水平与 horizon 位置的正弦嵌入,然后按
$$[s^{\mathrm{tok}}_{1},a^{\mathrm{tok}}_{1},\ldots,s^{\mathrm{tok}}_{h},a^{\mathrm{tok}}_{h}] \tag{2}$$
交错成一条序列送进 Transformer 解码器,学习到的位置嵌入保留 horizon 顺序。这个骨架沿用 Diffuse-CLoC 的交错 token 对与非对称自注意力:状态 query 可以看到所有状态 token,但看不到动作 token;动作 query 对两条流都做因果注意力。解码器另外对 $\mathbf{C}$ 做交叉注意力,于是去噪 token 能查询编码后的本体感受历史与任务上下文。两个独立输出头分别给出 $\hat{\mathbf{s}}^{0}$ 与 $\hat{\mathbf{a}}^{0}$。参考骨架是 2 层解码器、4 个注意力头、256 维嵌入,horizon $h=20$,动作维度 29——论文明确说这些是配置选择而非架构必需。
这条掩码规则在开源代码里能一一对上。PredActor/diffusion_policy/backbone/transformer_codiffuse.py 第 143–154 行按奇偶下标把四块子掩码拼成一张 $\mathbb{R}^{(h_{x}+h_{y})\times(h_{x}+h_{y})}$ 的浮点掩码:
sz = self.x_horizon + self.y_horizon
mask = torch.ones((sz, sz), dtype=torch.bool)
mask[::2,::2] = get_causal_mask(x_to_x_attn, self.x_horizon, self.x_horizon)
mask[1::2,1::2] = get_causal_mask(y_to_y_attn, self.y_horizon, self.y_horizon)
mask[::2,1::2] = get_causal_mask(x_to_y_attn, self.x_horizon, self.y_horizon)
mask[1::2,::2] = get_causal_mask(y_to_x_attn, self.y_horizon, self.x_horizon)
mask = mask.float().masked_fill(mask == 0, float('-inf')).masked_fill(mask == 1, float(0.0))
偶数行是状态 token、奇数行是动作 token,所以 mask[::2,1::2] 就是「状态 query 看动作 key」这一块。配置文件 config_files/defaults/policy/cond_codiffuse.yaml 给的是 x_to_x_attn: full、x_to_y_attn: no_attn、y_to_x_attn: causal、y_to_y_attn: causal,也就是状态看不到动作、动作因果地看到状态与自己——与论文描述的非对称模式完全一致(YAML 里那两行注释把 x/y 的方向写反了,以掩码构造代码为准)。这个方向性是整套引导机制能成立的原因:状态被引导改写后,动作能在下一步通过 state→action 注意力感知到;反过来状态不会被动作污染,引导才有干净的落点。
3.3 两条操舵通道:CFG 与 CG
应用时,任务条件与目标操舵是两个互补接口。条件 / 无条件 / 部分条件的训练让 CFG 可用,它把条件预测与空预测混合以放大学到的任务行为(例如文本条件动作)。操舵命令 $\mathbf{g}=[g_{1},\ldots,g_{r}]$ 参数化一个可微目标 $\mathcal{J}(\hat{\mathbf{s}}^{0};\mathbf{g})$,CG 在反向更新之前施加 $\nabla_{\hat{\mathbf{s}}^{0}}\mathcal{J}$。论文特别强调 CG 的语义边界:它不改动当前这一步的动作预测,被更新的状态通过 state→action 注意力在下一个去噪步影响动作。
部署档位把这条链路写得非常省。每个噪声水平 $t_{i}$ 上,精简骨架只预测一次干净的动作与状态轨迹
$$(\hat{a}_{i}^{0},\hat{s}_{i}^{0})=F_{\theta}(a_{i},s_{i},t_{i},c_{\mathrm{enc}}) \tag{3}$$
引导开启时,同一份状态预测被一个解析的全身代价(whole-body guidance,WBG)修正后直接喂回 DDIM 更新:
$$\tilde{s}_{i}^{0}=\hat{s}_{i}^{0}-G(\hat{s}_{i}^{0};u_{v_{x}},u_{v_{y}},u_{v_{z}}),\qquad(a_{i-1},s_{i-1})=\mathcal{D}(a_{i},s_{i},\hat{a}_{i}^{0},\tilde{s}_{i}^{0};t_{i},t_{i-1}) \tag{4}$$
关键在于 $\hat{a}_{i}^{0}$ 不会因为引导而重算,被修改的状态进入 $s_{i-1}$,下一次骨架前向才把操舵效果传播到动作预测上。因此每个扩散步只做一次骨架前向,两步采样总共两次。论文顺带说明:一个「重复骨架」的变体要跑四次前向、并且会改变引导方程,所以被明确排除在精确加速消融之外——这是为了让 Table 4 的每一行都对应同一份计算图。
代码侧同样能对上。PredActor/diffusion_policy/modules/classifier_guidance.py 的 compute_gradient()(第 71–123 行)先 with torch.enable_grad() 强制打开梯度(注释写着「引导即使在推理期的 no_grad 上下文里也需要梯度」),必要时 detach().requires_grad_(True) 把状态与动作轨迹接上计算图,算完代价后用 torch.autograd.grad 分别取 state_grad 与 action_grad,缺失的一侧补零张量,最后统一乘上 guidance_scale(即论文里的 $\lambda$)。配置 config_files/g1_cond_diffuse.yaml 里 guidance_mode: classifier 后面直接注着「paper-correct」,另有一个 pd 遗留模式。
更细的一层是引导的粒度:每个受控自由度是一个独立引导对象,各自持有自己的激活集合与身体分组。guidance_types/axes_vel.py 里的 VxGuidance/VyGuidance/VzGuidance 各控一个机体坐标平移轴,WzGuidance 控偏航角速度,它们都只把 delta = target - current 掩到自己负责的分量上,叠加由管理器求和完成(分量不重叠所以能正确累加)。配置里 vx_guide 引导 pelvis_torso、vy_guide/wz_guide/hz_guide 引导 torso,各自带 kp 与取值范围;目的地跟随默认关闭,可在评测 Web UI 里打开(kp_x: 2.0、kp_y: 0.8、kp_w: 6.0、arrival_radius: 0.30)。这就是论文里「stacked-axis WBG」的实现形态:把多轴代价沿轴堆叠成一次张量运算,而不是逐轴循环。
3.4 数据与训练:把带标签的动作库变成可部署的观测窗口
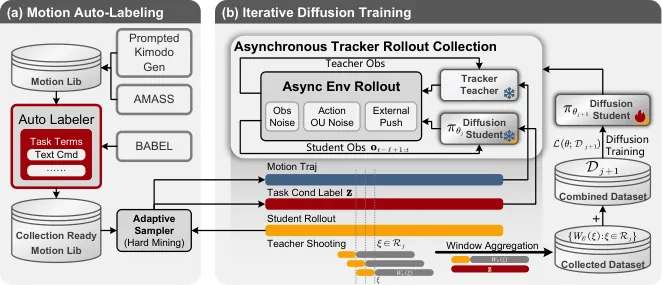
图3(论文 Figure 4):数据与训练流水线。生成并标注过的动作参考驱动异步跟踪 rollout,产出的可部署观测与任务标签条件化联合状态—动作训练。迭代数据聚合阶段,教师轨迹射击从学生 rollout 的原点构造目标窗口,收集到的窗口进入回放池,然后才开始下一轮重建训练。
动作库由提示式动作生成与 AMASS 合并而成,BABEL 提供任务标签,MotionCLIP 把标签编码成条件隐向量。自适应采样器把动作参考喂给异步 rollout 流水线:一个冻结的跟踪教师在观测噪声、动作噪声与外部推扰下执行每条参考,把同步的观测历史、未来身体状态、教师动作与任务标签存成初始离线数据集 $\mathcal{D}_{0}$。被评测的数据集是 7600 条教师 rollout episode,来自 152 段重定向到 G1 的 ACCAD 动作、每段 50 条 rollout。完整 rollout 轨迹先划分训练/评测、再切固定长度窗口,归一化统计只在训练划分上拟合,因此没有任何一条 rollout 同时给两个划分贡献窗口。
训练用 DAgger 式的迭代数据聚合,交替做三件事:冻结学生 rollout 采集、隔离的教师轨迹射击、继续扩散重建训练。第 $j$ 轮里学生 $\pi_{\theta_{j}}$ 诱导出一批 rollout 原点 $\mathcal{R}_{j}$;从每个原点 $\xi$ 出发,一条独立仿真分支里的教师沿对齐的参考继续走,产出目标状态—动作窗口 $W_{E}(\xi)$,与学生的历史和任务标签配对,然后
$$\begin{aligned}\mathcal{D}_{j+1}&=\mathcal{D}_{j}\cup\{W_{E}(\xi):\xi\in\mathcal{R}_{j}\},\\ \theta_{j+1}&\approx\arg\min_{\theta}\mathcal{L}(\theta;\mathcal{D}_{j+1})\end{aligned} \tag{5}$$
这里有个容易被读漏的实现细节,论文在 Appendix B.2.2 专门澄清:教师续段是在另一个仿真分支里查询的,带状态与随机数生成器校验,保证这次查询不推进也不改变学生的实时轨迹。所以教师动作是标签,不是干预——它不会把学生从自己的状态分布上拽走,这正好是 DAgger 想要的性质(训练分布跟着学生走,监督信号来自教师)。窗口构造器 $W_{E}$ 保留学生已执行的历史前缀(过去的动作是学生自己的、与其转移前状态配对),从分支原点起的动作与状态目标则来自教师;未完成的续段会被标记,只有完整窗口进入回放。
初训与后续回放共用同一个重建目标:
$$\begin{aligned}\mathcal{L}(\theta;\mathcal{D})=\mathbb{E}\bigg[&\sum_{i=1}^{h}w_{i}^{a}\lVert\hat{\mathbf{a}}_{i}^{0}-\mathbf{a}_{i}^{0}\rVert_{2}^{2}+\rho\sum_{i=2}^{h}\lVert\Delta\hat{\mathbf{a}}_{i}^{0}-\Delta\mathbf{a}_{i}^{0}\rVert_{2}^{2}\\ &+\gamma_{s}\sum_{i=1}^{h}w_{i}^{s}\lVert\hat{\mathbf{s}}_{i}^{0}-\mathbf{s}_{i}^{0}\rVert_{2}^{2}\bigg]\end{aligned} \tag{6}$$
期望覆盖训练窗口、采样噪声与扩散水平;$w_{i}^{a},w_{i}^{s}$ 是逐 horizon 位置的权重,$\Delta\mathbf{a}_{i}^{0}=\mathbf{a}_{i}^{0}-\mathbf{a}_{i-1}^{0}$,$\rho$ 与 $\gamma_{s}$ 分别给动作差分正则与状态重建加权。三项各管一件事:动作本身、动作的平滑性、以及用于引导的那条内部未来状态轨迹。状态与动作窗口是独立加噪的。训练超参:50 个 epoch,基础学习率 $10^{-4}$,余弦衰减配 10000 步 warmup,batch 256,数据采样率 0.01,三个种子 92025/92026/92027。教师只提供训练目标,部署时完全不在链路里。
3.5 滚动推理:调度匹配的复用与延迟补偿
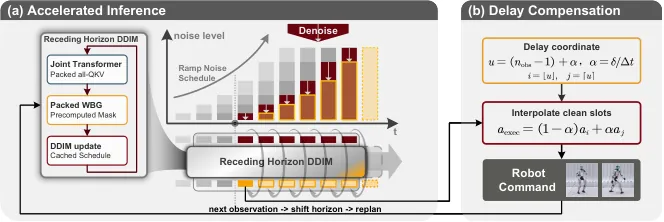
图4(论文 Figure 5):滚动推理与延迟补偿。调度匹配的样本在每次拿到新观测后被平移并重新规划;执行前用一个延迟坐标在相邻的干净动作槽之间插值。
训练时每个位置的噪声水平是独立采样的,推理时却是另一回事:滚动推理把一条部分去噪的状态—动作 horizon 跨控制拍携带。执行完一个动作,缓冲区平移一格,最新的本体感受观测条件化下一次去噪。对 $u\in\{s,a\}$ 任一条流,DDIM 更新把干净预测转回目标噪声水平上的反演样本:
$$\hat{\epsilon}_{t}=\frac{u^{t}-\sqrt{\bar{\alpha}_{t}}\hat{u}^{0}}{\sqrt{1-\bar{\alpha}_{t}}},\qquad u^{t^{\prime}}=\sqrt{\bar{\alpha}_{t^{\prime}}}\hat{u}^{0}+\sqrt{1-\bar{\alpha}_{t^{\prime}}-\sigma_{t}^{2}}\hat{\epsilon}_{t}+\sigma_{t}\epsilon \tag{7}$$
$$\sigma_{t}=\eta\sqrt{\frac{1-\bar{\alpha}_{t^{\prime}}}{1-\bar{\alpha}_{t}}}\sqrt{1-\frac{\bar{\alpha}_{t}}{\bar{\alpha}_{t^{\prime}}}} \tag{8}$$
评测用的确定性档位令 $\eta=0$,于是 $\sigma_{t}=0$、随机噪声项消失,运行时因此可以把中间样本跨控制步带着走,而不是每拍重启整条 horizon。每个 horizon 位置可以走自己的 DDIM 跳跃,源水平与目标水平用矩阵 $S,S^{\prime}\in\mathbb{Z}^{K\times h}$ 表示,每个元素在其 horizon 位置上沿特征维广播,状态流与动作流可以用不同矩阵。运行时复用那个源水平恰好等于下一步所需位置的已存中间样本,只对新暴露出来的尾部位置加新噪声,再在最新观测下去噪平移后的 horizon。论文把这条性质叫「调度匹配复用」,并点出它的对立面:把一个干净预测直接拷进任意噪声水平是错的,那样等于篡改了样本的扩散坐标。
开源实现里这两块都能定位。PredActor/diffusion_policy/utils/noise_scheduler.py 的 get_denoising_matrix() 返回 $(K,H)$ 的噪声水平矩阵(供 DDPM 路径与滚动 DDIM 路径使用),get_rolling_traj() 从一条去噪链里抽出 $(B,H-1,D)$ 的滚动缓冲——即「部分去噪轨迹」——并且在找不到匹配快照时直接抛错而不是静默降级("rolling trajectory has no matching denoising snapshot for ...");build_ns_ddim_steps() 构造的就是评测档位用的 NS-DDIM 步序列,每步带 s_t_cur/s_t_prev/a_t_cur/a_t_prev 四个逐位置水平。
执行侧还有一个真实世界才会出现的问题:从「策略算出动作」到「电机真的动」之间有延迟 $\delta$。PredActor 不额外建延迟模型,而是在同一套 horizon 坐标里定义延迟坐标 $u=(n_{\mathrm{obs}}-1)+\delta/\Delta t$,取它相邻的两个干净动作槽做线性插值,得到延迟补偿后的 PD 目标。utils/action_selection.py 第 43–92 行就是这条算术:coordinate = past_step + delay(其中 past_step = n_obs_steps - 1),并做两级校验——插值端点必须落在可执行槽内,而非整数延迟要求末端动作噪声水平为 0(terminal_action_noise_levels()),否则报错。也就是说「拿一个还没去噪干净的槽去插值」这种静默错误在代码层被挡住了。
3.6 机载执行:C++ 导出与安全边界
机载部署把扩散 actor 与控制接口导出成 C++。导出产物包含 TorchScript 骨架、扩散调度、归一化统计、actor 配置与部署配置。C++ 运行时负责归一化观测与条件、跑 actor、反归一化动作轨迹,并按上面的延迟坐标线性插值出补偿后的 PD 目标。外部条件(文本命令、摇杆量)由一个异步 UDP 接收器在互斥锁下锁存最新值,因此条件传输与控制回调解耦——命令晚到不会拖住 50 Hz 的拍子。一个 Passive–Ready–Running 状态机为策略动作把门,跌倒或力矩故障时回落 Passive。被评测的 Orin 档位是:batch 为 1 的 FP32 条件化策略、两步确定性 DDIM、打包的自注意力与交叉注意力投影、缓存的命令嵌入、预计算调度、堆叠轴 WBG、eager 有限性检查,以及 LibTorch inference mode。
flowchart TB
    OBS["Proprioceptive history o_t-l+1:t
96 dim: 29 q + 29 dq + 3 gravity + 3 imu
+ 29 prev action + 3 base lin vel"] --> ENC["Condition encoder
to memory C of m tokens"]
    TXT["Optional task context z
512 dim MotionCLIP text embedding"] --> ENC
    JOY["Test-time steering g
joystick vel or destination"] --> COST["Analytic whole-body cost J
per-DOF guidance, stacked axes"]
    ENC --> XATTN["Interleaved transformer 2 layers 4 heads 256 dim
tokens s1 a1 ... s20 a20
state queries see states only
action queries see both causally"]
    XATTN --> PRED["One forward per level
clean preds s0_hat and a0_hat  (Eq 3)"]
    PRED --> CG["Classifier guidance
s_tilde = s0_hat - G(s0_hat; g)  (Eq 4)
action pred NOT recomputed"]
    PRED --> CFG["Classifier-free guidance
mix conditional and null preds
amplifies text condition"]
    CFG --> CG
    CG --> DDIM["DDIM jump to target levels (Eq 7)
eta = 0 so sigma_t = 0, deterministic"]
    DDIM --> ROLL["Rolling buffer shift
schedule-matched reuse S and S_prime in Z^(K x h)
fresh noise only on newly exposed tail"]
    ROLL -->|next control tick| XATTN
    ROLL --> SEL["Delay compensation
u = (n_obs - 1) + delta / dt
interpolate two adjacent clean action slots"]
    SEL --> PD["29 PD targets to joint controller at 50 Hz
no motion reference tracker, no privileged state"]
    PD --> ROBOT["Unitree G1 onboard Jetson Orin NX
callback p50 16.790 ms, p95 19.383 ms"]
    ROBOT -->|new proprioception| OBS
    ROBOT --> SAFE["Passive-Ready-Running state machine
fall or torque fault falls back to Passive"]
    TEACHER["Frozen tracking teacher
training-time data source only"] -.->|labels, absent at deployment| XATTN
图5:PredActor 的闭环数据流。实线是部署时每 20 ms 走一圈的推理路径,虚线的教师只存在于训练期。操舵注入点在 CG 一处,它改的是状态而不是当前动作,效果要到下一个去噪步才通过 state→action 注意力传到动作上。
四、实验:论文自设的三问三答
论文把评测组织成三个问题:Q1,PredActor 能否同时具备 CG 目的地操舵与 CFG 文本控制,还不丢扰动恢复?Q2,精确的引导式推理能否满足 20 ms 的机载预算?Q3,同一个策略能否既支撑仿真接口又跑通真机 G1?策略以 50 Hz 控制 29 个关节,预测 20 步状态—动作 horizon。
4.1 Q1:七个策略在同一台校准过的 MuJoCo 上对打
比较对象是七个策略,六个是学习策略(各用 7600 条教师 rollout、三个训练种子),ARDY+SONIC 是单模型参考。指标覆盖存活率、0.6 m 内到达、导航误差、MotionCLIP 文本检索、jerk 与延迟。作者自己复现的 Diffuse-CLoC 记作 CLoC+FK:用前向运动学估计它需要的特权状态输入,后缀就是指这个观测接口;相对地 PredActor 只条件在本体感受历史上,不做 FK 重建。
| 方法 | Jerk RMS ↓ ($10^{3}\,\mathrm{s}^{-3}$) | 延迟 ↓ (ms) | 抗推存活 ↑ | 导航存活 ↑ | 到达率 ↑ | 末次有效误差 ↓ (m) | 文本存活 ↑ | 文本检索 ↑ |
|---|---|---|---|---|---|---|---|---|
| ARDY + SONIC(单模型参考) | 19.221 | N/E | 0.534 | 1.000 [2/15] | 0.500 [2/15] | 0.656 | 1.000 [23/45] | 0.237 [23/45] |
| DiffuseLoco w TextCFG | 15.899 ±6.870 | 12.141 ±0.145 | 0.563 ±0.009 | N/A | N/A | N/A | 0.947 ±0.047 | 0.424 ±0.159 |
| CLoC+FK | 266.605 ±32.412 | 6.102 ±0.029 | 0.303 ±0.031 | 0.064 ±0.005 | 0.000 ±0.000 | 3.194 ±0.112 | N/A | N/A |
| CLoC+FK w TextCFG | 101.682 ±2.110 | 8.788 ±0.141 | 0.296 ±0.020 | 0.450 ±0.059 | 0.333 ±0.067 | 2.217 ±0.450 | 0.782 ±0.033 | 0.416 ±0.106 |
| PredActor w/o TextCFG | 11.849 ±0.899 | 1.310 ±0.006 | 0.579 ±0.012 | 0.845 ±0.120 | 0.822 ±0.139 | 0.983 ±0.301 | N/A | N/A |
| PredActor w/o state | 12.448 ±0.675 | 1.050 ±0.004 | 0.487 ±0.033 | N/A | N/A | N/A | 0.778 ±0.145 | 0.397 ±0.023 |
| PredActor | 16.810 ±1.409 | 1.321 ±0.011 | 0.511 ±0.030 | 0.983 ±0.030 | 0.978 ±0.038 | 0.605 ±0.029 | 0.888 ±0.068 | 0.539 ±0.075 |
表2:据论文 Table 2 整理。六个学习策略的行为三个独立训练检查点的均值 ± 样本标准差;方括号是「已评测/请求」的格子数。N/A 表示该策略不支持此任务,N/E 表示未评测——两者都与 0 严格区分。ARDY+SONIC 的 45 个目的地参考里只有 2 个、45 个文本参考里只有 23 个能通过它的关节范围转换器,因此该行数字不可与其他行横比。文本检索按各策略自己的合格窗口计(PredActor 119/135,DiffuseLoco 126/135,CLoC+FK w TextCFG 103/135,w/o state 98/135)。
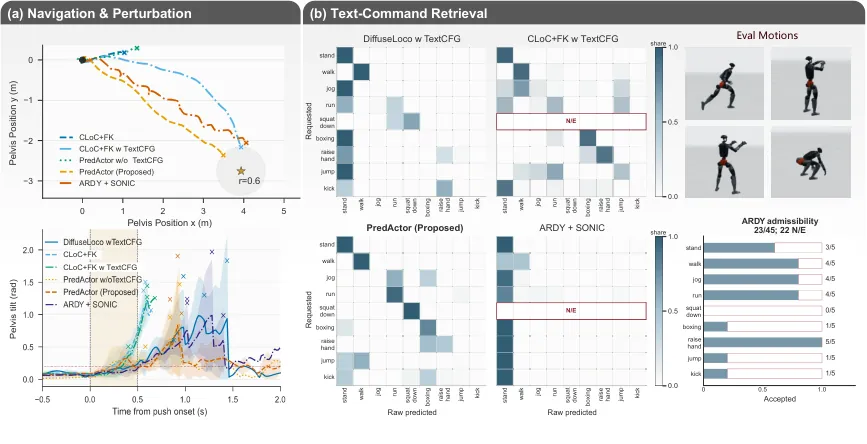
图6(论文 Figure 6):七个策略行中六个的代表性 MuJoCo 轨迹。(a) 统一协议坐标系下的目的地轨迹(星号是目标、圆圈是 0.6 m 到达阈值),以及 300 N 推力下方向匹配的骨盆倾角(线为均值、带为样本标准差、叉号标记提前终止),每个策略 20 个配对的方向/种子格子。(b) 各可评测策略的逐类原始 MotionCLIP top-1 检索、示例评测动作,以及 ARDY+SONIC 按请求类别的参考可采纳性。缺失格子与 0 保持区分。
操舵性能。PredActor 是唯一同时交出目的地跟随与文本控制成绩的策略:45 个目的地里到达 44 个(到达率 $0.978\pm0.038$),末次有效误差 $0.605\pm0.029$ m;文本检索 $0.539\pm0.075$,而 DiffuseLoco w TextCFG 是 $0.424\pm0.159$。文本存活率分别是 $0.888\pm0.068$ 与 $0.947\pm0.047$——纯动作扩散在「不出事」上略好,但在「做出来的动作是不是被要求的那个」上明显差一截,标准差也大得多(0.159 对 0.075),说明它的文本响应不稳定。CLoC+FK 两行更能说明特权状态接口的代价:不带文本条件时到达率是 0.000、末次有效误差 3.194 m,带上文本 CFG 也只恢复到 0.333 与 2.217 m,同时 jerk RMS 高达 101.682(PredActor 是 16.810),动作剧烈抖动。
效率与鲁棒性。actor 延迟 $1.321\pm0.011$ ms,DiffuseLoco w TextCFG 是 $12.141\pm0.145$、CLoC+FK w TextCFG 是 $8.788\pm0.141$,接近一个数量级的差距。jerk RMS 三者分别是 $16.810\pm1.409$、$15.899\pm6.870$、$101.682\pm2.110$——PredActor 的均值略高于 DiffuseLoco,但对方标准差是它的近五倍。抗推存活率 $0.511\pm0.030$ 对 DiffuseLoco 的 $0.563\pm0.009$,论文的用词是 similar,没有声称更好。
状态流消融。去掉预测状态这一条流之后,抗推存活、文本存活、文本检索分别变成 $0.487\pm0.033$、$0.778\pm0.145$、$0.397\pm0.023$,都低于完整模型;更直接的是目的地指标变成 N/A——没有预测状态就没有 CG 的落点,这个任务从「做得差」变成「做不了」。论文为此单独做了一次匹配消融(两臂分别重训,同一份数据、同一套观测与条件张量、20 步动作 horizon、同一优化器与调度、同一个两步采样器、同一运行时、同三个种子,可训练参数量只差 0.0161%),并诚实给出配对效应与 95% 置信区间:
| 指标(主 no-CG 契约下) | 匹配的 PredActor(S+A) | PredActor w/o state(A) | 配对效应 [95% CI] |
|---|---|---|---|
| 抗推存活 ↑ | 0.535 ±0.009 | 0.487 ±0.033 | +0.048 [-0.024, 0.120] |
| 推后恢复 ↑ | 0.043 ±0.040 | 0.193 ±0.110 | −0.150 [-0.494, 0.194] |
| 文本存活 ↑ | 0.866 ±0.011 | 0.778 ±0.145 | +0.088 [-0.246, 0.421] |
| 文本检索 ↑ | 0.538 ±0.087 | 0.397 ±0.023 | +0.142 [-0.019, 0.302] |
| Jerk RMS ↓ | 15.684 ±2.368 | 12.448 ±0.675 | +3.236 [-2.200, 8.671] |
| 延迟(B=5)↓ (ms) | 1.335 ±0.039 | 1.050 ±0.004 | +0.285 [0.199, 0.372] |
表3:据论文 Table 8 整理。效应 = 匹配的联合状态—动作臂减去纯动作臂,95% 置信区间取三个配对种子差值的双侧 $t$ 区间。检索窗口分别是 113/135 与 98/135。目的地指标不可用,因为在线状态 CG 被禁用(这就是「主 no-CG 契约」的含义)。
这张表值得逐格读,因为它并不全对 PredActor 有利:六项里只有延迟一项的置信区间不跨零,而它的方向是「联合建模更慢 0.285 ms」。文本检索 +0.142 的区间是 [-0.019, 0.302],差一点点就显著;抗推存活与文本存活的区间都宽到覆盖 0;推后恢复一项点估计甚至是负的(0.043 对 0.193),不过两臂的标准差都很大(0.040 与 0.110),这个指标本身噪声极高——严格恢复要求在力结束后 25 步持续留在三道门内(根高度不低于 0.55 m、骨盆倾角绝对值小于 0.3 rad、基座角速度小于 1 rad/s),两臂都很少达标。诚实地说:在三个种子的样本量下,状态流的收益主要还是一个功能性事实(它让 CG 存在),而不是一组已经被统计证实的性能优势。
4.2 Q2:把引导式扩散塞进 20 ms
机载这一节是全文工程密度最高的部分。基准测的是一台 Jetson Orin NX 上 batch 为 1 的 FP32 引导推理与完整回调,计时边界是「收到机器人状态消息 → 产出主机侧动作张量」,期间不下发任何执行指令(所有 actuation counter 保持为 0)。先看采样步数的收益:把十步降到两步,优化前的引导 actor p50 从 92.011 ms 降到 21.846 ms。但步数不是白降的——论文用滚动去噪下的抗推存活率来选点:两步 58%、三步 61%、十步 45%。十步反而最差,说明更长的去噪链在闭环里会带来跨拍不一致;两步与三步接近,于是选两步作为部署档位。
然后是运行时优化的累计路径。这张表的读法要小心:Saved 列是同一测试套件内相对上一行的 p50 下降量,不是可相加的因子效应;换套件或换边界的地方论文用单独的行标出。
| 组成 / 边界 | p50 (ms) | p95 (ms) | 相对上行节省 (ms) | 超 20 ms 次数 |
|---|---|---|---|---|
| 结构化基线;顺序 WBG | 21.461 | 22.036 | – | 600/600 |
| + 堆叠轴 WBG | 18.315 | 19.677 | 3.147 | 8/600 |
| + DDIM 调度预计算 | 17.442 | 18.347 | 0.872 | 0/600 |
| + all-QKV 打包 | 16.331 | 17.372 | 1.111 | 0/600 |
| + 条件缓存 | 15.930 | 16.728 | 0.401 | 0/600 |
| 同结构,运行时重测 | 16.234 | 16.912 | – | 1/600 |
| + inference mode(最终 actor) | 13.175 | 13.400 | 3.058 | 0/600 |
| 最终 live callback-to-host | 16.790 | 19.383 | – | 7/600 |
表4:据论文 Table 4 整理。除最后一行 live callback 外均为冻结 actor 的 CUDA 计时;档位是 NS-DDIM2、B=1 FP32、每步一次前向(共两次)、WBG 开启、eager 有限性检查。数值为三个 200 次调用分块的中位数。
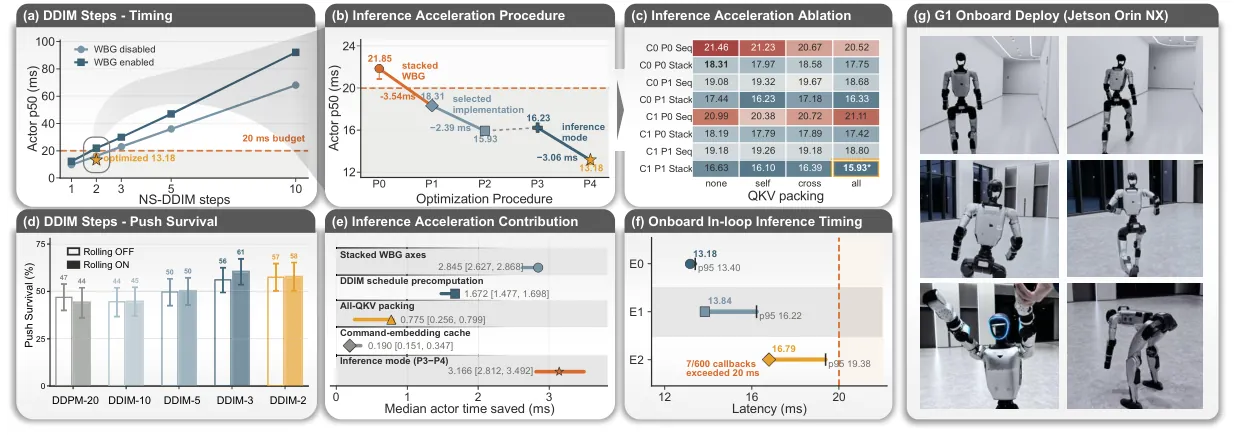
图7(论文 Figure 7):Orin 加速与机载 G1 部署。(a,d) 采样器计时与抗推存活率;(b) 从原始 actor 经可缓存重导出、选定配置、运行时重测到 LibTorch inference mode 的 $\mathrm{P}_{0}$–$\mathrm{P}_{4}$ 路径;(c) 消融矩阵(C 条件缓存,P 调度预计算,Seq/Stack 为 WBG 的两种轴向);(e) 各项实现节省,标记为三个配对分块的中位下降、括号给出 min–max 范围;(f) 三个计时端点 $\mathrm{E}_{0}$(固定输入 actor)、$\mathrm{E}_{1}$(新状态接收与转换 + actor)、$\mathrm{E}_{2}$(完整回调至主机动作)的 p50–p95,各端点用 $3\times200$ 次保留调用;(g) 机载 G1 部署的定性帧。
配对消融把中位节省归因到具体项:WBG 堆叠 2.845 ms、调度预计算 1.672 ms、all-QKV 打包 0.775 ms、条件缓存 0.190 ms,inference mode 在配对运行时块之间省 3.166 ms。这些效应依赖配置、不可相加。整条链最重要的性质是「计算保持」:优化前后输出漂移小于 $1.073\times10^{-6}$,也就是说省下来的时间不是靠改变策略算出来的东西换来的,而是靠消掉重复劳动(打包 QKV、缓存条件嵌入与 DDIM 调度、把逐轴 WBG 堆叠成一次张量运算、开 inference mode)。
最后是完整回调:p50/p95 为 16.790/19.383 ms,593/600 次落在 20 ms 预算内。注意 actor 本身的 13.175 ms 与回调的 16.790 ms 之间有约 3.6 ms 差额,那是状态接收与转换、归一化、延迟补偿插值、主机侧动作张量成型这些真实边界开销——论文用 $\mathrm{E}_{0}/\mathrm{E}_{1}/\mathrm{E}_{2}$ 三个端点把它们分开测,并明确说明各端点的百分位数不能相加。剩下的 7/600 次超时定义了尾延迟余量。
4.3 Q3:真机 G1 上的六组设置
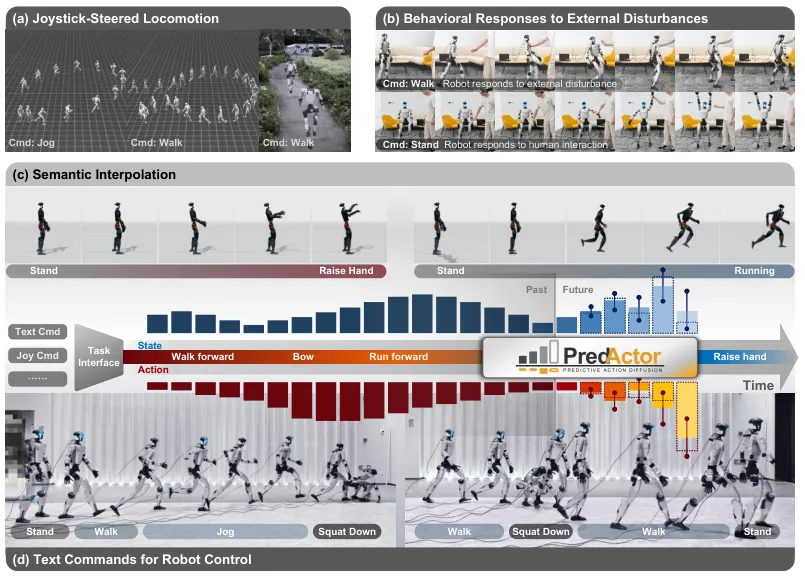
图8(论文 Figure 1):PredActor 在单个直接执行的策略里实现可操舵、可响应的人形控制。与「操舵参考轨迹、把可行性与扰动恢复交给独立跟踪器」的生成器—跟踪器流水线不同,也与「缺少显式未来状态接口、无法做测试时引导」的纯动作扩散不同,PredActor 联合预测未来状态与可执行动作,因而在同一个闭环策略内同时支持 (a) 摇杆操舵、(b) 扰动响应、(c) 语义插值、(d) 文本命令控制。
真机部分是独立的 Unitree G1 试验:四种动作转换与两种推扰设置,每组五次。成功判据写得很硬——完成请求的转换,或在推力之后保持直立;跌倒、行为不完整、安全停机都算失败。结果是 stand→walk 5/5、walk→jog 5/5、stand→squat 5/5、squat→stand 4/5、站立推扰 4/5、行走推扰 4/5(论文 Table 3)。论文明确标注这些是描述性计数,不做统计推断,逐次试验的六帧时序图放在 Appendix D.4 的 Figures 10–15。
定性演示覆盖四类接口:文本控制(真机上分段的 stand / walk / jog / squat 命令)、摇杆控制(仿真中的操舵行走)、语义插值(仿真中从站立向「举手」或「跑步」插值)、交互响应(真机对外部干扰的选定响应,另有四段在 walk 或 stand 命令激活下的外部交互序列)。仿真侧的推扰协议是行走中水平施加 100/200/300/400/500 N、持续 0.5 s,每个检查点在每个力级上用同样的 20 个配对方向/种子抽取,共 100 个请求格子;存活率是650 步视界里观测到的比例,提前终止按其实际时长计入而不是记 0,这一点论文也特意说明,因为它决定了 0.511 这类数字该怎么读。
五、局限性
作者自述(Appendix D.3 Future scope)。当前引导接口只在测过的目标范围内标定过,更强的引导会把去噪推出策略的训练分布;文本控制被限制在学到的语义类别里,因为条件模型与训练数据、动作库的覆盖还不支持对复杂或组合式命令的可靠解释;训练动作库也不覆盖持续多接触行为,例如爬行与攀爬。作者列出的后续方向是受约束或自适应的引导、更广的语言—动作数据,以及面向更丰富接触转换的训练目标。
作者自述(计时研究的边界)。计时只针对一台 Orin 上的一个 batch-one FP32 导出产物,测的是离线的 callback-to-host 边界,期间不真正下发执行指令。图字节、热状态、运行时版本与实现设置都属于被测系统的一部分,换一次导出或换一台设备就需要重新鉴定。这条限制很实在:16.790/19.383 ms 不是一个可移植的通用数字,而是这一份产物在这一台机器上的测量。
我的判断一:状态流的性能收益尚未被统计证实。Table 8 的六个配对效应里,只有延迟一项的 95% CI 不跨零,而它的方向对 PredActor 不利(+0.285 ms)。文本检索 +0.142 的区间是 [-0.019, 0.302],抗推存活与文本存活的区间更宽。三个种子的样本量决定了这张表只能说明「没有证据表明联合建模更差」,不能说明「联合建模更鲁棒」。真正的硬收益是功能性的:没有状态流,目的地 CG 直接不可用(Table 2 里那三格 N/A)。
我的判断二:抗扰能力的绝对水平仍然不高。0.511 的抗推存活率意味着大约一半的推扰试验会触发终止判据,而这是 100–500 N、0.5 s 的水平推力,覆盖的正是人形机器人日常会遇到的干扰量级。论文用 similar 描述它与 DiffuseLoco 0.563 的关系是准确的,但读者容易把它读成「问题已解决」。同一张表里 CLoC+FK 两行的 0.303 / 0.296 与 PredActor w/o state 的 0.487 一起说明:这个量级的鲁棒性对整类方法都还是开放问题。
我的判断三:真机样本太小,无法归因失败。每组五次、无置信区间的描述性计数,加上 squat→stand 与两组推扰各失败一次,无法区分失败来自策略、场地、标定还是安全停机的保守阈值。论文没有回避这一点(明确写了「counts are descriptive」),但也意味着真机结论只能停在「可重复地完成这些转换」的强度上。
我的判断四:CLoC+FK 这条基线的弱势可能被复现接口放大。它是作者自己实现的 Diffuse-CLoC,并用前向运动学去估计原方法期望的特权状态输入。FK 重建必然引入误差,而那 101.682 的 jerk RMS 与 0.000 的到达率有多少来自原方法、有多少来自这个替代观测接口,从论文里分不出来。作者把命名与后缀都标清楚了(这是好习惯),但横向比较时仍需保留这层不确定性。
我的判断五:可复现性目前只到评测层。仓库放出了浏览器 MuJoCo 评测与 PDP051 检查点,这已经比多数人形控制论文走得远——可以直接看到策略在同一台仿真 plant 上的行为。但数据采集与标注、BC 训练、DAgger 聚合、机载部署四项都还在清单上未勾选,第三方现在无法复现训练配方(7600 episodes、三个种子、迭代聚合轮次)与真机部分,而后者恰恰是这篇论文最主要的贡献主张。
六、总结与展望
PredActor 的贡献可以按「表示 / 系统 / 部署」三层拆开看。表示层:它证明了内部预测状态可以同时充当 CG 的可微落点与 CFG 的语义载体,而这条状态轨迹不必离开策略、也不必变成某个跟踪器的参考——于是「生成器可能给出跟踪器做不到的动作」这个分层架构的老问题从根上消失了,因为根本不存在第二个模块。系统层:调度匹配的滚动去噪加上一组计算保持的运行时优化,把两步引导式联合扩散的完整回调压进 20 ms,输出漂移小于 $10^{-6}$ 量级。部署层:只用 96 维本体感受(含基座线速度)、29 个关节指令,在 Unitree G1 的 Jetson Orin NX 上跑 50 Hz,作者称这是联合状态—动作扩散策略的第一次整机载部署。
它同样清楚地划出了自己的边界:引导强度不能超出标定范围,文本只覆盖学到的语义类别,动作库不含持续多接触行为,计时结论绑定在特定导出与设备上。往这个方向看,下一步最有价值的不是把某个数字再推高一点,而是三件事——把引导做成受约束或自适应的(这样操舵强度就不会把去噪推出训练分布)、把语言—动作覆盖撑到组合式命令、以及把训练与部署代码补齐,让「整机载 50 Hz」这个主张可以被别人独立验证。
对做人形控制的工程团队,这篇论文最实用的部分可能不是那个联合扩散骨架,而是第 4.2 节那张加速表:它把「两步采样 + 滚动复用 + 五项不改变计算结果的运行时优化」这条组合拳的每一节收益都量了出来,并且诚实地标注了哪些行不可相加、哪个数字只在特定产物上成立。这套方法论对任何要在 Orin 级别算力上跑迭代式神经推理的机器人系统都可以直接搬。
金句
预测出来的未来状态不需要被执行,它只需要存在——存在成一个可微的接口,让测试时才给出的目标有地方落。PredActor 把这条轨迹关在策略内部,于是「操舵」与「直接执行动作」第一次不再是二选一:引导改的是状态,动作在下一个去噪步自己跟上,而 20 ms 之内下发给关节的始终只有一件事。