PAPER DEEP DIVE
D&A:解耦描述与评估,让视觉语言模型成为零样本机器人奖励模型
现有视觉语言模型在机器人奖励估计中容易受确认偏差影响,把失败轨迹误判为成功。D&A 将奖励预测拆成两个无共享上下文的阶段:描述器不看任务指令,客观叙述视频中的机器人行为;评估器先给出明确的任务成功标准,再依据标准为每一帧分配密集进度奖励。该方法无需机器人数据或微调,能够惩罚失败执行并保留成功过程中的部分进展;在多项基准以及真实机器人在线与离线强化学习中,性能可匹配或超过经过后训练的奖励模型。
论文元信息:Marius Memmel、Shawn Yin、Urvi Rutia、Angad Wadhwa 等;华盛顿大学与英伟达合作完成。论文链接:arXiv 2611.03622;项目页:weirdlabuw.github.io/dna;代码:memmelma/dna,许可证为 MIT,核验提交为 8f728ef。
一句话总结
论文把机器人奖励估计拆成“先客观描述整段视频,再按显式成功标准评分”两个阶段,在不训练机器人数据的情况下显著压低失败轨迹被误判为成功的概率。
研究背景与动机
机器人策略学习需要能够区分优劣动作的奖励。真实环境中获取稠密、可靠的人工奖励成本很高,因此研究者希望直接使用视觉语言模型从视频和自然语言指令中给出逐帧进度。理想信号应满足三个条件:未开始时接近零,任务完成时接近一,失败或倒退时不能继续上升。
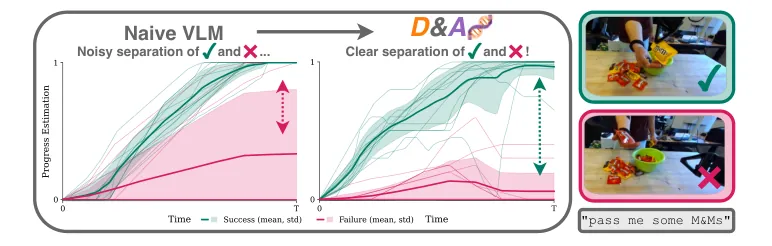
直接询问通用视觉语言模型却会出现确认偏差。模型看到“机器人正在完成任务”这样的指令后,容易把动作本身解释为进展,即使物体并未放到目标位置。论文图 1 展示了这种症状:失败轨迹也获得较高奖励,成功与失败的分布大量重叠,导致奖励无法指导策略改进。
另一类解法是在机器人数据上后训练专用奖励模型。RoboReward 与 Robometer 通过大规模数据学习进度或偏好,确实提高了分布内可靠性,但它们依赖带失败标注的机器人轨迹,而且每换一个基础模型都要重新训练。基础视觉语言模型快速升级时,这种绑定会变成持续成本。
已有零样本方案同样没有绕开偏差。GVL 通过打乱帧序进行相对排序,TOPReward 读取成功词元的概率,这些方法把“轨迹中是否出现像成功的局部画面”当成主要证据,缺少对整段行为的明确完成条件。论文的出发点是:先把“发生了什么”与“这是否算完成任务”分开,再让模型评分。
问题定义与方法框架
给定长度为 $T$ 的机器人视频 $o_{1:T}=\{o_1,o_2,\ldots,o_T\}$ 和自然语言指令 $l$,目标是输出逐帧奖励 $r_{1:T}$。每个奖励限制在 $[0,1]$,零表示没有进展,一表示完成。传统直接提示要求模型一次学习映射 $$ R:(o_{1:T},l)\mapsto r_{1:T}. $$ 这种端到端提示把场景识别、任务理解和评分压在同一次回答里,模型很容易顺着指令假定成功。
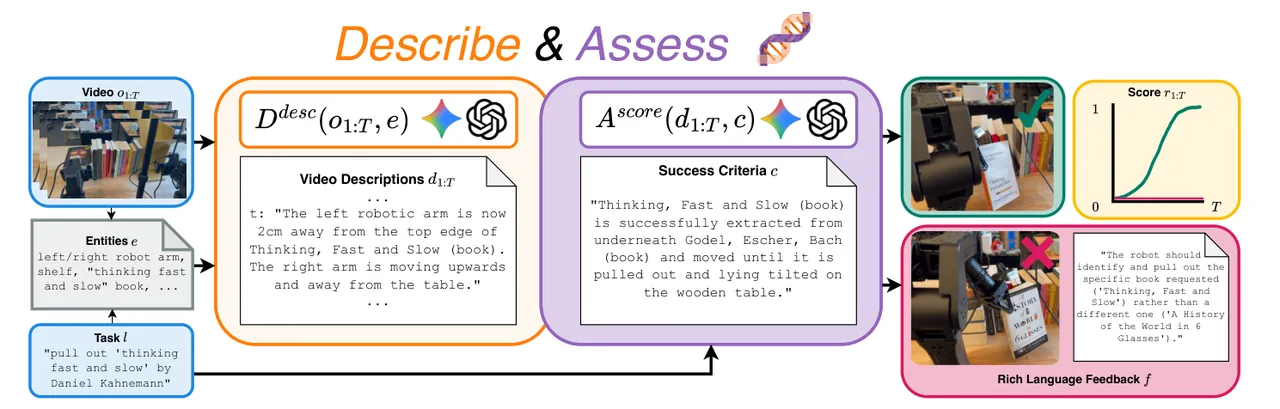
D&A 将奖励函数改写为描述器与评估器的复合: $$ R(o_{1:T},l)=A\bigl(l,D(o_{1:T})\bigr). $$ 描述器 $D$ 只负责把视频转成文本轨迹,评估器 $A$ 才接触任务指令。两个调用没有共享上下文,目的不是追求形式上的模块化,而是切断任务先验对视觉观察的提前污染。
具体执行时,描述器生成 $d_{1:T}$,评估器再由描述和指令产生奖励: $$ d_{1:T}=D(o_{1:T}),\qquad r_{1:T}=A(l,d_{1:T}). $$ 这一步把连续的视觉证据固定为可检查的语言证据。若评分异常,开发者能够回看描述,判断是机器人确实完成失败,还是描述阶段漏掉了目标物体。
为了控制调用成本,系统并不直接把全部 $T$ 帧送入模型,而是先线性抽取 $H$ 个关键帧。论文常用 $H=8$,满足 $H\ll T$;得到关键帧奖励后再线性插值回原始长度。这个近似是用时间分辨率换成本,并不改变奖励的绝对完成语义。
flowchart TB
    V[Full robot video] --> S[Sample H key frames]
    I[Language instruction] --> E[Entity extractor]
    S --> E
    E --> O[All observed objects]
    S --> D[Grounded describer]
    O --> D
    D --> X[Per-frame text description]
    I --> C[Generate explicit success criterion]
    X --> C
    C --> A[Assessor]
    X --> A
    A --> R[Rewards in 0 to 1]
    A --> F[Failure analysis and corrective feedback]
    R --> P[Online RL or offline advantage]
    F --> G[Next planning attempt]
图 1:依据论文图 3 重绘的方法流程。实体提取器可以看到指令,但交给描述器的是完整物体集合;评估器则显式生成成功条件后再评分。
方法详解
1. 为什么要描述整段轨迹
一些奖励模型按时间前缀分别计算 $r_t=R(o_{1:t},l)$,每个时刻只观察过去。D&A 则一次看完整个视频再描述。整段上下文可以区分“物体暂时经过目标位置”和“物体最终被稳定放置”,也能识别先完成再破坏的倒退过程。论文强调奖励不必单调,因此模型允许后一帧低于前一帧。
这种整体描述不是简单增加输入帧数。它让描述器知道动作的后续结果,从而用相同措辞追踪物体状态。对于长轨迹,这种做法仍然受模型上下文限制,但至少把时间一致性从评分阶段前置到了观察阶段。
2. 实体接地但不泄露任务相关性
完全隐藏指令虽然减少确认偏差,却会让描述器忽略对任务关键的细小物体。例如目标是一本特定书时,“桌上有一本书”不足以支持后续判断。论文加入实体提取器 $E$,它同时读取指令和视频,输出画面中的所有对象,再把完整集合交给描述器: $$ d_{1:T}=D_{\mathrm{desc}}\bigl(o_{1:T},E(o_{1:T},l)\bigr). $$ 描述器看到“橙色书脊的书”这类具体指代,却不知道哪本书是任务目标。
这个设计让描述粒度与指令对齐,同时避免直接告诉描述器“应该完成什么”。它不是严格的信息隔离:实体提取器已经看过指令,可能选择更有利于任务对象的称谓。论文将其称为对指令有效盲视,而不是密码学意义上的信息隔离。
3. 先写成功标准再评分
指令通常描述动作目标,但没有定义可观察的完成状态。“把杯子放到桌上”可能包含杯子已接触桌面、机械臂已释放、杯子仍保持直立等条件。若评估器直接在指令和描述之间猜一个分数,部分完成与失败之间的边界仍然模糊。
因此评估器先生成自然语言成功条件 $c$,再把它作为评分依据: $$ r_{1:T}=A_{\mathrm{score}}\bigl(d_{1:T},C(l,d_{1:T})\bigr). $$ 这时问题从“像不像在执行指令”变成“当前描述满足完成条件的程度是多少”。实践上,成功条件生成与逐帧评分在同一个评估调用内完成,提示词要求模型先写出完整完成状态,再针对每个时间点打分。
这一改动提供绝对锚点。相对排序模型只能知道一段视频比另一段更像成功,若整批视频都失败,最高分轨迹仍会被抬高。显式条件允许模型对全部缺失目标物体的视频给出零分,也能对成功前的中间状态分配部分奖励。
4. 失败解释与纠正反馈
标量奖励告诉策略“这一动作不够好”,却不说明原因。D&A 的反馈变体增加失败分析 $F$: $$ A(l,d_{1:T})=A_{\mathrm{score}}\bigl(d_{1:T},C(l,d_{1:T}),F(l,d_{1:T})\bigr). $$ 当任务未完成时,模型同时输出失败描述和可执行建议,例如目标物体被拿错、夹爪没有闭合、放置位置偏离。反馈会进入下一次代码策略规划,使系统能够跨尝试积累纠正信息。
反馈没有改变奖励的数值边界,而是利用同一套成功标准提供可读诊断。它的价值在论文的 LIBERO 实验中单独验证:仅保留代码历史时成功率为 40.6%,加入 D&A 反馈后达到 51.4%。
5. 奖励如何进入策略学习
在线强化学习直接把 $r_t$ 当作稠密环境奖励,论文使用 DSRL 在冻结的视觉语言动作策略潜空间上优化。评估器若能区分拿香蕉与拿冰淇淋的错误行为,策略才会获得朝正确对象移动的梯度。
离线数据没有真实奖励时,D&A 先把进度分数当作全局势函数,再用动作块大小 $C$ 构造优势。一种常用形式是 $$ A_t=r_{\min(t+C,T)}-r_t. $$ 它比较一个动作块执行前后的完成度,正值表示块内推进任务,负值表示没有变化或倒退。优势可用于筛选高质量块,也可作为策略条件。
论文还讨论了更细的时序形式。用相邻奖励差分 $$ \tilde r_t=r_t-r_{t-1} $$ 表示局部进展,再累积折扣进展 $$ G_t=\sum_{k=t}^{T}\gamma^{k-t}\tilde r_k. $$ 它与价值基线组合得到优势 $A(s_t,a_t)=G_t-V$。这些构造本质上是把语言奖励转成策略优化可使用的回报,而不是把语言模型直接当成策略。
6. 代码实现映射
官方实现把三种方法封装为统一接口:dna 先接地、再描述、再评分;dna_feedback 在评分时附上失败与建议;naive 直接让视频生成进度。下列源码来自 dna/classes/main.py:21-53,能够与方法章节的调用次数对应。
_METHOD_ALIASES = {
    "dna": "dna",
    "video_grounded_hierarchy_single": "dna",
    "dna_feedback": "dna_feedback",
    "video_grounded_hierarchy_failure": "dna_feedback",
    "naive": "naive",
    "video_endtoend_single": "naive",
}
完整流程在 dna/classes/main.py:192-247。代码先调用 get_description_from_video_grounded 得到描述,然后根据模式选择普通评分或带反馈评分;输出的进度最后除以一百并检查长度。
description_raw = await get_description_from_video_grounded(
    frames, task, model_id=self.model,
    thinking_level=self.thinking
)
description = {i: d["description"]
               for i, d in enumerate(description_raw)}

if self.method == "dna_feedback":
    results = await get_progress_from_description_failure(
        description, task, model_id=self.model,
        thinking_level=self.thinking
    )
else:
    results = await get_progress_from_description(
        description, task, model_id=self.model,
        thinking_level=self.thinking
)源码中的提示词还落实了论文的关键约束。dna/functions/description.py:64-146 要求描述器不得判断机器人意图,只客观描述机器人与物体状态;dna/functions/progress.py:10-87 明确规定指令文本决定哪些对象计数,描述是环境证据的唯一来源,禁止把不同物体改名成任务对象。
实验设置与主要结果
论文构造了 D&A-Bench:14 个 YAM 双臂任务、54 条成功或失败轨迹、每个任务 10 种同义指令。论文正文与摘要强调共 540 个视频指令对;附录另有一处按“14×4×10”写成 560 的说明,但实际轨迹数是 54,条数与正文一致的计算结果应为 540。本文采用可复核的 540。
评估使用最终步奖励排序的 Kendall $\tau_\alpha$,取值范围为 $[-1,1]$,越高表示模型越能把成功、次优和失败轨迹排对。外部集合 RBM-EVAL-OOD 检验分布外泛化,RoboRewardBenchmark 则用离散进度标签计算平均绝对误差,越低越好。
| 基准 | 模型 | 指标 | 数值 |
|---|---|---|---|
| D&A-Bench | D&A + Gemini 3 Flash | Kendall τ(表中 0.672) | 0.67 |
| D&A-Bench | Robometer | Kendall τ | 0.56 |
| D&A-Bench | RoboReward | Kendall τ | 0.43 |
| D&A-Bench | GVL / TOPReward | Kendall τ | 0.27 / 0.24 |
| D&A-Bench | D&A + GPT-6 Astra | Kendall τ | 0.790 |
| RBM-EVAL-OOD | D&A + Gemini 3 Flash | Kendall τ | 0.626 |
| RBM-EVAL-OOD | Robometer | Kendall τ | 0.648 |
表 1 显示,D&A 在自建集合上以 0.67 超过后训练的 Robometer 0.56 与 RoboReward 0.43。这个结果的说服力不在于领先幅度本身,而在于同一提示框架没有见过这 14 个任务。外部集合中 Gemini 3 Flash 版本为 0.626,略低于 Robometer 的 0.648;换成 Gemini 4 Argon 后达到 0.734,说明基础模型能力与提示结构需要一起看。
| 模型 | RoboRewardBenchmark MAE ↓ | 说明 |
|---|---|---|
| 直接提示 | 0.92 | 无显式描述与成功标准 |
| GVL | 1.34 | 帧序相对排序 |
| TOPReward | 1.80 | 成功词元概率提取 |
| RoboReward-4B | 0.85 | 机器人数据后训练 |
| Robometer | 0.75 | 机器人数据后训练 |
| D&A | 0.70 | 零样本提示框架 |
表 2 的误差结果更直接。D&A 的平均绝对误差为 0.70,低于 Robometer 的 0.75 和 RoboReward-4B 的 0.85,也远低于直接提示的 0.92。这里需要保留一个审慎判断:D&A 不需要机器人训练数据,但它使用前沿闭源模型,成本与可获得性不能省略。
这一案例揭示了描述阶段为何必要。像素差分和局部运动都是强视觉信号,但它们回答的是“画面变化多少”,不是“目标状态实现了多少”。D&A 通过先描述“机器人把衬衫折叠并放到何处”,再让评估器核对“衬衫应被展开”,把错误从数值评分中显式暴露出来。
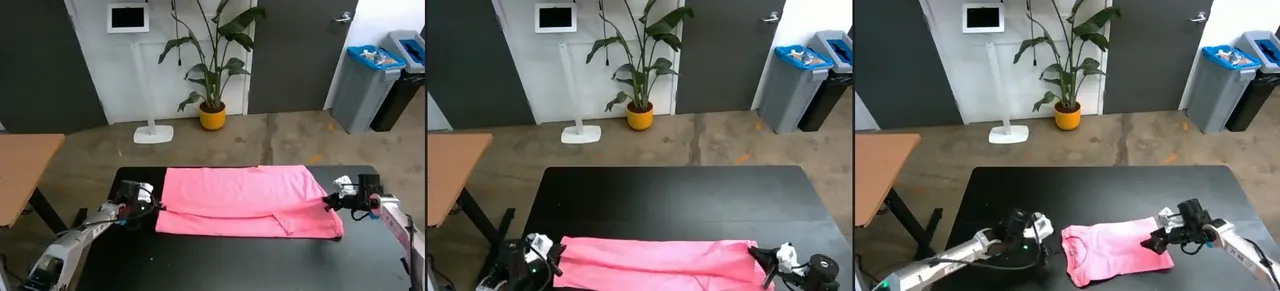
从开发角度看,这个流水线比单个奖励分数更容易调试。若成功视频得分很低,可以先检查描述是否遗漏状态;若失败视频得分很高,可以检查成功条件是否含糊。代价是描述与评估之间存在信息瓶颈,无法写进自然语言的空间关系也会丢失。
真实机器人策略学习
在线实验中,基础 $\pi_0$ 策略在 DROID 厨房场景执行“把水果放进碗里”,最初成功率只有 10%。失败模式是反复抓冰淇淋筒,而任务要求拿香蕉。TOPReward 给两类抓取都较高奖励,训练后成功率停在 5%;D&A 对错误物体给低分,对正确轨迹给稠密奖励,约 90 分钟后达到 100%。
这组结果说明奖励模型需要具备物体身份与指令对应能力。若只判断“机械臂是否抓到某物”,冰淇淋与香蕉都像有效动作;只有把指令中的目标实体与描述中的具体物体对齐,错误抓取才会被压低。
离线实验使用双臂 YAM 收集 50 条最优、50 条次优和 50 条失败轨迹。直接行为克隆的成功率为 20%,会复制次优行为。D&A 计算动作块优势、筛选数据并条件化 $\pi_{0.5}$,相对行为克隆提高 80%。在另一项“取出特定书并放到桌上”的优势筛选中,D&A 训练的策略成功时平均耗时 18.8 秒,标准差 1.8 秒;基线为 28.5 秒,标准差 9.2 秒。
18.8 秒与 28.5 秒的差异不仅是速度,还体现方差从 9.2 秒降到 1.8 秒。对部署策略而言,稳定完成比偶尔快速更实用。该证据支持“奖励排名可用于筛选动作块”,但没有证明所有长时任务都能仅靠语言描述完成细粒度控制。
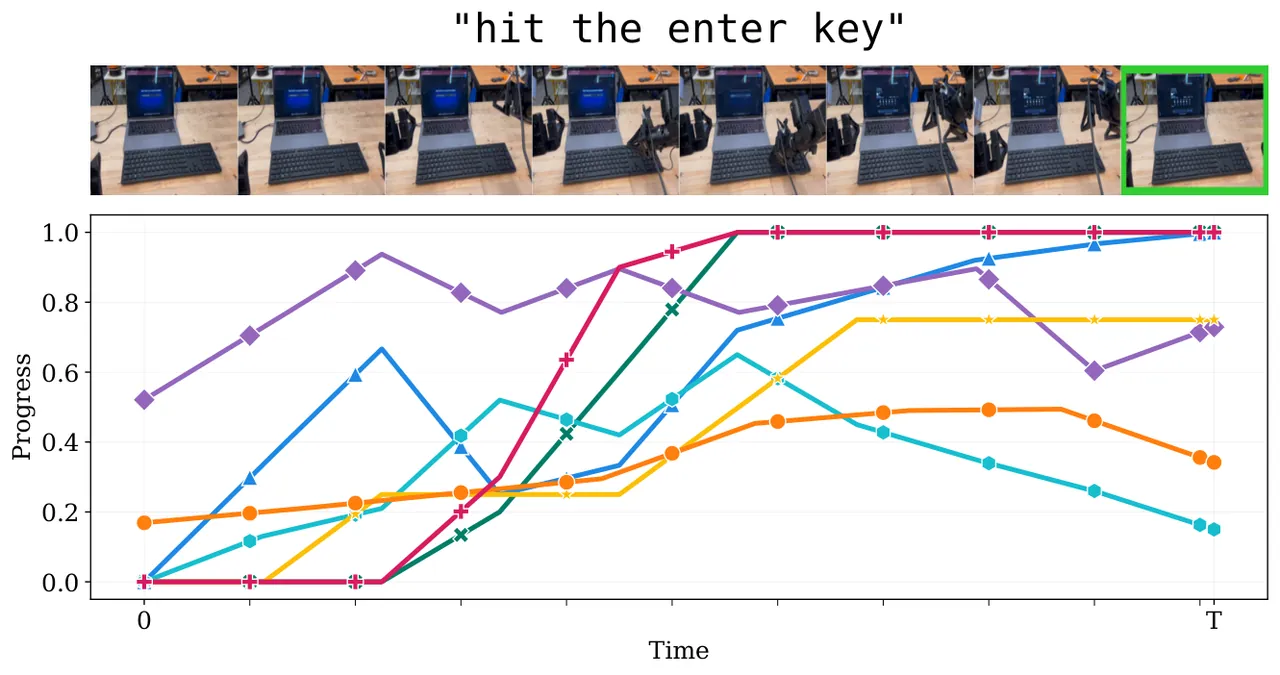
模型缩放实验显示,方法并非只对某一个接口有效。Gemini 2.5 Flash 从直接提示的 0.280 提升到低推理档 D&A 的 0.418;Gemini 3.5 Flash 从 0.499 提升到 0.609;Gemini 3.1 Pro 的中推理档从 0.515 提升到 0.620。减少推理强度有时反而提高分数,说明收益主要来自任务分解,而不是无限增加测试时计算。
消融与反馈实验
RBM-EVAL-OOD 上的消融结果清楚显示了组件关系。仅给直接提示加入成功标准,得分从 0.486 升到 0.561;仅做描述与评估解耦而不接地,反而降到 0.343,因为描述可能漏掉任务相关物体;解耦加实体接地回升到 0.546;完整方法达到 0.626。也就是说,“解耦”必须和“接地”一起使用。
这是论文最有技术含量的负面结果之一。它说明把流程拆成两个模型调用并不会自动减少偏差,信息瓶颈可能让结果更差。有效设计是保留任务相关物体的精细命名,同时不让描述器知道评分目标。
成本方面,Gemini 3.1 Pro 每条轨迹平均花费 0.035 美元、23.7 秒、7358 个词元;Gemini 3.5 Flash 为 0.039 美元、25.9 秒、8842 个词元;Gemini 2.5 Pro 为 0.060 美元、58.0 秒、10843 个词元;Gemini 2.5 Flash 为 0.015 美元、36.9 秒、11177 个词元。成本、时延和词元数没有单调对应,选择模型不能只看价格。
讨论与适用边界
D&A 的核心贡献是把奖励模型的失败模式从“分数看起来不对”转化为可诊断的语言中间量。它适合任务成功能够用语言描述、目标实体能在画面中辨认的抓取、放置、整理和多步骤操作任务。对于需要毫米级位置、连续力控或高速接触判断的任务,自然语言瓶颈会直接限制奖励精度。
该方法也适合作为策略学习前的数据筛选器。先用奖励排序找出数据集中更接近成功的动作块,再用较强的优势条件微调,能够避免把所有次优轨迹都当成正面示范。论文在双臂长时任务上的结果支持这一路线,但每个新环境仍需检查奖励是否与真实成功一致。
从系统设计看,描述器、实体提取器和评估器都是独立调用,失败可以重试,也可以替换基础模型。代码中的 _sample_once 会检查进度长度,失败时重试,并在输出后除以 100;这比直接把模型返回当成可信奖励更稳健。不过重试只能处理格式错误,不能消除语义错误。
局限性
作者明确承认,D&A 继承前沿模型的推理时延、词元成本和上下文窗口限制。闭源接口还带来随机性与有限控制,同样的视频在不同调用中可能得到不同描述。语义幻觉一旦进入描述,评估器会把错误文本当成事实,后续成功标准再清晰也无法完全补救。
作者还指出,奖励粒度受自然语言描述限制。精确空间关系、绝对几何距离和连续接触力很难稳定写进句子。本文的独立判断是,实体提取器看了指令但没有把任务相关对象集合传给描述器,仍可能存在弱标签泄漏;这种泄漏可能通过物体命名粒度影响描述。此外,Gemini 4 Argon 在 RBM-EVAL-OOD 的异常高位可能包含训练数据重叠,跨模型比较不能只看一个分数。
结论
D&A 没有训练新的机器人奖励网络,而是重新组织视觉语言模型的推理顺序。它先让模型描述实际发生的轨迹,再让模型写出完成条件并评分,最后把绝对进度转成在线奖励或离线优势。这个设计在自建与外部基准、真实在线强化学习、离线优势条件化和代码策略反馈上都得到验证。
更重要的结论是,零样本奖励模型的瓶颈不只在基础模型能力,还在任务信息进入视觉判断的方式。把“看见什么”和“要求什么”分开,使失败轨迹有机会被低分惩罚,也让奖励具备了可检查的中间证据。后续工作若要突破精度上限,需要让语言描述接入空间、几何和力觉信号,而不是继续堆叠单一的文本评分提示。
奖励模型首先要如实看见失败,才有资格判断成功。