PAPER DEEP DIVE
PaperBanana-Interact:多轮人类反馈下的科研示意图精修
科研示意图很难一轮画到位:14 人用户研究里所有参与者在看到初稿后都要求继续修改,86% 认为精修后的图更令人满意。这项工作把 292 张专家手绘示意图上的 3518 条隐藏修改需求做成多轮基准 MTPaperBananaBench,并提出 PaperBanana-Interact:历史摘要器把多轮图文交互压成结构化记忆,多目标批评家与提示词精修器在每轮用户反馈下自我迭代至多 10 次。同一个单轮生成器 PaperBanana 起点质量分 50.3,配最强基线 DirectRefine 五轮后是 47.1、遗忘率 18.8%,换成 Interact 则是 61.2 与 12.6%。
论文元信息
标题:PaperBanana-Interact: Scientific Diagram Refinement with Multi-Turn Human Feedback(PaperBanana-Interact:用多轮人类反馈精修科研示意图)
作者:Xueqing Wu、Ashwin Balasubramanian、Bingxuan Li、Dawei Zhu、Kai-Wei Chang、Yale Song、Yiwen Song、Rui Meng、Tomas Pfister、Nanyun Peng(UCLA、Google、北京大学、UIUC)
链接:arXiv:2608.30241(v1,2026-08-31,cs.CL / cs.CV)· 项目主页 · 代码仓库 · MTPaperBananaBench 数据集 · 在线演示
代码状态:已开源,Apache License 2.0,源文件头署 Copyright 2026 Google LLC。仓库给了两条入口:app.py 是 Gradio 交互演示(自带 Gemini API key 即可跑),main_multiturn.py 是基准评测主程序,复现本文主结果的命令就是 python main_multiturn.py --refiner pb_interact --refiner_internal_critic_rounds 10。agents/ 下除了本文提出的三种 refiner(pb_interact.py、pb_directrefine.py、generative_refiner.py),还带了上一代 PaperBanana 的 planner / retriever / stylist / polish / visualizer 全套智能体,负责生成第一版草图。
一句话总结:科研配图从来不是「一次生成就完事」,这篇论文把 292 张专家手绘图上的 3518 条隐藏偏好做成一个多轮基准,用会摘要历史、会分目标打分的智能体内循环把图越改越好——质量分从 50.3 提到 61.2,遗忘率从 18.8% 压到 12.6%。
研究背景与动机
把论文方法段自动画成示意图,这条线最近一年跑得很快:AutoFigure 用代码起草再让生成模型润色,Crafter 与 PaperBanana 直接让多模态模型出终图、只用大语言模型优化提示词。但所有这些系统都停在单轮:给一段方法描述加一句图注,产出一张图,结束。作者先做了一件事——问 14 位有学术写作与科研配图经验的研究者,这个假设到底成不成立。
结果是彻底的否定。14 人全部在看到第一版草图之后要求继续改,12 人(86%)给改完的图打了更高的满意度分,平均分从 3.2 涨到 4.2,单人涨幅在 0.5 到 2 分之间。更关键的一个数字来自访谈:9 位参与者说,是那张草图本身塑造甚至改变了他们对「这张图该长什么样」的想法;64% 的会话里,修改要求是在看到初稿或某个中间版本之后才冒出来的。也就是说,用户偏好不是一份可以事先写完的需求文档,它是在交互过程中逐步显形的。
访谈同时暴露了当时基线系统 PaperBanana-DirectRefine 的三类反复出现的毛病:事实忠实度下降(29% 的会话)、美观度变差(43%)、之前已经改好的地方又被改回去(29%)。第三条尤其刺眼——它不是「没听懂这次的要求」,而是「听懂了这次的要求,顺手毁掉了上次的成果」。作者后来在基准上把这两种失败模式量化成了两个术语:质量漂移(quality drift)与遗忘(forgetting)。
为什么单轮能力很强的模型在多轮里会崩?论文的失效分析给了一条清晰的因果链。用生成模型直接改图时,每一轮都是一次完整的重绘,模型没有「哪些部分不该动」的显式约束,五轮下来画面结构被反复重排,质量分从 50.3 一路掉到 19.0。用智能体改写提示词再渲染时,情况好一些(50.3 掉到 47.1),但漂移换了个形态:用户的新要求被生硬地塞进版面,留下大片空白和不平衡的布局,风格也会莫名其妙地跑偏。两条路都缺同一个东西——一份跨轮的、能被后续每一步查阅的约束账本。
这些基线在单轮上并不差:DirectRefine 的当轮需求满足率有 68.6%,NanoBananaPro 有 56.2%。所以问题不在「听不听得懂一句话」,而在多轮状态管理。这也解释了为什么最终的总需求满足率会远低于当轮满足率——GPT-Image-2 当轮 67.4% 而总分只有 52.9%,Crafter 配 NanoBananaPro 当轮 56.2% 总分却只有 39.4%。差掉的那一截,就是被后面的轮次抹掉的。
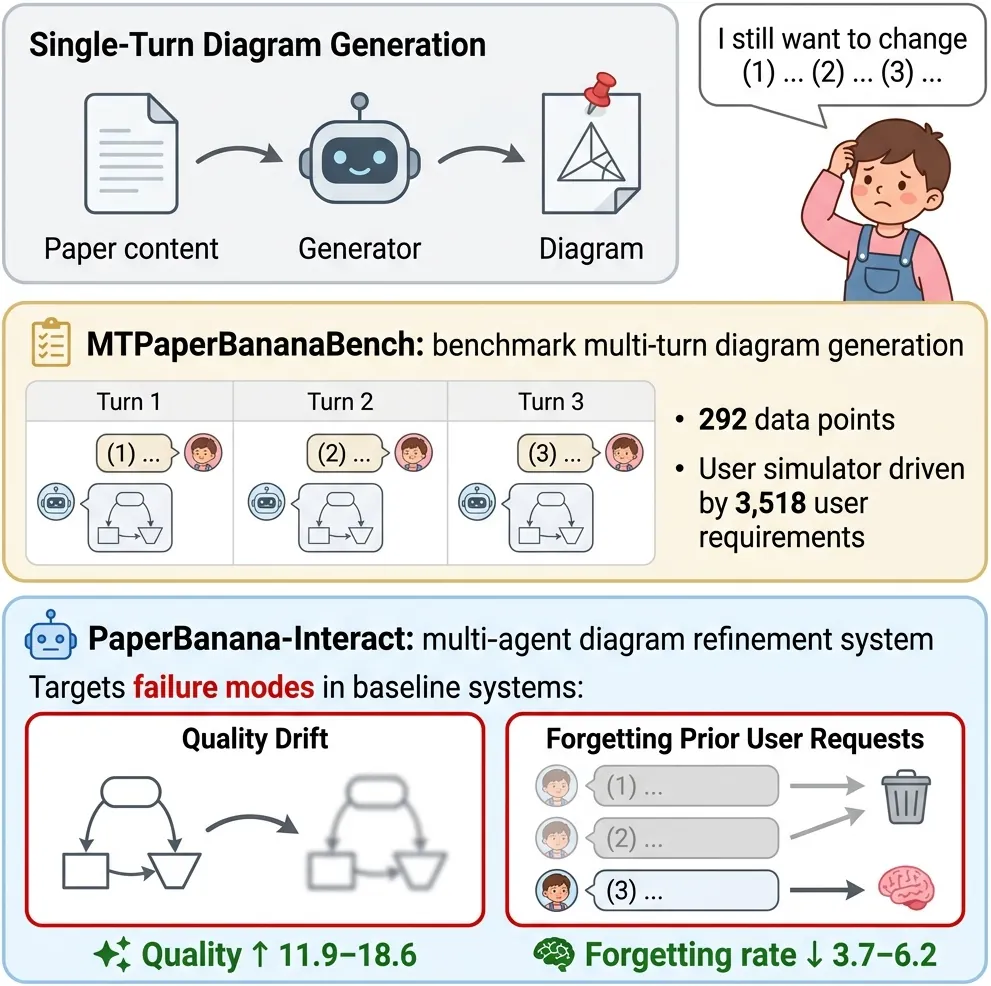
图 1(论文 teaser):生成器很难一轮满足作者的视觉偏好,因此需要带人类反馈的多轮精修。论文用 MTPaperBananaBench 度量这件事,并用 PaperBanana-Interact 压住基线系统的两种典型失败。这张图本身就是 PaperBanana-Interact 画的。
任务形式化与基准构造
单轮任务是从源上下文 $x_{0}$(论文内容加一句说明该图范围与重点的沟通意图)生成示意图 $I_{0}$。多轮版本在第 $t\geq 1$ 轮收到用户的自然语言反馈 $x_{t}$,要求生成 $I_{t}$,条件是整个交互历史 $[\mathbf{I}_{<t},\mathbf{x}_{\leq t}]$,其中 $\mathbf{x}_{\leq t}=[x_{0},\ldots,x_{t}]$,$\mathbf{I}_{<t}=[I_{0},\ldots,I_{t-1}]$。这个形式化本身没什么花头,但它把「历史是一串图而不是一串文本」这件事摆到了台面上——后面所有的设计取舍都从这里长出来。
要评测这个任务,先得有多轮交互数据,而真实人机交互既贵又无法在不同评测轮次之间保持标准一致。作者的选择是造一个用户模拟器,驱动它的是一批事先标好、对生成系统隐藏的偏好需求。基准最终包含 292 张图、3518 条需求,平均每张图约 12 条。
标注方式有个聪明的地方:不是让人凭想象编「用户可能会提什么要求」,而是拿原作者亲手画的参考图 $I_{H}$ 当证据,把它体现出来的设计决策反推成需求条目。流程是两段式——先用 Gemini-3.1-Pro 生成候选需求并打上分类标签,再由三名人工标注者独立复核。复核动了多少?删掉 0.5%,改写 24.7%,也就是每四条候选里就有一条需要人工修正。207 条子集上的标注者间一致性 Cohen's $\kappa=0.767$。为了防止图注泄露隐藏需求,作者还用 Gemini-3.1-Pro 把每条图注改写精简,去掉与已标注需求重复的内容;标注过程中另用 Gemini-3.1-Pro 与 Claude-Opus-4.8 各自独立核查每条需求的忠实度与分类标签,两个模型意见不一致的一律标记出来重点复查。
需求被组织在一个三乘三的分类体系里:语义类别分内容、组织、视觉表现,影响严重度分关键、沟通、风格。标注者被明确要求在三类语义上大致均衡,并覆盖全部三个严重度等级。这个设计让后面的失效分析可以按类别拆解——比如能看出 DirectRefine 的漂移主要伤在简洁性与可读性两维上。
| 维度 | 取值 | 含义(论文附录 B) |
|---|---|---|
| 语义类别 | Content 内容 | 图里出现哪些信息、省略哪些、展示哪些函数关系、数学细节到什么粒度 |
| Organization 组织 | 信息在空间上如何排布、排序与分组 | |
| Visual representation 视觉表现 | 视觉编码、样式、隐喻与整体审美处理 | |
| 影响严重度 | Critical 关键 | 违反后图在科学、数学或结构上就是错的 |
| Communicative 沟通 | 技术上仍正确,但图变得混乱、信息过载或容易被误读 | |
| Stylistic 风格 | 既不影响正确性也不影响理解,只是美观度与专业感下降 |
表 1:MTPaperBananaBench 的需求分类体系(3 类语义 × 3 级严重度)。
用户模拟器的运转方式是这样:需求列表 $R=[r_{1},\ldots,r_{N}]$ 全部隐藏,第 $t$ 轮由 LLM 裁判 $\mathcal{E}$ 逐条判断当前图 $I_{t-1}$ 是否满足,得到失败集合 $F_{t-1}$。若非空,就按预先固定好的顺序取前 $k$ 条($k$ 是超参,论文报 $k=1$ 与 $k=3$ 两档),再让视觉语言模型把它们写成一句自然的用户话 $x_{t}$。为了让模拟更像真人抱怨,评测器给出的「为什么这条没满足」的理由也一并喂给模拟器。$F_{t-1}=\varnothing$ 或触到轮次预算 $T_{\max}=5$ 就停。需求列表的顺序在标注完成后随机置换一次并固定,避免评测顺序偏置。
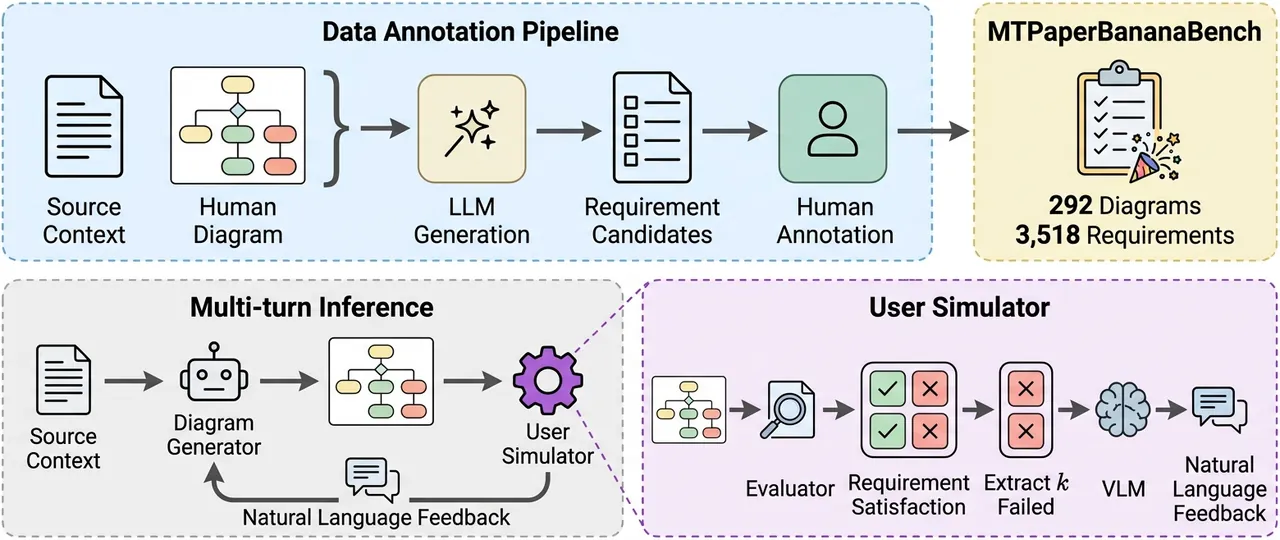
图 2(论文图 3):上半是标注流水线(LLM 出候选 + 人工复核),下半是推理时的用户模拟器——每轮拿全部需求逐条评当前图,抽出 $k$ 条失败的写成自然语言反馈。
方法:两条基线与 PaperBanana-Interact
基线一:生成模型当 refiner。最省事的做法是把上一轮的图和到目前为止的全部用户话一起丢给图像生成模型 $\mathcal{V}$,让它重画:
$$I_{t}=\mathcal{V}(I_{t-1},\mathbf{x}_{\leq t}).$$
这条路的问题在实验里非常直白:NanoBananaPro 在 PaperBanana 的草图上迭代五轮,质量分从 50.3 掉到 19.0;换成 Crafter 的草图更惨,35.4 掉到 2.9。每一次「重画」都是一次没有约束的重新排版,累积五轮之后原图的设计意图基本被洗掉了。
基线二:PaperBanana-DirectRefine。智能体系统的通行做法是维护一份详细的图像生成提示词 $P$,由智能体流水线 $\mathcal{A}$ 产出,再交给可视化器 $\mathcal{V}$ 渲染。首轮是 $P_{0}=\mathcal{A}(x_{0})$,$I_{0}=\mathcal{V}(P_{0})$。多轮版本把改写提示词的部分抽成 $\mathcal{A}_{r}$:
$$P_{t}=\mathcal{A}_{r}(P_{t-1},\mathbf{I}_{<t},\mathbf{x}_{\leq t}),\quad I_{t}=\mathcal{V}(P_{t}).$$
作者把 $\mathcal{A}_{r}$ 实例化成对视觉语言模型 $\mathcal{M}_{\text{vlm}}$ 的一次直接提示:为了控制算力与长上下文退化,用户话给全量,但图像与提示词只给最近一轮。
$$P_{t}=\mathcal{M}_{\text{vlm}}(I_{t-1},P_{t-1},\mathbf{x}_{\leq t}).$$
这个取舍很关键:模型看不到历史图,就只能靠文字去猜「之前那些改动长什么样」,于是先前已经满足的要求在后续改写中被顺手覆盖——这就是遗忘的机制来源。它的质量保持确实比重画好得多(50.3 到 47.1),但遗忘率 18.8% 与当轮满足率 68.6% 之间的落差说明它管不住跨轮状态。
PaperBanana-Interact 的第一块:摘要器 $\mathcal{S}$。既然让每个智能体各自去啃多图历史既贵又容易分心,那就先压一次。摘要器把交互历史蒸馏成一份文本记忆,供后续所有智能体共享:
$$M_{t}=\mathcal{S}(\mathbf{I}_{<t},\mathbf{x}_{\leq t}).$$
$M_{t}$ 记的不是泛泛的对话摘要,而是三件具体的事:每张图画了什么、相对上一版改了哪些地方、这些改动是否落实了当轮用户的要求。论文的理由也很实在——相邻版本的图视觉上高度冗余,本来就该压。
第二块:批评家—精修器内循环。第 $t$ 轮从上一轮的图和提示词起步,即 $I_{t}^{(0)}=I_{t-1}$,$P_{t}^{(0)}=P_{t-1}$。第 $\tau$ 次迭代里,批评家 $\mathcal{C}$ 看着当前版本挑毛病:
$$c_{t}^{(\tau)}=\mathcal{C}(I_{t}^{(\tau-1)},\mathbf{x}_{\leq t},M_{t}).$$
如果批评家认为还要改,精修器 $\mathcal{R}$ 拿着这份批评去更新提示词:
$$P_{t}^{(\tau)}=\mathcal{R}(I_{t}^{(\tau-1)},P_{t}^{(\tau-1)},c_{t}^{(\tau)},\mathbf{x}_{\leq t},M_{t}).$$
可视化器再把它渲染成新图 $I_{t}^{(\tau)}=\mathcal{V}(P_{t}^{(\tau)})$,送回批评家。循环在批评家判定无需再改、或触到迭代预算 $\tau_{\max}=10$ 时终止。这里有两个时间尺度:外层是用户轮次 $t$(最多 5 轮),内层是同一句反馈下的自我迭代 $\tau$(最多 10 次)。用户只说一句话,系统可以在背后改十版。
第三块:多目标批评家。这是全文最核心的设计,也是消融里唯一能同时拉动四项指标的部件。批评家不是给一句总体评价,而是被要求输出结构化 JSON,对每一路约束各写一条批评:当前这轮的用户请求、此前每一轮的用户请求、对源上下文(方法段与图注)的忠实度、以及整体呈现质量(布局、可读性、图例)。「此前每一轮请求各占一个字段」这一条,正对着遗忘这个失败模式——新改动想悄悄牺牲旧改动,得先在批评家的账本上留下一行。
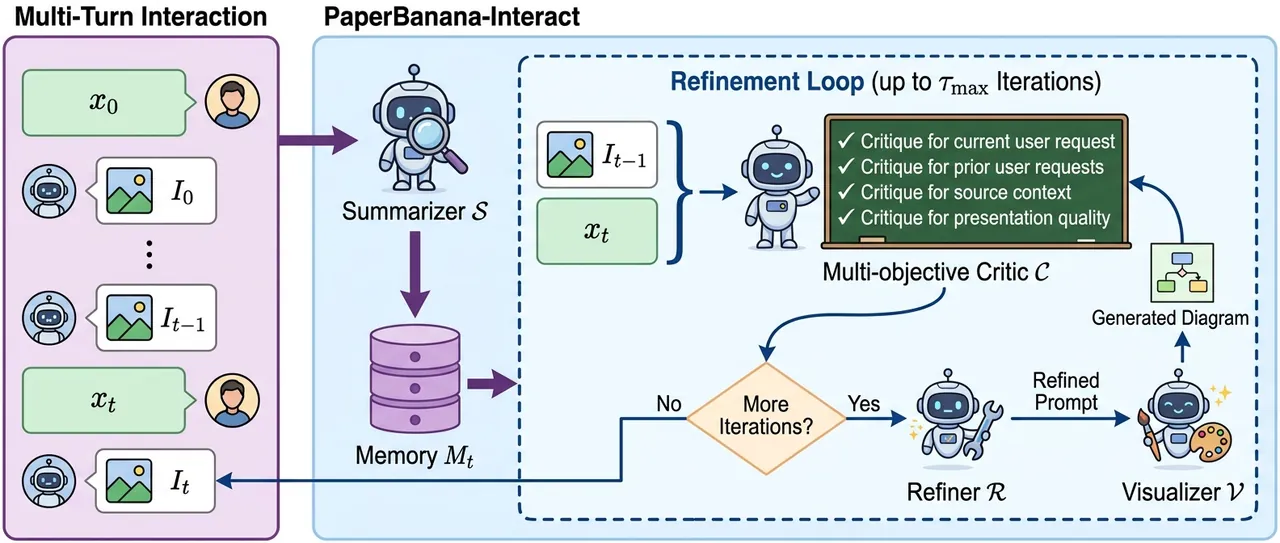
图 3(论文图 4):方法总览。摘要器先把多图历史压成紧凑记忆,随后进入精修循环——多目标批评家按不同约束逐路评估当前图,据此指导提示词更新与重新渲染。
flowchart TD
  SIM["用户模拟器
逐条评当前图 抽出前 k 条未满足需求"] --> UT["本轮反馈 x_t"]
  UT --> SUM["摘要器 S
把多图历史压成文本记忆 M_t
每图画了什么 改了什么 是否落实"]
  SUM --> CRIT["多目标批评家 C
输出结构化 JSON"]
  CRIT --> K1["当前这轮请求"]
  CRIT --> K2["此前每一轮请求 各一条"]
  CRIT --> K3["对方法段与图注的忠实度"]
  CRIT --> K4["呈现质量 布局 图例"]
  K1 --> GATE{"还需要改吗"}
  K2 --> GATE
  K3 --> GATE
  K4 --> GATE
  GATE -->|不需要| KEEP["保留当前图 本轮结束"]
  GATE -->|需要| REF["精修器 R
改写图像生成提示词 P_t"]
  REF --> VIS["可视化器 V
渲染新图 I_t"]
  VIS --> BUD{"达到 tau_max = 10"}
  BUD -->|否| CRIT
  BUD -->|是| KEEP
  KEEP --> NEXT["进入下一轮 t+1
记忆随历史一起更新"]
  NEXT --> SIM
图 4:PaperBanana-Interact 的双层循环。外层是用户轮次(最多 $T_{\max}=5$ 轮),内层是同一句反馈下的批评—精修—渲染迭代(最多 $\tau_{\max}=10$ 次),批评家判定无需再改就提前收敛。
评测指标到底怎么算
总需求满足率 Req 是把全部 $N$ 条需求在最终图 $I_{T}$ 上的二元判定取平均,$\text{Req}=\frac{1}{N}\sum_{i=1}^{N}\mathbf{1}[\mathcal{E}(r_{i},I_{T})=\text{satisfied}]$。当轮满足率 $\text{Req}^{\text{pt}}$ 只看「本轮新提出的那些需求在本轮是否被满足」,用来剥离单轮指令跟随能力;遗忘率 Forget@any 按(轮次,样本,需求)三元组池化统计:
$$\text{Forget@any}=\frac{\sum_{t=1}^{T-1}\sum_{dp}\mathbf{1}[\,r\ \text{在}\ t\ \text{轮被提出且已满足}\ \wedge\ \text{此后某次真实修改后变为未满足}\,]}{\sum_{t=1}^{T-1}\sum_{dp}\mathbf{1}[\,r\ \text{在}\ t\ \text{轮被提出且已满足}\ \wedge\ \text{此后存在真实修改}\,]}.$$
分母那个「此后存在真实修改」的条件不是可有可无的:如果后面所有轮次都因为需求全满足而提前停了,就根本没机会发生遗忘,这种事件必须从分母里剔掉,否则遗忘率会被系统性低估。最后一轮也不作为「提出轮」计入,因为它之后没有可被破坏的未来。
图质量沿用 PaperBanana 那套两两对比:把生成图 $I_{T}$ 与人类参考图 $I_{H}$ 在四个维度上判胜负——忠实度、简洁性、可读性、美观度,每个维度给出胜/平/负,再按两层投票合成总体结果,胜 100 分、平 50 分、负 0 分。论文明确说主维度是忠实度与简洁性,次维度是可读性与美观度:主维度出现明确赢家(一方两维全赢,或赢一维平一维)就直接定局,打平才看次维度。
裁判可信度做了三重校验。人工独立判定 200 条需求的满足情况,与 VLM 裁判的 Cohen's $\kappa=0.812$;换 Claude-Opus-4.8 当裁判在同一批 DirectRefine 输出($k=3$ 五轮)上重判,与 Gemini-3.1-Pro 的 $\kappa=0.663$;再由人工标注者在隐藏系统身份的条件下对 150 个样本做三选一排序,Interact 相对 NanoBananaPro 与 DirectRefine 的被偏好率分别是 81.3% 与 76.7%。这三条一起,把「模型自评自夸」的嫌疑压到了可讨论的范围。
实验结果
所有智能体系统统一用 Gemini-3.1-Pro 当语言模型、NanoBananaPro 当图像后端,Interact 的内循环预算 $\tau_{\max}=10$,用户模拟器跑 $T_{\max}=5$ 轮。AutoFigure 与 AutoFigure-Edit 因为单轮质量分只有 1.9 和 0.3 被排除在多轮评测之外——在这么低的起点上谈多轮精修没有意义。
| 单轮生成器 | 多轮 refiner | Qual ↑ | Req ↑ | Reqpt ↑ | Forget ↓ |
|---|---|---|---|---|---|
| AutoFigure | - | 1.9 | 20.4 | - | - |
| AutoFigure-Edit | - | 0.3 | 16.5 | - | - |
| NanoBananaPro | -(单轮) | 22.4 | 18.1 | - | - |
| NanoBananaPro | NanoBananaPro | 12.5 | 39.4 | 53.8 | 20.9 |
| GPT-Image-2 | -(单轮) | 41.6 | 25.0 | - | - |
| GPT-Image-2 | GPT-Image-2 | 25.7 | 52.9 | 67.4 | 15.5 |
| Crafter | -(单轮) | 35.4 | 18.4 | - | - |
| Crafter | NanoBananaPro | 6.2 | 39.4 | 56.2 | 19.2 |
| Crafter | DirectRefine | 30.5 | 47.6 | 68.1 | 15.0 |
| Crafter | Interact | 48.1 | 52.1 | 73.4 | 10.3 |
| PaperBanana | -(单轮) | 50.3 | 25.2 | - | - |
| PaperBanana | NanoBananaPro | 19.0 | 45.2 | 56.2 | 19.0 |
| PaperBanana | DirectRefine | 47.1 | 52.6 | 68.6 | 18.8 |
| PaperBanana | Interact | 61.2 | 58.0 | 77.2 | 12.6 |
表 2:$k=1$ 用户模拟器下的主结果(论文表 1)。Qual 是与人类参考图对比后的质量分,Req 是最终图上的总需求满足率,Reqpt 是当轮满足率,Forget 是遗忘率。
把 $k=1$ 这张表竖着读,能看出三件事。第一,多轮确实换来了需求满足率:PaperBanana 单轮只有 25.2,配任何 refiner 都能到 45 以上,因为隐藏需求本来就是一轮一轮放出来的。第二,满足率的提升并不自动带来质量提升——NanoBananaPro 当 refiner 时 Req 从 25.2 涨到 45.2,Qual 却从 50.3 崩到 19.0,等于用画面向用户的要求低头。第三,当轮满足率与总满足率之间那道 10 到 20 个百分点的口子就是遗忘,所有基线都在 14.1% 到 22.9% 之间,Interact 是 12.6%。
Interact 是唯一一个「质量分比单轮起点还高」的 refiner:50.3 起步,五轮之后 61.2。这不是小幅波动——五次重跑的均值与标准差是 61.2 ± 1.8(Req 58.0 ± 0.4,Reqpt 77.2 ± 0.3,Forget 12.6 ± 1.2),差距远大于抖动。换成 Crafter 当起点同样成立:35.4 到 48.1。论文摘要里那句「比基线高 11.9 到 18.6 分、遗忘率低 3.7 到 6.2 个百分点」就是这么来的。
| 单轮生成器 | 多轮 refiner | Qual ↑ | Req ↑ | Reqpt ↑ | Forget ↓ |
|---|---|---|---|---|---|
| NanoBananaPro | -(单轮) | 22.4 | 18.1 | - | - |
| NanoBananaPro | NanoBananaPro | 8.6 | 76.5 | 59.6 | 21.5 |
| GPT-Image-2 | -(单轮) | 41.6 | 25.0 | - | - |
| GPT-Image-2 | GPT-Image-2 | 22.4 | 88.5 | 71.0 | 14.1 |
| Crafter | -(单轮) | 35.4 | 18.4 | - | - |
| Crafter | NanoBananaPro | 2.9 | 74.6 | 59.1 | 21.6 |
| Crafter | DirectRefine | 23.5 | 87.8 | 72.2 | 16.0 |
| Crafter | Interact | 42.1 | 93.4 | 79.0 | 12.3 |
| PaperBanana | NanoBananaPro | 18.3 | 76.9 | 59.8 | 22.9 |
| PaperBanana | DirectRefine | 42.6 | 87.6 | 71.0 | 19.1 |
| PaperBanana | Interact | 54.5 | 94.2 | 79.6 | 13.0 |
表 3:$k=3$ 用户模拟器下的主结果(论文表 2)。每轮放出三条需求,反馈更长、约束更密。
$k=3$ 这一档把难度提上去了:一次说三条要求,反馈文本更长,需求之间还会互相牵制。总满足率随之大幅上升(Interact 在 PaperBanana 起点上到 94.2,因为五轮下来放出的需求更多),但质量漂移被放大——DirectRefine 从 $k=1$ 的 47.1 掉到 42.6,NanoBananaPro 掉到 18.3,Crafter 配 NanoBananaPro 只剩 2.9 分。Interact 在这一档的增益相对温和(54.5 对起点 50.3),作者也承认这一点,但方向仍然是往上而不是往下。
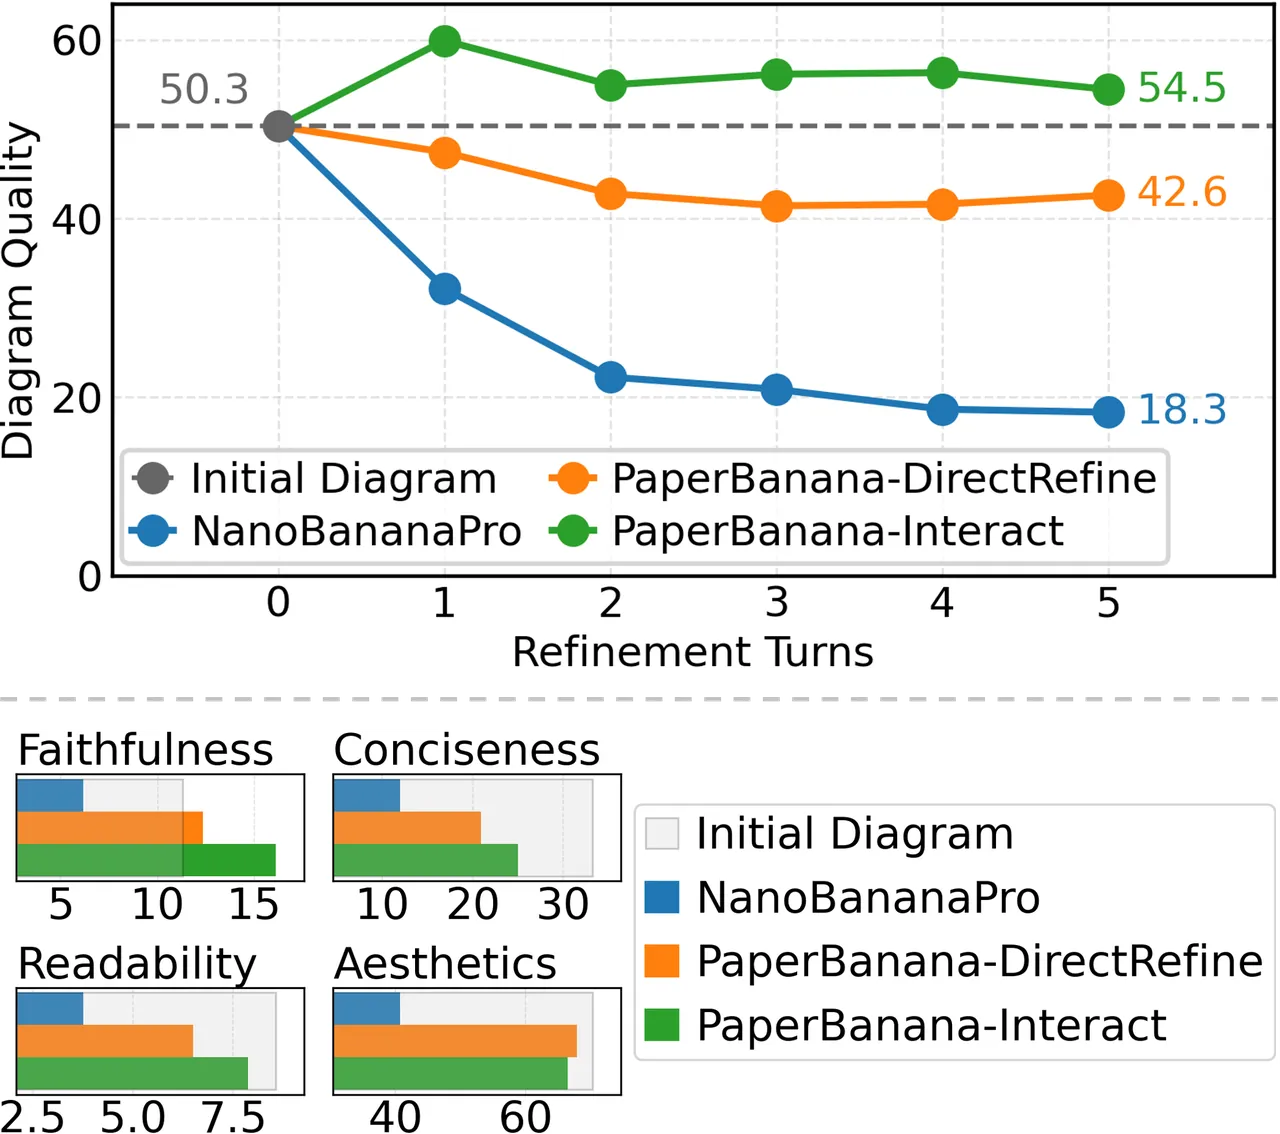
图 5(论文图 5):在 PaperBanana 输出上用 $k=3$ 模拟器迭代五轮,上图是逐轮质量分,下图是终图的分维度质量拆解。NanoBananaPro 在四个维度上全线漂移,DirectRefine 的失分主要集中在简洁性与可读性。
分维度拆解把两种失败模式分开了。NanoBananaPro 是全维度崩,典型症状是美观度突降与扭曲的渲染伪影;DirectRefine 守住了大部分画面质量,但把用户要求硬塞进版面,导致布局失衡、大片留白,外加风格无端漂移,伤在简洁性与可读性两维。Interact 的机制差异正在于此:它在一轮之内有多次内部迭代,可以把布局与样式问题当轮修掉,而不是把未消化的约束带进下一轮。
| 批评家 | 历史输入 | $\tau_{\max}$ | Qual ↑ | Req ↑ | Reqpt ↑ | Forget ↓ |
|---|---|---|---|---|---|---|
| MO 多目标 | Sum 摘要记忆 | 10 | 61.2 | 58.0 | 77.2 | 12.6 |
| Naive 非结构化 | Sum | 10 | 58.9 | 57.1 | 72.3 | 13.1 |
| MO | None 只有上一张图 | 10 | 58.0 | 58.1 | 77.1 | 14.7 |
| MO | Full 全量多图历史 | 10 | 58.9 | 57.6 | 73.5 | 11.6 |
| MO | Sum | 5 | 60.6 | 57.4 | 75.5 | 13.4 |
| MO | Sum | 3 | 53.3 | 55.9 | 74.1 | 13.8 |
| MO | Sum | 1 | 43.5 | 54.2 | 72.3 | 16.8 |
表 4:消融(论文表 3),均在 PaperBanana 输出上用 $k=1$ 模拟器迭代五轮。MO = 多目标批评家,Sum = 摘要记忆,None = 除 $I_{t-1}$ 外不给历史,Full = 给全量多图历史。
消融里最值得读的是「历史怎么给」这三行。不给历史(None)时遗忘率从 12.6 升到 14.7,质量掉 3.2 分,但总满足率几乎没变(58.1 对 58.0)——说明历史记忆主要买的是「别把旧改动弄丢」,而不是「多满足几条新要求」。给全量历史(Full)遗忘率最低(11.6),代价是当轮满足率从 77.2 掉到 73.5、终图质量掉到 58.9,而且输入 token 多花 37.1%。压缩过的文本记忆恰好在中间拿下质量与当轮满足率的双料第一,这才是摘要器真正的价值论证:它不是省钱的权宜之计,而是效果最好的那一档。
迭代预算 $\tau_{\max}$ 的影响最陡:10 到 5 到 3 到 1,质量分 61.2 → 60.6 → 53.3 → 43.5,遗忘率 12.6% → 13.4% → 13.8% → 16.8% 单调变差。$\tau_{\max}=1$ 意味着只改一遍就交卷,此时质量分 43.5 已经低于单轮起点 50.3——内循环一旦拿掉,这套系统就退化成一个更啰嗦的 DirectRefine。多目标批评家换成非结构化的朴素批评家,当轮满足率掉 4.9 分、质量掉 2.3 分、遗忘率略升,说明「按约束逐路出结论」这个结构化要求本身就在起作用,而不只是提示词写得好。
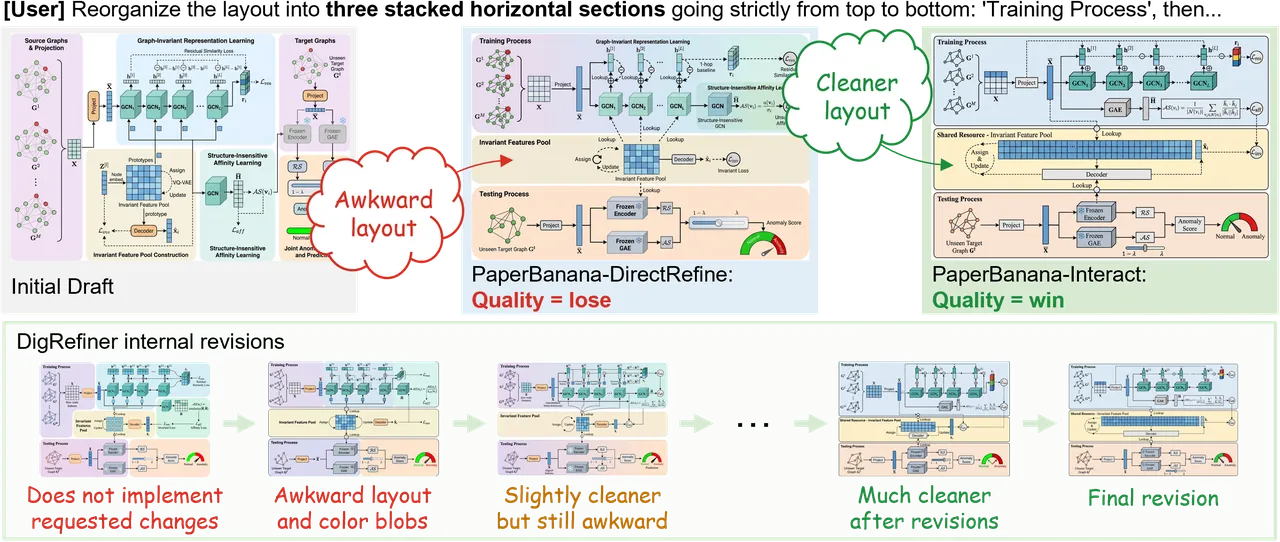
图 6(论文图 6):质量漂移的定性对比。DirectRefine 把用户要求生硬塞进画面,留下失衡布局与大片空白;Interact 通过多次内部迭代调整布局与样式,终图明显更完整。
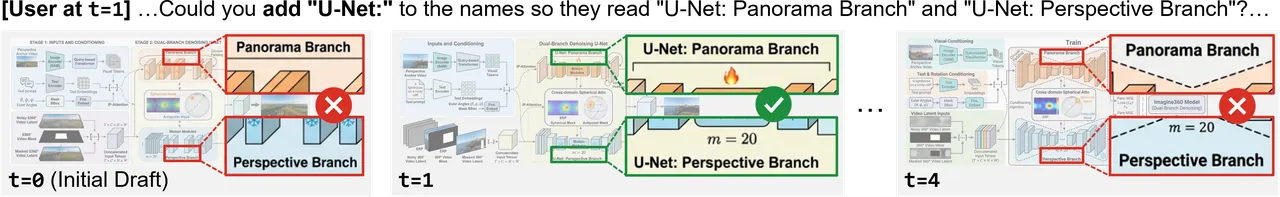
图 7(论文图 7):遗忘的定性对比。DirectRefine 先按要求改好了,但后续几轮反复调整相关模块的样式时,把已经满足的改动丢了。
代价也得摆出来。用 PaperBanana 出初稿再让 Interact 以 $\tau_{\max}=10$ 精修五轮,初稿那一轮消耗 186.8k / 6.2k 的 Gemini-3.1-Pro 输入/输出 token 加 5.7k / 5.3k 的 NanoBananaPro token;此后每一轮精修是 159.4k / 11.2k 加 7.1k / 5.0k。绝大部分开销来自内循环的多次迭代。迭代次数的分布集中在小值并随次数递减,但在上限处有一个 22% 的尖峰——也就是每五次里就有一次是「改到预算用完仍不满足停止条件」的难例。
论文方法在代码里的落点
仓库里的实现比论文正文更细,有几处只在代码里能看清楚,值得单独列出。
| 论文里的部件 | 代码位置 | 只有读代码才知道的细节 |
|---|---|---|
| 摘要器 $\mathcal{S}$ | agents/refiner/pb_interact.py 的 STEP 0 与 CONTEXT_SYSTEM_PROMPT | 记忆不是一段自由文本,而是按轮次编号的结构化 JSON:每张图一个 context_diagram{n}、每轮用户话一个 context_user_turn{n}。提示词把摘要者设定为「顶会首席视觉设计师兼会议记录员」,并要求每条注记自成一体——没看过图的人也能据此重建画面内容、用户反对什么、为什么反对。它只在 $\tau=0$(代码里的 j == 0)跑一次,后续内部迭代复用同一份。 |
| 多目标批评家 $\mathcal{C}$ | 同文件 STEP 1,输出 schema 动态拼装 | 四路批评对应四个 JSON 键:critique_latest_turn、按实际轮数生成的 critique_prior_turn{n}、critique_source_content、critique_presentation。批评阶段刻意不把当前提示词给模型看,避免它顺着既有描述自我合理化;提示词要到 STEP 3 真正改写时才注入。 |
| 循环终止条件 | utils/paperviz_processor.py::process_single_feedback | 内循环由 processor 持有,轮次索引是 [i, j]($i$ 是用户轮,$j$ 是内部迭代)。STEP 2 是一道门控问答,模型答「No」就写下 No changes needed. 并直接返回,连提示词都不改——省掉一次无谓渲染。渲染失败时保留上一张好图并跳出循环,不会把坏图喂给下一轮批评。 |
| 用户模拟器 | utils/user_simulator_multi_req.py::simulate_user_feedback | 按 req_order 取前 n_surfaced_req_per_turn 条未满足需求,一条都没有就打上 early_stopped=True 直接返回——这就是论文里的 $F_{t-1}=\varnothing$ 提前停止。写进对话历史的除了用户话,还有 surfaced_index 与每条需求的评测理由,供后续指标计算复用。 |
| 遗忘率与当轮满足率 | main_multiturn.py::_forgetting_rate / _surfaced_addressed_ratio | 事件按(轮次,样本,需求)池化,同一条需求在两轮被提出算两次事件;early_stopped 的轮次在分子分母两侧都被跳过,因为它「从未发生」,其尾部的 surfaced_index 只是上一真实轮的陈旧副本。 |
表 5:论文方法部件与开源代码的对应关系(仓库 shirley-wu/PaperBanana-Interact)。
还有一处论文与代码对不上,复现时会踩到。论文附录 F.1 写明质量分的主维度是忠实度与简洁性、次维度是可读性与美观度;但 utils/eval_toolkits.py 里的实现是第一层投票用忠实度与可读性,平局才看简洁性与美观度(先 _determine_tier_outcome(faithfulness, readability),未定局再 _determine_tier_outcome(conciseness, aesthetics))。两套分层在「忠实度赢、简洁性输、可读性平」这类组合下会给出不同的总体胜负。同一个函数里还有一条兜底规则:某轮模型没能渲染出图时直接判人类参考图胜,这解释了为什么 NanoBananaPro 在 Crafter 起点上会掉到 2.9 这种极端低分。
配置默认值也要留意。utils/config.py 里 max_critic_rounds=3、refiner_internal_critic_rounds=1、n_surfaced_req_per_turn=1,图像模型默认 gemini-3.1-flash-image-preview;论文报数用的是 $T_{\max}=5$、$\tau_{\max}=10$ 与 NanoBananaPro(gemini-3-pro-image),全靠命令行覆盖。照默认值跑一遍,得到的是消融表里 $\tau_{\max}=1$ 那一行(质量 43.5),不是主结果。
局限性
作者自述:视觉幻觉与「只能辅助」的定位。附录 A 明确承认生成模型的伦理风险,尤其是「看起来合理但事实上错误」的科学内容表征。作者的应对是把工具定位成纯辅助系统,在 README 与演示页首屏都挂免责声明,并计划用一份专门的许可证要求:任何使用了本系统生成图像的学术发表,必须明确披露图像由该系统生成,并附一节讨论人工智能在研究中所起的作用。论文同时强调用户不应过度依赖此类系统,必须保留严格的人工把关以维持已发表插图 scientific accuracy。
作者自述:遗忘没有被消灭,只是被压低。Interact 的遗忘率仍在 10% 到 13% 区间,也就是说每 8 到 10 条曾经满足的需求里就有一条会在后续修改中丢掉。对一个要拿去做投稿配图的系统,这个数字意味着人工复查不可省。
作者自述:单跑数字与算力约束。附录 D 直说受算力限制,正文大多数数字来自单次运行,只有主设置重跑了五次给出标准差。加上 22% 的轮次是撞在 $\tau_{\max}$ 上限上停的,那些难例的真实上限并未被测出来——预算再放宽,质量分可能还有空间,也可能只是烧掉更多 token。
补充判断一:Gemini 同时是选手、裁判和用户。语言主干是 Gemini-3.1-Pro,质量与需求满足的裁判也是 Gemini-3.1-Pro,用户模拟器的话术生成还是 Gemini-3.1-Pro。论文用换 Claude-Opus-4.8 当裁判($\kappa=0.663$)和 150 样本人工排序做了对冲,但用户模拟器一侧没有做等价校验:如果模拟器的抱怨方式偏向某种 Gemini 更容易消化的表述,各系统的相对排名就可能被系统性影响。
补充判断二:需求池锚定在原作者的手绘图上。把 $I_{H}$ 的设计决策反推成需求,保证了条目的专业性与可判定性,但也把「原作者的偏好」当成了唯一正确答案。图设计里常有多种同等合理的解法(横向排布还是纵向堆叠、要不要展开数学细节),这类分歧在二元满足判定下会被算成失败。质量分同理——它是与参考图对比的胜率,不是绝对质量。这也解释了为什么 Interact 的质量分最高只有 61.2:它与人类参考图仍有相当距离。
补充判断三:14 人的形成性研究与回顾式自评。动机研究样本量 14 人,人工排序与 200 条需求的人工判定各由一位标注者完成,论文未说明其与被评系统的利益隔离。86% 的满意度提升幅度很可观,但它是回顾性自评(看完终图再回头给初稿打分),这类设计天然会放大对改善的感知。
补充判断四:单位成本与适用范围。每轮精修约 16 万输入 token 的量级,五轮下来一张图的开销相当可观,这在需要批量出图的场景里是硬约束。另外整套方法与评测都绑定在「科研示意图」这个域上:它依赖源上下文(方法段加图注)作为忠实度的判据,换到没有明确源文本的插画或产品设计场景,多目标批评家的第三路约束就失去了抓手。
总结与展望
这篇论文的贡献不在某个单点技巧,而在于把一个长期被跳过的设定做完整了:任务形式化、可复现的多轮基准(292 图 / 3518 需求 / 三乘三分类体系 / $\kappa=0.767$ 的标注一致性)、两种被量化的失败模式(质量漂移与遗忘),以及一个能同时压住两者的系统。方法层面真正撑住效果的是两件事:把多图历史压成按轮次编号的结构化文本记忆,以及让批评家对每一路约束各出一条结论。前者在消融里是效果最好的一档而不只是省钱的一档,后者把「新改动不得悄悄牺牲旧改动」写进了系统结构。
对做智能体系统的人,可迁移的部分很清楚:跨轮状态不要指望模型自己记住,要显式建一份能被每一步查阅的约束账本;批评阶段不要把即将被改写的中间产物给批评者看,否则批评会退化成对既有方案的辩护;内循环预算是实打实的性能旋钮($\tau_{\max}$ 从 1 到 10 差 17.7 个质量分),不是可选的锦上添花。留给后面的问题也很明确:把 10% 到 13% 的残余遗忘压到接近零、把 22% 撞上限的难例真正解掉、以及让裁判与选手不再是同一家模型。
金句:图设计天然是迭代的——看过初稿之后才会浮现出那些事先想不到的修改机会(figure design is naturally iterative: reviewing an initial draft often reveals refinement opportunities that are difficult to anticipate upfront)。这句话是整篇论文的立论基础:既然偏好是在看到图之后才形成的,任何一次性生成的系统都注定不够,而 64% 的会话在实测里印证了这一点。