PAPER DEEP DIVE
RankEvolve:把研究流程编译成状态机,让 Claude Code 与 Codex 互审补丁的自动研究 harness
Meta 团队提出 RankEvolve——面向排序模型演化的多智能体自动研究框架:可执行操作协议(EOP)编译为运行时强制的状态机,治好长周期流程漂移;meta-meta-harness 把 Claude Code、Codex 等完整编码 agent 产品绑定为执行图节点并互相交叉审查;知识层让负结果与事故教训跨迭代沉淀。在开源 HSTU 推荐模型上十二轮迭代将 MovieLens-20M LARGE 的 NDCG@10 推到 0.2192(较发表锚点 +4.48%)。基于隐藏 oracle 的 ExecML 基准显示:预算匹配下 CC+Codex 异构配对把 all-oracle 执行准确率从 45.8% 提到 62.5%(配对 +16.7,95% CI [6.6,26.7]),静默关键缺陷率砍到 10.4%,且在 LitGPT 上复现(+12.5)。
自动研究 agent——让 LLM 读代码、提假设、写补丁、跑训练、看指标、决定下一步——这两年被反复演示过:FunSearch、AlphaEvolve、AI Scientist 一脉相承。但绝大多数演示停留在「小模型 + 便宜评估器」的舒适区,一旦进入成熟的生产级代码库,每一轮改动都要花几小时 GPU 训练,且一次隐蔽缺陷(测试集泄漏、漏掉一个 layer norm、梯度断开、train/eval 开关没接上)就能烧掉几十小时加速器时间,还让整个迭代从错误结论上继续滚下去。Meta 的四位研究者(Zheng Chen、Linfeng Liu、Hong Li、Hong Yan)把这个真实场景摊开来讲,给出了 RankEvolve——一个专门为「演化排序模型」设计的多智能体自动研究框架,并在开源 HSTU 生成式推荐模型上跑了整整十二轮迭代。
这篇论文真正有意思的地方,不在「agent 自动做研究」这个口号,而在它对可靠性工程的量化态度:作者没有停留在架构图,而是搭了一个带隐藏 oracle 的基准,把「两个不同厂商的编码 agent 互相审查」这件事,做成了一个有对照组、有预算匹配、有预注册假设的可证伪实验。
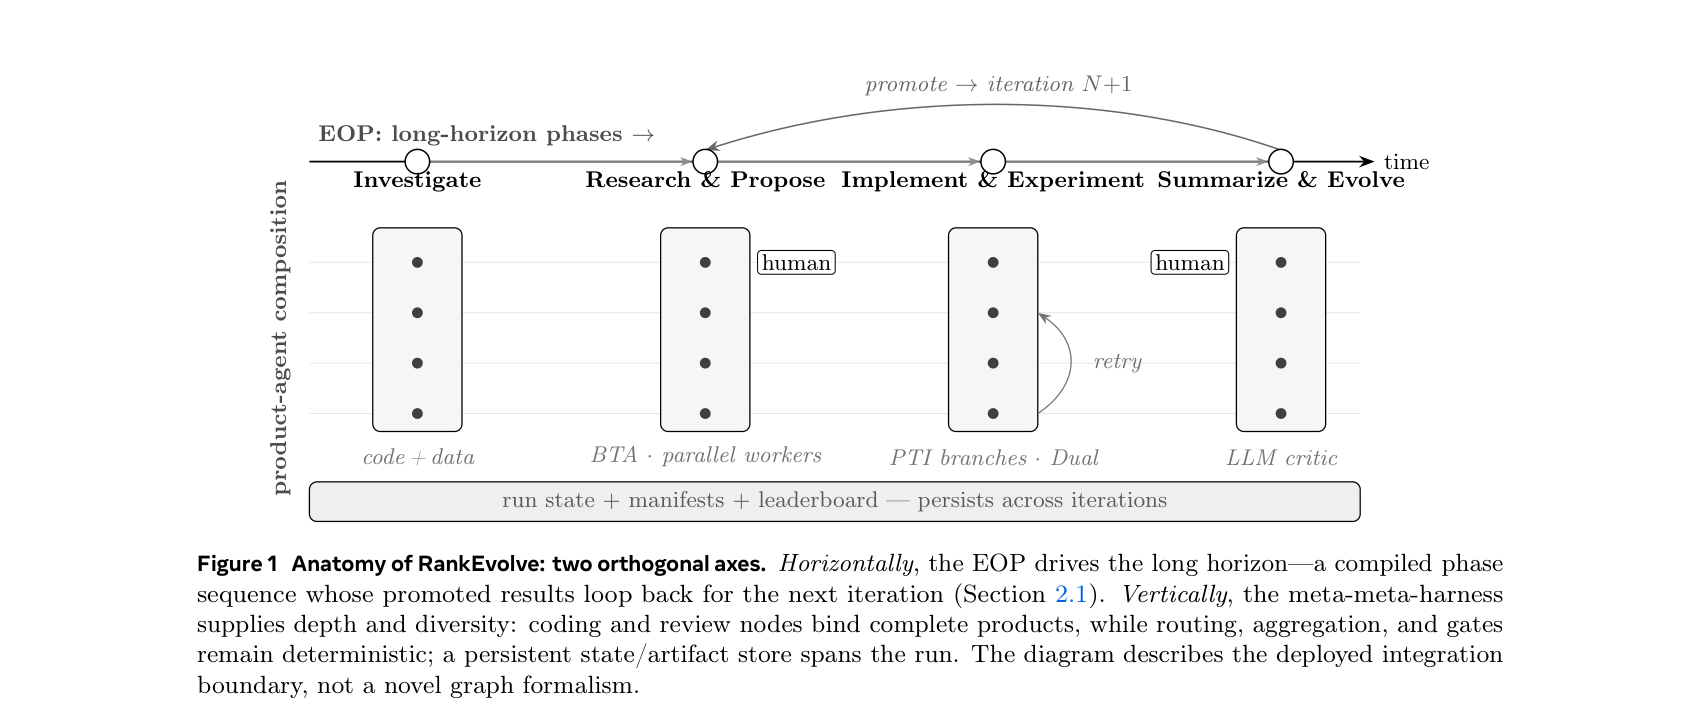
三层架构:把「研究流程」变成被运行时执行的协议
RankEvolve 分三层,各层的主张刻意不同。
第一层:可执行操作协议(EOP,Executable Operating Protocol)。作者的第一条断言是:把研究流程写成一次性、可版本化的半结构化协议——声明阶段(phase)、依赖、工具、人工确认门(gate)、分支与循环——然后编译成状态机,由运行时强制执行。协议里每个标记(依赖、分支、join、goto、循环预算、工具白名单)要么被静态检查、要么在运行时被强制执行;模型负责执行每一步的具体工作,但流程的控制权始终在框架手里。运行时状态被形式化为 $\sigma=(q,V,A,G,B,R,T)$——活跃阶段、协议变量、已提交工件、门状态、活跃分支、尝试/预算计数器、追加式事件轨迹——由类型化事件 $\delta(\sigma,e)\rightarrow\sigma'$ 推进:节点完成、门批准、分支失败、预算耗尽。值得称道的是作者明确划出保证边界:依赖、门、分支基数、循环预算、工具白名单、检查点重启都可以被强制,但语义层面的代码正确性明确不在保证范围内。
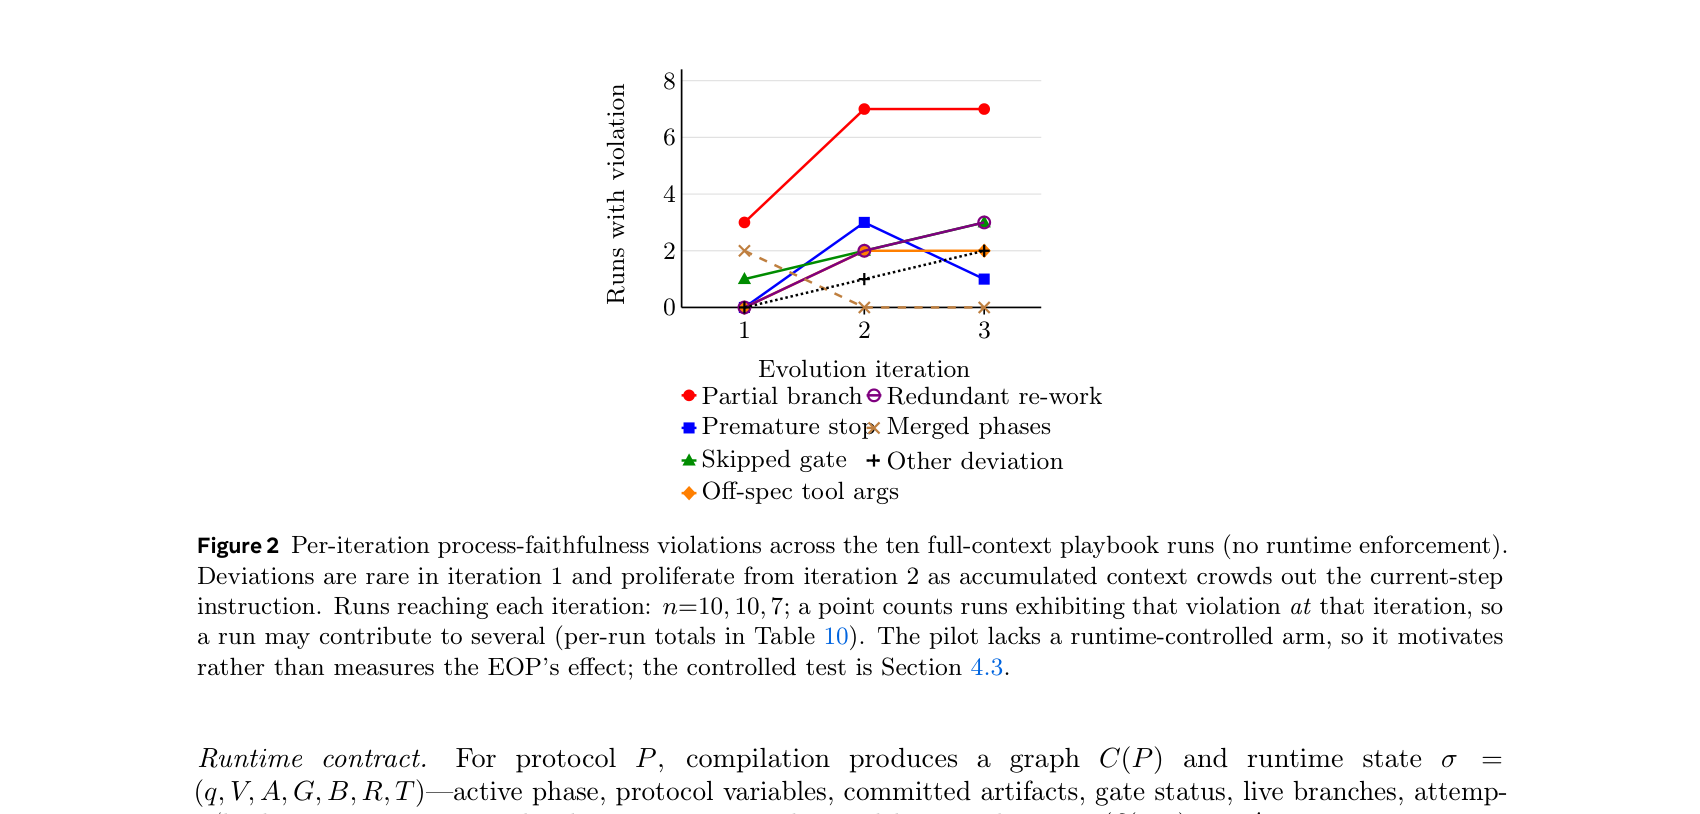
为什么需要运行时强制?论文给了一个 Pilot 实验:十次运行把完整流程当作单一上下文的 playbook 喂给模型,十次无一完全忠于流程——十次都只执行了部分提案、四次提前停止、四次跳过门、三次工具参数不合规范。图 2 展示了违规随迭代累积的过程:第一轮违规罕见,从第二轮开始随着上下文膨胀急剧增多——累积的上下文「挤掉」了当前步骤的指令。这就是长周期 agent 的漂移问题:协议写在提示词里,就会被上下文稀释;编译进状态机,才不会被稀释。
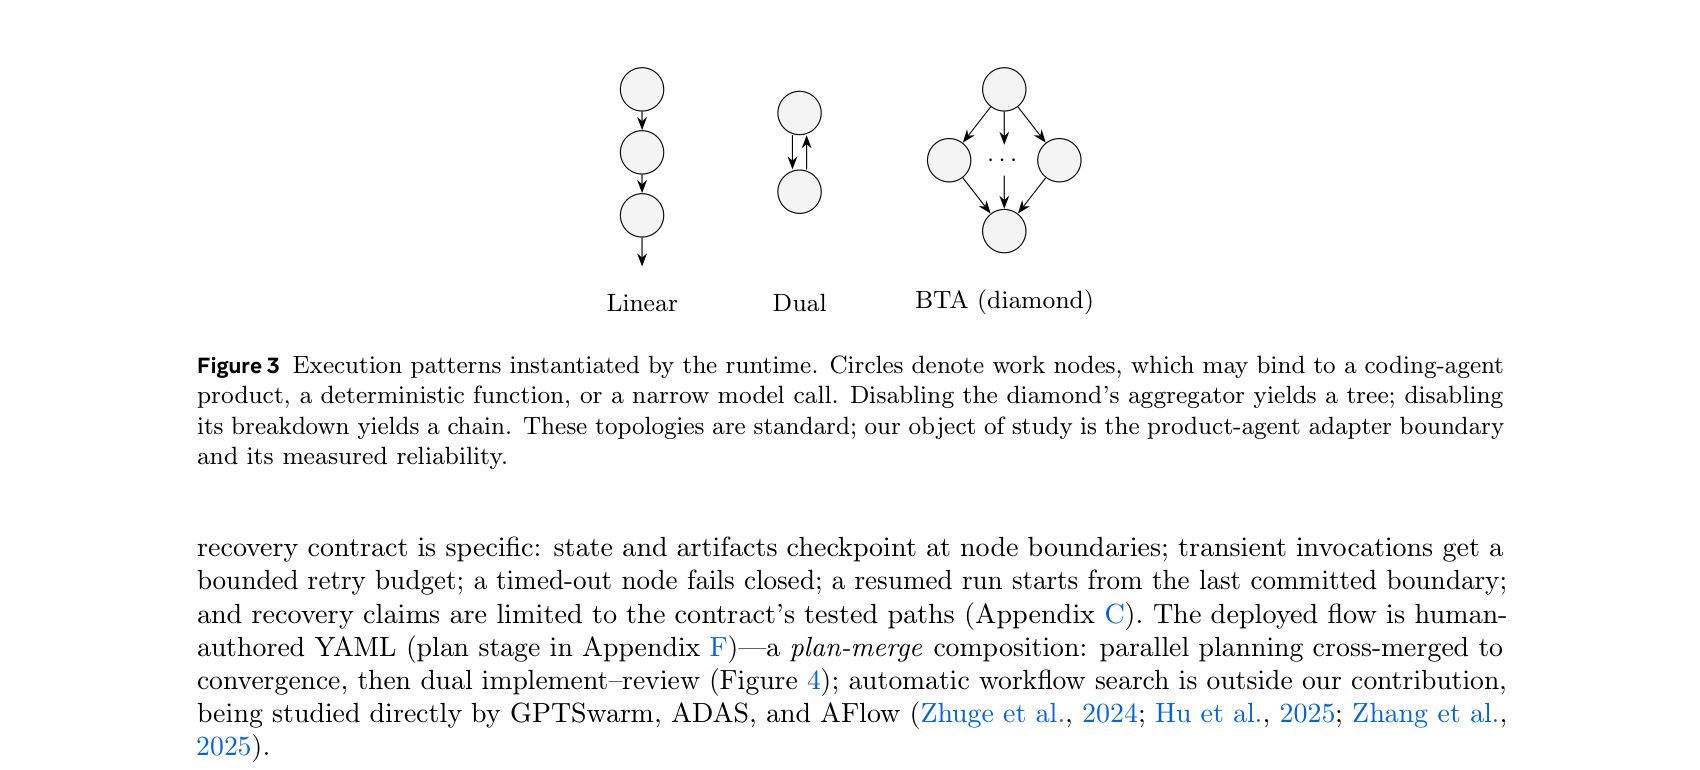
第二层:meta-meta-harness。这是全文最锋利的设计。作者指出:每个商业编码产品(Claude Code、Codex、OpenHands)本身已经是套在原始模型上的 harness——自带规划器、上下文管理、工具和沙箱。RankEvolve 则「harness 这些 harness」,站在模型之上两层,把完整的产品作为执行图的工作节点,而不是发起原始模型调用。绑定方式是一份适配器契约:输入任务、仓库快照、允许工具、预算和先验工件,返回补丁、终态、事件轨迹和用量记录;沙箱、非交互调用、超时、用量收集归运行时所有,产品内部规划一概不碰。这让三个产品在「编码」或「审查」节点上可互换替换,而路由、聚合、门、指标保持为确定性运行时函数。
运行时实例化三种执行模式(图 3):Linear——带回环的链;Dual——提出→审查→修复的共识循环,本质上是「内部同行评审」,重复直到审查者批准或剩余严重度低于阈值;BTA(Breakdown-then-Aggregate)——菱形拓扑,把任务拆成有界并发的子任务再汇总,是图 1 中并行研究工作节点的扇出实现。这些模式组合成 PTI(Plan-then-Implement)等流。恢复契约也很具体:状态与工件在节点边界检查点化;瞬态调用有有界重试预算;超时节点失效关闭(fail closed);恢复的运行从最后提交的边界开始。
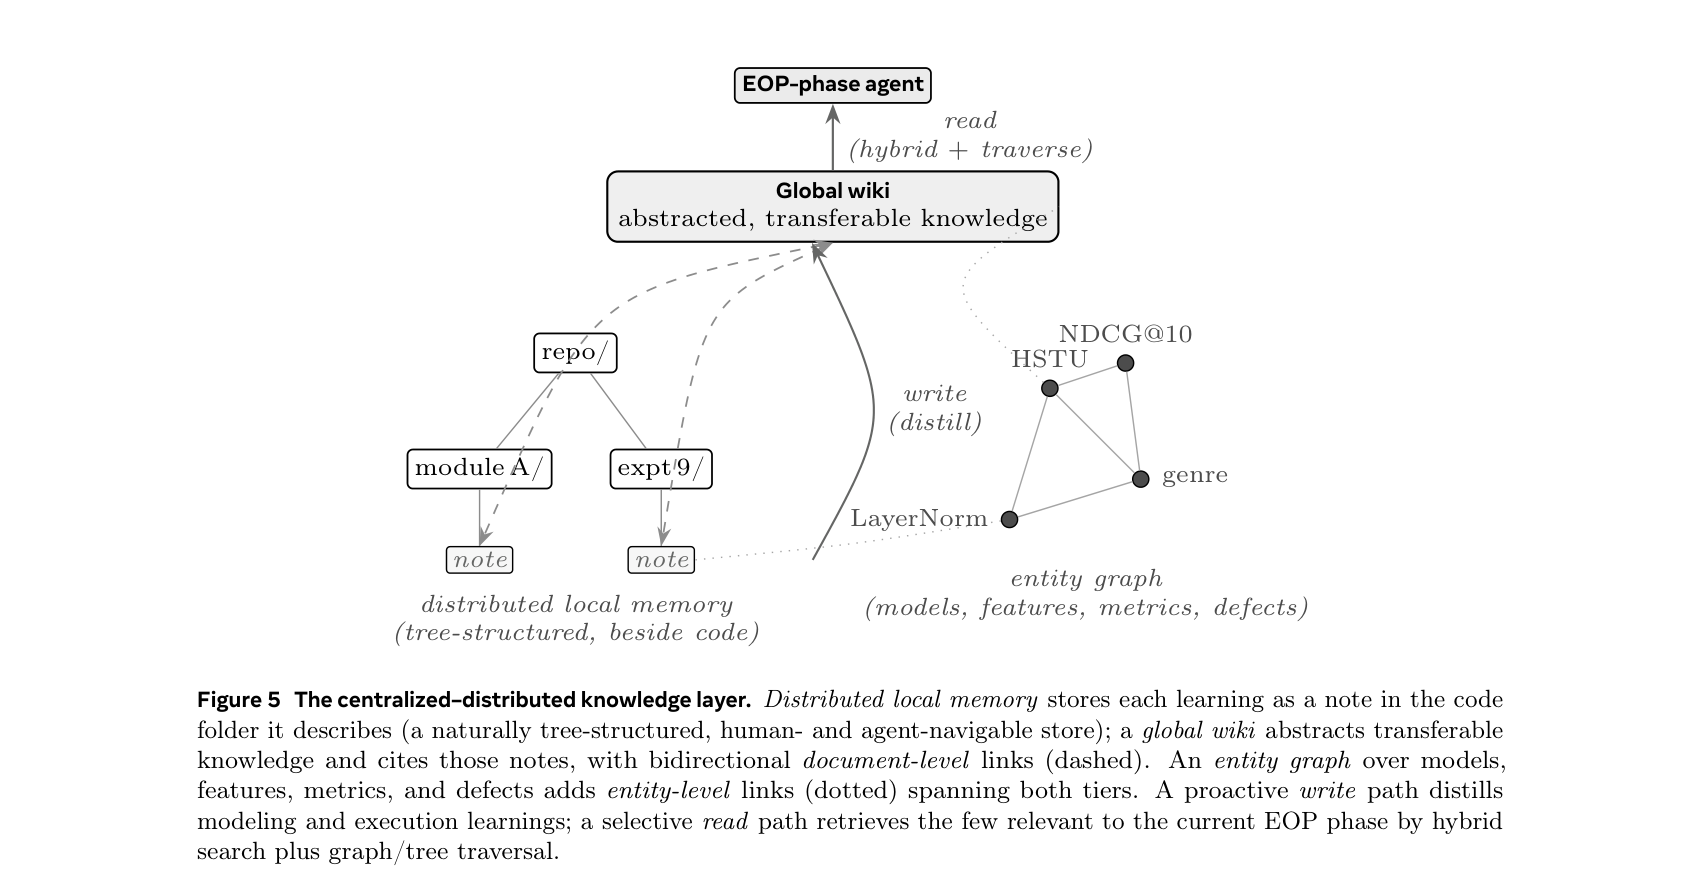
第三层:知识层。一个会遗忘的长期 agent 会不断重推同样的死胡同。知识层做两件事:其一,工件/证据存储按提案记录仓库与环境哈希、提示词、EOP 与产品版本、补丁、测试输出、训练配置、切分、检查点、指标、成本和晋升决策——负结果是一等公民的排行榜行;其二,经验记忆把自包含的笔记写在其描述的代码旁边,把可迁移的教训抽象进中央 wiki(引用笔记为证据),再通过实体图把两层连起来。一个和解 agent 保持 wiki 为唯一事实源,而每阶段的读路径只注入当前阶段相关的几条教训,保住 EOP 的逐步上下文纪律。
十二轮 HSTU 实战:赢在执行,输在新颖
目标模型是 HSTU(Meta 发表于 ICML 2024 的生成式推荐器):作者用其公开实现和公开的 MovieLens 数据,保证所有结果都在公开基准尺度上。HSTU 把 Transformer 块替换为 SiLU 归一化注意力、融合的 UVQK 投影和可学习的相对分桶时间-位置偏置——最后这一点正是后面时间衰减插件被证明冗余的原因。基线锚点:ML-20M BASE 0.1895、LARGE 0.2098。评估纪律是全文最见功力的细节之一:报告canonical full-test NDCG@10(leave-one-out、全语料排序),与更快但虚高 0.005–0.010 的子集评估严格分开;单次运行的检查点评估不是独立种子,「最佳检查点」只作描述性历史。作者直言,没有这条纪律,系统会反复追逐子集与检查点噪声造成的幻影「收益」。计算规模:工作区约 55 条排行榜记录、49 个实验目录、1–8 张 NVIDIA H200。
| 阶段 | 轮次 | 干预 | 结果 | 结论与主张范围 |
|---|---|---|---|---|
| 锚点 | 0 | HSTU 发表锚点 | 0.2098 | 公开对比点 |
| I 组合已知组件 | 1–2 | SSD 输入压缩 IC + PRISM 条件化 | 0.2140 | +2.0%,实测历史终点 |
| 3–4 | + 多 token 打分头;偏好优化 DPO/IPO/SimPO | 0.2161 / DPO −35.9% | SYNAPSE +3.0%;偏好方向被拒 | |
| II 精细化 | 5–7 | FLUID 时间衰减;失败重叠诊断;focal/尾部 | 打平 / 75.2% 重叠 / 无增益 | 衰减冗余;诊断仅描述性;重加权被拒 |
| 8 | 深度失败分析 + MPTA | 0.2154 | genre Jaccard ≈0.236;MPTA 在噪声内,被拒 | |
| III 推天花板 | 9 | 无泄漏 genre 侧特征(UDK) | 0.2192 | 最大终点 +4.48%,v1 泄漏已修;元数据增益非架构新颖 |
| 10–11 | 位置平均 TTA;UDK 三通道 | ≈0.2190 / ≈0.2192 | 均无增益;三通道同饱和 ≈0.219 天花板 | |
| 12 | 推理端 boost-last-K 等 | ±0.0003 | 检查点噪声内,不计新终点 |
十二轮迭代概括为三个阶段,轨迹颇有一种「反高潮」的诚实:
阶段 I——组合已知组件(SYNAPSE)。最有架构含量的工作是把三块已知组件调好组合在 HSTU 骨干上:SSD 风格的分层输入压缩 IC(对长历史做 $O(N)$ 状态压缩,承袭结构化状态空间对偶);PRISM 用户条件化(逐特征的 FiLM 调制 $\gamma\odot\text{item}+\beta$);多 token 打分头(把序列池化为「近期意图」和「长期偏好」两个 token,以逐面归一化下的内积和打分,塌缩为单次 ANN 调用)。没有一块是新的,但调好的组合把 NDCG@10 从 0.2098 提到 0.2161(+3.0%)。同阶段最大胆的赌注——RLHF 式偏好优化——全军覆没:DPO 相对自己的参考值崩掉 35.9%(0.2191→0.1405),IPO −8.2%、SimPO −17.9%,而三个方法的偏好准确率都逼近 1.0——典型的奖励过优化症状。Agent 自己在第 8 轮给出了根因:被「拒绝」的 top-K 物品与目标物品的 genre Jaccard 相似度约 0.236,即被拒样本其实部分相关,偏好目标在系统性贬低有效候选。无泄漏的重新推导(只从内部位置挖掘拒绝对)不再崩但增益归零——偏好对微调与这个检索目标在结构上就不匹配。
阶段 II——精细化(收益递减)。FLUID 真实间隔时间衰减插件与 0.2161 打平(HSTU 自带可学习相对时间偏置,显式衰减天然冗余);focal/尾部重加权修了三个 bug、跑了九次实验仍无增益(HSTU 的 sampled-softmax 本就平衡了逐物品梯度,把分类技术搬进排序是错配);多位置训练增强 MPTA 只带来检查点噪声内的 +0.7%。最有价值的输出是第 6 轮的失败重叠诊断:定义失败集 $F_{T}=\{u:\mathrm{rank}_{u}(i_{n})>10\}$,对同一用户在内部位置重新评估冻结模型得到 $F_{S}$,重叠度 $O(F_{T},F_{S})=\frac{|F_{T}\cap F_{S}|}{|F_{T}|}$。在 0.2127 检查点上,75.2% 的末位失败与次末位失败重叠,88.8% 与第 2/3/4 位之并重叠——失败是用户/历史的属性而非特定测试物品的属性,因此可以从训练侧下手。诊断完全不暴露测试标签($i_{n-1}$ 是训练中见过的普通标签,只用于定位、绝不作为指标上报),是一个可对任意检查点安全计算的事后分析。由它自然导出的训练侧 boost-last-$K$ 加权 $w_{t}^{\prime}=w_{t}\cdot[1+(\beta-1)\,\mathbf{1}\{n-K-1\leq t\}]$——一个函数、两个参数的改动——agent 未经人类帮助就实现并通过了冒烟测试。
阶段 III——推天花板。最大的数字来自最便宜的招:一个无泄漏的 genre 侧特征(UDK 的 ML-20M 实例化)。可学习嵌入表 $E_{g}$ 把物品类型映射为向量,只在编码器输入端做加性融合 $\tilde{x}_{t}=x_{t}+\alpha\cdot\mathrm{meanpool}(E_{g}[\mathrm{genres}(i_{t})])$,监督信号从原始物品嵌入计算以保证正负样本对称。这里藏着全文最好的教学案例:v1 版本把 genre 注入损失函数使用的物品嵌入查找,导致正样本带 genre 信息而负样本没有——训练损失塌到零、评估先冲高(0.2163)再劣化,一个教科书式的特征泄漏;agent 自己检测并修正了它。无泄漏的 v2 稳健拿到 0.2192(+4.48%),对 $\alpha\in[0.05,0.20]$ 均稳健,且必须从 0.2140 栈微调(从头训练只有 0.1911)。但随后 genre/year/popularity 三条通道全部饱和在约 0.219,推理端 last-$K$ 提升和位置平均测试时增强也不再带来增益——一条明显的 0.22 天花板。
作者把这个弧线称为反转(the inversion):唯一有架构含量的工作只换来坚实的 +3.0%,最大胆的目标函数赌注崩掉 −35.9%,而最大的数字来自最廉价、最不新颖的元数据特征——然后饱和,真正的模型新颖性反而未被证明。作者的读法值得每个关注自动研究的人记住:当代自动研究 agent 最可靠的是纪律化执行、失败诊断和务实的信息补充;最不可靠的,恰恰是我们最想从它那里得到的建模新颖性。
跨数据集迁移提供了安慰剂检查:把 SYNAPSE 和 UDK 两个配方原样(不做逐数据集调参)重放到 Foursquare-TKY/NYC、Gowalla、Yelp 四个数据集,全部超过 vanilla HSTU,累计最多 +25%(Yelp 0.0321→0.0382)——发现的杠杆是可携带的,尽管 Foursquare-TKY 上 UDK 几乎不再增益(0.0200→0.0202)。
核心实验:产品组合是否真能买到执行正确性
案例研究证明「系统跑得通」,但论文的科学问题是更硬的一个:把预算花在组合两个不同产品上,是否比花在单一产品上更能买到执行正确性?为此作者把部署中记录的事故变成 ExecML 基准:每个仓库 96 个私有任务(HSTU 与非推荐器的 LitGPT 各一个),任务均衡覆盖六类事故族——数据溯源与泄漏、张量路由、梯度流、train/eval 模式、指标语义、配置接线——一半新实现一半修复。每题配不可变快照与隐藏的可执行 oracle:只有当补丁同时通过回归套件、任务级行为检查、科学安全不变量和评估器完整性检查才算通过;主指标是 all-oracle 执行准确率(EA),另报静默关键缺陷率(CDR)——补丁能跑、但可能让科学结论失效的 oracle 确认故障(泄漏、死特性路径、断梯度、错误评估语义)。所有条件统一资源包络 $B$(相同的三角色、每节点限额、工具权限、动作上限、时长与花费上限),超时与超支计为失败并留在分母里。CC 跑 Claude Opus 4.8、Codex 跑 GPT-5.6,均开最大推理档。假设在私有评估前预注册:若 CC→Codex→CC 超过全部预算匹配基线且任务聚类 95% 区间排除零,才允许说「异构组合买到执行准确率」;LitGPT 转移对比无论结果如何都要发表。
| 条件 | HSTU EA↑ | HSTU CDR↓ | LitGPT EA↑ | LitGPT CDR↓ | 成本/题↓ |
|---|---|---|---|---|---|
| CC 单次 | 22.9 ± 10.5 | 35.4 ± 12.0 | 20.8 ± 10.1 | 37.5 ± 12.1 | $0.41 |
| CC 扩展预算 B | 33.3 ± 11.8 | 27.1 ± 11.1 | 29.2 ± 11.4 | 29.2 ± 11.4 | $0.98 |
| CC best-of-N + 盲选 | 43.8 ± 12.4 | 18.8 ± 9.8 | 39.6 ± 12.2 | 20.8 ± 10.1 | $0.95 |
| CC→CC→CC | 45.8 ± 12.5 | 16.7 ± 9.3 | 43.8 ± 12.4 | 18.8 ± 9.8 | $0.97 |
| CC→Codex→CC | 62.5 ± 12.1 | 10.4 ± 7.6 | 56.2 ± 12.4 | 12.5 ± 8.3 | $1.02 |
| Codex→CC→Codex | 56.2 ± 12.4 | 12.5 ± 8.3 | 50.0 ± 12.5 | 14.6 ± 8.8 | $1.00 |
| Plan-merge(CC∥Codex,二期)† | 70.8 ± 11.4 | 6.2 ± 6.0 | 64.6 ± 12.0 | 8.3 ± 6.9 | $2.40 |
结果清晰得近乎干净利落:异构对 CC→Codex→CC 拿下 62.5% EA,高于所有预算匹配基线(单次 22.9、扩展预算 33.3、盲选 best-of-N 43.8、同构 CC→CC→CC 45.8);对最强基线的配对对比 +16.7 点(95% CI [6.6, 26.7])。静默关键缺陷率从 35.4% 砍到 10.4%。预注册的 LitGPT 转移对比同样成立:56.2% vs 43.8%,配对 +12.5(CI [3.0, 22.0],p=0.008)——效应在非推荐器代码库上复现。五个包络内条件的成本 $0.95–$1.02/题、90–109 次工具动作,改进不是用预算买来的。反结对也胜过所有同构条件(56.2%),但落后正向对 6.2 点——谁实现、谁审查,是有讲究的。
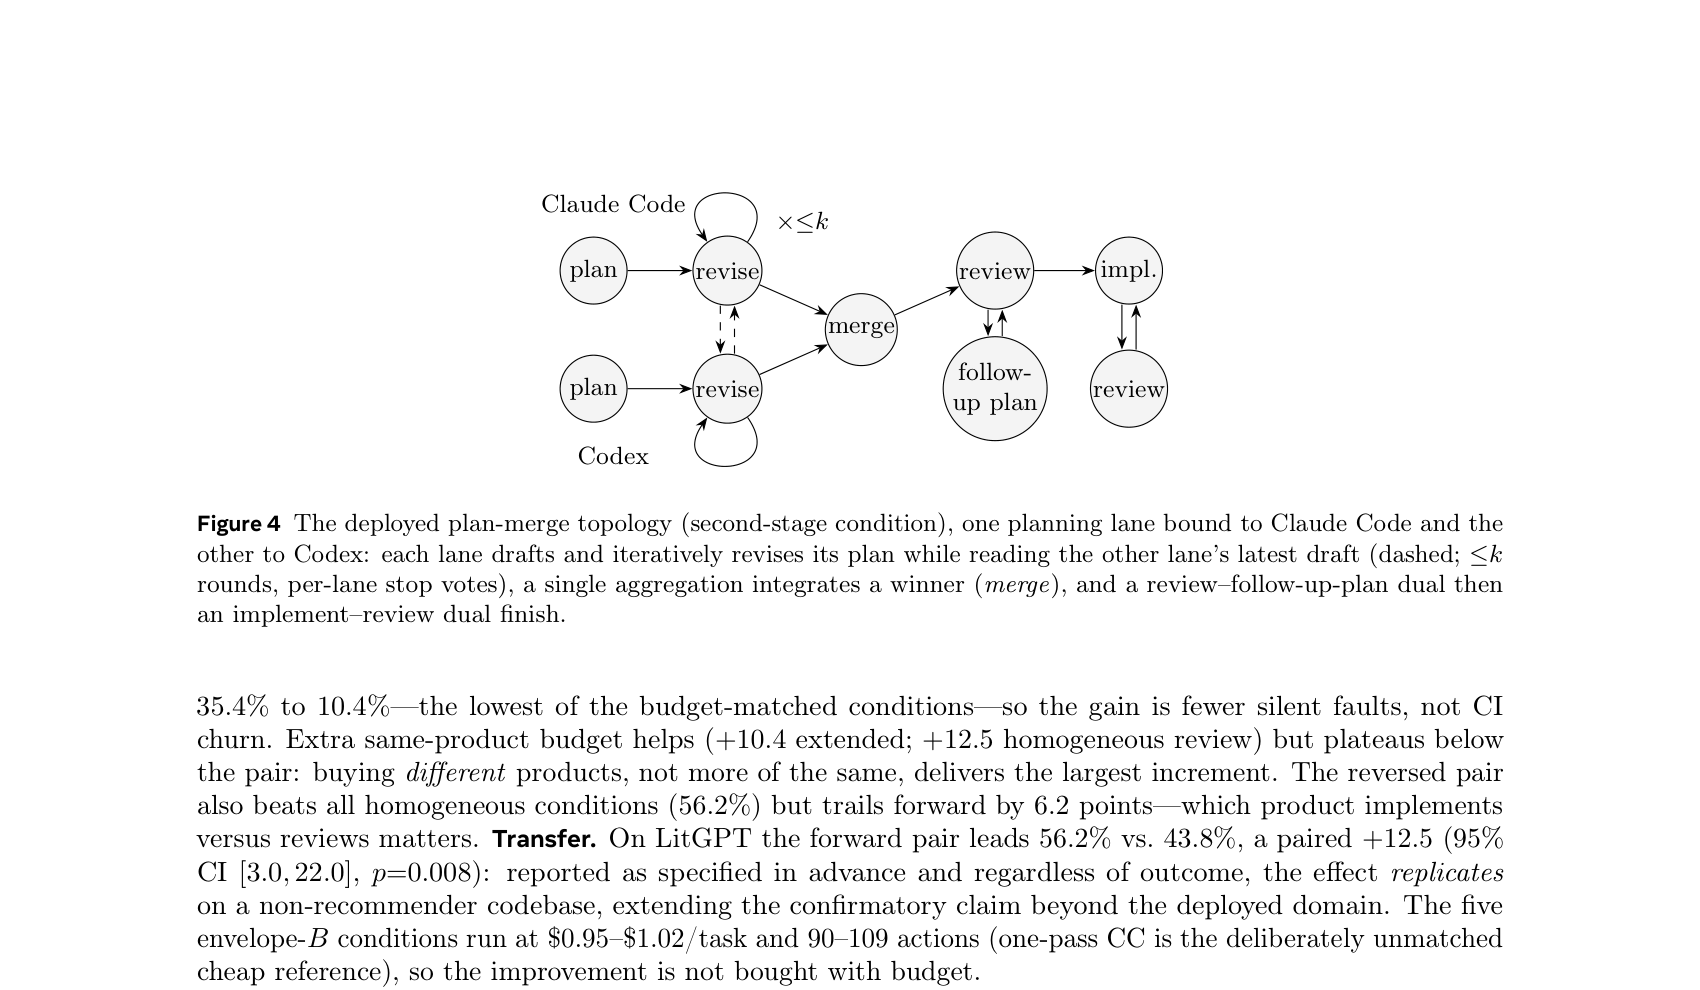
二期的部署拓扑 plan-merge(CC∥Codex 双规划通道)拿到全表最高的 70.8% EA 与最低的 6.2% CDR——但对重跑对照的配对提升 +8.3 点(McNemar p=0.077,CI [−0.7, 17.3])在统计上不可区分;把它限回包络 B 时与 CC→Codex→CC 打平(配对 0.0 点)。结论干脆:受控对比证明了为什么有效——配对两个不同的产品;plan-merge 是我们部署什么——它的优势来自值得多花的预算($2.40/题,约 2.4 倍包络),推理成本与它保护的多 GPU 训练相比可以忽略:一个漏掉的缺陷烧掉数小时到数天的加速器并污染所有下游迭代,避免一次损失的量级约为支出的 10³ 倍。
机制层(RQ3)把「为什么」钉死:定义方向互补度 $D_{a\leftarrow b}=P(E_{a}{=}1,E_{b}{=}0)$——审查者 b 可救援执行者 a 的错误质量。异构对 CC←Codex 的错误相关性低(ρ=0.21)、互补质量大(D=0.18)、扣掉审查自身引入的错误后净收益为正(G=0.06);同构对 CC←CC 的相关性高达 0.58、几乎无可救(D=0.10)、净收益约等于零。回归斜率 $\hat{\beta}_{1}{=}0.34$(CI [0.12, 0.56])排除零,机制成立:不是「多样性就好」,而是互补错误 × 转换效率。上下文作用域消融(RQ4)则补上 EOP 的最后一块证据:运行时、状态、工具、产品全部固定,只切「仅注入当前阶段正文」vs「全协议注入」,配对 EA 早期 +2.1、中期 +6.2、后期 +10.4 点,单调增长——既然状态机承担了流程,提示词里的非活跃指令只是干扰。
诚实的边界
作者的限制声明同样值得抄录:证据基础是一个排序代码库加 LitGPT,均为 Python/PyTorch,跨域迁移未完全确立;预训练可能见过公开仓库(任务、隐藏测试与参考补丁是私有的);oracle 不完备,变异测试和审计减少而非消除误通过;产品是黑盒,可观测 token/动作/时间/成本可匹配,厂商侧 FLOPs 无法匹配;知识层在部署中活跃,但缺少 memory 开关消融,其对提案质量的边际贡献未被分离;HSTU 案例研究有协议门上的人类操作员(同时也在引导运行),无法把 agent 的贡献与操作员分开(ExecML 条件则无人参与)。在同名的另一篇 RankEvolve(检索算法演化,arXiv 2602.16932)重名问题上,作者也专门加了脚注声明区别——这种学术卫生在 agent 论文里少见。
结语:给 agent 装上「过程免疫系统」
把 RankEvolve 的三层放回机器人与具身智能的语境里读,会发现它提出的其实是所有长周期 agent 系统的共同命题:当每一步都昂贵、每一次失败都隐蔽时,可靠性不是模型能力的函数,而是系统架构的函数。EOP 把流程从提示词搬进状态机,治上下文漂移;异构产品互审治静默缺陷——两件兵器都不新颖,但把它们各自的效果用预算匹配的隐藏 oracle 量化出来,这份测量纪律是全文最稀缺的贡献。反直觉的结论同样锋利:agent 在「把已知杠杆用对」上已经相当可靠(甚至能自己抓住自己的特征泄漏),在「发明新东西」上仍然不可靠。对想用自动研究 agent 加速实验闭环的团队,这篇论文给出的部署配方——协议编译成运行时、不同厂商的产品互为审查者、负结果进排行榜——比任何「agent 将取代研究员」的叙事都更有操作价值。
论文(arXiv:2609.39551)标题里那个词组说得再准不过:这是一台可靠的自动研究 harness——可靠,恰恰是靠工程而非靠模型。
flowchart LR
    A[Investigate
代码+数据] --> B[Research & Propose
BTA 并行工作者]
    B --> C[Implement & Experiment
PTI 分支·Dual 评审环]
    C --> D[Summarize & Evolve
LLM critic 重排]
    D -- "promote → 下一轮迭代" --> A
    B -. 人工确认门 .-> HUMAN[human]
    D -. 人工确认门 .-> HUMAN
    subgraph K[知识层 · 跨迭代持久]
      L[run state + manifests + leaderboard]
    end
    C -- 记录假设/补丁/负结果 --> L
    L -- 只注入相关教训 --> B
本文未提供 RankEvolve 框架的公开代码;论文评测所用的 HSTU 公开实现对应 Meta 开源的 facebookresearch/generative-recommenders(本文方法对应处:论文的 leave-one-out 与 ignore_last_n 切分逻辑对应 generative_recommenders/research/data/dataset.py 的 ignore_last_n 训练/验证/测试集构造;可学习相对时间-位置偏置对应 generative_recommenders/modules/positional_encoder.py 的 add_timestamp_positional_embeddings;论文提到的「dropout 0.2→0.1 是唯一干净的 BASE 收益」对应 configs/ml-20m/hstu-sampled-softmax-n128-final.gin 中的 train_fn.dropout_rate = 0.2 与 hstu_encoder.linear_dropout_rate = 0.2;sampled-softmax 损失对应 gin 配置的 SampledSoftmaxLoss;LARGE 16 层/8 头配置对应同目录 hstu-sampled-softmax-n128-large-final.gin)。