AwareVLN:面向视觉语言导航的自感知推理
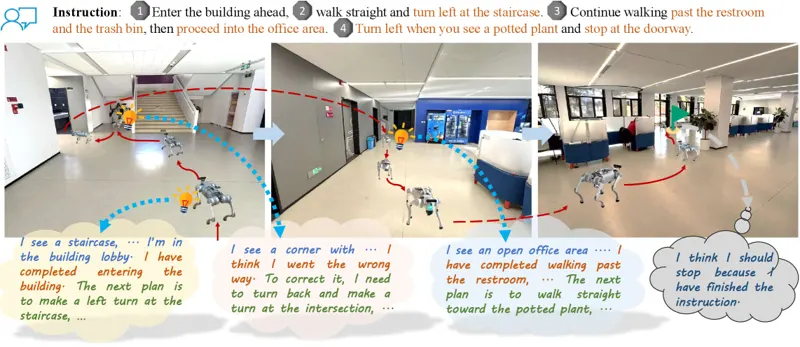
视觉语言导航(VLN)要求智能体将语言指令与自身在视觉环境中的运动进行关联。当前最先进的方法利用视觉语言模型(VLM)的推理能力进行端到端动作预测,但往往缺乏对智能体自身状态、指令和场景之间关系的显式且可解释的理解。另一方面,显式构建场景图进行启发式规划虽然直观,但依赖额外的3D传感器并阻碍大规模视觉语言预训练。为弥合这一差距,我们提出 AwareVLN,一种赋予导航模型自感知推理机制的新框架,使其能够以完全端到端和数据驱动的方式理解智能体状态和任务进度。该方法包含两项关键创新:(1)一个结构化推理模块,培养空间和任务导向的自感知能力;(2)一个带有进度划分的自动数据引擎,用于有效训练。在 Habitat 仿真器中多个数据集上的大量实验表明,AwareVLN 显著优于先前最先进的视觉语言导航方法。
Wenxuan Guo, Xiuwei Xu, Yichen Liu·2026年5月21日
视觉语言模型VLN视觉语言导航2026年5月21日
 0:54